
Lernpfad
Wissenschaftler für maschinelles Lernen in Python
85 Std.
Stell dir vor, du willst mit verbundenen Augen den tiefsten Punkt in einer Hügellandschaft finden. Du kannst nur den Boden direkt um dich herum ertasten, um herauszufinden, wo es bergab geht. Genau so verhalten sich Machine-Learning-Algorithmen, wenn sie die beste Lösung für ein Problem suchen.
Sie übersetzen das Problem in eine mathematische Funktion, deren Eingaben und Ausgaben einer hügeligen Oberfläche entsprechen. Das Minimum dieser Funktion zu finden, bedeutet, die beste Lösung erreicht zu haben. Einer der beliebtesten Algorithmen dafür ist Stochastic Gradient Descent (SGD).
In diesem Tutorial lernst du alles Wichtige über den Algorithmus: erst ein Gefühl ohne Formeln, dann die mathematischen Details und schließlich die Umsetzung in Python.
Stochastic Gradient Descent (SGD) ist eine Optimierungstechnik im Machine Learning, mit der Fehler in Vorhersagemodellen minimiert werden. Anders als beim klassischen Gradient Descent, der den Gradienten über den gesamten Datensatz berechnet und damit die Modellparameter aktualisiert, passt SGD die Parameter jeweils anhand eines einzelnen Datenpunkts an. Das macht SGD bei großen Datensätzen schneller und effizienter, allerdings auch rauschbehafteter und weniger stabil. SGD hilft, optimale Parameterwerte zu finden, sodass Vorhersagen genauer werden.
Zuerst eine wichtige Klarstellung: Stochastic Gradient Descent (SGD) ist kein eigener Machine-Learning-Algorithmus. Es ist eine Optimierungstechnik, die auf ML-Algorithmen angewendet werden kann.
Was heißt Optimierung? Gehen wir dazu vom Problemstatement im Machine Learning aus.
Angenommen, wir wollen Diamantpreise anhand des Karatwerts vorhersagen (ein Karat sind 0,2 Gramm). Das ist ein Regressionsproblem, weil das Modell Zahlenwerte ausgibt.
Zur Lösung stehen uns viele Algorithmen zur Verfügung, aber wir wählen Einfache Lineare Regression mit der Formel f(x) = mx + b, wobei:
b der Basispreis des Diamanten istm die Preissteigerung pro Karat istx der Karatwert des Diamanten istf(x) der vorhergesagte Preis des Diamanten istDiese lineare Gleichung ist unser Modell. Unser Ziel ist es, die besten Werte für m und b zu finden, damit die Vorhersagen über alle Diamanten im Datensatz möglichst präzise sind.
Hätten wir ein weiteres Merkmal im Datensatz, zum Beispiel das Volumen des Diamanten, würde sich unsere Formel zu f(x1, x2) = m1*x1 + m2*x2 + b ändern, wobei:
b der Basispreis des Diamanten istm1 die Preissteigerung pro Karat istm2 die Preissteigerung pro Volumeneinheit istx1 der Karatwert des Diamanten istx2 das Volumen des Diamanten istf(x) der vorhergesagte Preis des Diamanten istNun müssten wir die optimalen Werte für m1, m2 und b finden.
Im Allgemeinen haben alle Machine-Learning-Modelle Gleichungen wie oben mit einem oder mehreren Parametern. Die Definition von Optimierung lautet hier also: „Gegeben ein Modell und ein Datensatz, finde die optimalen Parameterwerte in der Gleichung.“
Es gibt viele Optimierungsalgorithmen für diese Aufgabe, etwa Stochastic Gradient Descent — darauf konzentriert sich dieses Tutorial. Um SGD voll zu verstehen, schauen wir uns zuerst die Grundideen dahinter an.
Um SGD zu verstehen, sollten wir zunächst den klassischen Gradient-Descent-Algorithmus (GD) betrachten, der viele Grundideen mit der stochastischen Variante teilt. Einfacher Gradient Descent beginnt mit dem Konzept des Fehlers im Machine Learning.
ML-Algorithmen raten in der Regel die richtige Antwort auf ein Problem. Diese Antwort nennen wir Vorhersage, und sie ist nicht immer korrekt. Daher führen wir die Begriffe „Fehler“ oder „Loss“ ein, die die Differenz zwischen dem tatsächlichen Wert und der Modellvorhersage beschreiben. Unser Ziel ist ein Modell, das diesen Fehler minimiert.
Wenn unser Modell f(x) 10.000 $ für einen Diamanten schätzt, der tatsächlich 12.000 $ kostet, beträgt der Fehler 2.000 $. Wir sollten unser Modell so anpassen, dass dieser Fehler kleiner wird. Die Vorhersagen müssen aber für alle Diamanten gut sein, nicht nur für einen. Wir brauchen also eine Möglichkeit, alle Fehler im Datensatz zusammenzufassen. Hier kommen Kostenfunktionen ins Spiel.
Eine Kostenfunktion fasst alle Einzelfehler zu einer Zahl zusammen, die die Gesamtleistung des Modells repräsentiert. Je geringer diese Gesamtkosten, desto besser die Vorhersagen.
Kostenfunktionen variieren je nach Problemtyp.
Bei Regressionsproblemen sagt das Modell Zahlenwerte vorher, etwa den Preis eines Diamanten oder die Zeit für eine Schwimmbahn. Bei der Klassifikation ordnet das Modell einer Kategorie zu: Ist ein Pilz essbar oder nicht? Ist das Objekt im Bild eine Katze, ein Hund oder ein Pferd?
Es gibt weitere Problemtypen, doch entscheidend ist: Jeder benötigt andere Kostenfunktionen. In diesem Tutorial konzentrieren wir uns auf die Mittlere Quadratische Abweichung (Mean Squared Error, MSE), die oft in der Regression verwendet wird.
Die Differenz zwischen den echten Werten (Ground Truth) und den Modellvorhersagen nennt man Fehler oder Loss. Eine Funktion, die all diese Fehler zusammenfasst, heißt entsprechend Fehlerfunktion, Loss-Funktion oder Kostenfunktion. Unterschiedliche Quellen nutzen die Begriffe teils synonym; in diesem Tutorial verwenden wir ab jetzt den Begriff Loss-Funktion.
Bei Regressionsproblemen sieht man häufig folgende Grafik, die echte Werte (Ground Truth) gegen Modellvorhersagen aufträgt.
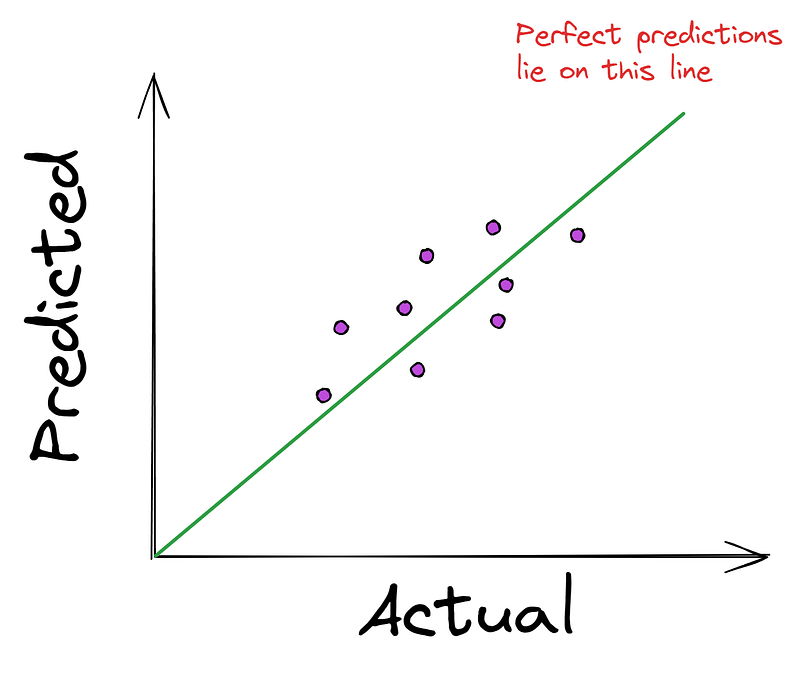
Je näher die Punkte an der Geraden liegen, desto besser sind die Vorhersagen. Daher versuchen die meisten Regressionsalgorithmen, den durchschnittlichen Abstand der Punkte zur idealen Linie zu minimieren. Wie erwähnt, geschieht diese Minimierung über eine Kostenfunktion wie die Mean Squared Error (MSE).
MSE nimmt echte und vorhergesagte Werte als Eingabe und liefert die quadrierte durchschnittliche Distanz zur perfekten Linie.
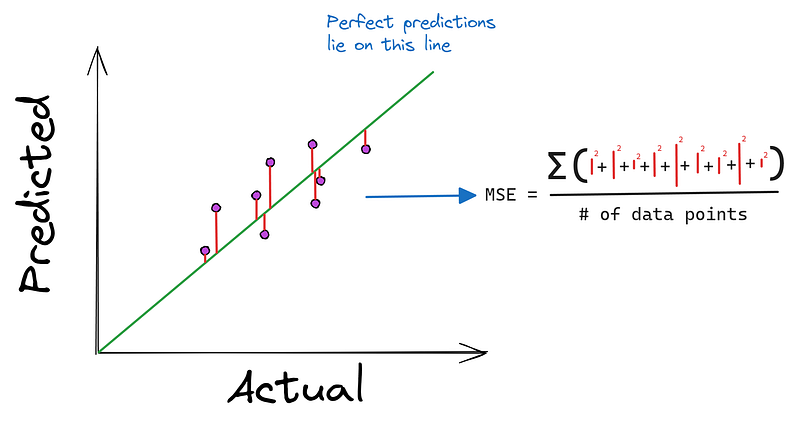
Warum quadrieren statt den Betrag zu nehmen? Erstens ist die Ableitung einer Quadratfunktion sehr einfach zu bestimmen. Zweitens betont das Quadrieren große Fehler stärker und bestraft damit die schlechtesten Vorhersagen stärker.
Deshalb wird MSE oft gegenüber Alternativen wie der Mean Absolute Error (MAE) bevorzugt, die zwar einfacher wirkt, aber sich schwerer ableiten lässt.
Das nächste Puzzleteil bei Gradient Descent ist der Gradient selbst. Kehren wir zur „den Hügel hinunter“-Analogie zurück.
Wir stehen mit verbundenen Augen auf einem Hügel und wollen so schnell wie möglich ins Tal. Wenn wir Wasser zu unseren Füßen ausgießen, in welche Richtung fließt es? Den Hang hinab, entlang der steilsten Abwärtsrichtung.
Genau das zeigt der Gradient an – allerdings in die Gegenrichtung. Der Gradient zeigt bergauf, also in die Richtung des steilsten Anstiegs. Wollen wir den Fehler minimieren, gehen wir einfach in die entgegengesetzte Richtung des Gradienten, um am schnellsten nach unten zu gelangen.
Mathematisch sagt der Gradient, wie sich die Ausgabe einer Funktion ändert, wenn wir ihre Eingaben ändern. Konkret zeigt er in die Richtung, in der die Funktion am schnellsten zunimmt.
Im ML-Kontext, in dem wir den Fehler über eine Loss-Funktion minimieren wollen, dient uns der Gradient als Wegweiser, um den Fehler am schnellsten zu senken.
Der Gradient ist ein Vektor — je einer für jeden Eingabeparameter der Funktion. Jede Zahl im Vektor gibt an, wie stark sich der Funktionswert ändert, wenn wir den entsprechenden Parameter minimal anpassen.
Wie findet man also den Gradienten einer Funktion?
Bei Funktionen mit nur einer Variablen wie f(x) = x ** 2 ist der Gradient die Ableitung der Funktion, als Vektor mit einem Element: [2x].
Bei mehrvariablen Funktionen wie f(x1, x2) = x1 ** 3 - x2 ** 2 enthält der Gradient die partiellen Ableitungen der Funktion nach jeder Eingabe. Für die zweite Funktion ist der Gradientenvektor also [3x1 ** 2, 2*x2].
Zurück zur MSE mit folgender Formel:
MSE = (1/n) * Σ(y - f(x))², wobei:
f(x) mx + b istm und b die Variablen der Funktion sindx der Karatwert der Diamanten istn die Anzahl der Datenpunkte isty der tatsächliche Preis der Diamanten istIhr Gradient sind also die partiellen Ableitungen der MSE nach m und b:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
The gradient = [∂/∂m (MSE), ∂/∂b (MSE)]
Mach dir über die Formeln nicht zu viele Gedanken. Wichtig ist: Sie sagen uns, wie sich die mittlere quadratische Abweichung ändert, wenn wir m oder b minimal verändern.
Jetzt haben wir alles, um Gradient Descent auszuführen – sprich, so effizient wie möglich ins Tal zu kommen. Springen wir in diese Richtung oder machen wir kleine Schritte? Das legt doch der Gradient fest, oder? Seine Größe bestimmt, wie weit wir pro Schritt gehen.
Aber was, wenn der Gradient so groß ist, dass wir statt im Tal auf dem nächsten Hügel landen – in nur einem Schritt? Überraschenderweise passiert das oft. Deshalb führen wir einen Parameter ein, die Schrittweite, die die Wirkung des Gradienten steuert.
Vor jedem Schritt multiplizieren wir den Gradienten einfach mit der Schrittweite, um seine Größe zu verringern. Sagt der Gradient zum Beispiel „3,56 bergab“, macht eine Schrittweite von 0,1 daraus 0,356.
So brauchen wir zwar länger bis zum Tal, laufen aber nicht mehr Gefahr, daran vorbeizuschießen.
Die Schrittweite heißt im Machine Learning üblicherweise Learning Rate und liegt typischerweise zwischen 0,001 und 0,3.
Schauen wir uns die mathematische Version an.
Zuerst geben wir den Parametern m und b Zufallswerte:
m = 0.215  # Generated randomly
b = 0.059
Damit berechnen wir die initiale MSE über den gesamten Datensatz:
MSE = (1/n) * Σ(y - (0.215 * x + 0.059))² = ...Um diesen Fehler zu senken, machen wir nun einen kleinen Schritt entgegen der Gradientenrichtung, sprich: Wir aktualisieren m und b mithilfe des Gradienten und der Learning Rate:
m_new = 0.215 - alpha * (∂/∂m (MSE))
b_new = 0.059 - alpha * (∂/∂b (MSE))
Meist wird alpha bzw. α (griechischer Buchstabe) für die Learning Rate verwendet.
Mit den neuen Werten für m und b berechnen wir die MSE erneut:
MSE_new = (1/n) * Σ(y - (m_new * x + b_new))²Dann berechnen wir wieder den Gradienten und machen so weiter, bis eine Abbruchbedingung erfüllt ist.
Sieh dir in diesem Artikel zu Gradient Descent visuell an, wie die Learning Rate das Training beeinflusst.
Mit verbundenen Augen sehen wir nicht, wann wir unten angekommen sind – vor allem bei kleinen Schritten.
Wir brauchen also Stoppkriterien. Typisch sind:
Diese Regeln legst du als ML Engineer fest. Python-Implementierungen bieten dafür meist Parameter – mehr dazu später.
Vorteile:
Herausforderungen:
Im nächsten Abschnitt siehst du, wie Stochastic Gradient Descent vor allem bei großen Datensätzen einige dieser Punkte adressiert.
Wenn du Gradient Descent verstanden hast, ist SGD leicht nachzuvollziehen.
So elegant Gradient Descent ist, bei großen Datensätzen hat es einen Nachteil. Erinnere dich: In jedem Schritt berechnen wir den Gradienten über alle Datenpunkte im Datensatz:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
Hier sind x und y Arrays mit allen Karatwerten bzw. echten Preisen. Das heißt, in jedem Schritt fließen alle Diamanten in die Parameteraktualisierung ein.
Das wird bei Millionen Datenpunkten teuer und langsam. In Zeiten von Big Data ist klassischer Gradient Descent oft unpraktisch für reale ML-Probleme.
„Stochastisch“ bedeutet „zufallsbestimmt“ – genau das macht SGD: Es bringt Zufall in den Optimierungsprozess.
Statt alle Datenpunkte für den Gradienten zu verwenden, wählt SGD in jedem Schritt zufällig einen einzelnen Punkt. Auf Basis dieses einen Punkts wird der Gradienten-Schätzer berechnet und die Parameter werden aktualisiert.
Weil SGD jeweils nur einen Datenpunkt betrachtet, erfolgen Aktualisierungen häufiger. So kann die Fehlerfläche (der „Hügel“) schneller durchschritten werden – besonders bei großen Datensätzen.
Diese Geschwindigkeit hat ihren Preis: Da der Gradienten-Schätzer nur auf einem Punkt basiert, ist er deutlich rauschiger. Unser Weg über die Fehlerfläche ist daher unruhiger und zackiger.
Für SGD definieren wir zunächst eine stochastische Kostenfunktion.
Statt die MSE über alle Datenpunkte zu berechnen, betrachten wir den quadrierten Fehler für einen zufällig ausgewählten Punkt:
Cost = (y - f(x))²Dabei ist y der echte Preis des zufällig gewählten Diamanten und f(x) = mx + b unser vorhergesagter Preis.
Dann berechnen wir den stochastischen Gradienten dieser Kostenfunktion bezüglich unserer Parameter m und b:
∂/∂m (Cost) = -2x(y - (mx + b))
∂/∂b (Cost) = -2(y - (mx + b))
The stochastic gradient = [∂/∂m (Cost), ∂/∂b (Cost)]
Mit diesem stochastischen Gradienten aktualisieren wir unsere Parameter wie beim klassischen Gradient Descent:
m_new = m_old - learning_rate * ∂/∂m (Cost)
b_new = b_old - learning_rate * ∂/∂b (Cost)
Der zentrale Punkt bei SGD: Jeder Schritt basiert auf einem zufällig gewählten Datenpunkt. Die Stoppregeln bleiben dieselben wie bei Gradient Descent.
In der Praxis wird „pures“ SGD mit Parameterupdates pro Trainingsbeispiel selten verwendet. Grund: Die Updates haben eine hohe Varianz, wodurch die Loss-Funktion stark schwanken kann und die Konvergenz zum Minimum erschwert wird.
Klassisches Gradient Descent ist stabiler, nutzt aber in jedem Schritt alle Datenpunkte und ist damit für heutige Datensätze oft unpraktisch.
Den Mittelweg zwischen Stabilität und Geschwindigkeit bietet Mini-Batch Gradient Descent, besonders in neuronalen Netzen. Dabei werden statt eines einzelnen Beispiels Batches mit mehreren Beispielen verwendet. Gängige Batchgrößen sind 16, 32, 64 usw.
Batchgröße 1 entspricht SGD. Ist die Batchgröße gleich der Datensatzgröße, ist es klassisches Gradient Descent. Alles dazwischen ist Mini-Batch Gradient Descent.
Hier eine Tabelle mit den Unterschieden und Einsatzempfehlungen:
| Typ | Update-Frequenz | Rechenaufwand | Speicherbedarf | Konvergenzstabilität | Beste Einsatzszenarien |
| Gradient Descent (GD) | Gesamter Datensatz pro Update | Am langsamsten, da kompletter Datensatz genutzt wird | Erfordert gesamten Datensatz im Speicher | Am stabilsten, aber langsam | Kleine Datensätze, bei denen Stabilität Priorität hat |
| Stochastic Gradient Descent (SGD) | Ein Beispiel pro Update | Am schnellsten, verarbeitet ein Beispiel nach dem anderen | Geringer Speicherbedarf | Hohe Varianz, kann schwanken | Große Datensätze mit Bedarf an schnellen Updates |
| Mini-Batch Gradient Descent | Batch mit Beispielen pro Update | Guter Kompromiss, effizienter als GD, langsamer als SGD | Benötigt Speicher für einen Batch | Stabiler als SGD, weniger stabil als GD | Große Datensätze mit Bedarf an Balance aus Stabilität und Effizienz |
Ein wichtiger Begriff in jedem Optimierungsalgorithmus ist die Epoche. Sie bezeichnet einen vollständigen Durchlauf durch den Trainingsdatensatz.
In einer Epoche verarbeitet der Algorithmus jedes Trainingsbeispiel genau einmal. Für jedes Beispiel (oder jeden Mini-Batch) erstellt das Modell Vorhersagen, berechnet die Loss und aktualisiert die Gewichte gemäß dem Gradienten. Eine Epoche markiert also einen Verbesserungszyklus. Nach jeder Epoche kannst du typischerweise sehen, wie sich die Modellleistung verändert hat.
Trainingsläufe umfassen meist mehrere Epochen (mindestens 10 sind empfehlenswert). Die Anzahl der Epochen ist ein Hyperparameter. Häufig wird der Datensatz vor jeder Epoche neu gemischt, damit das Modell nicht die Reihenfolge der Beispiele „lernt“.
In unserer Hügel-Analogie ist eine Epoche eine vollständige Erkundung der Landschaft. Pro Epoche:
Nach jeder kompletten Erkundung startest du vom neuen Standort. Mehrere Epochen geben dem Modell wiederholt die Chance, die Loss-Landschaft zu erkunden und ein gutes Minimum zu finden.
Mehrere Epochen garantieren jedoch kein globales Minimum. Startpunkt und Komplexität der Loss-Landschaft können den Prozess beeinflussen.
In diesem Abschnitt implementieren wir SGD mit Unterstützung für Batchgrößen (Mini-Batch GD) ausschließlich mit Numpy.
Zuerst importieren wir die benötigten Bibliotheken:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
Wir verwenden 10.000 Datenpunkte aus dem Diamonds-Datensatz von Seaborn. Wir nehmen nur das Merkmal carat und die Spalte price als Zielvariable:
# Load the data
dataset_size = 10_000
diamonds = sns.load_dataset('diamonds')
# Extract the target and the feature
xy = diamonds[['carat', 'price']].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
(10000, 2)
Jetzt teilen wir die Daten in Trainings- und Testset auf, wobei das Training 80 % umfasst.
# Split the data
np.random.shuffle(xy)
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(8000, 2)
Dann definieren wir unsere Modellfunktion:
def model(m, x, b):
   """Simple linear model"""
   return m * x + b
Wir führen eine einfache lineare Regression mit nur zwei unabhängigen Parametern durch: m und b.
Als Loss-Funktion definieren wir die MSE:
def loss(y_true, y_pred):
   """Mean squared error"""
   return np.mean((y_true - y_pred) ** 2)
Nun definieren wir eine Funktion namens stochastic_gradient_descent mit sechs Argumenten:
x und y sind Merkmal und Zielvariableepochs gibt an, wie oft wir den Abstieg durchführen (mehr dazu gleich)learning_rate ist die Schrittweitebatch_size steuert, wie häufig Parameterupdates erfolgenstopping_threshold legt fest, um wie viel sich die Loss pro Schritt mindestens verringern solldef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""Zum Start initialisieren wir die zu optimierenden Parameter zufällig und setzen die Loss auf unendlich:
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infDann starten wir eine for-Schleife über die epochs. Darin mischen wir die Daten neu, um die Berechnungen robuster zu machen:
for i in range(epochs):
# Shuffle the data
indices = np.random.permutation(n)
x = x[indices]
y = y[indices]Die eigentliche Gradientenberechnung beginnt dann in einer weiteren for-Schleife.
for j in range(0, n, batch_size):
x_batch = x[j:j + batch_size]
y_batch = y[j:j + batch_size]Wir extrahieren den Batch aus x und y und berechnen die Gradienten:
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)Wir nutzen die oben definierte model-Funktion, um mit den aktuellen Werten von m und b vorherzusagen. Dann bestimmen wir die partiellen Ableitungen, die den Gradienten bilden – gemäß der oben angegebenen Formel.
Mit den partiellen Ableitungen und der Learning Rate aktualisieren wir die Parameter:
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientHier ist der bisherige vollständige Code:
def stochastic_gradient_descent(
   x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
   """
   SGD with support for mini-batches.
   """
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x)
previous_loss = np.inf
for i in range(epochs):
   # Shuffle the data
   indices = np.random.permutation(n)
   x = x[indices]
   y = y[indices]
for j in range(0, n, batch_size):
   x_batch = x[j:j + batch_size]
   y_batch = y[j:j + batch_size]
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientAußerhalb der inneren Schleife berechnen wir die Loss für die Epoche:
# Compute the loss
y_pred = model(m, x, b)
current_loss = loss(y, y_pred)
Ist die Differenz previous_loss - current_loss kleiner als der stopping_threshold, beenden wir den Prozess:
if previous_loss - current_loss < stopping_threshold:
   break
previous_loss = current_loss
Andernfalls setzen wir previous_loss auf current_loss. Am Ende geben wir die optimierten Parameter m und b zurück:
return m, bDen gesamten Code findest du in diesem GitHub-Gist, um den Überblick zu behalten.
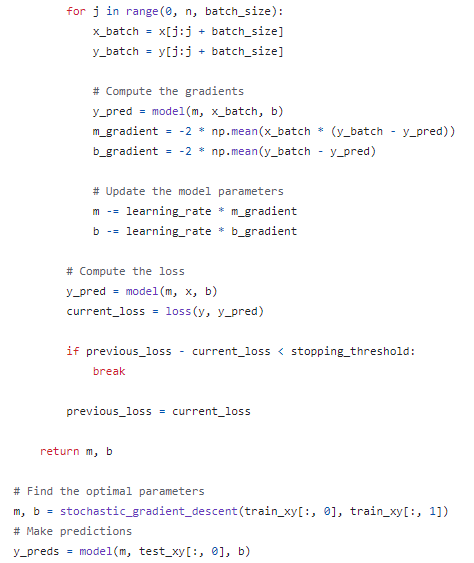
Testen wir die gefundenen Parameter, indem wir das Modell auf dem Testset ausführen:
# Find the optimal parameters
m, b = stochastic_gradient_descent(train_xy[:, 0], train_xy[:, 1])
# Make predictions
y_preds = model(m, test_xy[:, 0], b)
# Compute and print the loss
mean_squared_error = loss(test_xy[:, 1], y_preds)
mean_squared_error ** 0.5
1595.3955619759456
Die Quadratwurzel der MSE liegt bei etwa 1.600 $, das heißt, unser Modell liegt im Schnitt um 1.600 $ daneben. Um den Fehler zu verbessern, können wir die Anzahl der Epochen erhöhen oder einen größeren Datensatz verwenden.
Die obige Implementierung von SGD ist grob und ineffizient. Sie dient nur dazu, die Intuition aus den vorherigen Abschnitten mit einem Coding-Walkthrough zu festigen.
In der Praxis implementierst du SGD fast nie selbst, sondern nutzt vorhandene Implementierungen in gängigen Frameworks.
Scikit-learn bietet zum Beispiel die Estimatoren SGDRegressor und SGDClassifier, um verschiedene ML-Algorithmen zu trainieren, darunter:
mit SGD als Optimierungsalgorithmus.
from sklearn.linear_model import SGDRegressor, SGDClassifier
# SGD for Linear Regression with 1000 epochs
regressor = SGDRegressor(loss='squared_loss', max_iter=1000)
In PyTorch ist er als Klasse SGD im Modul optim verfügbar:
import torch.optim as optim
optimizer = optim.SGD(model.parameters(), lr=0.01)
Wenn du lernen willst, wie man Modelle in PyTorch trainiert und optimiert, schau dir den DataCamp-Kurs Introduction to PyTorch an.
In Keras heißt der Optimierer ebenfalls SGD:
from tensorflow.keras.optimizers import SGD
optimizer = SGD(learning_rate=0.01)
Für Training und Optimierung in TensorFlow empfehle ich DataCamps Kurs „Introduction to TensorFlow“.
Es gibt viele Best Practices und Tipps für den Einsatz von SGD und ähnlichen Algorithmen. Hier einige davon:
Heute hast du einen der wichtigsten Optimierungsalgorithmen im Machine Learning kennengelernt: Stochastic Gradient Descent.
Zuerst haben wir Intuition und Grundideen über klassischen Gradient Descent aufgebaut – mit der Hügel-Analogie, bei der wir mit verbundenen Augen den Talboden suchen.
Wir haben gelernt, dass sich SGD und klassisches GD dadurch unterscheiden, wie viele Datenpunkte pro Parameterupdate genutzt werden. Um das Verständnis zu festigen und die Mathematik greifbar zu machen, haben wir SGD in Numpy implementiert.
Beachte, dass SGD nur ein Teil des gesamten ML-Trainingsprozesses ist. Um mehr über seinen Kontext zu erfahren, sieh dir diese Ressourcen an:
Top-DataCamp-Kurse
Lernpfad
Lernpfad
Lernpfad