
Programma
Scienziato specializzato in apprendimento automatico in Python
85 ore
Immagina di cercare il punto più basso tra le colline con una benda sugli occhi. Affidandoti solo al tatto, puoi percepire il terreno immediatamente intorno a te per capire da che parte si scende. In sostanza, è quello che fanno gli algoritmi di machine learning quando cercano la soluzione migliore a un problema.
Trasformano il problema in una funzione matematica i cui input e output rappresentano una superficie collinare. Trovare il minimo di questa funzione significa aver raggiunto la soluzione migliore. Uno degli algoritmi più popolari per farlo si chiama Stochastic Gradient Descent (SGD).
In questo tutorial imparerai tutto quello che ti serve sapere sull’algoritmo: dall’intuizione di base senza formule, ai dettagli matematici, fino a come implementarlo in Python.
La Stochastic Gradient Descent (SGD) è una tecnica di ottimizzazione usata nel machine learning per minimizzare gli errori nei modelli predittivi. A differenza della discesa del gradiente classica, che usa l’intero dataset per calcolare il gradiente e aggiornare i parametri del modello, l’SGD aggiorna i parametri usando un solo punto dati alla volta. Questo la rende più veloce ed efficiente su dataset grandi, anche se può essere più rumorosa e meno stabile. L’SGD aiuta a trovare i valori ottimali dei parametri del modello per migliorare l’accuratezza delle previsioni.
La prima cosa da chiarire subito è che la stochastic gradient descent (SGD) non è un algoritmo di machine learning. Piuttosto, è solo una tecnica di ottimizzazione che può essere applicata a algoritmi di ML.
Quindi, cos’è l’ottimizzazione? Per capirlo, partiamo dalla definizione del problema nel machine learning.
Supponiamo di voler prevedere il prezzo dei diamanti in base al loro valore in carati (un carato è 0,2 grammi). Si tratta di un problema di regressione perché il modello produce valori numerici.
Per risolvere il problema abbiamo a disposizione un’ampia gamma di algoritmi, ma scegliamo la Regressione lineare semplice, che ha la semplice formula f(x) = mx + b dove:
b è il prezzo base del diamantem è l’aumento di prezzo per caratox è il valore in carati del diamantef(x) è il prezzo previsto del diamanteQuesta equazione lineare rappresenta il nostro modello. L’obiettivo è trovare i valori migliori di m e b che rendano le nostre previsioni il più accurate possibile su tutti i diamanti del dataset.
Se avessimo un’altra caratteristica nel dataset, come il volume del diamante, la formula diventerebbe f(x1, x2) = m1*x1 + m2*x2 + b, dove:
b è il prezzo base del diamantem1 è l’aumento di prezzo per caratom2 è l’aumento di prezzo per unità di volumex1 è il valore in carati del diamantex2 è il volume del diamantef(x) è il prezzo previsto del diamanteOra dovremmo trovare i valori ottimali per m1, m2 e b.
In generale, tutti i modelli di machine learning hanno equazioni come quelle sopra con uno o più parametri. Quindi, la definizione di ottimizzazione in questo contesto diventa: “Dato questo modello e questo dataset, trova i valori ottimali dei parametri nell’equazione”.
Esistono molti algoritmi di ottimizzazione in grado di svolgere questo compito, come la Stochastic Gradient Descent, che è il focus del nostro tutorial. Ma per capire a fondo come funziona l’SGD, ripassiamo alcune idee fondamentali alla base.
Per capire l’SGD, dobbiamo conoscere l’algoritmo della discesa del gradiente “classica” (GD), che condivide molti dei principi alla base della sua versione stocastica. La discesa del gradiente semplice parte dal concetto di errore nel machine learning.
Di solito gli algoritmi di ML “indovinano” la risposta corretta a un problema. Chiamiamo questa risposta una previsione e non è sempre accurata. Introduciamo quindi un nuovo termine, “errore” o “loss”, che rappresenta la differenza tra la risposta reale e la previsione del modello. Il nostro obiettivo è costruire un modello che minimizzi questo errore.
Se il nostro modello f(x) stima 10.000 $ per un diamante che in realtà costa 12.000 $, l’errore è di 2.000 $. Dovremmo quindi aggiustare il modello per ridurre questo errore. Ma le previsioni del modello devono essere buone per qualsiasi diamante, non solo per uno. Abbiamo quindi bisogno di un modo per combinare l’errore di tutti i diamanti del dataset. Qui entrano in gioco le funzioni di costo.
Una funzione di costo combina tutti gli errori individuali in un unico numero che rappresenta la performance complessiva del modello. Un costo complessivo più basso significa previsioni migliori.
Le funzioni di costo cambiano in base al tipo di problema che stiamo risolvendo.
Nei problemi di regressione, il modello prevede valori numerici, come quanto costa un diamante o quanto tempo serve per fare una vasca a nuoto. Nella classificazione, il modello prevede la categoria di appartenenza di qualcosa. Per esempio, un fungo è commestibile o no? L’oggetto nell’immagine è un gatto, un cane o un cavallo?
Esistono altri tipi di problemi, ma il punto importante è che ognuno richiede funzioni di costo diverse. In questo tutorial ci concentreremo sulla Mean Squared Error (MSE), spesso usata nella regressione.
La differenza tra i valori reali (ground truth) e le previsioni del modello si chiama errore o loss. Di conseguenza, una funzione che combina tutti questi errori o perdite viene chiamata funzione di errore, loss function o funzione di costo. Fonti diverse potrebbero usare questi termini in modo intercambiabile; da qui in avanti useremo il termine loss function.
Nei problemi di regressione è comune vedere il seguente grafico, che mette a confronto i valori reali (ground truth) e le previsioni del modello.
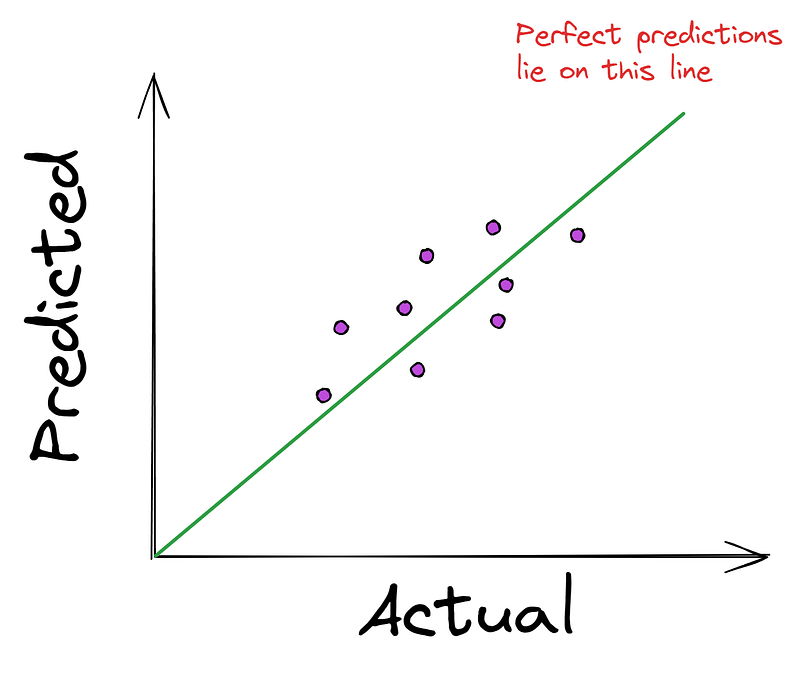
Più i punti sono vicini alla retta, migliori sono le previsioni del modello. Per questo, la maggior parte degli algoritmi di regressione cerca di minimizzare la distanza media dei punti dalla linea perfetta. E, come detto prima, la minimizzazione avviene usando una funzione di costo come la Mean Squared Error (MSE).
La MSE prende in input i valori reali e previsti e produce la distanza media quadratica dalla linea perfetta.
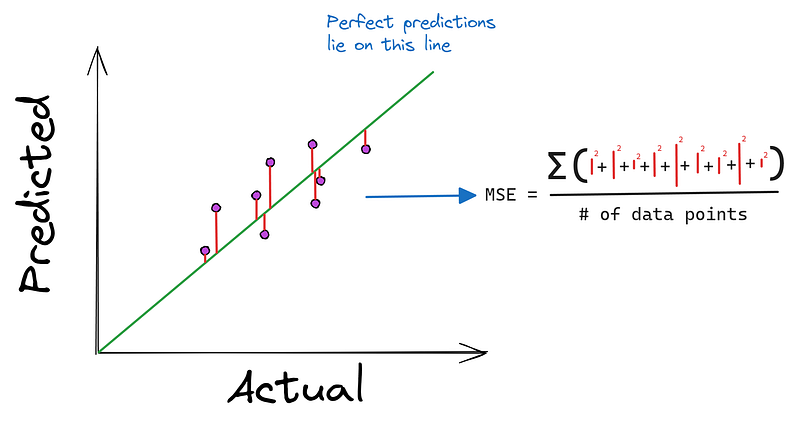
Potresti chiederti: “Perché elevare al quadrato le differenze invece di prenderne il valore assoluto?”. Il primo motivo è che è molto semplice trovare la derivata di una funzione quadratica. Inoltre, elevare al quadrato le differenze enfatizza gli errori più grandi, penalizzando il modello per le sue previsioni peggiori.
Ecco perché la MSE è preferita ad altre funzioni alternative come la Mean Absolute Error (MAE), che a prima vista sembrano più semplici ma sono più difficili da derivare.
Il pezzo successivo del puzzle della discesa del gradiente è proprio il gradiente. Torniamo alla nostra analogia “giù per la collina” per capirlo meglio.
Eravamo in cima alla collina con la benda sugli occhi e volevamo raggiungere il fondo il più velocemente possibile. Se versassimo dell’acqua ai nostri piedi, in che direzione scorrerebbe? Scenderebbe in direzione della massima pendenza.
È esattamente quello che indica il gradiente, ma nella direzione opposta. Il gradiente punta verso l’alto — nella direzione della massima salita. Quando vogliamo minimizzare l’errore, andiamo semplicemente nella direzione opposta al gradiente per trovare la via più rapida verso il basso.
Matematicamente, il gradiente ci dice come cambiano gli output di una funzione al variare dei suoi input. Più specificamente, ci indica la direzione in cui la funzione cresce più rapidamente.
Nel contesto del machine learning, dove cerchiamo di minimizzare l’errore usando una loss function, il gradiente diventa la nostra guida per trovare il percorso più rapido per ridurlo.
Il gradiente è rappresentato come un vettore — uno per ciascun parametro in input della funzione. Ogni numero in questo vettore ci dice quanto cambierebbe la funzione se apportassimo un piccolo aggiustamento al parametro corrispondente.
Quindi, come si trova il gradiente di una funzione?
Per funzioni a singola variabile come f(x) = x ** 2, il gradiente è la derivata della funzione, data come vettore con un elemento - [2x].
Per funzioni multivariabili come f(x1, x2) = x1 ** 3 - x2 ** 2, il gradiente contiene le derivate parziali della funzione rispetto a ciascun input. Quindi, per la seconda funzione, il vettore gradiente è [3x1 ** 2, 2*x2].
Torniamo alla MSE, che ha la seguente formula:
MSE = (1/n) * Σ(y - f(x))² dove:
f(x) è mx + bm e b sono variabili della funzionex è il valore in carati dei diamantin è il numero di punti datiy è il prezzo reale dei diamantiIl suo gradiente è quindi dato dalle derivate parziali della MSE rispetto a m e b:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
The gradient = [∂/∂m (MSE), ∂/∂b (MSE)]
Non preoccuparti troppo di queste formule. L’idea chiave è che ci dicono come cambia la mean squared error se modifichiamo di pochissimo m o b.
Ora abbiamo tutto ciò che serve per eseguire la discesa del gradiente o, in altre parole, per raggiungere il fondo della collina nel modo più efficiente possibile. Ma dobbiamo “saltare” in quella direzione o fare piccoli passi? Be’, lo determina il gradiente, giusto? La grandezza del gradiente indica quanto lontano scendiamo a ogni passo.
Ma supponiamo che il gradiente sia così grande che, invece di raggiungere il fondo, lo superiamo e finiamo in cima a un’altra collina in un solo passo. Sorprendentemente, questo capita spesso nella discesa del gradiente, quindi introduciamo un parametro chiamato ampiezza del passo, che controlla l’effetto del gradiente.
Prima di fare un passo, moltiplichiamo semplicemente il gradiente per l’ampiezza del passo, riducendone la magnitudine. Ad esempio, se il nostro gradiente suggerisce un passo di 3,56 in discesa, un’ampiezza del passo di 0,1 lo trasforma in 0,356.
Ci metteremo più tempo a raggiungere il fondo, ma non rischieremo di oltrepassarlo del tutto.
Nel machine learning l’ampiezza del passo si chiama di solito learning rate e tipicamente assume valori tra 0,001 e 0,3.
Vediamo ora la versione matematica di questo processo.
Per prima cosa assegniamo ai parametri m e b del nostro modello dei valori casuali:
m = 0.215  # Generated randomly
b = 0.059
Usandoli, calcoliamo la MSE iniziale sull’intero dataset:
MSE = (1/n) * Σ(y - (0.215 * x + 0.059))² = ...Ora, per ridurre questo errore, dobbiamo fare un piccolo passo nella direzione opposta al gradiente, ovvero aggiornare m e b usando il gradiente e il learning rate:
m_new = 0.215 - alpha * (∂/∂m (MSE))
b_new = 0.059 - alpha * (∂/∂b (MSE))
La maggior parte delle risorse usa alpha o α (la lettera greca) per indicare il learning rate.
Dopo aver ottenuto i nuovi valori di m e b, ricalcoliamo la MSE:
MSE_new = (1/n) * Σ(y - (m_new * x + b_new))²A questo punto ricalcoliamo il gradiente e proseguiamo in questo modo finché non raggiungiamo una condizione di arresto.
Scopri visivamente come il learning rate influisce sull’addestramento leggendo questo articolo sulla discesa del gradiente.
Dal momento che abbiamo la benda sugli occhi, non possiamo davvero vedere quando abbiamo raggiunto il fondo, specialmente facendo piccoli passi.
Servono quindi delle condizioni per fermare la discesa. In genere si usano queste regole:
Queste regole le imposti tu, l’ingegnere ML, quando esegui la discesa del gradiente. Le implementazioni in Python dell’algoritmo di solito hanno argomenti per impostarle e ne vedremo alcune più avanti.
Vantaggi:
Sfide:
Nella prossima sezione vedremo come la Stochastic Gradient Descent affronta alcune di queste sfide, in particolare sui dataset di grandi dimensioni.
Una volta compresa la discesa del gradiente classica, l’SGD diventa molto facile da capire.
Per quanto la discesa del gradiente sia uno degli algoritmi di ottimizzazione più eleganti, ha un notevole svantaggio quando si lavora con grandi dataset. Ricorda che a ogni passo calcoliamo il gradiente usando tutti i punti dati del dataset:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
Qui, x e y sono array che contengono tutti i valori in carati e i prezzi reali dei diamanti. Questo significa che a ogni passo useremmo le informazioni di ogni singolo diamante per aggiornare i parametri.
Come puoi immaginare, diventa costoso dal punto di vista computazionale e richiede tempo quando abbiamo milioni di punti dati. Nell’era dei big data, questo limite può rendere la discesa del gradiente classica poco pratica per molti problemi reali di machine learning.
“Stocastico” significa “determinato casualmente”, ed è esattamente ciò che fa l’SGD: introduce casualità nel nostro processo di ottimizzazione.
Invece di usare tutti i punti dati per calcolare il gradiente, l’SGD seleziona casualmente un punto dati a ogni passo. Usa questo singolo punto per calcolare una stima del gradiente e aggiornare i parametri.
Poiché l’SGD considera un punto alla volta, può aggiornare i parametri più frequentemente. Questo gli consente di attraversare più velocemente la superficie d’errore (la “collina”), soprattutto con dataset grandi.
Tuttavia, questa velocità ha un costo. Usando un solo punto dati per stimare il gradiente dell’intero dataset, le stime risultano molto più rumorose. Ciò significa che il nostro percorso lungo la superficie d’errore è meno regolare e più irregolare.
Per eseguire l’SGD, definiamo innanzitutto una funzione di costo stocastica.
Invece di calcolare la Mean Squared Error su tutti i punti dati, ora consideriamo l’errore quadratico per un singolo punto scelto casualmente:
Cost = (y - f(x))²Dove y è il prezzo reale del diamante scelto casualmente e f(x) = mx + b è il nostro prezzo previsto per quel diamante.
Poi calcoliamo il gradiente stocastico di questa funzione di costo rispetto ai nostri parametri m e b:
∂/∂m (Cost) = -2x(y - (mx + b))
∂/∂b (Cost) = -2(y - (mx + b))
The stochastic gradient = [∂/∂m (Cost), ∂/∂b (Cost)]
Usando questo gradiente stocastico, aggiorniamo i parametri nello stesso modo della discesa del gradiente classica:
m_new = m_old - learning_rate * ∂/∂m (Cost)
b_new = b_old - learning_rate * ∂/∂b (Cost)
L’idea chiave nell’SGD è che ogni passo coinvolge un singolo punto dati scelto casualmente. Le regole per fermare la discesa restano le stesse della discesa del gradiente classica.
Nella pratica, la versione “vanilla” dell’SGD, in cui i parametri vengono aggiornati per ogni esempio di training, è raramente usata. Il motivo è che gli aggiornamenti dell’algoritmo hanno una varianza troppo alta, che può far fluttuare la loss function rendendo più difficile la convergenza al minimo esatto.
La discesa del gradiente classica è potente e fornisce risultati più stabili, ma, come detto, usa tutti i punti dati a ogni passo, risultando poco pratica per i dataset odierni.
Per trovare un equilibrio tra stabilità e velocità, si usa spesso la mini-batch gradient descent, soprattutto nelle reti neurali. Nella mini-batch GD, invece di usare un singolo campione casuale, si usa un batch di campioni per aggiornare i parametri. Le dimensioni dei batch più comuni sono 16, 32, 64 e così via.
Quindi, se usi un batch size di 1, stai facendo SGD. Se il batch size è uguale alla dimensione del dataset, hai la discesa del gradiente classica. Qualsiasi altra dimensione del batch ti dà la mini-batch gradient descent.
Ecco una tabella che riassume le differenze e quando usare ciascuna:
| Tipo | Frequenza di aggiornamento | Efficienza computazionale | Requisiti di memoria | Stabilità della convergenza | Uso migliore |
| Gradient Descent (GD) | Intero dataset per aggiornamento | Il più lento per via dell’uso dell’intero dataset | Richiede l’intero dataset in memoria | La più stabile, ma la più lenta | Dataset piccoli dove la stabilità è cruciale |
| Stochastic Gradient Descent (SGD) | Un esempio per aggiornamento | Il più veloce, elabora un esempio alla volta | Basso requisito di memoria | Alta varianza, può oscillare | Dataset grandi che richiedono aggiornamenti rapidi |
| Mini-Batch Gradient Descent | Un batch di esempi per aggiornamento | Bilancia efficienza e velocità, più efficiente del GD, più lento dell’SGD | Richiede memoria per un batch | Più stabile dell’SGD, meno stabile del GD | Dataset grandi che necessitano di un equilibrio tra stabilità ed efficienza |
Un concetto importante in qualsiasi tipo di algoritmo di ottimizzazione è l’epoca. Si riferisce a un passaggio completo attraverso l’intero dataset di addestramento.
In un’epoca, l’algoritmo elabora ogni campione nel dataset di addestramento esattamente una volta. Per ciascun campione (o mini-batch di campioni), il modello effettua previsioni, calcola la loss e aggiorna i pesi in base al gradiente della loss. Un’epoca segna un ciclo di miglioramento per il modello. Dopo ogni epoca, di solito puoi osservare come sono cambiati le prestazioni del modello.
L’addestramento in genere prevede più epoche (se ne raccomandano almeno 10). Il numero di epoche è un iperparametro che puoi regolare. Spesso, i dati vengono mescolati prima di ogni epoca per evitare che il modello apprenda l’ordine degli esempi di training.
Nella nostra analogia dell’esplorazione della collina bendati, un’epoca è un’esplorazione completa dell’intero paesaggio. Durante ogni epoca, tu:
Dopo ogni esplorazione completa, riparti dalla tua nuova posizione. Più epoche danno al modello ripetute opportunità di esplorare il paesaggio della loss, aumentando le probabilità di trovare un buon minimo.
Tuttavia, più epoche non garantiscono il raggiungimento del minimo globale e l’intero processo può essere influenzato da fattori come il punto di partenza o la complessità del paesaggio della loss.
In questa sezione implementeremo l’SGD con supporto per il batch size (mini-batch GD) usando solo Numpy.
Per prima cosa, importiamo le librerie necessarie:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
Useremo 10.000 punti dati dal dataset Diamonds disponibile in Seaborn. Prenderemo solo la caratteristica carat e la colonna price come target:
# Load the data
dataset_size = 10_000
diamonds = sns.load_dataset('diamonds')
# Extract the target and the feature
xy = diamonds[['carat', 'price']].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
(10000, 2)
Ora, dividiamo i dati in training e test set, impostando la dimensione del training all’80% del totale.
# Split the data
np.random.shuffle(xy)
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(8000, 2)
Poi, definiamo la nostra funzione di modello:
def model(m, x, b):
   """Simple linear model"""
   return m * x + b
Stiamo facendo una semplice regressione lineare con sole due variabili indipendenti m e b.
Dovremmo anche definire la nostra funzione di loss MSE:
def loss(y_true, y_pred):
   """Mean squared error"""
   return np.mean((y_true - y_pred) ** 2)
Ora definiamo una funzione chiamata stochastic_gradient_descent che accetta sei argomenti:
x e y rappresentano l’unica feature e il target nel nostro problemaepochs indica quante volte vogliamo eseguire la discesa (ne parleremo meglio tra poco)learning_rate è l’ampiezza del passobatch_size per controllare quanto frequentemente facciamo aggiornamenti dei parametristopping_threshold imposta il valore minimo di diminuzione della loss a ogni passodef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""Per iniziare, inizializziamo i parametri che vogliamo ottimizzare con valori casuali e impostiamo la loss a infinito:
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infPoi avviamo un ciclo for usando il parametro epochs. All’interno del ciclo, mescoliamo i dati per rendere i calcoli più robusti:
for i in range(epochs):
# Shuffle the data
indices = np.random.permutation(n)
x = x[indices]
y = y[indices]Poi, il calcolo effettivo del gradiente inizia all’interno di un altro ciclo for.
for j in range(0, n, batch_size):
x_batch = x[j:j + batch_size]
y_batch = y[j:j + batch_size]Estraiamo il batch da x e y e calcoliamo i gradienti:
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)Usiamo la funzione model creata sopra per fare una previsione con i valori correnti di m e b. Quindi troviamo le derivate parziali che compongono il gradiente usando la formula indicata nella sezione precedente.
Usando le derivate parziali e il learning rate, aggiorniamo i parametri:
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientEcco il codice completo finora:
def stochastic_gradient_descent(
   x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
   """
   SGD with support for mini-batches.
   """
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x)
previous_loss = np.inf
for i in range(epochs):
   # Shuffle the data
   indices = np.random.permutation(n)
   x = x[indices]
   y = y[indices]
for j in range(0, n, batch_size):
   x_batch = x[j:j + batch_size]
   y_batch = y[j:j + batch_size]
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientContinuando la funzione al di fuori del ciclo interno, calcoliamo la loss per l’epoca:
# Compute the loss
y_pred = model(m, x, b)
current_loss = loss(y, y_pred)
Se la current_loss è minore della stopping_threshold interrompiamo l’intero processo:
if previous_loss - current_loss < stopping_threshold:
   break
previous_loss = current_loss
Altrimenti, impostiamo previous_loss a current_loss. Infine, restituiamo i parametri m e b ottimizzati:
return m, bHo incollato l’intero codice in questa gist su GitHub così puoi vedere l’insieme completo.
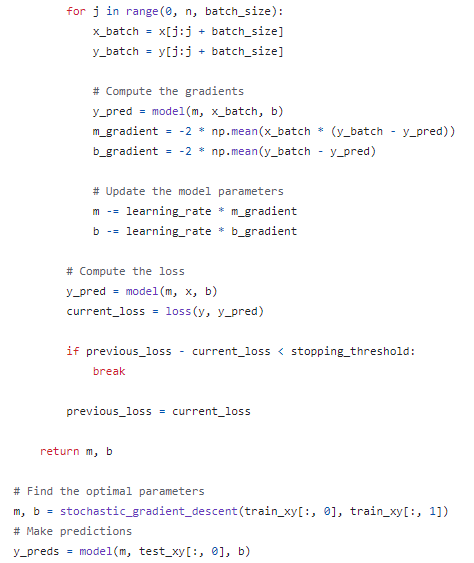
Testiamo quanto funzionano bene i parametri trovati eseguendo il modello sul test set:
# Find the optimal parameters
m, b = stochastic_gradient_descent(train_xy[:, 0], train_xy[:, 1])
# Make predictions
y_preds = model(m, test_xy[:, 0], b)
# Compute and print the loss
mean_squared_error = loss(test_xy[:, 1], y_preds)
mean_squared_error ** 0.5
1595.3955619759456
La radice quadrata dell’MSE è circa 1.600 $, il che significa che il nostro modello sbaglia in media di 1.600 $. Per migliorare l’errore, possiamo aumentare il numero di epoche o usare un dataset più grande.
L’implementazione dell’SGD nell’ultima sezione è grezza e inefficiente. Serve semplicemente a consolidare l’intuizione che abbiamo costruito nelle sezioni precedenti con una dimostrazione di codice.
In pratica, quasi mai reimplementi manualmente l’SGD, ma usi versioni già disponibili nei framework più diffusi.
Per esempio, Scikit-learn fornisce gli stimatori SGDRegressor e SGDClassifier per addestrare vari algoritmi di ML come:
con l’SGD come algoritmo di ottimizzazione.
from sklearn.linear_model import SGDRegressor, SGDClassifier
# SGD for Linear Regression with 1000 epochs
regressor = SGDRegressor(loss='squared_loss', max_iter=1000)
In PyTorch, è disponibile come classe SGD all’interno del modulo optim:
import torch.optim as optim
optimizer = optim.SGD(model.parameters(), lr=0.01)
Per imparare ad addestrare e ottimizzare modelli in PyTorch, consulta il corso Introduction to PyTorch di DataCamp.
In Keras, l’SGD è disponibile con lo stesso nome:
from tensorflow.keras.optimizers import SGD
optimizer = SGD(learning_rate=0.01)
Per imparare ad addestrare e ottimizzare modelli in TensorFlow, consulta il corso Introduction to TensorFlow di DataCamp.
Esistono molte best practice e suggerimenti per usare l’SGD o algoritmi simili. Di seguito ne elenchiamo alcuni:
Oggi abbiamo imparato uno dei principali algoritmi di ottimizzazione nel machine learning — lo Stochastic Gradient Descent.
Per prima cosa, abbiamo costruito l’intuizione e le sue idee fondamentali considerando un normale algoritmo di discesa del gradiente. Abbiamo usato ampiamente l’analogia della collina in cui cerchiamo di trovare il fondo mentre siamo bendati.
Abbiamo visto che l’SGD e il GD classico differiscono per la quantità di punti dati usati negli aggiornamenti dei parametri. Per consolidare l’intuizione e chiarire i dettagli matematici, abbiamo implementato l’SGD in Numpy.
Ricorda che l’SGD è solo una parte dell’intero processo di training di ML. Per saperne di più sul suo ruolo, dai un’occhiata alle seguenti risorse:
I migliori corsi DataCamp
Programma
Programma
Programma
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



