
Cursus
Chercheur en apprentissage automatique en Python
85 h
Imaginez que vous cherchiez le point le plus bas parmi des collines, les yeux bandés. Avec pour seul repère le toucher, vous ne pouvez sentir que le sol à proximité immédiate pour déterminer la pente descendante. C’est exactement ce que font les algorithmes de machine learning lorsqu’ils cherchent la meilleure solution à un problème.
Ils traduisent le problème en une fonction mathématique dont les entrées et sorties représentent une surface vallonnée. Trouver le minimum de cette fonction revient à atteindre la meilleure solution. L’un des algorithmes les plus utilisés pour y parvenir est la descente de gradient stochastique (SGD, pour Stochastic Gradient Descent).
Dans ce tutoriel, vous allez découvrir tout ce qu’il faut savoir sur l’algorithme : une intuition de départ sans formules, les détails mathématiques, puis une implémentation en Python.
La descente de gradient stochastique (SGD) est une technique d’optimisation utilisée en machine learning pour minimiser les erreurs des modèles prédictifs. Contrairement à la descente de gradient « classique », qui utilise l’ensemble du jeu de données pour calculer le gradient et mettre à jour les paramètres, SGD met à jour les paramètres à partir d’un seul point de données à la fois. C’est plus rapide et plus efficace sur de grands jeux de données, mais plus bruité et moins stable. SGD aide à trouver des valeurs optimales des paramètres afin d’améliorer la précision des prédictions.
Première mise au point : la descente de gradient stochastique (SGD) n’est pas un algorithme de machine learning. C’est une technique d’optimisation qui s’applique à des algorithmes de ML.
Alors, qu’entend-on par optimisation ? Pour le comprendre, repartons de l’énoncé du problème en machine learning.
Supposons que nous voulions prédire le prix des diamants en fonction de leur poids en carats (1 carat = 0,2 gramme). C’est un problème de régression, car le modèle produit des valeurs numériques.
Pour le résoudre, nous disposons de nombreux algorithmes, mais choisissons la régression linéaire simple, avec la formule f(x) = mx + b où :
b est le prix de base du diamantm est l’augmentation de prix par caratx est la valeur en carats du diamantf(x) est le prix prédit du diamantCette équation linéaire représente notre modèle. Notre objectif est de trouver les meilleures valeurs de m et b pour obtenir des prédictions aussi justes que possible sur l’ensemble des diamants du jeu de données.
Si nous ajoutons une autre caractéristique, comme le volume du diamant, la formule devient f(x1, x2) = m1*x1 + m2*x2 + b, où :
b est le prix de base du diamantm1 est l’augmentation de prix par caratm2 est l’augmentation de prix par unité de volumex1 est la valeur en carats du diamantx2 est le volume du diamantf(x) est le prix prédit du diamantNous devons maintenant trouver les valeurs optimales de m1, m2 et b.
De manière générale, tous les modèles de machine learning s’expriment par des équations similaires, avec un ou plusieurs paramètres. Dans ce contexte, l’optimisation consiste donc à « Trouver, pour un modèle et un jeu de données donnés, les valeurs optimales des paramètres de l’équation. »
Il existe de nombreux algorithmes d’optimisation capables d’effectuer cette tâche, dont la descente de gradient stochastique, qui est au cœur de ce tutoriel. Pour bien comprendre le fonctionnement de SGD, passons d’abord par quelques notions fondamentales.
Pour comprendre SGD, il faut d’abord voir la descente de gradient classique (GD), qui partage ses idées fondamentales. La descente de gradient simple commence par la notion d’erreur en machine learning.
Les algorithmes de ML proposent généralement une réponse supposée correcte à un problème. On appelle cela une prédiction, et elle n’est pas toujours exacte. On introduit donc la notion d’« erreur » ou de « perte », qui représente l’écart entre la valeur réelle et la prédiction du modèle. Notre objectif est de construire un modèle qui minimise cette erreur.
Si notre modèle f(x) prédit 10 000 $ pour un diamant qui en vaut 12 000 $, l’erreur est de 2 000 $. Il faut ajuster le modèle pour réduire cette erreur. Mais les prédictions doivent être bonnes sur l’ensemble des diamants, pas sur un seul. Nous avons donc besoin d’agréger les erreurs de tous les diamants du jeu de données. C’est le rôle des fonctions de coût.
Une fonction de coût combine toutes les erreurs individuelles en un seul nombre qui représente la performance globale du modèle. Plus le coût global est faible, meilleures sont les prédictions du modèle.
Les fonctions de coût varient selon le type de problème traité.
En régression, le modèle prédit des valeurs numériques, comme le prix d’un diamant ou le temps pour nager une longueur. En classification, il prédit la catégorie d’appartenance : par exemple, un champignon est-il comestible ou non ? L’objet sur l’image est-il un chat, un chien ou un cheval ?
Il existe d’autres types de problèmes, mais l’essentiel est que chacun requiert des fonctions de coût différentes. Dans ce tutoriel, nous nous concentrerons sur l’erreur quadratique moyenne (MSE), très utilisée en régression.
La différence entre les valeurs réelles (vérité terrain) et les prédictions du modèle s’appelle une erreur ou une perte. Par conséquent, une fonction qui agrège toutes ces erreurs est appelée fonction d’erreur, loss function ou fonction de coût. Les sources utilisent ces termes de manière interchangeable ; dans ce tutoriel, nous emploierons désormais « loss function ».
En régression, on visualise souvent un graphique opposant valeurs réelles et prédictions du modèle.
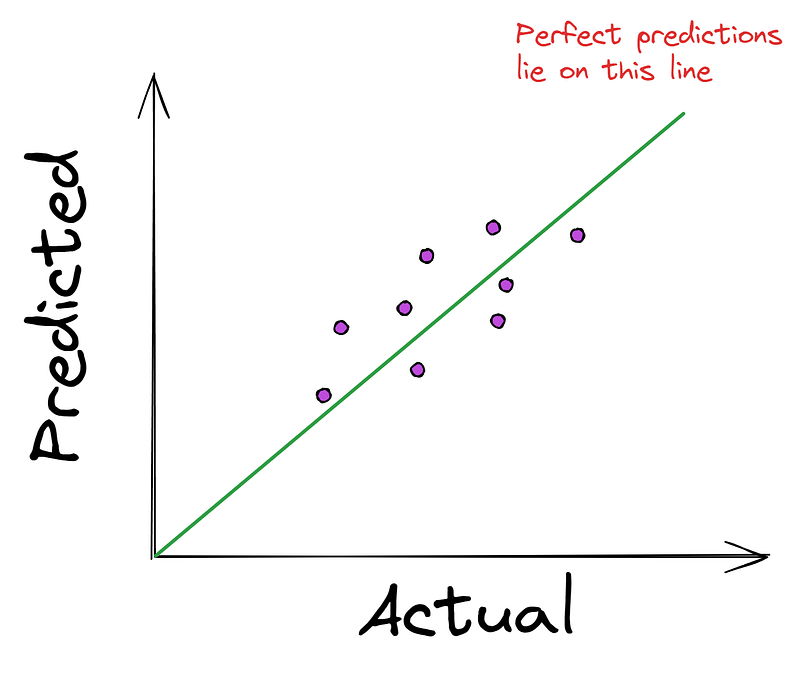
Plus les points sont proches de la ligne droite, meilleures sont les prédictions. La plupart des algorithmes de régression cherchent donc à minimiser la distance moyenne entre les points et la ligne parfaite, via une fonction de coût comme la MSE.
La MSE prend en entrée les valeurs réelles et prédites et renvoie la distance quadratique moyenne à la ligne parfaite.
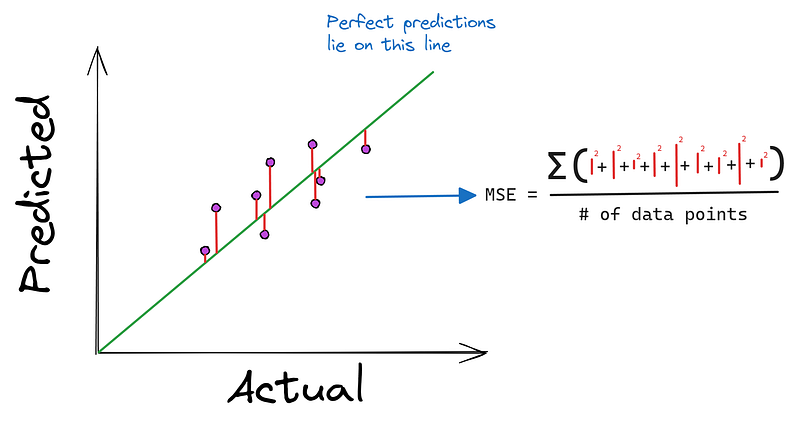
Vous vous demandez peut‑être : « Pourquoi élever au carré plutôt que prendre la valeur absolue ? ». Premièrement, la dérivée d’une fonction carrée est très simple à obtenir. Ensuite, le carré accentue les grosses erreurs, pénalisant davantage les pires prédictions.
C’est pourquoi la MSE est souvent préférée à d’autres fonctions comme l’erreur absolue moyenne (MAE), plus simple en apparence mais plus difficile à dériver.
Prochaine pièce du puzzle : le gradient lui‑même. Revenons à l’analogie de la colline pour mieux le saisir.
Les yeux bandés au sommet, vous voulez atteindre le bas le plus vite possible. Si vous versez de l’eau à vos pieds, dans quel sens coule‑t‑elle ? Dans la direction de la descente la plus raide.
C’est exactement ce qu’indique le gradient, mais à l’inverse : il pointe vers le haut — dans la direction de la montée la plus raide. Quand on cherche à minimiser l’erreur, on va simplement à l’opposé du gradient pour descendre le plus rapidement.
Mathématiquement, le gradient indique comment la sortie d’une fonction varie lorsque l’on fait varier ses entrées. Plus précisément, il donne la direction d’accroissement le plus rapide.
Dans le contexte du machine learning, où l’on cherche à réduire l’erreur à l’aide d’une fonction de perte, le gradient devient notre boussole pour trouver la voie la plus rapide de réduction de cette erreur.
Le gradient est un vecteur — une composante par paramètre d’entrée de la fonction. Chaque valeur du vecteur indique de combien la fonction changerait si l’on ajustait légèrement le paramètre correspondant.
Comment calcule‑t‑on le gradient d’une fonction ?
Pour une fonction à une variable comme f(x) = x ** 2, le gradient est la dérivée, donnée par un vecteur à un élément : [2x].
Pour une fonction multivariée comme f(x1, x2) = x1 ** 3 - x2 ** 2, le gradient contient les dérivées partielles par rapport à chaque entrée. Pour cette fonction, le vecteur gradient est donc [3x1 ** 2, 2*x2].
Revenons à la MSE, dont la formule est :
MSE = (1/n) * Σ(y - f(x))² où :
f(x) vaut mx + bm et b sont les variablesx est la valeur en carats des diamantsn est le nombre de pointsy est le prix réel des diamantsSon gradient correspond donc aux dérivées partielles de la MSE par rapport à m et b :
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
The gradient = [∂/∂m (MSE), ∂/∂b (MSE)]
Pas d’inquiétude si ces formules vous semblent arides. L’idée clé est qu’elles indiquent comment la MSE varie quand on modifie très légèrement m ou b.
Nous avons tout ce qu’il faut pour exécuter la descente de gradient, autrement dit pour atteindre le bas de la colline le plus efficacement possible. Faut‑il sauter dans cette direction ou avancer par petits pas ? On pourrait se dire que la taille du gradient suffit. Mais si le gradient est si grand qu’au lieu d’atteindre le bas, on le dépasse et on finit au sommet d’une autre colline en un seul pas ? Étonnamment, cela arrive souvent. On introduit donc un paramètre, la taille de pas, qui atténue l’effet du gradient.
Avant chaque mise à jour, on multiplie simplement le gradient par la taille de pas, ce qui réduit son amplitude. Par exemple, si le gradient suggère un pas de 3,56 vers le bas, un pas de 0,1 le ramène à 0,356.
Il faudra plus de temps pour atteindre le minimum, mais on limite le risque de le « sauter » complètement.
En machine learning, la taille de pas s’appelle le taux d’apprentissage et prend typiquement des valeurs entre 0,001 et 0,3.
Voyons la version mathématique du processus.
On commence par donner des valeurs aléatoires aux paramètres m et b du modèle :
m = 0.215  # Generated randomly
b = 0.059
Avec celles‑ci, on calcule la MSE initiale sur l’ensemble du jeu de données :
MSE = (1/n) * Σ(y - (0.215 * x + 0.059))² = ...Pour réduire cette erreur, on fait un petit pas dans la direction opposée au gradient, autrement dit on met à jour m et b à l’aide du gradient et du taux d’apprentissage :
m_new = 0.215 - alpha * (∂/∂m (MSE))
b_new = 0.059 - alpha * (∂/∂b (MSE))
La plupart des ressources notent le taux d’apprentissage par alpha ou α (lettre grecque).
Une fois m et b mis à jour, on recalcule la MSE :
MSE_new = (1/n) * Σ(y - (m_new * x + b_new))²On recalcule alors le gradient et on poursuit ainsi jusqu’à un critère d’arrêt.
Visualisez l’effet du taux d’apprentissage sur l’entraînement en consultant cet article sur la descente de gradient.
Les yeux bandés, difficile de savoir si l’on a atteint le bas, surtout à petits pas.
Il faut donc des conditions d’arrêt. Typiquement :
Ces règles sont définies par vous, l’ingénieur ML. Les implémentations Python prévoient généralement des paramètres pour les configurer — nous en verrons plus loin.
Avantages :
Défis :
Dans la section suivante, nous verrons comment la descente de gradient stochastique répond à certains de ces défis, notamment sur les grands jeux de données.
Une fois la descente de gradient classique comprise, SGD devient très simple à appréhender.
Aussi élégante soit‑elle, la descente de gradient classique montre ses limites avec de grands jeux de données. À chaque pas, on calcule le gradient à partir de tous les points du jeu :
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
Ici, x et y sont des tableaux contenant toutes les valeurs en carats et tous les prix réels. Cela signifie qu’à chaque mise à jour, on utilise l’information de chaque diamant.
Comme vous l’imaginez, c’est coûteux en calcul et chronophage quand on a des millions de points. À l’ère du big data, cette contrainte rend la descente classique peu pratique pour de nombreux cas d’usage réels.
« Stochastique » signifie « déterminé aléatoirement » ; c’est exactement ce que fait SGD : elle introduit de l’aléa dans l’optimisation.
Au lieu d’utiliser tous les points pour calculer le gradient, SGD sélectionne aléatoirement un point à chaque pas. Elle utilise ce seul point pour estimer le gradient et mettre à jour les paramètres.
Parce qu’elle ne regarde qu’un point à la fois, SGD peut mettre à jour les paramètres plus fréquemment. Elle parcourt donc la surface d’erreur (la colline) plus vite, surtout sur de grands jeux de données.
Cette vitesse a un coût : l’estimation du gradient à partir d’un seul point est très bruitée. Le chemin de descente est donc moins lisse et plus erratique.
Pour exécuter SGD, on définit d’abord une fonction de coût stochastique.
Au lieu de calculer la MSE sur tous les points, on considère l’erreur au carré pour un point choisi aléatoirement :
Cost = (y - f(x))²où y est le prix réel du diamant choisi, et f(x) = mx + b notre prix prédit.
Ensuite, on calcule le gradient stochastique de cette fonction de coût par rapport à m et b :
∂/∂m (Cost) = -2x(y - (mx + b))
∂/∂b (Cost) = -2(y - (mx + b))
The stochastic gradient = [∂/∂m (Cost), ∂/∂b (Cost)]
À l’aide de ce gradient stochastique, on met à jour les paramètres comme en descente de gradient classique :
m_new = m_old - learning_rate * ∂/∂m (Cost)
b_new = b_old - learning_rate * ∂/∂b (Cost)
L’idée clé de SGD : à chaque pas, on utilise un unique point de données choisi aléatoirement. Les règles d’arrêt restent identiques à la descente classique.
En pratique, le SGD « pur », avec mise à jour à chaque exemple, est rarement utilisé. Les mises à jour sont trop variables, la fonction de perte fluctue et la convergence vers le minimum exact est plus difficile.
La descente de gradient « batch » est plus stable, mais elle exploite tous les points à chaque pas, ce qui la rend peu réaliste avec les jeux actuels.
Pour trouver un bon compromis entre stabilité et vitesse, on utilise fréquemment la descente de gradient en mini‑lots, notamment pour les réseaux de neurones. Au lieu d’un seul échantillon, on met à jour les paramètres à partir d’un lot d’exemples. Les tailles de lot courantes sont 16, 32, 64, etc.
Ainsi, une taille de lot de 1 correspond à SGD. Une taille égale à la taille du jeu de données correspond à la descente de gradient « batch ». Toute autre taille donne la descente en mini‑lots.
Voici un tableau récapitulatif de leurs différences et cas d’usage :
| Type | Fréquence de mise à jour | Efficacité de calcul | Besoins mémoire | Stabilité de convergence | Meilleur cas d’usage |
| Gradient Descent (GD) | Jeu de données entier par mise à jour | La plus lente (utilise tout le jeu de données) | Nécessite tout le jeu en mémoire | La plus stable, mais la plus lente | Petits jeux où la stabilité prime |
| Stochastic Gradient Descent (SGD) | Un exemple par mise à jour | La plus rapide, traite un exemple à la fois | Besoin mémoire faible | Variance élevée, fluctuations possibles | Grands jeux nécessitant des mises à jour rapides |
| Mini-Batch Gradient Descent | Lot d’exemples par mise à jour | Compromis vitesse/efficacité, plus efficace que GD, plus lente que SGD | Mémoire pour un lot | Plus stable que SGD, moins que GD | Grands jeux nécessitant un équilibre stabilité/efficacité |
Concept essentiel de tout algorithme d’optimisation : une époque correspond à un passage complet sur l’ensemble des données d’entraînement.
Durant une époque, l’algorithme traite chaque échantillon exactement une fois. Pour chaque échantillon (ou mini‑lot), le modèle effectue une prédiction, calcule la perte et met à jour les poids selon le gradient de la perte. Une époque marque un cycle d’amélioration du modèle. Après chaque époque, on peut généralement mesurer les progrès réalisés.
L’entraînement comporte généralement plusieurs époques (au moins 10 recommandées). Le nombre d’époques est un hyperparamètre à ajuster. On mélange souvent les données avant chaque époque pour éviter que le modèle n’apprenne l’ordre des exemples.
Dans notre analogie de la colline, une époque correspond à une exploration complète du paysage. À chaque époque, vous :
Après chaque exploration complète, vous repartez de votre nouvelle position. Plusieurs époques offrent au modèle des occasions répétées d’explorer le paysage de perte, améliorant ses chances de trouver un bon minimum.
Cependant, plusieurs époques ne garantissent pas de trouver le minimum global, et le processus dépend de facteurs comme le point de départ ou la complexité du paysage de perte.
Dans cette section, nous implémentons SGD avec prise en charge de la taille de lot (mini‑batch GD) en utilisant uniquement Numpy.
Commençons par importer les bibliothèques nécessaires :
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
Nous utiliserons 10 000 points issus du jeu Diamonds de Seaborn. Nous prendrons uniquement la caractéristique carat et la colonne price comme cible :
# Load the data
dataset_size = 10_000
diamonds = sns.load_dataset('diamonds')
# Extract the target and the feature
xy = diamonds[['carat', 'price']].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
(10000, 2)
Scindons ensuite les données en entraînement et test, avec 80 % pour l’entraînement.
# Split the data
np.random.shuffle(xy)
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(8000, 2)
Définissons ensuite la fonction de modèle :
def model(m, x, b):
   """Simple linear model"""
   return m * x + b
Nous faisons une régression linéaire simple avec deux variables indépendantes seulement : m et b.
Définissons aussi notre fonction de perte MSE :
def loss(y_true, y_pred):
   """Mean squared error"""
   return np.mean((y_true - y_pred) ** 2)
Créons maintenant une fonction stochastic_gradient_descent qui prend six arguments :
x et y représentent l’unique variable et la cibleepochs indique le nombre de passages d’entraînement (nous y revenons)learning_rate est la taille de pasbatch_size contrôle la fréquence des mises à jourstopping_threshold fixe la baisse minimale de perte attendue à chaque pasdef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""Pour démarrer, on initialise aléatoirement les paramètres à optimiser et on met la perte à l’infini :
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infOn lance ensuite une boucle for sur le nombre d’époques. À l’intérieur, on mélange les données pour rendre les calculs plus robustes :
for i in range(epochs):
# Shuffle the data
indices = np.random.permutation(n)
x = x[indices]
y = y[indices]Le calcul effectif du gradient se fait dans une seconde boucle for.
for j in range(0, n, batch_size):
x_batch = x[j:j + batch_size]
y_batch = y[j:j + batch_size]On extrait le lot de x et y et on calcule les gradients :
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)On utilise la fonction model définie plus haut pour prédire avec les valeurs courantes de m et b, puis on calcule les dérivées partielles composant le gradient, selon la formule vue plus tôt.
À partir de ces dérivées et du taux d’apprentissage, on met à jour les paramètres :
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientVoici le code complet à ce stade :
def stochastic_gradient_descent(
   x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
   """
   SGD with support for mini-batches.
   """
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x)
previous_loss = np.inf
for i in range(epochs):
   # Shuffle the data
   indices = np.random.permutation(n)
   x = x[indices]
   y = y[indices]
for j in range(0, n, batch_size):
   x_batch = x[j:j + batch_size]
   y_batch = y[j:j + batch_size]
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientEn continuant la fonction après la boucle interne, on calcule la perte pour l’époque :
# Compute the loss
y_pred = model(m, x, b)
current_loss = loss(y, y_pred)
Si la current_loss est inférieure au stopping_threshold, on arrête tout le processus :
if previous_loss - current_loss < stopping_threshold:
   break
previous_loss = current_loss
Sinon, on met previous_loss à current_loss. Enfin, on renvoie les paramètres m et b optimisés :
return m, bJ’ai déposé l’intégralité du code dans ce gist GitHub pour que vous puissiez le consulter d’un bloc.
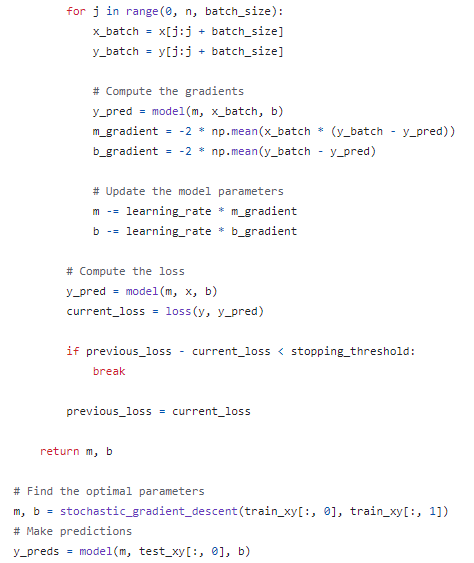
Testons la qualité des paramètres trouvés en exécutant le modèle sur le jeu de test :
# Find the optimal parameters
m, b = stochastic_gradient_descent(train_xy[:, 0], train_xy[:, 1])
# Make predictions
y_preds = model(m, test_xy[:, 0], b)
# Compute and print the loss
mean_squared_error = loss(test_xy[:, 1], y_preds)
mean_squared_error ** 0.5
1595.3955619759456
La racine de la MSE est d’environ 1 600 $, ce qui signifie que notre modèle se trompe en moyenne de 1 600 $. Pour améliorer l’erreur, on peut augmenter le nombre d’époques ou utiliser un jeu de données plus large.
L’implémentation de SGD de la section précédente est volontairement simple et peu efficace. Elle sert à ancrer l’intuition acquise via un pas à pas de code.
En pratique, vous ne réimplémentez presque jamais SGD à la main ; vous utilisez les versions éprouvées des frameworks populaires.
Par exemple, Scikit-learn propose les estimateurs SGDRegressor et SGDClassifier pour entraîner divers algorithmes tels que :
avec SGD comme algorithme d’optimisation.
from sklearn.linear_model import SGDRegressor, SGDClassifier
# SGD for Linear Regression with 1000 epochs
regressor = SGDRegressor(loss='squared_loss', max_iter=1000)
Dans PyTorch, il est disponible via la classe SGD du module optim :
import torch.optim as optim
optimizer = optim.SGD(model.parameters(), lr=0.01)
Pour apprendre à entraîner et optimiser des modèles avec PyTorch, consultez le cours Introduction to PyTorch de DataCamp.
Dans Keras, SGD est disponible sous le même nom :
from tensorflow.keras.optimizers import SGD
optimizer = SGD(learning_rate=0.01)
Pour apprendre à entraîner et optimiser des modèles avec TensorFlow, consultez le cours Introduction to TensorFlow de DataCamp.
Voici plusieurs bonnes pratiques et astuces pour SGD et algorithmes proches :
Nous avons découvert aujourd’hui un algorithme d’optimisation clé en machine learning : la descente de gradient stochastique.
Nous avons d’abord construit l’intuition et les idées fondamentales via la descente de gradient classique, en filant l’analogie de la colline descendue les yeux bandés.
Nous avons vu que SGD et GD diffèrent par la quantité de données utilisée à chaque mise à jour de paramètres. Pour ancrer l’intuition et détailler les aspects mathématiques, nous avons implémenté SGD en Numpy.
Gardez à l’esprit que SGD n’est qu’une pièce du puzzle de l’entraînement ML. Pour approfondir son rôle, consultez :
Les meilleurs cours DataCamp
Cursus
Cursus
Cursus