
Program
Makine Öğrenimi Bilimcisi Python'da
85 sa
Gözleriniz bağlıyken tepeler arasında en alçak noktayı bulmaya çalıştığınızı hayal edin. Dokunuşla sınırlı olduğunuz için, aşağı yönü belirlemek adına yalnızca hemen çevrenizdeki zemini hissedebilirsiniz. Makine öğrenmesi algoritmaları, bir probleme en iyi çözümü bulmaya çalışırken özünde tam olarak bunu yapar.
Problemi, girdileri ve çıktıları engebeli bir yüzeyi temsil eden bir matematiksel fonksiyona dönüştürürler. Bu fonksiyonun minimumunu bulmak, probleme en iyi çözümü bulduğunuz anlamına gelir. Bu süreci gerçekleştirmek için en popüler algoritmalardan biri Stokastik Gradyan İnişi’dir (SGD).
Bu öğreticide, matematiğe girmeden önce sezgisel bir giriş, matematiksel ayrıntılar ve Python’da nasıl uygulanacağı da dahil olmak üzere algoritma hakkında bilmeniz gereken her şeyi öğreneceksiniz.
Stokastik Gradyan İnişi (SGD), makine öğrenmesinde tahmin modellerindeki hataları en aza indirmek için kullanılan bir optimizasyon tekniğidir. Tam gradyan inişinin, gradyanı hesaplamak ve model parametrelerini güncellemek için tüm veri setini kullanmasının aksine, SGD parametreleri her seferinde yalnızca tek bir veri noktasıyla günceller. Bu, özellikle büyük veri setlerinde daha hızlı ve verimli olmasını sağlar; ancak daha gürültülü ve daha az kararlı olabilir. SGD, model parametreleri için en iyi değerleri bularak tahminlerin doğruluğunu artırmaya yardımcı olur.
Öncelikle şunu netleştirelim: stokastik gradyan inişi (SGD) bir makine öğrenmesi algoritması değildir. Daha ziyade, ML algoritmalarına uygulanabilen bir optimizasyon tekniğidir.
Peki optimizasyon nedir? Bunu anlamak için, makine öğrenmesinde problem tanımı aşamasından başlayalım.
Diyelim ki elmas fiyatlarını karat değerine göre tahmin etmeye çalışıyoruz (bir karat 0,2 gramdır). Model sayısal değerler ürettiği için bu bir regresyon problemidir.
Problemi çözmek için elimizde birçok algoritma var; ancak Basit Doğrusal Regresyonu seçelim. Basit formülü f(x) = mx + b olan bu modelde:
b temel elmas fiyatıdırm karat başına fiyat artışıdırx elmasın karat değeridirf(x) elmasın tahmini fiyatıdırBu doğrusal denklem modelimizi temsil eder. Amacımız, veri setimizdeki tüm elmaslar için tahminlerimizi olabildiğince doğru kılacak m ve b değerlerini bulmaktır.
Veri setimizde elmas hacmi gibi başka bir özellik daha olsaydı, formülümüz f(x1, x2) = m1*x1 + m2*x2 + b şeklinde değişirdi. Burada:
b temel elmas fiyatıdırm1 karat başına fiyat artışıdırm2 birim hacim başına fiyat artışıdırx1 elmasın karat değeridirx2 elmasın hacmidirf(x) elmasın tahmini fiyatıdırŞimdi, m1, m2 ve b için en uygun değerleri bulmamız gerekecektir.
Genel olarak, tüm makine öğrenmesi modellerinde, yukarıdakilere benzer ve bir veya daha fazla parametre içeren denklemler bulunur. Dolayısıyla, bu bağlamda optimizasyonun tanımı şu olur: “Bu model ve bu veri seti verildiğinde, denklemdeki parametreler için en uygun değerleri bul.”
Bu görevi yerine getirebilen birçok optimizasyon algoritması vardır; öğretimizin odağı olan Stokastik Gradyan İnişi de bunlardan biridir. Ancak SGD’nin nasıl çalıştığını tam olarak anlamak için arkasındaki bazı temel fikirleri gözden geçirelim.
SGD’yi anlamak için, stokastik sürümüyle birçok temel fikri paylaşan klasik gradyan inişi (GD) algoritmasını öğrenmemiz gerekir. Basit gradyan inişi, makine öğrenmesindeki hata kavramıyla başlar.
ML algoritmaları genellikle bir problemin doğru cevabını tahmin eder. Bu cevaba tahmin deriz ve her zaman doğru olmayabilir. Bu nedenle, gerçek cevap ile modelin tahmini arasındaki farkı temsil eden “hata” veya “kayıp” adlı yeni bir terim kullanırız. Amacımız bu hatayı en aza indiren bir model kurmaktır.
Modelimiz f(x) gerçek fiyatı 12.000 $ olan bir elmas için 10.000 $ tahmin ederse, hata 2.000 $’dır. Bu hatayı azaltmak için modelimizi ayarlamalıyız. Fakat modelin tahminlerinin yalnızca tek bir elmas için değil, tüm elmaslar için iyi olması gerekir. Bu yüzden veri setimizdeki tüm elmaslar için hatayı birleştirecek bir yönteme ihtiyaç duyarız. Burada devreye maliyet fonksiyonları girer.
Bir maliyet fonksiyonu, tüm bireysel hataları modelimizin genel performansını temsil eden tek bir sayıda toplar. Daha düşük toplam maliyet, modelimizin tahminlerinin daha iyi olduğu anlamına gelir.
Maliyet fonksiyonları, çözdüğümüz problem türüne göre değişir.
Regresyon problemlerinde, model bir elmasın ne kadara mal olduğu ya da bir turun ne kadar sürede yüzüldüğü gibi sayısal değerleri tahmin eder. Sınıflandırmada ise model bir şeyin hangi kategoriye ait olduğunu tahmin eder. Örneğin bir mantar yenilebilir mi, ya da görüntüdeki nesne bir kedi, köpek veya at mı?
Başka problem türleri de vardır; ancak önemli olan nokta, her birinin farklı maliyet fonksiyonları gerektirmesidir. Bu öğreticide, regresyonda sıklıkla kullanılan Ortalama Kare Hataya (MSE) odaklanacağız.
Gerçek değerler (ground truth) ile modelin tahminleri arasındaki farka hata veya kayıp denir. Dolayısıyla, bu hata veya kayıpların tümünü birleştiren bir fonksiyon da hata fonksiyonu, kayıp fonksiyonu veya maliyet fonksiyonu olarak adlandırılır. Farklı kaynaklar bu terimleri birbirinin yerine kullanabilir; bu öğreticide bundan sonra kayıp fonksiyonu terimini kullanacağız.
Regresyon problemlerinde, gerçek değerleri (ground truth) modelin tahminlerine karşı çizen şu grafiği görmek yaygındır.
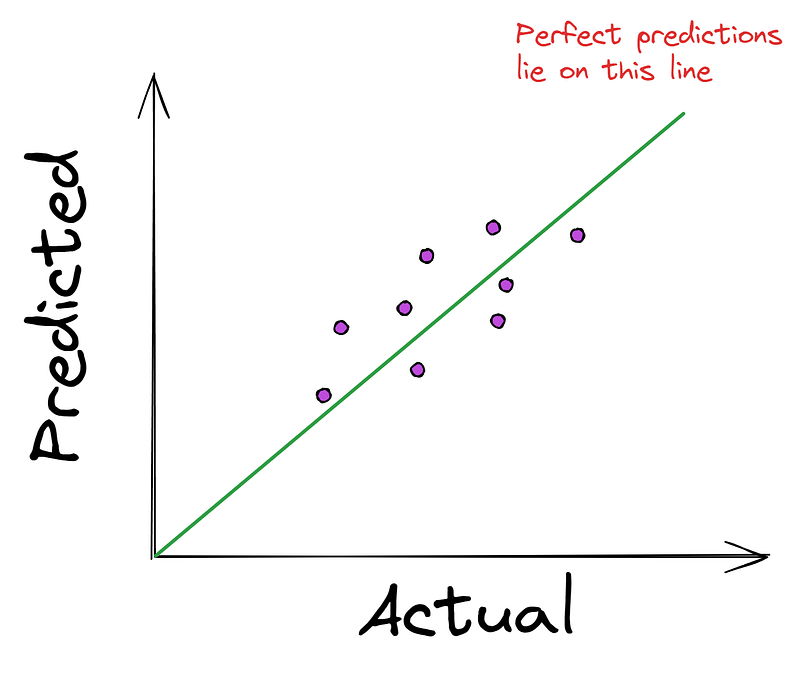
Noktalar düz çizgiye ne kadar yakınsa, model tahminleri o kadar iyidir. Bu nedenle, çoğu regresyon algoritması noktaların mükemmel çizgiye olan ortalama uzaklığını en aza indirmeye çalışır. Ve daha önce belirttiğimiz gibi, bu minimizasyon, Ortalama Kare Hata (MSE) gibi bir maliyet fonksiyonu kullanılarak yapılır.
MSE, girdi olarak gerçek ve tahmini değerleri alır ve mükemmel çizgiye olan karesel ortalama uzaklığı üretir.
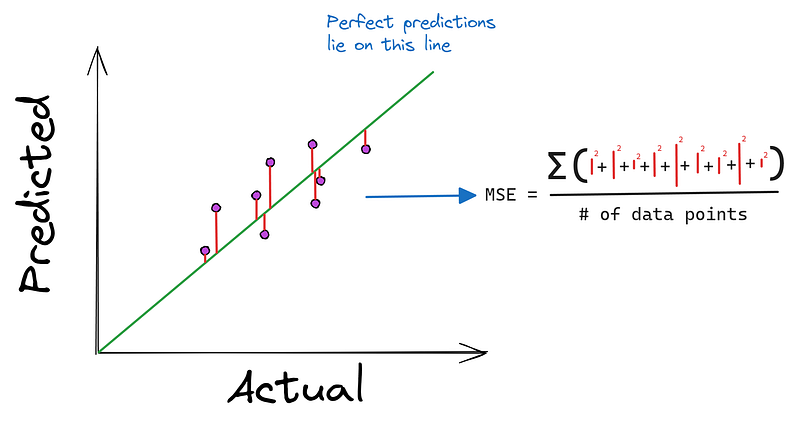
“Neden farkların mutlak değerini almak yerine karesini alıyoruz?” diye sorabilirsiniz. İlk neden, kare fonksiyonunun türevinin çok kolay bulunmasıdır. Ayrıca farkların karesini almak, büyük hataları daha fazla vurgular ve modelin en kötü tahminlerini daha çok cezalandırır.
Bu yüzden, yüzeyde daha basit görünen ancak türevi almak daha zor olan Ortalama Mutlak Hata (MAE) gibi alternatif fonksiyonlara kıyasla MSE tercih edilir.
Gradyan inişi bulmacasındaki bir sonraki parça, bizzat gradyanın kendisidir. Bunu daha iyi anlamak için “yokuş aşağı” benzetmesine geri dönelim.
Gözlerimiz bağlıyken tepenin zirvesinde duruyor ve olabildiğince hızlı bir şekilde tabana ulaşmak istiyoruz. Ayaklarımızın dibine su döksek, hangi yöne akardı? En dik iniş yönünde aşağı doğru akardı.
Gradyan tam olarak bunu söyler, ama ters yönde. Gradyan yokuş yukarıyı — en dik çıkış yönünü — işaret eder. Hata değerini en aza indirmeye çalışırken, en hızlı şekilde aşağı inmek için basitçe gradyanın ters yönüne gideriz.
Matematiksel olarak, gradyan bir fonksiyonun çıktılarının, girdilerini değiştirdiğimizde nasıl değiştiğini söyler. Daha spesifik olarak, fonksiyonun en hızlı arttığı yönü gösterir.
Makine öğrenmesi bağlamında, bir kayıp fonksiyonu kullanarak hatayı en aza indirmeye çalıştığımızda, gradyan bu hatayı en hızlı azaltma yolunu bulmamızda rehberimiz olur.
Gradyan bir vektörle temsil edilir — fonksiyonumuzun her bir girdi parametresi için bir tane. Bu vektördeki her sayı, ilgili parametreyi küçük bir miktar ayarlarsak fonksiyonun ne kadar değişeceğini söyler.
Peki bir fonksiyonun gradyanı nasıl bulunur?
Tek değişkenli fonksiyonlar için, örneğin f(x) = x ** 2, gradyan fonksiyonun türevidir ve tek öğeli bir vektör olarak verilir - [2x].
Çok değişkenli fonksiyonlar için, örneğin f(x1, x2) = x1 ** 3 - x2 ** 2, gradyan fonksiyonun her girdi değişkenine göre kısmi türevlerini içerir. Dolayısıyla ikinci fonksiyon için gradyan vektörü [3x1 ** 2, 2*x2] olur.
Aşağıdaki formüle sahip olan MSE’ye geri dönelim:
MSE = (1/n) * Σ(y - f(x))² burada:
f(x) mx + b’dirm ve b fonksiyon değişkenleridirx elmasların karat değeridirn veri noktası sayısıdıry elmasların gerçek fiyatıdırDolayısıyla gradyanı, MSE’nin m ve b’ye göre kısmi türevleridir:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
The gradient = [∂/∂m (MSE), ∂/∂b (MSE)]
Bu formüller için çok endişelenmeyin. Asıl fikir, m veya b’yi çok az değiştirirsek, ortalama kare hatanın nasıl değiştiğini bize söylemeleridir.
Artık gradyan inişini, yani başka bir deyişle mümkün olduğunca verimli şekilde tepenin dibine ulaşmayı gerçekleştirmek için gereken her şeye sahibiz. Peki o yöne doğru sıçrayalım mı, yoksa küçük adımlar mı atalım? Bunu gradyan belirler, değil mi? Gradyanın büyüklüğü, her adımda ne kadar aşağı ineceğimizi söyler.
Ama gradyan o kadar büyük olabilir ki, dibe ulaşmak yerine tek bir adımda aşırıya kaçar ve kendimizi başka bir tepenin üstünde buluruz. Şaşırtıcı bir şekilde, bu durum gradyan inişinde sık görülür; bu yüzden gradyanın etkilerini kontrol eden adım boyutu adlı bir parametre tanımlarız.
Adım atmadan önce, gradyanı adım boyutuyla çarparız; bu da büyüklüğünü azaltır. Örneğin, gradyan bize 3,56 birim yokuş aşağı adım atmamızı söylüyorsa, 0,1’lik bir adım boyutu bu mesafeyi 0,356’ya çevirir.
Dibe ulaşmak daha uzun sürer ama artık tamamen atlama riskimiz olmaz.
Makine öğrenmesinde adım boyutuna genellikle öğrenme oranı denir ve tipik olarak 0,001 ile 0,3 arasında değerler alır.
Şimdi bu sürecin matematiksel haline bakalım.
Önce modelimizin m ve b parametrelerine rastgele değerler veririz:
m = 0.215  # Generated randomly
b = 0.059
Bunları kullanarak, tüm veri seti üzerinde başlangıç MSE’sini hesaplarız:
MSE = (1/n) * Σ(y - (0.215 * x + 0.059))² = ...Şimdi, bu hatayı azaltmak için, gradyanın ters yönünde küçük bir adım atmamız gerekir; başka bir deyişle, gradyanı ve öğrenme oranını kullanarak m ve b’yi güncellememiz gerekir:
m_new = 0.215 - alpha * (∂/∂m (MSE))
b_new = 0.059 - alpha * (∂/∂b (MSE))
Kaynakların çoğu öğrenme oranını göstermek için alpha veya α (Yunan harfi) sembolünü kullanır.
Yeni m ve b değerlerini bulduktan sonra MSE’yi tekrar hesaplarız:
MSE_new = (1/n) * Σ(y - (m_new * x + b_new))²Ardından gradyanı tekrar hesaplar ve bir durdurma koşuluna ulaşana kadar bu şekilde devam ederiz.
Öğrenme oranının eğitimi görsel olarak nasıl etkilediğini görmek için bu gradyan inişi makalesine göz atın.
Gözlerimiz bağlı olduğu için, özellikle küçük adımlar atarken dibe ulaştığımızı gerçekten göremeyiz.
Bu nedenle inişimizi durdurmak için bazı koşullara ihtiyaç duyarız. Tipik olarak şu kurallar kullanılır:
Bu kuralları, gradyan inişini gerçekleştirirken ML mühendisi olarak siz belirlersiniz. Algoritmanın Python uygulamalarında bu kuralları ayarlamak için genellikle argümanlar bulunur ve bunlardan bazılarını ileride göreceğiz.
Avantajlar:
Zorluklar:
Bir sonraki bölümde, Stokastik Gradyan İnişi’nin özellikle büyük veri setleri için bu zorlukların bazılarını nasıl ele aldığını göreceğiz.
Klasik gradyan inişini kavradığınızda, SGD’yi anlamak çok daha kolay hale gelir.
Gradyan inişi en zarif optimizasyon algoritmalarından biri olsa da, büyük veri setleriyle çalışırken önemli bir dezavantajı vardır. Her adımda, gradyanı veri setimizdeki tüm veri noktalarını kullanarak hesapladığımızı unutmayın:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
Burada, x ve y elmasların tüm karat değerlerini ve gerçek fiyatlarını içeren dizilerdir. Bu, her adımda parametreleri güncellemek için her bir elmasın bilgisini kullanacağımız anlamına gelir.
Tahmin edebileceğiniz gibi, milyonlarca veri noktasına sahip olduğumuzda bu işlem hesaplama açısından pahalı ve zaman alıcı hale gelir. Büyük veri çağında bu sınırlama, birçok gerçek dünya makine öğrenmesi problemi için klasik gradyan inişini pratik olmaktan çıkarabilir.
“Stokastik”, “rastgele belirlenen” anlamına gelir ve SGD tam olarak bunu yapar: optimizasyon sürecimize rastgelelik katar.
Gradyanı hesaplamak için tüm veri noktalarını kullanmak yerine, SGD her adımda rastgele bir veri noktası seçer. Gradyanın bir kestirimini hesaplamak ve parametreleri güncellemek için bu tek noktayı kullanır.
SGD her seferinde yalnızca tek bir veri noktasına baktığından, parametrelere daha sık güncelleme yapabilir. Bu da özellikle büyük veri setlerinde hata yüzeyinde (tepe) daha hızlı ilerlemesini sağlar.
Ancak bu hızın bir bedeli vardır. Tüm veri setinin gradyanını, tek bir veri noktasını kullanarak kestirdiğimiz için, kestirimlerimiz çok daha gürültülüdür. Bu da hata yüzeyindeki yolumuzun daha az düzgün ve daha dalgalı olması anlamına gelir.
SGD uygulamak için önce bir stokastik maliyet fonksiyonu tanımlarız.
Ortalama Kare Hata’yı tüm veri noktaları üzerinde hesaplamak yerine, şimdi rastgele seçilen tek bir nokta için karesel hataya bakarız:
Cost = (y - f(x))²Burada y rastgele seçilen elmasın gerçek fiyatı, f(x) = mx + b ise o elmas için tahmini fiyatımızdır.
Ardından, bu maliyet fonksiyonunun stokastik gradyanını parametrelerimiz olan m ve b’ye göre hesaplarız:
∂/∂m (Cost) = -2x(y - (mx + b))
∂/∂b (Cost) = -2(y - (mx + b))
The stochastic gradient = [∂/∂m (Cost), ∂/∂b (Cost)]
Bu stokastik gradyanı kullanarak, parametrelerimizi klasik gradyan inişindekiyle aynı şekilde güncelleriz:
m_new = m_old - learning_rate * ∂/∂m (Cost)
b_new = b_old - learning_rate * ∂/∂b (Cost)
SGD’deki kilit fikir, her adımın tek bir rastgele seçilmiş veri noktasını içermesidir. İnişi ne zaman durduracağımıza ilişkin kurallar klasik gradyan inişiyle aynıdır.
Uygulamada, parametrelerin her eğitim örneği için güncellendiği sade (vanilla) SGD nadiren kullanılır. Nedeni, güncellemelerin varyansının çok yüksek olması ve bunun da kayıp fonksiyonunun dalgalanmasına yol açarak kesin minimuma yakınsamayı zorlaştırabilmesidir.
Klasik gradyan inişi güçlüdür ve daha istikrarlı sonuçlar verir; ancak daha önce bahsettiğimiz gibi, her adımda tüm veri noktalarını kullanır ve bu da günümüz veri setleri için pratik değildir.
İstikrar ve hız arasında denge kurmak için, özellikle sinir ağlarında mini-batch gradyan inişi sıklıkla kullanılır. Mini-batch GD’de, tek bir rastgele örnek yerine parametre güncellemeleri yapılırken bir küme (batch) örnek kullanılır. Yaygın küme boyutları 16, 32, 64 vb.dir.
Dolayısıyla, küme boyutu 1 ise SGD kullanıyorsunuzdur. Küme boyutunuz veri seti boyutuna eşitse klasik gradyan inişiniz vardır. Bu iki değerin dışındaki herhangi bir küme boyutu size mini-batch gradyan inişi verir.
İşte aralarındaki farkları ve her birini ne zaman kullanmanız gerektiğini özetleyen bir tablo:
| Tür | Güncelleme Sıklığı | Hesaplama Verimliliği | Bellek Gereksinimleri | Yakınsama Kararlılığı | En İyi Kullanım Alanı |
| Gradyan İnişi (GD) | Güncelleme başına tüm veri seti | Tüm veri seti kullanımı nedeniyle en yavaş | Tüm veri setinin bellekte olmasını gerektirir | En kararlı, ancak en yavaş | Kararlılığın kritik olduğu küçük veri setleri |
| Stokastik Gradyan İnişi (SGD) | Güncelleme başına bir örnek | En hızlı, bir seferde tek örnek işler | Düşük bellek gereksinimi | Yüksek varyans, dalgalanabilir | Hızlı güncelleme gerektiren büyük veri setleri |
| Mini-Batch Gradyan İnişi | Güncelleme başına bir örnek kümesi | Verimlilik ve hız arasında denge; GD’den verimli, SGD’den yavaş | Bir küme için bellek gerektirir | SGD’den daha kararlı, GD’den daha az kararlı | Kararlılık ve verimlilik dengesi gerektiren büyük veri setleri |
Her tür optimizasyon algoritmasında önemli bir kavram epoch’tur. Tüm eğitim veri seti üzerinde yapılan bir tam geçişe karşılık gelir.
Bir epoch’ta, algoritma eğitim veri setindeki her örneği tam olarak bir kez işler. Her örnek (veya örnek mini-kümesi) için model tahmin yapar, kaybı hesaplar ve kaybın gradyanına göre ağırlıkları günceller. Bir epoch, model için bir iyileşme döngüsünü ifade eder. Her epoch’tan sonra genellikle modelin performansındaki değişimi gözlemleyebilirsiniz.
Eğitim genellikle birden çok epoch içerir (en az 10 önerilir). Epoch sayısı ayarlanabilir bir hiperparametredir. Çoğu zaman, eğitim örneklerinin sırasını modelin öğrenmesini engellemek için her epoch’tan önce veri karıştırılır.
Gözlerimiz bağlıyken tepe keşfi benzetmemizde, bir epoch tüm manzaranın bir kez keşfedilmesidir. Her epoch sırasında:
Her tam keşiften sonra yeni konumunuzdan yeniden başlarsınız. Birden çok epoch, modelin kayıp manzarasını tekrar tekrar keşfetmesine fırsat sağlar ve iyi bir minimum bulma şansını artırır.
Ancak, birden çok epoch küresel minimumu bulmayı garanti etmez ve tüm süreç başlangıç noktası veya kayıp manzarasının karmaşıklığı gibi faktörlerden etkilenebilir.
Bu bölümde, yalnızca Numpy kullanarak küme boyutunu (mini-batch GD) destekleyen bir SGD uygulayacağız.
Önce gerekli kütüphaneleri içe aktaralım:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
Seaborn’da bulunan Diamonds veri setinden 10.000 veri noktası kullanacağız. Yalnızca carat özelliğini alacak ve price sütununu hedef olarak belirleyeceğiz:
# Load the data
dataset_size = 10_000
diamonds = sns.load_dataset('diamonds')
# Extract the target and the feature
xy = diamonds[['carat', 'price']].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
(10000, 2)
Şimdi verileri eğitim ve test setlerine bölelim; eğitim boyutunu toplamın %80’i olarak ayarlayalım.
# Split the data
np.random.shuffle(xy)
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(8000, 2)
Ardından model fonksiyonumuzu tanımlayalım:
def model(m, x, b):
   """Simple linear model"""
   return m * x + b
Yalnızca iki bağımsız değişken m ve b ile basit doğrusal regresyon yapıyoruz.
Kayıp fonksiyonumuz MSE’yi de tanımlamalıyız:
def loss(y_true, y_pred):
   """Mean squared error"""
   return np.mean((y_true - y_pred) ** 2)
Şimdi stochastic_gradient_descent adlı ve altı argüman alan bir fonksiyon tanımlayalım:
x ve y problemimizdeki tek özelliği ve hedefi temsil ederepochs kaç kez iniş yapmak istediğimizi belirtir (buna birazdan daha fazla değineceğiz)learning_rate adım boyutudurbatch_size parametre güncellemelerini ne sıklıkla yapacağımızı kontrol ederstopping_threshold her adımda kaybın azalması gereken minimum değeri belirlerdef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""Başlangıç olarak, optimize etmek istediğimiz parametreleri rastgele değerlerle başlatır ve kaybı sonsuza ayarlarız:
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infArdından, epochs parametresini kullanarak bir for döngüsü başlatırız. Döngü içinde, hesaplamaları daha sağlam yapmak için veriyi karıştırırız:
for i in range(epochs):
# Shuffle the data
indices = np.random.permutation(n)
x = x[indices]
y = y[indices]Ardından, gerçek gradyan hesaplaması başka bir for döngüsünün içinde başlar.
for j in range(0, n, batch_size):
x_batch = x[j:j + batch_size]
y_batch = y[j:j + batch_size]Kümeyi x ve y’den çıkarır ve gradyanları hesaplarız:
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)Yukarıda oluşturduğumuz model fonksiyonunu, mevcut m ve b değerleriyle bir tahmin yapmak için kullanırız. Ardından, önceki bölümde belirttiğimiz formülü kullanarak gradyanı oluşturan kısmi türevleri buluruz.
Kısmi türevleri ve öğrenme oranını kullanarak parametreleri güncelleriz:
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientİşte şu ana kadarki tam kod:
def stochastic_gradient_descent(
   x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
   """
   SGD with support for mini-batches.
   """
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x)
previous_loss = np.inf
for i in range(epochs):
   # Shuffle the data
   indices = np.random.permutation(n)
   x = x[indices]
   y = y[indices]
for j in range(0, n, batch_size):
   x_batch = x[j:j + batch_size]
   y_batch = y[j:j + batch_size]
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientİç döngünün dışında fonksiyona devam ederek epoch için kaybı hesaplarız:
# Compute the loss
y_pred = model(m, x, b)
current_loss = loss(y, y_pred)
Eğer current_loss değeri stopping_threshold’dan daha küçükse tüm süreci durdururuz:
if previous_loss - current_loss < stopping_threshold:
   break
previous_loss = current_loss
Aksi halde, previous_loss’u current_loss olarak ayarlarız. Sonunda, optimize edilmiş m ve b parametrelerini döndürürüz:
return m, bTüm kodu bu GitHub gist’ine yapıştırdım; böylece tamamına göz atabilirsiniz.
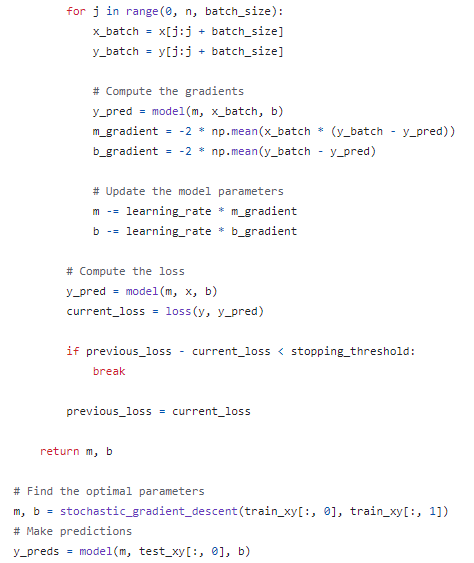
Bulunan parametrelerin ne kadar iyi çalıştığını test seti üzerinde modeli çalıştırarak test edelim:
# Find the optimal parameters
m, b = stochastic_gradient_descent(train_xy[:, 0], train_xy[:, 1])
# Make predictions
y_preds = model(m, test_xy[:, 0], b)
# Compute and print the loss
mean_squared_error = loss(test_xy[:, 1], y_preds)
mean_squared_error ** 0.5
1595.3955619759456
MSE’nin karekökü yaklaşık 1.600 $’dır; bu da modelimizin ortalama olarak 1.600 $ sapma gösterdiği anlamına gelir. Hatayı iyileştirmek için epoch sayısını artırabilir veya daha büyük bir veri seti kullanabiliriz.
Önceki bölümdeki SGD uygulaması kaba ve verimsizdir. Amacı, önceki bölümlerde oluşturduğumuz sezgiyi bir kod yürüyüşüyle pekiştirmektir.
Uygulamada, SGD’yi neredeyse hiçbir zaman elle yeniden uygulamaz, popüler çerçevelerdeki hazır sürümleri kullanırsınız.
Örneğin, Scikit-learn; çeşitli ML algoritmalarını eğitmek için SGDRegressor ve SGDClassifier kestirimcilerini sağlar. Bunlar aşağıdaki gibi algoritmalar için kullanılabilir:
optimizasyon algoritması olarak SGD ile.
from sklearn.linear_model import SGDRegressor, SGDClassifier
# SGD for Linear Regression with 1000 epochs
regressor = SGDRegressor(loss='squared_loss', max_iter=1000)
PyTorch’ta, optim modülü içinde SGD sınıfı olarak mevcuttur:
import torch.optim as optim
optimizer = optim.SGD(model.parameters(), lr=0.01)
PyTorch’ta model eğitmeyi ve optimize etmeyi öğrenmek için DataCamp’in Introduction to PyTorch kursuna bakın.
Keras’ta, SGD aynı adla mevcuttur:
from tensorflow.keras.optimizers import SGD
optimizer = SGD(learning_rate=0.01)
TensorFlow’da model eğitmeyi ve optimize etmeyi öğrenmek için DataCamp’in Introduction to TensorFlow kursuna bakın.
SGD veya benzeri algoritmalar için birçok en iyi uygulama ve ipucu vardır. Aşağıda bazılarını özetleyeceğiz:
Bugün, makine öğrenmesindeki temel optimizasyon algoritmalarından birini — Stokastik Gradyan İnişi’ni — öğrendik.
Önce klasik gradyan inişi algoritmasını ele alarak sezgimizi ve temel fikirlerini oluşturduk. Gözlerimiz bağlıyken dibi bulmaya çalıştığımız yamaç benzetmesini kapsamlı şekilde kullandık.
SGD ile klasik GD’nin, parametre güncellemelerinde kullanılan veri noktası sayısıyla birbirinden ayrıldığını öğrendik. Sezgimizi pekiştirmek ve matematiksel ayrıntıları netleştirmek için Numpy ile SGD uyguladık.
Lütfen SGD’nin, tüm ML eğitim sürecinin yalnızca bir parçası olduğunu unutmayın. Rolü hakkında daha fazla bilgi edinmek için aşağıdaki kaynaklara göz atın:
En İyi DataCamp Kursları
Program
Program
Program
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




