
Last chance! 50% off DataCamp Premium
Sale ends in
कल्पना कीजिए कि आप आंखों पर पट्टी बांधकर पहाड़ियों के बीच सबसे निचला बिंदु खोजने की कोशिश कर रहे हैं। स्पर्श की सीमा के कारण, आप केवल अपने आस-पास की जमीन को महसूस करके यह तय कर सकते हैं कि नीचे जाने का रास्ता कौन-सा है। मशीन लर्निंग एल्गोरिदम भी मूल रूप से यही करते हैं जब वे किसी समस्या का सर्वश्रेष्ठ समाधान खोजने की कोशिश करते हैं।
वे समस्या को एक गणितीय फलन में रूपांतरित करते हैं, जिसके इनपुट और आउटपुट एक पहाड़ी सतह का प्रतिनिधित्व करते हैं। इस फलन का न्यूनतम ढूंढ लेना मतलब आपने समस्या का सर्वश्रेष्ठ समाधान पा लिया। इस प्रक्रिया के लिए सबसे लोकप्रिय एल्गोरिदमों में से एक Stochastic Gradient Descent (SGD) कहलाता है।
इस ट्यूटोरियल में, आप इस एल्गोरिदम के बारे में वह सब सीखेंगे जो आपको जानना चाहिए—गणित के बिना प्रारंभिक अंतर्दृष्टि से लेकर गणितीय विवरण, और Python में इसका कार्यान्वयन तक।
Stochastic Gradient Descent (SGD) मशीन लर्निंग में इस्तेमाल होने वाली एक ऑप्टिमाइज़ेशन तकनीक है, जो प्रेडिक्टिव मॉडलों में त्रुटि को न्यूनतम करने के लिए प्रयोग की जाती है। साधारण ग्रेडिएंट डीसेंट के विपरीत, जो पूरे डेटासेट का उपयोग करके ग्रेडिएंट की गणना करता है और पैरामीटर अपडेट करता है, SGD हर बार केवल एक डेटा पॉइंट से पैरामीटर अपडेट करता है। इससे बड़े डेटासेट पर यह तेज़ और अधिक कुशल बनता है, हालांकि यह अधिक शोरयुक्त और कम स्थिर हो सकता है। SGD मॉडल पैरामीटरों के सर्वोत्तम मान खोजने में मदद करता है ताकि भविष्यवाणियों की सटीकता बढ़े।
सबसे पहले यह स्पष्ट कर लें कि स्टोचैस्टिक ग्रेडिएंट डीसेंट (SGD) कोई मशीन लर्निंग एल्गोरिदम नहीं है। बल्कि, यह केवल एक ऑप्टिमाइज़ेशन तकनीक है जिसे ML एल्गोरिदमों पर लागू किया जा सकता है।
तो, ऑप्टिमाइज़ेशन क्या है? इसे समझने के लिए, चलिए मशीन लर्निंग के समस्या-विवरण चरण से आगे बढ़ते हैं।
मान लीजिए हम करेट मान (एक करेट = 0.2 ग्राम) के आधार पर हीरे की कीमत का पूर्वानुमान लगाना चाहते हैं। चूंकि मॉडल संख्यात्मक मान उत्पन्न करता है, यह एक रिग्रेशन समस्या है।
समस्या को हल करने के लिए हमारे पास कई एल्गोरिदम हैं, लेकिन चलिए सिंपल लीनियर रिग्रेशन चुनते हैं, जिसकी सरल समीकरण है f(x) = mx + b, जहाँ:
b आधार (बेस) हीरे की कीमत हैm प्रति करेट कीमत में वृद्धि हैx हीरे का करेट मान हैf(x) हीरे की अनुमानित कीमत हैयह रैखिक समीकरण हमारा मॉडल दर्शाती है। हमारा लक्ष्य m और b के ऐसे सर्वोत्तम मान खोजना है जो हमारे डेटासेट के सभी हीरों के लिए भविष्यवाणी को यथासंभव सटीक बनाएं।
यदि हमारे डेटासेट में कोई और फीचर हो, जैसे हीरे का आयतन, तो हमारा सूत्र बदलकर f(x1, x2) = m1*x1 + m2*x2 + b हो जाएगा, जहाँ:
b आधार हीरा कीमत हैm1 प्रति करेट कीमत में वृद्धि हैm2 प्रति इकाई आयतन कीमत में वृद्धि हैx1 हीरे का करेट मान हैx2 हीरे का आयतन हैf(x) हीरे की अनुमानित कीमत हैअब, हमें m1, m2 और b के सर्वोत्तम मान खोजने होंगे।
सामान्यतः, सभी मशीन लर्निंग मॉडल ऊपर जैसी समीकरणों के रूप में होते हैं, जिनमें एक या अधिक पैरामीटर होते हैं। अतः इस संदर्भ में ऑप्टिमाइज़ेशन की परिभाषा बनती है: “दिए गए मॉडल और डेटासेट के लिए, समीकरण के पैरामीटरों के सर्वोत्तम मान खोजो।”
इस कार्य के लिए कई ऑप्टिमाइज़ेशन एल्गोरिदम मौजूद हैं, जैसे Stochastic Gradient Descent, जो हमारे ट्यूटोरियल का केंद्र है। लेकिन SGD को पूरी तरह समझने के लिए, चलिए इसके पीछे की कुछ बुनियादी अवधारणाएँ देखते हैं।
SGD को समझने के लिए, हमें साधारण ग्रेडिएंट डीसेंट एल्गोरिदम (GD) सीखना होगा, जो अपनी स्टोचैस्टिक संस्करण के साथ कई बुनियादी विचार साझा करता है। सिंपल ग्रेडिएंट डीसेंट की शुरुआत मशीन लर्निंग में त्रुटि की अवधारणा से होती है।
ML एल्गोरिदम आमतौर पर किसी समस्या के सही उत्तर का अनुमान लगाते हैं। हम इस उत्तर को प्रेडिक्शन कहते हैं और यह हमेशा सटीक नहीं होता। इसलिए, हम “त्रुटि” या “लॉस” नामक एक नया पद परिभाषित करते हैं, जो वास्तविक उत्तर और मॉडल की भविष्यवाणी के बीच के अंतर का प्रतिनिधित्व करता है। हमारा लक्ष्य ऐसा मॉडल बनाना है जो इस त्रुटि को न्यूनतम करे।
यदि हमारा मॉडल f(x) किसी ऐसे हीरे के लिए $10,000 का अनुमान लगाता है जिसकी वास्तविक कीमत $12,000 है, तो त्रुटि $2,000 है। हमें इस त्रुटि को घटाने के लिए अपने मॉडल को समायोजित करना चाहिए। लेकिन मॉडल की भविष्यवाणियाँ किसी एक हीरे के लिए ही नहीं, बल्कि सभी हीरों के लिए अच्छी होनी चाहिए। इसलिए, हमें अपने डेटासेट के सभी हीरों की त्रुटियों को एक साथ जोड़ने का तरीका चाहिए। यहीं कॉस्ट फ़ंक्शन काम आते हैं।
एक कॉस्ट फ़ंक्शन सभी व्यक्तिगत त्रुटियों को मिलाकर एक संख्या देता है जो हमारे मॉडल के समग्र प्रदर्शन का प्रतिनिधित्व करती है। कम समग्र कॉस्ट का मतलब है कि हमारे मॉडल की भविष्यवाणियाँ बेहतर हैं।
कॉस्ट फ़ंक्शन इस बात पर निर्भर करते हैं कि हम किस प्रकार की समस्या हल कर रहे हैं।
रिग्रेशन समस्याओं में, मॉडल संख्यात्मक मानों की भविष्यवाणी करता है, जैसे कोई हीरा कितने का है या एक लैप तैरने में कितना समय लगता है। क्लासिफिकेशन में, मॉडल यह श्रेणी बताता है कि कोई वस्तु किस वर्ग में आती है। उदाहरण के लिए, क्या कोई मशरूम खाने योग्य है या नहीं, या किसी छवि में वस्तु बिल्ली, कुत्ता या घोड़ा है?
अन्य प्रकार की समस्याएँ भी हैं, पर महत्वपूर्ण बात यह है कि प्रत्येक के लिए अलग कॉस्ट फ़ंक्शनों की आवश्यकता होती है। इस ट्यूटोरियल में, हम मीन स्क्वेयर्ड एरर (MSE) पर ध्यान देंगे, जिसे रिग्रेशन में अक्सर उपयोग किया जाता है।
वास्तविक मानों (ग्राउंड ट्रुथ) और मॉडल की भविष्यवाणियों के बीच के अंतर को त्रुटि या लॉस कहा जाता है। तदनुसार, इन सभी त्रुटियों या लॉसेज़ को मिलाने वाले फ़ंक्शन को एरर फ़ंक्शन, लॉस फ़ंक्शन या कॉस्ट फ़ंक्शन कहा जाता है। अलग-अलग स्रोत इन शब्दों का परस्पर विनिमय से उपयोग कर सकते हैं; यह ट्यूटोरियल आगे लॉस फ़ंक्शन शब्द का उपयोग करेगा।
रिग्रेशन समस्याओं में अक्सर नीचे जैसा ग्राफ़ देखा जाता है, जो वास्तविक मानों (ग्राउंड ट्रुथ) को मॉडल की भविष्यवाणियों के विरुद्ध प्लॉट करता है।
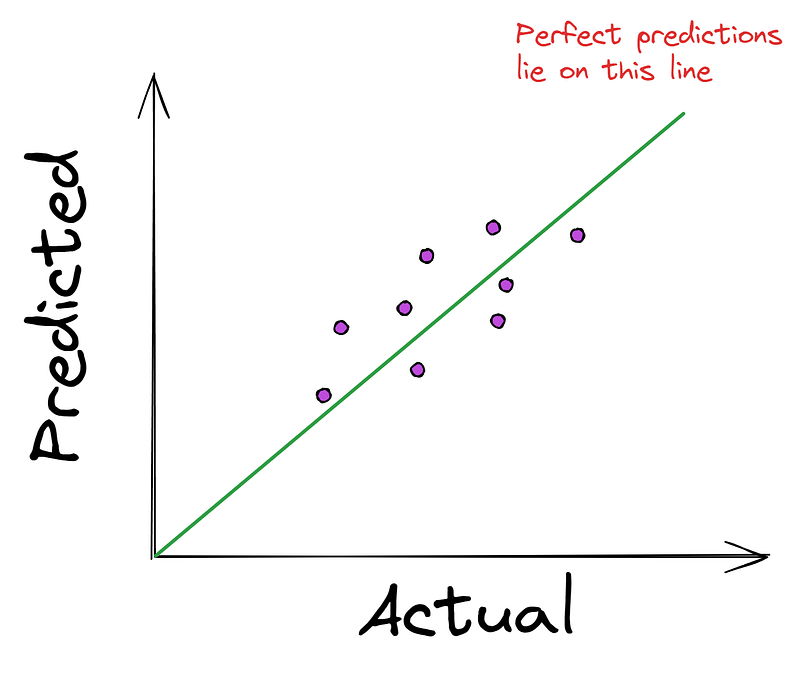
बिंदु जितने सीधी रेखा के पास होंगे, मॉडल की भविष्यवाणी उतनी ही बेहतर होगी। इसलिए, अधिकतर रिग्रेशन एल्गोरिदम बिंदुओं से उस परफेक्ट रेखा तक की औसत दूरी को न्यूनतम करने की कोशिश करते हैं। और जैसा कि पहले उल्लेख किया, यह न्यूनकरण Mean Squared Error (MSE) जैसे कॉस्ट फ़ंक्शन के माध्यम से होता है।
MSE वास्तविक और भविष्यवाणी मानों को इनपुट के रूप में लेकर, परफेक्ट रेखा तक की औसत वर्ग दूरी देता है।
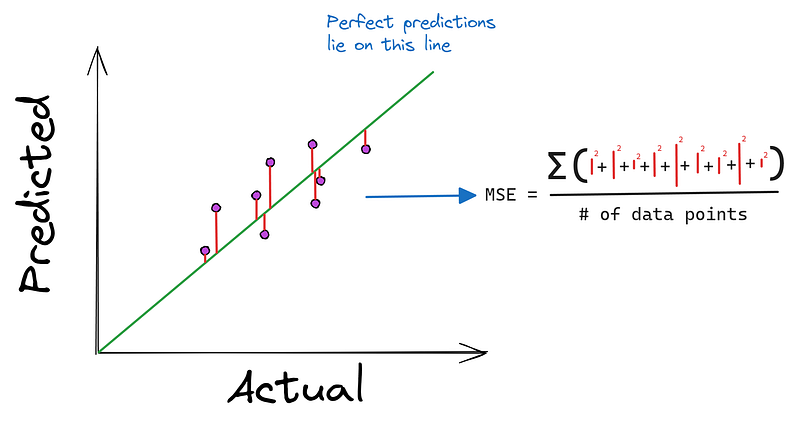
आप पूछ सकते हैं, “अंतर का परिमाण (absolute value) लेने के बजाय हम उन्हें स्क्वेयर क्यों करते हैं?” पहला कारण यह है कि वर्ग फलन का अवकलन (डेरिवेटिव) निकालना बहुत आसान है। साथ ही, अंतर का वर्ग बड़े एरर पर ज़्यादा जोर देता है, जिससे मॉडल की सबसे ख़राब भविष्यवाणियों को अधिक दंड मिलता है।
इसीलिए MSE को Mean Absolute Error (MAE) जैसे अन्य विकल्पों पर तरजीह दी जाती है, जो ऊपर से सरल दिखते हैं लेकिन उनका अवकलन कठिन होता है।
ग्रेडिएंट डीसेंट पहेली का अगला हिस्सा है स्वयं ग्रेडिएंट। इसे बेहतर समझने के लिए चलिए “पहाड़ी से नीचे” वाली उपमा पर लौटते हैं।
हम आंखों पर पट्टी बांधकर पहाड़ी की चोटी पर खड़े थे और जल्द-से-जल्द नीचे पहुंचना चाहते थे। अगर हम अपने पैरों के पास पानी बहाएँ, तो वह किस दिशा में बहेगा? वह सबसे खड़ी ढलान की दिशा में नीचे की ओर बहेगा।
ग्रेडिएंट हमें बिल्कुल यही बताता है, लेकिन विपरीत दिशा में। ग्रेडिएंट ऊपर की ओर इशारा करता है—सबसे तीव्र आरोहण की दिशा में। जब हम त्रुटि को न्यूनतम करने की कोशिश करते हैं, तो हम ग्रेडिएंट की विपरीत दिशा में जाकर सबसे तेज़ी से नीचे पहुँचते हैं।
गणितीय रूप से, ग्रेडिएंट हमें बताता है कि जब हम किसी फलन के इनपुट बदलते हैं, तो उसका आउटपुट कैसे बदलता है। विशेष रूप से, यह उस दिशा की ओर इंगित करता है, जहाँ फलन सबसे तेजी से बढ़ता है।
मशीन लर्निंग के संदर्भ में, जहाँ हम लॉस फ़ंक्शन का उपयोग करते हुए त्रुटि घटाना चाहते हैं, ग्रेडिएंट त्रुटि कम करने के सबसे तेज़ रास्ते का हमारा मार्गदर्शक बन जाता है।
ग्रेडिएंट एक वेक्टर के रूप में व्यक्त होता है—हमारे फलन के प्रत्येक इनपुट पैरामीटर के लिए एक। इस वेक्टर का हर मान बताता है कि संबंधित पैरामीटर में थोड़ा-सा परिवर्तन करने पर फलन कितना बदलेगा।
तो, आप किसी फलन का ग्रेडिएंट कैसे ढूंढते हैं?
एक चर वाले फलन जैसे f(x) = x ** 2 के लिए, ग्रेडिएंट फलन का डेरिवेटिव होता है, जो एक तत्व वाले वेक्टर के रूप में दिया जाता है — [2x]।
बहु-चर वाले फलन जैसे f(x1, x2) = x1 ** 3 - x2 ** 2 के लिए, ग्रेडिएंट फलन के प्रत्येक इनपुट के सापेक्ष आंशिक अवकलज (partial derivatives) से बनता है। तो, दूसरे फलन के लिए ग्रेडिएंट वेक्टर होगा [3x1 ** 2, 2*x2]।
MSE पर लौटते हैं, जिसका निम्न सूत्र है:
MSE = (1/n) * Σ(y - f(x))² जहाँ:
f(x) है mx + bm और b फलन के चर (variables) हैंx हीरों का करेट मान हैn डेटा पॉइंट्स की संख्या हैy हीरों की वास्तविक कीमत हैतो, इसका ग्रेडिएंट MSE के m और b के सापेक्ष आंशिक अवकलज होंगे:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
The gradient = [∂/∂m (MSE), ∂/∂b (MSE)]
इन सूत्रों को लेकर बहुत चिंतित न हों। मूल बात यह है कि ये हमें बताते हैं कि यदि हम m या b को थोड़ा-सा बदलें, तो मीन स्क्वेयर्ड एरर कैसे बदलेगा।
अब, हमारे पास ग्रेडिएंट डीसेंट निष्पादित करने के लिए सब कुछ है—या कहें, जितना संभव हो उतनी कुशलता से पहाड़ी के नीचे पहुंचने के लिए। लेकिन क्या हम उस दिशा में छलांग लगाएँ या छोटे-छोटे कदम लें? खैर, यह तो ग्रेडिएंट से निर्धारित होता है, है ना? ग्रेडिएंट का आकार बताता है कि हर कदम में हम कितनी दूरी नीचे जाएंगे।
पर मान लीजिए ग्रेडिएंट इतना बड़ा है कि नीचे पहुंचने के बजाय हम एक ही कदम में आगे निकलकर दूसरी पहाड़ी की चोटी पर पहुँच जाएँ। हैरानी की बात है कि ऐसा ग्रेडिएंट डीसेंट में अक्सर होता है, इसलिए हम step size नाम का एक पैरामीटर लाते हैं, जो ग्रेडिएंट के प्रभाव को नियंत्रित करता है।
कदम लेने से पहले, हम बस ग्रेडिएंट को step size से गुणा कर देते हैं, जिससे उसका परिमाण घट जाता है। उदाहरण के लिए, यदि हमारा ग्रेडिएंट हमें 3.56 की डाउनहिल चाल बताता है, तो 0.1 का step size दूरी को 0.356 बना देता है।
नीचे पहुंचने में हमें अधिक समय लगेगा, लेकिन अब नीचे के बिंदु को पूरी तरह पार कर जाने का जोखिम नहीं रहेगा।
लर्निंग रेट मशीन लर्निंग में step size के लिए प्रचलित शब्द है और आमतौर पर इसके मान 0.001 से 0.3 के बीच होते हैं।
तो, आइए इस प्रक्रिया का गणितीय संस्करण देखें।
पहले, हम अपने मॉडल के m और b पैरामीटरों को यादृच्छिक मान देते हैं:
m = 0.215  # Generated randomly
b = 0.059
इनका उपयोग करके, हम पूरे डेटासेट पर शुरुआती MSE की गणना करते हैं:
MSE = (1/n) * Σ(y - (0.215 * x + 0.059))² = ...अब, इस त्रुटि को घटाने के लिए, हमें ग्रेडिएंट की विपरीत दिशा में एक छोटा कदम लेना होगा, यानी हमें लर्निंग रेट और ग्रेडिएंट का उपयोग करके m और b को अपडेट करना होगा:
m_new = 0.215 - alpha * (∂/∂m (MSE))
b_new = 0.059 - alpha * (∂/∂b (MSE))
अधिकांश स्रोत लर्निंग रेट को दर्शाने के लिए alpha या α (ग्रीक अक्षर) का उपयोग करते हैं।
नए m और b मान मिलने के बाद, हम फिर से MSE निकालते हैं:
MSE_new = (1/n) * Σ(y - (m_new * x + b_new))²अब, हम फिर से ग्रेडिएंट की गणना करते हैं और किसी स्टॉपिंग कंडीशन तक इसी तरह जारी रखते हैं।
लर्निंग रेट प्रशिक्षण को कैसे प्रभावित करता है, यह दृश्य रूप से देखने के लिए इस ग्रेडिएंट डीसेंट आलेख को देखें।
चूँकि हमारी आँखों पर पट्टी बंधी है, हम वास्तव में नहीं देख सकते कि हम नीचे पहुँच गए हैं या नहीं, खासकर जब छोटे-छोटे कदम ले रहे हों।
इसलिए, हमें अपने अवतरण को रोकने के कुछ नियम चाहिए। प्रायः ये नियम प्रयोग होते हैं:
इन नियमों को आप, एक ML इंजीनियर के रूप में, ग्रेडिएंट डीसेंट करते समय निर्धारित करते हैं। Python में एल्गोरिदम के इम्प्लिमेंटेशन प्रायः ऐसे आर्ग्युमेंट्स देते हैं जिनसे ये नियम सेट किए जा सकते हैं—हम इन्हें आगे देखेंगे।
लाभ:
चुनौतियाँ:
अगले भाग में, हम देखेंगे कि Stochastic Gradient Descent इन चुनौतियों—विशेषकर बड़े डेटासेट के लिए—को कैसे संबोधित करता है।
एक बार जब आप साधारण ग्रेडिएंट डीसेंट समझ लेते हैं, तो SGD को समझना बहुत आसान हो जाता है।
यद्यपि ग्रेडिएंट डीसेंट सबसे सुरुचिपूर्ण ऑप्टिमाइज़ेशन एल्गोरिदमों में से एक है, बड़े डेटासेट के साथ इसका एक महत्वपूर्ण नुकसान है। याद कीजिए कि हर कदम पर हम अपने डेटासेट के सभी डेटा पॉइंट्स का उपयोग करके ग्रेडिएंट की गणना करते हैं:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
यहाँ x और y ऐसे एरे हैं जिनमें हीरों के सभी करेट मान और वास्तविक कीमतें हैं। इसका मतलब है कि हर कदम पर हम हर एक हीरे की जानकारी का उपयोग करके पैरामीटर अपडेट करेंगे।
आप कल्पना कर सकते हैं कि जब हमारे पास लाखों डेटा पॉइंट्स हों, तो यह संगणनात्मक रूप से महंगा और समय लेने वाला हो जाता है। बिग डेटा के युग में, यह सीमा कई वास्तविक दुनिया की ML समस्याओं के लिए साधारण ग्रेडिएंट डीसेंट को अव्यावहारिक बना सकती है।
“Stochastic” का अर्थ है “आकस्मिक रूप से निर्धारित,” और SGD यही करता है: यह हमारे ऑप्टिमाइज़ेशन प्रोसेस में रैंडमनेस लाता है।
पूरे डेटा का उपयोग करके ग्रेडिएंट निकालने के बजाय, SGD हर कदम पर एक डेटा पॉइंट को यादृच्छिक रूप से चुनता है। यह उसी एक पॉइंट से ग्रेडिएंट का अनुमान लगाता है और पैरामीटर अपडेट करता है।
क्योंकि SGD एक समय में केवल एक डेटा पॉइंट देखता है, यह पैरामीटर अधिक बार अपडेट कर सकता है। यह विशेषकर बड़े डेटासेट के लिए, त्रुटि सतह (पहाड़ी) पर अधिक तेजी से आगे बढ़ने देता है।
हालाँकि, यह गति कीमत के साथ आती है। चूँकि हम पूरे डेटासेट के ग्रेडिएंट का अनुमान एक ही पॉइंट से लगा रहे हैं, हमारे अनुमान अधिक शोरयुक्त होते हैं। इसका मतलब है कि त्रुटि सतह पर हमारा रास्ता कम स्मूद और अधिक उछालभरा होता है।
SGD करने के लिए, हम पहले एक स्टोचैस्टिक कॉस्ट फ़ंक्शन परिभाषित करते हैं।
पूरे डेटा पॉइंट्स पर Mean Squared Error निकालने के बजाय, अब हम यादृच्छिक रूप से चुने गए एक मात्र पॉइंट के लिए स्क्वेयर्ड एरर देखते हैं:
Cost = (y - f(x))²जहाँ y उस यादृच्छिक रूप से चुने गए हीरे की वास्तविक कीमत है, और f(x) = mx + b उस हीरे के लिए हमारी अनुमानित कीमत है।
फिर, हम अपने पैरामीटर m और b के सापेक्ष इस कॉस्ट फ़ंक्शन का स्टोचैस्टिक ग्रेडिएंट निकालते हैं:
∂/∂m (Cost) = -2x(y - (mx + b))
∂/∂b (Cost) = -2(y - (mx + b))
The stochastic gradient = [∂/∂m (Cost), ∂/∂b (Cost)]
इस स्टोचैस्टिक ग्रेडिएंट का उपयोग करके, हम साधारण ग्रेडिएंट डीसेंट की तरह ही पैरामीटर अपडेट करते हैं:
m_new = m_old - learning_rate * ∂/∂m (Cost)
b_new = b_old - learning_rate * ∂/∂b (Cost)
SGD में मुख्य विचार यह है कि हर कदम एक ही यादृच्छिक डेटा पॉइंट पर आधारित होता है। रुकने के नियम साधारण ग्रेडिएंट डीसेंट के समान ही रहते हैं।
व्यवहार में, वैनिला SGD—जहाँ हर प्रशिक्षण उदाहरण के लिए पैरामीटर अपडेट होते हैं—बहुत कम इस्तेमाल होता है। कारण यह है कि एल्गोरिदम के अपडेट्स का वैरिएंस बहुत अधिक होता है, जिससे लॉस फ़ंक्शन में उतार-चढ़ाव हो सकता है और सटीक न्यूनतम पर पहुँचना कठिन हो जाता है।
साधारण ग्रेडिएंट डीसेंट शक्तिशाली है और अधिक स्थिर परिणाम देता है, लेकिन जैसा हमने कहा, यह हर कदम पर सभी डेटा पॉइंट्स का उपयोग करता है, जिससे मौजूदा डेटासेट के लिए यह अव्यावहारिक हो जाता है।
स्थिरता और गति के बीच संतुलन के लिए, मिनी-बैच ग्रेडिएंट डीसेंट का अक्सर—खासकर न्यूरल नेटवर्क्स में—उपयोग होता है। मिनी-बैच GD में, एक मात्र रैंडम सैंपल के बजाय, पैरामीटर अपडेट करते समय सैंपल्स का एक बैच लिया जाता है। सामान्य बैच साइज 16, 32, 64 इत्यादि होते हैं।
तो, यदि आपका बैच साइज 1 है, तो वह SGD है। यदि आपका बैच साइज डेटासेट के आकार के बराबर है, तो वह साधारण ग्रेडिएंट डीसेंट है। इन दोनों के अलावा कोई भी बैच साइज आपको मिनी-बैच ग्रेडिएंट डीसेंट देता है।
यहाँ एक तालिका उनके अंतर और उपयोग के समय का सार प्रस्तुत करती है:
| प्रकार | अपडेट की आवृत्ति | संगणनात्मक दक्षता | मेमोरी आवश्यकताएँ | कन्वर्जेंस स्थिरता | सर्वोत्तम उपयोग मामला |
| ग्रेडिएंट डीसेंट (GD) | प्रत्येक अपडेट पर पूरा डेटासेट | पूरे डेटासेट उपयोग के कारण सबसे धीमा | पूरे डेटासेट की मेमोरी में आवश्यकता | सबसे स्थिर, पर सबसे धीमा | छोटे डेटासेट जहाँ स्थिरता महत्वपूर्ण हो |
| Stochastic Gradient Descent (SGD) | प्रत्येक अपडेट पर एक उदाहरण | सबसे तेज़, एक बार में एक उदाहरण प्रोसेस करता है | कम मेमोरी आवश्यकता | उच्च वैरिएंस, उतार-चढ़ाव संभव | बड़े डेटासेट जहाँ तेज़ अपडेट चाहिए |
| मिनी-बैच ग्रेडिएंट डीसेंट | प्रत्येक अपडेट पर उदाहरणों का बैच | दक्षता और गति का संतुलन; GD से अधिक कुशल, SGD से धीमा | एक बैच के लिए मेमोरी की आवश्यकता | SGD से अधिक स्थिर, GD से कम स्थिर | बड़े डेटासेट जहाँ स्थिरता और दक्षता का संतुलन चाहिए |
किसी भी ऑप्टिमाइज़ेशन एल्गोरिदम में एक महत्वपूर्ण अवधारणा है epoch। यह पूरे प्रशिक्षण डेटासेट पर एक पूर्ण पास को संदर्भित करता है।
एक epoch में, एल्गोरिदम प्रशिक्षण डेटासेट के हर सैंपल को ठीक एक बार प्रोसेस करता है। प्रत्येक सैंपल (या मिनी-बैच) के लिए, मॉडल प्रेडिक्शन करता है, लॉस की गणना करता है और लॉस के ग्रेडिएंट के अनुसार वेट्स अपडेट करता है। एक epoch मॉडल के सुधार के एक चक्र को चिह्नित करता है। हर epoch के बाद आप आमतौर पर देख सकते हैं कि मॉडल का प्रदर्शन कैसे बदला है।
ट्रेनिंग आम तौर पर कई epochs (कम से कम 10 अनुशंसित) में होती है। epochs की संख्या एक हाइपरपैरामीटर है जिसे आप ट्यून कर सकते हैं। अक्सर, प्रशिक्षण उदाहरणों के क्रम को मॉडल द्वारा सीखने से रोकने के लिए हर epoch से पहले डेटा को शफ़ल किया जाता है।
हमारी आँखों पर पट्टी बांधकर पहाड़ी की जाँच-पड़ताल वाली उपमा में, एक epoch पूरे परिदृश्य की एक संपूर्ण खोज है। हर epoch में, आप:
हर पूर्ण खोज के बाद, आप अपनी नई स्थिति से फिर शुरू करते हैं। अनेक epochs मॉडल को लॉस लैंडस्केप को बार-बार खोजने का अवसर देते हैं, जिससे अच्छा न्यूनतम पाने की संभावना बढ़ती है।
हालाँकि, कई epochs वैश्विक न्यूनतम मिलने की गारंटी नहीं देते, और पूरी प्रक्रिया शुरुआती बिंदु या लॉस लैंडस्केप की जटिलता जैसे कारकों से प्रभावित हो सकती है।
इस खंड में, हम केवल Numpy का उपयोग करके बैच साइज (मिनी-बैच GD) के समर्थन सहित SGD इम्प्लिमेंट करेंगे।
पहले, आवश्यक लाइब्रेरी इम्पोर्ट कर लेते हैं:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
हम Seaborn में उपलब्ध Diamonds डेटासेट से 10,000 डेटा पॉइंट्स लेंगे। हम केवल carat फीचर और price कॉलम (टार्गेट) लेंगे:
# Load the data
dataset_size = 10_000
diamonds = sns.load_dataset('diamonds')
# Extract the target and the feature
xy = diamonds[['carat', 'price']].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
(10000, 2)
अब, डेटा को ट्रेनिंग और टेस्ट सेट में बाँटते हैं, जहाँ ट्रेनिंग साइज कुल का 80% होगा।
# Split the data
np.random.shuffle(xy)
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(8000, 2)
फिर, अपना मॉडल फ़ंक्शन परिभाषित करते हैं:
def model(m, x, b):
   """Simple linear model"""
   return m * x + b
हम सरल रैखिक रिग्रेशन कर रहे हैं, जिसमें केवल दो स्वतंत्र चर m और b हैं।
हमें अपना लॉस फ़ंक्शन MSE भी परिभाषित करना चाहिए:
def loss(y_true, y_pred):
   """Mean squared error"""
   return np.mean((y_true - y_pred) ** 2)
अब, हम stochastic_gradient_descent नामक एक फ़ंक्शन परिभाषित करते हैं जो छह आर्ग्युमेंट लेता है:
x और y हमारी समस्या में एकल फीचर और टार्गेट को दर्शाते हैंepochs दर्शाता है कि हम कितनी बार अवतरण (descent) करना चाहते हैं (इस पर आगे)learning_rate स्टेप साइज हैbatch_size पैरामीटर अपडेट की आवृत्ति नियंत्रित करता हैstopping_threshold यह सेट करता है कि हर कदम पर लॉस कम-से-कम कितना घटेdef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""शुरू करने के लिए, जिन पैरामीटरों को हमें ऑप्टिमाइज़ करना है उन्हें यादृच्छिक मानों से इनिशियलाइज़ करते हैं और लॉस को अनंत पर सेट करते हैं:
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infफिर, हम epochs पैरामीटर का उपयोग करके एक for लूप शुरू करते हैं। लूप के भीतर, हम गणनाओं को अधिक मजबूत बनाने के लिए डेटा को शफ़ल करते हैं:
for i in range(epochs):
# Shuffle the data
indices = np.random.permutation(n)
x = x[indices]
y = y[indices]इसके बाद, वास्तविक ग्रेडिएंट गणना एक और for लूप के अंदर शुरू होती है।
for j in range(0, n, batch_size):
x_batch = x[j:j + batch_size]
y_batch = y[j:j + batch_size]हम x और y से बैच निकालते हैं और ग्रेडिएंट्स की गणना करते हैं:
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)हम ऊपर बनाए गए model फ़ंक्शन का उपयोग वर्तमान m और b मानों के साथ प्रेडिक्शन बनाने के लिए करते हैं। फिर, पहले वाले खंड में दिए गए सूत्र के अनुसार ग्रेडिएंट के आंशिक अवकलज निकालते हैं।
आंशिक अवकलज और लर्निंग रेट का उपयोग करते हुए, हम पैरामीटर अपडेट करते हैं:
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientअब तक का पूरा कोड यह रहा:
def stochastic_gradient_descent(
   x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
   """
   SGD with support for mini-batches.
   """
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x)
previous_loss = np.inf
for i in range(epochs):
   # Shuffle the data
   indices = np.random.permutation(n)
   x = x[indices]
   y = y[indices]
for j in range(0, n, batch_size):
   x_batch = x[j:j + batch_size]
   y_batch = y[j:j + batch_size]
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientआंतरिक लूप के बाहर फ़ंक्शन को आगे बढ़ाते हुए, हम epoch के लिए लॉस निकालते हैं:
# Compute the loss
y_pred = model(m, x, b)
current_loss = loss(y, y_pred)
यदि current_loss stopping_threshold से छोटा है, तो हम पूरी प्रक्रिया रोक देते हैं:
if previous_loss - current_loss < stopping_threshold:
   break
previous_loss = current_loss
अन्यथा, हम previous_loss को current_loss पर सेट करते हैं। अंत में, हम ऑप्टिमाइज़ किए गए m और b पैरामीटर लौटा देते हैं:
return m, bमैंने पूरा कोड इस GitHub gist में पेस्ट किया है ताकि आप पूरी तस्वीर देख सकें।
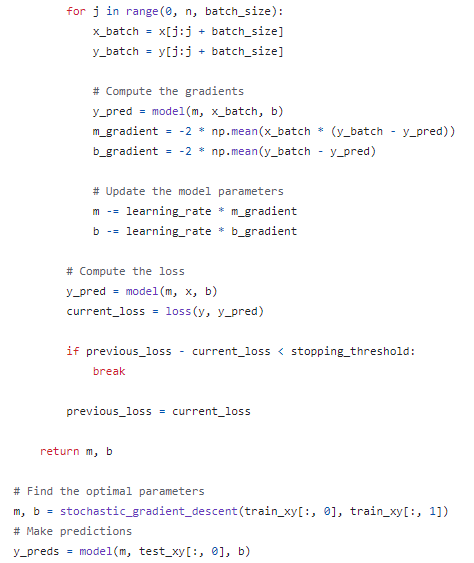
आइए, टेस्ट सेट पर मॉडल चलाकर मिले पैरामीटरों के प्रदर्शन को जाँचते हैं:
# Find the optimal parameters
m, b = stochastic_gradient_descent(train_xy[:, 0], train_xy[:, 1])
# Make predictions
y_preds = model(m, test_xy[:, 0], b)
# Compute and print the loss
mean_squared_error = loss(test_xy[:, 1], y_preds)
mean_squared_error ** 0.5
1595.3955619759456
MSE का वर्गमूल लगभग $1,600 है, यानी हमारा मॉडल औसतन $1,600 से चूक रहा है। त्रुटि में सुधार के लिए, हम epochs की संख्या बढ़ा सकते हैं या बड़ा डेटासेट इस्तेमाल कर सकते हैं।
पिछले खंड में SGD का जो इम्प्लिमेंटेशन हमने किया, वह प्राथमिक और अल्प-कुशल है। इसका उद्देश्य केवल हमारी बनाई हुई अंतर्दृष्टि को कोडिंग वॉकथ्रू के साथ मजबूत करना था।
व्यवहार में, आप लगभग कभी SGD को मैन्युअली रीइम्प्लिमेंट नहीं करते, बल्कि लोकप्रिय फ़्रेमवर्क्स में उपलब्ध संस्करणों का उपयोग करते हैं।
उदाहरण के लिए, Scikit-learn SGDRegressor और SGDClassifier इस्टीमेटर्स देता है, जिनसे आप विभिन्न ML एल्गोरिदम जैसे कि
को SGD को ऑप्टिमाइज़ेशन एल्गोरिदम के रूप में उपयोग करके प्रशिक्षित कर सकते हैं।
from sklearn.linear_model import SGDRegressor, SGDClassifier
# SGD for Linear Regression with 1000 epochs
regressor = SGDRegressor(loss='squared_loss', max_iter=1000)
PyTorch में, यह optim मॉड्यूल के भीतर SGD क्लास के रूप में उपलब्ध है:
import torch.optim as optim
optimizer = optim.SGD(model.parameters(), lr=0.01)
PyTorch में मॉडल ट्रेनिंग और उनका ऑप्टिमाइज़ेशन सीखने के लिए DataCamp के Introduction to PyTorch कोर्स को देखें।
Keras में, SGD इसी नाम से उपलब्ध है:
from tensorflow.keras.optimizers import SGD
optimizer = SGD(learning_rate=0.01)
TensorFlow में मॉडल ट्रेनिंग और उनका ऑप्टिमाइज़ेशन सीखने के लिए DataCamp के Introduction to TensorFlow कोर्स को देखें।
SGD या समान एल्गोरिदम का उपयोग करते समय कई श्रेष्ठ प्रथाएँ और सुझाव हैं। नीचे हम उनमें से कुछ बताते हैं:
आज, हमने मशीन लर्निंग के प्रमुख ऑप्टिमाइज़ेशन एल्गोरिदमों में से एक—Stochastic Gradient Descent—सीखा।
पहले, हमने साधारण ग्रेडिएंट डीसेंट एल्गोरिदम पर विचार करके इसकी अंतर्दृष्टि और बुनियादी विचार विकसित किए। हमने व्यापक रूप से पहाड़ी ढलान वाली उपमा का उपयोग किया, जहाँ हम आँखों पर पट्टी बाँधकर नीचे का बिंदु ढूँढने की कोशिश कर रहे हैं।
हमने सीखा कि SGD और साधारण GD में अंतर पैरामीटर अपडेट करने में इस्तेमाल किए गए डेटा पॉइंट्स की संख्या का है। अपनी अंतर्दृष्टि को पुख्ता करने और गणितीय विवरणों को समझने के लिए, हमने Numpy में SGD को इम्प्लिमेंट किया।
कृपया याद रखें कि SGD पूरे ML प्रशिक्षण प्रोसेस का केवल एक हिस्सा है। इसकी भूमिका के बारे में अधिक जानने के लिए निम्नलिखित संसाधन देखें:
शीर्ष DataCamp कोर्स
लर्निंग पाथ
लर्निंग पाथ
लर्निंग पाथ
