
Lộ trình
Chuyên gia Khoa học Học máy trong Python
85 giờ
Hãy tưởng tượng bạn đang cố tìm điểm thấp nhất giữa những ngọn đồi khi bị bịt mắt. Vì chỉ dựa vào xúc giác, bạn chỉ có thể cảm nhận mặt đất ngay xung quanh để xác định hướng đi xuống. Về bản chất, đó cũng là cách các thuật toán machine learning hoạt động khi chúng cố tìm lời giải tốt nhất cho một bài toán.
Chúng biểu diễn bài toán thành một hàm toán học với đầu vào và đầu ra tạo nên một bề mặt lồi lõm như đồi núi. Tìm giá trị nhỏ nhất của hàm này nghĩa là bạn đã đạt lời giải tốt nhất cho bài toán. Một trong những thuật toán phổ biến nhất để thực hiện quy trình này gọi là Stochastic Gradient Descent (SGD).
Trong hướng dẫn này, bạn sẽ học mọi điều cần biết về thuật toán, gồm trực giác ban đầu (không cần công thức), chi tiết toán học, và cách triển khai bằng Python.
Stochastic Gradient Descent (SGD) là một kỹ thuật tối ưu hóa dùng trong machine learning để giảm lỗi trong các mô hình dự báo. Khác với gradient descent thông thường sử dụng toàn bộ tập dữ liệu để tính gradient và cập nhật tham số, SGD cập nhật tham số chỉ với một điểm dữ liệu mỗi lần. Điều này giúp nhanh hơn và hiệu quả hơn với các tập dữ liệu lớn, dù có thể nhiễu và kém ổn định hơn. SGD giúp tìm các giá trị tối ưu cho tham số mô hình nhằm cải thiện độ chính xác của dự đoán.
Điều đầu tiên cần hiểu ngay là stochastic gradient descent (SGD) không phải là một thuật toán machine learning. Đúng hơn, nó chỉ là một kỹ thuật tối ưu hóa có thể áp dụng cho các thuật toán ML.
Vậy tối ưu hóa là gì? Để hiểu điều này, hãy bắt đầu từ giai đoạn phát biểu bài toán trong machine learning.
Giả sử chúng ta muốn dự đoán giá kim cương dựa trên trọng lượng carat (một carat là 0,2 gram). Đây là bài toán hồi quy vì mô hình tạo ra giá trị số.
Để giải bài toán, ta có nhiều thuật toán, nhưng hãy chọn Hồi quy tuyến tính đơn, với công thức đơn giản f(x) = mx + b trong đó:
b là giá cơ bản của kim cươngm là mức tăng giá theo mỗi caratx là giá trị carat của viên kim cươngf(x) là giá dự đoán của viên kim cươngPhương trình tuyến tính này là mô hình của ta. Mục tiêu là tìm giá trị tốt nhất cho m và b để dự đoán của mô hình chính xác nhất có thể trên toàn bộ tập dữ liệu kim cương.
Nếu có thêm một đặc trưng khác trong dữ liệu, như thể tích kim cương, công thức sẽ thành f(x1, x2) = m1*x1 + m2*x2 + b, trong đó:
b là giá cơ bản của kim cươngm1 là mức tăng giá theo mỗi caratm2 là mức tăng giá theo mỗi đơn vị thể tíchx1 là giá trị carat của viên kim cươngx2 là thể tích của viên kim cươngf(x) là giá dự đoán của viên kim cươngBây giờ, ta cần tìm các giá trị tối ưu cho m1, m2 và b.
Nhìn chung, mọi mô hình machine learning đều có các phương trình như trên với một hoặc nhiều tham số. Do đó, định nghĩa của tối ưu hóa trong ngữ cảnh này là: “Với mô hình và tập dữ liệu này, hãy tìm các giá trị tối ưu cho những tham số trong phương trình.”
Có nhiều thuật toán tối ưu hóa có thể thực hiện nhiệm vụ này, như Stochastic Gradient Descent — trọng tâm của hướng dẫn này. Nhưng để hiểu trọn vẹn cách SGD hoạt động, hãy điểm qua một số ý tưởng nền tảng đằng sau nó.
Để hiểu SGD, ta cần học thuật toán gradient descent thông thường (GD), vốn chia sẻ nhiều ý tưởng nền tảng với phiên bản ngẫu nhiên. Gradient descent đơn giản bắt đầu từ khái niệm lỗi trong machine learning.
Các thuật toán ML thường đoán đáp án đúng cho một bài toán. Chúng ta gọi đáp án đó là dự đoán và nó không phải lúc nào cũng chính xác. Vì vậy, ta đưa vào một thuật ngữ mới gọi là “lỗi” hay “mất mát”, biểu thị chênh lệch giữa đáp án thực và dự đoán của mô hình. Mục tiêu của chúng ta là xây dựng mô hình giảm thiểu lỗi này.
Nếu mô hình f(x) đoán $10.000 cho một viên kim cương thực tế có giá $12.000, thì lỗi là $2.000. Ta nên điều chỉnh mô hình để giảm lỗi này. Nhưng dự đoán của mô hình phải tốt cho mọi viên kim cương, không chỉ một. Vì vậy, ta cần cách tổng hợp lỗi trên toàn bộ tập dữ liệu. Đây là lúc các hàm chi phí xuất hiện.
Hàm chi phí gộp tất cả lỗi riêng lẻ thành một con số biểu thị hiệu năng tổng thể của mô hình. Chi phí tổng thể càng thấp nghĩa là dự đoán của mô hình càng tốt.
Hàm chi phí thay đổi tùy theo loại bài toán ta đang giải.
Trong các bài toán hồi quy, mô hình dự đoán giá trị số như giá một viên kim cương hay thời gian bơi một vòng. Trong phân loại, mô hình dự đoán hạng mục mà một đối tượng thuộc về. Ví dụ, nấm có ăn được hay không, hoặc đối tượng trong ảnh là mèo, chó hay ngựa?
Còn nhiều loại bài toán khác, nhưng điểm quan trọng là mỗi loại cần các hàm chi phí khác nhau. Trong hướng dẫn này, chúng ta sẽ tập trung vào Sai số bình phương trung bình (MSE), thường dùng trong hồi quy.
Chênh lệch giữa giá trị thực (ground truth) và dự đoán của mô hình được gọi là lỗi hoặc mất mát. Do đó, một hàm kết hợp tất cả các lỗi hay mất mát này được gọi là hàm lỗi, hàm mất mát, hoặc hàm chi phí. Các nguồn khác nhau có thể dùng thay thế cho nhau; từ đây, hướng dẫn sẽ dùng thuật ngữ hàm mất mát.
Trong các bài toán hồi quy, bạn thường thấy đồ thị vẽ giá trị thực (ground truth) so với dự đoán của mô hình.
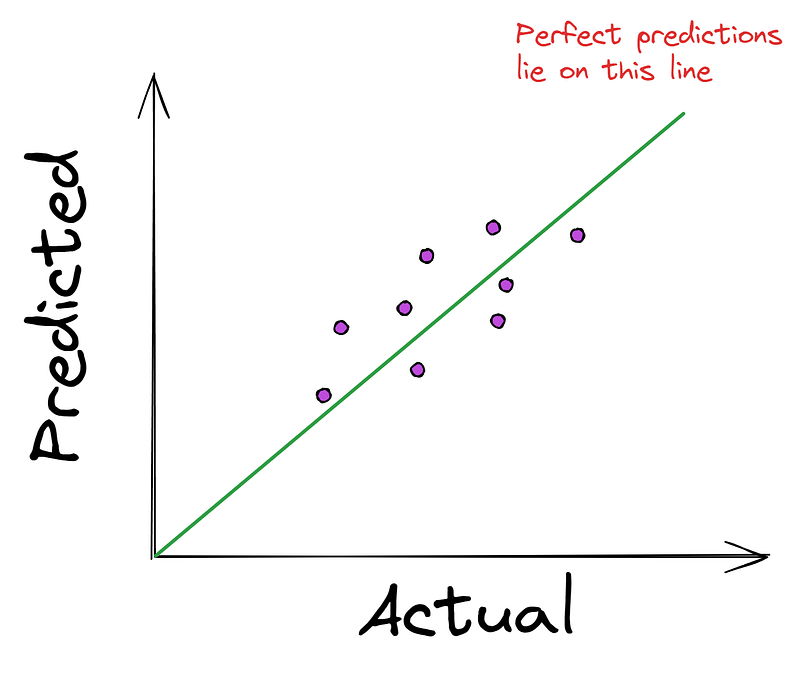
Các điểm càng gần đường thẳng, dự đoán của mô hình càng tốt. Do đó, hầu hết thuật toán hồi quy cố giảm khoảng cách trung bình từ các điểm tới đường hoàn hảo. Và như đã đề cập, việc tối thiểu hóa diễn ra nhờ một hàm chi phí như Sai số bình phương trung bình (MSE).
MSE nhận đầu vào là giá trị thực và dự đoán, và cho ra khoảng cách bình phương trung bình tới đường hoàn hảo.
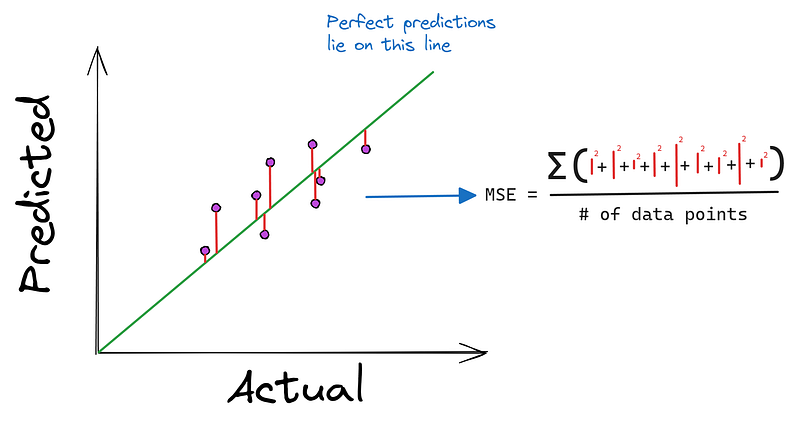
Bạn có thể hỏi “Tại sao lại bình phương chênh lệch thay vì lấy trị tuyệt đối?”. Lý do đầu tiên là rất dễ lấy đạo hàm của hàm bình phương. Ngoài ra, việc bình phương nhấn mạnh các lỗi lớn hơn, phạt mô hình nặng hơn cho các dự đoán tệ nhất.
Vì thế MSE được ưa chuộng hơn các hàm thay thế như Sai số tuyệt đối trung bình (MAE), vốn nhìn qua có vẻ đơn giản hơn nhưng khó vi phân hơn.
Mảnh ghép tiếp theo trong bài toán gradient descent chính là gradient. Hãy quay lại phép ẩn dụ “đi xuống đồi” để hiểu rõ hơn.
Ta đứng trên đỉnh đồi bị bịt mắt và muốn xuống chân đồi nhanh nhất. Nếu ta đổ nước ngay dưới chân, nó sẽ chảy theo hướng nào? Nó sẽ chảy xuống theo hướng dốc nhất.
Đó chính xác là điều gradient cho ta biết, nhưng theo hướng ngược lại. Gradient chỉ lên dốc — theo hướng tăng nhanh nhất. Khi ta đang cố tối thiểu hóa lỗi, ta chỉ việc đi theo hướng ngược với gradient để tìm lối xuống nhanh nhất.
Về mặt toán học, gradient cho biết đầu ra của một hàm thay đổi như thế nào khi ta thay đổi đầu vào. Cụ thể hơn, nó chỉ hướng mà hàm tăng nhanh nhất.
Trong bối cảnh machine learning, nơi ta cố giảm lỗi thông qua hàm mất mát, gradient trở thành kim chỉ nam giúp tìm đường giảm lỗi nhanh nhất.
Gradient được biểu diễn dưới dạng một vector — một phần tử cho mỗi tham số đầu vào của hàm. Mỗi con số trong vector này cho biết hàm sẽ thay đổi bao nhiêu nếu ta điều chỉnh một chút tham số tương ứng.
Vậy làm sao để tìm gradient của một hàm?
Với hàm một biến như f(x) = x ** 2, gradient là đạo hàm của hàm, được cho dưới dạng vector một phần tử - [2x].
Với hàm nhiều biến như f(x1, x2) = x1 ** 3 - x2 ** 2, gradient chứa các đạo hàm riêng của hàm theo từng đầu vào. Như vậy, với hàm thứ hai, vector gradient là [3x1 ** 2, 2*x2].
Quay lại MSE, với công thức sau:
MSE = (1/n) * Σ(y - f(x))² trong đó:
f(x) là mx + bm và b là biến của hàmx là giá trị carat của các viên kim cươngn là số lượng điểm dữ liệuy là giá thực tế của các viên kim cươngVì vậy, gradient của nó là các đạo hàm riêng của MSE theo m và b:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
The gradient = [∂/∂m (MSE), ∂/∂b (MSE)]
Đừng quá lo lắng về các công thức này. Ý chính là chúng cho ta biết MSE thay đổi thế nào nếu ta thay đổi m hoặc b một lượng rất nhỏ.
Giờ ta đã có mọi thứ cần để thực hiện gradient descent, hay nói cách khác, xuống chân đồi hiệu quả nhất có thể. Nhưng ta nên nhảy một bước dài hay đi những bước nhỏ? Ừm, điều đó do gradient quyết định, phải không? Độ lớn của gradient cho biết ta đi xa bao nhiêu ở mỗi bước.
Nhưng giả sử gradient quá lớn đến mức thay vì xuống tới chân đồi, ta vượt qua và rơi lên một ngọn đồi khác chỉ trong một bước. Điều này khá thường gặp trong gradient descent, nên ta đưa vào một tham số gọi là kích thước bước, giúp kiểm soát ảnh hưởng của gradient.
Trước khi bước, ta chỉ cần nhân gradient với kích thước bước, giúp giảm độ lớn của nó. Ví dụ, nếu gradient bảo ta đi một bước 3,56 xuống dốc, kích thước bước 0,1 biến quãng đường thành 0,356.
Sẽ mất lâu hơn để tới chân đồi nhưng giờ ta không còn rủi ro đi quá luôn điểm thấp nhất.
Tốc độ học là cách gọi thường dùng trong machine learning cho kích thước bước và thường nhận giá trị trong khoảng 0,001 đến 0,3.
Hãy xem phiên bản toán học của quy trình này.
Đầu tiên, ta gán ngẫu nhiên giá trị cho các tham số m và b của mô hình:
m = 0.215  # Generated randomly
b = 0.059
Dùng các giá trị này, ta tính MSE ban đầu trên toàn bộ dữ liệu:
MSE = (1/n) * Σ(y - (0.215 * x + 0.059))² = ...Giờ, để giảm lỗi này, ta cần đi một bước nhỏ theo hướng ngược với gradient, hay nói cách khác, ta cần cập nhật m và b bằng gradient và tốc độ học:
m_new = 0.215 - alpha * (∂/∂m (MSE))
b_new = 0.059 - alpha * (∂/∂b (MSE))
Phần lớn tài liệu ký hiệu tốc độ học là alpha hoặc α (chữ cái Hy Lạp).
Sau khi có giá trị mới cho m và b, ta tính lại MSE:
MSE_new = (1/n) * Σ(y - (m_new * x + b_new))²Giờ, ta lại tính gradient và tiếp tục như vậy cho đến khi đạt điều kiện dừng.
Tìm hiểu trực quan cách tốc độ học ảnh hưởng đến quá trình huấn luyện bằng cách xem bài viết về gradient descent này.
Vì bị bịt mắt, ta không thật sự thấy khi nào đã tới chân đồi, nhất là khi đi những bước nhỏ.
Vì vậy, ta cần một số điều kiện để dừng lại. Thông thường dùng các quy tắc sau:
Những quy tắc này do bạn, kỹ sư ML, thiết lập khi thực hiện gradient descent. Các triển khai Python thường có tham số để đặt các quy tắc này và ta sẽ thấy một số sau đây.
Ưu điểm:
Thách thức:
Ở phần tiếp theo, ta sẽ xem cách Stochastic Gradient Descent giải quyết một số thách thức này, đặc biệt với tập dữ liệu lớn.
Khi bạn đã nắm gradient descent thông thường, SGD trở nên rất dễ hiểu.
Dù gradient descent là một trong những thuật toán tối ưu hóa tao nhã nhất, nó có một bất lợi lớn khi xử lý các tập dữ liệu lớn. Hãy nhớ rằng ở mỗi bước, ta tính gradient bằng mọi điểm dữ liệu trong tập:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
Ở đây, x và y là các mảng chứa mọi giá trị carat và giá thực tế của kim cương. Điều này có nghĩa ta dùng thông tin của từng viên kim cương để cập nhật tham số ở mỗi bước.
Bạn có thể hình dung, điều này tốn kém về tính toán và thời gian khi có hàng triệu điểm dữ liệu. Trong thời đại dữ liệu lớn, hạn chế này có thể khiến gradient descent thông thường không thực tế cho nhiều bài toán ML ngoài đời thực.
“Stochastic” nghĩa là “được xác định ngẫu nhiên”, và đó chính là điều SGD làm: đưa tính ngẫu nhiên vào quá trình tối ưu hóa.
Thay vì dùng tất cả điểm dữ liệu để tính gradient, SGD chọn ngẫu nhiên một điểm dữ liệu ở mỗi bước. Nó dùng điểm đơn lẻ này để ước lượng gradient và cập nhật tham số.
Vì chỉ xét một điểm dữ liệu mỗi lần, SGD có thể cập nhật tham số thường xuyên hơn. Điều này giúp nó di chuyển trên bề mặt lỗi (sườn đồi) nhanh hơn, đặc biệt với dữ liệu lớn.
Tuy nhiên, tốc độ này phải đánh đổi. Vì ta dùng một điểm dữ liệu đơn lẻ để ước lượng gradient của toàn bộ tập, ước lượng của ta nhiễu hơn nhiều. Điều này khiến đường đi xuống bề mặt lỗi kém mượt mà và chao đảo hơn.
Để thực hiện SGD, trước tiên ta định nghĩa một hàm chi phí ngẫu nhiên.
Thay vì tính MSE trên toàn bộ dữ liệu, giờ ta xét sai số bình phương cho một điểm được chọn ngẫu nhiên:
Cost = (y - f(x))²Trong đó y là giá thực tế của viên kim cương được chọn ngẫu nhiên, và f(x) = mx + b là giá dự đoán của ta cho viên đó.
Sau đó, ta tính gradient ngẫu nhiên của hàm chi phí này theo các tham số m và b:
∂/∂m (Cost) = -2x(y - (mx + b))
∂/∂b (Cost) = -2(y - (mx + b))
The stochastic gradient = [∂/∂m (Cost), ∂/∂b (Cost)]
Dùng gradient ngẫu nhiên này, ta cập nhật tham số giống như trong gradient descent thông thường:
m_new = m_old - learning_rate * ∂/∂m (Cost)
b_new = b_old - learning_rate * ∂/∂b (Cost)
Ý tưởng then chốt trong SGD là mỗi bước chỉ liên quan đến một điểm dữ liệu được chọn ngẫu nhiên. Các quy tắc dừng vẫn giữ nguyên như gradient descent thông thường.
Trong thực tế, SGD thuần túy — nơi cập nhật tham số sau mỗi ví dụ huấn luyện — hiếm khi được dùng. Lý do là các cập nhật của thuật toán có phương sai quá cao, có thể khiến hàm mất mát dao động, khó hội tụ về đúng cực tiểu.
Gradient descent thông thường mạnh và ổn định hơn, nhưng như đã nói, nó dùng toàn bộ dữ liệu ở mỗi bước, khiến nó không thực tế với các tập dữ liệu hiện nay.
Để cân bằng giữa ổn định và tốc độ, mini-batch gradient descent thường được dùng, đặc biệt trong mạng nơ-ron. Trong mini-batch GD, thay vì dùng một mẫu ngẫu nhiên, một lô mẫu được dùng khi cập nhật tham số. Kích thước lô thường gặp gồm 16, 32, 64, v.v.
Vì vậy, nếu kích thước lô của bạn là 1, thì đó là SGD. Nếu kích thước lô bằng kích thước tập dữ liệu, bạn có gradient descent thông thường. Bất kỳ kích thước lô nào khác hai giá trị đó sẽ cho bạn mini-batch gradient descent.
Dưới đây là bảng tóm tắt sự khác nhau và khi nào dùng mỗi loại:
| Loại | Tần suất cập nhật | Hiệu quả tính toán | Yêu cầu bộ nhớ | Độ ổn định hội tụ | Trường hợp dùng tốt nhất |
| Gradient Descent (GD) | Toàn bộ tập dữ liệu mỗi lần cập nhật | Chậm nhất do dùng toàn bộ dữ liệu | Cần nạp toàn bộ dữ liệu vào bộ nhớ | Ổn định nhất, nhưng chậm nhất | Tập dữ liệu nhỏ, yêu cầu tính ổn định cao |
| Stochastic Gradient Descent (SGD) | Một ví dụ mỗi lần cập nhật | Nhanh nhất, xử lý từng ví dụ một | Nhu cầu bộ nhớ thấp | Phương sai cao, có thể dao động | Tập dữ liệu lớn cần cập nhật nhanh |
| Mini-Batch Gradient Descent | Một lô ví dụ mỗi lần cập nhật | Cân bằng hiệu quả và tốc độ, hiệu quả hơn GD, chậm hơn SGD | Cần bộ nhớ cho một lô | Ổn định hơn SGD, kém ổn định hơn GD | Tập dữ liệu lớn cần cân bằng giữa ổn định và hiệu quả |
Một khái niệm quan trọng trong mọi thuật toán tối ưu là epoch. Nó ám chỉ một lượt đi qua toàn bộ tập dữ liệu huấn luyện.
Trong một epoch, thuật toán xử lý mỗi mẫu trong tập huấn luyện đúng một lần. Với mỗi mẫu (hoặc mini-batch), mô hình đưa ra dự đoán, tính mất mát và cập nhật trọng số theo gradient của mất mát. Một epoch đánh dấu một chu kỳ cải thiện của mô hình. Sau mỗi epoch, bạn thường có thể quan sát hiệu năng mô hình thay đổi ra sao.
Quá trình huấn luyện thường gồm nhiều epoch (khuyến nghị ít nhất 10). Số epoch là một siêu tham số bạn có thể điều chỉnh. Thông thường, dữ liệu được xáo trộn trước mỗi epoch để tránh mô hình học theo thứ tự của các ví dụ huấn luyện.
Trong phép ẩn dụ khám phá đồi núi khi bị bịt mắt, một epoch là một lượt khám phá toàn cảnh địa hình. Trong mỗi epoch, bạn:
Sau mỗi lần khám phá toàn bộ, bạn bắt đầu lại từ vị trí mới. Nhiều epoch cho mô hình thêm cơ hội khám phá bề mặt mất mát, cải thiện khả năng tìm được một cực tiểu tốt.
Tuy nhiên, nhiều epoch không đảm bảo tìm được cực tiểu toàn cục, và toàn bộ quá trình có thể bị ảnh hưởng bởi các yếu tố như điểm khởi đầu hay độ phức tạp của bề mặt mất mát.
Trong phần này, ta sẽ triển khai SGD có hỗ trợ kích thước lô (mini-batch GD) chỉ với Numpy.
Đầu tiên, hãy nhập các thư viện cần thiết:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
Ta sẽ dùng 10.000 điểm dữ liệu từ bộ Diamonds có trong Seaborn. Ta chỉ lấy đặc trưng carat và cột price làm mục tiêu:
# Load the data
dataset_size = 10_000
diamonds = sns.load_dataset('diamonds')
# Extract the target and the feature
xy = diamonds[['carat', 'price']].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
(10000, 2)
Giờ hãy chia dữ liệu thành tập huấn luyện và kiểm tra, với kích thước train là 80% tổng số.
# Split the data
np.random.shuffle(xy)
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(8000, 2)
Tiếp theo, định nghĩa hàm mô hình:
def model(m, x, b):
   """Simple linear model"""
   return m * x + b
Ta đang thực hiện hồi quy tuyến tính đơn với chỉ hai biến độc lập m và b.
Ta cũng nên định nghĩa hàm mất mát MSE:
def loss(y_true, y_pred):
   """Mean squared error"""
   return np.mean((y_true - y_pred) ** 2)
Giờ, ta định nghĩa hàm gọi là stochastic_gradient_descent nhận sáu đối số:
x và y biểu diễn đặc trưng đơn và mục tiêu trong bài toán của taepochs chỉ số lần ta muốn thực hiện descent (sẽ nói thêm sau)learning_rate là kích thước bướcbatch_size để kiểm soát tần suất cập nhật tham sốstopping_threshold đặt mức tối thiểu mà mất mát phải giảm ở mỗi bướcdef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""Bắt đầu bằng việc khởi tạo ngẫu nhiên các tham số cần tối ưu và đặt mất mát là vô cùng:
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infSau đó, ta bắt đầu một vòng lặp for dùng tham số epochs. Bên trong vòng lặp, ta xáo trộn dữ liệu để việc tính toán vững hơn:
for i in range(epochs):
# Shuffle the data
indices = np.random.permutation(n)
x = x[indices]
y = y[indices]Tiếp đến, việc tính gradient thực sự bắt đầu trong một vòng lặp for khác.
for j in range(0, n, batch_size):
x_batch = x[j:j + batch_size]
y_batch = y[j:j + batch_size]Ta trích xuất lô từ x và y và tính gradient:
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)Ta dùng hàm model đã tạo ở trên để dự đoán với các giá trị hiện tại của m và b. Sau đó, ta tìm các đạo hàm riêng cấu thành gradient theo công thức đã nêu ở phần trước.
Dùng các đạo hàm riêng và tốc độ học, ta cập nhật tham số:
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientĐây là toàn bộ mã cho đến lúc này:
def stochastic_gradient_descent(
   x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
   """
   SGD with support for mini-batches.
   """
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x)
previous_loss = np.inf
for i in range(epochs):
   # Shuffle the data
   indices = np.random.permutation(n)
   x = x[indices]
   y = y[indices]
for j in range(0, n, batch_size):
   x_batch = x[j:j + batch_size]
   y_batch = y[j:j + batch_size]
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientTiếp tục hàm ở bên ngoài vòng lặp trong, ta tính mất mát cho epoch:
# Compute the loss
y_pred = model(m, x, b)
current_loss = loss(y, y_pred)
Nếu current_loss nhỏ hơn stopping_threshold ta dừng toàn bộ quy trình:
if previous_loss - current_loss < stopping_threshold:
   break
previous_loss = current_loss
Nếu không, ta gán previous_loss bằng current_loss. Cuối cùng, ta trả về các tham số m và b đã được tối ưu:
return m, bTôi đã dán toàn bộ mã vào GitHub gist này để bạn có thể xem tổng thể.
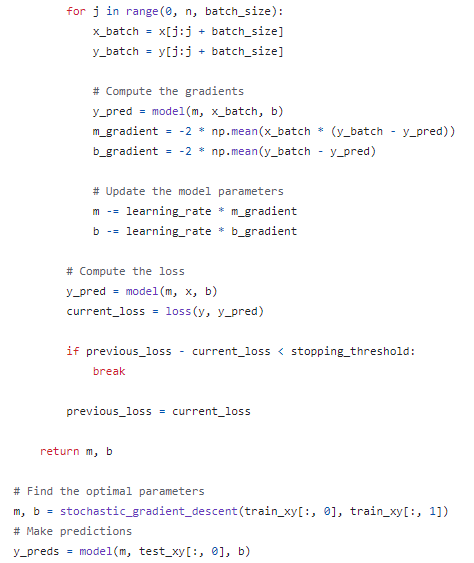
Hãy kiểm thử các tham số tìm được bằng cách chạy mô hình trên tập kiểm tra:
# Find the optimal parameters
m, b = stochastic_gradient_descent(train_xy[:, 0], train_xy[:, 1])
# Make predictions
y_preds = model(m, test_xy[:, 0], b)
# Compute and print the loss
mean_squared_error = loss(test_xy[:, 1], y_preds)
mean_squared_error ** 0.5
1595.3955619759456
Căn bậc hai của MSE vào khoảng $1.600, nghĩa là mô hình của ta lệch trung bình $1.600. Để cải thiện lỗi, ta có thể tăng số epoch hoặc dùng tập dữ liệu lớn hơn.
Triển khai SGD ở phần trước còn thô và kém hiệu quả. Nó chỉ nhằm củng cố trực giác đã xây dựng qua phần đi kèm mã.
Trong thực tiễn, bạn hầu như không tự viết lại SGD mà dùng các phiên bản có sẵn trong các framework phổ biến.
Ví dụ, Scikit-learn cung cấp các estimator SGDRegressor và SGDClassifier để huấn luyện nhiều thuật toán ML như:
với SGD là thuật toán tối ưu hóa.
from sklearn.linear_model import SGDRegressor, SGDClassifier
# SGD for Linear Regression with 1000 epochs
regressor = SGDRegressor(loss='squared_loss', max_iter=1000)
Trong PyTorch, nó có sẵn dưới dạng lớp SGD trong mô-đun optim:
import torch.optim as optim
optimizer = optim.SGD(model.parameters(), lr=0.01)
Để học cách huấn luyện và tối ưu mô hình trong PyTorch, tham khảo khóa Introduction to PyTorch của DataCamp.
Trong Keras, SGD có sẵn với cùng tên:
from tensorflow.keras.optimizers import SGD
optimizer = SGD(learning_rate=0.01)
Để học cách huấn luyện và tối ưu mô hình trong TensorFlow, tham khảo khóa Introduction to TensorFlow của DataCamp.
Có nhiều thực hành tốt và mẹo khi dùng SGD hay các thuật toán tương tự. Dưới đây là một số điểm:
Hôm nay, chúng ta đã học một trong những thuật toán tối ưu chủ chốt trong machine learning — Stochastic Gradient Descent.
Đầu tiên, ta xây dựng trực giác và các ý tưởng nền tảng bằng cách xét thuật toán gradient descent thông thường. Ta dùng nhiều phép ẩn dụ sườn đồi nơi ta cố tìm điểm thấp nhất khi bị bịt mắt.
Ta đã học rằng SGD và GD thông thường khác nhau ở lượng điểm dữ liệu dùng để cập nhật tham số. Để củng cố trực giác và làm rõ chi tiết toán học, ta đã triển khai SGD bằng Numpy.
Hãy nhớ rằng SGD chỉ là một phần của toàn bộ quy trình huấn luyện ML. Để tìm hiểu thêm về vai trò của nó, xem các tài nguyên sau:
Các khóa học hàng đầu của DataCamp
Lộ trình
Lộ trình
Lộ trình
blog
Matt Crabtree
10 phút
