Cours
Introduction à Tidyverse
4 h
395.3K
Ce tutoriel est la retranscription d’un Facebook Live que nous avons animé il y a une semaine. Le thème : « Introduction au Tidyverse ». Ce pas-à-pas reprend tout le contenu que nous avons couvert pendant la session de code en direct.
Vous pouvez regarder la première partie de la session ici :
Et la seconde partie ici :
Remarque : vous trouverez tout le code de la session dans ce dépôt.
Le noyau du tidyverse inclut les packages que vous utiliserez au quotidien en analyse de données, comme ggplot2 pour la visualisation et dplyr pour la manipulation de données. Ce tutoriel se concentre sur ces deux outils.
À retenir : un package est un ensemble d’outils pour travailler vos données. Pour en savoir plus sur les packages R, consultez ce tutoriel.
Pour aller plus loin avec le Tidyverse, découvrez le cours de David Robinson Introduction to Tidyverse sur DataCamp et les ressources Learn the Tidyverse.
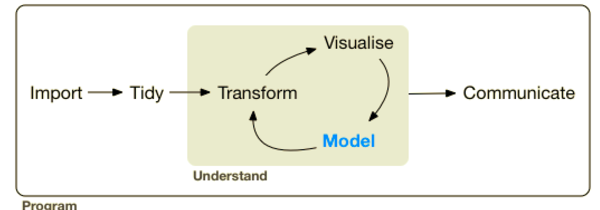
Commencez par installer le tidyverse si ce n’est pas déjà fait :
# Install the tidyverse
# install.packages("tidyverse")
Maintenant que le tidyverse est installé, chargez vos données et examinez quelques observations.
Dans ce tutoriel, vous allez explorer le jeu de données Titanic, où chaque observation correspond à une personne et chaque variable à une caractéristique comme Name, Age et Survived (ou non).
Chargez vos données comme suit :
 # Import the Tidyverse
library(tidyverse)

# Import data
passengers <- read.csv("data/train.csv")

# Check out the first several observations of your dataframe
passengers

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6     0           330877  8.4583              Q
Remarque : le chemin de fichier passé à read.csv() peut varier selon votre configuration. Pour conserver le même chemin, référez-vous à l’arborescence du projet dans notre dépôt GitHub, disponible ici.
Notez aussi que si vous souhaitez en savoir plus sur les variables affichées en exécutant passengers, consultez la description du jeu de données.
Pour obtenir une vue d’ensemble, utilisez la fonction summary() :
# Summarize titanic
summary(passengers)

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
##  (Other)    :186
Faites la même chose en utilisant un pipe %>%, l’un des outils les plus pratiques du tidyverse :
# Summarize titanic using a pipe
passengers %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
##  (Other)    :186
Astuce : pour en savoir plus sur l’opérateur pipe en R, consultez ce tutoriel.
Refaites l’exercice après avoir supprimé les observations avec des valeurs manquantes. Indice : vous pouvez chaîner les pipes !
# Summarize titanic after dropping na
passengers %>%
  drop_na() %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:222.2   1st Qu.:0.0000   1st Qu.:1.000
##  Median :445.0   Median :0.0000   Median :2.000
##  Mean   :448.6   Mean   :0.4062   Mean   :2.237
##  3rd Qu.:677.8   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:261   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :453   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :708
##      SibSp            Parch                 Ticket         Fare
##  Min.   :0.0000   Min.   :0.0000   347082      :  7   Min.   :  0.00
##  1st Qu.:0.0000   1st Qu.:0.0000   3101295     :  6   1st Qu.:  8.05
##  Median :0.0000   Median :0.0000   347088      :  6   Median : 15.74
##  Mean   :0.5126   Mean   :0.4314   CA 2144     :  6   Mean   : 34.69
##  3rd Qu.:1.0000   3rd Qu.:1.0000   382652      :  5   3rd Qu.: 33.38
##  Max.   :5.0000   Max.   :6.0000   S.O.C. 14879:  5   Max.   :512.33
##                                    (Other)     :679
##          Cabin     Embarked
##             :529    :  2
##  B96 B98    :  4   C:130
##  C23 C25 C27:  4   Q: 28
##  G6         :  4   S:554
##  C22 C26    :  3
##  D          :  3
##  (Other)    :167
Vous avez peut-être remarqué la cohérence stylistique du code ci-dessus. C’est parce que vous suivez un guide de style. En data science et en programmation, il est important d’adopter rapidement un guide de style. Comme l’écrit Hadley Wickham dans le guide de style du tidyverse :
Une bonne hygiène de code, c’est comme une ponctuation correcte : on peut s’en passer, maisçafaitquandmêmelalecturebeaucoupplusfluide.
Dans la section suivante, vous allez manipuler vos données avec dplyr pour les filtrer, les trier et créer de nouvelles variables à partir des existantes.
Il est temps d’explorer vos données et d’en tirer des premiers enseignements. Vous utiliserez les verbes dplyr tels que filter(), arrange() et mutate(), qui font exactement ce qu’ils annoncent.
Supposons que vous vouliez sélectionner un sous-ensemble d’observations, par exemple celles dont la variable « Sex » vaut « female ». dplyr le permet de façon intuitive, dans un langage qui reflète votre manière de penser et de parler des données.
Le verbe filter conserve uniquement les observations qui satisfont la condition. Démonstration :
# Filter to get all "male" rows
passengers %>%
  filter(Sex == "male")

##   PassengerId Survived Pclass                           Name  Sex Age
## 1           1        0      3        Braund, Mr. Owen Harris male  22
## 2           5        0      3       Allen, Mr. William Henry male  35
## 3           6        0      3               Moran, Mr. James male  NA
## 4           7        0      1        McCarthy, Mr. Timothy J male  54
## 5           8        0      3 Palsson, Master. Gosta Leonard male   2
## 6          13        0      3 Saundercock, Mr. William Henry male  20
##   SibSp Parch    Ticket    Fare Cabin Embarked
## 1     1     0 A/5 21171  7.2500              S
## 2     0     0    373450  8.0500              S
## 3     0     0    330877  8.4583              Q
## 4     0     0     17463 51.8625   E46        S
## 5     3     1    349909 21.0750              S
## 6     0     0 A/5. 2151  8.0500              S
À la lecture du résultat, on constate que beaucoup d’hommes n’ont pas survécu au naufrage du RMS Titanic. C’est intéressant, et vous explorerez ce point plus rigoureusement un peu plus loin.
Remarque : vous pouvez lire le code dplyr comme une phrase : prenez vos données puis (%>%) filtrez-les selon la condition « Sex est male ». Le code présenté ci-dessus ne modifie pas le data frame d’origine. filter(Sex = "male") est une erreur courante (Hugo l’a faite aussi !) ; consultez ce guide des erreurs tidyverse.
# Filter to get all "female" rows
passengers %>%
  filter(Sex == "female")

##   PassengerId Survived Pclass
## 1           2        1      1
## 2           3        1      3
## 3           4        1      1
## 4           9        1      3
## 5          10        1      2
## 6          11        1      3
##                                                  Name    Sex Age SibSp
## 1 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 2                              Heikkinen, Miss. Laina female  26     0
## 3        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 4   Johnson, Mrs. Oscar W (Elisabeth Vilhelmina Berg) female  27     0
## 5                 Nasser, Mrs. Nicholas (Adele Achem) female  14     1
## 6                     Sandstrom, Miss. Marguerite Rut female   4     1
##   Parch           Ticket    Fare Cabin Embarked
## 1     0         PC 17599 71.2833   C85        C
## 2     0 STON/O2. 3101282  7.9250              S
## 3     0           113803 53.1000  C123        S
## 4     2           347742 11.1333              S
## 5     0           237736 30.0708              C
## 6     1          PP 9549 16.7000    G6        S
De façon anecdotique au moins, les femmes semblent avoir eu de meilleures chances de survie.
Lors de l’exploration, posez-vous des questions et essayez d’y répondre au mieux. Par exemple, vous pouvez arrange() vos observations par Fare croissant pour déceler des tendances. Utilisez le verbe arrange() :
# Arrange by increasing Fare
passengers %>%
  arrange(Fare)

##   PassengerId Survived Pclass                            Name  Sex Age
## 1         180        0      3             Leonard, Mr. Lionel male  36
## 2         264        0      1           Harrison, Mr. William male  40
## 3         272        1      3    Tornquist, Mr. William Henry male  25
## 4         278        0      2     Parkes, Mr. Francis "Frank" male  NA
## 5         303        0      3 Johnson, Mr. William Cahoone Jr male  19
## 6         414        0      2  Cunningham, Mr. Alfred Fleming male  NA
##   SibSp Parch Ticket Fare Cabin Embarked
## 1     0     0   LINE    0              S
## 2     0     0 112059    0   B94        S
## 3     0     0   LINE    0              S
## 4     0     0 239853    0              S
## 5     0     0   LINE    0              S
## 6     0     0 239853    0              S
Beaucoup de personnes ayant payé peu n’ont pas survécu au naufrage. C’est une observation intéressante permise par un simple tri.
Vous pouvez aussi arrange par Fare décroissant :
# Arrange by decreasing Fare
passengers %>%
  arrange(desc(Fare))

##   PassengerId Survived Pclass                               Name    Sex
## 1         259        1      1                   Ward, Miss. Anna female
## 2         680        1      1 Cardeza, Mr. Thomas Drake Martinez   male
## 3         738        1      1             Lesurer, Mr. Gustave J   male
## 4          28        0      1     Fortune, Mr. Charles Alexander   male
## 5          89        1      1         Fortune, Miss. Mabel Helen female
## 6         342        1      1     Fortune, Miss. Alice Elizabeth female
##   Age SibSp Parch   Ticket     Fare       Cabin Embarked
## 1  35     0     0 PC 17755 512.3292                    C
## 2  36     0     1 PC 17755 512.3292 B51 B53 B55        C
## 3  35     0     0 PC 17755 512.3292        B101        C
## 4  19     3     2    19950 263.0000 C23 C25 C27        S
## 5  23     3     2    19950 263.0000 C23 C25 C27        S
## 6  24     3     2    19950 263.0000 C23 C25 C27        S
On observe effectivement davantage de survivants parmi les tarifs les plus élevés.
Il peut aussi être utile de créer de nouvelles variables. Vous savez que Parch indique le nombre de parents et enfants, et SibSp le nombre de frères/sœurs et conjoints. En les additionnant, vous obtenez une nouvelle variable FamSize. C’est de l’ingénierie de variables, cruciale en apprentissage automatique.
Pour créer cette nouvelle variable, vous mutate() les variables d’origine.
# Create new column FamSize (size of family)
passengers %>%
  mutate(FamSize = Parch + SibSp)

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked FamSize
## 1     0        A/5 21171  7.2500              S       1
## 2     0         PC 17599 71.2833   C85        C       1
## 3     0 STON/O2. 3101282  7.9250              S       0
## 4     0           113803 53.1000  C123        S       1
## 5     0           373450  8.0500              S       0
## 6     0           330877  8.4583              Q       0
Remarque : mutate() sert à créer de nouvelles colonnes ou à modifier des colonnes existantes, un peu comme une « mutation » en biologie. L’analogie n’est pas parfaite, mais elle éclaire le choix du verbe.
Avec cette variable supplémentaire, vous pouvez poser d’autres questions : « Est-il possible que les familles nombreuses aient un taux de survie plus faible ? »
Pour tester cette hypothèse, créez FamSize comme somme de Parch et SibSp comme ci-dessus, puis triez par FamSize décroissant :
# Create new column FamSize (size of family)
# Arrange by decreasing FamSize
passengers %>%
  mutate(FamSize = Parch + SibSp) %>%
  arrange(desc(FamSize))

##   PassengerId Survived Pclass                         Name    Sex Age
## 1         160        0      3   Sage, Master. Thomas Henry   male  NA
## 2         181        0      3 Sage, Miss. Constance Gladys female  NA
## 3         202        0      3          Sage, Mr. Frederick   male  NA
## 4         325        0      3     Sage, Mr. George John Jr   male  NA
## 5         793        0      3      Sage, Miss. Stella Anna female  NA
## 6         847        0      3     Sage, Mr. Douglas Bullen   male  NA
##   SibSp Parch   Ticket  Fare Cabin Embarked FamSize
## 1     8     2 CA. 2343 69.55              S      10
## 2     8     2 CA. 2343 69.55              S      10
## 3     8     2 CA. 2343 69.55              S      10
## 4     8     2 CA. 2343 69.55              S      10
## 5     8     2 CA. 2343 69.55              S      10
## 6     8     2 CA. 2343 69.55              S      10
Tous les membres de la famille en tête de liste n’ont pas survécu ! C’est parlant : peut-être que faire partie d’une famille nombreuse compliquait l’évacuation à temps.
Cependant, comme les zéros et les uns sont peu parlants, remplacez les valeurs numériques de Survived par des chaînes No et Yes (et créez un nouveau data frame) :
# Turn numerical values of Survived column to "No" & "Yes" (new data frame)
passengers1 <- passengers %>%
  mutate(Survived = ifelse(Survived == 0, "No", "Yes"))
passengers1

##   PassengerId Survived Pclass
## 1           1       No      3
## 2           2      Yes      1
## 3           3      Yes      3
## 4           4      Yes      1
## 5           5       No      3
## 6           6       No      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6 0 330877 8.4583 QPour tracer avec ggplot2, vous spécifiez trois éléments :
Commencez par un diagramme en barres de Sex pour voir combien d’hommes et de femmes étaient enregistrés à bord du Titanic :
# Plot barplot of passenger Sex
ggplot(passengers, aes(x = Sex)) +
  geom_bar()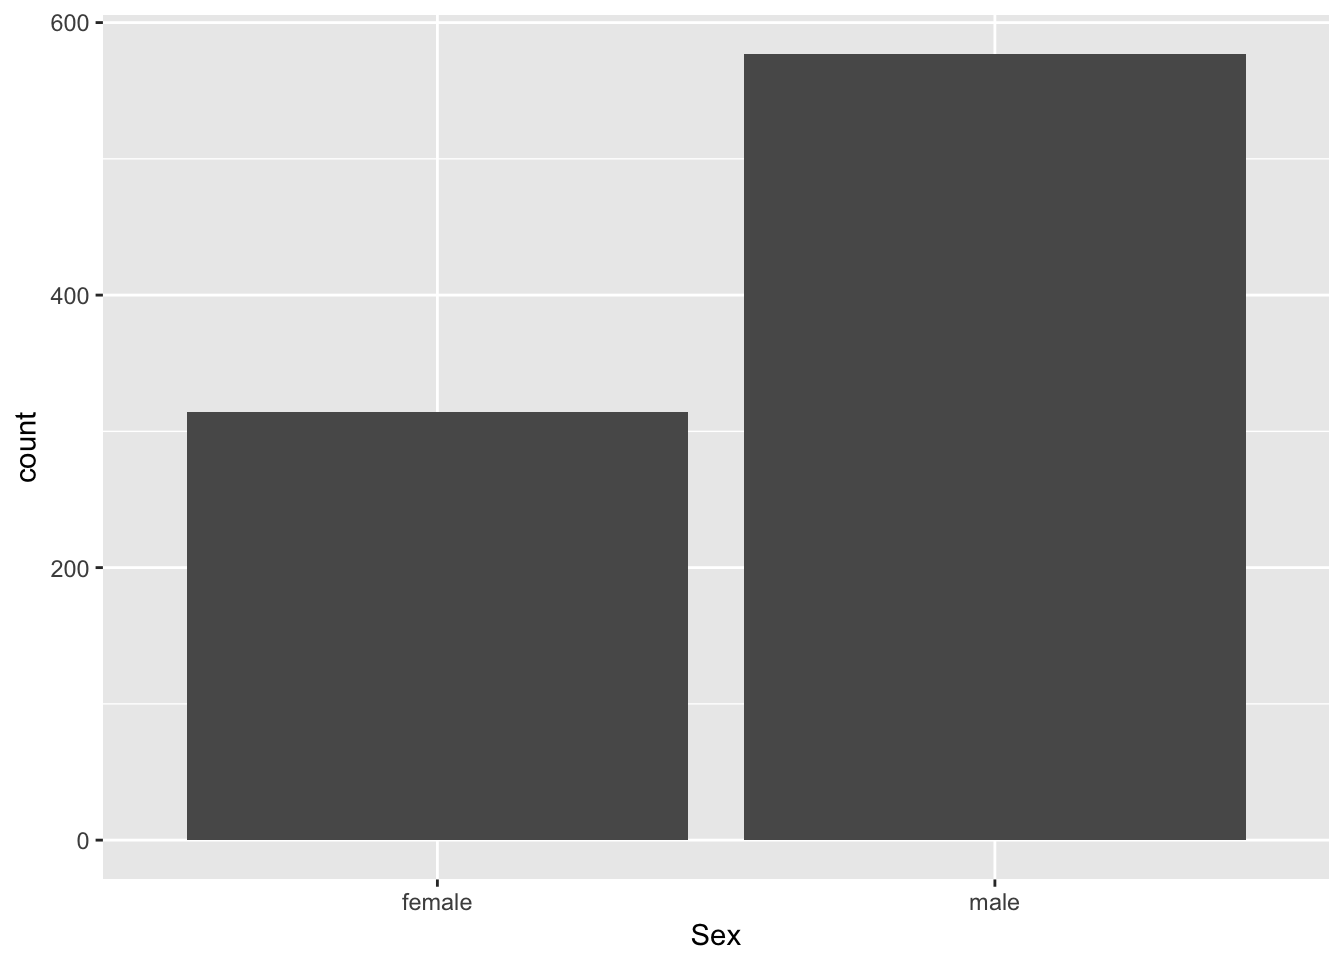
On observe qu’environ 600 hommes et 300 femmes se trouvaient à bord du RMS Titanic.
Remarque : la fonction aes() sert à faire correspondre les aesthétiques du graphique aux variables des données. Voir Modern Dive de Chester Ismay & Albert Y. Kim pour aller plus loin.
Passons aux nuages de points. L’Age d’un passager est-il corrélé au Fare qu’il a payé ?
# Scatter plot of Age vs Fare
ggplot(passengers, aes(x = Age, y = Fare)) +
  geom_point()

## Warning: Removed 177 rows containing missing values (geom_point).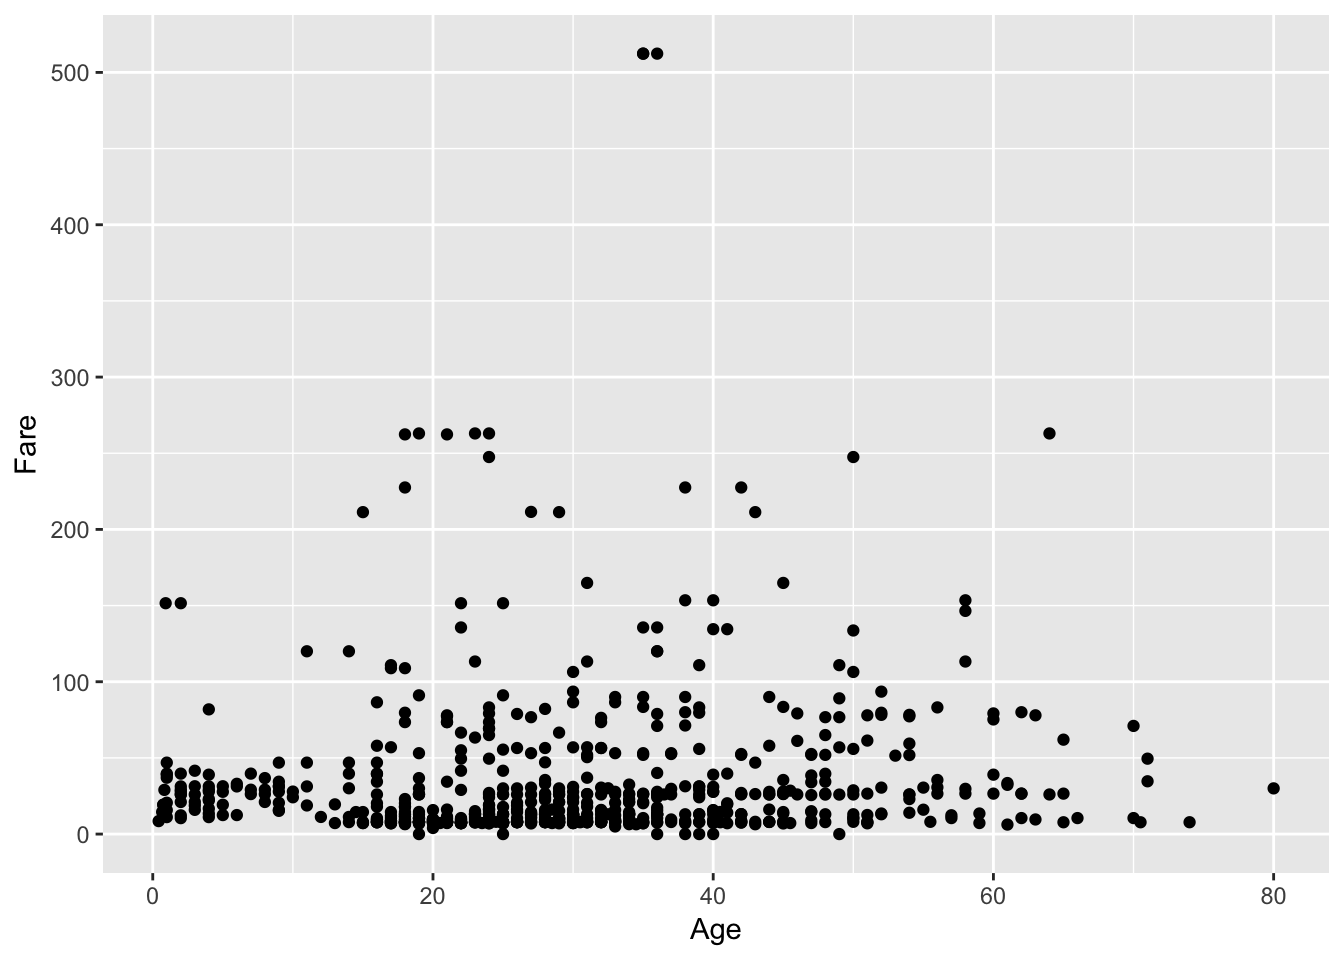
Ce seul graphique livre déjà de bonnes informations : nombre de personnes ayant payé cher étaient aussi sensiblement plus âgées. Le tarif augmentait peut-être avec l’âge… Vous voyez aussi immédiatement deux valeurs extrêmes en haut du graphique, à étudier plus en détail.
Le code ggplot2 se lit comme une phrase, tout comme celui de dplyr : « Vous prenez les données titanic, vous mappez Age sur l’axe x et Fare sur l’axe y, puis vous ajoutez les points comme couche du graphique. »
Reprenons le graphique précédent et colorons chaque point par Sex pour voir d’éventuelles corrélations entre Sex, Age et Fare :
# Scatter plot of Age vs Fare colored by Sex
ggplot(passengers %>% drop_na(), aes(x = Age, y = Fare, color = Sex)) +
  geom_point()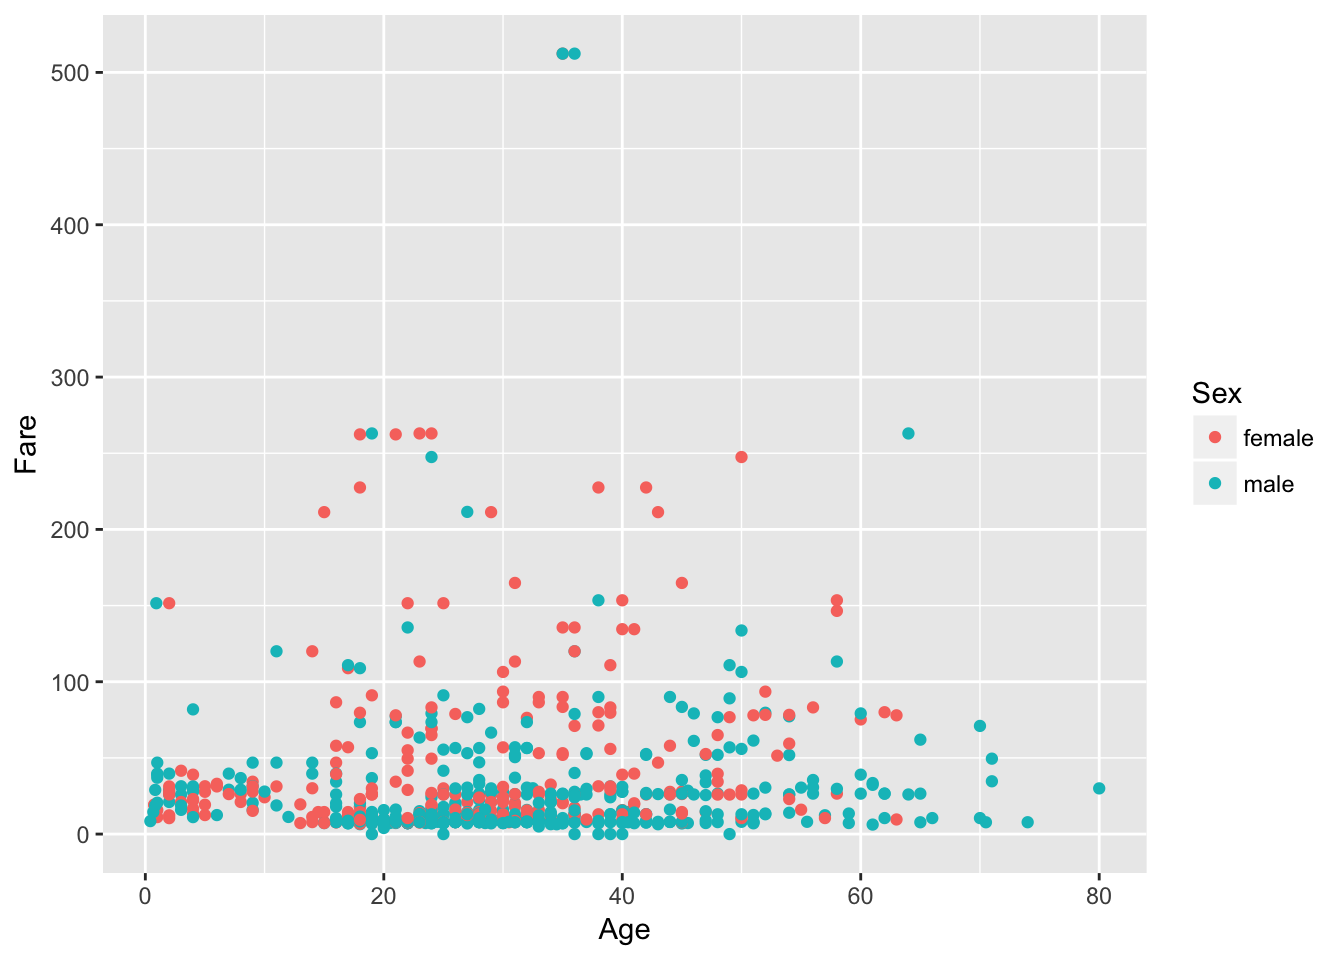
On voit que beaucoup d’hommes se situent en bas (tarifs faibles). On observe aussi un groupe de femmes vers le haut, légèrement plus âgées et ayant payé plus cher pour embarquer.
Visualiser trois variables (deux numériques, Age et Fare, et une catégorielle, Sex) sur un seul graphique, c’est déjà puissant. Et si vous ajoutiez la variable Survived pour repérer des tendances apparentes ? Utilisez le facettage, qui permet de produire plusieurs graphiques simultanément :
# Scatter plot of Age vs Fare colored by Sex faceted by Survived
ggplot(passengers1, aes(x = Age, y = Fare, color = Sex)) +
  geom_point() +
  facet_grid(~Survived)

## Warning: Removed 177 rows containing missing values (geom_point).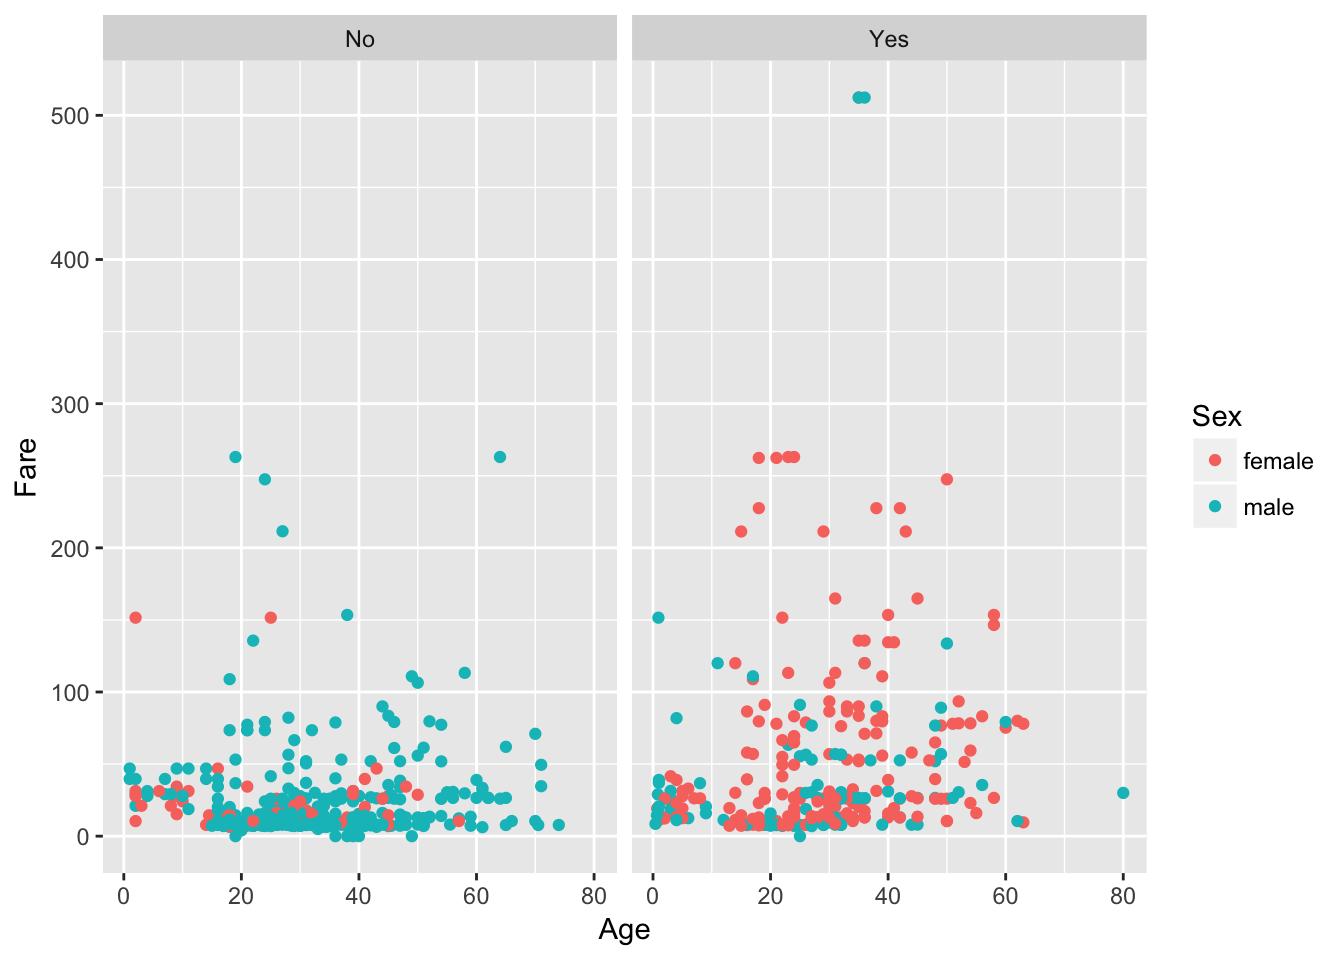
On constate alors que beaucoup des femmes repérées plus haut ont survécu, et que la majorité de celles qui n’ont pas survécu avaient payé moins de 50 unités. Astuce : essayez d’identifier vous-même l’unité monétaire.
Refaisons maintenant le diagramme en barres de Sex, en remplissant les barres selon Survived :
# Plot barplot of passenger Sex & fill according to Survival
ggplot(passengers1, aes(x = Sex, fill = Survived)) +
  geom_bar()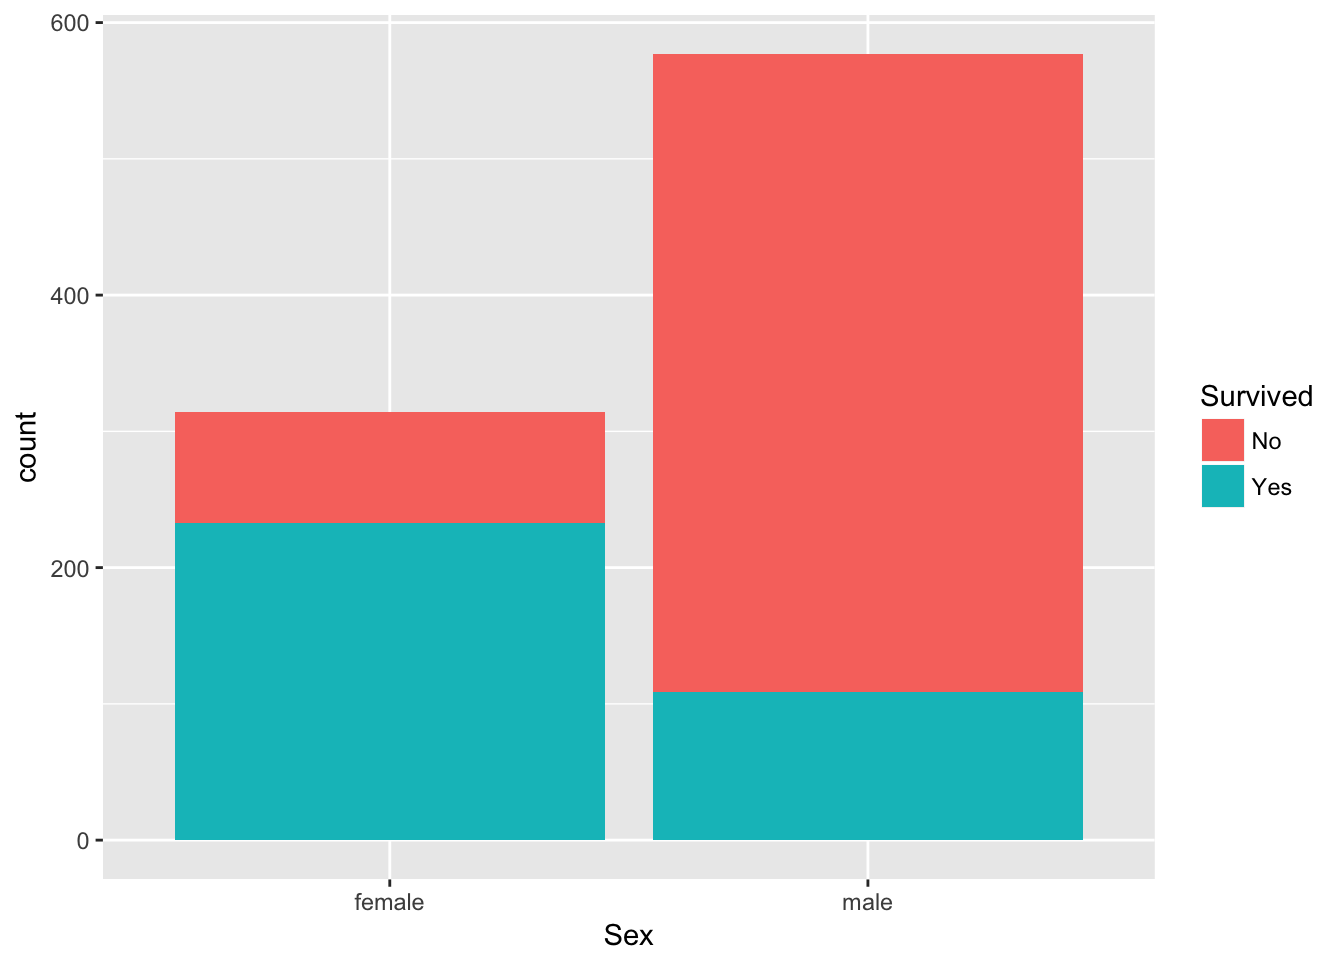
On voit que la grande majorité des hommes n’a pas survécu, tandis que plus des deux tiers des femmes ont survécu.
Utilisez le verbe summarise() pour calculer le tarif moyen payé :
# Check out mean Fare
passengers %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 32.20421
Utilisez summarise() pour calculer le tarif médian :
# Check out mean Fare
passengers %>%
  summarise(medianFare = median(Fare))

##   medianFare
## 1    14.4542
Combinez filter() et summarise() pour connaître le tarif moyen payé par les hommes :
# Check out mean Fare for men
passengers %>%
  filter(Sex == "male") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 25.52389
Faites de même pour les femmes :
# Check out mean Fare for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 44.47982
Utilisez filter() et summarise() pour obtenir le tarif moyen payé par les femmes et combien ont survécu :
# Check out mean Fare & number of survivors for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

##   meanFare numSurv
## 1 44.47982     233
Utilisez group_by() et summarise() pour calculer le tarif moyen et le nombre de survivants en fonction du sexe :
# Check out mean Fare & number of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <int>
## 1 female     44.5     233
## 2 male       25.5     109
Utilisez group_by() et summarise() pour calculer le tarif moyen et la proportion de survivants selon le sexe :
# Check out mean Fare & proportion of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived)/n())

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <dbl>
## 1 female     44.5   0.742
## 2 male 25.5 0.189Dans ce tutoriel, vous êtes passé des bases à une première analyse avec le tidyverse et ses outils. Vous avez appris à filter() vos données, à les arrange() et les mutate(), à les visualiser et les summarise() avec dplyr et ggplot2, en écrivant du code qui reflète votre façon de raisonner sur les données. Bravo. Pour aller plus loin, suivez le cours de David Robinson Introduction to Tidyverse et appliquez ces outils à d’autres jeux de données qui vous intéressent. Partagez vos analyses sur Twitter @DataCamp et @hugobowne. Merci de votre lecture.
Approfondir R
Cours
Cours
Cours