Curso
Introdução ao Tidyverse
4 h
394.9K
Este tutorial é a transcrição de um evento no Facebook Live que fizemos há uma semana. O tema foi "Introdução ao Tidyverse" e aqui você vai passar por todo o conteúdo que cobrimos durante a sessão de code-along!
Você pode assistir à primeira parte da sessão aqui:
E a segunda parte aqui:
Observação: você encontra todo o código da sessão neste repositório.
O tidyverse principal inclui os pacotes que você provavelmente vai usar no dia a dia de análise de dados, como o ggplot2 para visualização de dados e o dplyr para transformação e manipulação de dados. Neste tutorial, o foco é nesses dois.
Lembre-se de que um pacote é, essencialmente, um conjunto de ferramentas para trabalhar com dados. Se quiser saber mais sobre pacotes em R, confira este tutorial.
Para se aprofundar no Tidyverse, confira o curso Introduction to Tidyverse do David Robinson no DataCamp e os recursos Learn the Tidyverse.
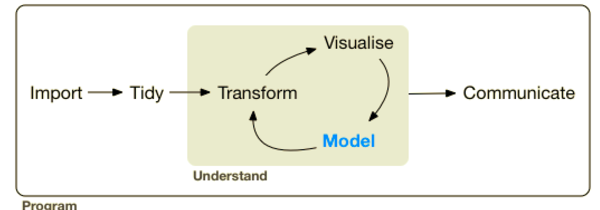
Para começar, instale o tidyverse, se ainda não fez isso:
# Install the tidyverse
# install.packages("tidyverse")
Agora que você instalou o tidyverse, é hora de carregar seus dados e dar uma olhada nas observações.
Neste tutorial, você vai explorar o conjunto de dados Titanic, em que cada observação é uma pessoa e cada variável é uma característica como Name, Age e se Survived (sobreviveu) ou não.
Carregue seus dados assim:
 # Import the Tidyverse
library(tidyverse)

# Import data
passengers <- read.csv("data/train.csv")

# Check out the first several observations of your dataframe
passengers

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6 0 330877 8.4583 QObservação: o caminho que você vai passar para read.csv() pode variar conforme seu ambiente. Se quiser manter o mesmo caminho de arquivo, confira a estrutura de pastas deste projeto no nosso repositório no GitHub, disponível aqui.
Outra dica: se você quiser saber mais sobre todas as variáveis que aparecem ao executar passengers, consulte a descrição do dataset.
Para ter uma visão geral dos seus dados, use a função summary():
# Summarize titanic
summary(passengers)

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
##  (Other)    :186
Agora faça o mesmo usando um pipe %>%, uma das ferramentas mais práticas do tidyverse:
# Summarize titanic using a pipe
passengers %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
## (Other) :186Dica: se quiser saber mais sobre o operador pipe em R, confira este tutorial.
Faça o mesmo depois de remover observações com valores ausentes. Dica: você pode encadear pipes!
# Summarize titanic after dropping na
passengers %>%
  drop_na() %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:222.2   1st Qu.:0.0000   1st Qu.:1.000
##  Median :445.0   Median :0.0000   Median :2.000
##  Mean   :448.6   Mean   :0.4062   Mean   :2.237
##  3rd Qu.:677.8   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:261   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :453   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :708
##      SibSp            Parch                 Ticket         Fare
##  Min.   :0.0000   Min.   :0.0000   347082      :  7   Min.   :  0.00
##  1st Qu.:0.0000   1st Qu.:0.0000   3101295     :  6   1st Qu.:  8.05
##  Median :0.0000   Median :0.0000   347088      :  6   Median : 15.74
##  Mean   :0.5126   Mean   :0.4314   CA 2144     :  6   Mean   : 34.69
##  3rd Qu.:1.0000   3rd Qu.:1.0000   382652      :  5   3rd Qu.: 33.38
##  Max.   :5.0000   Max.   :6.0000   S.O.C. 14879:  5   Max.   :512.33
##                                    (Other)     :679
##          Cabin     Embarked
##             :529    :  2
##  B96 B98    :  4   C:130
##  C23 C25 C27:  4   Q: 28
##  G6         :  4   S:554
##  C22 C26    :  3
##  D          :  3
##  (Other)    :167
Você deve ter notado uma consistência de estilo no código acima. Isso acontece porque você está seguindo um guia de estilo. Em ciência de dados e programação em geral, é importante se acostumar a usar um guia de estilo o quanto antes. Como o Hadley Wickham coloca no guia de estilo do tidyverse,
Good coding style is like correct punctuation: you can manage without it, butitsuremakesthingseasiertoread.
Na próxima seção, você vai manipular dados com o dplyr para filtrar, ordenar e criar novas variáveis a partir de outras.
Agora é hora de explorar seus dados e obter insights iniciais sobre o conjunto. Você vai usar os verbos do dplyr, como filter(), arrange() e mutate(), que fazem exatamente o que o nome sugere.
Vamos supor que você queira escolher um conjunto específico de observações, por exemplo, aquelas em que "Sex" seja 'female'. O dplyr permite fazer isso de forma intuitiva, em uma linguagem que reflete como você pensa e fala sobre dados.
O verbo filter seleciona apenas as observações que atendem à condição. Veja em ação:
# Filter to get all "male" rows
passengers %>%
  filter(Sex == "male")

##   PassengerId Survived Pclass                           Name  Sex Age
## 1           1        0      3        Braund, Mr. Owen Harris male  22
## 2           5        0      3       Allen, Mr. William Henry male  35
## 3           6        0      3               Moran, Mr. James male  NA
## 4           7        0      1        McCarthy, Mr. Timothy J male  54
## 5           8        0      3 Palsson, Master. Gosta Leonard male   2
## 6          13        0      3 Saundercock, Mr. William Henry male  20
##   SibSp Parch    Ticket    Fare Cabin Embarked
## 1     1     0 A/5 21171  7.2500              S
## 2     0     0    373450  8.0500              S
## 3     0     0    330877  8.4583              Q
## 4     0     0     17463 51.8625   E46        S
## 5     3     1    349909 21.0750              S
## 6     0     0 A/5. 2151  8.0500              S
Ao olhar o resultado do código acima, parece que muitos homens não sobreviveram ao naufrágio do RMS Titanic. Isso é interessante, e você vai explorar isso com mais rigor ainda neste tutorial!
Observação: você pode ler o código do dplyr como uma frase: pegue seus dados e então (%>%) filtre de acordo com a condição de que o sexo é masculino. O código exibido acima não altera o data frame original. filter(Sex = "male") é um erro comum (o Hugo cometeu o mesmo engano!); há um ótimo guia de erros do tidyverse.
# Filter to get all "female" rows
passengers %>%
  filter(Sex == "female")

##   PassengerId Survived Pclass
## 1           2        1      1
## 2           3        1      3
## 3           4        1      1
## 4           9        1      3
## 5          10        1      2
## 6          11        1      3
##                                                  Name    Sex Age SibSp
## 1 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 2                              Heikkinen, Miss. Laina female  26     0
## 3        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 4   Johnson, Mrs. Oscar W (Elisabeth Vilhelmina Berg) female  27     0
## 5                 Nasser, Mrs. Nicholas (Adele Achem) female  14     1
## 6                     Sandstrom, Miss. Marguerite Rut female   4     1
##   Parch           Ticket    Fare Cabin Embarked
## 1     0         PC 17599 71.2833   C85        C
## 2     0 STON/O2. 3101282  7.9250              S
## 3     0           113803 53.1000  C123        S
## 4     2           347742 11.1333              S
## 5     0           237736 30.0708              C
## 6     1          PP 9549 16.7000    G6        S
Mulheres parecem ter tido mais chances de sobreviver ao desastre do Titanic, pelo menos de forma anedótica.
Ao explorar dados, você deve fazer e responder perguntas de interesse com o máximo de rigor possível! Agora, você pode querer arrange() suas observações por Fare crescente para ver se nota alguma tendência. Use o verbo arrange() para isso:
# Arrange by increasing Fare
passengers %>%
  arrange(Fare)

##   PassengerId Survived Pclass                            Name  Sex Age
## 1         180        0      3             Leonard, Mr. Lionel male  36
## 2         264        0      1           Harrison, Mr. William male  40
## 3         272        1      3    Tornquist, Mr. William Henry male  25
## 4         278        0      2     Parkes, Mr. Francis "Frank" male  NA
## 5         303        0      3 Johnson, Mr. William Cahoone Jr male  19
## 6         414        0      2  Cunningham, Mr. Alfred Fleming male  NA
##   SibSp Parch Ticket Fare Cabin Embarked
## 1     0     0   LINE    0              S
## 2     0     0 112059    0   B94        S
## 3     0     0   LINE    0              S
## 4     0     0 239853    0              S
## 5     0     0   LINE    0              S
## 6     0     0 239853    0              S
Muitas pessoas que pagaram menos não sobreviveram ao desastre. Isso é algo interessante que você descobriu apenas reorganizando seus dados!
Você também pode arrange por Fare decrescente:
# Arrange by decreasing Fare
passengers %>%
  arrange(desc(Fare))

##   PassengerId Survived Pclass                               Name    Sex
## 1         259        1      1                   Ward, Miss. Anna female
## 2         680        1      1 Cardeza, Mr. Thomas Drake Martinez   male
## 3         738        1      1             Lesurer, Mr. Gustave J   male
## 4          28        0      1     Fortune, Mr. Charles Alexander   male
## 5          89        1      1         Fortune, Miss. Mabel Helen female
## 6         342        1      1     Fortune, Miss. Alice Elizabeth female
##   Age SibSp Parch   Ticket     Fare       Cabin Embarked
## 1  35     0     0 PC 17755 512.3292                    C
## 2  36     0     1 PC 17755 512.3292 B51 B53 B55        C
## 3  35     0     0 PC 17755 512.3292        B101        C
## 4  19     3     2    19950 263.0000 C23 C25 C27        S
## 5  23     3     2    19950 263.0000 C23 C25 C27        S
## 6  24     3     2    19950 263.0000 C23 C25 C27        S
Há mesmo mais sobreviventes no topo!
Às vezes, você pode querer criar novas variáveis. Você sabe que a variável Parch é o número de pais e filhos, enquanto SibSp é o número de irmãos e cônjuges. Você pode somá-las para obter uma nova variável FamSize. Isso é engenharia de atributos (feature engineering) e é uma parte importante de machine learning na maior parte do tempo!
Para criar sua nova variável, você usa mutate() para transformar as variáveis originais na nova.
# Create new column FamSize (size of family)
passengers %>%
  mutate(FamSize = Parch + SibSp)

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked FamSize
## 1     0        A/5 21171  7.2500              S       1
## 2     0         PC 17599 71.2833   C85        C       1
## 3     0 STON/O2. 3101282  7.9250              S       0
## 4     0           113803 53.1000  C123        S       1
## 5     0           373450  8.0500              S       0
## 6 0 330877 8.4583 Q 0Observação: mutate() pode ser usado para criar novas colunas e também para modificar colunas existentes, de maneira análoga ao que uma mutação faz do ponto de vista biológico. Não é uma analogia perfeita, mas ajuda a dar contexto à escolha do verbo.
Agora que você tem a variável extra, pode fazer outras perguntas, como: "É possível que famílias maiores tenham uma taxa de sobrevivência menor?".
Para testar essa hipótese, crie a nova variável FamSize como a soma de Parch e SibSp como acima e depois ordene por FamSize decrescente:
# Create new column FamSize (size of family)
# Arrange by decreasing FamSize
passengers %>%
  mutate(FamSize = Parch + SibSp) %>%
  arrange(desc(FamSize))

##   PassengerId Survived Pclass                         Name    Sex Age
## 1         160        0      3   Sage, Master. Thomas Henry   male  NA
## 2         181        0      3 Sage, Miss. Constance Gladys female  NA
## 3         202        0      3          Sage, Mr. Frederick   male  NA
## 4         325        0      3     Sage, Mr. George John Jr   male  NA
## 5         793        0      3      Sage, Miss. Stella Anna female  NA
## 6         847        0      3     Sage, Mr. Douglas Bullen   male  NA
##   SibSp Parch   Ticket  Fare Cabin Embarked FamSize
## 1     8     2 CA. 2343 69.55              S      10
## 2     8     2 CA. 2343 69.55              S      10
## 3     8     2 CA. 2343 69.55              S      10
## 4     8     2 CA. 2343 69.55              S      10
## 5     8     2 CA. 2343 69.55              S      10
## 6     8     2 CA. 2343 69.55              S      10
Todos da maior família no topo não sobreviveram! Isso pode ser significativo: talvez, se você fazia parte de uma família grande, não conseguiu deixar o Titanic a tempo.
Como zeros e uns nem sempre dizem muita coisa, transforme os valores da variável Survived em strings No e Yes (e crie um novo data frame!):
# Turn numerical values of Survived column to "No" & "Yes" (new data frame)
passengers1 <- passengers %>%
  mutate(Survived = ifelse(Survived == 0, "No", "Yes"))
passengers1

##   PassengerId Survived Pclass
## 1           1       No      3
## 2           2      Yes      1
## 3           3      Yes      3
## 4           4      Yes      1
## 5           5       No      3
## 6           6       No      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6 0 330877 8.4583 QPara plotar seus dados com o ggplot2, você especifica três coisas:
Primeiro, faça um gráfico de barras de Sex para ver quantos homens e mulheres estavam a bordo do Titanic:
# Plot barplot of passenger Sex
ggplot(passengers, aes(x = Sex)) +
  geom_bar()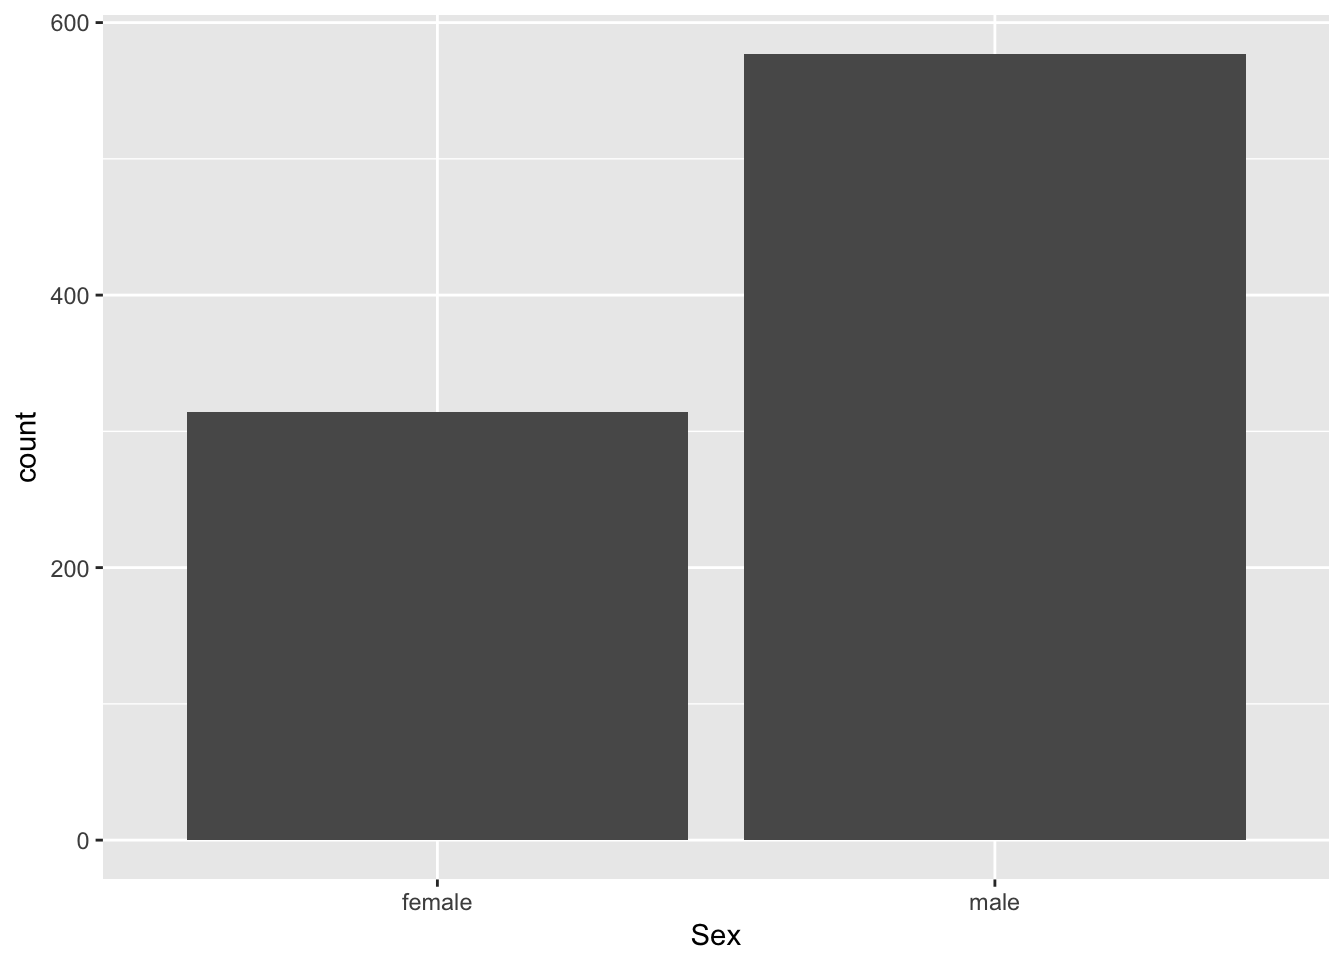
Pelo gráfico acima, dá para ver que havia cerca de 600 homens e 300 mulheres a bordo do RMS Titanic.
Observação: a função aes() é a forma de mapear as aestéticas do gráfico para as variáveis dos dados. Veja mais em Modern Dive, de Chester Ismay e Albert Y. Kim.
Agora é a vez dos gráficos de dispersão. A Age de um passageiro tem correlação com a Fare que ele pagou?
# Scatter plot of Age vs Fare
ggplot(passengers, aes(x = Age, y = Fare)) +
  geom_point()

## Warning: Removed 177 rows containing missing values (geom_point).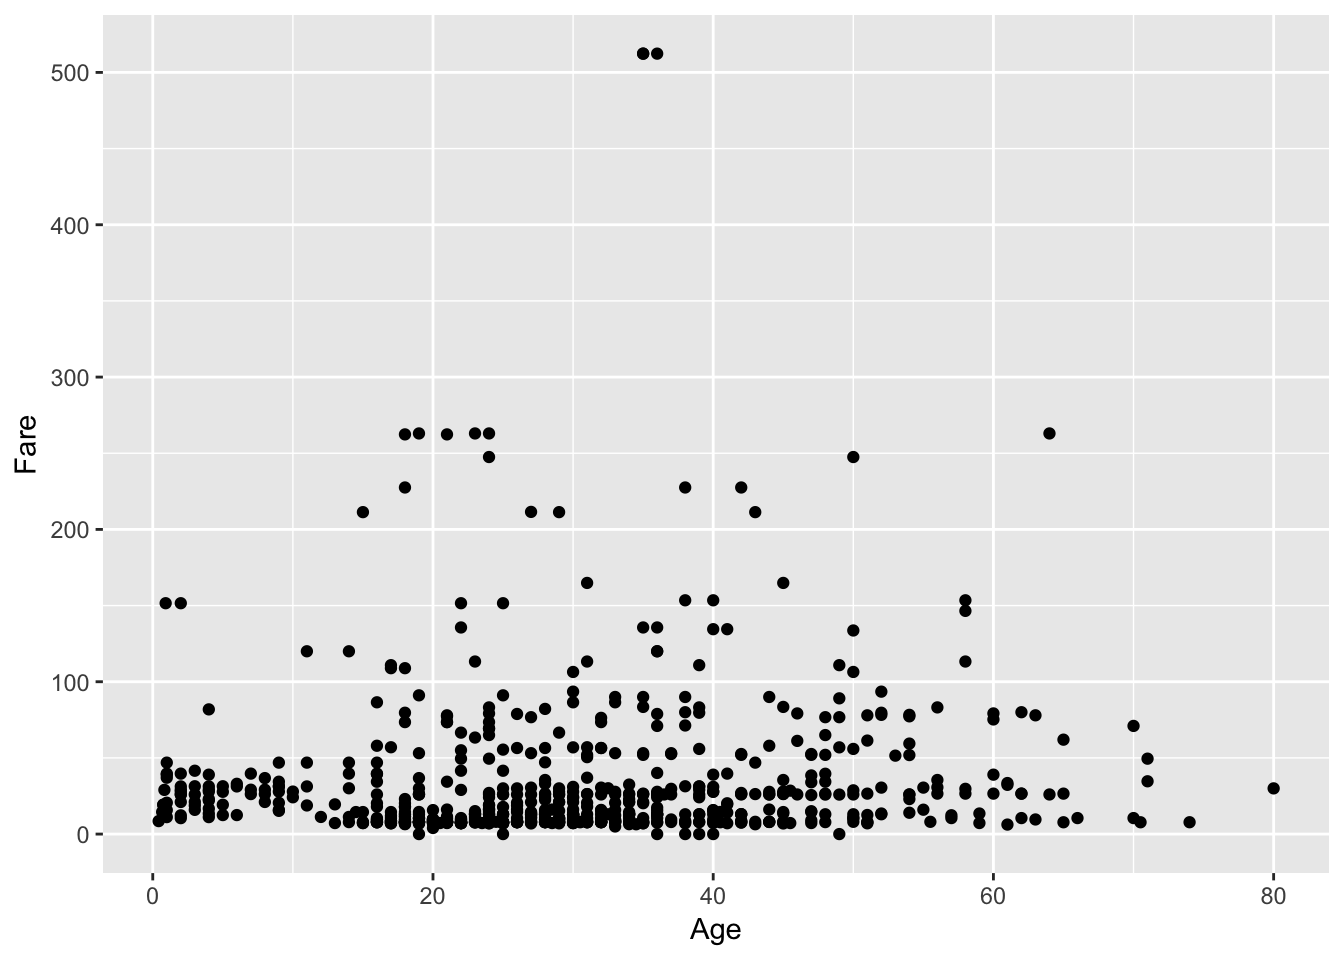
Você já tira vários insights só com esse gráfico! Dá para ver que muitas pessoas que pagaram mais também eram bem mais velhas. Pode ter havido um aumento de tarifa conforme a idade... Além disso, os dois outliers no topo do gráfico chamam atenção e podem ser investigados!
Você pode ler o código do ggplot2 como uma frase, assim como fez com o dplyr acima: "Você pega os dados titanic, mapeia Age para o eixo x e Fare para o eixo y, adicionando pontos como a camada do gráfico."
Vamos pegar o gráfico anterior e colorir cada ponto por Sex para ver correlações entre Sex, Age e Fare:
# Scatter plot of Age vs Fare colored by Sex
ggplot(passengers %>% drop_na(), aes(x = Age, y = Fare, color = Sex)) +
  geom_point()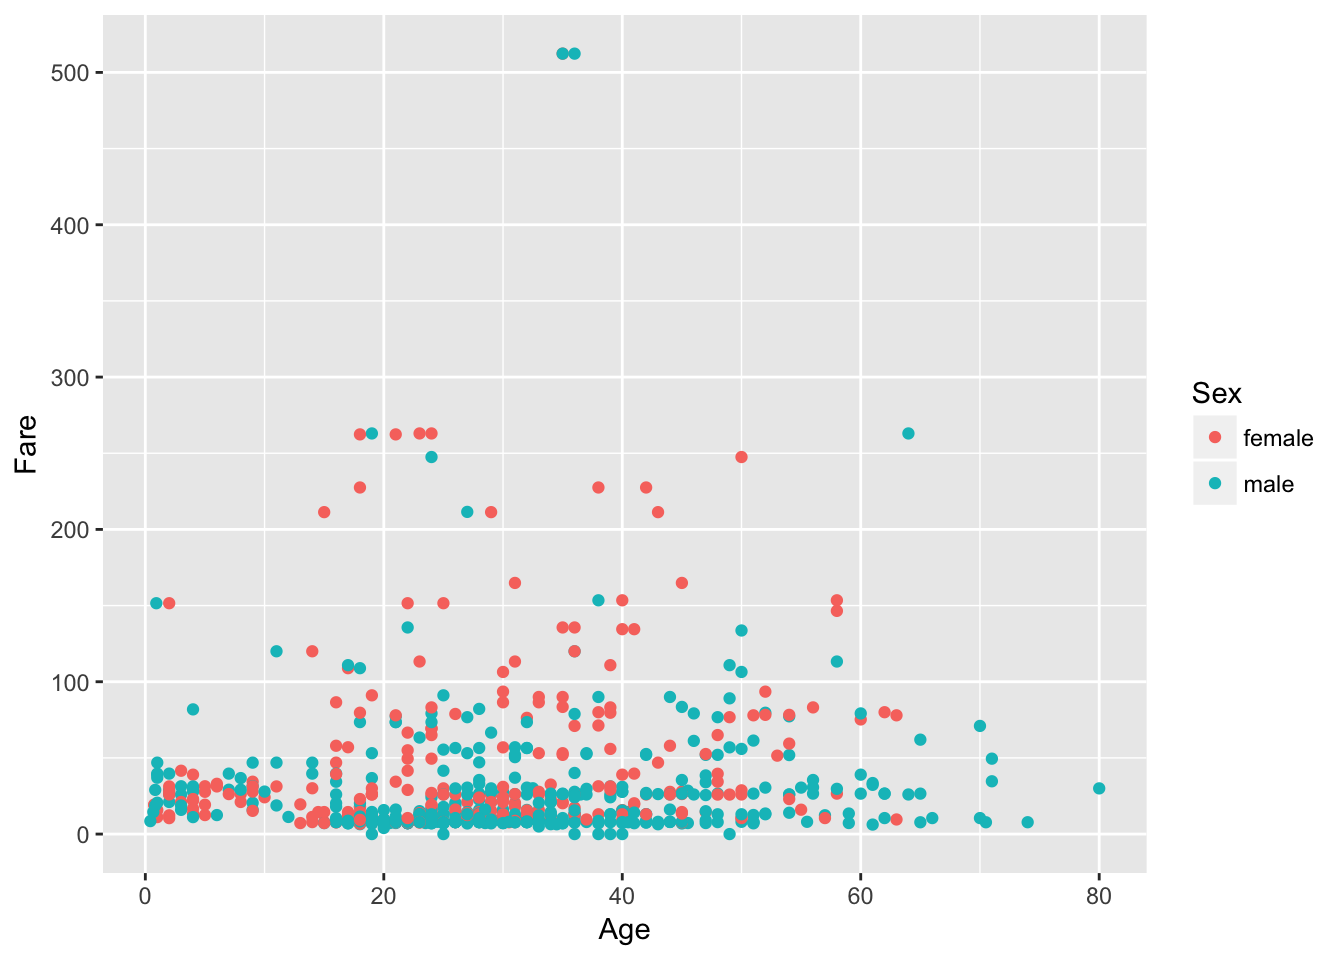
Dá para ver que muitos dos que pagaram menos, na parte de baixo, eram homens. Há também um aglomerado de mulheres na parte superior do gráfico que eram um pouco mais velhas e pagaram mais para embarcar no Titanic.
Visualizar três variáveis (duas numéricas, Age e Fare, e uma categórica, Sex) em um só gráfico é ótimo, mas e se você quiser incluir a variável Survived para ver tendências aparentes? Você pode fazer isso com facetas (faceting), que é uma forma de produzir múltiplos gráficos simultaneamente:
# Scatter plot of Age vs Fare colored by Sex faceted by Survived
ggplot(passengers1, aes(x = Age, y = Fare, color = Sex)) +
  geom_point() +
  facet_grid(~Survived)

## Warning: Removed 177 rows containing missing values (geom_point).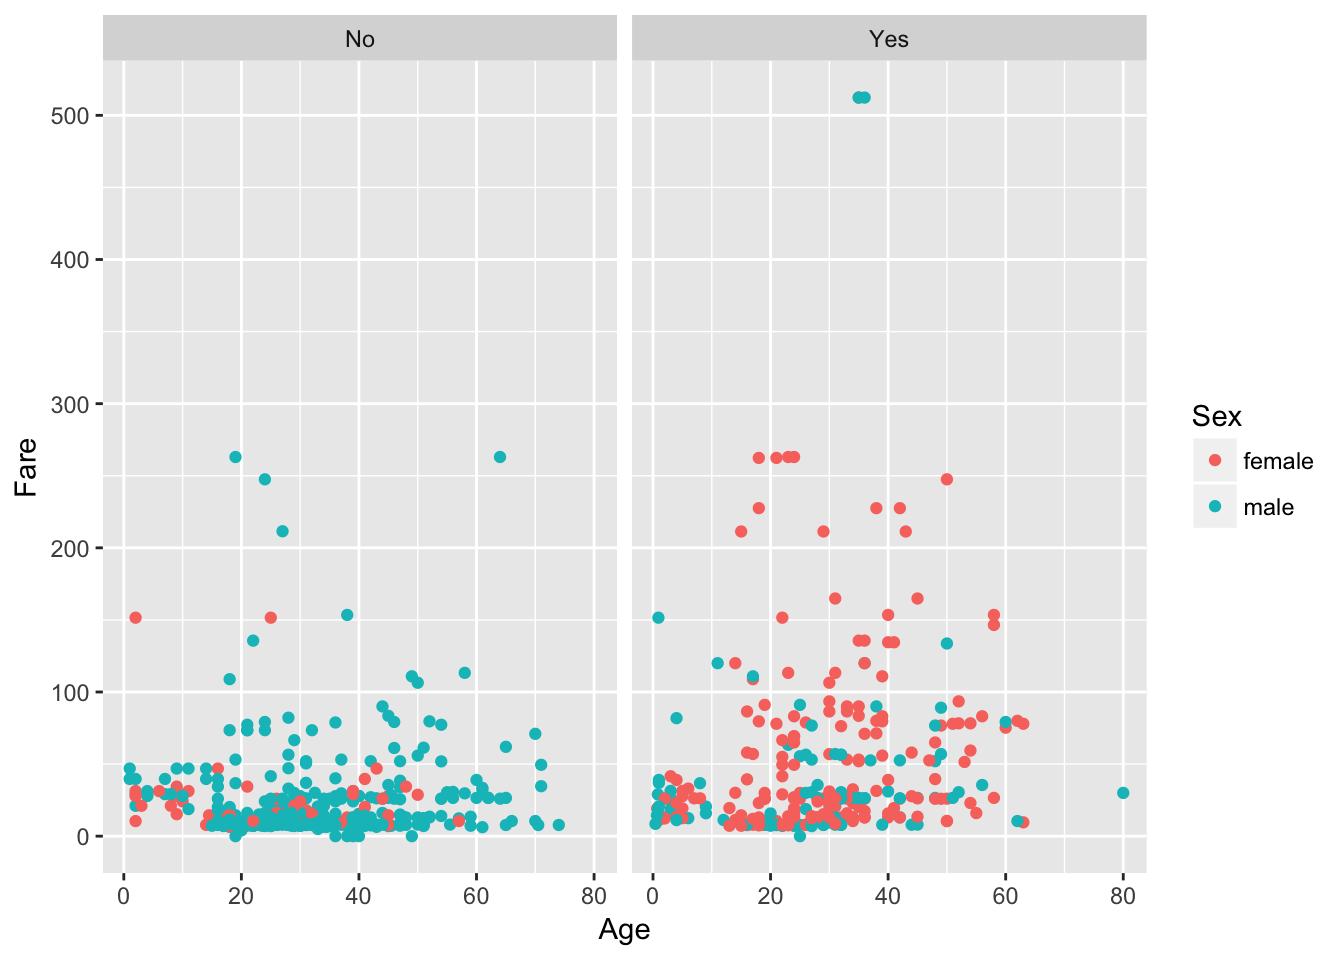
De repente, você percebe que muitas daquelas mulheres destacadas no gráfico anterior sobreviveram e que a maioria das que não sobreviveram pagou menos de 50 unidades. Dica: tente descobrir por conta própria quais são as unidades da moeda!
Agora vamos refazer o gráfico de barras de Sex e, desta vez, preencher as barras de acordo com Survived:
# Plot barplot of passenger Sex & fill according to Survival
ggplot(passengers1, aes(x = Sex, fill = Survived)) +
  geom_bar()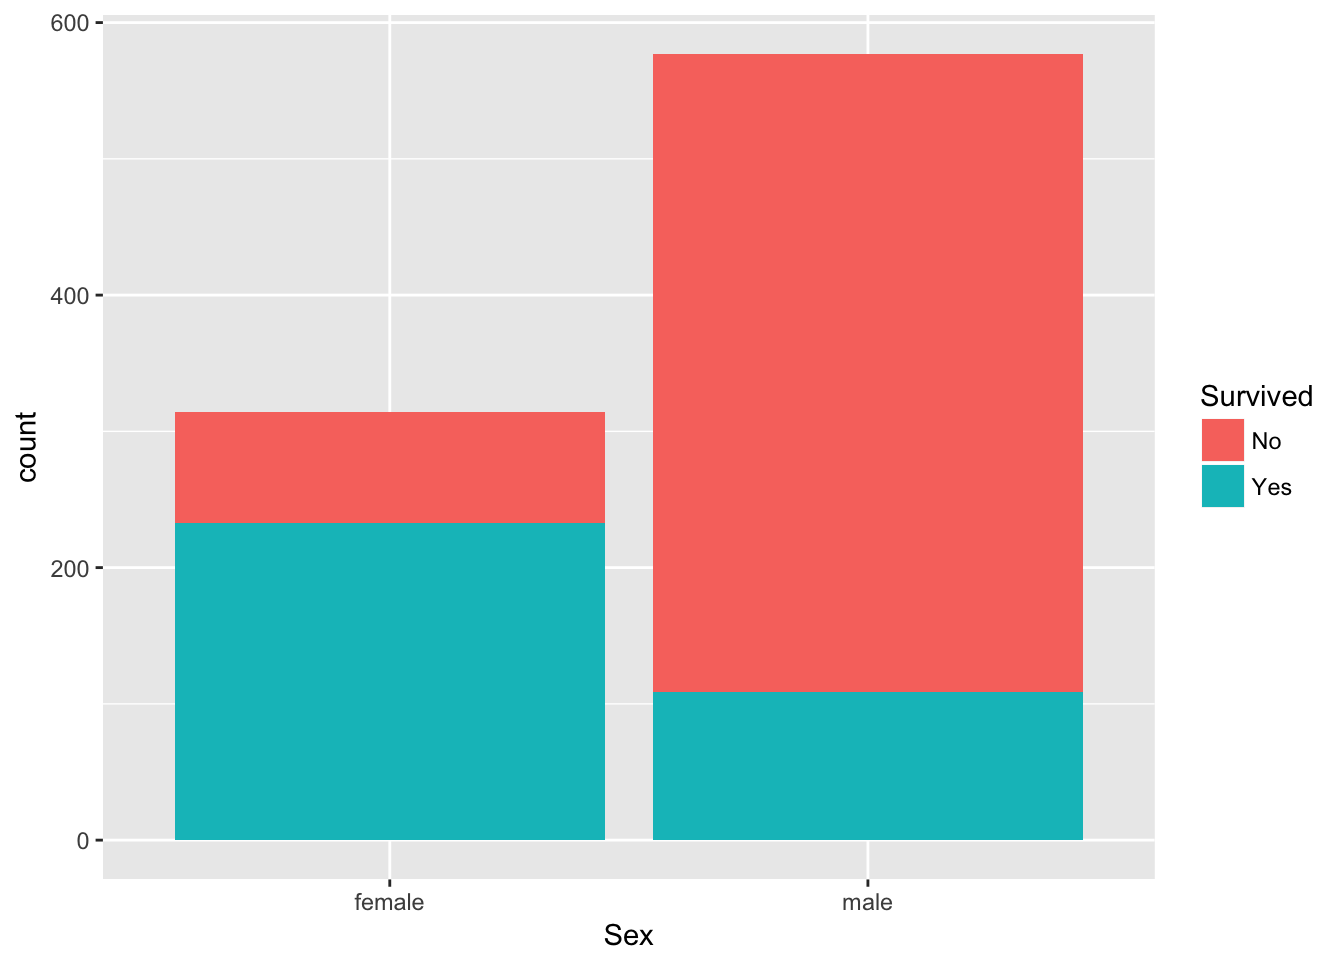
Você vê que a grande maioria dos homens não sobreviveu, enquanto mais de dois terços das mulheres sobreviveram!
Use o verbo summarise() para descobrir a tarifa média paga:
# Check out mean Fare
passengers %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 32.20421
Use o verbo summarise() para descobrir a mediana da tarifa paga:
# Check out mean Fare
passengers %>%
  summarise(medianFare = median(Fare))

##   medianFare
## 1    14.4542
Você também pode combinar filter() e summarise() para descobrir a tarifa média paga entre os homens:
# Check out mean Fare for men
passengers %>%
  filter(Sex == "male") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 25.52389
Use filter() e summarise() para descobrir a tarifa média paga entre as mulheres:
# Check out mean Fare for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 44.47982
Use filter() e summarise() para descobrir a tarifa média paga entre as mulheres e quantas mulheres sobreviveram:
# Check out mean Fare & number of survivors for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

##   meanFare numSurv
## 1 44.47982     233
Use group_by() e summarise() para encontrar a tarifa média e o número de sobreviventes em função do sexo:
# Check out mean Fare & number of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <int>
## 1 female     44.5     233
## 2 male       25.5     109
Use group_by() e summarise() para encontrar a tarifa média e a proporção de sobreviventes em função do sexo:
# Check out mean Fare & proportion of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived)/n())

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <dbl>
## 1 female     44.5   0.742
## 2 male 25.5 0.189Neste tutorial, você saiu do zero e aprendeu o básico de análise de dados usando o tidyverse e suas ferramentas. Você aprendeu a filter() seus dados, arrange() e mutate(), a plotar e a summarise() com dplyr e ggplot2, tudo escrevendo código que reflete a forma como pensamos e falamos sobre dados. Parabéns. Recomendo continuar aprendendo com o curso Introduction to Tidyverse do David Robinson e aplicando essas ferramentas em outros conjuntos de dados que te interessem. Compartilhe suas análises com a gente no Twitter @DataCamp e @hugobowne. Obrigado pela leitura.
Saiba mais sobre R
Curso
Curso
Curso
Tutorial
Karlijn Willems
15 min
Tutorial
Kevin Babitz
15 min
Tutorial
DataCamp Team
15 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Karlijn Willems
15 min