
Last chance! 50% off DataCamp Premium
Sale ends in
Deze tutorial is een uitwerking van een Facebook Live-event dat we een week geleden deden. Het onderwerp was "Introductie tot de Tidyverse" en deze tutorial loodst je door alle content die we tijdens de code-along sessie hebben behandeld!
Je kunt het eerste deel van de sessie hier bekijken:
En het tweede deel hier:
Let op dat je alle code voor de sessie kunt vinden in deze repository.
De kern van de tidyverse bevat de pakketten die je waarschijnlijk dagelijks gebruikt bij data-analyses, zoals ggplot2 voor datavisualisatie en dplyr voor data wrangling. In deze tutorial focus je op deze twee.
Onthoud dat een pakket in essentie een set tools is om dingen met data te doen. Wil je meer weten over pakketten in R, bekijk dan deze tutorial.
Wil je meer over de Tidyverse, bekijk dan David Robinsons Introduction to Tidyverse-cursus op DataCamp en de Learn the Tidyverse-bronnen.
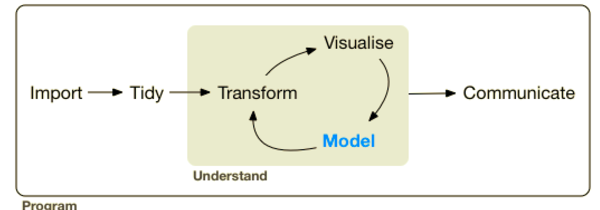
Om te beginnen installeer je de tidyverse, als je dat nog niet gedaan hebt:
# Install the tidyverse
# install.packages("tidyverse")
Nu je de tidyverse hebt geïnstalleerd, is het tijd om je data te laden en enkele observaties te bekijken.
In deze tutorial verken je de Titanic-dataset, waarbij elke observatie een persoon is en elke variabele een kenmerk zoals Name, Age en Survived (of niet).
Laad je data zo:
 # Import the Tidyverse
library(tidyverse)

# Import data
passengers <- read.csv("data/train.csv")

# Check out the first several observations of your dataframe
passengers

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6     0           330877  8.4583              Q
Let op dat het pad dat je meegeeft aan read.csv() kan verschillen afhankelijk van je setup. Als je gewoon hetzelfde bestandspad wilt aanhouden, kun je altijd de mapstructuur van dit project bekijken in onze GitHub-repository, die je hier vindt.
Let ook op dat als je meer wilt weten over alle variabelen die je ziet als resultaat van het uitvoeren van passengers, je de datasetbeschrijving kunt raadplegen.
Om een overzicht van je data te krijgen, kun je de functie summary() gebruiken:
# Summarize titanic
summary(passengers)

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
##  (Other)    :186
Doe nu hetzelfde met een pipe %>%, een van de handigste tools in de tidyverse:
# Summarize titanic using a pipe
passengers %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
## (Other) :186Tip: als je meer wilt weten over het gebruik van de pipe-operator in R, bekijk dan deze tutorial.
Doe hetzelfde nadat je observaties met missende waarden hebt verwijderd. Hint: je kunt pipes aan elkaar schakelen!
# Summarize titanic after dropping na
passengers %>%
  drop_na() %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:222.2   1st Qu.:0.0000   1st Qu.:1.000
##  Median :445.0   Median :0.0000   Median :2.000
##  Mean   :448.6   Mean   :0.4062   Mean   :2.237
##  3rd Qu.:677.8   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:261   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :453   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :708
##      SibSp            Parch                 Ticket         Fare
##  Min.   :0.0000   Min.   :0.0000   347082      :  7   Min.   :  0.00
##  1st Qu.:0.0000   1st Qu.:0.0000   3101295     :  6   1st Qu.:  8.05
##  Median :0.0000   Median :0.0000   347088      :  6   Median : 15.74
##  Mean   :0.5126   Mean   :0.4314   CA 2144     :  6   Mean   : 34.69
##  3rd Qu.:1.0000   3rd Qu.:1.0000   382652      :  5   3rd Qu.: 33.38
##  Max.   :5.0000   Max.   :6.0000   S.O.C. 14879:  5   Max.   :512.33
##                                    (Other)     :679
##          Cabin     Embarked
##             :529    :  2
##  B96 B98    :  4   C:130
##  C23 C25 C27:  4   Q: 28
##  G6         :  4   S:554
##  C22 C26    :  3
##  D          :  3
##  (Other)    :167
Je hebt misschien een stilistische consistentie opgemerkt in de code die je hierboven hebt geschreven. Dat komt doordat je je aan een stijlgids houdt. In data science en programmeren/coderen in het algemeen is het belangrijk om zo snel mogelijk te wennen aan een stijlgids. Zoals Hadley Wickham het zegt in de tidyverse-stijlgids,
Goede codeerstijl is als correcte interpunctie: je kunt zonder, maarhetmaaktalleswelveelmakkelijkertelezen.
In de volgende sectie ga je aan de slag met data wrangling met dplyr om je data te filteren, te ordenen en nieuwe features te maken door oude te muteren.
Het is nu tijd om je data te verkennen en een eerste inzicht in de dataset te krijgen. Je gebruikt dplyr-werkwoorden zoals filter(), arrange() en mutate(), die precies doen wat ze zeggen.
Stel dat je een bepaalde set observaties wilt kiezen, bijvoorbeeld die waarvoor "Sex" 'female' was. dplyr laat ons dit intuïtief doen in een taal die weerspiegelt hoe je over data denkt en praat.
Het filter-werkwoord kiest alleen de observaties die aan de voorwaarde voldoen. Zie het in actie:
# Filter to get all "male" rows
passengers %>%
  filter(Sex == "male")

##   PassengerId Survived Pclass                           Name  Sex Age
## 1           1        0      3        Braund, Mr. Owen Harris male  22
## 2           5        0      3       Allen, Mr. William Henry male  35
## 3           6        0      3               Moran, Mr. James male  NA
## 4           7        0      1        McCarthy, Mr. Timothy J male  54
## 5           8        0      3 Palsson, Master. Gosta Leonard male   2
## 6          13        0      3 Saundercock, Mr. William Henry male  20
##   SibSp Parch    Ticket    Fare Cabin Embarked
## 1     1     0 A/5 21171  7.2500              S
## 2     0     0    373450  8.0500              S
## 3     0     0    330877  8.4583              Q
## 4     0     0     17463 51.8625   E46        S
## 5     3     1    349909 21.0750              S
## 6     0     0 A/5. 2151  8.0500              S
Als je naar de resultaten van het bovenstaande codeblok kijkt, zie je dat het lijkt alsof veel mannen de zinking van de RMS Titanic niet hebben overleefd. Dat is interessant, en je gaat dit later in deze tutorial grondiger verkennen!
Let op dat je dplyr-code kunt lezen als een zin: neem je data en (%>%) filter die vervolgens volgens de voorwaarde dat het geslacht mannelijk is. De code die je in het bovenstaande codeblok ziet, wijzigt het oorspronkelijke dataframe niet. filter(Sex = "male") is een veelgemaakte fout (Hugo maakte dezelfde fout!); er is een handige tidyverse-foutengids.
# Filter to get all "female" rows
passengers %>%
  filter(Sex == "female")

##   PassengerId Survived Pclass
## 1           2        1      1
## 2           3        1      3
## 3           4        1      1
## 4           9        1      3
## 5          10        1      2
## 6          11        1      3
##                                                  Name    Sex Age SibSp
## 1 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 2                              Heikkinen, Miss. Laina female  26     0
## 3        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 4   Johnson, Mrs. Oscar W (Elisabeth Vilhelmina Berg) female  27     0
## 5                 Nasser, Mrs. Nicholas (Adele Achem) female  14     1
## 6                     Sandstrom, Miss. Marguerite Rut female   4     1
##   Parch           Ticket    Fare Cabin Embarked
## 1     0         PC 17599 71.2833   C85        C
## 2     0 STON/O2. 3101282  7.9250              S
## 3     0           113803 53.1000  C123        S
## 4     2           347742 11.1333              S
## 5     0           237736 30.0708              C
## 6     1          PP 9549 16.7000    G6        S
Vrouwen lijken meer kans te hebben gehad om de ramp met de Titanic te overleven, althans anekdotisch gezien.
Wanneer je data verkent, moet je vragen stellen en beantwoorden waar je in geïnteresseerd bent, naar beste kunnen! Misschien wil je nu je observaties arrange() op oplopende Fare om te zien of je trends kunt ontdekken. Je kunt hiervoor het werkwoord arrange() gebruiken:
# Arrange by increasing Fare
passengers %>%
  arrange(Fare)

##   PassengerId Survived Pclass                            Name  Sex Age
## 1         180        0      3             Leonard, Mr. Lionel male  36
## 2         264        0      1           Harrison, Mr. William male  40
## 3         272        1      3    Tornquist, Mr. William Henry male  25
## 4         278        0      2     Parkes, Mr. Francis "Frank" male  NA
## 5         303        0      3 Johnson, Mr. William Cahoone Jr male  19
## 6         414        0      2  Cunningham, Mr. Alfred Fleming male  NA
##   SibSp Parch Ticket Fare Cabin Embarked
## 1     0     0   LINE    0              S
## 2     0     0 112059    0   B94        S
## 3     0     0   LINE    0              S
## 4     0     0 239853    0              S
## 5     0     0   LINE    0              S
## 6     0     0 239853    0              S
Veel van de mensen die minder betaalden, hebben de ramp niet overleefd. Dat is iets interessants dat je net hebt ontdekt door je data opnieuw te ordenen!
Je kunt ook arrange op aflopende Fare:
# Arrange by decreasing Fare
passengers %>%
  arrange(desc(Fare))

##   PassengerId Survived Pclass                               Name    Sex
## 1         259        1      1                   Ward, Miss. Anna female
## 2         680        1      1 Cardeza, Mr. Thomas Drake Martinez   male
## 3         738        1      1             Lesurer, Mr. Gustave J   male
## 4          28        0      1     Fortune, Mr. Charles Alexander   male
## 5          89        1      1         Fortune, Miss. Mabel Helen female
## 6         342        1      1     Fortune, Miss. Alice Elizabeth female
##   Age SibSp Parch   Ticket     Fare       Cabin Embarked
## 1  35     0     0 PC 17755 512.3292                    C
## 2  36     0     1 PC 17755 512.3292 B51 B53 B55        C
## 3  35     0     0 PC 17755 512.3292        B101        C
## 4  19     3     2    19950 263.0000 C23 C25 C27        S
## 5  23     3     2    19950 263.0000 C23 C25 C27        S
## 6  24     3     2    19950 263.0000 C23 C25 C27        S
Er zijn inderdaad meer overlevenden aan de bovenkant!
Soms wil je misschien nieuwe variabelen creëren. Je weet dat de variabele Parch het aantal ouders en kinderen is, terwijl SibSp het aantal broers/zussen en partners is. Je kunt deze optellen om een nieuwe variabele FamSize te krijgen. Dit is feature engineering en dat is vaak een groot onderdeel van machine learning!
Om je nieuwe variabele te maken, mutate() je de oorspronkelijke variabelen naar de nieuwe.
# Create new column FamSize (size of family)
passengers %>%
  mutate(FamSize = Parch + SibSp)

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked FamSize
## 1     0        A/5 21171  7.2500              S       1
## 2     0         PC 17599 71.2833   C85        C       1
## 3     0 STON/O2. 3101282  7.9250              S       0
## 4     0           113803 53.1000  C123        S       1
## 5     0           373450  8.0500              S       0
## 6     0           330877  8.4583              Q       0
Let op dat je met mutate() nieuwe kolommen kunt maken maar ook bestaande kolommen kunt wijzigen, ongeveer zoals een mutatie vanuit biologisch perspectief. Niet exact, maar een fijne manier om context te geven voor de woordkeuze.
Nu je je extra variabele hebt, kun je andere vragen stellen, zoals "Is het mogelijk dat grotere families een lagere overlevingskans hebben?".
Om deze hypothese te testen, maak je een nieuwe variabele FamSize als de som van Parch en SibSp zoals hierboven, en orden je vervolgens op afnemende FamSize:
# Create new column FamSize (size of family)
# Arrange by decreasing FamSize
passengers %>%
  mutate(FamSize = Parch + SibSp) %>%
  arrange(desc(FamSize))

##   PassengerId Survived Pclass                         Name    Sex Age
## 1         160        0      3   Sage, Master. Thomas Henry   male  NA
## 2         181        0      3 Sage, Miss. Constance Gladys female  NA
## 3         202        0      3          Sage, Mr. Frederick   male  NA
## 4         325        0      3     Sage, Mr. George John Jr   male  NA
## 5         793        0      3      Sage, Miss. Stella Anna female  NA
## 6         847        0      3     Sage, Mr. Douglas Bullen   male  NA
##   SibSp Parch   Ticket  Fare Cabin Embarked FamSize
## 1     8     2 CA. 2343 69.55              S      10
## 2     8     2 CA. 2343 69.55              S      10
## 3     8     2 CA. 2343 69.55              S      10
## 4     8     2 CA. 2343 69.55              S      10
## 5     8     2 CA. 2343 69.55              S      10
## 6     8     2 CA. 2343 69.55              S      10
Iedereen in de grootste familie bovenaan heeft het niet overleefd! Dat kan veelzeggend zijn: misschien kon je, als je deel uitmaakte van een grote familie, niet op tijd van de Titanic afkomen.
Maar omdat nullen en enen vaak niet veel zeggen, muteer de waarden van de variabele Survived naar strings No en Yes (en maak een nieuw dataframe!):
# Turn numerical values of Survived column to "No" & "Yes" (new data frame)
passengers1 <- passengers %>%
  mutate(Survived = ifelse(Survived == 0, "No", "Yes"))
passengers1

##   PassengerId Survived Pclass
## 1           1       No      3
## 2           2      Yes      1
## 3           3      Yes      3
## 4           4      Yes      1
## 5           5       No      3
## 6           6       No      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6 0 330877 8.4583 QOm je data te plotten met ggplot2, specificeer je drie dingen:
Eerst plot je een staafdiagram van Sex om te zien hoeveel mannen en vrouwen aan boord van de Titanic waren geregistreerd:
# Plot barplot of passenger Sex
ggplot(passengers, aes(x = Sex)) +
  geom_bar()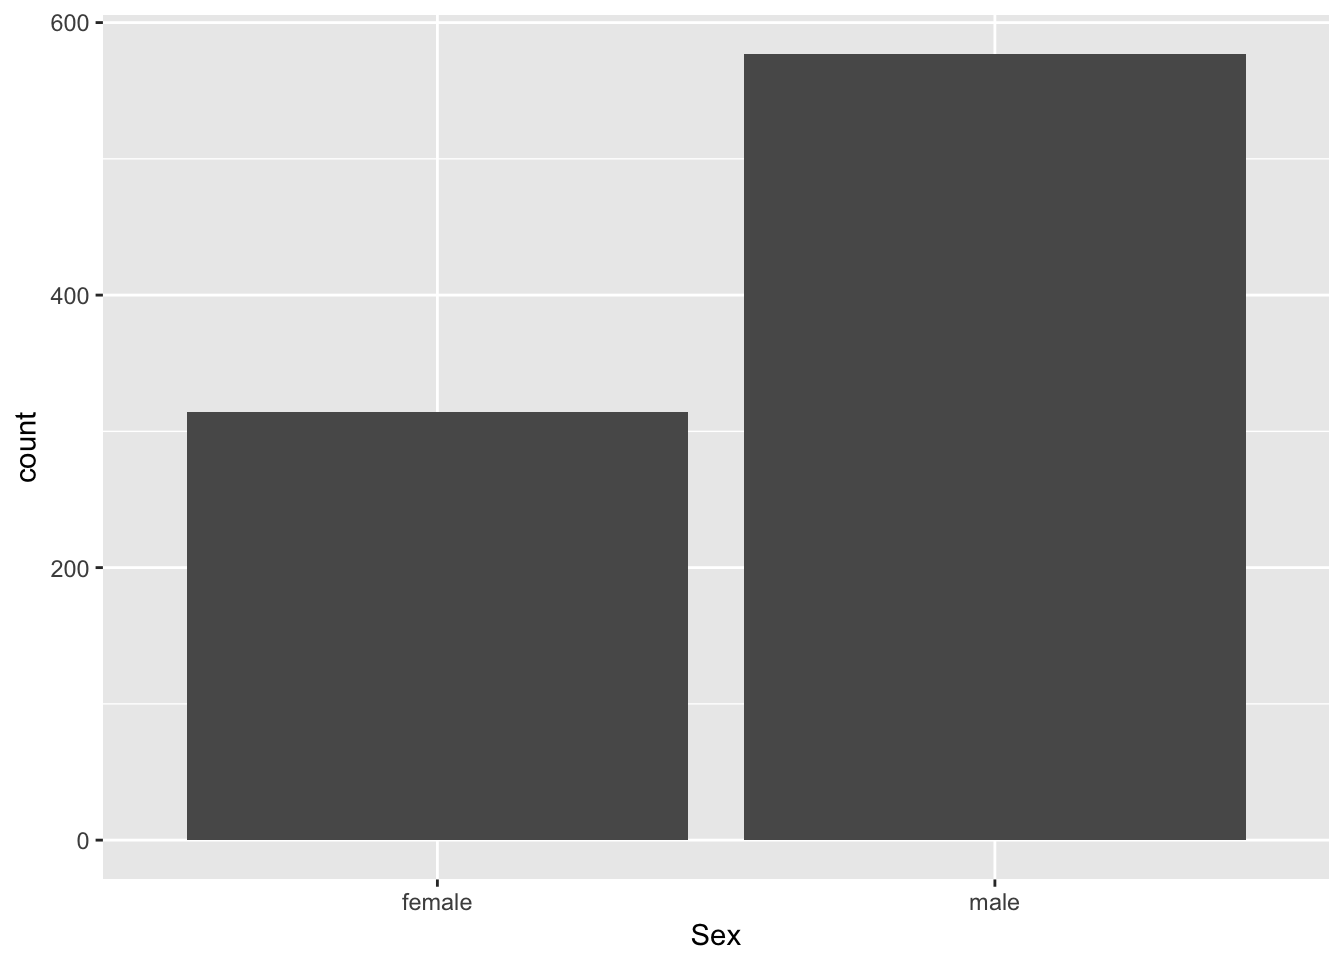
Uit de bovenstaande plot kun je opmaken dat er ongeveer 600 mannen en 300 vrouwen aan boord van de RMS Titanic waren.
Let op dat de functie aes() echt een manier is om de aesthetics van de plot te koppelen aan de variabelen in de data. Zie Modern Dive van Chester Ismay & Albert Y. Kim voor meer.
Nu is het tijd voor wat scatterplots. Is de Age van een passagier gecorreleerd met de Fare die hij/zij betaalde?
# Scatter plot of Age vs Fare
ggplot(passengers, aes(x = Age, y = Fare)) +
  geom_point()

## Warning: Removed 177 rows containing missing values (geom_point).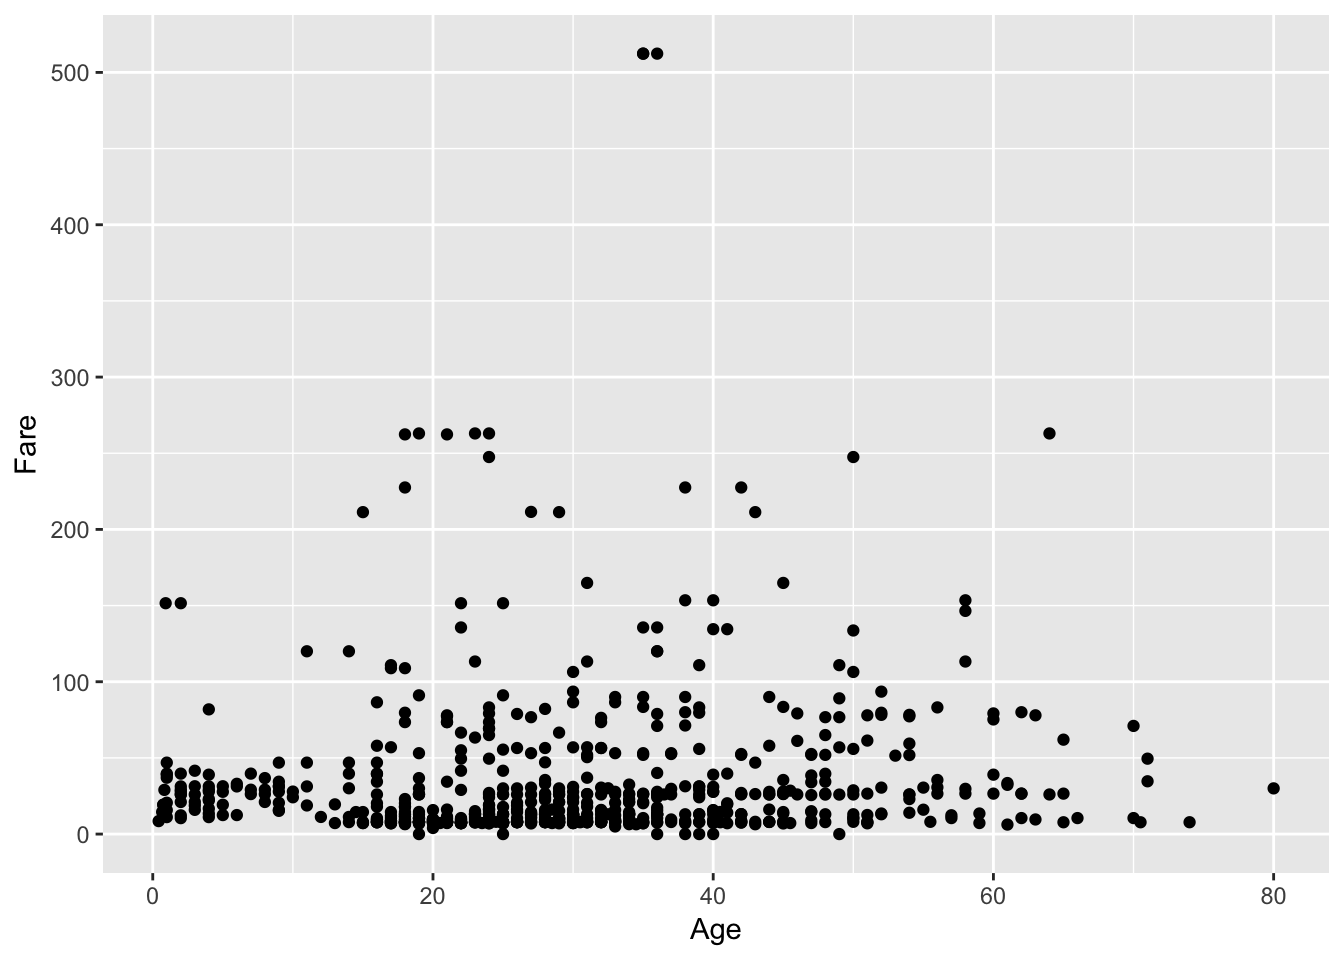
Je haalt veel inzichten uit deze ene plot! Je ziet dat veel van de mensen die meer betaalden, ook aanzienlijk ouder waren. Misschien was er een toename in tarief naar leeftijd... Daarnaast zie je meteen de twee uitschieters bovenaan de plot, die je verder zou kunnen onderzoeken!
Je kunt je ggplot2-code lezen als een zin, net als je dplyr-code hierboven: "Je neemt de data als titanic en je mappt Age op de x-as en Fare op de y-as, waarna je punten toevoegt als laag van de plot."
Laten we de vorige plot nemen en elk punt kleuren op basis van Sex, om eventuele verbanden tussen Sex, Age en Fare te zien:
# Scatter plot of Age vs Fare colored by Sex
ggplot(passengers %>% drop_na(), aes(x = Age, y = Fare, color = Sex)) +
  geom_point()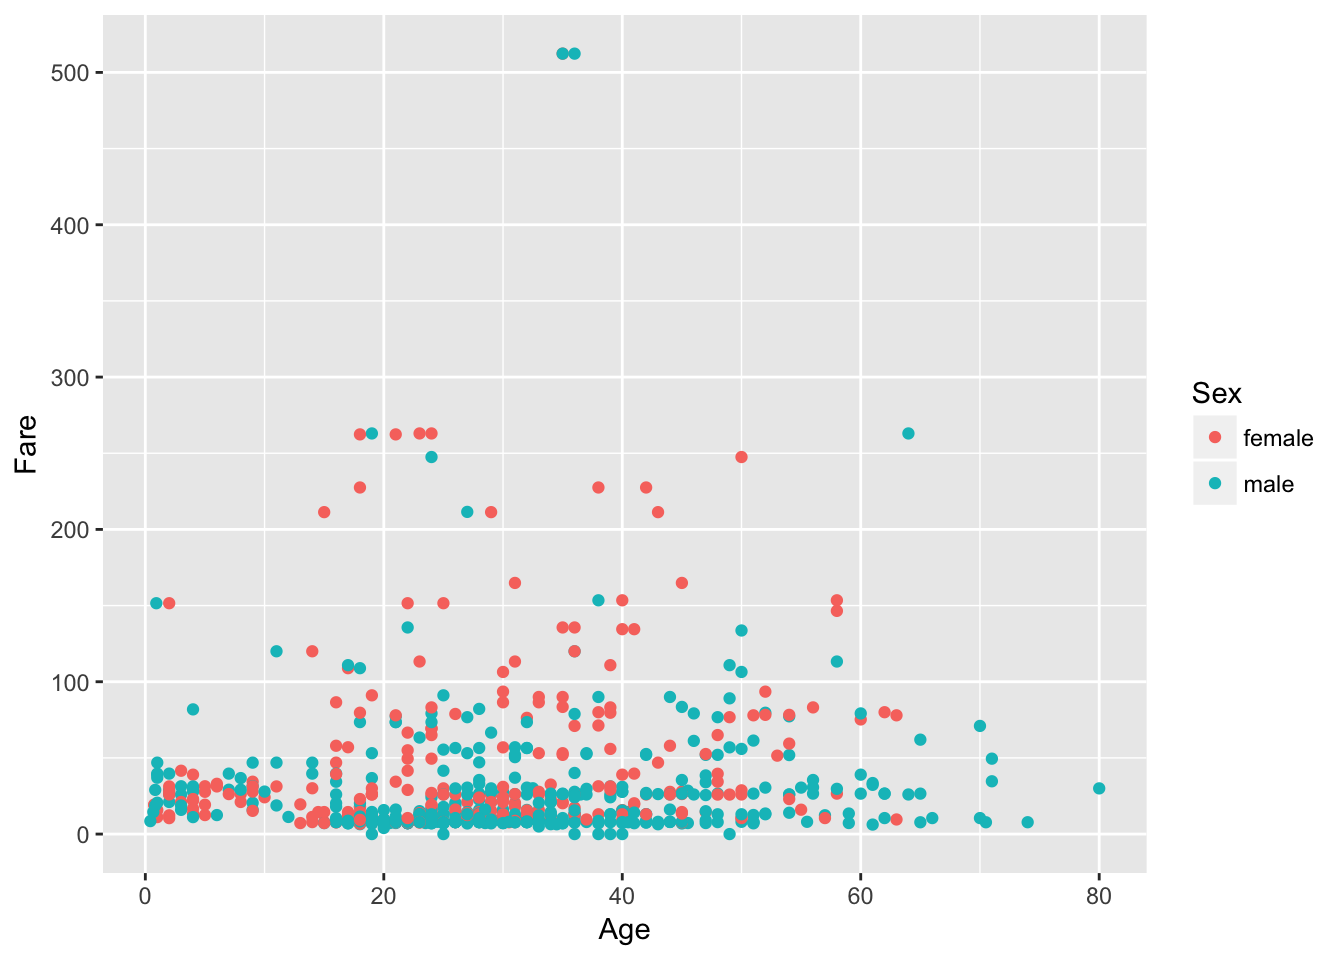
Je ziet dat veel van de mensen onderaan, die minder betaalden, mannen waren. Je hebt ook een cluster vrouwen bovenaan de plot die iets ouder waren en ook meer betaalden om aan boord van de Titanic te komen.
Drie variabelen visualiseren (twee numeriek, Age en Fare, en één categorisch, Sex) in één plot is best gaaf, maar wat als je de variabele Survived eraan wilt toevoegen om te zien of er duidelijke trends zijn? Dat kan met faceting, een manier om meerdere plots tegelijk te maken:
# Scatter plot of Age vs Fare colored by Sex faceted by Survived
ggplot(passengers1, aes(x = Age, y = Fare, color = Sex)) +
  geom_point() +
  facet_grid(~Survived)

## Warning: Removed 177 rows containing missing values (geom_point).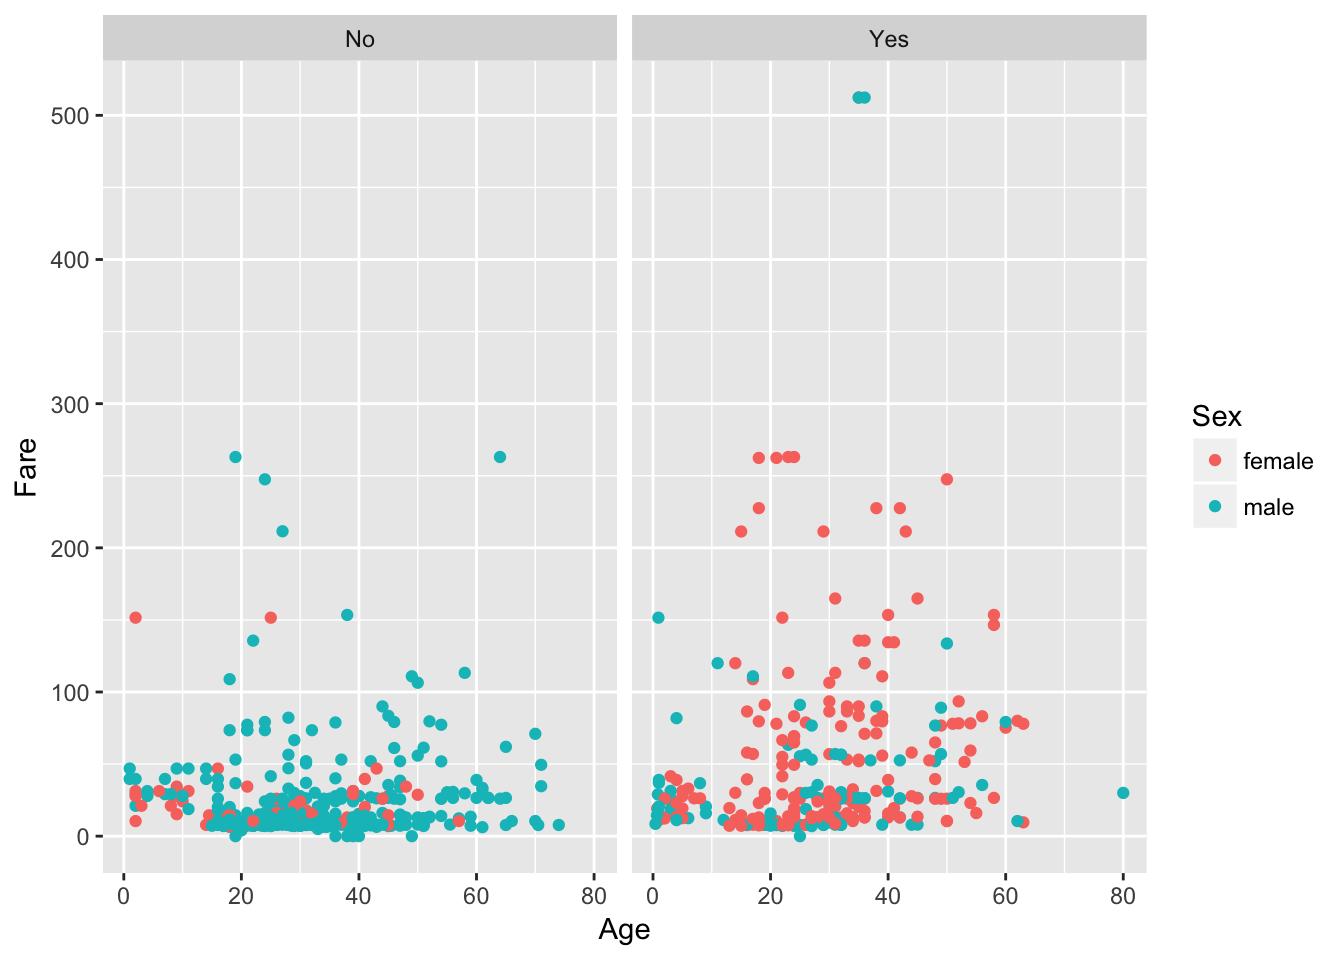
Plotseling zie je dat veel van de vrouwen die je hierboven in de vorige plot opmerkte, hebben overleefd, en dat de meesten die niet overleefden, minder dan 50 eenheden betaalden. Tip: probeer zelf de munteenheid te achterhalen!
Laten we nu je staafdiagram van passagiersSex opnieuw maken en deze keer je balken vullen op basis van Survived:
# Plot barplot of passenger Sex & fill according to Survival
ggplot(passengers1, aes(x = Sex, fill = Survived)) +
  geom_bar()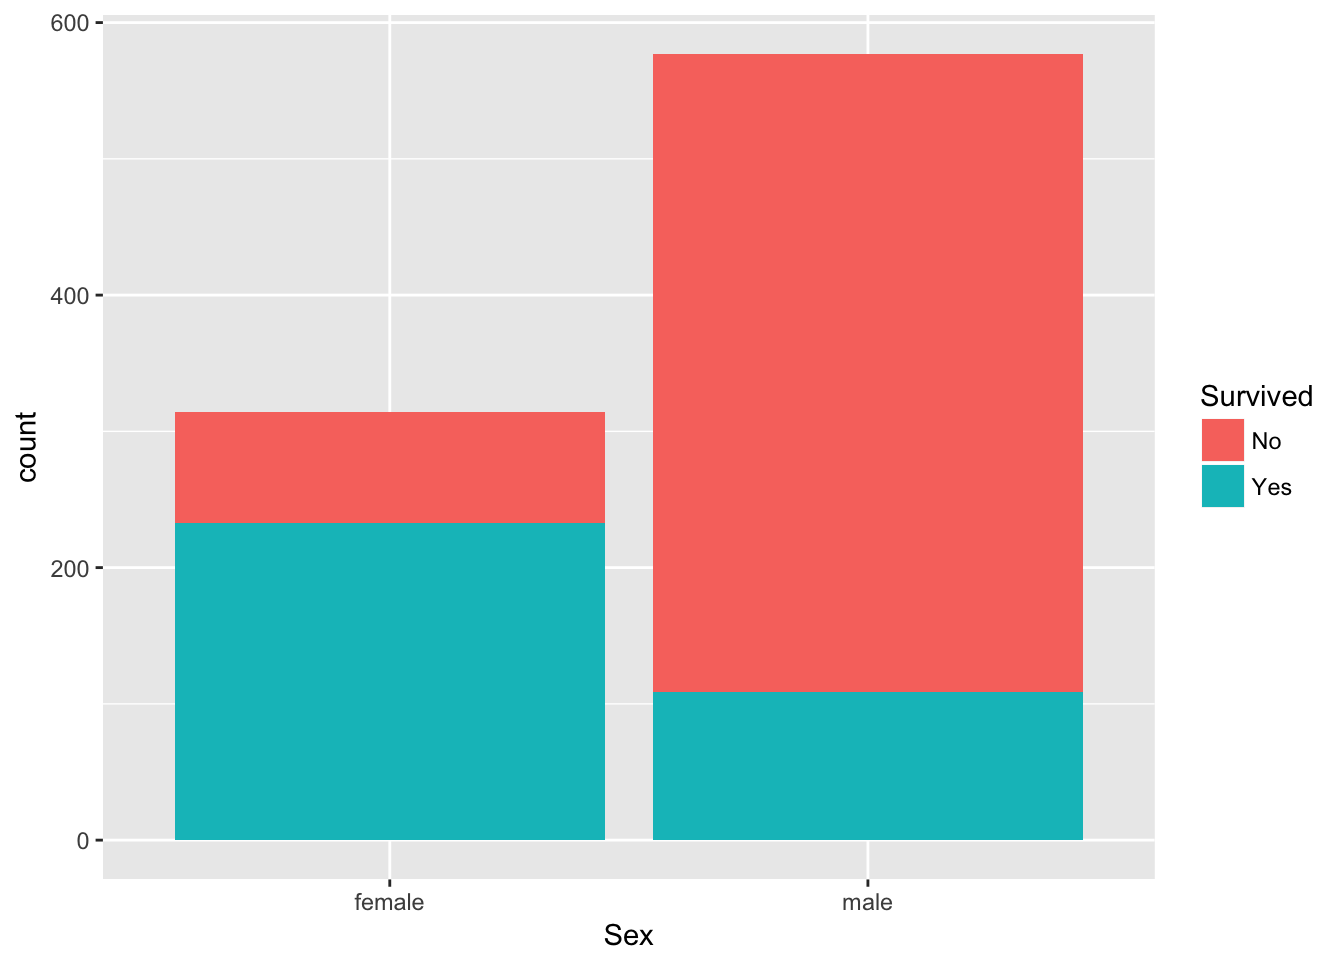
Je ziet dat het overgrote deel van de mannen niet overleefde, terwijl meer dan twee derde van de vrouwen wel overleefde!
Gebruik het werkwoord summarise() om de gemiddelde prijs te vinden die is betaald:
# Check out mean Fare
passengers %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 32.20421
Gebruik het werkwoord summarise() om de mediaan van de betaalde prijs te vinden:
# Check out mean Fare
passengers %>%
  summarise(medianFare = median(Fare))

##   medianFare
## 1    14.4542
Je kunt ook de werkwoorden filter() en summarise() gebruiken om de gemiddelde betaalde prijs onder mannen te vinden:
# Check out mean Fare for men
passengers %>%
  filter(Sex == "male") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 25.52389
Gebruik de werkwoorden filter() en summarise() om de gemiddelde betaalde prijs onder vrouwen te vinden:
# Check out mean Fare for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 44.47982
Gebruik de werkwoorden filter() en summarise() om de gemiddelde betaalde prijs onder vrouwen en hoeveel vrouwen overleefden te vinden:
# Check out mean Fare & number of survivors for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

##   meanFare numSurv
## 1 44.47982     233
Gebruik de werkwoorden group_by() en summarise() om de gemiddelde prijs en het aantal overlevenden te vinden als functie van geslacht:
# Check out mean Fare & number of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <int>
## 1 female     44.5     233
## 2 male       25.5     109
Gebruik de werkwoorden group_by() en summarise() om de gemiddelde prijs en de proportie overlevenden te vinden als functie van geslacht:
# Check out mean Fare & proportion of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived)/n())

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <dbl>
## 1 female     44.5   0.742
## 2 male 25.5 0.189In deze tutorial ben je van nul naar één gegaan met de basis van data-analyse met de tidyverse en tidy-tools. Je hebt geleerd hoe je je data kunt filter(), arrange() en mutate(), hoe je deze kunt plotten en summarise() met dplyr en ggplot2, allemaal door code te schrijven die weerspiegelt hoe je over data denkt en praat. Gefeliciteerd. Ik raad je aan om meer te leren door David Robinsons Introduction to Tidyverse-cursus te volgen en door deze tools te gebruiken op andere datasets die je interesseren. Deel deze analyses met ons op Twitter @DataCamp en @hugobowne. Bedankt voor het lezen.
Leer meer over R
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

