Curso
Introducción a Tidyverse
4 h
394.9K
Este tutorial es la transcripción de un evento de Facebook Live que hicimos hace una semana. El tema fue "Introducción al Tidyverse" y aquí recorrerás todo el contenido que cubrimos durante la sesión de code-along.
Puedes ver la primera parte de la sesión aquí:
Y la segunda parte aquí:
Nota: puedes encontrar todo el código de la sesión en este repositorio.
El núcleo de tidyverse incluye los paquetes que probablemente usarás en análisis de datos del día a día, como ggplot2 para visualización y dplyr para manipulación de datos. En este tutorial te centrarás en estos dos.
Recuerda que un paquete es, básicamente, un conjunto de herramientas para trabajar con datos. Si quieres saber más sobre paquetes en R, echa un vistazo a este tutorial.
Para profundizar en el Tidyverse, prueba el curso de David Robinson Introduction to Tidyverse en DataCamp y los recursos de Learn the Tidyverse.
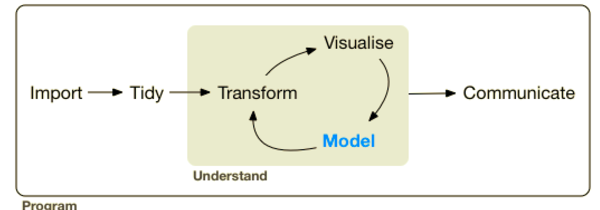
Para empezar, deberías instalar tidyverse si aún no lo has hecho:
# Install the tidyverse
# install.packages("tidyverse")
Ahora que has instalado tidyverse, es momento de cargar tus datos y echar un vistazo a algunas observaciones.
En este tutorial, explorarás el conjunto de datos del Titanic, donde cada observación es una persona y cada variable es una característica como Name, Age y si Survived (o no).
Carga tus datos así:
 # Import the Tidyverse
library(tidyverse)

# Import data
passengers <- read.csv("data/train.csv")

# Check out the first several observations of your dataframe
passengers

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6 0 330877 8.4583 QNota: la ruta que pases a read.csv() puede variar según tu configuración. Si prefieres mantener la misma ruta de archivo, puedes consultar la estructura de carpetas de este proyecto en nuestro repositorio de GitHub, que encontrarás aquí.
También ten en cuenta que, si quieres saber más sobre todas las variables que ves al ejecutar passengers, puedes revisar la descripción del conjunto de datos.
Para tener una vista general de tus datos, puedes usar la función summary():
# Summarize titanic
summary(passengers)

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
##  (Other)    :186
Ahora haz lo mismo usando un pipe %>%, una de las herramientas más útiles de tidyverse:
# Summarize titanic using a pipe
passengers %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
## (Other) :186Consejo: si quieres saber más sobre el operador pipe en R, puedes consultar este tutorial.
Haz lo mismo después de eliminar las observaciones con valores ausentes. Pista: ¡puedes encadenar pipes!
# Summarize titanic after dropping na
passengers %>%
  drop_na() %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:222.2   1st Qu.:0.0000   1st Qu.:1.000
##  Median :445.0   Median :0.0000   Median :2.000
##  Mean   :448.6   Mean   :0.4062   Mean   :2.237
##  3rd Qu.:677.8   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:261   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :453   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :708
##      SibSp            Parch                 Ticket         Fare
##  Min.   :0.0000   Min.   :0.0000   347082      :  7   Min.   :  0.00
##  1st Qu.:0.0000   1st Qu.:0.0000   3101295     :  6   1st Qu.:  8.05
##  Median :0.0000   Median :0.0000   347088      :  6   Median : 15.74
##  Mean   :0.5126   Mean   :0.4314   CA 2144     :  6   Mean   : 34.69
##  3rd Qu.:1.0000   3rd Qu.:1.0000   382652      :  5   3rd Qu.: 33.38
##  Max.   :5.0000   Max.   :6.0000   S.O.C. 14879:  5   Max.   :512.33
##                                    (Other)     :679
##          Cabin     Embarked
##             :529    :  2
##  B96 B98    :  4   C:130
##  C23 C25 C27:  4   Q: 28
##  G6         :  4   S:554
##  C22 C26    :  3
##  D          :  3
##  (Other)    :167
Puede que hayas notado coherencia estilística en el código anterior. Es porque estás siguiendo una guía de estilo. En ciencia de datos y en programación en general, es importante acostumbrarse cuanto antes a usar una guía de estilo. Como dice Hadley Wickham en la guía de estilo de tidyverse:
Un buen estilo de código es como la puntuación correcta: puedes apañarte sin ella, perolaverdadesquemuchofacilitalectura.
En la siguiente sección, abordarás la manipulación de datos con dplyr para filtrar, ordenar y crear nuevas variables a partir de otras.
Ahora toca explorar tus datos y obtener una primera visión del conjunto. Usarás verbos de dplyr como filter(), arrange() y mutate(), que hacen exactamente lo que su nombre sugiere.
Imagina que quieres seleccionar un conjunto concreto de observaciones, por ejemplo, aquellas para las que la variable "Sex" es 'female'. dplyr te permite hacerlo de forma intuitiva y con un lenguaje que refleja cómo piensas y hablas sobre datos.
El verbo filter elige solo las observaciones que cumplen la condición. Mira cómo funciona:
# Filter to get all "male" rows
passengers %>%
  filter(Sex == "male")

##   PassengerId Survived Pclass                           Name  Sex Age
## 1           1        0      3        Braund, Mr. Owen Harris male  22
## 2           5        0      3       Allen, Mr. William Henry male  35
## 3           6        0      3               Moran, Mr. James male  NA
## 4           7        0      1        McCarthy, Mr. Timothy J male  54
## 5           8        0      3 Palsson, Master. Gosta Leonard male   2
## 6          13        0      3 Saundercock, Mr. William Henry male  20
##   SibSp Parch    Ticket    Fare Cabin Embarked
## 1     1     0 A/5 21171  7.2500              S
## 2     0     0    373450  8.0500              S
## 3     0     0    330877  8.4583              Q
## 4     0     0     17463 51.8625   E46        S
## 5     3     1    349909 21.0750              S
## 6     0     0 A/5. 2151  8.0500              S
Al ver los resultados del bloque anterior, parece que muchos hombres no sobrevivieron al hundimiento del RMS Titanic. Es interesante y lo investigarás con más rigor más adelante en este tutorial.
Nota: puedes leer el código de dplyr como una frase: toma tus datos y luego (%>%) fíltalos según la condición de que el sexo sea masculino. El código del bloque anterior no modifica el data frame original. filter(Sex = "male") es un error común (¡a Hugo le pasó!); aquí tienes una útil guía de errores de tidyverse.
# Filter to get all "female" rows
passengers %>%
  filter(Sex == "female")

##   PassengerId Survived Pclass
## 1           2        1      1
## 2           3        1      3
## 3           4        1      1
## 4           9        1      3
## 5          10        1      2
## 6          11        1      3
##                                                  Name    Sex Age SibSp
## 1 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 2                              Heikkinen, Miss. Laina female  26     0
## 3        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 4   Johnson, Mrs. Oscar W (Elisabeth Vilhelmina Berg) female  27     0
## 5                 Nasser, Mrs. Nicholas (Adele Achem) female  14     1
## 6                     Sandstrom, Miss. Marguerite Rut female   4     1
##   Parch           Ticket    Fare Cabin Embarked
## 1     0         PC 17599 71.2833   C85        C
## 2     0 STON/O2. 3101282  7.9250              S
## 3     0           113803 53.1000  C123        S
## 4     2           347742 11.1333              S
## 5     0           237736 30.0708              C
## 6     1          PP 9549 16.7000    G6        S
Las mujeres parecen tener más probabilidades de haber sobrevivido al desastre del Titanic, al menos de forma anecdótica.
Al explorar datos, deberías plantearte y responder preguntas que te interesen con las herramientas que tengas. Ahora quizá quieras arrange() tus observaciones por Fare ascendente para ver si se aprecia alguna tendencia. Usa el verbo arrange() para lograrlo:
# Arrange by increasing Fare
passengers %>%
  arrange(Fare)

##   PassengerId Survived Pclass                            Name  Sex Age
## 1         180        0      3             Leonard, Mr. Lionel male  36
## 2         264        0      1           Harrison, Mr. William male  40
## 3         272        1      3    Tornquist, Mr. William Henry male  25
## 4         278        0      2     Parkes, Mr. Francis "Frank" male  NA
## 5         303        0      3 Johnson, Mr. William Cahoone Jr male  19
## 6         414        0      2  Cunningham, Mr. Alfred Fleming male  NA
##   SibSp Parch Ticket Fare Cabin Embarked
## 1     0     0   LINE    0              S
## 2     0     0 112059    0   B94        S
## 3     0     0   LINE    0              S
## 4     0     0 239853    0              S
## 5     0     0   LINE    0              S
## 6     0     0 239853    0              S
Muchas de las personas que pagaron menos no sobrevivieron al desastre. Es algo interesante que acabas de descubrir solo reordenando tus datos.
También puedes arrange por Fare descendente:
# Arrange by decreasing Fare
passengers %>%
  arrange(desc(Fare))

##   PassengerId Survived Pclass                               Name    Sex
## 1         259        1      1                   Ward, Miss. Anna female
## 2         680        1      1 Cardeza, Mr. Thomas Drake Martinez   male
## 3         738        1      1             Lesurer, Mr. Gustave J   male
## 4          28        0      1     Fortune, Mr. Charles Alexander   male
## 5          89        1      1         Fortune, Miss. Mabel Helen female
## 6         342        1      1     Fortune, Miss. Alice Elizabeth female
##   Age SibSp Parch   Ticket     Fare       Cabin Embarked
## 1  35     0     0 PC 17755 512.3292                    C
## 2  36     0     1 PC 17755 512.3292 B51 B53 B55        C
## 3  35     0     0 PC 17755 512.3292        B101        C
## 4  19     3     2    19950 263.0000 C23 C25 C27        S
## 5  23     3     2    19950 263.0000 C23 C25 C27        S
## 6  24     3     2    19950 263.0000 C23 C25 C27        S
¡Efectivamente, hay más personas supervivientes en la parte alta!
A veces querrás crear variables nuevas. Sabes que la variable Parch es el número de padres e hijos, mientras que SibSp es el número de hermanos y cónyuges. Puedes sumarlas para obtener una nueva variable FamSize. Esto es ingeniería de características y, a menudo, es una parte importante del machine learning.
Para crear tu nueva variable, mutate() transforma las variables originales en la nueva.
# Create new column FamSize (size of family)
passengers %>%
  mutate(FamSize = Parch + SibSp)

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked FamSize
## 1     0        A/5 21171  7.2500              S       1
## 2     0         PC 17599 71.2833   C85        C       1
## 3     0 STON/O2. 3101282  7.9250              S       0
## 4     0           113803 53.1000  C123        S       1
## 5     0           373450  8.0500              S       0
## 6 0 330877 8.4583 Q 0Nota: mutate() sirve para crear columnas nuevas pero también para modificar columnas existentes, de forma parecida a cómo una mutación puede cambiar algo en biología. No es exacto, pero ayuda a entender la elección del verbo.
Ahora que tienes tu variable extra, puedes hacerte otras preguntas, como: "¿Es posible que las familias más grandes tuvieran una menor tasa de supervivencia?".
Para probar esta hipótesis, crea una nueva variable FamSize como la suma de Parch y SibSp como antes, y luego ordena por FamSize descendente:
# Create new column FamSize (size of family)
# Arrange by decreasing FamSize
passengers %>%
  mutate(FamSize = Parch + SibSp) %>%
  arrange(desc(FamSize))

##   PassengerId Survived Pclass                         Name    Sex Age
## 1         160        0      3   Sage, Master. Thomas Henry   male  NA
## 2         181        0      3 Sage, Miss. Constance Gladys female  NA
## 3         202        0      3          Sage, Mr. Frederick   male  NA
## 4         325        0      3     Sage, Mr. George John Jr   male  NA
## 5         793        0      3      Sage, Miss. Stella Anna female  NA
## 6         847        0      3     Sage, Mr. Douglas Bullen   male  NA
##   SibSp Parch   Ticket  Fare Cabin Embarked FamSize
## 1     8     2 CA. 2343 69.55              S      10
## 2     8     2 CA. 2343 69.55              S      10
## 3     8     2 CA. 2343 69.55              S      10
## 4     8     2 CA. 2343 69.55              S      10
## 5     8     2 CA. 2343 69.55              S      10
## 6     8     2 CA. 2343 69.55              S      10
¡Nadie en la familia más numerosa sobrevivió! Esto puede ser revelador: quizá, si formabas parte de una familia grande, no pudiste abandonar el Titanic a tiempo.
Sin embargo, como los ceros y unos no cuentan gran cosa por sí solos, transforma los valores de la variable Survived a cadenas No y Yes (y crea un nuevo data frame):
# Turn numerical values of Survived column to "No" & "Yes" (new data frame)
passengers1 <- passengers %>%
  mutate(Survived = ifelse(Survived == 0, "No", "Yes"))
passengers1

##   PassengerId Survived Pclass
## 1           1       No      3
## 2           2      Yes      1
## 3           3      Yes      3
## 4           4      Yes      1
## 5           5       No      3
## 6           6       No      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6 0 330877 8.4583 QPara visualizar tus datos con ggplot2, especificas tres cosas:
Primero dibujarás un diagrama de barras de Sex para ver cuántos hombres y mujeres se registraron a bordo del Titanic:
# Plot barplot of passenger Sex
ggplot(passengers, aes(x = Sex)) +
  geom_bar()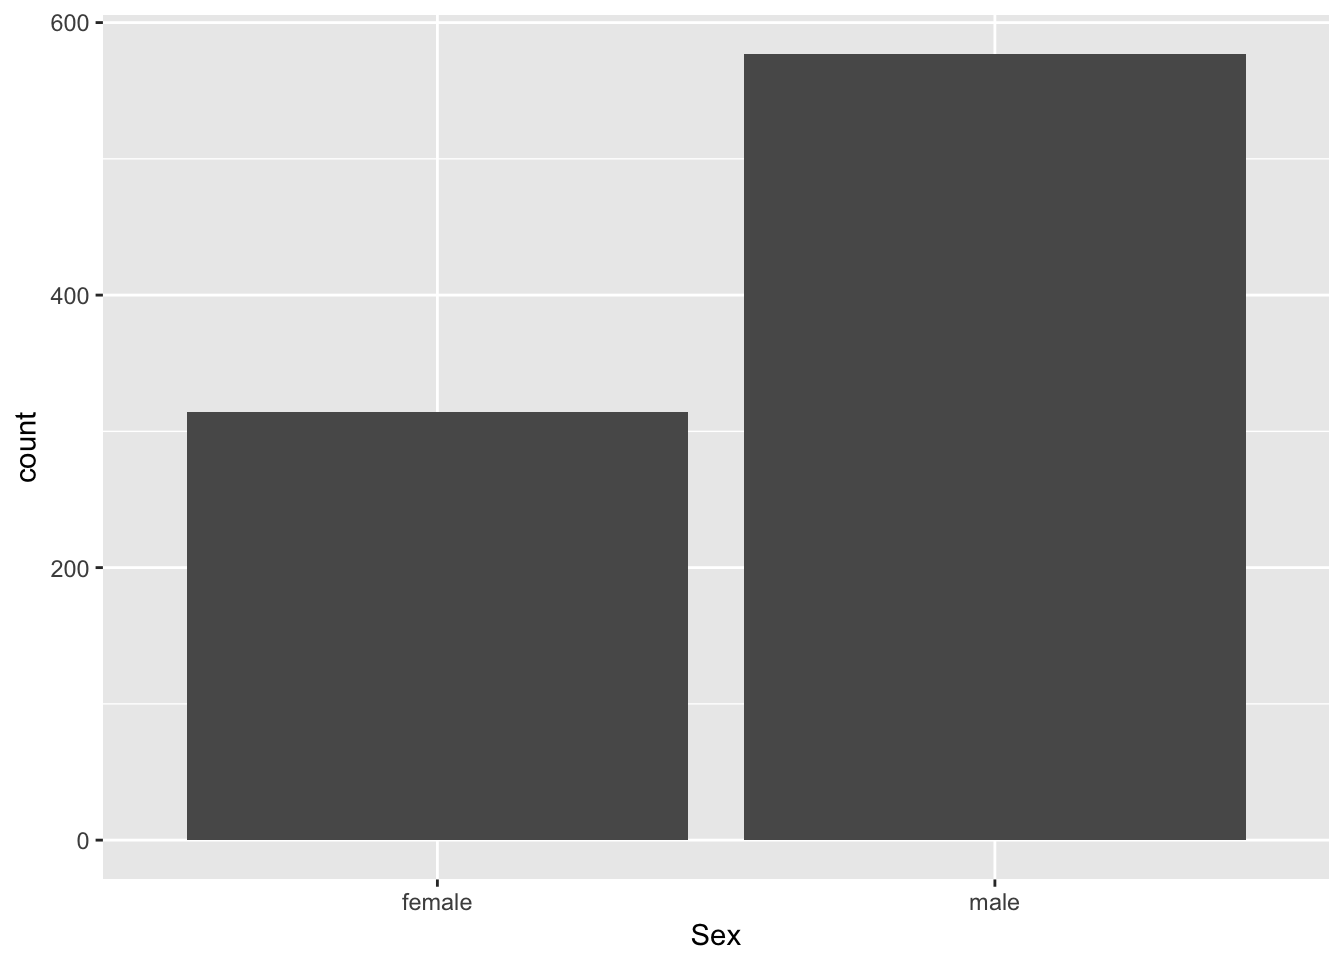
Por el gráfico anterior, se aprecia que había unos 600 hombres y 300 mujeres a bordo del RMS Titanic.
Nota: la función aes() sirve para mapear las aestéticas del gráfico a las variables de los datos. Consulta Modern Dive de Chester Ismay y Albert Y. Kim para saber más.
Ahora vamos con algunos diagramas de dispersión. ¿Está correlacionada la Age de cada pasajero con la Fare que pagó?
# Scatter plot of Age vs Fare
ggplot(passengers, aes(x = Age, y = Fare)) +
  geom_point()

## Warning: Removed 177 rows containing missing values (geom_point).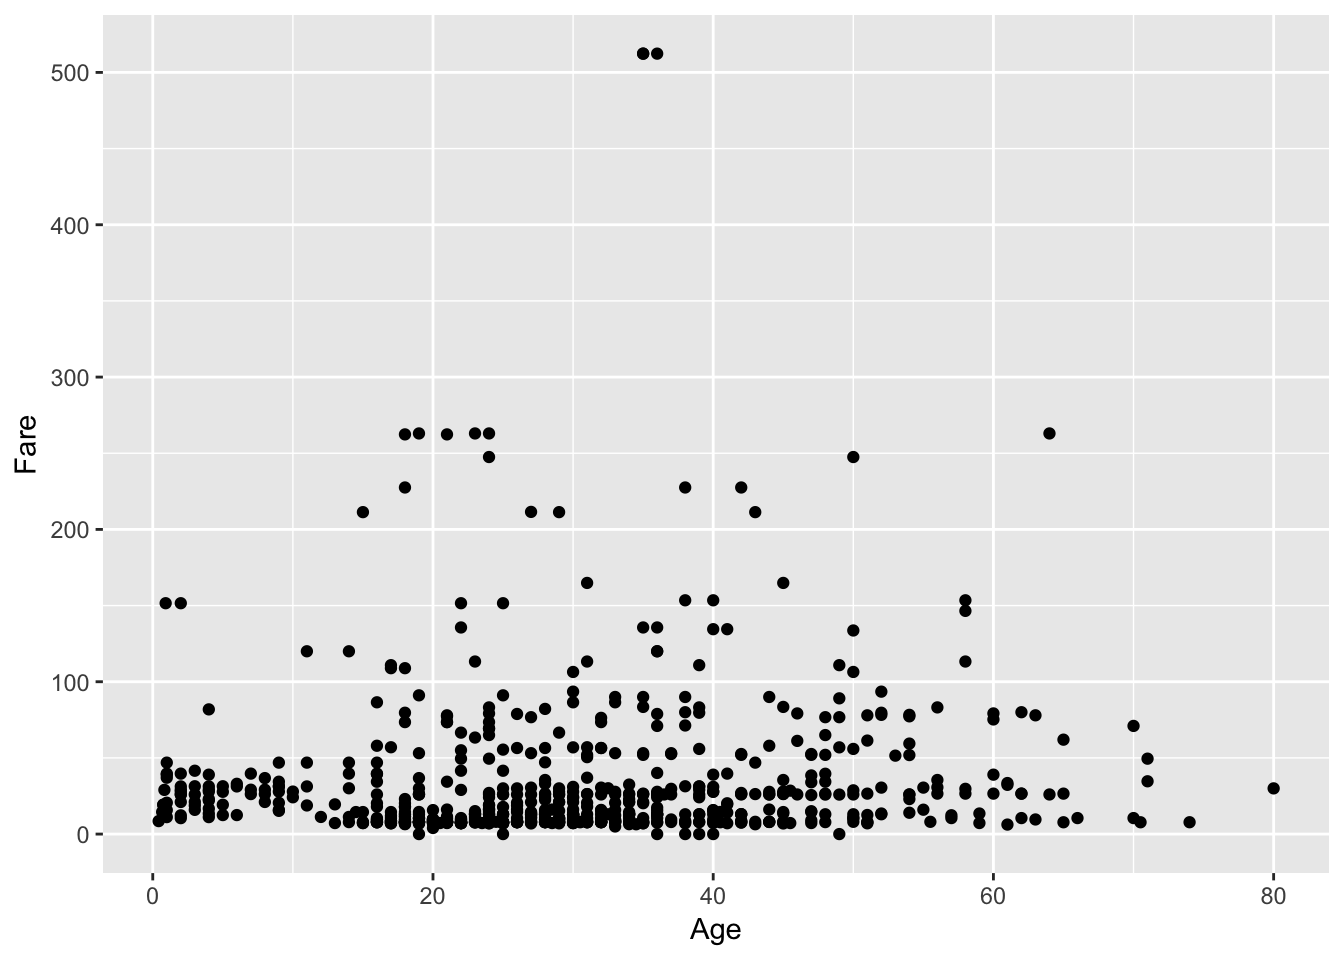
Has obtenido muchas ideas solo con este gráfico. Se ve que muchas de las personas que pagaron más también eran notablemente mayores. Podría haber un incremento de tarifa según la edad... Además, se ven dos valores atípicos en la parte superior del gráfico que quizá quieras investigar.
Puedes leer tu código de ggplot2 como una frase, igual que el de dplyr de antes: "Tomas los datos de titanic y asignas Age al eje x y Fare al eje y, añadiendo puntos como capa del gráfico".
Tomemos el gráfico anterior y coloreemos cada punto por Sex para ver correlaciones entre Sex, Age y Fare:
# Scatter plot of Age vs Fare colored by Sex
ggplot(passengers %>% drop_na(), aes(x = Age, y = Fare, color = Sex)) +
  geom_point()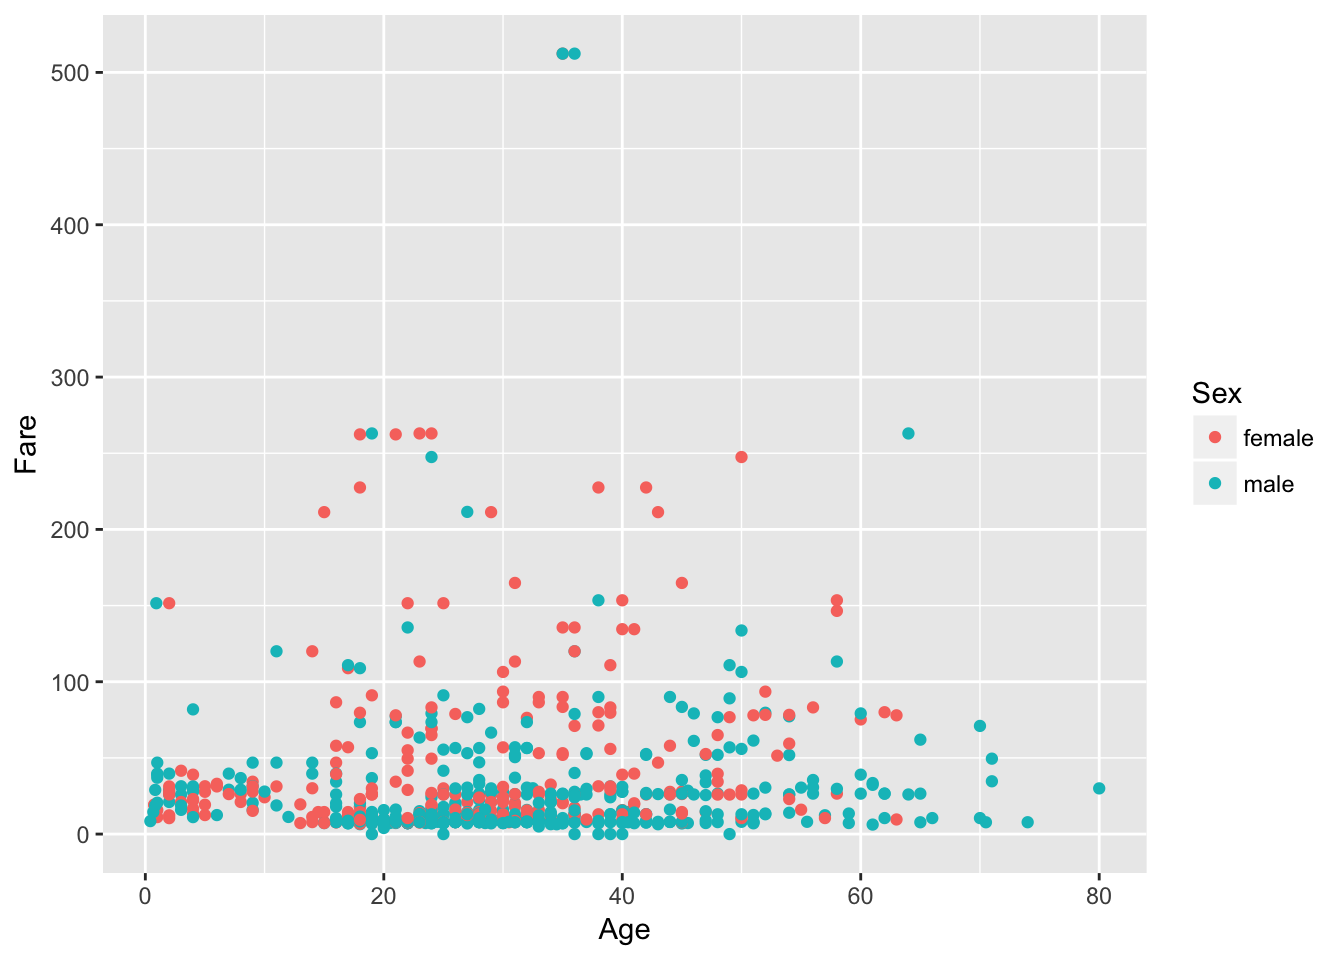
Se ve que muchos de los que pagaron menos, en la parte inferior, eran hombres. También hay un grupo de mujeres hacia la parte alta del gráfico que eran algo mayores y pagaron más por embarcar en el Titanic.
Visualizar tres variables (dos numéricas, Age y Fare, y una categórica, Sex) en un único gráfico está muy bien, pero ¿y si quieres añadir la variable Survived para ver si hay tendencias claras? Puedes hacerlo con facetas, una forma de generar múltiples gráficos a la vez:
# Scatter plot of Age vs Fare colored by Sex faceted by Survived
ggplot(passengers1, aes(x = Age, y = Fare, color = Sex)) +
  geom_point() +
  facet_grid(~Survived)

## Warning: Removed 177 rows containing missing values (geom_point).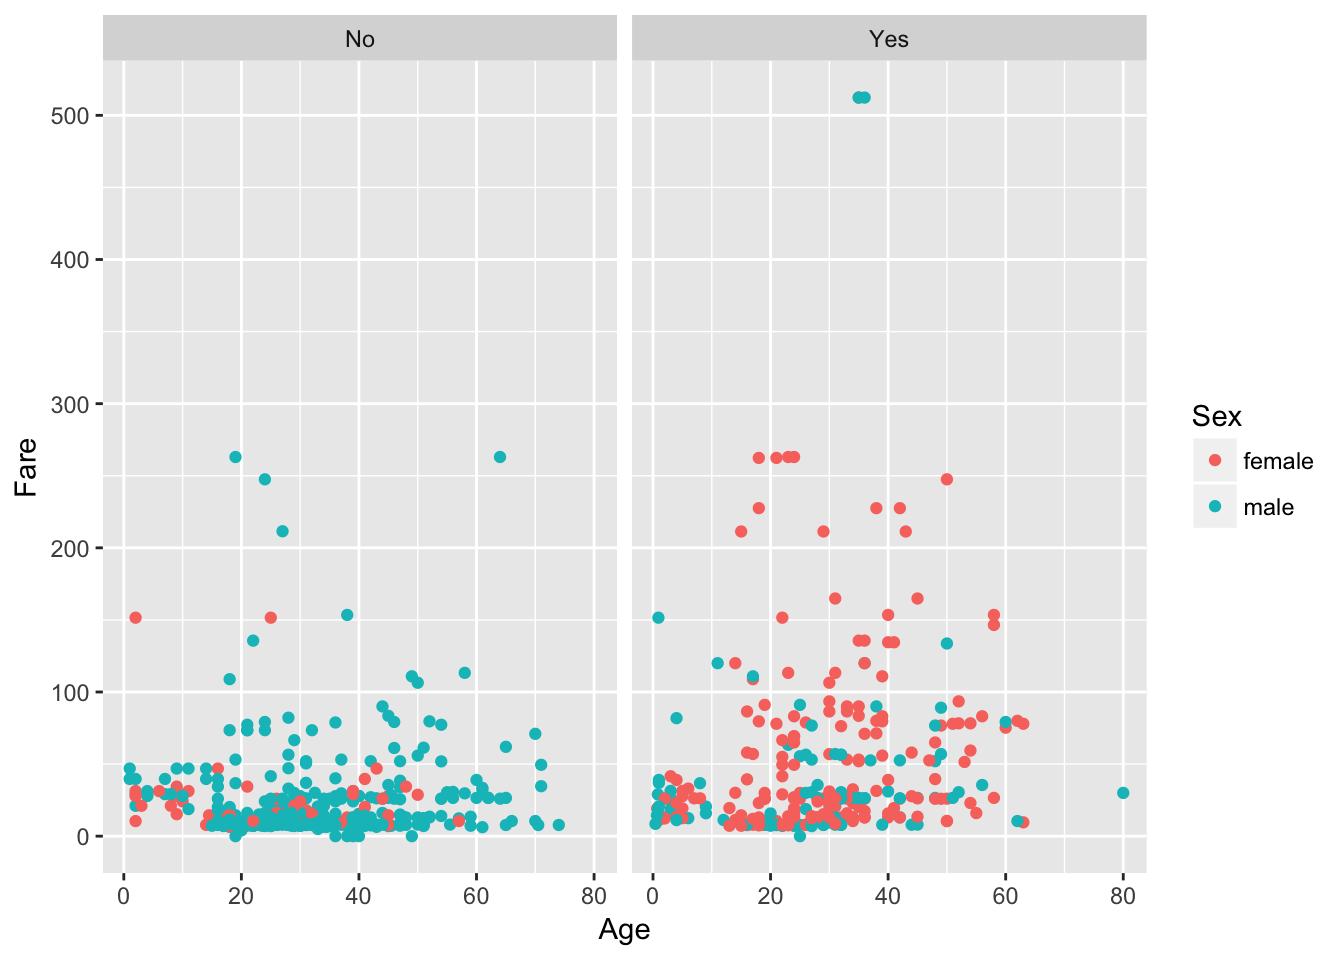
De repente, ves que muchas de las mujeres que detectaste arriba en el gráfico anterior sobrevivieron, y que la mayoría de las que no lo hicieron pagaron menos de 50 unidades. Consejo: intenta averiguar tú mismo la moneda.
Ahora rehagamos el diagrama de barras de Sex y, esta vez, rellena las barras según Survived:
# Plot barplot of passenger Sex & fill according to Survival
ggplot(passengers1, aes(x = Sex, fill = Survived)) +
  geom_bar()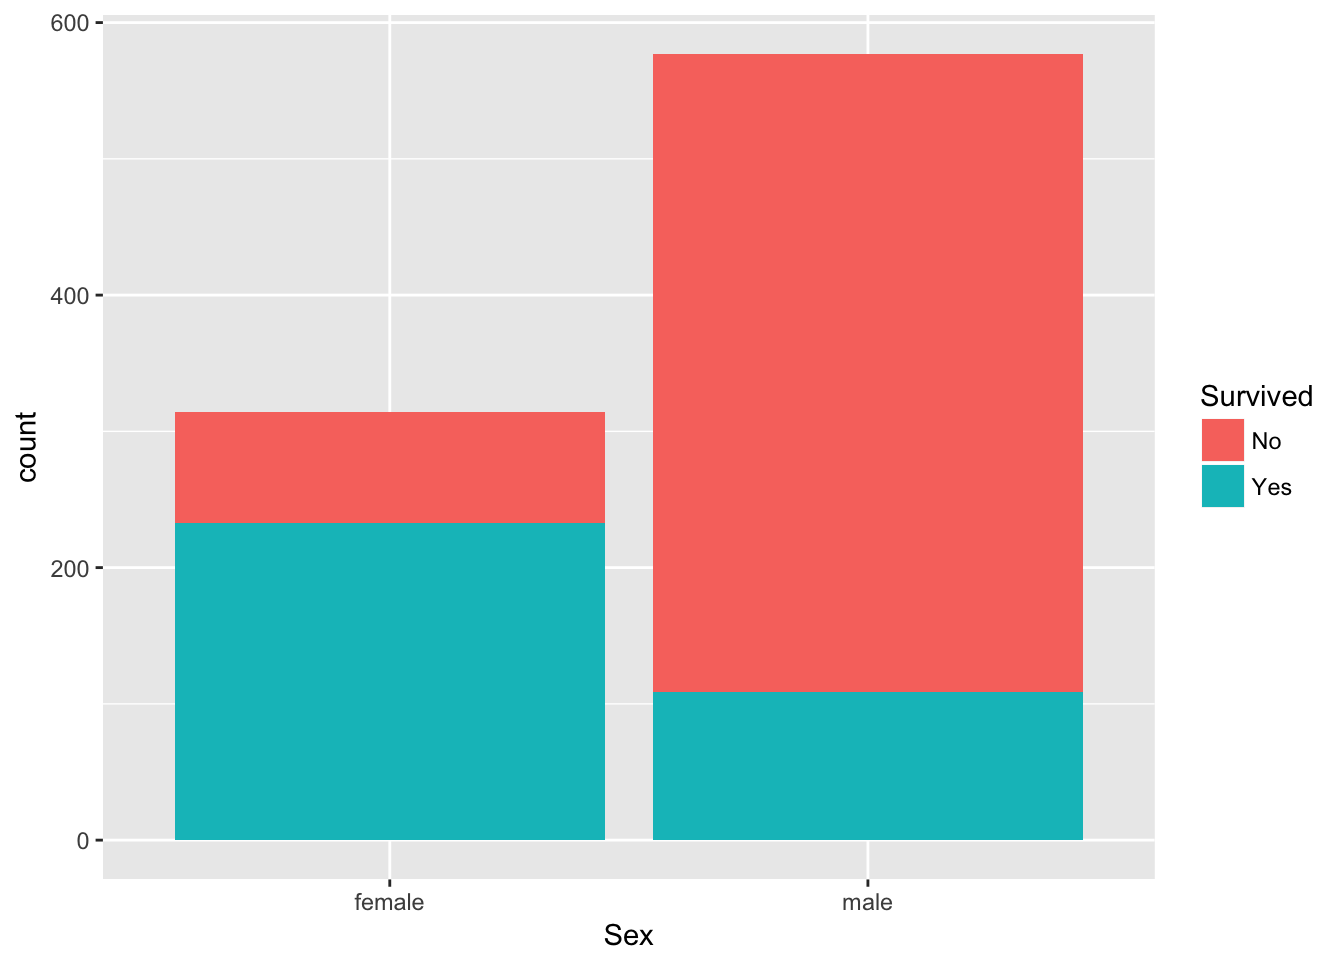
Ves que una gran proporción de hombres no sobrevivió, mientras que más de dos tercios de las mujeres sí lo hicieron.
Usa el verbo summarise() para calcular la tarifa media pagada:
# Check out mean Fare
passengers %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 32.20421
Usa el verbo summarise() para calcular la mediana de la tarifa pagada:
# Check out mean Fare
passengers %>%
  summarise(medianFare = median(Fare))

##   medianFare
## 1    14.4542
También puedes usar filter() y summarise() para saber la tarifa media pagada entre los hombres:
# Check out mean Fare for men
passengers %>%
  filter(Sex == "male") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 25.52389
Usa filter() y summarise() para saber la tarifa media pagada entre las mujeres:
# Check out mean Fare for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 44.47982
Usa filter() y summarise() para saber la tarifa media pagada entre las mujeres y cuántas mujeres sobrevivieron:
# Check out mean Fare & number of survivors for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

##   meanFare numSurv
## 1 44.47982     233
Usa group_by() y summarise() para obtener la tarifa media y el número de personas supervivientes en función del sexo:
# Check out mean Fare & number of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <int>
## 1 female     44.5     233
## 2 male       25.5     109
Usa group_by() y summarise() para obtener la tarifa media y la proporción de personas supervivientes en función del sexo:
# Check out mean Fare & proportion of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived)/n())

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <dbl>
## 1 female     44.5   0.742
## 2 male 25.5 0.189En este tutorial has pasado de cero a uno con lo básico del análisis de datos usando el tidyverse y sus herramientas. Has aprendido a filter() tus datos, a arrange() y mutate(), a representarlos y a summarise() con dplyr y ggplot2, todo escribiendo código que refleja cómo piensas y hablas sobre datos. Enhorabuena. Te animamos a seguir aprendiendo con el curso de David Robinson Introduction to Tidyverse y a usar estas herramientas en otros conjuntos de datos que te interesen. Comparte tus análisis con nosotros en Twitter @DataCamp y @hugobowne. Gracias por leer.
Aprende más sobre R
Curso
Curso
Curso
Tutorial
Łukasz Deryło
10 min
Tutorial
Karlijn Willems
15 min
Tutorial
Olivia Smith
6 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Kevin Babitz
15 min
Tutorial
Abid Ali Awan
10 min