कोर्स
Tidyverse परिचय
4 घंटा
397.1K
यह ट्यूटोरियल पिछले हफ्ते किए गए हमारे एक Facebook Live इवेंट का लेखन रूप है। विषय था "Introduction to the Tidyverse" और यह ट्यूटोरियल आपको कोड-अलॉन्ग सत्र में कवर की गई पूरी सामग्री से होकर ले जाएगा!
सत्र के पहले भाग को आप यहाँ देख सकते हैं:
और दूसरा भाग यहाँ:
ध्यान दें कि आप सत्र का सारा कोड इस रिपोजिटरी में पा सकते हैं।
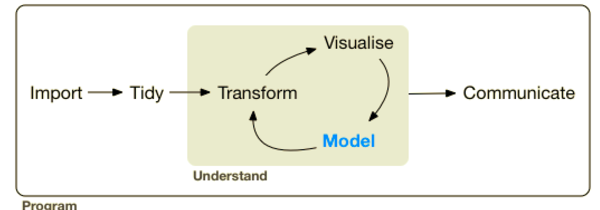
कोर tidyverse में वे पैकेज शामिल हैं जिन्हें आप रोज़मर्रा के डेटा विश्लेषण में संभवतः इस्तेमाल करेंगे, जैसे डेटा विज़ुअलाइज़ेशन के लिए ggplot2 और डेटा रैंगलिंग के लिए dplyr। इस ट्यूटोरियल में आप इन्हीं दो पर ध्यान देंगे।
याद रखें कि एक पैकेज मूल रूप से डेटा के साथ काम करने के लिए औज़ारों का एक सेट होता है। यदि आप R में पैकेजों के बारे में अधिक जानना चाहते हैं, तो यह ट्यूटोरियल देखें।
Tidyverse के बारे में और अधिक के लिए, DataCamp पर David Robinson का Introduction to Tidyverse कोर्स और Learn the Tidyverse संसाधन देखें।
सबसे पहले, यदि आपने अब तक इंस्टॉल नहीं किया है, तो tidyverse इंस्टॉल करें:
# Install the tidyverse
# install.packages("tidyverse")
अब जब आपने tidyverse इंस्टॉल कर लिया है, तो अपना डेटा लोड करें और कुछ ऑब्ज़र्वेशंस देखें।
इस ट्यूटोरियल में, आप Titanic डेटासेट को एक्सप्लोर करेंगे, जहाँ प्रत्येक ऑब्ज़र्वेशन एक व्यक्ति है और प्रत्येक वैरिएबल एक फीचर है, जैसे Name, Age और Survived (या नहीं)।
अपना डेटा इस तरह लोड करें:
 # Import the Tidyverse
library(tidyverse)

# Import data
passengers <- read.csv("data/train.csv")

# Check out the first several observations of your dataframe
passengers

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6     0           330877  8.4583              Q
ध्यान दें कि read.csv() को जो पाथ आप देंगे, वह आपकी सेटअप पर निर्भर कर सकता है। यदि आप वही फ़ाइल पाथ रखना चाहते हैं, तो आप हमेशा हमारे GitHub रिपोजिटरी में इस प्रोजेक्ट की फ़ोल्डर संरचना देख सकते हैं, जो आपको यहाँ मिलेगी।
यह भी ध्यान दें कि यदि आप passengers चलाने पर दिखने वाले सभी वैरिएबल्स के बारे में अधिक जानना चाहते हैं, तो आप डेटासेट विवरण देख सकते हैं।
अपने डेटा का अवलोकन पाने के लिए, आप summary() फ़ंक्शन का उपयोग कर सकते हैं:
# Summarize titanic
summary(passengers)

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
##  (Other)    :186
अब वही काम एक pipe %>% के साथ करें, जो tidyverse के सबसे उपयोगी औज़ारों में से एक है:
# Summarize titanic using a pipe
passengers %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
## (Other) :186टिप: यदि आप R में पाइप ऑपरेटर के उपयोग के बारे में और जानना चाहते हैं, तो यह ट्यूटोरियल देखें।
इसी को मिसिंग वैल्यूज़ वाली ऑब्ज़र्वेशंस हटाने के बाद करें। एक संकेत: आप पाइप्स को जोड़ सकते हैं!
# Summarize titanic after dropping na
passengers %>%
  drop_na() %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:222.2   1st Qu.:0.0000   1st Qu.:1.000
##  Median :445.0   Median :0.0000   Median :2.000
##  Mean   :448.6   Mean   :0.4062   Mean   :2.237
##  3rd Qu.:677.8   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:261   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :453   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :708
##      SibSp            Parch                 Ticket         Fare
##  Min.   :0.0000   Min.   :0.0000   347082      :  7   Min.   :  0.00
##  1st Qu.:0.0000   1st Qu.:0.0000   3101295     :  6   1st Qu.:  8.05
##  Median :0.0000   Median :0.0000   347088      :  6   Median : 15.74
##  Mean   :0.5126   Mean   :0.4314   CA 2144     :  6   Mean   : 34.69
##  3rd Qu.:1.0000   3rd Qu.:1.0000   382652      :  5   3rd Qu.: 33.38
##  Max.   :5.0000   Max.   :6.0000   S.O.C. 14879:  5   Max.   :512.33
##                                    (Other)     :679
##          Cabin     Embarked
##             :529    :  2
##  B96 B98    :  4   C:130
##  C23 C25 C27:  4   Q: 28
##  G6         :  4   S:554
##  C22 C26    :  3
##  D          :  3
##  (Other)    :167
हो सकता है आपने ऊपर लिखे कोड में शैलीगत एकरूपता नोटिस की हो। यह इसलिए है क्योंकि आप एक स्टाइल गाइड का पालन कर रहे हैं। डेटा साइंस और सामान्य रूप से प्रोग्रामिंग/कोडिंग में, यथाशीघ्र स्टाइल गाइड अपनाना महत्वपूर्ण है। जैसा कि Hadley Wickham tidyverse स्टाइल गाइड में कहते हैं,
अच्छी कोडिंग शैली सही विराम चिह्नों की तरह है: आप उसके बिना भी काम चला सकते हैं, पर इससे पढ़ना वाकई आसान हो जाता है।
अगले खंड में, आप dplyr के साथ डेटा रैंगलिंग करेंगे ताकि आप अपने डेटा को फ़िल्टर कर सकें, उसे व्यवस्थित कर सकें और पुराने वैरिएबल्स को बदलकर नए फीचर्स बना सकें।
अब समय है अपने डेटा को एक्सप्लोर करने और डेटासेट के बारे में शुरुआती समझ बनाने का। आप dplyr के verbs जैसे filter(), arrange() और mutate() का उपयोग करेंगे, जो बिल्कुल वही करते हैं जैसा उनके नाम बताते हैं।
मान लीजिए कि आप कुछ विशेष ऑब्ज़र्वेशंस चुनना चाहते हैं, जैसे वे जिनके लिए "Sex" 'female' है। dplyr हमें यह सहज ढंग से करने देता है और ऐसी भाषा में जो डेटा के बारे में आपकी सोच और बातचीत को प्रतिबिंबित करती है।
filter verb केवल उन्हीं ऑब्ज़र्वेशंस को चुनता है जो शर्त से मेल खाते हैं। इसे क्रिया में देखें:
# Filter to get all "male" rows
passengers %>%
  filter(Sex == "male")

##   PassengerId Survived Pclass                           Name  Sex Age
## 1           1        0      3        Braund, Mr. Owen Harris male  22
## 2           5        0      3       Allen, Mr. William Henry male  35
## 3           6        0      3               Moran, Mr. James male  NA
## 4           7        0      1        McCarthy, Mr. Timothy J male  54
## 5           8        0      3 Palsson, Master. Gosta Leonard male   2
## 6          13        0      3 Saundercock, Mr. William Henry male  20
##   SibSp Parch    Ticket    Fare Cabin Embarked
## 1     1     0 A/5 21171  7.2500              S
## 2     0     0    373450  8.0500              S
## 3     0     0    330877  8.4583              Q
## 4     0     0     17463 51.8625   E46        S
## 5     3     1    349909 21.0750              S
## 6     0     0 A/5. 2151  8.0500              S
ऊपर दिए गए कोड के परिणामों को देखते समय, आप देखेंगे कि ऐसा लगता है कि कई पुरुष RMS Titanic के डूबने से बच नहीं पाए। यह दिलचस्प है, और आप इसे इस ट्यूटोरियल में आगे और ठोस तरीके से जांचेंगे!
ध्यान दें कि आप dplyr कोड को एक वाक्य की तरह पढ़ सकते हैं: अपना डेटा लें और फिर (%>%) उसे इस शर्त के अनुसार फ़िल्टर करें कि sex male है। ऊपर दिए गए कोड खंड का कोड मूल डेटा फ़्रेम को नहीं बदलता। filter(Sex = "male") एक आम त्रुटि है (Hugo ने भी यही गलती की थी!); एक बढ़िया tidyverse एरर गाइड है।
# Filter to get all "female" rows
passengers %>%
  filter(Sex == "female")

##   PassengerId Survived Pclass
## 1           2        1      1
## 2           3        1      3
## 3           4        1      1
## 4           9        1      3
## 5          10        1      2
## 6          11        1      3
##                                                  Name    Sex Age SibSp
## 1 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 2                              Heikkinen, Miss. Laina female  26     0
## 3        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 4   Johnson, Mrs. Oscar W (Elisabeth Vilhelmina Berg) female  27     0
## 5                 Nasser, Mrs. Nicholas (Adele Achem) female  14     1
## 6                     Sandstrom, Miss. Marguerite Rut female   4     1
##   Parch           Ticket    Fare Cabin Embarked
## 1     0         PC 17599 71.2833   C85        C
## 2     0 STON/O2. 3101282  7.9250              S
## 3     0           113803 53.1000  C123        S
## 4     2           347742 11.1333              S
## 5     0           237736 30.0708              C
## 6     1          PP 9549 16.7000    G6        S
कम-से-कम सरसरी तौर पर देखें तो, महिलाएँ टाइटैनिक हादसे से अधिक संभावना के साथ बची दिखती हैं।
जब आप डेटा एक्सप्लोर करते हैं, तो आपको अपनी रुचि के सवाल पूछने और अपनी क्षमता के अनुसार उनके जवाब ढूँढने चाहिए! अभी, आप अपने ऑब्ज़र्वेशंस को बढ़ते हुए Fare के अनुसार arrange() करना चाह सकते हैं, ताकि देखें कि कोई रुझान दिखता है या नहीं। आप यह काम arrange() verb से कर सकते हैं:
# Arrange by increasing Fare
passengers %>%
  arrange(Fare)

##   PassengerId Survived Pclass                            Name  Sex Age
## 1         180        0      3             Leonard, Mr. Lionel male  36
## 2         264        0      1           Harrison, Mr. William male  40
## 3         272        1      3    Tornquist, Mr. William Henry male  25
## 4         278        0      2     Parkes, Mr. Francis "Frank" male  NA
## 5         303        0      3 Johnson, Mr. William Cahoone Jr male  19
## 6         414        0      2  Cunningham, Mr. Alfred Fleming male  NA
##   SibSp Parch Ticket Fare Cabin Embarked
## 1     0     0   LINE    0              S
## 2     0     0 112059    0   B94        S
## 3     0     0   LINE    0              S
## 4     0     0 239853    0              S
## 5     0     0   LINE    0              S
## 6     0     0 239853    0              S
कई ऐसे लोग जिन्होंने कम किराया दिया था, वे हादसे में नहीं बचे। यह कुछ दिलचस्प है, जो आपने केवल अपने डेटा को फिर से व्यवस्थित करके खोजा!
आप Fare के घटते क्रम में भी arrange कर सकते हैं:
# Arrange by decreasing Fare
passengers %>%
  arrange(desc(Fare))

##   PassengerId Survived Pclass                               Name    Sex
## 1         259        1      1                   Ward, Miss. Anna female
## 2         680        1      1 Cardeza, Mr. Thomas Drake Martinez   male
## 3         738        1      1             Lesurer, Mr. Gustave J   male
## 4          28        0      1     Fortune, Mr. Charles Alexander   male
## 5          89        1      1         Fortune, Miss. Mabel Helen female
## 6         342        1      1     Fortune, Miss. Alice Elizabeth female
##   Age SibSp Parch   Ticket     Fare       Cabin Embarked
## 1  35     0     0 PC 17755 512.3292                    C
## 2  36     0     1 PC 17755 512.3292 B51 B53 B55        C
## 3  35     0     0 PC 17755 512.3292        B101        C
## 4  19     3     2    19950 263.0000 C23 C25 C27        S
## 5  23     3     2    19950 263.0000 C23 C25 C27        S
## 6  24     3     2    19950 263.0000 C23 C25 C27        S
वास्तव में ऊपर के सिरे पर अधिक बचे हुए लोग दिखते हैं!
कभी-कभी आप नए वैरिएबल्स बनाना चाहेंगे। आप जानते हैं कि Parch माता-पिता और बच्चों की संख्या है जबकि SibSp भाई-बहनों और पति/पत्नी की संख्या है। आप इन दोनों को जोड़कर एक नया वैरिएबल FamSize बना सकते हैं। यह फीचर इंजीनियरिंग है और मशीन लर्निंग में अक्सर यह बड़ा हिस्सा होता है!
अब, अपना नया वैरिएबल बनाने के लिए, आप मूल वैरिएबल्स को बदलकर mutate() के जरिए नया वैरिएबल बनाएँ।
# Create new column FamSize (size of family)
passengers %>%
  mutate(FamSize = Parch + SibSp)

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked FamSize
## 1     0        A/5 21171  7.2500              S       1
## 2     0         PC 17599 71.2833   C85        C       1
## 3     0 STON/O2. 3101282  7.9250              S       0
## 4     0           113803 53.1000  C123        S       1
## 5     0           373450  8.0500              S       0
## 6     0           330877  8.4583              Q       0
ध्यान दें कि mutate() का इस्तेमाल नए कॉलम बनाने के साथ-साथ मौजूदा कॉलमों को संशोधित करने के लिए भी किया जा सकता है, कुछ उसी तरह जैसे जैविक संदर्भ में म्यूटेशन कार्य करता है। यह बिल्कुल सटीक उपमा नहीं है, पर क्रिया-चयन के संदर्भ को समझाने का अच्छा तरीका है।
अब जबकि आपके पास अतिरिक्त वैरिएबल है, आप दूसरे प्रश्न पूछ सकते हैं, जैसे कि "क्या संभव है कि बड़े परिवारों की उत्तरजीविता दर कम रही हो?"
इस परिकल्पना की जांच के लिए, ऊपर की तरह Parch और SibSp का योग लेकर एक नया वैरिएबल FamSize बनाएँ, फिर FamSize के घटते क्रम में व्यवस्थित करें:
# Create new column FamSize (size of family)
# Arrange by decreasing FamSize
passengers %>%
  mutate(FamSize = Parch + SibSp) %>%
  arrange(desc(FamSize))

##   PassengerId Survived Pclass                         Name    Sex Age
## 1         160        0      3   Sage, Master. Thomas Henry   male  NA
## 2         181        0      3 Sage, Miss. Constance Gladys female  NA
## 3         202        0      3          Sage, Mr. Frederick   male  NA
## 4         325        0      3     Sage, Mr. George John Jr   male  NA
## 5         793        0      3      Sage, Miss. Stella Anna female  NA
## 6         847        0      3     Sage, Mr. Douglas Bullen   male  NA
##   SibSp Parch   Ticket  Fare Cabin Embarked FamSize
## 1     8     2 CA. 2343 69.55              S      10
## 2     8     2 CA. 2343 69.55              S      10
## 3     8     2 CA. 2343 69.55              S      10
## 4     8     2 CA. 2343 69.55              S      10
## 5     8     2 CA. 2343 69.55              S      10
## 6     8     2 CA. 2343 69.55              S      10
शीर्ष परिवार के सभी लोग नहीं बचे! यह संकेतात्मक हो सकता है: शायद बड़े परिवार का हिस्सा होने पर समय पर टाइटैनिक से उतर पाना मुश्किल रहा होगा।
हालाँकि, शून्य और एक अक्सर बहुत कुछ नहीं बताते, इसलिए Survived वैरिएबल के मानों को स्ट्रिंग्स No और Yes में बदलें (और एक नया डेटा फ़्रेम बनाएँ!):
# Turn numerical values of Survived column to "No" & "Yes" (new data frame)
passengers1 <- passengers %>%
  mutate(Survived = ifelse(Survived == 0, "No", "Yes"))
passengers1

##   PassengerId Survived Pclass
## 1           1       No      3
## 2           2      Yes      1
## 3           3      Yes      3
## 4           4      Yes      1
## 5           5       No      3
## 6           6       No      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6 0 330877 8.4583 Qggplot2 का उपयोग करके डेटा प्लॉट करने के लिए, आप तीन बातें निर्दिष्ट करते हैं:
सबसे पहले आप Sex का बारप्लॉट बनाएँगे ताकि देखें कि टाइटैनिक पर कितने पुरुष और महिलाएँ दर्ज थीं:
# Plot barplot of passenger Sex
ggplot(passengers, aes(x = Sex)) +
  geom_bar()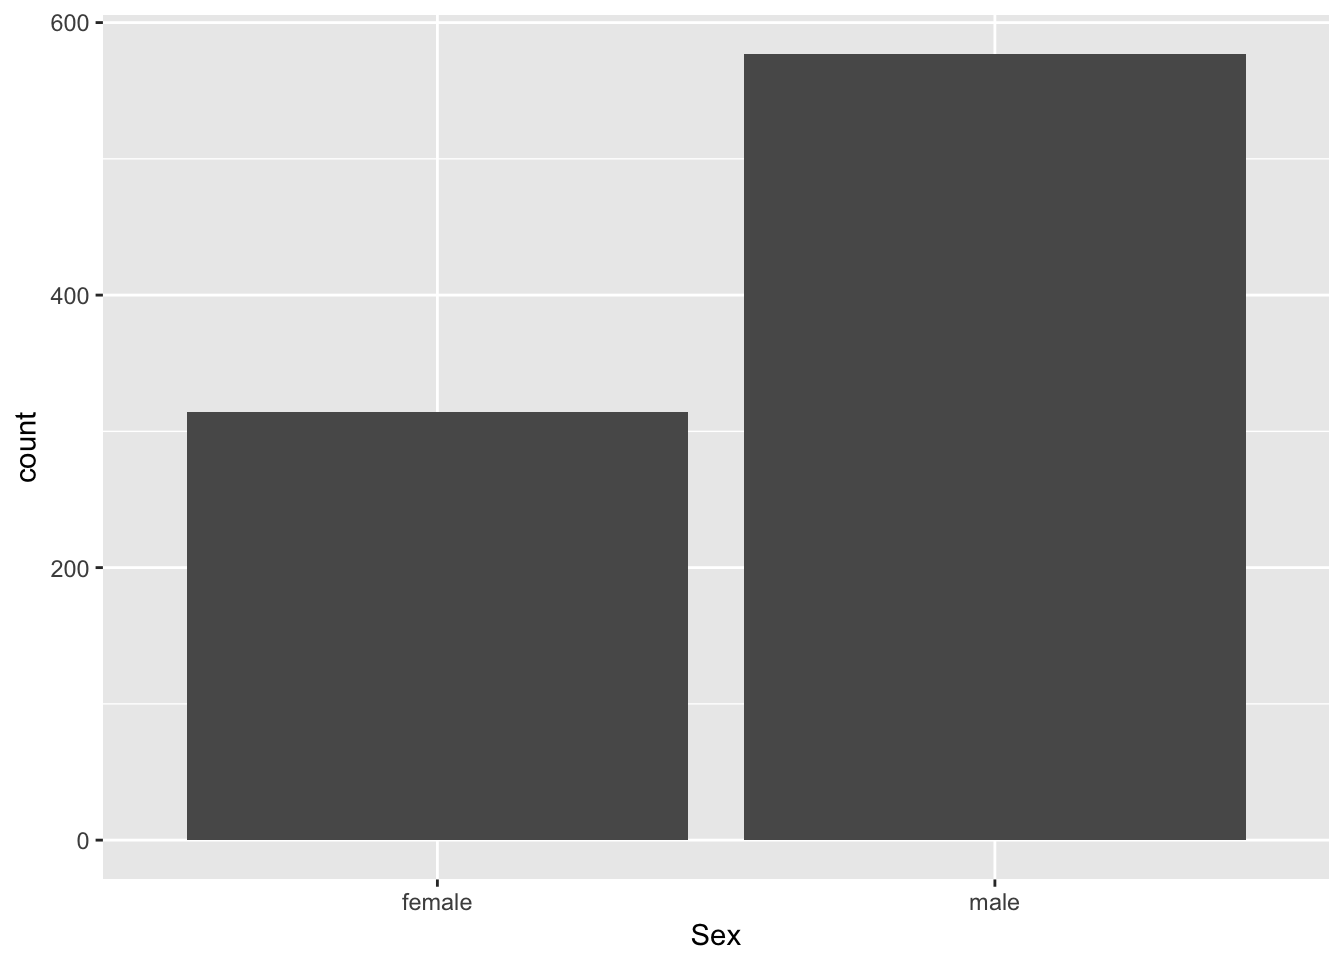
ऊपर के प्लॉट से आप बता सकते हैं कि RMS टाइटैनिक पर लगभग 600 पुरुष और 300 महिलाएँ थीं।
ध्यान दें कि aes() फ़ंक्शन वास्तव में प्लॉट के एस्थेटिक्स को डेटा में मौजूद वैरिएबल्स से मैप करने का तरीका है। अधिक जानकारी के लिए Chester Ismay और Albert Y. Kim की Modern Dive देखें।
अब बारी है कुछ स्कैटर प्लॉट्स की। क्या किसी यात्री की Age का उस Fare से सहसंबंध है जो उन्होंने चुकाया?
# Scatter plot of Age vs Fare
ggplot(passengers, aes(x = Age, y = Fare)) +
  geom_point()

## Warning: Removed 177 rows containing missing values (geom_point).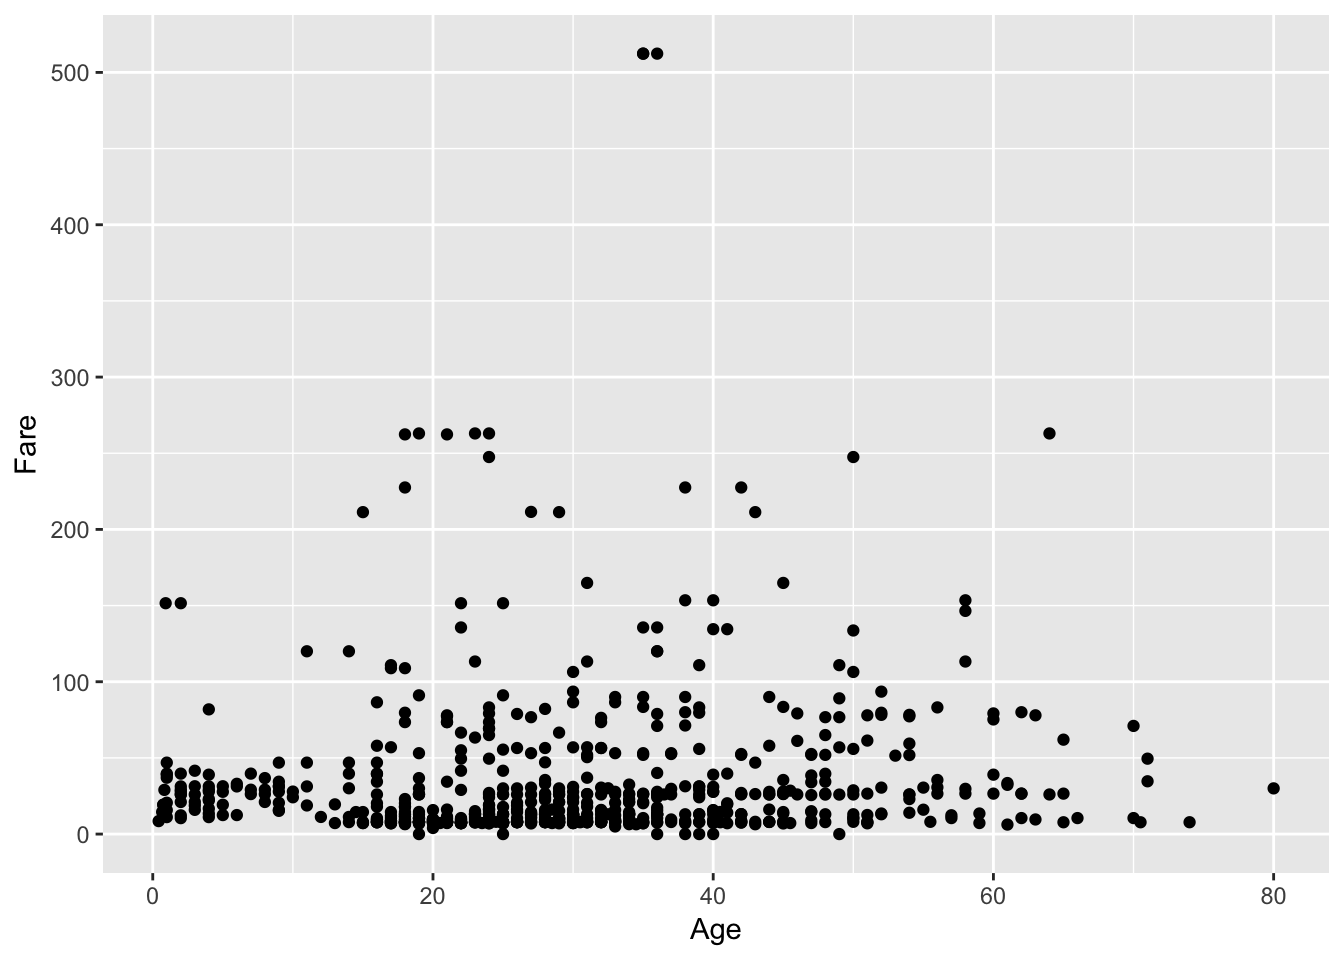
सिर्फ इस एक प्लॉट से आपने कई अंतर्दृष्टियाँ जुटा लीं! आप देखते हैं कि जिन लोगों ने अधिक भुगतान किया, वे काफी हद तक उम्रदराज़ भी थे। हो सकता है उम्र के साथ किराये में वृद्धि रही हो... साथ ही, आपको प्लॉट के शीर्ष पर दो अपवाद तुरंत दिखते हैं, जिन्हें आप आगे जाँचना चाहेंगे!
आप अपने ggplot2 कोड को एक वाक्य की तरह पढ़ सकते हैं, ठीक वैसे ही जैसे ऊपर आपने dplyr कोड पढ़ा: "आप डेटा के रूप में टाइटैनिक लेते हैं और Age को x-अक्ष तथा Fare को y-अक्ष से मैप करते हैं, और बिंदुओं को प्लॉट की लेयर के रूप में जोड़ते हैं।"
आइए पिछले प्लॉट में हर बिंदु को Sex के आधार पर रंग दें, ताकि Sex, Age और Fare के बीच कोई सहसंबंध दिखे तो पता चल सके:
# Scatter plot of Age vs Fare colored by Sex
ggplot(passengers %>% drop_na(), aes(x = Age, y = Fare, color = Sex)) +
  geom_point()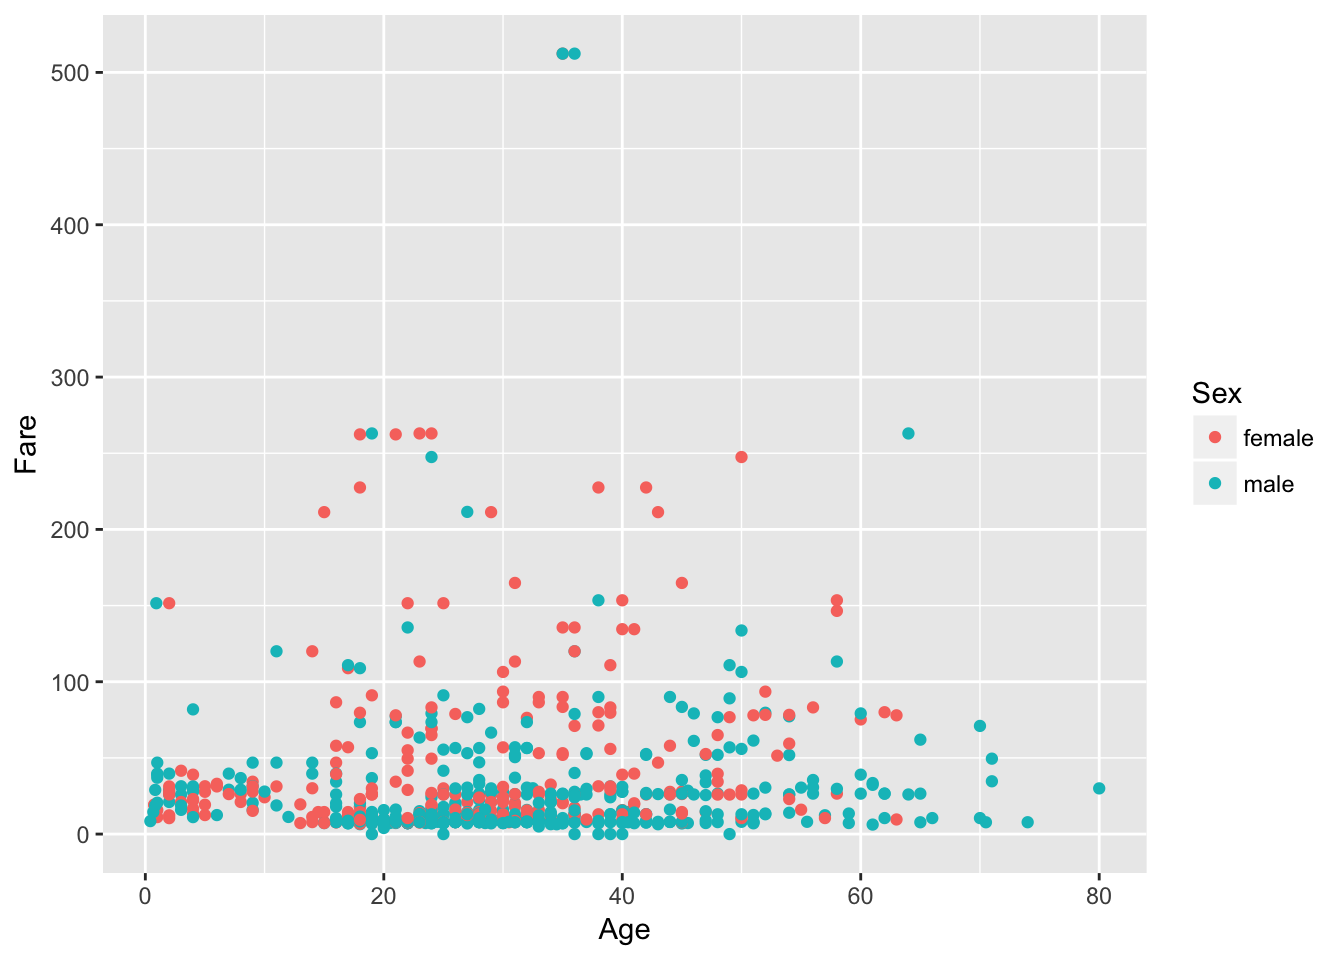
आप देखते हैं कि नीचे, कम भुगतान करने वाले कई लोग पुरुष थे। साथ ही, प्लॉट के ऊपरी हिस्से में महिलाओं का एक समूह है जो थोड़ी अधिक उम्र की थीं और बोर्डिंग के लिए अधिक भुगतान भी किया था।
एक ही प्लॉट पर तीन वैरिएबल्स को देखना (दो संख्यात्मक, Age और Fare, और एक श्रेणीबद्ध, Sex) काफ़ी अच्छा है, लेकिन अगर आप यह भी देखना चाहें कि Survived वैरिएबल जोड़ने पर कोई स्पष्ट रुझान दिखता है या नहीं? आप यह फैसेटिंग से कर सकते हैं, जो एक साथ कई प्लॉट बनाने का तरीका है:
# Scatter plot of Age vs Fare colored by Sex faceted by Survived
ggplot(passengers1, aes(x = Age, y = Fare, color = Sex)) +
  geom_point() +
  facet_grid(~Survived)

## Warning: Removed 177 rows containing missing values (geom_point).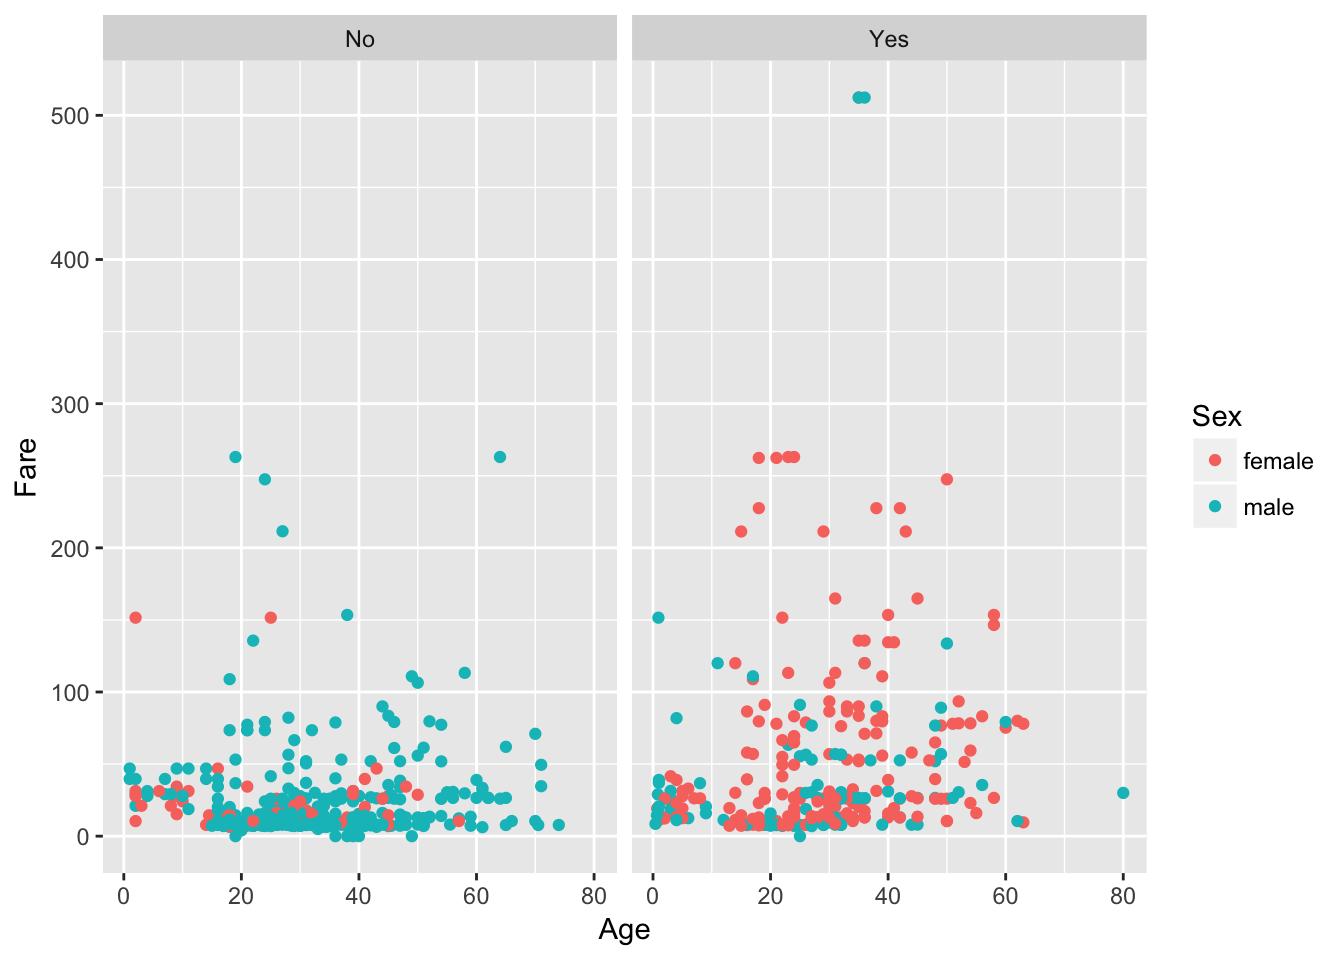
अचानक, आप देखते हैं कि पिछले प्लॉट में ऊपर जिन महिलाओं पर आपका ध्यान गया था, उनमें से बहुत-सी बच गईं, और जिनकी जान नहीं बची, उनमें से अधिकतर ने 50 इकाइयों से कम भुगतान किया था। सुझाव: मुद्रा की इकाइयाँ स्वयं पता लगाने की कोशिश करें!
अब यात्रियों के Sex का बार प्लॉट फिर से बनाते हैं और इस बार बार्स को Survived के अनुसार भरते हैं:
# Plot barplot of passenger Sex & fill according to Survival
ggplot(passengers1, aes(x = Sex, fill = Survived)) +
  geom_bar()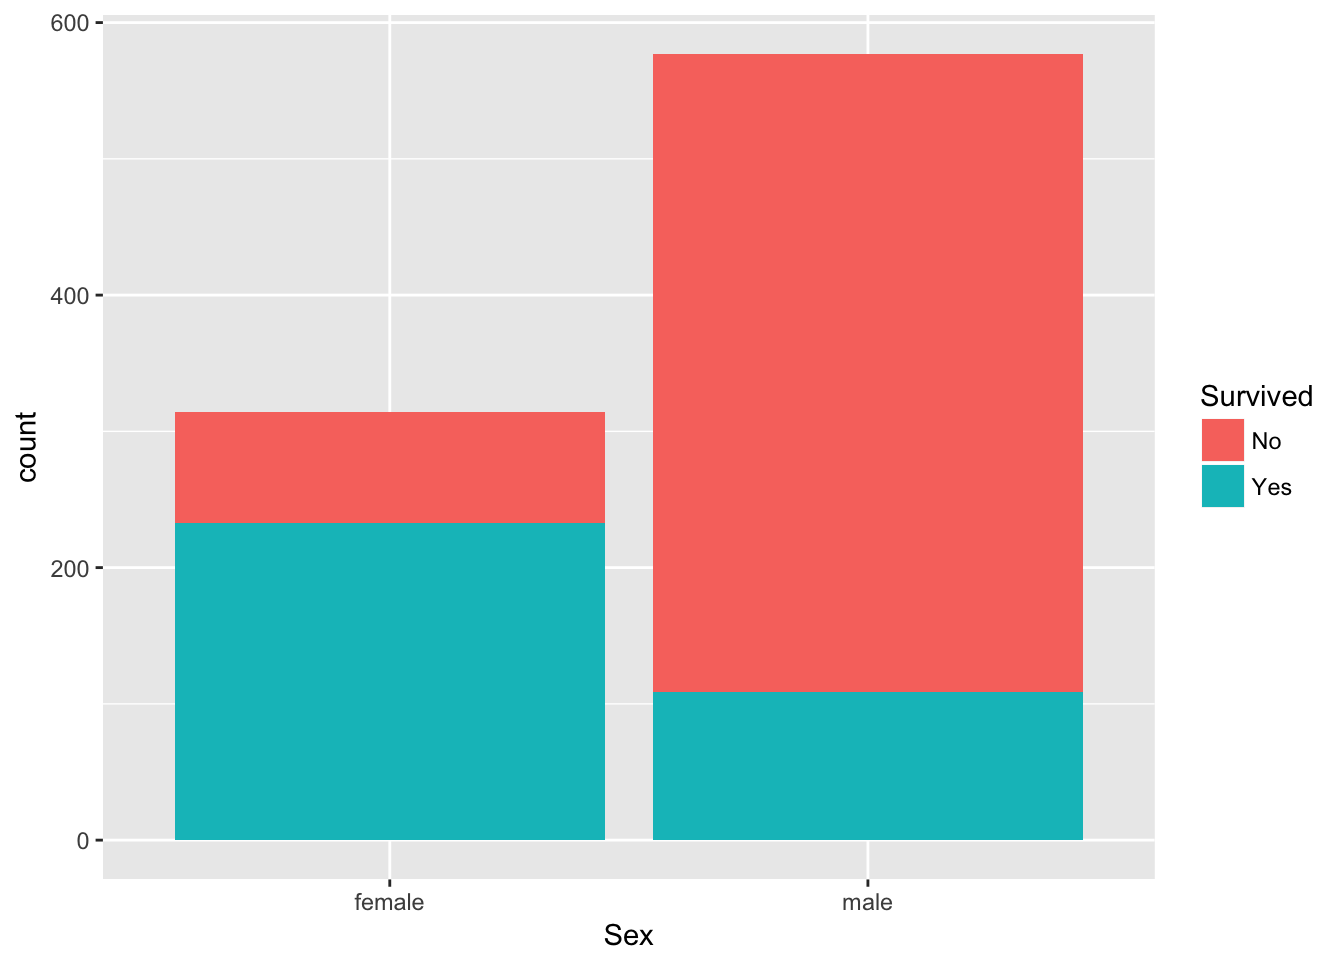
आप देखते हैं कि भारी बहुमत में पुरुष नहीं बचे, जबकि दो-तिहाई से अधिक महिलाएँ बच गईं!
summarise() क्रिया का उपयोग करके चुकाए गए औसत किराये का पता लगाएँ:
# Check out mean Fare
passengers %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 32.20421
summarise() क्रिया का उपयोग करके चुकाए गए माध्यिका किराये का पता लगाएँ:
# Check out mean Fare
passengers %>%
  summarise(medianFare = median(Fare))

##   medianFare
## 1    14.4542
आप filter() और summarise() क्रियाओं का उपयोग करके पुरुषों में चुकाए गए औसत किराये का भी पता लगा सकते हैं:
# Check out mean Fare for men
passengers %>%
  filter(Sex == "male") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 25.52389
filter() और summarise() क्रियाओं का उपयोग करके महिलाओं में चुकाए गए औसत किराये का पता लगाएँ:
# Check out mean Fare for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 44.47982
filter() और summarise() क्रियाओं का उपयोग करके महिलाओं में चुकाए गए औसत किराये और कितनी महिलाएँ बचीं, यह निकालें:
# Check out mean Fare & number of survivors for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

##   meanFare numSurv
## 1 44.47982     233
group_by() और summarise() क्रियाओं का उपयोग करके लिंग के अनुसार औसत किराया और बचे लोगों की संख्या निकालें:
# Check out mean Fare & number of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <int>
## 1 female     44.5     233
## 2 male       25.5     109
group_by() और summarise() क्रियाओं का उपयोग करके लिंग के अनुसार औसत किराया और उत्तरजीवियों का अनुपात निकालें:
# Check out mean Fare & proportion of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived)/n())

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <dbl>
## 1 female     44.5   0.742
## 2 male 25.5 0.189इस ट्यूटोरियल में, आपने टाइडिवर्स और टाइडी टूल्स का उपयोग करते हुए डेटा विश्लेषण की बुनियादी बातों पर शून्य से एक तक की यात्रा की। आपने सीखा कि dplyr और ggplot2 के साथ अपने डेटा को कैसे filter(), arrange() और mutate() करें, प्लॉट और summarise() करें—वह भी ऐसे कोड लिखकर जो डेटा के बारे में आपके सोचने और बोलने के तरीके का प्रतिरूप हो। बधाई। मैं आपको David Robinson के Introduction to Tidyverse कोर्स लेने और इन टूल्स को उन अन्य डेटासेट्स पर आज़माने के लिए प्रोत्साहित करूँगा जो आपको रुचिकर लगते हैं। इन विश्लेषणों को ट्विटर पर @DataCamp और @hugobowne के साथ साझा करें। पढ़ने के लिए धन्यवाद।
R के बारे में और जानें
कोर्स
कोर्स
कोर्स