Corso
Introduzione al Tidyverse
4 ore
397.1K
Questo tutorial è la trascrizione di un evento Facebook Live che abbiamo fatto una settimana fa. L’argomento era "Introduzione al Tidyverse" e questo tutorial ti accompagnerà in tutti i contenuti trattati durante la sessione di code-along!
Puoi guardare la prima parte della sessione qui:
E la seconda parte qui:
Nota che puoi trovare tutto il codice della sessione in questo repository.
Il core del tidyverse include i pacchetti che probabilmente userai nelle analisi quotidiane, come ggplot2 per la visualizzazione dei dati e dplyr per il data wrangling. In questo tutorial ti concentrerai su questi due.
Ricorda che un package è essenzialmente un insieme di strumenti per lavorare con i dati. Se vuoi saperne di più sui pacchetti in R, dai un’occhiata a questo tutorial.
Per saperne di più sul Tidyverse, guarda il corso di David Robinson Introduzione al Tidyverse su DataCamp e le risorse Learn the Tidyverse.
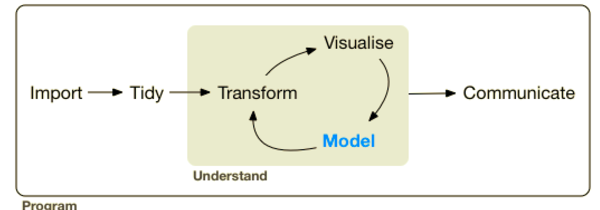
Per cominciare, dovresti installare il tidyverse, se non l’hai già fatto:
# Install the tidyverse
# install.packages("tidyverse")
Ora che hai installato il tidyverse, è il momento di caricare i tuoi dati e dare un’occhiata ad alcune osservazioni.
In questo tutorial, esplorerai il dataset del Titanic, in cui ogni osservazione corrisponde a una persona e ogni variabile è una caratteristica come Name, Age e Survived (o meno).
Carica i tuoi dati così:
 # Import the Tidyverse
library(tidyverse)

# Import data
passengers <- read.csv("data/train.csv")

# Check out the first several observations of your dataframe
passengers

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6     0           330877  8.4583              Q
Nota che il percorso che fornirai a read.csv() può cambiare a seconda della tua configurazione. Se vuoi mantenere lo stesso percorso file, puoi sempre controllare la struttura delle cartelle di questo progetto nel nostro repository GitHub, che trovi qui.
Nota anche che se vuoi sapere di più su tutte le variabili che vedi come risultato dell’esecuzione di passengers, puoi dare un’occhiata alla descrizione del dataset.
Per ottenere una panoramica dei tuoi dati, puoi usare la funzione summary():
# Summarize titanic
summary(passengers)

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
##  (Other)    :186
Ora fai lo stesso usando una pipe %>%, uno degli strumenti più comodi del tidyverse:
# Summarize titanic using a pipe
passengers %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
## (Other) :186Consiglio: se vuoi saperne di più sull’operatore pipe in R, puoi consultare questo tutorial.
Fai lo stesso dopo aver eliminato le osservazioni con valori mancanti. Un indizio: puoi concatenare le pipe!
# Summarize titanic after dropping na
passengers %>%
  drop_na() %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:222.2   1st Qu.:0.0000   1st Qu.:1.000
##  Median :445.0   Median :0.0000   Median :2.000
##  Mean   :448.6   Mean   :0.4062   Mean   :2.237
##  3rd Qu.:677.8   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:261   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :453   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :708
##      SibSp            Parch                 Ticket         Fare
##  Min.   :0.0000   Min.   :0.0000   347082      :  7   Min.   :  0.00
##  1st Qu.:0.0000   1st Qu.:0.0000   3101295     :  6   1st Qu.:  8.05
##  Median :0.0000   Median :0.0000   347088      :  6   Median : 15.74
##  Mean   :0.5126   Mean   :0.4314   CA 2144     :  6   Mean   : 34.69
##  3rd Qu.:1.0000   3rd Qu.:1.0000   382652      :  5   3rd Qu.: 33.38
##  Max.   :5.0000   Max.   :6.0000   S.O.C. 14879:  5   Max.   :512.33
##                                    (Other)     :679
##          Cabin     Embarked
##             :529    :  2
##  B96 B98    :  4   C:130
##  C23 C25 C27:  4   Q: 28
##  G6         :  4   S:554
##  C22 C26    :  3
##  D          :  3
##  (Other)    :167
Potresti aver notato una coerenza stilistica nel codice che hai scritto sopra. Questo perché stai seguendo una style guide. Nella data science e nella programmazione in generale, è importante abituarsi a usare una guida di stile il prima possibile. Come dice Hadley Wickham nella style guide del tidyverse,
Un buon stile di codice è come la punteggiatura corretta: puoi farne a meno, maitsuremakesthingseasiertoread.
Nella prossima sezione, affronterai il data wrangling con dplyr per filtrare i dati, ordinarli e creare nuove feature modificando quelle esistenti.
Ora è il momento di esplorare i dati e ottenere alcune prime informazioni sul dataset. Userai i verbi di dplyr come filter(), arrange() e mutate(), che fanno esattamente ciò che dicono.
Mettiamo che tu voglia scegliere un insieme specifico di osservazioni, ad esempio quelle per cui "Sex" è 'female'. dplyr ce lo consente in modo intuitivo e con un linguaggio che rispecchia come pensi e parli dei dati.
Il verbo filter seleziona solo le osservazioni che soddisfano la condizione. Ecco come funziona:
# Filter to get all "male" rows
passengers %>%
  filter(Sex == "male")

##   PassengerId Survived Pclass                           Name  Sex Age
## 1           1        0      3        Braund, Mr. Owen Harris male  22
## 2           5        0      3       Allen, Mr. William Henry male  35
## 3           6        0      3               Moran, Mr. James male  NA
## 4           7        0      1        McCarthy, Mr. Timothy J male  54
## 5           8        0      3 Palsson, Master. Gosta Leonard male   2
## 6          13        0      3 Saundercock, Mr. William Henry male  20
##   SibSp Parch    Ticket    Fare Cabin Embarked
## 1     1     0 A/5 21171  7.2500              S
## 2     0     0    373450  8.0500              S
## 3     0     0    330877  8.4583              Q
## 4     0     0     17463 51.8625   E46        S
## 5     3     1    349909 21.0750              S
## 6     0     0 A/5. 2151  8.0500              S
Guardando i risultati del codice qui sopra, vedrai che sembra che molti uomini non siano sopravvissuti all’affondamento del RMS Titanic. È interessante, e lo esplorerai in modo più rigoroso più avanti in questo tutorial!
Nota che puoi leggere il codice dplyr come una frase: prendi i tuoi dati e poi (%>%) filtrali secondo la condizione che il sesso sia maschile. Il codice che vedi nel blocco sopra non modifica il data frame originale. filter(Sex = "male") è un errore comune (anche Hugo ha fatto lo stesso errore!); c’è una valida guida agli errori del tidyverse.
# Filter to get all "female" rows
passengers %>%
  filter(Sex == "female")

##   PassengerId Survived Pclass
## 1           2        1      1
## 2           3        1      3
## 3           4        1      1
## 4           9        1      3
## 5          10        1      2
## 6          11        1      3
##                                                  Name    Sex Age SibSp
## 1 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 2                              Heikkinen, Miss. Laina female  26     0
## 3        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 4   Johnson, Mrs. Oscar W (Elisabeth Vilhelmina Berg) female  27     0
## 5                 Nasser, Mrs. Nicholas (Adele Achem) female  14     1
## 6                     Sandstrom, Miss. Marguerite Rut female   4     1
##   Parch           Ticket    Fare Cabin Embarked
## 1     0         PC 17599 71.2833   C85        C
## 2     0 STON/O2. 3101282  7.9250              S
## 3     0           113803 53.1000  C123        S
## 4     2           347742 11.1333              S
## 5     0           237736 30.0708              C
## 6     1          PP 9549 16.7000    G6        S
Sembra che le donne avessero più probabilità di sopravvivere al disastro del Titanic, almeno a livello aneddotico.
Quando esplori i dati, dovresti porti e rispondere alle domande che ti interessano al meglio delle tue possibilità! In questo momento, potresti voler arrange() le osservazioni in ordine crescente di Fare per vedere se noti qualche tendenza. Puoi usare il verbo arrange() per farlo:
# Arrange by increasing Fare
passengers %>%
  arrange(Fare)

##   PassengerId Survived Pclass                            Name  Sex Age
## 1         180        0      3             Leonard, Mr. Lionel male  36
## 2         264        0      1           Harrison, Mr. William male  40
## 3         272        1      3    Tornquist, Mr. William Henry male  25
## 4         278        0      2     Parkes, Mr. Francis "Frank" male  NA
## 5         303        0      3 Johnson, Mr. William Cahoone Jr male  19
## 6         414        0      2  Cunningham, Mr. Alfred Fleming male  NA
##   SibSp Parch Ticket Fare Cabin Embarked
## 1     0     0   LINE    0              S
## 2     0     0 112059    0   B94        S
## 3     0     0   LINE    0              S
## 4     0     0 239853    0              S
## 5     0     0   LINE    0              S
## 6     0     0 239853    0              S
Molte delle persone che pagarono meno non sopravvissero al disastro. È qualcosa di interessante che hai appena scoperto semplicemente riordinando i dati!
Puoi anche arrange in ordine decrescente di Fare:
# Arrange by decreasing Fare
passengers %>%
  arrange(desc(Fare))

##   PassengerId Survived Pclass                               Name    Sex
## 1         259        1      1                   Ward, Miss. Anna female
## 2         680        1      1 Cardeza, Mr. Thomas Drake Martinez   male
## 3         738        1      1             Lesurer, Mr. Gustave J   male
## 4          28        0      1     Fortune, Mr. Charles Alexander   male
## 5          89        1      1         Fortune, Miss. Mabel Helen female
## 6         342        1      1     Fortune, Miss. Alice Elizabeth female
##   Age SibSp Parch   Ticket     Fare       Cabin Embarked
## 1  35     0     0 PC 17755 512.3292                    C
## 2  36     0     1 PC 17755 512.3292 B51 B53 B55        C
## 3  35     0     0 PC 17755 512.3292        B101        C
## 4  19     3     2    19950 263.0000 C23 C25 C27        S
## 5  23     3     2    19950 263.0000 C23 C25 C27        S
## 6  24     3     2    19950 263.0000 C23 C25 C27        S
Effettivamente ci sono più sopravvissuti nella fascia alta!
A volte potresti voler creare nuove variabili. Sai che la variabile Parch è il numero di genitori e figli mentre SibSp è il numero di fratelli e coniugi. Puoi sommarle per ottenere una nuova variabile FamSize. Questo è feature engineering ed è spesso una parte importante del machine learning!
Ora, per creare la nuova variabile, mutate() le variabili originali nella nuova.
# Create new column FamSize (size of family)
passengers %>%
  mutate(FamSize = Parch + SibSp)

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked FamSize
## 1     0        A/5 21171  7.2500              S       1
## 2     0         PC 17599 71.2833   C85        C       1
## 3     0 STON/O2. 3101282  7.9250              S       0
## 4     0           113803 53.1000  C123        S       1
## 5     0           373450  8.0500              S       0
## 6     0           330877  8.4583              Q       0
Nota che mutate() può essere usato per creare nuove colonne ma anche per modificare colonne esistenti, un po’ come una mutazione da un punto di vista biologico. Non è esattamente corretto, ma è un modo carino per dare contesto alla scelta del verbo.
Ora che hai la variabile aggiuntiva, puoi porti altre domande, come "È possibile che le famiglie più numerose abbiano un tasso di sopravvivenza più basso?".
Per testare questa ipotesi, crea una nuova variabile FamSize come somma di Parch e SibSp come sopra, poi ordina in modo decrescente per FamSize:
# Create new column FamSize (size of family)
# Arrange by decreasing FamSize
passengers %>%
  mutate(FamSize = Parch + SibSp) %>%
  arrange(desc(FamSize))

##   PassengerId Survived Pclass                         Name    Sex Age
## 1         160        0      3   Sage, Master. Thomas Henry   male  NA
## 2         181        0      3 Sage, Miss. Constance Gladys female  NA
## 3         202        0      3          Sage, Mr. Frederick   male  NA
## 4         325        0      3     Sage, Mr. George John Jr   male  NA
## 5         793        0      3      Sage, Miss. Stella Anna female  NA
## 6         847        0      3     Sage, Mr. Douglas Bullen   male  NA
##   SibSp Parch   Ticket  Fare Cabin Embarked FamSize
## 1     8     2 CA. 2343 69.55              S      10
## 2     8     2 CA. 2343 69.55              S      10
## 3     8     2 CA. 2343 69.55              S      10
## 4     8     2 CA. 2343 69.55              S      10
## 5     8     2 CA. 2343 69.55              S      10
## 6     8     2 CA. 2343 69.55              S      10
Tutti quelli nella famiglia in cima non sono sopravvissuti! Questo potrebbe dirci qualcosa: forse, se facevi parte di una famiglia numerosa, non sei riuscito a scendere dal Titanic in tempo.
Tuttavia, dato che zeri e uno spesso non dicono molto, modifica i valori della variabile Survived in stringhe No e Yes (e crea un nuovo data frame!):
# Turn numerical values of Survived column to "No" & "Yes" (new data frame)
passengers1 <- passengers %>%
  mutate(Survived = ifelse(Survived == 0, "No", "Yes"))
passengers1

##   PassengerId Survived Pclass
## 1           1       No      3
## 2           2      Yes      1
## 3           3      Yes      3
## 4           4      Yes      1
## 5           5       No      3
## 6           6       No      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6 0 330877 8.4583 QPer tracciare i tuoi dati con ggplot2, specifichi tre cose:
Per iniziare, traccerai un barplot di Sex per vedere quanti uomini e quante donne sono stati registrati a bordo del Titanic:
# Plot barplot of passenger Sex
ggplot(passengers, aes(x = Sex)) +
  geom_bar()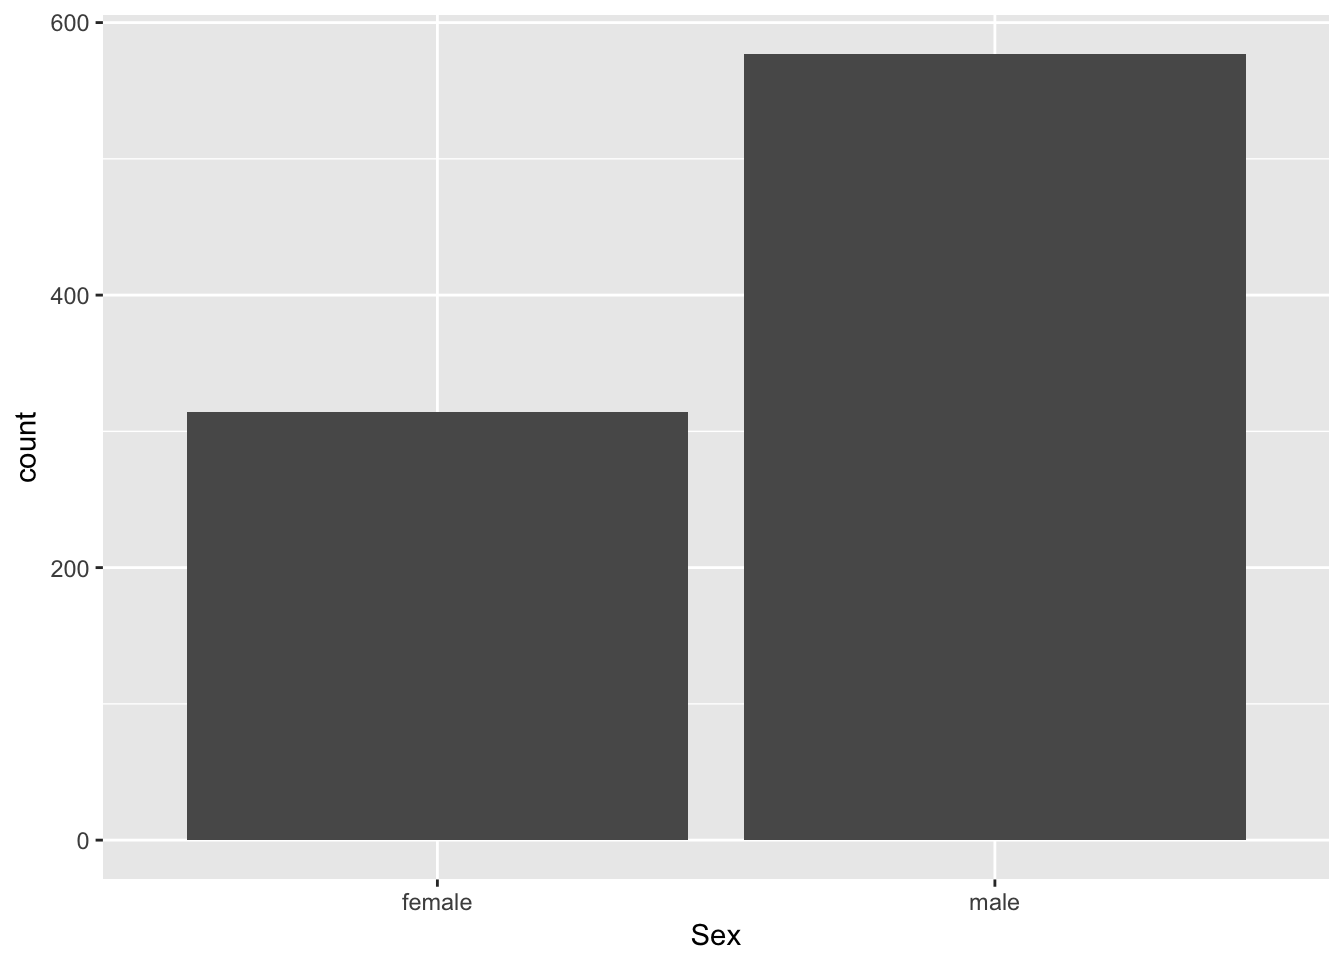
Dal grafico sopra, puoi capire che c’erano circa 600 uomini e 300 donne a bordo del RMS Titanic.
Nota che la funzione aes() è in realtà un modo per mappare le aestetiche del grafico alle variabili nei dati. Vedi Modern Dive di Chester Ismay & Albert Y. Kim per saperne di più.
Ora è il momento di alcuni scatter plot. L’Age di un dato passeggero è correlata alla Fare che ha pagato?
# Scatter plot of Age vs Fare
ggplot(passengers, aes(x = Age, y = Fare)) +
  geom_point()

## Warning: Removed 177 rows containing missing values (geom_point).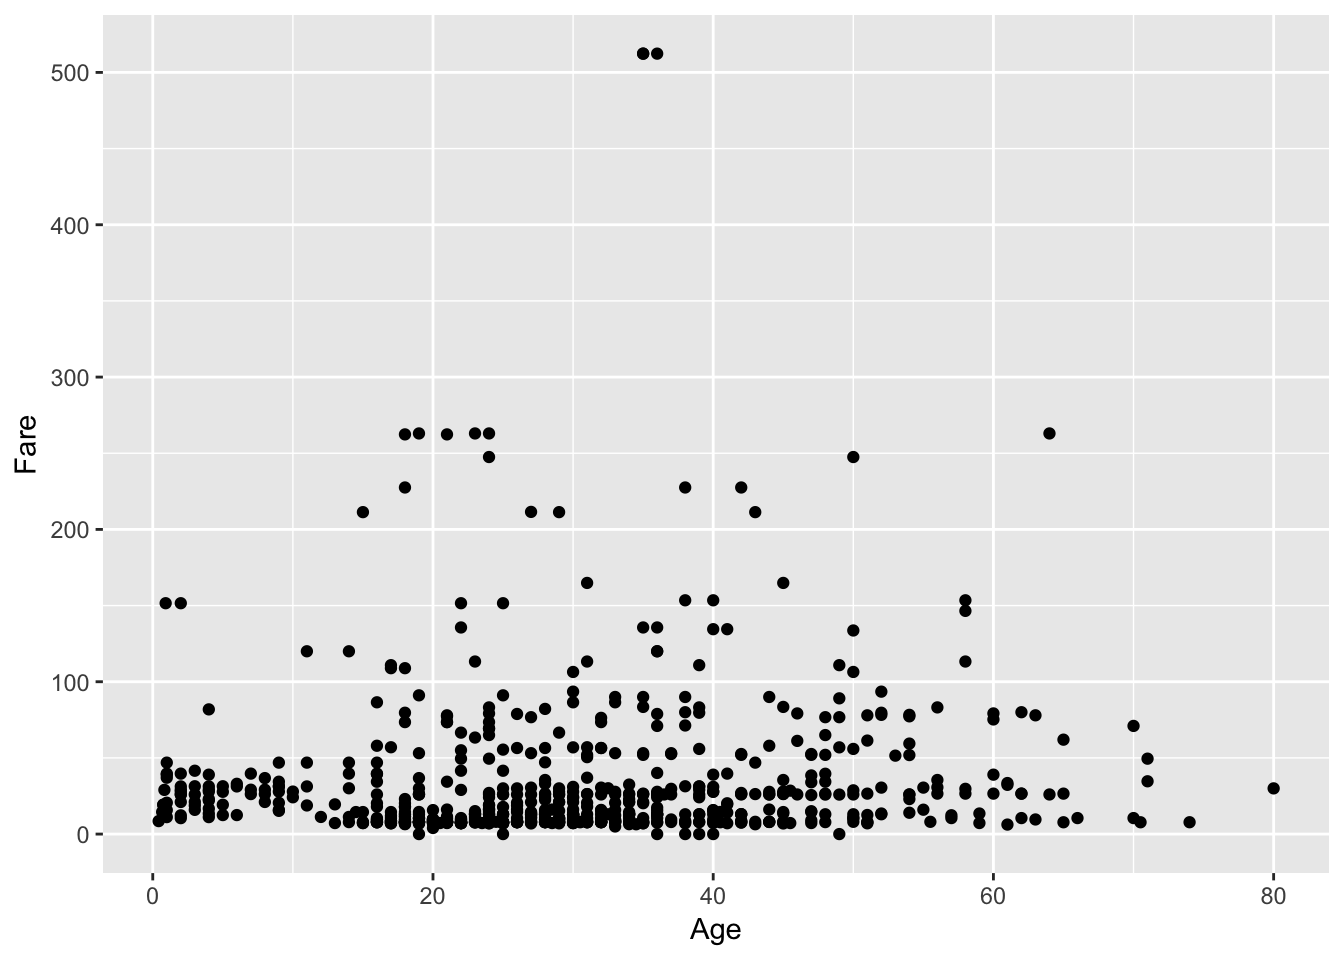
Hai ricavato molte informazioni da questo solo grafico! Vedi che molte delle persone che hanno pagato di più erano anche sensibilmente più anziane. Potrebbe esserci stato un aumento della tariffa in base all’età... Inoltre, vedi subito le due osservazioni anomale nella parte alta del grafico, che potresti voler approfondire!
Puoi leggere il codice di ggplot2 come una frase, proprio come il codice dplyr di sopra: "Prendi i dati come titanic e mappi Age sull’asse x e Fare sull’asse y, aggiungendo i punti come layer del grafico."
Riprendiamo il grafico precedente e coloriamo ogni punto in base a Sex, per vedere eventuali correlazioni tra Sex, Age e Fare:
# Scatter plot of Age vs Fare colored by Sex
ggplot(passengers %>% drop_na(), aes(x = Age, y = Fare, color = Sex)) +
  geom_point()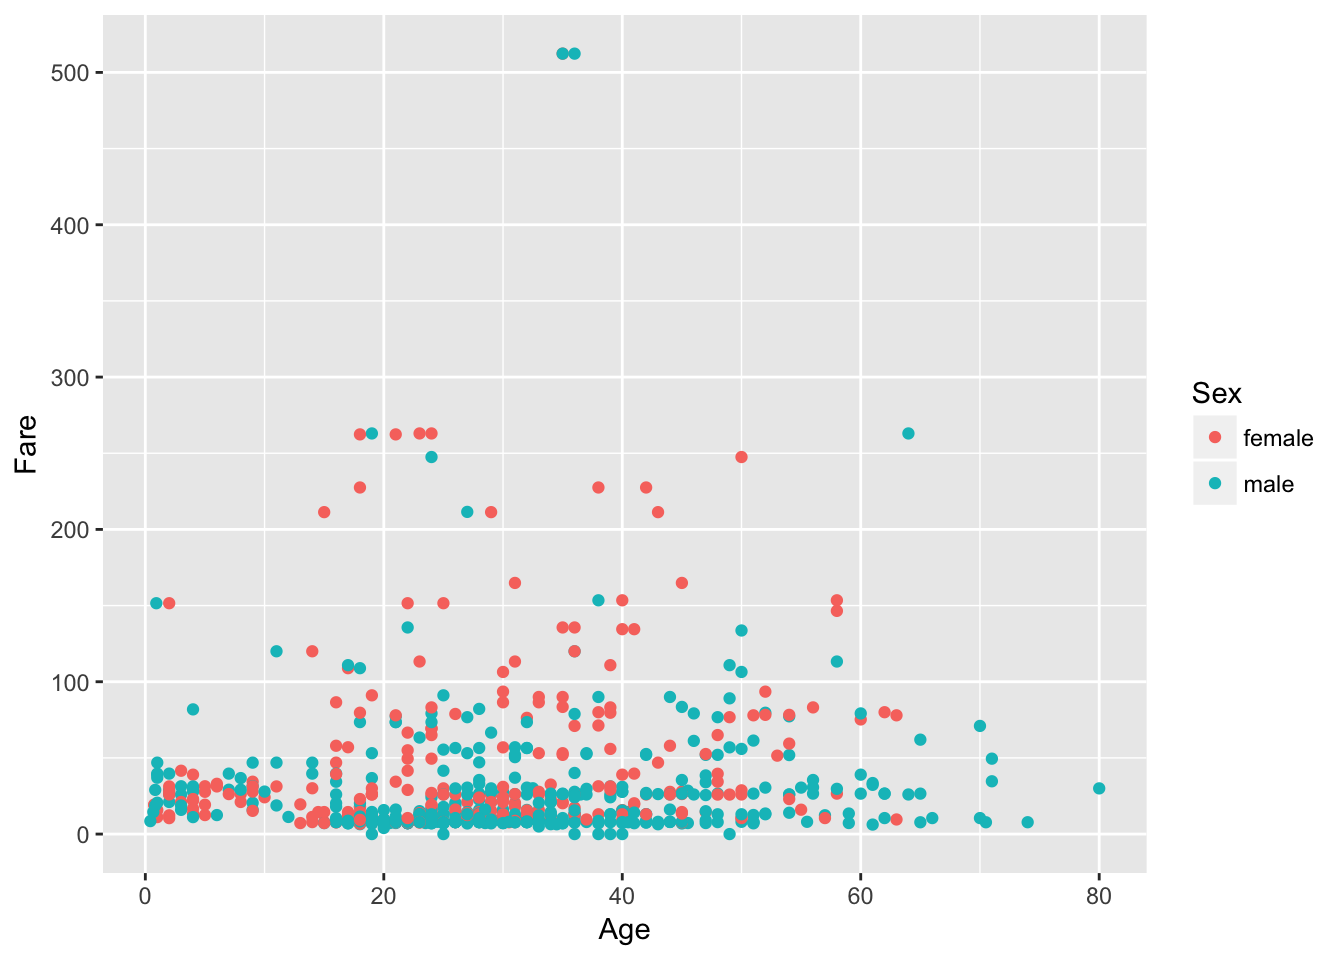
Vedi che molte delle persone in basso, che hanno pagato meno, erano uomini. C’è anche un cluster di donne verso la parte alta del grafico che erano leggermente più anziane e hanno anche pagato di più per salire a bordo del Titanic.
Visualizzare tre variabili (due numeriche, Age e Fare, e una categoriale, Sex) in un unico grafico è piuttosto interessante, ma se volessi aggiungere anche la variabile Survived per vedere se emergono tendenze evidenti? Puoi farlo con il faceting, un modo per produrre più grafici contemporaneamente:
# Scatter plot of Age vs Fare colored by Sex faceted by Survived
ggplot(passengers1, aes(x = Age, y = Fare, color = Sex)) +
  geom_point() +
  facet_grid(~Survived)

## Warning: Removed 177 rows containing missing values (geom_point).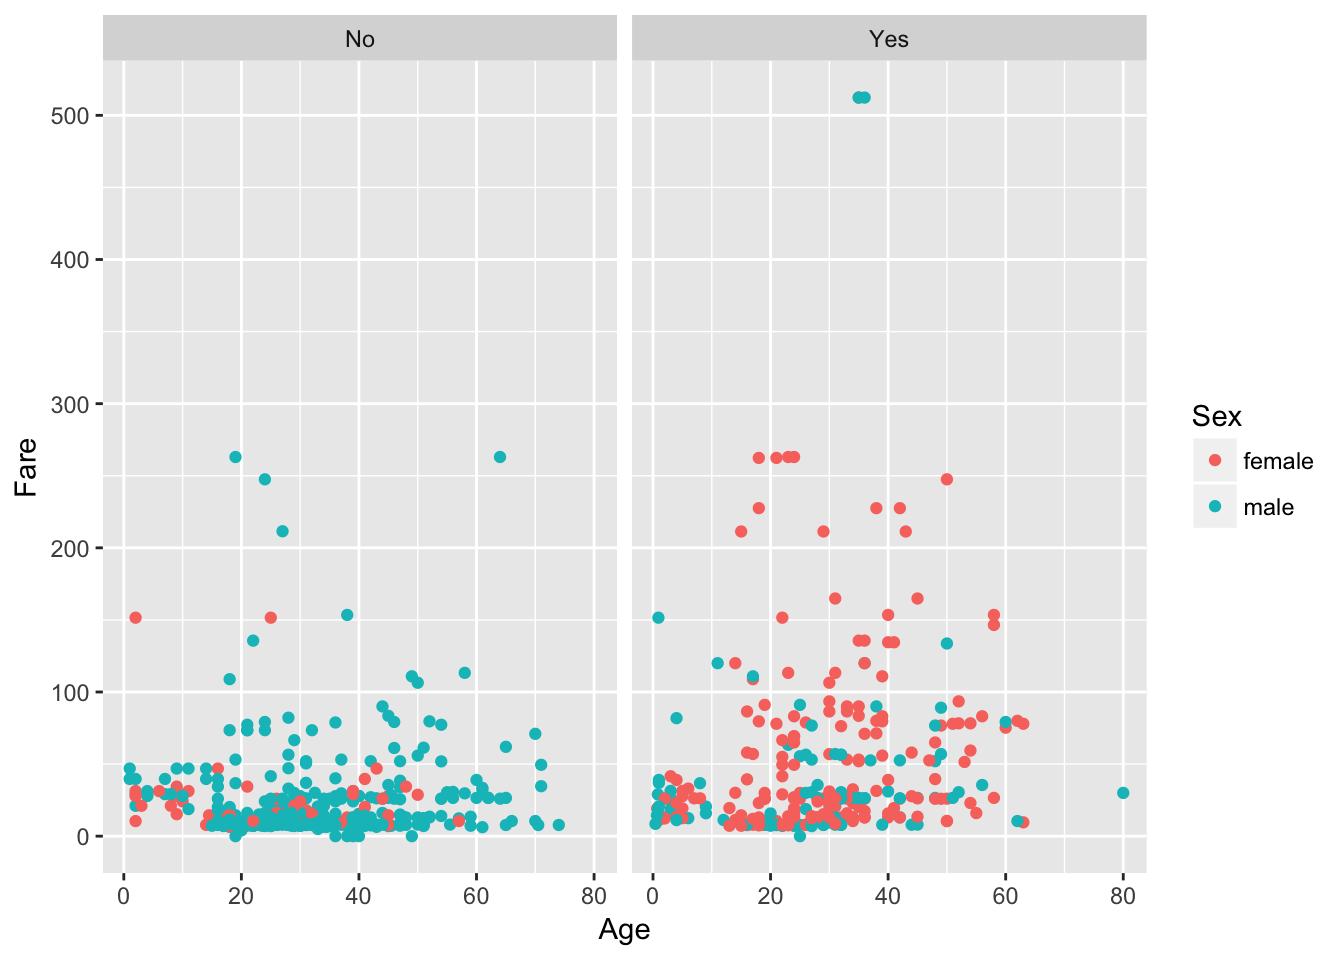
All’improvviso, vedi che molte delle donne che avevi notato lì sopra nel grafico precedente sono sopravvissute, e che la maggior parte di quelle che non sono sopravvissute ha pagato meno di 50 unità. Consiglio: prova a capire da solo l’unità della valuta!
Ora rifacciamo il bar plot del Sex dei passeggeri e questa volta riempi le barre in base a Survived:
# Plot barplot of passenger Sex & fill according to Survival
ggplot(passengers1, aes(x = Sex, fill = Survived)) +
  geom_bar()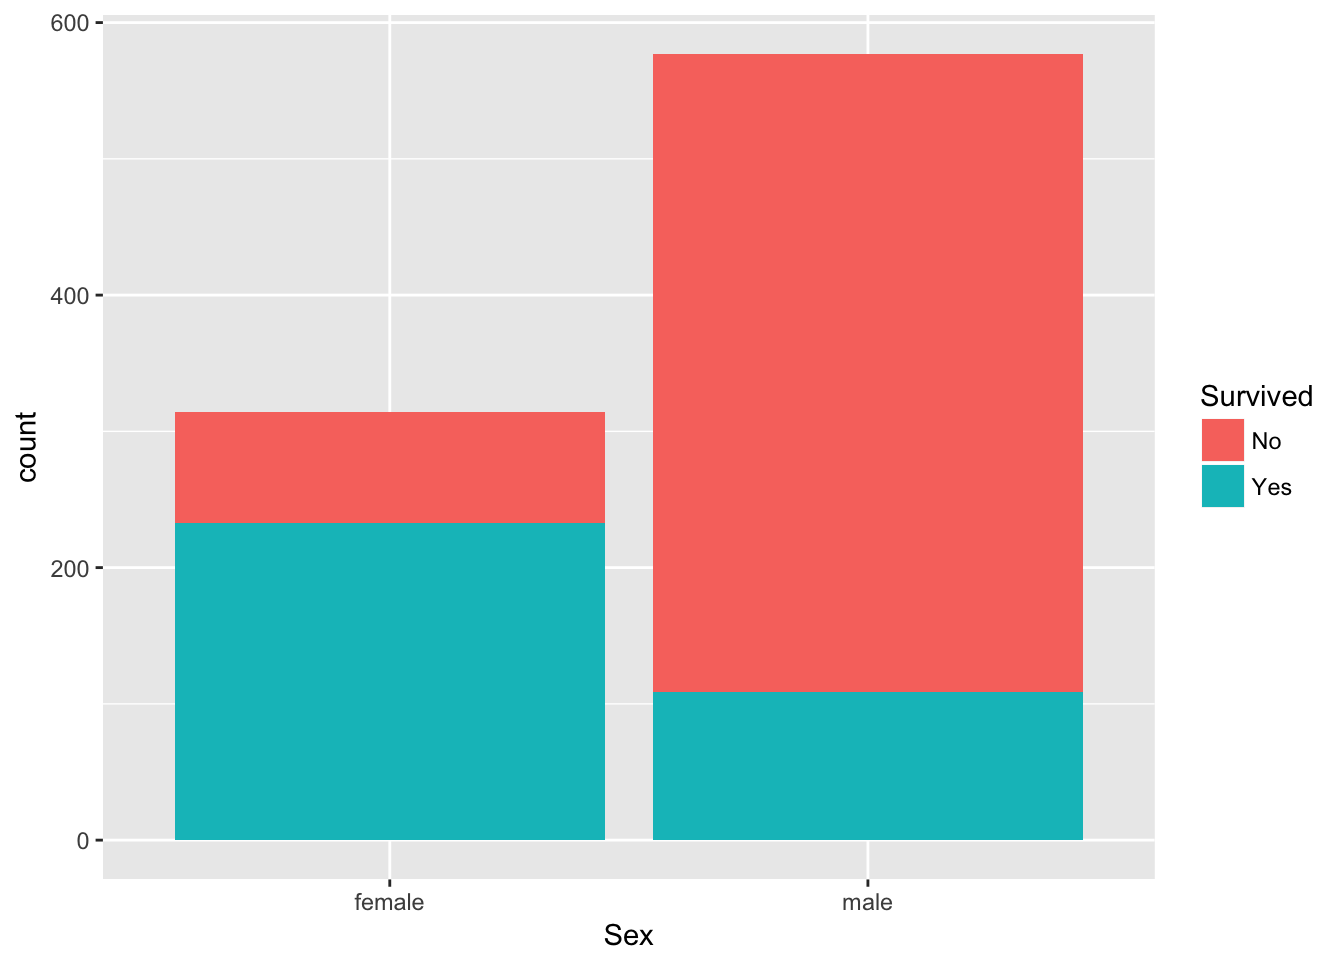
Vedi che la grande maggioranza degli uomini non è sopravvissuta, mentre oltre due terzi delle donne sono sopravvissute!
Usa il verbo summarise() per scoprire la tariffa media pagata:
# Check out mean Fare
passengers %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 32.20421
Usa il verbo summarise() per scoprire la tariffa mediana pagata:
# Check out mean Fare
passengers %>%
  summarise(medianFare = median(Fare))

##   medianFare
## 1    14.4542
Puoi anche usare i verbi filter() e summarise() per scoprire la tariffa media pagata dagli uomini:
# Check out mean Fare for men
passengers %>%
  filter(Sex == "male") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 25.52389
Usa i verbi filter() e summarise() per scoprire la tariffa media pagata dalle donne:
# Check out mean Fare for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 44.47982
Usa i verbi filter() e summarise() per scoprire la tariffa media pagata dalle donne e quante donne sono sopravvissute:
# Check out mean Fare & number of survivors for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

##   meanFare numSurv
## 1 44.47982     233
Usa i verbi group_by() e summarise() per trovare la tariffa media e il numero di sopravvissuti in funzione del sesso:
# Check out mean Fare & number of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <int>
## 1 female     44.5     233
## 2 male       25.5     109
Usa i verbi group_by() e summarise() per trovare la tariffa media e la proporzione di sopravvissuti in funzione del sesso:
# Check out mean Fare & proportion of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived)/n())

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <dbl>
## 1 female     44.5   0.742
## 2 male 25.5 0.189In questo tutorial, sei passato da zero a uno con le basi dell’analisi dei dati usando il tidyverse e gli strumenti tidy. Hai imparato a filter() i dati, a arrange() e mutate(), a tracciarli e a summarise() utilizzando dplyr e ggplot2, scrivendo codice che rispecchia il modo in cui pensi e parli dei dati. Complimenti. Ti incoraggio a imparare di più seguendo il corso di David Robinson Introduzione al Tidyverse e usando questi strumenti su altri dataset che ti interessano. Condividi queste analisi con noi su Twitter @DataCamp e @hugobowne. Grazie per la lettura.
Scopri di più su R
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



