Kurs
Einführung in das Tidyverse
4 Std.
394.9K
Dieses Tutorial ist die verschriftlichte Version eines Facebook-Live-Events von letzter Woche. Das Thema war „Introduction to the Tidyverse“, und hier führen wir dich durch den gesamten Inhalt der gemeinsamen Code-Session!
Den ersten Teil der Session kannst du dir hier ansehen:
Und den zweiten Teil hier:
Hinweis: Den gesamten Code zur Session findest du in diesem Repository.
Der Kern des tidyverse umfasst Pakete, die du in der täglichen Datenanalyse wahrscheinlich nutzt, etwa ggplot2 für Datenvisualisierung und dplyr für Datenaufbereitung. In diesem Tutorial konzentrierst du dich auf diese beiden.
Merke: Ein Package ist im Grunde ein Werkzeugkasten, um mit Daten zu arbeiten. Wenn du mehr über Packages in R wissen willst, sieh dir dieses Tutorial an.
Mehr zum Tidyverse findest du in David Robinsons Introduction to Tidyverse Kurs auf DataCamp und den Learn the Tidyverse Ressourcen.
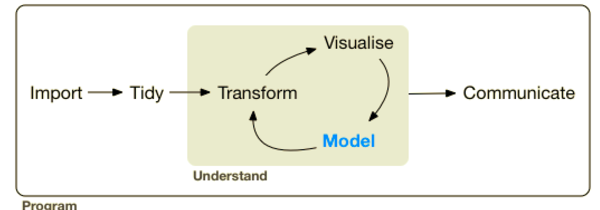
Installiere zunächst das tidyverse, falls noch nicht geschehen:
# Install the tidyverse
# install.packages("tidyverse")
Jetzt, da du das tidyverse installiert hast, ist es Zeit, deine Daten zu laden und dir erste Beobachtungen anzusehen.
In diesem Tutorial erkundest du den Titanic-Datensatz. Jede Zeile entspricht einer Person, jede Variable einem Merkmal wie Name, Age und Survived (überlebt oder nicht).
Lade deine Daten so:
 # Import the Tidyverse
library(tidyverse)

# Import data
passengers <- read.csv("data/train.csv")

# Check out the first several observations of your dataframe
passengers

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6 0 330877 8.4583 QHinweis: Der Pfad, den du an read.csv() übergibst, kann je nach Setup variieren. Wenn du denselben Dateipfad beibehalten willst, schau dir die Ordnerstruktur dieses Projekts im GitHub-Repository an, das du hier findest.
Wenn du mehr über die Variablen wissen willst, die du beim Ausführen von passengers siehst, wirf einen Blick in die Datensatzbeschreibung.
Für einen schnellen Überblick über deine Daten kannst du die Funktion summary() verwenden:
# Summarize titanic
summary(passengers)

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
##  (Other)    :186
Mach dasselbe mit einem Pipe %>%, einem der praktischsten Werkzeuge im tidyverse:
# Summarize titanic using a pipe
passengers %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
## (Other) :186Tipp: Wenn du mehr über den Pipe-Operator in R wissen willst, sieh dir dieses Tutorial an.
Mach dasselbe, nachdem du Beobachtungen mit fehlenden Werten entfernt hast. Kleiner Hinweis: Du kannst Pipes verketten!
# Summarize titanic after dropping na
passengers %>%
  drop_na() %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:222.2   1st Qu.:0.0000   1st Qu.:1.000
##  Median :445.0   Median :0.0000   Median :2.000
##  Mean   :448.6   Mean   :0.4062   Mean   :2.237
##  3rd Qu.:677.8   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:261   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :453   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :708
##      SibSp            Parch                 Ticket         Fare
##  Min.   :0.0000   Min.   :0.0000   347082      :  7   Min.   :  0.00
##  1st Qu.:0.0000   1st Qu.:0.0000   3101295     :  6   1st Qu.:  8.05
##  Median :0.0000   Median :0.0000   347088      :  6   Median : 15.74
##  Mean   :0.5126   Mean   :0.4314   CA 2144     :  6   Mean   : 34.69
##  3rd Qu.:1.0000   3rd Qu.:1.0000   382652      :  5   3rd Qu.: 33.38
##  Max.   :5.0000   Max.   :6.0000   S.O.C. 14879:  5   Max.   :512.33
##                                    (Other)     :679
##          Cabin     Embarked
##             :529    :  2
##  B96 B98    :  4   C:130
##  C23 C25 C27:  4   Q: 28
##  G6         :  4   S:554
##  C22 C26    :  3
##  D          :  3
##  (Other)    :167
Vielleicht ist dir die konsequente Schreibweise im obigen Code aufgefallen. Das liegt daran, dass du einem Styleguide folgst. In der Datenwissenschaft und in der Programmierung allgemein ist es wichtig, sich früh an einen Styleguide zu gewöhnen. Wie Hadley Wickham im tidyverse style guide schreibt,
Guter Code-Stil ist wie richtige Zeichensetzung: Man kommt auch ohne aus, aberesmachtdasLesenerheblichleichter.
Im nächsten Abschnitt kümmerst du dich mit dplyr um Data Wrangling: Du filterst deine Daten, sortierst sie und erstellst neue Features, indem du bestehende veränderst.
Jetzt ist es Zeit, deine Daten zu erkunden und erste Einblicke zu gewinnen. Du verwendest dplyr-Verben wie filter(), arrange() und mutate() – sie tun genau das, was ihre Namen versprechen.
Angenommen, du möchtest eine bestimmte Teilmenge wählen, zum Beispiel alle Beobachtungen, bei denen „Sex“ auf 'female' steht. dplyr ermöglicht das intuitiv und in einer Sprache, die dem Denken und Sprechen über Daten entspricht.
Das Verb filter wählt nur die Zeilen aus, die die Bedingung erfüllen. So sieht das aus:
# Filter to get all "male" rows
passengers %>%
  filter(Sex == "male")

##   PassengerId Survived Pclass                           Name  Sex Age
## 1           1        0      3        Braund, Mr. Owen Harris male  22
## 2           5        0      3       Allen, Mr. William Henry male  35
## 3           6        0      3               Moran, Mr. James male  NA
## 4           7        0      1        McCarthy, Mr. Timothy J male  54
## 5           8        0      3 Palsson, Master. Gosta Leonard male   2
## 6          13        0      3 Saundercock, Mr. William Henry male  20
##   SibSp Parch    Ticket    Fare Cabin Embarked
## 1     1     0 A/5 21171  7.2500              S
## 2     0     0    373450  8.0500              S
## 3     0     0    330877  8.4583              Q
## 4     0     0     17463 51.8625   E46        S
## 5     3     1    349909 21.0750              S
## 6     0     0 A/5. 2151  8.0500              S
Beim Blick auf die Ergebnisse wird deutlich: Viele Männer haben das Sinken der RMS Titanic nicht überlebt. Spannend – das schauen wir uns später im Tutorial noch genauer an!
Hinweis: Du kannst dplyr-Code wie einen Satz lesen: Nimm die Daten und (%>%) filtere sie nach der Bedingung, dass das Geschlecht männlich ist. Der oben gezeigte Code verändert den ursprünglichen Data Frame nicht. filter(Sex = "male") ist ein häufiger Fehler (Hugo ist er auch passiert!); es gibt einen hilfreichen tidyverse Error Guide.
# Filter to get all "female" rows
passengers %>%
  filter(Sex == "female")

##   PassengerId Survived Pclass
## 1           2        1      1
## 2           3        1      3
## 3           4        1      1
## 4           9        1      3
## 5          10        1      2
## 6          11        1      3
##                                                  Name    Sex Age SibSp
## 1 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 2                              Heikkinen, Miss. Laina female  26     0
## 3        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 4   Johnson, Mrs. Oscar W (Elisabeth Vilhelmina Berg) female  27     0
## 5                 Nasser, Mrs. Nicholas (Adele Achem) female  14     1
## 6                     Sandstrom, Miss. Marguerite Rut female   4     1
##   Parch           Ticket    Fare Cabin Embarked
## 1     0         PC 17599 71.2833   C85        C
## 2     0 STON/O2. 3101282  7.9250              S
## 3     0           113803 53.1000  C123        S
## 4     2           347742 11.1333              S
## 5     0           237736 30.0708              C
## 6     1          PP 9549 16.7000    G6        S
Frauen scheinen eine deutlich höhere Überlebenswahrscheinlichkeit gehabt zu haben – zumindest auf den ersten Blick.
Bei der Erkundung von Daten solltest du Fragen stellen und nach bestem Wissen beantworten. Vielleicht möchtest du die Beobachtungen nach aufsteigendem Fare sortieren, um Muster zu erkennen. Das geht mit arrange():
# Arrange by increasing Fare
passengers %>%
  arrange(Fare)

##   PassengerId Survived Pclass                            Name  Sex Age
## 1         180        0      3             Leonard, Mr. Lionel male  36
## 2         264        0      1           Harrison, Mr. William male  40
## 3         272        1      3    Tornquist, Mr. William Henry male  25
## 4         278        0      2     Parkes, Mr. Francis "Frank" male  NA
## 5         303        0      3 Johnson, Mr. William Cahoone Jr male  19
## 6         414        0      2  Cunningham, Mr. Alfred Fleming male  NA
##   SibSp Parch Ticket Fare Cabin Embarked
## 1     0     0   LINE    0              S
## 2     0     0 112059    0   B94        S
## 3     0     0   LINE    0              S
## 4     0     0 239853    0              S
## 5     0     0   LINE    0              S
## 6     0     0 239853    0              S
Viele der Menschen mit sehr niedrigen Ticketpreisen haben nicht überlebt. Ein interessanter Befund, den du allein durch Sortieren entdeckt hast!
Du kannst auch nach absteigendem Fare sortieren:
# Arrange by decreasing Fare
passengers %>%
  arrange(desc(Fare))

##   PassengerId Survived Pclass                               Name    Sex
## 1         259        1      1                   Ward, Miss. Anna female
## 2         680        1      1 Cardeza, Mr. Thomas Drake Martinez   male
## 3         738        1      1             Lesurer, Mr. Gustave J   male
## 4          28        0      1     Fortune, Mr. Charles Alexander   male
## 5          89        1      1         Fortune, Miss. Mabel Helen female
## 6         342        1      1     Fortune, Miss. Alice Elizabeth female
##   Age SibSp Parch   Ticket     Fare       Cabin Embarked
## 1  35     0     0 PC 17755 512.3292                    C
## 2  36     0     1 PC 17755 512.3292 B51 B53 B55        C
## 3  35     0     0 PC 17755 512.3292        B101        C
## 4  19     3     2    19950 263.0000 C23 C25 C27        S
## 5  23     3     2    19950 263.0000 C23 C25 C27        S
## 6  24     3     2    19950 263.0000 C23 C25 C27        S
Am oberen Ende gibt es tatsächlich mehr Überlebende!
Manchmal willst du neue Variablen erstellen. Du weißt, dass Parch die Anzahl der Eltern und Kinder ist, während SibSp die Anzahl der Geschwister und Ehepartner angibt. Beides zusammen ergibt eine neue Variable FamSize. Das ist Feature Engineering und ein wichtiger Teil von Machine Learning!
Um die neue Variable zu erzeugen, mutate()st du die ursprünglichen Spalten in eine neue.
# Create new column FamSize (size of family)
passengers %>%
  mutate(FamSize = Parch + SibSp)

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked FamSize
## 1     0        A/5 21171  7.2500              S       1
## 2     0         PC 17599 71.2833   C85        C       1
## 3     0 STON/O2. 3101282  7.9250              S       0
## 4     0           113803 53.1000  C123        S       1
## 5     0           373450  8.0500              S       0
## 6 0 330877 8.4583 Q 0Hinweis: mutate() kann neue Spalten erzeugen, aber auch bestehende verändern – ähnlich wie eine Mutation in der Biologie. Nicht ganz wörtlich zu nehmen, aber hilfreich zur Einordnung des Verbs.
Mit der neuen Variable kannst du weitere Fragen stellen, etwa: „Ist es möglich, dass größere Familien eine geringere Überlebensrate hatten?“.
Um diese Hypothese zu prüfen, erstelle wie oben FamSize als Summe aus Parch und SibSp und sortiere dann nach absteigendem FamSize:
# Create new column FamSize (size of family)
# Arrange by decreasing FamSize
passengers %>%
  mutate(FamSize = Parch + SibSp) %>%
  arrange(desc(FamSize))

##   PassengerId Survived Pclass                         Name    Sex Age
## 1         160        0      3   Sage, Master. Thomas Henry   male  NA
## 2         181        0      3 Sage, Miss. Constance Gladys female  NA
## 3         202        0      3          Sage, Mr. Frederick   male  NA
## 4         325        0      3     Sage, Mr. George John Jr   male  NA
## 5         793        0      3      Sage, Miss. Stella Anna female  NA
## 6         847        0      3     Sage, Mr. Douglas Bullen   male  NA
##   SibSp Parch   Ticket  Fare Cabin Embarked FamSize
## 1     8     2 CA. 2343 69.55              S      10
## 2     8     2 CA. 2343 69.55              S      10
## 3     8     2 CA. 2343 69.55              S      10
## 4     8     2 CA. 2343 69.55              S      10
## 5     8     2 CA. 2343 69.55              S      10
## 6     8     2 CA. 2343 69.55              S      10
Alle in der größten Familie haben nicht überlebt! Das ist aufschlussreich: Vielleicht konnten Mitglieder großer Familien die Titanic nicht rechtzeitig verlassen.
Da Nullen und Einsen nicht besonders aussagekräftig sind, wandel die Werte in Survived in die Strings No und Yes um (und erzeuge einen neuen Data Frame):
# Turn numerical values of Survived column to "No" & "Yes" (new data frame)
passengers1 <- passengers %>%
  mutate(Survived = ifelse(Survived == 0, "No", "Yes"))
passengers1

##   PassengerId Survived Pclass
## 1           1       No      3
## 2           2      Yes      1
## 3           3      Yes      3
## 4           4      Yes      1
## 5           5       No      3
## 6           6       No      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6 0 330877 8.4583 QUm deine Daten mit ggplot2 zu plotten, gibst du drei Dinge an:
Zuerst erstellst du ein Balkendiagramm von Sex, um zu sehen, wie viele Männer und Frauen an Bord der Titanic waren:
# Plot barplot of passenger Sex
ggplot(passengers, aes(x = Sex)) +
  geom_bar()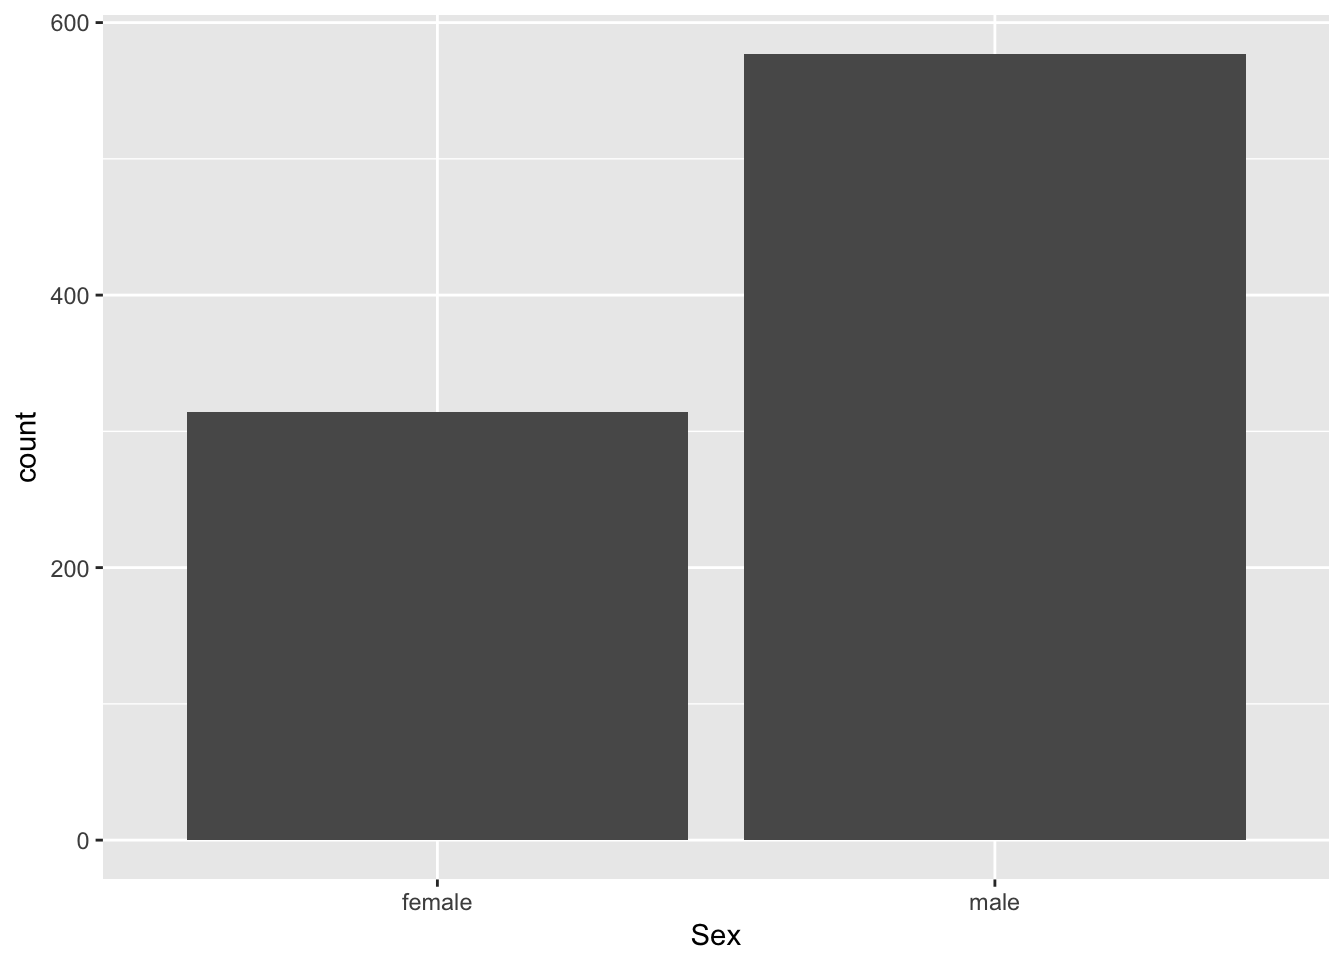
Am Diagramm erkennst du, dass etwa 600 Männer und 300 Frauen an Bord der RMS Titanic waren.
Hinweis: Die Funktion aes() dient dazu, die aesthetischen Eigenschaften des Plots auf Variablen in den Daten abzubilden. Mehr dazu in Modern Dive von Chester Ismay & Albert Y. Kim.
Weiter geht’s mit Streudiagrammen. Ist das Age eines Passagiers mit dem gezahlten Fare korreliert?
# Scatter plot of Age vs Fare
ggplot(passengers, aes(x = Age, y = Fare)) +
  geom_point()

## Warning: Removed 177 rows containing missing values (geom_point).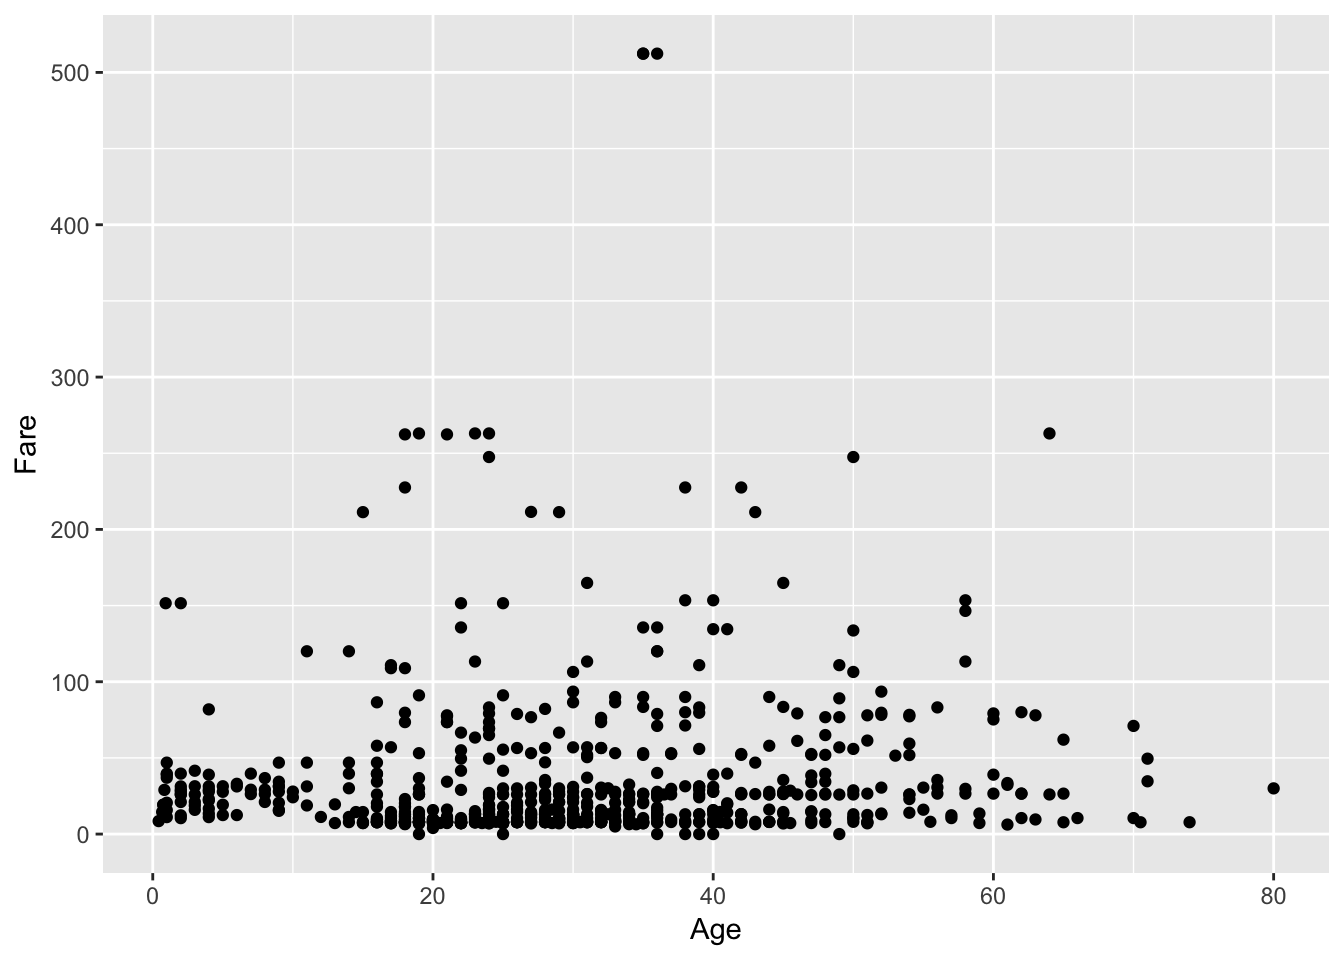
Schon dieser Plot liefert viele Einsichten: Viele der Personen mit höherem Fahrpreis waren deutlich älter. Möglicherweise stieg der Preis mit dem Alter. Außerdem fallen sofort zwei Ausreißer oben im Plot auf – die könntest du weiter untersuchen!
Du kannst deinen ggplot2-Code wie einen Satz lesen – genau wie oben bei dplyr: „Nimm die Daten titanic, mappe Age auf die x-Achse und Fare auf die y-Achse und füge Punkte als Layer hinzu.“
Nimm den vorherigen Plot und färbe die Punkte nach Sex, um Zusammenhänge zwischen Sex, Age und Fare zu erkennen:
# Scatter plot of Age vs Fare colored by Sex
ggplot(passengers %>% drop_na(), aes(x = Age, y = Fare, color = Sex)) +
  geom_point()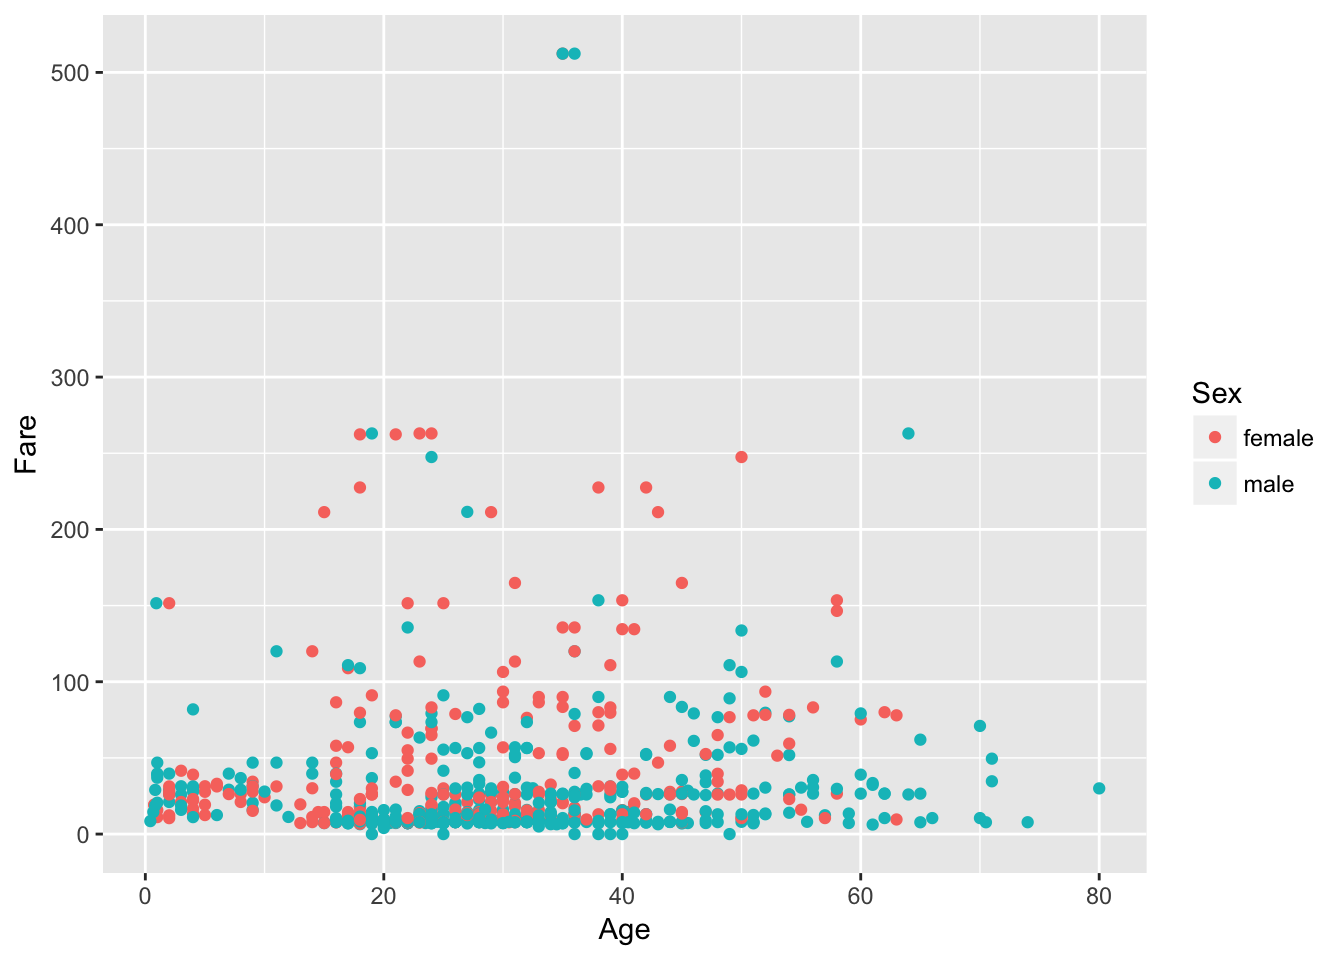
Unten, bei den niedrigen Preisen, siehst du viele Männer. Oben bildet sich ein Cluster von Frauen, die etwas älter waren und auch mehr für die Passage bezahlt haben.
Drei Variablen in einem Plot zu zeigen (zwei numerische, Age und Fare, und eine kategoriale, Sex) ist schon stark. Aber was, wenn du zusätzlich Survived betrachten willst? Das geht mit Faceting, also dem gleichzeitigen Erzeugen mehrerer Plots:
# Scatter plot of Age vs Fare colored by Sex faceted by Survived
ggplot(passengers1, aes(x = Age, y = Fare, color = Sex)) +
  geom_point() +
  facet_grid(~Survived)

## Warning: Removed 177 rows containing missing values (geom_point).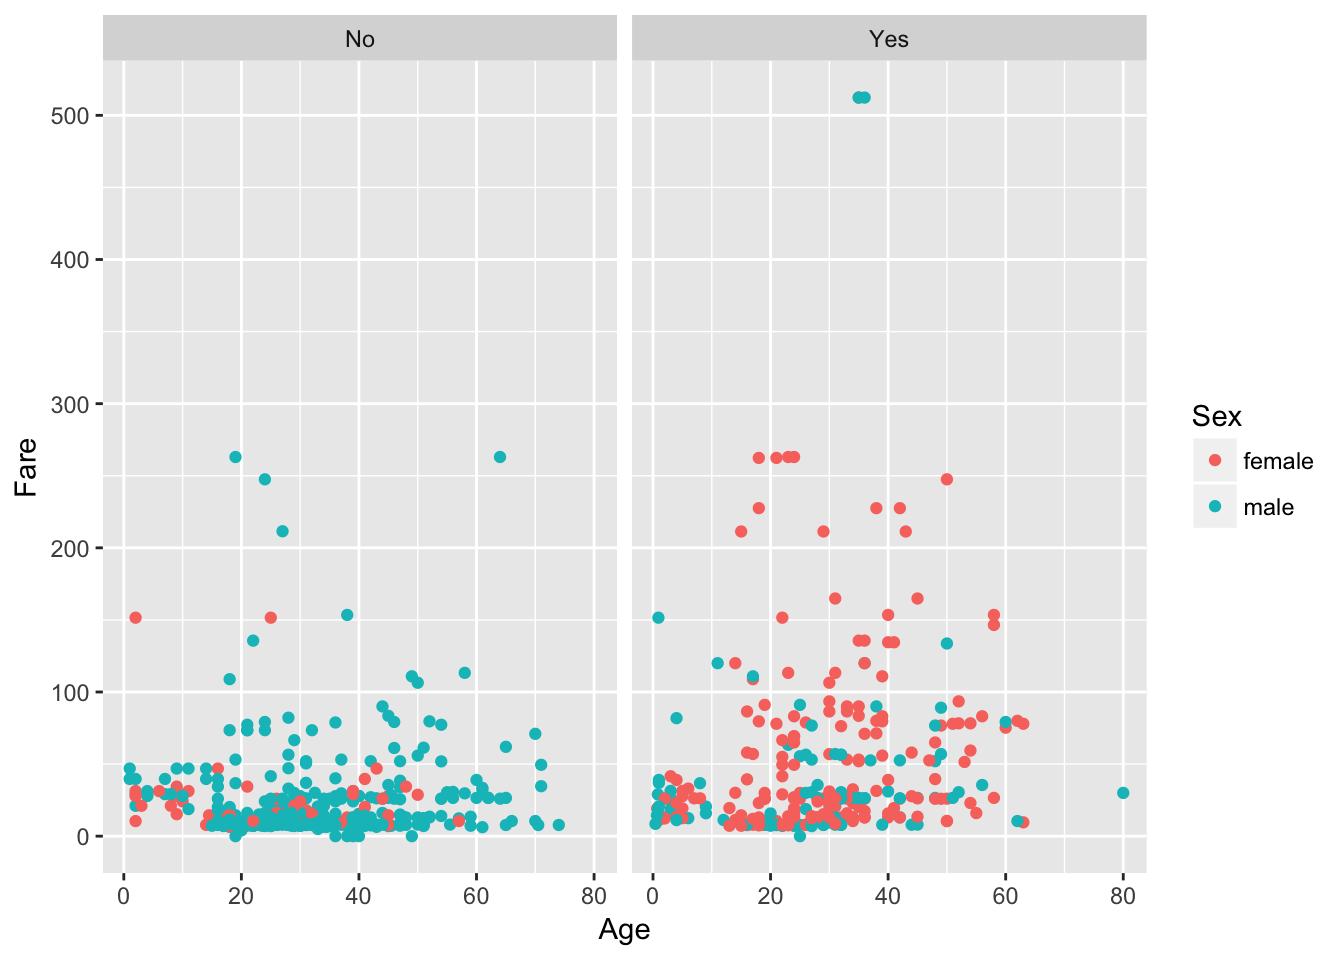
Jetzt wird sichtbar: Viele der Frauen aus dem oberen Bereich des vorherigen Plots haben überlebt, und die meisten, die nicht überlebt haben, zahlten unter 50 Einheiten. Tipp: Finde selbst heraus, um welche Währung es sich handelt!
Erstelle nun erneut das Balkendiagramm von Sex und fülle die Balken diesmal nach Survived:
# Plot barplot of passenger Sex & fill according to Survival
ggplot(passengers1, aes(x = Sex, fill = Survived)) +
  geom_bar()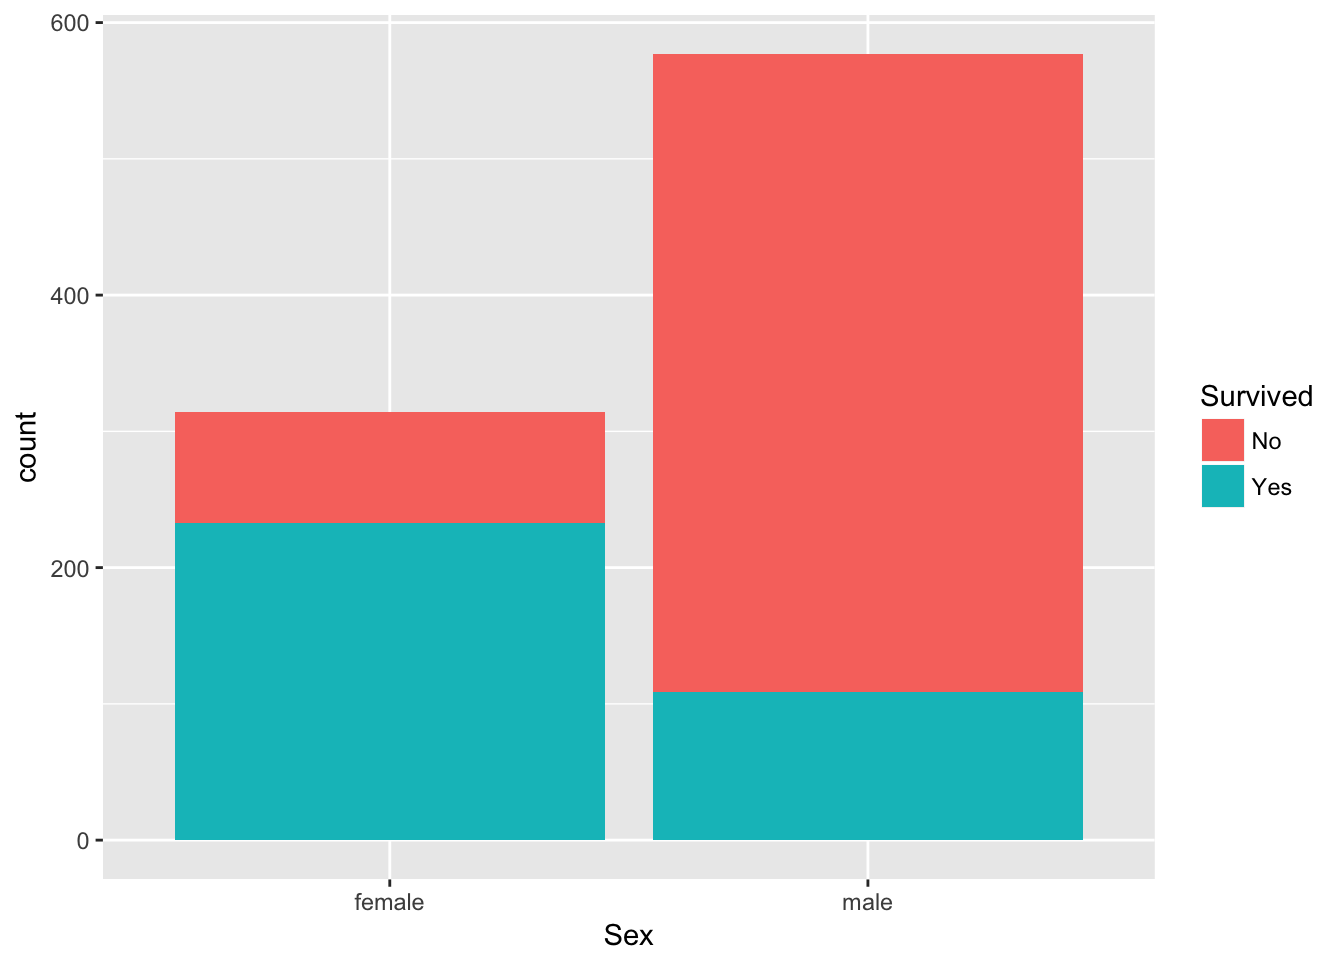
Du siehst: Der Großteil der Männer hat nicht überlebt, während über zwei Drittel der Frauen überlebt haben.
Nutze das Verb summarise(), um den durchschnittlichen Fahrpreis zu berechnen:
# Check out mean Fare
passengers %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 32.20421
Nutze summarise(), um den Median des Fahrpreises zu berechnen:
# Check out mean Fare
passengers %>%
  summarise(medianFare = median(Fare))

##   medianFare
## 1    14.4542
Mit filter() und summarise() findest du den durchschnittlichen Fahrpreis unter Männern:
# Check out mean Fare for men
passengers %>%
  filter(Sex == "male") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 25.52389
Und so den durchschnittlichen Fahrpreis unter Frauen:
# Check out mean Fare for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 44.47982
Finde den durchschnittlichen Fahrpreis unter Frauen und wie viele Frauen überlebt haben:
# Check out mean Fare & number of survivors for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

##   meanFare numSurv
## 1 44.47982     233
Berechne mit group_by() und summarise() den durchschnittlichen Fahrpreis und die Anzahl der Überlebenden nach Geschlecht:
# Check out mean Fare & number of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <int>
## 1 female     44.5     233
## 2 male       25.5     109
Oder den durchschnittlichen Fahrpreis und den Anteil der Überlebenden nach Geschlecht:
# Check out mean Fare & proportion of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived)/n())

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <dbl>
## 1 female     44.5   0.742
## 2 male 25.5 0.189In diesem Tutorial bist du mit den Grundlagen der Datenanalyse im tidyverse gestartet. Du hast gelernt, Daten zu filter()n, zu arrange()n und zu mutate()n, sie zu plotten und mit summarise() zusammenzufassen – und das mit dplyr und ggplot2 in einer Syntax, die dem Denken über Daten entspricht. Glückwunsch! Wenn du tiefer einsteigen willst, empfehle ich dir David Robinsons Introduction to Tidyverse Kurs und diese Tools auf weitere Datensätze anzuwenden, die dich interessieren. Teile deine Analysen mit uns auf Twitter unter @DataCamp und @hugobowne. Danke fürs Lesen.
Mehr über R lernen
Kurs
Kurs
Kurs