
{count, plural, one {Corso} other {Corsi}}
Fondamenti di probabilità in R
{hours} ore
43K
Immagina di sviluppare un sistema di rilevamento dello spam per le email. All'inizio potresti contrassegnare un'email come sospetta se contiene determinate parole chiave. Ma cosa succede se scopri che quell'email proviene da un mittente affidabile? O se è stata inviata a un'ora insolita? Ogni nuova informazione sposta la probabilità che l'email sia spam. Questo aggiornamento dinamico delle probabilità in base a nuove evidenze è al cuore della probabilità condizionata, un concetto che alimenta molte applicazioni moderne della data science, dal filtraggio delle email al rilevamento delle frodi.
Per chi sta iniziando a esplorare i concetti di probabilità, la Cheat Sheet introduttiva alle regole di probabilità offre un utile riferimento a principi e formule di base. Il corso Introduzione alla statistica costruisce solide fondamenta esplorando le distribuzioni di probabilità e le loro proprietà, che sono alla base della comprensione di come funziona la probabilità condizionata nella pratica. Queste risorse offrono un percorso strutturato per sviluppare basi solide nei concetti che esploreremo in questo articolo.
La probabilità condizionata misura quanto è probabile che si verifichi un evento sapendo che un altro evento è già avvenuto. Quando riceviamo nuove informazioni su un evento, adeguiamo di conseguenza i nostri calcoli di probabilità.
Per capire questo concetto, esploriamo un esempio con le carte da gioco. Quando peschi una carta da un mazzo standard, ci sono 52 possibili esiti. Se vuoi pescare un re, la probabilità iniziale è 4/52 (circa 7,7%) poiché nel mazzo ci sono quattro re. Ma cosa succede se qualcuno ti dice che la carta che hai pescato è una figura? Questa nuova informazione cambia tutto: la probabilità di avere un re ora è molto più alta, pari a 4/12 (circa 33,3%), dato che in totale ci sono solo dodici figure.
Questa relazione tra probabilità ha una definizione matematica precisa:
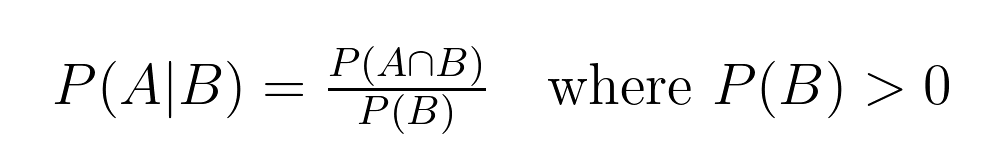
Questa formula ci aiuta a calcolare la probabilità condizionata, dove:
Nel nostro esempio con le carte:
Per capire meglio come funziona la probabilità condizionata nella pratica, possiamo usare un diagramma ad albero. I diagrammi ad albero sono particolarmente utili perché mostrano come ogni nuova informazione modifica le nostre probabilità:
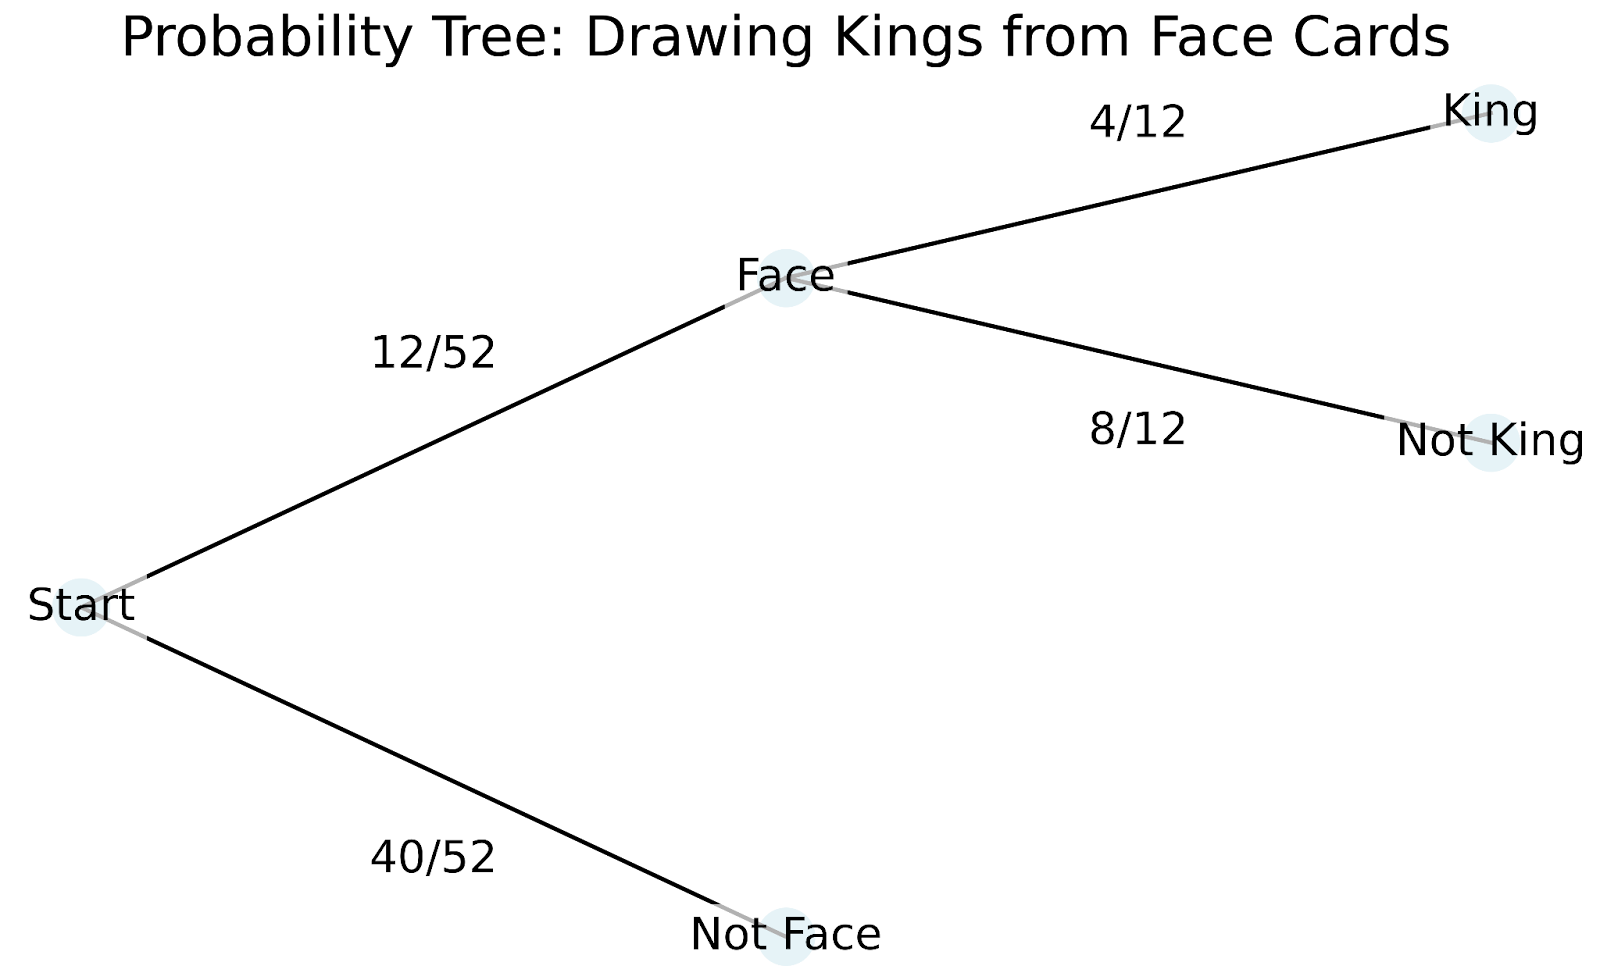
Vediamo come funziona questo diagramma ad albero:
Il diagramma ad albero ci aiuta a comprendere diversi concetti chiave della probabilità condizionata:
La bellezza della probabilità condizionata è che ci permette di aggiornare le nostre probabilità man mano che otteniamo nuove informazioni. Così come abbiamo aggiornato la probabilità di avere un re dal 7,7% al 33,3% quando abbiamo saputo che si trattava di una figura, la probabilità condizionata ci offre un modo formale per ricalcolare le probabilità sulla base di nuove evidenze.
La struttura matematica della probabilità condizionata ci fornisce strumenti per analizzare scenari complessi che coinvolgono più eventi. Esploriamo le proprietà chiave.
Queste proprietà matematiche ci aiutano a risolvere problemi complessi in modo più efficiente:
Quando due eventi A e B sono indipendenti sappiamo che il verificarsi dell'uno non influisce sulla probabilità dell'altro. Matematicamente: P(A|B) = P(A), che si legge: "la probabilità di A dato B è uguale alla probabilità di A".
Ad esempio, se lanciamo un dado e una moneta, ottenere testa con la moneta non cambia la probabilità di fare sei col dado. La formula ci mostra: P(Sei|Testa) = P(Sei) = 1/6
Per qualsiasi evento A dato B, le probabilità di A e del suo complemento A' (letto "A primo") devono sommare a 1. Matematicamente: P(A|B) + P(A'|B) = 1, che si legge: “La probabilità di A dato B più la probabilità del complemento di A dato B è uguale a 1”.
Nel nostro precedente esempio con le carte: P(Re|Figura) + P(Non Re|Figura) = 4/12 + 8/12 = 1
La regola di moltiplicazione collega le probabilità congiunte a quelle condizionate: P(A ∩ B) = P(A|B) × P(B). Diciamo: "La probabilità di A intersezione B è uguale alla probabilità di A dato B per la probabilità di B".
Questo si estende a più eventi tramite la chain rule. Per tre eventi A, B e C: P(A ∩ B ∩ C) = P(A|B ∩ C) × P(B|C) × P(C). Ovvero: "La probabilità di A intersezione B intersezione C è uguale alla probabilità di A dato B intersezione C per la probabilità di B dato C per la probabilità di C".
Vediamolo in azione con una sequenza di pescate di carte:
P(K ∩ Q ∩ A) = P(A|K ∩ Q) × P(Q|K) × P(K) = (4/50) × (4/51) × (4/52)
La chain rule diventa particolarmente preziosa nel machine learning, specialmente nelle reti bayesiane dove dobbiamo modellare dipendenze complesse tra più variabili. Analizzando i dati, spesso incontriamo situazioni in cui gli eventi seguono una sequenza naturale, e la chain rule ci aiuta a scomporre questi scenari complessi in calcoli più semplici e gestibili.
Rivediamo due degli esempi più comuni e pensiamo anche a come la probabilità condizionata possa presentarsi nel tuo lavoro.
Questi due esempi sono molto comuni e vale la pena studiarli, soprattutto se stai affrontando colloqui:
Quando lanciamo un dado, il nostro spazio campionario parte da sei possibilità: {1, 2, 3, 4, 5, 6}. Conoscere informazioni parziali sul lancio cambia i nostri calcoli di probabilità in modo specifico. Vediamo come:
Probabilità iniziale di fare 6: P(6) = 1/6
Se apprendiamo che il risultato è pari, il nostro spazio campionario si riduce a {2, 4, 6}: P(6 | pari) = 1/3
Un sacchetto contiene 5 biglie blu e 3 rosse. Quando peschiamo senza reinserimento, ogni pescata influisce sulle probabilità delle pescate successive.
Prima pescata - probabilità di blu: P(blu₁) = 5/8
Seconda pescata, dato che la prima era blu: P(blu₂ | blu₁) = 4/7
Questo esempio completa il precedente con le carte evidenziando le dipendenze sequenziali.
I test medici sono un'applicazione perfetta della probabilità condizionata per valutare l'accuratezza di un test. Per qualsiasi test diagnostico, dobbiamo comprendere quattro probabilità condizionate chiave:
Quando valutano le prestazioni di un test, i medici usano queste probabilità condizionate per:
Per esempio, se testiamo 1000 pazienti e otteniamo 100 risultati positivi, possiamo usare queste probabilità condizionate per stimare quanti sono veri positivi rispetto ai falsi positivi. Questa analisi aiuta i medici a bilanciare il rischio di mancare una diagnosi con i costi e l'ansia causati da falsi allarmi.
Le società di investimento usano la probabilità condizionata per valutare i rischi di mercato. Considera un gestore di portafoglio che monitora la volatilità del mercato:
La volatilità giornaliera può essere Bassa (L), Media (M) o Alta (H).
I dati storici mostrano:
Queste informazioni aiutano i gestori a:
La nostra esplorazione dei test medici ha evidenziato una distinzione importante: la probabilità di avere una malattia dato un test positivo è diversa dalla probabilità di risultare positivi dato che si ha la malattia. Il teorema di Bayes fornisce un quadro formale per orientarsi in questa relazione, permettendoci di aggiornare le stime di probabilità man mano che emergono nuove evidenze.
Il teorema di Bayes esprime la relazione tra due probabilità condizionate: P(A|B) = [P(B|A) × P(A)] / P(B). Possiamo leggerla così: "La probabilità di A dato B è uguale alla probabilità di B dato A per la probabilità di A, diviso per la probabilità di B".
Ogni componente ha un ruolo:
Vediamo come funziona nella pratica con il nostro scenario di test medico, ora ampliato per mostrare l'analisi bayesiana completa.
Considera una condizione medica che colpisce il 2% della popolazione. Un nuovo test diagnostico ha:
Quando un paziente risulta positivo, come dovremmo aggiornare la nostra convinzione sulla sua condizione?
Risolviamo passo dopo passo:
Questa analisi rivela che, anche con un test positivo, la probabilità di avere la condizione è solo circa il 16,2%: molto più alta dell'iniziale 2%, ma forse più bassa di quanto suggerirebbe l'intuizione.
Il teorema di Bayes brilla quando riceviamo più elementi di evidenza. La probabilità a posteriori di ogni calcolo diventa la probabilità a priori per l'aggiornamento successivo. Per esempio, se il nostro paziente ottiene un secondo test positivo:
Questo aggiornamento sequenziale fornisce un quadro matematico per incorporare nuove evidenze nelle nostre stime di probabilità. La bellezza dell'inferenza bayesiana sta nella sua capacità di quantificare come le nostre convinzioni debbano cambiare man mano che raccogliamo nuove informazioni, offrendo un metodo formale per aggiornare le probabilità alla luce delle evidenze.
Vediamo come la probabilità condizionata si presenta nella data science.
Il classificatore Naive Bayes, uno degli strumenti più semplici ma potenti nel machine learning, applica il teorema di Bayes per prevedere le categorie in base alle probabilità delle caratteristiche. Quando si classifica un'email come spam o non spam, per esempio, l'algoritmo calcola la probabilità condizionata che un'email sia spam dati i termini che contiene. Pur facendo l'ipotesi "ingenua" che le caratteristiche siano indipendenti, questa semplificazione spesso funziona sorprendentemente bene nella pratica.
Gli alberi decisionali adottano un approccio diverso alla probabilità condizionata, suddividendo i dati in base ai valori delle caratteristiche per creare sottoinsiemi condizionati. A ogni nodo, l'albero pone domande come: "Qual è la probabilità della nostra variabile target dato questo specifico valore della caratteristica?" Queste suddivisioni continuano fino a raggiungere sottoinsiemi puri o quasi puri, creando di fatto una mappa di probabilità condizionate che guidano le nostre previsioni.
I sistemi di credit scoring usano probabilità condizionate per valutare la probabilità di insolvenza di un prestito date varie caratteristiche del cliente. Per esempio, una banca può calcolare la probabilità di default dato il livello di reddito, la storia creditizia e lo stato occupazionale. Questi calcoli diventano più sofisticati quando si considerano rischi dipendenti multipli, come il modo in cui la probabilità di default di un mutuo possa cambiare dato sia una recessione sia l'aumento dei tassi d'interesse. I modelli di rischio d'investimento usano probabilità condizionate per stimare il Value at Risk (VaR), calcolando la probabilità di specifici livelli di perdita date le condizioni di mercato correnti. I gestori di portafoglio usano queste probabilità condizionate per adeguare le allocazioni di asset, comprendendo come il rischio di un investimento possa cambiare dato l'andamento degli altri in portafoglio.
Le reti bayesiane rappresentano l'applicazione più diretta della probabilità condizionata nel machine learning, modellando le relazioni tra variabili come un grafo diretto in cui lo stato di ciascun nodo dipende dai suoi genitori. Queste reti eccellono in compiti come la diagnosi medica, dove la probabilità di varie condizioni dipende da più sintomi e risultati di test interconnessi.
I modelli grafici probabilistici utilizzano dipendenze condizionate per rappresentare relazioni complesse nei dati, rendendoli preziosi per compiti come il riconoscimento di immagini e l'elaborazione del linguaggio naturale. Anche i modelli di deep learning, pur non essendo esplicitamente probabilistici, producono probabilità condizionate negli strati finali quando effettuano classificazioni. La funzione softmax, comunemente usata nelle reti neurali, trasforma i punteggi grezzi in probabilità condizionate, indicandoci la probabilità di ciascuna classe possibile dato l'input.
Quando si lavora con la probabilità condizionata, tre fraintendimenti principali portano spesso a conclusioni errate.
Infine, diamo uno sguardo ad alcune idee più complesse che si basano su quanto abbiamo praticato.
Quando passiamo da distribuzioni di probabilità discrete a continue, incontriamo una sfida interessante: punti specifici in una distribuzione continua hanno probabilità zero. Considera la misurazione dell'altezza esatta di una persona: mentre possiamo dire che la probabilità che qualcuno sia tra 170 e 171 centimetri è significativa, la probabilità che qualcuno sia esattamente 170,5432... centimetri è tecnicamente zero. Eppure spesso vogliamo condizionare su misure così precise. La probabilità condizionata regolare fornisce un quadro matematico per gestire queste situazioni, estendendo i concetti di base ai casi continui tramite funzioni di densità e teoria della misura. Questa estensione ci consente di dare senso a enunciati come "la distribuzione di probabilità del peso di una persona, dato che è esattamente alta 170,5 centimetri".
La condizionalizzazione di Jeffrey amplia la probabilità condizionata tradizionale a situazioni in cui la nostra nuova evidenza non è certa ma ha una sua probabilità. A differenza del condizionamento standard, in cui assumiamo assoluta certezza sulla nuova informazione, la regola di Jeffrey ci permette di aggiornare le convinzioni basandoci su evidenze incerte. Questo si adatta meglio a scenari reali in cui le nuove informazioni spesso arrivano con un certo grado di incertezza. Per esempio, anziché sapere con certezza che un test medico è positivo, potremmo apprendere che è positivo con probabilità dell'80%. La regola di Jeffrey fornisce un metodo formale per aggiornare le probabilità in queste situazioni più sfumate.
La probabilità condizionata fornisce un quadro matematico per aggiornare le nostre convinzioni man mano che emergono nuove informazioni. In tutto l'articolo, abbiamo visto come questo concetto si applichi in vari campi, dalla diagnosi medica alla valutazione del rischio finanziario. I principi che abbiamo esplorato ci aiutano a capire come la probabilità cambi con nuove evidenze, consentendo decisioni più informate nelle applicazioni di data science. Questa comprensione diventa particolarmente preziosa quando si lavora con algoritmi di classificazione, modelli di rischio e sistemi di machine learning in cui gli aggiornamenti di probabilità avvengono continuamente.
Man mano che continui a costruire la tua esperienza in probabilità e inferenza statistica, diversi corsi possono approfondire la comprensione di questi concetti in ottica bayesiana. Il nostro corso Fondamenti di analisi dei dati bayesiana in R introduce i principi chiave e le loro applicazioni pratiche, mentre il corso Bayesian Modeling with RJAGS mostra come implementare questi concetti con potenti strumenti statistici. Per chi usa Python, il nostro corso Bayesian Data Analysis in Python offre esperienza pratica nell'applicazione di questi metodi a problemi reali. Ogni corso offre un percorso per ampliare la tua conoscenza della probabilità e delle sue applicazioni nella data science moderna.
Impara con DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min



