想象您正在为电子邮件开发垃圾邮件检测系统。起初,您可能会根据是否包含某些关键词来将邮件标记为可疑。但如果您发现这封邮件来自可信发件人呢?或者它是在一个不寻常的时间发送的呢?每一条新信息都会改变该邮件为垃圾邮件的概率。基于新证据动态更新概率,正是条件概率的核心所在。这个概念为许多现代数据科学应用提供动力,从邮件过滤到欺诈检测不一而足。
对于刚开始学习概率概念的读者,概率规则入门速查表为核心原理和公式提供了有用参考。统计学入门课程通过探讨概率分布及其性质,夯实理解条件概率在实践中如何运作的基础。这些资源为本文将要探讨的概念提供了一条循序渐进、体系化的学习路径。
什么是条件概率?
条件概率衡量的是:在已知另一事件已经发生的情况下,一个事件发生的可能性。当我们获得关于某个事件的新信息时,我们会相应调整概率计算。
为理解这一概念,让我们用一副扑克牌举例。从一副标准牌中抽一张牌,共有52种可能。如果您想抽到一张国王(K),初始概率是4/52(约7.7%),因为牌中有四张K。但如果有人告诉您抽到的是人头牌呢?这条新信息会改变一切——您拿到K的概率此时变为4/12(约33.3%),因为人头牌总共有12张。
这种概率之间的关系有一个精确的数学定义:
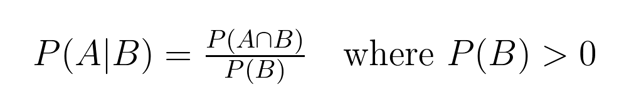
这个公式帮助我们计算条件概率,其中:
- P(A|B) 表示在事件B已发生的条件下,事件A发生的概率。读作“在B条件下A的概率”。
- P(A∩B) 表示联合概率,即事件A和事件B同时发生的概率。读作“A与B的交集的概率”。
- P(B) 表示事件B发生的概率。
在我们的扑克牌示例中:
- 事件A是“抽到一张K”
- 事件B是“抽到一张人头牌”
- P(A|B) = 4/12(在已知为人头牌的条件下抽到K的概率)
- P(A∩B) = 4/52(抽到K的概率,K必然是人头牌)
- P(B) = 12/52(抽到任意人头牌的概率)
为了更好地理解条件概率在实践中的运作,我们可以使用树状图。树状图特别有用,因为它展示了每条新信息如何改变我们的概率:
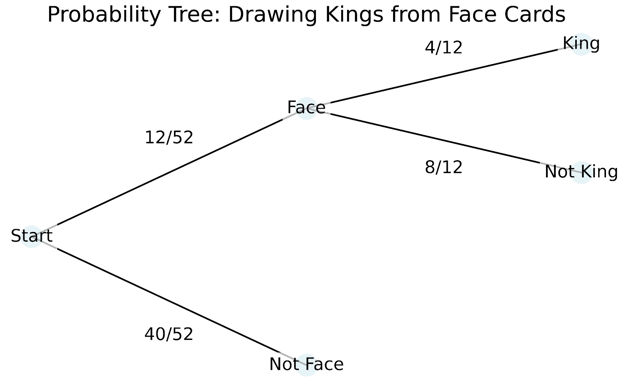
让我们逐步看看这个树状图如何工作:
- 从根节点(最左侧)开始,我们有全部52张牌。
- 第一层分支给出第一条信息——它是人头牌还是不是?
- 沿着“人头牌”分支继续,第二层基于第二条信息再分——它是K吗?
树状图帮助我们理解条件概率中的若干关键概念:
- 样本空间: 指我们情境下所有可能结果。初始样本空间是52张牌,但一旦知道是人头牌,就“缩小”为12张。
- 事件: 我们关注的具体结果,比如“抽到人头牌”或“抽到K”。树中的分支代表不同事件。
- 联合概率: 多个事件同时发生的概率。在树中,可通过沿路径相乘得到。例如,抽到K且它是人头牌的概率是 (12/52) × (4/12) = 4/52。
- 边际(无条件)概率: 不考虑任何其他信息时事件发生的概率。在示例中,这就像在未知任何信息前,抽到K的初始概率4/52。
条件概率的妙处在于,它允许我们在获得新信息时更新概率。正如当我们得知是人头牌后,把拿到K的概率从7.7%调整到33.3%一样,条件概率为我们基于新证据重新计算概率提供了形式化的方法。
条件概率公式
条件概率的数学结构为我们分析涉及多个事件的复杂情景提供了工具。让我们来看关键性质。
条件概率的关键性质
这些数学性质帮助我们更高效地解决复杂问题:
1. 独立性性质
当两个事件A和B相互独立时,一个事件的发生不影响另一个事件的概率。数学上:P(A|B) = P(A),读作“在B条件下A的概率等于A的概率”。
例如,掷骰子并抛硬币时,硬币正面朝上的结果并不改变掷出6点的概率。公式表示为:P(六点|正面) = P(六点) = 1/6
2. 互补法则
在给定条件B的情况下,任一事件A与其补事件A'(读作“A撇”)的概率之和必须为1。 数学上:P(A|B) + P(A'|B) = 1,读作:“在B条件下A的概率加上在B条件下A的补集的概率等于1。”
在前述扑克牌示例中:P(国王|人头牌) + P(非国王|人头牌) = 4/12 + 8/12 = 1
乘法法则与链式法则
乘法法则将联合概率与条件概率联系起来:P(A ∩ B) = P(A|B) × P(B)。我们说:“A与B的交集的概率等于在B条件下A的概率乘以B的概率。”
这一定义通过链式法则扩展到多个事件。对于三个事件A、B和C:P(A ∩ B ∩ C) = P(A|B ∩ C) × P(B|C) × P(C)。也就是:“A与B与C的交集的概率等于在B与C条件下A的概率乘以在C条件下B的概率再乘以C的概率。”
让我们用一段抽牌序列来看看它的实际应用:
- 先抽到一张国王(K)
- 在余牌中抽到一张皇后(Q)
- 在余牌中抽到一张A(A)
P(K ∩ Q ∩ A) = P(A|K ∩ Q) × P(Q|K) × P(K) = (4/50) × (4/51) × (4/52)
链式法则在机器学习中尤为重要,尤其是在贝叶斯网络中,需要对多个变量之间的复杂依赖关系建模。分析数据时,我们常会遇到事件按自然顺序发生的情形,链式法则帮助我们将复杂情景分解为更简单、可管理的计算。
举例说明条件概率
让我们回顾两个最常见的示例,并思考条件概率如何出现在您的工作中。
经典示例
这两个示例非常常见,值得研究,尤其在面试中:
掷骰子:理解缩减的样本空间
掷一次骰子时,样本空间从六种可能开始:{1, 2, 3, 4, 5, 6}。关于点数的部分信息会以特定方式改变我们的概率计算。如下所示:
掷出6点的初始概率:P(6) = 1/6
如果得知点数为偶数,样本空间缩减为 {2, 4, 6}:P(6 | 偶数) = 1/3
弹珠:序列依赖
一个袋子里有5颗蓝色弹珠和3颗红色弹珠。当我们不放回地抽取时,每一次抽取都会影响后续抽取的概率。
第一次抽到蓝色的概率:P(blue₁) = 5/8
已知第一次为蓝色时第二次抽到蓝色的概率:P(blue₂ | blue₁) = 4/7
这个例子与前面的扑克牌示例相辅相成,突出了序列依赖性。
现实世界示例
医学检测:评估测试准确性
医学检测是条件概率在评估测试准确性方面的典型应用。对于任何诊断测试,我们需要理解四个关键的条件概率:
- P(T+ | D+): 在患者确有疾病的前提下测试呈阳性的概率(敏感性)
- P(T- | D-): 在患者确无疾病的前提下测试呈阴性的概率(特异性)
- P(T+ | D-): 在患者确无疾病的前提下测试呈阳性的概率(假阳性率)
- P(T- | D+): 在患者确有疾病的前提下测试呈阴性的概率(假阴性率)
在评估测试性能时,医疗专业人士会用这些条件概率来:
- 比较不同患者群体之间的测试准确性
- 判断何时需要进行多次检测
- 为阳性/阴性结果设定合适的阈值
例如,如果我们测试1000名患者并得到100个阳性结果,我们可以利用这些条件概率来估计其中有多少是真阳性、有多少是假阳性。此类分析有助于在漏诊风险与假警报带来的成本和焦虑之间取得平衡。
金融风险评估
投资机构使用条件概率来评估市场风险。设想一位跟踪市场波动性的投资组合经理:
每日市场波动性可为低(L)、中(M),或高(H)。
历史数据显示:
- P(明天为H | 今天为H) = 0.70
- P(明天为M | 今天为H) = 0.25
- P(明天为L | 今天为H) = 0.05
这些信息帮助经理人:
- 根据当前市场状况调整资产配置
- 为自动化交易系统设定风险阈值
- 制定应对持续高波动时期的预案
条件概率与贝叶斯定理
我们在医学检测的探讨中强调了一个重要区分:在阳性结果下患病的概率,与在患病条件下检测为阳性的概率不同。贝叶斯定理为处理这种关系提供了正式框架,使我们能够在有新证据出现时更新概率估计。
理解贝叶斯定理
贝叶斯定理刻画了两个条件概率之间的关系:P(A|B) = [P(B|A) × P(A)] / P(B)。我们这样理解该等式:“在B条件下A的概率等于在A条件下B的概率乘以A的先验概率,再除以B的概率。”
各部分含义如下:
- P(A):先验概率——在看到证据B之前我们对A的初始信念
- P(B|A):似然——如果A为真,观察到证据B的可能性
- P(B):观察到证据B的总体概率
- P(A|B):后验概率——在看到证据B之后我们对A的更新信念
让我们在医学检测情境中看看其具体运作,展开完整的贝叶斯分析。
医学检测示例
假设某种疾病影响人口的2%。一项新的诊断测试具有:
- 95%敏感性:P(阳性 | 有病) = 0.95
- 90%特异性:P(阴性 | 无病) = 0.90
当患者检测为阳性时,我们应如何更新对其患病的判断?
让我们一步步计算:
- 先验概率(检测前):P(患病) = 0.02(2%人群患病率)
- 在患病条件下阳性的似然:P(阳性|患病) = 0.95(测试敏感性)
- 阳性的总体概率:P(阳性) = P(阳性|患病) × P(患病) + P(阳性|无病) × P(无病) = 0.95 × 0.02 + 0.10 × 0.98 = 0.019 + 0.098 = 0.117
- 后验概率(用贝叶斯定理):P(患病|阳性) = [0.95 × 0.02] / 0.117 ≈ 0.162,即16.2%
该分析表明,即使检测为阳性,患病的概率也只有约16.2%——远高于最初的2%,但可能低于直觉所想。
贝叶斯更新的力量
当我们获得多条证据时,贝叶斯定理尤为出色。每次计算得到的后验概率都会成为下一次更新的先验概率。比如,如果患者第二次检测仍为阳性:
- 新的先验:P(患病) = 0.162(来自第一次计算)
- 似然:P(阳性|患病) = 0.95
- 计算新的后验……
这种序列式更新为我们将新证据纳入概率估计提供了数学框架。贝叶斯推断的美妙之处在于,它能够量化我们在获取新信息时信念应如何变化,从而在证据面前以正式方法更新概率。
数据科学中的应用
看看条件概率如何出现在数据科学中。
预测建模
朴素贝叶斯分类器是机器学习中最直接却强大的工具之一,它应用贝叶斯定理,根据特征的概率来预测类别。以垃圾邮件分类为例,该算法会计算在给定邮件所含词语的条件下,邮件为垃圾邮件的条件概率。尽管它做出“朴素”的独立性假设,但这种简化在实践中往往效果出乎意料地好。
决策树采用了与条件概率不同的路径,通过基于特征值划分数据来创建条件子集。在每个节点,树会提出类似这样的提问:“在这个特定特征取值下,我们的目标变量的概率是多少?”分裂持续进行,直到我们得到纯或近乎纯的子集,实质上构建了一张指导预测的条件概率地图。
风险管理
信用评分系统使用条件概率来评估在给定各类客户特征下贷款违约的可能性。例如,银行可能计算在给定收入水平、信用记录和就业状况时的违约概率。当考虑多个相关风险时(例如在经济衰退与利率上升同时发生的条件下,按揭违约概率如何变化),这些计算会更为复杂。投资风险模型利用条件概率估计在险价值(VaR),即在当前市场条件下达到特定亏损水平的概率。投资组合经理利用这些条件概率调整资产配置,理解在其他资产表现给定的情形下,某一投资的风险如何变化。
机器学习
贝叶斯网络是条件概率在机器学习中最直接的应用形式,它将变量之间的关系建模为有向图,其中每个节点的状态取决于其父节点。这类网络在医学诊断等任务中表现出色,因为各种疾病的概率取决于多个相互关联的症状和检测结果。
概率图模型利用条件依赖来表示数据中的复杂关系,使其在图像识别和自然语言处理等任务中颇具价值。即便是深度学习模型,虽然并非显式的概率模型,在进行分类时其最终层也会输出条件概率。常见的softmax函数会将原始分数转换为条件概率,告诉我们在给定输入数据时各个可能类别的可能性。
常见陷阱与误解
处理条件概率时,三种主要误解常导致错误结论。
- 逆向谬误(也称“混淆逆命题”)是将P(A|B)与P(B|A)混为一谈。我们在医学检测例子中见过——在阳性结果下患病的概率,与在患病条件下阳性的概率不同。
- 基率忽视发生在我们关注条件概率而忽略事件的底层概率时。例如,如果一种罕见疾病仅影响万分之一的人口,即便测试非常准确,也可能主要给出假阳性,因为疾病太罕见。
- 第三个陷阱是在更新概率时对证据权重评估不当。人们往往高估近期或戏剧性的证据,低估稳定的背景信息。在金融交易中,例如投资者可能对近期市场新闻反应过度,而忽视长期市场概率。
高级主题与进一步思考
最后,让我们看看一些建立在上述练习之上的更复杂思路。
对零概率事件进行条件化
当我们从离散概率分布转向连续概率分布时,会遇到一个有趣的挑战:连续分布中的具体点的概率为零。以测量某人的精确身高为例——我们可以说身高在170到171厘米之间的概率是有意义的,但某人身高恰为170.5432…厘米的概率在技术上为零。然而我们常常希望对如此精确的测量进行条件化。正则条件概率为处理这些情形提供了数学框架,通过密度函数与测度论将基本概念扩展到连续情形。借助这一扩展,我们可以理解诸如“在身高恰为170.5厘米的条件下,一名个体体重的概率分布”这样的表述。
部分条件概率与扩展
Jeffrey条件化将传统条件概率扩展到新证据并非确定、而是自带概率的不确定情境。不同于标准条件化假定我们对新信息绝对确定,Jeffrey法则允许我们在不确定证据的基础上更新信念。这更契合现实世界中信息常常带有不确定性的情况。例如,我们可能无法确定医学测试为阳性,但得知其有80%的可能为阳性。对于这类更微妙的情形,Jeffrey法则提供了形式化的概率更新方法。
结论
条件概率为我们在出现新信息时更新信念提供了数学框架。本文展示了该概念在多个领域的应用,从医学诊断到金融风险评估。我们探讨的原理帮助我们理解在新证据下概率如何变化,从而在数据科学应用中做出更明智的决策。这种理解在处理分类算法、风险模型和机器学习系统时尤为重要,因为其中的概率更新是持续发生的。
在您持续构建概率与统计推断方面的专业能力时,有多门课程可通过贝叶斯视角加深您对这些概念的理解。我们的R语言贝叶斯数据分析基础课程介绍关键原理及其实践应用,而使用RJAGS的贝叶斯建模课程展示如何用强大的统计工具实现这些概念。对于Python用户,我们的Python贝叶斯数据分析课程提供将这些方法应用于真实问题的动手实践。每门课程都为您扩展对概率及其在现代数据科学中的应用的认知提供了路径。


想象您正在为电子邮件开发垃圾邮件检测系统。起初,您可能会根据是否包含某些关键词来将邮件标记为可疑。但如果您发现这封邮件来自可信发件人呢?或者它是在一个不寻常的时间发送的呢?每一条新信息都会改变该邮件为垃圾邮件的概率。基于新证据动态更新概率,正是条件概率的核心所在。这个概念为许多现代数据科学应用提供动力,从邮件过滤到欺诈检测不一而足。
对于刚开始学习概率概念的读者,概率规则入门速查表为核心原理和公式提供了有用参考。统计学入门课程通过探讨概率分布及其性质,夯实理解条件概率在实践中如何运作的基础。这些资源为本文将要探讨的概念提供了一条循序渐进、体系化的学习路径。
什么是条件概率?
条件概率衡量的是:在已知另一事件已经发生的情况下,一个事件发生的可能性。当我们获得关于某个事件的新信息时,我们会相应调整概率计算。
为理解这一概念,让我们用一副扑克牌举例。从一副标准牌中抽一张牌,共有52种可能。如果您想抽到一张国王(K),初始概率是4/52(约7.7%),因为牌中有四张K。但如果有人告诉您抽到的是人头牌呢?这条新信息会改变一切——您拿到K的概率此时变为4/12(约33.3%),因为人头牌总共有12张。
这种概率之间的关系有一个精确的数学定义:
这个公式帮助我们计算条件概率,其中:
在我们的扑克牌示例中:
为了更好地理解条件概率在实践中的运作,我们可以使用树状图。树状图特别有用,因为它展示了每条新信息如何改变我们的概率:
让我们逐步看看这个树状图如何工作:
树状图帮助我们理解条件概率中的若干关键概念:
条件概率的妙处在于,它允许我们在获得新信息时更新概率。正如当我们得知是人头牌后,把拿到K的概率从7.7%调整到33.3%一样,条件概率为我们基于新证据重新计算概率提供了形式化的方法。
条件概率公式
条件概率的数学结构为我们分析涉及多个事件的复杂情景提供了工具。让我们来看关键性质。
条件概率的关键性质
这些数学性质帮助我们更高效地解决复杂问题:
1. 独立性性质
当两个事件A和B相互独立时,一个事件的发生不影响另一个事件的概率。数学上:P(A|B) = P(A),读作“在B条件下A的概率等于A的概率”。
例如,掷骰子并抛硬币时,硬币正面朝上的结果并不改变掷出6点的概率。公式表示为:P(六点|正面) = P(六点) = 1/6
2. 互补法则
在给定条件B的情况下,任一事件A与其补事件A'(读作“A撇”)的概率之和必须为1。 数学上:P(A|B) + P(A'|B) = 1,读作:“在B条件下A的概率加上在B条件下A的补集的概率等于1。”
在前述扑克牌示例中:P(国王|人头牌) + P(非国王|人头牌) = 4/12 + 8/12 = 1
乘法法则与链式法则
乘法法则将联合概率与条件概率联系起来:P(A ∩ B) = P(A|B) × P(B)。我们说:“A与B的交集的概率等于在B条件下A的概率乘以B的概率。”
这一定义通过链式法则扩展到多个事件。对于三个事件A、B和C:P(A ∩ B ∩ C) = P(A|B ∩ C) × P(B|C) × P(C)。也就是:“A与B与C的交集的概率等于在B与C条件下A的概率乘以在C条件下B的概率再乘以C的概率。”
让我们用一段抽牌序列来看看它的实际应用:
P(K ∩ Q ∩ A) = P(A|K ∩ Q) × P(Q|K) × P(K) = (4/50) × (4/51) × (4/52)
链式法则在机器学习中尤为重要,尤其是在贝叶斯网络中,需要对多个变量之间的复杂依赖关系建模。分析数据时,我们常会遇到事件按自然顺序发生的情形,链式法则帮助我们将复杂情景分解为更简单、可管理的计算。
举例说明条件概率
让我们回顾两个最常见的示例,并思考条件概率如何出现在您的工作中。
经典示例
这两个示例非常常见,值得研究,尤其在面试中:
掷骰子:理解缩减的样本空间
掷一次骰子时,样本空间从六种可能开始:{1, 2, 3, 4, 5, 6}。关于点数的部分信息会以特定方式改变我们的概率计算。如下所示:
掷出6点的初始概率:P(6) = 1/6
如果得知点数为偶数,样本空间缩减为 {2, 4, 6}:P(6 | 偶数) = 1/3
弹珠:序列依赖
一个袋子里有5颗蓝色弹珠和3颗红色弹珠。当我们不放回地抽取时,每一次抽取都会影响后续抽取的概率。
第一次抽到蓝色的概率:P(blue₁) = 5/8
已知第一次为蓝色时第二次抽到蓝色的概率:P(blue₂ | blue₁) = 4/7
这个例子与前面的扑克牌示例相辅相成,突出了序列依赖性。
现实世界示例
医学检测:评估测试准确性
医学检测是条件概率在评估测试准确性方面的典型应用。对于任何诊断测试,我们需要理解四个关键的条件概率:
在评估测试性能时,医疗专业人士会用这些条件概率来:
例如,如果我们测试1000名患者并得到100个阳性结果,我们可以利用这些条件概率来估计其中有多少是真阳性、有多少是假阳性。此类分析有助于在漏诊风险与假警报带来的成本和焦虑之间取得平衡。
金融风险评估
投资机构使用条件概率来评估市场风险。设想一位跟踪市场波动性的投资组合经理:
每日市场波动性可为低(L)、中(M),或高(H)。
历史数据显示:
这些信息帮助经理人:
条件概率与贝叶斯定理
我们在医学检测的探讨中强调了一个重要区分:在阳性结果下患病的概率,与在患病条件下检测为阳性的概率不同。贝叶斯定理为处理这种关系提供了正式框架,使我们能够在有新证据出现时更新概率估计。
理解贝叶斯定理
贝叶斯定理刻画了两个条件概率之间的关系:P(A|B) = [P(B|A) × P(A)] / P(B)。我们这样理解该等式:“在B条件下A的概率等于在A条件下B的概率乘以A的先验概率,再除以B的概率。”
各部分含义如下:
让我们在医学检测情境中看看其具体运作,展开完整的贝叶斯分析。
医学检测示例
假设某种疾病影响人口的2%。一项新的诊断测试具有:
当患者检测为阳性时,我们应如何更新对其患病的判断?
让我们一步步计算:
该分析表明,即使检测为阳性,患病的概率也只有约16.2%——远高于最初的2%,但可能低于直觉所想。
贝叶斯更新的力量
当我们获得多条证据时,贝叶斯定理尤为出色。每次计算得到的后验概率都会成为下一次更新的先验概率。比如,如果患者第二次检测仍为阳性:
这种序列式更新为我们将新证据纳入概率估计提供了数学框架。贝叶斯推断的美妙之处在于,它能够量化我们在获取新信息时信念应如何变化,从而在证据面前以正式方法更新概率。
数据科学中的应用
看看条件概率如何出现在数据科学中。
预测建模
朴素贝叶斯分类器是机器学习中最直接却强大的工具之一,它应用贝叶斯定理,根据特征的概率来预测类别。以垃圾邮件分类为例,该算法会计算在给定邮件所含词语的条件下,邮件为垃圾邮件的条件概率。尽管它做出“朴素”的独立性假设,但这种简化在实践中往往效果出乎意料地好。
决策树采用了与条件概率不同的路径,通过基于特征值划分数据来创建条件子集。在每个节点,树会提出类似这样的提问:“在这个特定特征取值下,我们的目标变量的概率是多少?”分裂持续进行,直到我们得到纯或近乎纯的子集,实质上构建了一张指导预测的条件概率地图。
风险管理
信用评分系统使用条件概率来评估在给定各类客户特征下贷款违约的可能性。例如,银行可能计算在给定收入水平、信用记录和就业状况时的违约概率。当考虑多个相关风险时(例如在经济衰退与利率上升同时发生的条件下,按揭违约概率如何变化),这些计算会更为复杂。投资风险模型利用条件概率估计在险价值(VaR),即在当前市场条件下达到特定亏损水平的概率。投资组合经理利用这些条件概率调整资产配置,理解在其他资产表现给定的情形下,某一投资的风险如何变化。
机器学习
贝叶斯网络是条件概率在机器学习中最直接的应用形式,它将变量之间的关系建模为有向图,其中每个节点的状态取决于其父节点。这类网络在医学诊断等任务中表现出色,因为各种疾病的概率取决于多个相互关联的症状和检测结果。
概率图模型利用条件依赖来表示数据中的复杂关系,使其在图像识别和自然语言处理等任务中颇具价值。即便是深度学习模型,虽然并非显式的概率模型,在进行分类时其最终层也会输出条件概率。常见的softmax函数会将原始分数转换为条件概率,告诉我们在给定输入数据时各个可能类别的可能性。
常见陷阱与误解
处理条件概率时,三种主要误解常导致错误结论。
高级主题与进一步思考
最后,让我们看看一些建立在上述练习之上的更复杂思路。
对零概率事件进行条件化
当我们从离散概率分布转向连续概率分布时,会遇到一个有趣的挑战:连续分布中的具体点的概率为零。以测量某人的精确身高为例——我们可以说身高在170到171厘米之间的概率是有意义的,但某人身高恰为170.5432…厘米的概率在技术上为零。然而我们常常希望对如此精确的测量进行条件化。正则条件概率为处理这些情形提供了数学框架,通过密度函数与测度论将基本概念扩展到连续情形。借助这一扩展,我们可以理解诸如“在身高恰为170.5厘米的条件下,一名个体体重的概率分布”这样的表述。
部分条件概率与扩展
Jeffrey条件化将传统条件概率扩展到新证据并非确定、而是自带概率的不确定情境。不同于标准条件化假定我们对新信息绝对确定,Jeffrey法则允许我们在不确定证据的基础上更新信念。这更契合现实世界中信息常常带有不确定性的情况。例如,我们可能无法确定医学测试为阳性,但得知其有80%的可能为阳性。对于这类更微妙的情形,Jeffrey法则提供了形式化的概率更新方法。
结论
条件概率为我们在出现新信息时更新信念提供了数学框架。本文展示了该概念在多个领域的应用,从医学诊断到金融风险评估。我们探讨的原理帮助我们理解在新证据下概率如何变化,从而在数据科学应用中做出更明智的决策。这种理解在处理分类算法、风险模型和机器学习系统时尤为重要,因为其中的概率更新是持续发生的。
在您持续构建概率与统计推断方面的专业能力时,有多门课程可通过贝叶斯视角加深您对这些概念的理解。我们的R语言贝叶斯数据分析基础课程介绍关键原理及其实践应用,而使用RJAGS的贝叶斯建模课程展示如何用强大的统计工具实现这些概念。对于Python用户,我们的Python贝叶斯数据分析课程提供将这些方法应用于真实问题的动手实践。每门课程都为您扩展对概率及其在现代数据科学中的应用的认知提供了路径。