Hãy tưởng tượng bạn đang phát triển một hệ thống phát hiện thư rác cho email. Ban đầu, bạn có thể gắn cờ một email là đáng ngờ nếu nó chứa một số từ khóa nhất định. Nhưng điều gì nếu bạn phát hiện email này đến từ một người gửi đáng tin cậy? Hoặc nó được gửi vào một giờ bất thường? Mỗi mảnh thông tin mới đều làm thay đổi xác suất email là thư rác. Việc cập nhật động các xác suất dựa trên bằng chứng mới chính là cốt lõi của xác suất có điều kiện, một khái niệm cung cấp năng lượng cho nhiều ứng dụng khoa học dữ liệu hiện đại, từ lọc email đến phát hiện gian lận.
Với những ai mới bắt đầu làm quen với các khái niệm xác suất, Cheat Sheet Giới thiệu Quy tắc Xác suất cung cấp tài liệu tham khảo hữu ích về các nguyên tắc và công thức cốt lõi. Khóa học Giới thiệu về Thống kê xây dựng nền tảng vững chắc bằng cách khám phá các phân phối xác suất và thuộc tính của chúng, là cơ sở để hiểu cách xác suất có điều kiện vận hành trong thực tế. Những tài nguyên này mang đến lộ trình có cấu trúc để phát triển nền tảng vững chắc cho các khái niệm chúng ta sẽ tìm hiểu trong bài viết này.
Xác suất có điều kiện là gì?
Xác suất có điều kiện đo lường mức độ khả dĩ của một sự kiện khi ta biết rằng một sự kiện khác đã xảy ra. Khi nhận được thông tin mới về một sự kiện, chúng ta điều chỉnh các phép tính xác suất cho phù hợp.
Để hiểu khái niệm này, hãy xét ví dụ với bộ bài tây. Khi bạn rút một lá từ một bộ bài tiêu chuẩn, có 52 kết quả có thể. Nếu bạn muốn rút một lá vua (King), xác suất ban đầu là 4/52 (khoảng 7,7%) vì có bốn lá vua trong bộ. Nhưng nếu ai đó nói rằng lá bạn rút là lá hình (face card)? Thông tin mới này thay đổi mọi thứ – xác suất có lá vua giờ cao hơn nhiều, 4/12 (khoảng 33,3%), vì tổng cộng chỉ có mười hai lá hình.
Mối quan hệ giữa các xác suất này có một định nghĩa toán học chính xác:
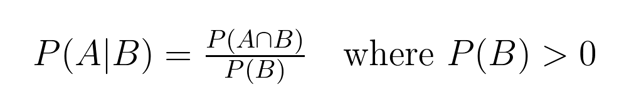
Công thức này giúp chúng ta tính xác suất có điều kiện, trong đó:
- P(A|B) là xác suất sự kiện A xảy ra, với điều kiện sự kiện B đã xảy ra. Đọc là "xác suất của A khi biết B".
- P(A∩B) là xác suất đồng thời, hay xác suất cả hai sự kiện A và B xảy ra cùng nhau. Đọc là "xác suất A giao B".
- P(B) là xác suất sự kiện B xảy ra.
Trong ví dụ bộ bài:
- Sự kiện A là "rút được lá Vua"
- Sự kiện B là "rút được lá hình"
- P(A|B) = 4/12 (xác suất được lá vua khi biết là lá hình)
- P(A∩B) = 4/52 (xác suất rút được lá vua, vốn luôn là lá hình)
- P(B) = 12/52 (xác suất rút được bất kỳ lá hình nào)
Để hiểu rõ hơn cách xác suất có điều kiện vận hành trong thực tế, ta có thể dùng sơ đồ cây. Sơ đồ cây đặc biệt hữu ích vì chúng cho thấy cách mỗi mảnh thông tin mới thay đổi xác suất của chúng ta:
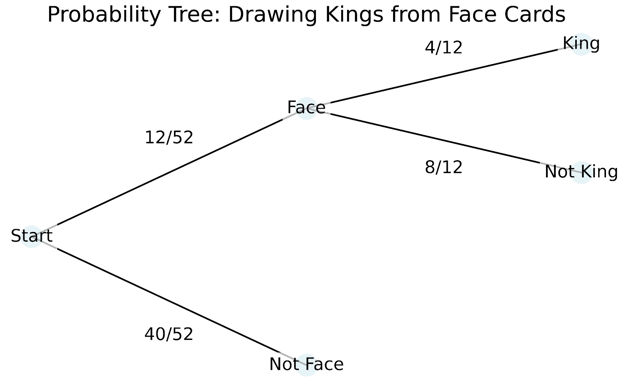
Hãy cùng đi qua cách sơ đồ cây này hoạt động:
- Chúng ta bắt đầu ở gốc (điểm ngoài cùng bên trái) với tất cả 52 lá.
- Nhánh đầu tiên thể hiện mảnh thông tin đầu tiên – đó có phải là lá hình hay không?
- Nếu theo nhánh lá hình, nó lại tách tiếp theo mảnh thông tin thứ hai – đó có phải là lá vua không?
Sơ đồ cây giúp chúng ta hiểu một số khái niệm then chốt trong xác suất có điều kiện:
- Không gian mẫu: Đây là tất cả các kết cục có thể trong kịch bản của chúng ta. Không gian mẫu ban đầu là 52 lá, nhưng được "thu hẹp" còn 12 lá khi ta biết đang có một lá hình.
- Sự kiện: Đây là những kết cục cụ thể mà ta quan tâm, như "rút được lá hình" hay "rút được lá vua". Các nhánh trong sơ đồ cây đại diện cho những sự kiện khác nhau.
- Xác suất đồng thời: Đây là xác suất nhiều sự kiện xảy ra cùng lúc. Trên sơ đồ cây, ta có thể tìm bằng cách nhân các xác suất dọc theo một đường đi. Ví dụ, xác suất rút được lá vua VÀ đó là lá hình là (12/52) × (4/12) = 4/52.
- Xác suất biên (vô điều kiện): Đây là xác suất của một sự kiện khi không xét đến bất kỳ thông tin nào khác. Trong ví dụ, đó là 4/52 – xác suất rút được lá vua trước khi biết gì thêm về lá bài.
Điều hay của xác suất có điều kiện là nó cho phép chúng ta cập nhật xác suất khi có thêm thông tin. Cũng như ta đã điều chỉnh xác suất có lá vua từ 7,7% lên 33,3% khi biết đó là lá hình, xác suất có điều kiện cho ta một cách thức chính quy để tính lại xác suất dựa trên bằng chứng mới.
Công thức Xác suất Có điều kiện
Cấu trúc toán học của xác suất có điều kiện cung cấp cho chúng ta các công cụ để phân tích những kịch bản phức tạp liên quan đến nhiều sự kiện. Hãy cùng xem các tính chất chính.
Các tính chất then chốt của xác suất có điều kiện
Những tính chất toán học này giúp chúng ta giải các bài toán phức tạp hiệu quả hơn:
1. Tính độc lập
Khi hai sự kiện A và B độc lập, ta biết rằng việc một sự kiện xảy ra không ảnh hưởng đến xác suất của sự kiện kia. Về mặt toán học: P(A|B) = P(A), đọc là: "xác suất của A khi biết B bằng xác suất của A".
Ví dụ, nếu ta tung một con xúc xắc và tung một đồng xu, ra mặt ngửa trên đồng xu không làm thay đổi xác suất ra số sáu. Công thức cho thấy: P(Six|Heads) = P(Six) = 1/6
2. Quy tắc bù
Với bất kỳ sự kiện A khi có điều kiện B, tổng xác suất của A và phần bù của nó A' (đọc là "A phảy") phải bằng 1. Về mặt toán học: P(A|B) + P(A'|B) = 1, đọc là: “Xác suất của A khi biết B cộng với xác suất của phần bù A khi biết B bằng 1.”
Trong ví dụ bộ bài trước đó: P(King|Face Card) + P(Not King|Face Card) = 4/12 + 8/12 = 1
Quy tắc nhân và quy tắc dây chuyền
Quy tắc nhân liên kết xác suất đồng thời với xác suất có điều kiện: P(A ∩ B) = P(A|B) × P(B). Ta đọc là: "Xác suất A giao B bằng xác suất A khi biết B nhân với xác suất B".
Điều này mở rộng cho nhiều sự kiện thông qua quy tắc dây chuyền. Với ba sự kiện A, B và C: P(A ∩ B ∩ C) = P(A|B ∩ C) × P(B|C) × P(C). Tức là: "Xác suất A giao B giao C bằng xác suất A khi biết B giao C nhân với xác suất B khi biết C nhân với xác suất C".
Hãy xem điều này vận hành ra sao với một chuỗi rút bài:
- Rút một lá vua (K)
- Từ các lá còn lại, rút một lá hoàng hậu (Q)
- Từ các lá còn lại, rút một lá át (A)
P(K ∩ Q ∩ A) = P(A|K ∩ Q) × P(Q|K) × P(K) = (4/50) × (4/51) × (4/52)
Quy tắc dây chuyền đặc biệt hữu ích trong học máy, nhất là trong các mạng Bayes nơi chúng ta cần mô hình hóa sự phụ thuộc phức tạp giữa nhiều biến. Khi phân tích dữ liệu, ta thường gặp những tình huống các sự kiện diễn tiến theo trình tự tự nhiên, và quy tắc dây chuyền giúp phân rã những kịch bản phức tạp này thành các phép tính đơn giản, dễ xử lý hơn.
Ví dụ Minh họa Xác suất Có điều kiện
Hãy điểm lại hai ví dụ phổ biến nhất và cũng nghĩ xem xác suất có điều kiện có thể xuất hiện trong công việc của bạn như thế nào.
Ví dụ kinh điển
Hai ví dụ này rất phổ biến và đáng để học kỹ, đặc biệt nếu bạn đang phỏng vấn:
Tung xúc xắc: Hiểu không gian mẫu bị thu hẹp
Khi tung một con xúc xắc, không gian mẫu của chúng ta bắt đầu với sáu khả năng: {1, 2, 3, 4, 5, 6}. Khi biết một phần thông tin về lần tung, các phép tính xác suất của ta thay đổi theo một cách cụ thể. Cùng xem:
Xác suất ban đầu ra 6: P(6) = 1/6
Nếu ta biết kết quả là số chẵn, không gian mẫu thu hẹp còn {2, 4, 6}: P(6 | chẵn) = 1/3
Bi ve: Phụ thuộc theo trình tự
Một túi chứa 5 viên bi màu xanh và 3 viên bi màu đỏ. Khi rút bi không hoàn lại, mỗi lần rút sẽ ảnh hưởng đến xác suất của các lần rút tiếp theo.
Lần rút đầu – xác suất rút được xanh: P(xanh₁) = 5/8
Lần rút thứ hai, biết lần đầu là xanh: P(xanh₂ | xanh₁) = 4/7
Ví dụ này bổ sung cho ví dụ bộ bài trước bằng cách nhấn mạnh sự phụ thuộc theo trình tự.
Ví dụ thực tế
Xét nghiệm y khoa: Đánh giá độ chính xác xét nghiệm
Các xét nghiệm y khoa là ứng dụng hoàn hảo của xác suất có điều kiện trong việc đánh giá độ chính xác của xét nghiệm. Với bất kỳ xét nghiệm chẩn đoán nào, ta cần hiểu bốn xác suất có điều kiện quan trọng:
- P(T+ | D+): Xác suất xét nghiệm dương tính khi bệnh nhân có bệnh (độ nhạy)
- P(T- | D-): Xác suất xét nghiệm âm tính khi bệnh nhân không có bệnh (độ đặc hiệu)
- P(T+ | D-): Xác suất xét nghiệm dương tính khi bệnh nhân không có bệnh (tỉ lệ dương tính giả)
- P(T- | D+): Xác suất xét nghiệm âm tính khi bệnh nhân có bệnh (tỉ lệ âm tính giả)
Khi đánh giá hiệu suất xét nghiệm, các chuyên gia y tế sử dụng những xác suất có điều kiện này để:
- So sánh độ chính xác xét nghiệm giữa các nhóm bệnh nhân khác nhau
- Xác định khi nào cần nhiều xét nghiệm
- Đặt ngưỡng phù hợp cho kết quả dương/âm tính
Ví dụ, nếu ta xét nghiệm 1000 bệnh nhân và nhận được 100 kết quả dương tính, ta có thể dùng các xác suất có điều kiện này để ước tính có bao nhiêu dương tính thật so với dương tính giả. Phân tích này giúp các chuyên gia y tế cân bằng rủi ro bỏ sót chẩn đoán với chi phí và lo âu do báo động giả.
Đánh giá rủi ro tài chính
Các công ty đầu tư sử dụng xác suất có điều kiện để đánh giá rủi ro thị trường. Hãy xét một nhà quản lý danh mục theo dõi biến động thị trường:
Biến động thị trường hàng ngày có thể ở mức Thấp (L), Trung bình (M), hoặc Cao (H).
Dữ liệu lịch sử cho thấy:
- P(H ngày mai | H hôm nay) = 0,70
- P(M ngày mai | H hôm nay) = 0,25
- P(L ngày mai | H hôm nay) = 0,05
Thông tin này giúp các nhà quản lý:
- Điều chỉnh phân bổ danh mục dựa trên điều kiện thị trường hiện tại
- Thiết lập ngưỡng rủi ro cho các hệ thống giao dịch tự động
- Phát triển kế hoạch dự phòng cho giai đoạn biến động cao kéo dài
Xác suất Có điều kiện và Định lý Bayes
Khám phá về xét nghiệm y khoa đã làm nổi bật một khác biệt quan trọng: Xác suất mắc bệnh khi xét nghiệm dương tính khác với xác suất xét nghiệm dương tính khi có bệnh. Định lý Bayes cung cấp khuôn khổ chính quy để xử lý mối quan hệ này, cho phép chúng ta cập nhật ước lượng xác suất khi xuất hiện bằng chứng mới.
Hiểu Định lý Bayes
Định lý Bayes biểu diễn mối quan hệ giữa hai xác suất có điều kiện: P(A|B) = [P(B|A) × P(A)] / P(B). Ta đọc phương trình như sau: "Xác suất của A khi biết B bằng xác suất của B khi biết A nhân với xác suất của A, chia cho xác suất của B".
Mỗi thành phần đóng một vai trò:
- P(A): Xác suất tiên nghiệm – niềm tin ban đầu của chúng ta về A trước khi thấy bằng chứng B
- P(B|A): Độ hợp lý (likelihood) – mức độ khả dĩ của bằng chứng B nếu A là đúng
- P(B): Tổng xác suất quan sát được bằng chứng B
- P(A|B): Xác suất hậu nghiệm – niềm tin cập nhật của chúng ta về A sau khi thấy bằng chứng B
Hãy xem điều này vận hành thế nào trong thực tế với kịch bản xét nghiệm y khoa của chúng ta, nay được mở rộng để thể hiện đầy đủ phân tích Bayes.
Một ví dụ xét nghiệm y khoa
Xét một tình trạng y khoa ảnh hưởng đến 2% dân số. Một xét nghiệm chẩn đoán mới có:
- Độ nhạy 95%: P(xét nghiệm dương | có bệnh) = 0,95
- Độ đặc hiệu 90%: P(xét nghiệm âm | không bệnh) = 0,90
Khi một bệnh nhân có kết quả dương tính, chúng ta nên cập nhật niềm tin về tình trạng của họ như thế nào?
Hãy giải từng bước:
- Xác suất tiên nghiệm (trước xét nghiệm): P(có bệnh) = 0,02 (tỉ lệ dân số 2%)
- Độ hợp lý của xét nghiệm dương khi có bệnh: P(dương|có bệnh) = 0,95 (độ nhạy của xét nghiệm)
- Tổng xác suất có xét nghiệm dương: P(dương) = P(dương|có bệnh) × P(có bệnh) + P(dương|không bệnh) × P(không bệnh) = 0,95 × 0,02 + 0,10 × 0,98 = 0,019 + 0,098 = 0,117
- Xác suất hậu nghiệm (dùng Định lý Bayes): P(có bệnh|dương) = [0,95 × 0,02] / 0,117 ≈ 0,162 hay 16,2%
Phân tích này cho thấy ngay cả với kết quả dương tính, xác suất mắc bệnh chỉ khoảng 16,2% – cao hơn nhiều so với 2% ban đầu, nhưng có lẽ thấp hơn trực giác của bạn.
Sức mạnh của cập nhật Bayes
Định lý Bayes tỏa sáng khi chúng ta nhận nhiều mảnh bằng chứng. Xác suất hậu nghiệm của mỗi lần tính trở thành xác suất tiên nghiệm cho lần cập nhật tiếp theo. Ví dụ, nếu bệnh nhân của chúng ta có xét nghiệm dương tính lần hai:
- Tiên nghiệm mới: P(có bệnh) = 0,162 (từ phép tính đầu tiên)
- Độ hợp lý: P(dương|có bệnh) = 0,95
- Tính hậu nghiệm mới...
Cách cập nhật tuần tự này cung cấp khuôn khổ toán học để đưa bằng chứng mới vào ước lượng xác suất của chúng ta. Điều đẹp đẽ của suy luận Bayes nằm ở khả năng định lượng cách niềm tin của chúng ta nên thay đổi khi tích lũy thông tin mới, cung cấp phương pháp chính quy để cập nhật xác suất dưới ánh sáng của bằng chứng.
Ứng dụng trong Khoa học Dữ liệu
Hãy xem xác suất có điều kiện xuất hiện trong khoa học dữ liệu như thế nào.
Mô hình dự đoán
Bộ phân loại Naive Bayes, một trong những công cụ đơn giản nhưng mạnh mẽ trong học máy, áp dụng Định lý Bayes để dự đoán nhãn dựa trên xác suất của các đặc trưng. Khi phân loại email là thư rác hay không, chẳng hạn, thuật toán tính xác suất có điều kiện của một email là thư rác khi biết các từ nó chứa. Dù đưa ra giả định “ngây thơ” rằng các đặc trưng độc lập, sự đơn giản hóa này thường hoạt động đáng ngạc nhiên trong thực tế.
Cây quyết định tiếp cận xác suất có điều kiện theo cách khác, phân tách dữ liệu dựa trên giá trị đặc trưng để tạo ra các tập con có điều kiện. Tại mỗi nút, cây đặt câu hỏi như "Xác suất của biến mục tiêu là gì khi biết giá trị đặc trưng cụ thể này?" Các phép chia tiếp tục cho đến khi đạt được các tập gần như thuần nhất, về bản chất tạo ra một bản đồ xác suất có điều kiện dẫn dắt dự đoán của chúng ta.
Quản trị rủi ro
Hệ thống chấm điểm tín dụng sử dụng các xác suất có điều kiện để đánh giá khả năng vỡ nợ của khoản vay khi biết các đặc điểm khách hàng khác nhau. Ví dụ, ngân hàng có thể tính xác suất vỡ nợ khi biết mức thu nhập, lịch sử tín dụng và tình trạng việc làm. Những phép tính này trở nên tinh vi hơn khi xét đến nhiều rủi ro phụ thuộc, như cách xác suất vỡ nợ thế chấp có thể thay đổi khi vừa có suy thoái vừa có lãi suất tăng. Mô hình rủi ro đầu tư sử dụng xác suất có điều kiện để ước lượng Giá trị rủi ro (VaR), tính xác suất các mức thua lỗ cụ thể khi biết điều kiện thị trường hiện tại. Các nhà quản lý danh mục dùng những xác suất này để điều chỉnh phân bổ tài sản, hiểu cách rủi ro của một khoản đầu tư có thể thay đổi khi biết hiệu suất của các khoản khác trong danh mục.
Học máy
Mạng Bayes là ứng dụng trực tiếp nhất của xác suất có điều kiện trong học máy, mô hình hóa mối quan hệ giữa các biến dưới dạng đồ thị có hướng, nơi trạng thái của mỗi nút phụ thuộc vào các nút cha của nó. Những mạng này xuất sắc ở các tác vụ như chẩn đoán y khoa, nơi xác suất của nhiều tình trạng phụ thuộc vào các triệu chứng và kết quả xét nghiệm liên thông.
Các mô hình đồ họa xác suất sử dụng các phụ thuộc có điều kiện để biểu diễn mối quan hệ phức tạp trong dữ liệu, khiến chúng có giá trị cho các tác vụ như nhận dạng ảnh và xử lý ngôn ngữ tự nhiên. Ngay cả các mô hình học sâu, tuy không rõ ràng là xác suất, cũng xuất ra các xác suất có điều kiện ở các lớp cuối khi phân loại. Hàm softmax, thường dùng trong mạng nơ-ron, biến đổi điểm số thô thành các xác suất có điều kiện, cho chúng ta biết khả năng của mỗi lớp có thể cho trước dữ liệu đầu vào.
Những Sai lầm và Hiểu lầm Phổ biến
Khi làm việc với xác suất có điều kiện, ba hiểu lầm chính thường dẫn đến kết luận sai.
- Ngụy biện đảo ngược, còn gọi là nhầm lẫn nghịch đảo, xảy ra khi ta trộn lẫn P(A|B) với P(B|A). Chúng ta đã thấy điều này trong ví dụ xét nghiệm y khoa – xác suất mắc bệnh khi xét nghiệm dương tính khác với xác suất xét nghiệm dương tính khi bạn có bệnh.
- Bỏ qua tỉ lệ gốc xảy ra khi ta tập trung vào các xác suất có điều kiện nhưng bỏ qua xác suất nền tảng của một sự kiện. Chẳng hạn, nếu một bệnh hiếm chỉ ảnh hưởng 1 trên 10.000 người, ngay cả một xét nghiệm rất chính xác cũng có thể tạo ra chủ yếu là dương tính giả chỉ vì bệnh quá hiếm.
- Sai lầm thứ ba liên quan đến cân nhắc bằng chứng không đúng khi cập nhật xác suất. Con người có xu hướng đánh giá quá cao bằng chứng mới hoặc kịch tính, trong khi đánh giá thấp thông tin nền ổn định. Trong giao dịch tài chính, ví dụ, nhà đầu tư có thể phản ứng thái quá với tin tức thị trường gần đây và bỏ qua các xác suất thị trường dài hạn.
Chủ đề Nâng cao và Những Lưu ý Tiếp theo
Cuối cùng, hãy xem một số ý tưởng phức tạp hơn xây dựng trên những gì chúng ta đã thực hành.
Điều kiện hóa trên các sự kiện có xác suất bằng không
Khi chuyển từ phân phối rời rạc sang liên tục, ta gặp một thách thức thú vị: các điểm cụ thể trong phân phối liên tục có xác suất bằng không. Hãy xét việc đo chính xác chiều cao của ai đó – trong khi ta có thể nói xác suất một người cao trong khoảng 170 đến 171 cm là có ý nghĩa, thì xác suất một người cao đúng 170,5432... cm về mặt kỹ thuật là bằng không. Tuy vậy ta thường muốn điều kiện hóa trên các phép đo chính xác như vậy. Xác suất có điều kiện chính quy cung cấp khuôn khổ toán học để xử lý các tình huống này, mở rộng các khái niệm cơ bản sang trường hợp liên tục thông qua hàm mật độ và lý thuyết đo. Sự mở rộng này cho phép ta hiểu những phát biểu như "phân phối xác suất của cân nặng một người, khi biết họ cao đúng 170,5 cm".
Xác suất có điều kiện một phần và các mở rộng
Điều kiện hóa Jeffrey mở rộng xác suất có điều kiện truyền thống cho các tình huống mà bằng chứng mới của chúng ta không chắc chắn mà đi kèm với xác suất riêng của nó. Không giống điều kiện hóa tiêu chuẩn, nơi ta giả định chắc chắn tuyệt đối về thông tin mới, quy tắc của Jeffrey cho phép cập nhật niềm tin dựa trên bằng chứng không chắc chắn. Điều này phù hợp hơn với thực tế, nơi thông tin mới thường đi kèm một mức độ bất định. Ví dụ, thay vì biết chắc xét nghiệm y khoa dương tính, ta có thể biết rằng khả năng dương tính là 80%. Quy tắc của Jeffrey cung cấp phương pháp chính quy để cập nhật xác suất trong những tình huống tinh tế hơn như vậy.
Kết luận
Xác suất có điều kiện cung cấp khuôn khổ toán học để cập nhật niềm tin khi xuất hiện thông tin mới. Xuyên suốt bài viết, chúng ta đã thấy khái niệm này áp dụng trong nhiều lĩnh vực, từ chẩn đoán y khoa đến đánh giá rủi ro tài chính. Những nguyên tắc đã khám phá giúp chúng ta hiểu cách xác suất thay đổi theo bằng chứng mới, từ đó đưa ra quyết định sáng suốt hơn trong các ứng dụng khoa học dữ liệu. Hiểu biết này đặc biệt giá trị khi làm việc với thuật toán phân loại, mô hình rủi ro và hệ thống học máy, nơi việc cập nhật xác suất diễn ra liên tục.
Khi bạn tiếp tục bồi đắp chuyên môn về xác suất và suy luận thống kê, một số khóa học có thể tăng cường hiểu biết của bạn về các khái niệm này theo lăng kính Bayes. Khóa Các Nền tảng Phân tích Dữ liệu Bayes bằng R giới thiệu các nguyên lý chủ chốt và ứng dụng thực tiễn, trong khi khóa Mô hình hóa Bayes với RJAGS cho thấy cách triển khai các khái niệm này bằng những công cụ thống kê mạnh mẽ. Với người dùng Python, khóa Phân tích Dữ liệu Bayes bằng Python mang đến trải nghiệm thực hành áp dụng các phương pháp này cho bài toán thực tế. Mỗi khóa đều cung cấp lộ trình để mở rộng kiến thức của bạn về xác suất và các ứng dụng của nó trong khoa học dữ liệu hiện đại.


Hãy tưởng tượng bạn đang phát triển một hệ thống phát hiện thư rác cho email. Ban đầu, bạn có thể gắn cờ một email là đáng ngờ nếu nó chứa một số từ khóa nhất định. Nhưng điều gì nếu bạn phát hiện email này đến từ một người gửi đáng tin cậy? Hoặc nó được gửi vào một giờ bất thường? Mỗi mảnh thông tin mới đều làm thay đổi xác suất email là thư rác. Việc cập nhật động các xác suất dựa trên bằng chứng mới chính là cốt lõi của xác suất có điều kiện, một khái niệm cung cấp năng lượng cho nhiều ứng dụng khoa học dữ liệu hiện đại, từ lọc email đến phát hiện gian lận.
Với những ai mới bắt đầu làm quen với các khái niệm xác suất, Cheat Sheet Giới thiệu Quy tắc Xác suất cung cấp tài liệu tham khảo hữu ích về các nguyên tắc và công thức cốt lõi. Khóa học Giới thiệu về Thống kê xây dựng nền tảng vững chắc bằng cách khám phá các phân phối xác suất và thuộc tính của chúng, là cơ sở để hiểu cách xác suất có điều kiện vận hành trong thực tế. Những tài nguyên này mang đến lộ trình có cấu trúc để phát triển nền tảng vững chắc cho các khái niệm chúng ta sẽ tìm hiểu trong bài viết này.
Xác suất có điều kiện là gì?
Xác suất có điều kiện đo lường mức độ khả dĩ của một sự kiện khi ta biết rằng một sự kiện khác đã xảy ra. Khi nhận được thông tin mới về một sự kiện, chúng ta điều chỉnh các phép tính xác suất cho phù hợp.
Để hiểu khái niệm này, hãy xét ví dụ với bộ bài tây. Khi bạn rút một lá từ một bộ bài tiêu chuẩn, có 52 kết quả có thể. Nếu bạn muốn rút một lá vua (King), xác suất ban đầu là 4/52 (khoảng 7,7%) vì có bốn lá vua trong bộ. Nhưng nếu ai đó nói rằng lá bạn rút là lá hình (face card)? Thông tin mới này thay đổi mọi thứ – xác suất có lá vua giờ cao hơn nhiều, 4/12 (khoảng 33,3%), vì tổng cộng chỉ có mười hai lá hình.
Mối quan hệ giữa các xác suất này có một định nghĩa toán học chính xác:
Công thức này giúp chúng ta tính xác suất có điều kiện, trong đó:
Trong ví dụ bộ bài:
Để hiểu rõ hơn cách xác suất có điều kiện vận hành trong thực tế, ta có thể dùng sơ đồ cây. Sơ đồ cây đặc biệt hữu ích vì chúng cho thấy cách mỗi mảnh thông tin mới thay đổi xác suất của chúng ta:
Hãy cùng đi qua cách sơ đồ cây này hoạt động:
Sơ đồ cây giúp chúng ta hiểu một số khái niệm then chốt trong xác suất có điều kiện:
Điều hay của xác suất có điều kiện là nó cho phép chúng ta cập nhật xác suất khi có thêm thông tin. Cũng như ta đã điều chỉnh xác suất có lá vua từ 7,7% lên 33,3% khi biết đó là lá hình, xác suất có điều kiện cho ta một cách thức chính quy để tính lại xác suất dựa trên bằng chứng mới.
Công thức Xác suất Có điều kiện
Cấu trúc toán học của xác suất có điều kiện cung cấp cho chúng ta các công cụ để phân tích những kịch bản phức tạp liên quan đến nhiều sự kiện. Hãy cùng xem các tính chất chính.
Các tính chất then chốt của xác suất có điều kiện
Những tính chất toán học này giúp chúng ta giải các bài toán phức tạp hiệu quả hơn:
1. Tính độc lập
Khi hai sự kiện A và B độc lập, ta biết rằng việc một sự kiện xảy ra không ảnh hưởng đến xác suất của sự kiện kia. Về mặt toán học: P(A|B) = P(A), đọc là: "xác suất của A khi biết B bằng xác suất của A".
Ví dụ, nếu ta tung một con xúc xắc và tung một đồng xu, ra mặt ngửa trên đồng xu không làm thay đổi xác suất ra số sáu. Công thức cho thấy: P(Six|Heads) = P(Six) = 1/6
2. Quy tắc bù
Với bất kỳ sự kiện A khi có điều kiện B, tổng xác suất của A và phần bù của nó A' (đọc là "A phảy") phải bằng 1. Về mặt toán học: P(A|B) + P(A'|B) = 1, đọc là: “Xác suất của A khi biết B cộng với xác suất của phần bù A khi biết B bằng 1.”
Trong ví dụ bộ bài trước đó: P(King|Face Card) + P(Not King|Face Card) = 4/12 + 8/12 = 1
Quy tắc nhân và quy tắc dây chuyền
Quy tắc nhân liên kết xác suất đồng thời với xác suất có điều kiện: P(A ∩ B) = P(A|B) × P(B). Ta đọc là: "Xác suất A giao B bằng xác suất A khi biết B nhân với xác suất B".
Điều này mở rộng cho nhiều sự kiện thông qua quy tắc dây chuyền. Với ba sự kiện A, B và C: P(A ∩ B ∩ C) = P(A|B ∩ C) × P(B|C) × P(C). Tức là: "Xác suất A giao B giao C bằng xác suất A khi biết B giao C nhân với xác suất B khi biết C nhân với xác suất C".
Hãy xem điều này vận hành ra sao với một chuỗi rút bài:
P(K ∩ Q ∩ A) = P(A|K ∩ Q) × P(Q|K) × P(K) = (4/50) × (4/51) × (4/52)
Quy tắc dây chuyền đặc biệt hữu ích trong học máy, nhất là trong các mạng Bayes nơi chúng ta cần mô hình hóa sự phụ thuộc phức tạp giữa nhiều biến. Khi phân tích dữ liệu, ta thường gặp những tình huống các sự kiện diễn tiến theo trình tự tự nhiên, và quy tắc dây chuyền giúp phân rã những kịch bản phức tạp này thành các phép tính đơn giản, dễ xử lý hơn.
Ví dụ Minh họa Xác suất Có điều kiện
Hãy điểm lại hai ví dụ phổ biến nhất và cũng nghĩ xem xác suất có điều kiện có thể xuất hiện trong công việc của bạn như thế nào.
Ví dụ kinh điển
Hai ví dụ này rất phổ biến và đáng để học kỹ, đặc biệt nếu bạn đang phỏng vấn:
Tung xúc xắc: Hiểu không gian mẫu bị thu hẹp
Khi tung một con xúc xắc, không gian mẫu của chúng ta bắt đầu với sáu khả năng: {1, 2, 3, 4, 5, 6}. Khi biết một phần thông tin về lần tung, các phép tính xác suất của ta thay đổi theo một cách cụ thể. Cùng xem:
Xác suất ban đầu ra 6: P(6) = 1/6
Nếu ta biết kết quả là số chẵn, không gian mẫu thu hẹp còn {2, 4, 6}: P(6 | chẵn) = 1/3
Bi ve: Phụ thuộc theo trình tự
Một túi chứa 5 viên bi màu xanh và 3 viên bi màu đỏ. Khi rút bi không hoàn lại, mỗi lần rút sẽ ảnh hưởng đến xác suất của các lần rút tiếp theo.
Lần rút đầu – xác suất rút được xanh: P(xanh₁) = 5/8
Lần rút thứ hai, biết lần đầu là xanh: P(xanh₂ | xanh₁) = 4/7
Ví dụ này bổ sung cho ví dụ bộ bài trước bằng cách nhấn mạnh sự phụ thuộc theo trình tự.
Ví dụ thực tế
Xét nghiệm y khoa: Đánh giá độ chính xác xét nghiệm
Các xét nghiệm y khoa là ứng dụng hoàn hảo của xác suất có điều kiện trong việc đánh giá độ chính xác của xét nghiệm. Với bất kỳ xét nghiệm chẩn đoán nào, ta cần hiểu bốn xác suất có điều kiện quan trọng:
Khi đánh giá hiệu suất xét nghiệm, các chuyên gia y tế sử dụng những xác suất có điều kiện này để:
Ví dụ, nếu ta xét nghiệm 1000 bệnh nhân và nhận được 100 kết quả dương tính, ta có thể dùng các xác suất có điều kiện này để ước tính có bao nhiêu dương tính thật so với dương tính giả. Phân tích này giúp các chuyên gia y tế cân bằng rủi ro bỏ sót chẩn đoán với chi phí và lo âu do báo động giả.
Đánh giá rủi ro tài chính
Các công ty đầu tư sử dụng xác suất có điều kiện để đánh giá rủi ro thị trường. Hãy xét một nhà quản lý danh mục theo dõi biến động thị trường:
Biến động thị trường hàng ngày có thể ở mức Thấp (L), Trung bình (M), hoặc Cao (H).
Dữ liệu lịch sử cho thấy:
Thông tin này giúp các nhà quản lý:
Xác suất Có điều kiện và Định lý Bayes
Khám phá về xét nghiệm y khoa đã làm nổi bật một khác biệt quan trọng: Xác suất mắc bệnh khi xét nghiệm dương tính khác với xác suất xét nghiệm dương tính khi có bệnh. Định lý Bayes cung cấp khuôn khổ chính quy để xử lý mối quan hệ này, cho phép chúng ta cập nhật ước lượng xác suất khi xuất hiện bằng chứng mới.
Hiểu Định lý Bayes
Định lý Bayes biểu diễn mối quan hệ giữa hai xác suất có điều kiện: P(A|B) = [P(B|A) × P(A)] / P(B). Ta đọc phương trình như sau: "Xác suất của A khi biết B bằng xác suất của B khi biết A nhân với xác suất của A, chia cho xác suất của B".
Mỗi thành phần đóng một vai trò:
Hãy xem điều này vận hành thế nào trong thực tế với kịch bản xét nghiệm y khoa của chúng ta, nay được mở rộng để thể hiện đầy đủ phân tích Bayes.
Một ví dụ xét nghiệm y khoa
Xét một tình trạng y khoa ảnh hưởng đến 2% dân số. Một xét nghiệm chẩn đoán mới có:
Khi một bệnh nhân có kết quả dương tính, chúng ta nên cập nhật niềm tin về tình trạng của họ như thế nào?
Hãy giải từng bước:
Phân tích này cho thấy ngay cả với kết quả dương tính, xác suất mắc bệnh chỉ khoảng 16,2% – cao hơn nhiều so với 2% ban đầu, nhưng có lẽ thấp hơn trực giác của bạn.
Sức mạnh của cập nhật Bayes
Định lý Bayes tỏa sáng khi chúng ta nhận nhiều mảnh bằng chứng. Xác suất hậu nghiệm của mỗi lần tính trở thành xác suất tiên nghiệm cho lần cập nhật tiếp theo. Ví dụ, nếu bệnh nhân của chúng ta có xét nghiệm dương tính lần hai:
Cách cập nhật tuần tự này cung cấp khuôn khổ toán học để đưa bằng chứng mới vào ước lượng xác suất của chúng ta. Điều đẹp đẽ của suy luận Bayes nằm ở khả năng định lượng cách niềm tin của chúng ta nên thay đổi khi tích lũy thông tin mới, cung cấp phương pháp chính quy để cập nhật xác suất dưới ánh sáng của bằng chứng.
Ứng dụng trong Khoa học Dữ liệu
Hãy xem xác suất có điều kiện xuất hiện trong khoa học dữ liệu như thế nào.
Mô hình dự đoán
Bộ phân loại Naive Bayes, một trong những công cụ đơn giản nhưng mạnh mẽ trong học máy, áp dụng Định lý Bayes để dự đoán nhãn dựa trên xác suất của các đặc trưng. Khi phân loại email là thư rác hay không, chẳng hạn, thuật toán tính xác suất có điều kiện của một email là thư rác khi biết các từ nó chứa. Dù đưa ra giả định “ngây thơ” rằng các đặc trưng độc lập, sự đơn giản hóa này thường hoạt động đáng ngạc nhiên trong thực tế.
Cây quyết định tiếp cận xác suất có điều kiện theo cách khác, phân tách dữ liệu dựa trên giá trị đặc trưng để tạo ra các tập con có điều kiện. Tại mỗi nút, cây đặt câu hỏi như "Xác suất của biến mục tiêu là gì khi biết giá trị đặc trưng cụ thể này?" Các phép chia tiếp tục cho đến khi đạt được các tập gần như thuần nhất, về bản chất tạo ra một bản đồ xác suất có điều kiện dẫn dắt dự đoán của chúng ta.
Quản trị rủi ro
Hệ thống chấm điểm tín dụng sử dụng các xác suất có điều kiện để đánh giá khả năng vỡ nợ của khoản vay khi biết các đặc điểm khách hàng khác nhau. Ví dụ, ngân hàng có thể tính xác suất vỡ nợ khi biết mức thu nhập, lịch sử tín dụng và tình trạng việc làm. Những phép tính này trở nên tinh vi hơn khi xét đến nhiều rủi ro phụ thuộc, như cách xác suất vỡ nợ thế chấp có thể thay đổi khi vừa có suy thoái vừa có lãi suất tăng. Mô hình rủi ro đầu tư sử dụng xác suất có điều kiện để ước lượng Giá trị rủi ro (VaR), tính xác suất các mức thua lỗ cụ thể khi biết điều kiện thị trường hiện tại. Các nhà quản lý danh mục dùng những xác suất này để điều chỉnh phân bổ tài sản, hiểu cách rủi ro của một khoản đầu tư có thể thay đổi khi biết hiệu suất của các khoản khác trong danh mục.
Học máy
Mạng Bayes là ứng dụng trực tiếp nhất của xác suất có điều kiện trong học máy, mô hình hóa mối quan hệ giữa các biến dưới dạng đồ thị có hướng, nơi trạng thái của mỗi nút phụ thuộc vào các nút cha của nó. Những mạng này xuất sắc ở các tác vụ như chẩn đoán y khoa, nơi xác suất của nhiều tình trạng phụ thuộc vào các triệu chứng và kết quả xét nghiệm liên thông.
Các mô hình đồ họa xác suất sử dụng các phụ thuộc có điều kiện để biểu diễn mối quan hệ phức tạp trong dữ liệu, khiến chúng có giá trị cho các tác vụ như nhận dạng ảnh và xử lý ngôn ngữ tự nhiên. Ngay cả các mô hình học sâu, tuy không rõ ràng là xác suất, cũng xuất ra các xác suất có điều kiện ở các lớp cuối khi phân loại. Hàm softmax, thường dùng trong mạng nơ-ron, biến đổi điểm số thô thành các xác suất có điều kiện, cho chúng ta biết khả năng của mỗi lớp có thể cho trước dữ liệu đầu vào.
Những Sai lầm và Hiểu lầm Phổ biến
Khi làm việc với xác suất có điều kiện, ba hiểu lầm chính thường dẫn đến kết luận sai.
Chủ đề Nâng cao và Những Lưu ý Tiếp theo
Cuối cùng, hãy xem một số ý tưởng phức tạp hơn xây dựng trên những gì chúng ta đã thực hành.
Điều kiện hóa trên các sự kiện có xác suất bằng không
Khi chuyển từ phân phối rời rạc sang liên tục, ta gặp một thách thức thú vị: các điểm cụ thể trong phân phối liên tục có xác suất bằng không. Hãy xét việc đo chính xác chiều cao của ai đó – trong khi ta có thể nói xác suất một người cao trong khoảng 170 đến 171 cm là có ý nghĩa, thì xác suất một người cao đúng 170,5432... cm về mặt kỹ thuật là bằng không. Tuy vậy ta thường muốn điều kiện hóa trên các phép đo chính xác như vậy. Xác suất có điều kiện chính quy cung cấp khuôn khổ toán học để xử lý các tình huống này, mở rộng các khái niệm cơ bản sang trường hợp liên tục thông qua hàm mật độ và lý thuyết đo. Sự mở rộng này cho phép ta hiểu những phát biểu như "phân phối xác suất của cân nặng một người, khi biết họ cao đúng 170,5 cm".
Xác suất có điều kiện một phần và các mở rộng
Điều kiện hóa Jeffrey mở rộng xác suất có điều kiện truyền thống cho các tình huống mà bằng chứng mới của chúng ta không chắc chắn mà đi kèm với xác suất riêng của nó. Không giống điều kiện hóa tiêu chuẩn, nơi ta giả định chắc chắn tuyệt đối về thông tin mới, quy tắc của Jeffrey cho phép cập nhật niềm tin dựa trên bằng chứng không chắc chắn. Điều này phù hợp hơn với thực tế, nơi thông tin mới thường đi kèm một mức độ bất định. Ví dụ, thay vì biết chắc xét nghiệm y khoa dương tính, ta có thể biết rằng khả năng dương tính là 80%. Quy tắc của Jeffrey cung cấp phương pháp chính quy để cập nhật xác suất trong những tình huống tinh tế hơn như vậy.
Kết luận
Xác suất có điều kiện cung cấp khuôn khổ toán học để cập nhật niềm tin khi xuất hiện thông tin mới. Xuyên suốt bài viết, chúng ta đã thấy khái niệm này áp dụng trong nhiều lĩnh vực, từ chẩn đoán y khoa đến đánh giá rủi ro tài chính. Những nguyên tắc đã khám phá giúp chúng ta hiểu cách xác suất thay đổi theo bằng chứng mới, từ đó đưa ra quyết định sáng suốt hơn trong các ứng dụng khoa học dữ liệu. Hiểu biết này đặc biệt giá trị khi làm việc với thuật toán phân loại, mô hình rủi ro và hệ thống học máy, nơi việc cập nhật xác suất diễn ra liên tục.
Khi bạn tiếp tục bồi đắp chuyên môn về xác suất và suy luận thống kê, một số khóa học có thể tăng cường hiểu biết của bạn về các khái niệm này theo lăng kính Bayes. Khóa Các Nền tảng Phân tích Dữ liệu Bayes bằng R giới thiệu các nguyên lý chủ chốt và ứng dụng thực tiễn, trong khi khóa Mô hình hóa Bayes với RJAGS cho thấy cách triển khai các khái niệm này bằng những công cụ thống kê mạnh mẽ. Với người dùng Python, khóa Phân tích Dữ liệu Bayes bằng Python mang đến trải nghiệm thực hành áp dụng các phương pháp này cho bài toán thực tế. Mỗi khóa đều cung cấp lộ trình để mở rộng kiến thức của bạn về xác suất và các ứng dụng của nó trong khoa học dữ liệu hiện đại.