

Immagina di muoverti in un labirinto. A ogni passo, devi prendere una decisione che ti porta più vicino all’uscita o più nel profondo. Questo è simile a un algoritmo ad albero decisionale, un metodo di machine learning potente e intuitivo che ci aiuta a dare un senso a dati complessi e a scegliere la strada migliore.
Un algoritmo ad albero decisionale suddivide un dataset in sottoinsiemi sempre più piccoli in base a determinate condizioni. Come un albero con rami e foglie, parte da un singolo nodo radice e si espande in più rami, ciascuno dei quali rappresenta una decisione basata sul valore di una caratteristica. Le foglie finali dell’albero sono i possibili risultati o previsioni.
In questo articolo ti introdurremo al mondo degli alberi decisionali usando il linguaggio R. Tratteremo le basi, approfondiremo i tipi più diffusi di algoritmi ad albero decisionale, esploreremo i metodi basati su alberi e ti guideremo con un esempio passo dopo passo. Alla fine, sarai in grado di sfruttare la potenza degli alberi decisionali per prendere decisioni migliori guidate dai dati.
Che cos’è un albero decisionale nel Machine Learning?
Gli alberi decisionali sono speciali nel machine learning per la loro semplicità, interpretabilità e versatilità.
Si tratta di un algoritmo di apprendimento supervisionato che può essere utilizzato sia per problemi di regressione (previsione di valori continui) sia di classificazione (previsione di valori categoriali). Inoltre, sono la base per tecniche più avanzate, come bagging, boosting e random forest.
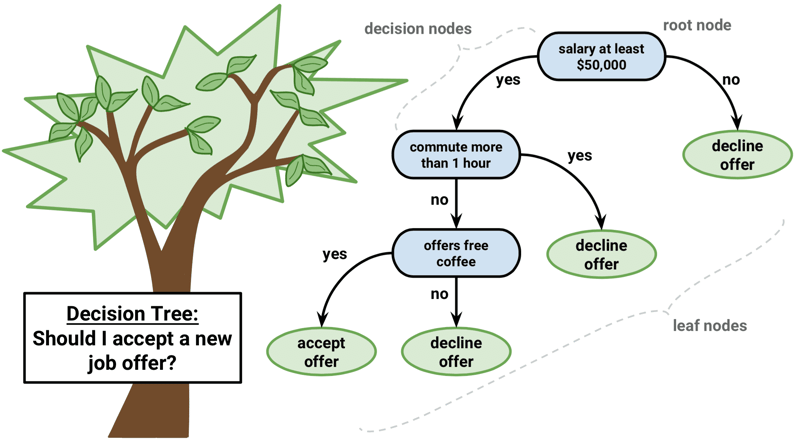
Il diagramma qui sotto illustra la terminologia alla base degli alberi decisionali:
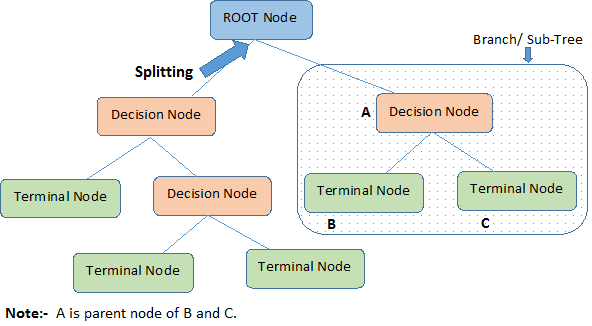
Un albero decisionale inizia con un nodo radice che rappresenta l’intera popolazione o il campione, che poi viene suddiviso in due o più gruppi omogenei tramite un metodo chiamato splitting. Quando i sotto-nodi subiscono ulteriori divisioni, vengono identificati come nodi decisionali, mentre quelli che non si dividono sono chiamati nodi terminali o foglie. Un segmento di un albero completo è detto ramo.
Abbiamo stabilito che gli alberi decisionali possono essere utilizzati sia per regressione che per classificazione; capiamo quindi l’algoritmo dietro i tipi di alberi decisionali.
Tipi popolari di algoritmi ad albero decisionale
Comprendiamo in modo intuitivo sia gli alberi di regressione che quelli di classificazione, cosa hanno in comune e cosa li distingue, e le funzioni di errore.
Alberi di regressione
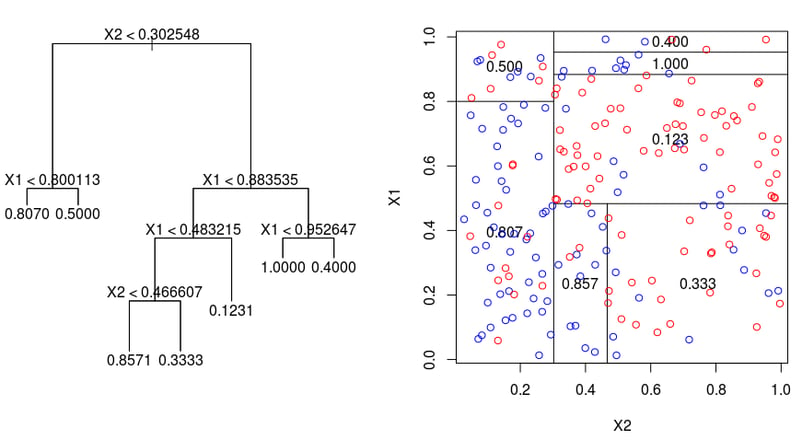
Guardiamo l’immagine qui sotto, che aiuta a visualizzare la natura della partizione effettuata da un Regression Tree. Mostra un albero non potato e un albero di regressione adattato a un dataset casuale. Entrambe le visualizzazioni mostrano una serie di regole di splitting, a partire dalla cima dell’albero. Nota che ogni split del dominio è allineato con uno degli assi delle feature. Il concetto di split paralleli agli assi si generalizza in modo diretto a dimensioni maggiori di due. Per uno spazio delle feature di dimensione $p$, un sottoinsieme di $\mathbb{R}^p$, lo spazio è diviso in $M$ regioni, $R_{m}$, ciascuna delle quali è un "iperblocco" $p$-dimensionale.
Per costruire un albero di regressione, prima si usa il recursive binary splitting per far crescere un albero grande sui dati di training, fermandosi solo quando ogni nodo terminale ha meno di un numero minimo di osservazioni. Il Recursive Binary Splitting è un algoritmo greedy e top-down usato per minimizzare il Residual Sum of Squares (RSS), una misura di errore usata anche nei contesti di regressione lineare. L’RSS, nel caso di uno spazio delle feature partizionato in M partizioni, è dato da:
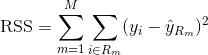
Partendo dalla cima dell’albero, lo dividi in 2 rami, creando una partizione in 2 spazi. Esegui poi questo specifico split in cima all’albero più volte e scegli lo split delle feature che minimizza l’RSS (corrente).
Successivamente, applichi il cost complexity pruning all’albero grande per ottenere una sequenza dei migliori sottoalberi, in funzione di $\alpha$. L’idea di base è introdurre un ulteriore parametro di tuning, indicato con $\alpha$, che bilancia la profondità dell’albero e la sua bontà di adattamento ai dati di training.
Puoi usare la validazione incrociata K-fold per scegliere $\alpha$. Questa tecnica prevede semplicemente di suddividere le osservazioni di training in K fold per stimare il tasso di errore di test dei sottoalberi. Il tuo obiettivo è selezionare quello che porta al tasso d’errore più basso.
Alberi di classificazione
Un albero di classificazione è molto simile a un albero di regressione, tranne per il fatto che viene usato per prevedere una risposta qualitativa piuttosto che quantitativa.
Ricorda che, per un albero di regressione, la risposta predetta per un’osservazione è data dalla media delle risposte delle osservazioni di training che appartengono allo stesso nodo terminale. Al contrario, per un albero di classificazione, prevedi che ogni osservazione appartenga alla classe più frequente tra le osservazioni di training nella regione a cui appartiene.
Nell’interpretare i risultati di un albero di classificazione, spesso ti interessa non solo la previsione di classe corrispondente a una particolare regione di nodo terminale, ma anche le proporzioni di classe tra le osservazioni di training che ricadono in quella regione.
Il compito di far crescere un albero di classificazione è piuttosto simile a quello di far crescere un albero di regressione. Come nell’impostazione di regressione, usi il recursive binary splitting per far crescere un albero di classificazione. Tuttavia, nell’impostazione di classificazione, il Residual Sum of Squares non può essere usato come criterio per effettuare gli split binari. Invece, puoi usare uno di questi 3 metodi:
- Classification Error Rate: Anziché vedere quanto una risposta numerica si discosta dal valore medio, come nell’impostazione di regressione, puoi definire il "tasso di errore" come la frazione di osservazioni di training in una particolare regione che non appartengono alla classe più frequente. L’errore è dato da questa equazione:
E = 1 - argmaxc($\hat{\pi}_{mc}$)
in cui $\hat{\pi}_{mc}$ rappresenta la frazione di dati di training nella regione Rm che appartengono alla classe c.
- Indice di Gini: L’indice di Gini è una metrica di errore alternativa progettata per mostrare quanto è "pura" una regione. "Purezza" in questo caso significa quanto dei dati di training in una particolare regione appartiene a una singola classe. Se una regione Rm contiene dati per lo più di una sola classe c, allora il valore dell’indice di Gini sarà piccolo:
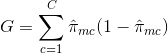
- Cross-Entropy: Una terza alternativa, simile all’indice di Gini, è nota come Cross-Entropy o Devianza:
La cross-entropy assume un valore vicino a zero se i $\hat{\pi}_{mc}$ sono tutti vicini a 0 o a 1. Pertanto, come l’indice di Gini, la cross-entropy assume un valore piccolo se l’m-esimo nodo è puro. In effetti, risulta che indice di Gini e cross-entropy sono numericamente piuttosto simili.
Nella costruzione di un albero di classificazione, in genere si utilizza l’indice di Gini o la cross-entropy per valutare la qualità di uno specifico split, poiché sono più sensibili alla purezza del nodo rispetto al tasso di errore di classificazione. Qualsiasi di questi 3 approcci può essere utilizzato nella potatura dell’albero, ma il tasso di errore di classificazione è preferibile se l’obiettivo è l’accuratezza predittiva dell’albero potato finale.
Vantaggi e svantaggi degli alberi decisionali
Per quanto vogliamo capire l’algoritmo e i suoi punti di forza, è fondamentale comprenderne anche i limiti. La verità è che gli alberi decisionali non sono la scelta migliore per tutti i tipi di problemi di machine learning, così come accade per qualsiasi algoritmo di machine learning.
Ecco vantaggi e svantaggi:
Vantaggi
- Facili da capire e interpretare. Gli alberi decisionali sono molto intuitivi e facilmente visualizzabili. La loro struttura gerarchica ricorda il processo decisionale umano, rendendoli accessibili anche ai non esperti. Questa interpretabilità è cruciale quando comprendere il processo decisionale è importante quanto la previsione stessa.
- Gestiscono sia variabili continue che categoriali. Gli alberi decisionali sono versatili e possono gestire dataset con un mix di feature continue e categoriali, oltre a variabili target di entrambi i tipi. Questa flessibilità consente di applicarli a un’ampia gamma di problemi.
- Richiedono un preprocessing minimo dei dati. Gli alberi decisionali non richiedono scaling o normalizzazione delle feature, poiché sono invarianti a trasformazioni monotone. Gestiscono facilmente valori mancanti e outlier, risultando adatti a dati grezzi e rumorosi.
- Utili per la selezione delle feature e l’identificazione delle variabili importanti. Gli alberi decisionali eseguono naturalmente la selezione delle feature scegliendo le più informative per suddividere i dati. L’importanza di una feature può essere inferita da quanto presto compare nell’albero e da quante volte viene utilizzata per gli split.
Svantaggi
- Soggetti a overfitting. Gli alberi decisionali possono diventare eccessivamente complessi quando crescono in profondità, portando a overfitting sui dati di training. Questo si traduce in scarsa generalizzazione su dati non visti. Tecniche come la potatura o l’impostazione di una profondità massima possono aiutare a mitigare il problema.
- Sensibili a piccole variazioni nei dati. Una piccola modifica nei dati di training può portare a una struttura dell’albero completamente diversa, rendendo gli alberi instabili. Questa sensibilità può essere ridotta con metodi ensemble, come bagging, boosting o random forest, che costruiscono più alberi e ne aggregano i risultati.
- Spesso meno accurati di altri metodi di machine learning. A causa della loro semplicità e della natura greedy della costruzione, gli alberi decisionali non sempre producono i modelli più accurati. Possono però essere un ottimo punto di partenza o un modello baseline per il confronto con metodi più sofisticati.
- Bias verso le classi dominanti. Gli alberi decisionali possono essere sbilanciati verso la classe maggioritaria in dataset squilibrati, portando a split subottimali e a misclassificazioni delle istanze minoritarie. Tecniche come oversampling, undersampling o l’uso di apprendimento sensibile al costo possono aiutare ad affrontare il problema.
Nonostante questi svantaggi, gli alberi decisionali restano una scelta popolare in molte applicazioni grazie a semplicità, interpretabilità e versatilità.
Algoritmi avanzati di machine learning basati su alberi
Esploriamo i metodi ensemble basati su alberi che sfruttano i punti di forza degli alberi decisionali affrontandone alcune limitazioni: bagging, boosting e random forest.
Bagging
Gli alberi decisionali discussi sopra soffrono di alta varianza, cioè se dividi casualmente i dati di training in 2 parti e adatti un albero decisionale a entrambe le metà, i risultati potrebbero essere molto diversi. Al contrario, una procedura con bassa varianza fornirà risultati simili se applicata ripetutamente a dataset distinti.
Bagging, o bootstrap aggregation, è una tecnica usata per ridurre la varianza delle previsioni combinando il risultato di più classificatori addestrati su diversi sotto-campioni dello stesso dataset. Ecco l’equazione del bagging:
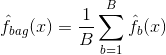
in cui generi $B$ diversi dataset di training bootstrap. Alleni quindi il tuo metodo sul $b$-esimo training set bootstrap per ottenere $\hat{f}_{b}(x)$ e infine medi le previsioni.
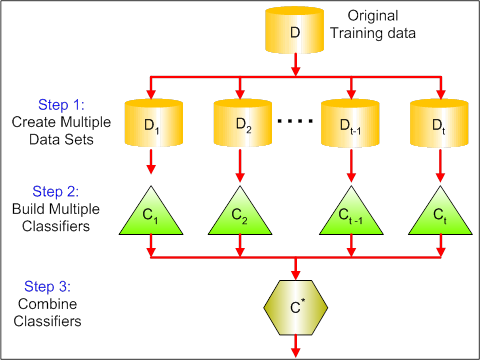
La visualizzazione seguente mostra i 3 passaggi del bagging:
-
Passaggio 1: Sostituisci i dati originali con nuovi dati. I nuovi dati hanno di solito una frazione delle colonne e delle righe dei dati originali, che poi possono essere usate come iperparametri nel modello di bagging.
-
Passaggio 2: Costruisci classificatori su ciascun dataset. In genere, puoi usare lo stesso classificatore per creare modelli e previsioni.
-
Passaggio 3: Infine, utilizzi un valore medio per combinare le previsioni di tutti i classificatori, a seconda del problema. In generale, questi valori combinati sono più robusti di un singolo modello.
Sebbene il bagging possa migliorare le previsioni per molti metodi di regressione e classificazione, è particolarmente utile per gli alberi decisionali. Per applicare il bagging ad alberi di regressione/classificazione, costruisci semplicemente $B$ alberi di regressione/classificazione usando $B$ training set bootstrap e medi le previsioni risultanti. Questi alberi crescono in profondità e non vengono potati. Quindi ogni singolo albero ha alta varianza ma basso bias. La media di questi $B$ alberi riduce la varianza.
In generale, il bagging ha dimostrato di fornire notevoli miglioramenti in accuratezza combinando centinaia o anche migliaia di alberi in un’unica procedura.
Random forest
Random forest è un metodo di machine learning versatile, in grado di eseguire sia compiti di regressione che di classificazione. Si occupa anche di riduzione della dimensionalità, gestisce valori mancanti, outlier e altri passaggi essenziali dell’esplorazione dei dati, e se la cava piuttosto bene.
Le random forest migliorano gli alberi bagging con una piccola modifica che de-correlaziona gli alberi. Come nel bagging, costruisci più alberi decisionali su campioni di training bootstrap. Ma nella costruzione di questi alberi, ogni volta che si considera uno split, viene scelta una selezione casuale di m predittori come candidati allo split dall’insieme completo di $p$ predittori. Lo split può usare solo uno di questi $m$ predittori. Questa è la principale differenza tra random forest e bagging; nel bagging, infatti, la scelta del predittore è $m = p$.
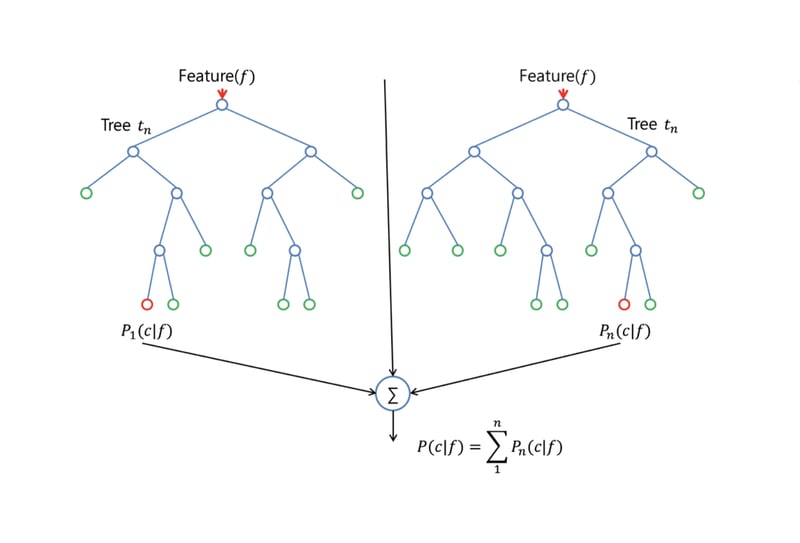
Per far crescere una random forest, dovresti:
-
Supporre innanzitutto che il numero di casi nel training set sia K. Quindi, prelevare un campione casuale di questi K casi e usare questo campione come training set per far crescere l’albero.
-
Se ci sono $p$ variabili in input, specificare un numero $m < p$ tale che a ogni nodo tu possa selezionare $m$ variabili casuali tra le $p$. Il miglior split su queste $m$ viene usato per dividere il nodo.
-
Ciascun albero viene poi fatto crescere il più possibile e non è necessaria alcuna potatura.
-
Infine, aggrega le previsioni degli alberi per prevedere i nuovi dati.
Le random forest sono molto efficaci nel stimare dati mancanti e nel mantenere l’accuratezza quando una grande proporzione di dati manca. Possono anche bilanciare gli errori in dataset con classi sbilanciate. Soprattutto, gestiscono dataset enormi con grande dimensionalità. Tuttavia, uno svantaggio dell’uso delle random forest è che potresti facilmente overfittare dataset rumorosi, specialmente nei casi di regressione.
Boosting
Boosting è un altro approccio per migliorare le previsioni ottenute da un albero decisionale. Come bagging e random forest, è un approccio generale applicabile a molti metodi di apprendimento statistico per regressione o classificazione. Ricorda che il bagging prevede la creazione di più copie del dataset di training originale usando il bootstrap, l’adattamento di un albero decisionale separato su ciascuna copia e la combinazione di tutti gli alberi per creare un unico modello predittivo. In particolare, ogni albero è costruito su un dataset bootstrap, indipendente dagli altri alberi.
Il boosting funziona in modo simile, tranne per il fatto che gli alberi crescono in sequenza: ogni albero viene fatto crescere utilizzando informazioni dagli alberi cresciuti in precedenza. Il boosting non prevede campionamento bootstrap; ogni albero è invece adattato su una versione modificata del dataset originale.
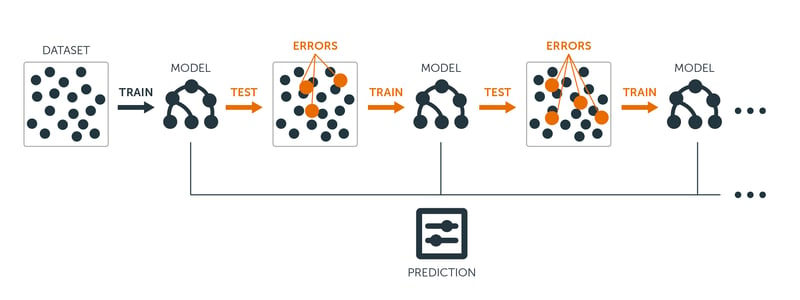
Per alberi di regressione e classificazione, il boosting funziona così:
-
A differenza dell’adattare un singolo grande albero decisionale ai dati, che equivale a forzare l’adattamento e potenzialmente overfittare, il boosting impara lentamente.
-
Dato il modello corrente, adatti un albero decisionale ai residui del modello. Cioè, adatti un albero usando i residui correnti, invece dell’outcome $Y$, come risposta.
-
Poi aggiungi questo nuovo albero decisionale alla funzione adattata per aggiornare i residui. Ciascuno di questi alberi può essere piuttosto piccolo, con poche foglie, determinate dal parametro $d$ nell’algoritmo. Adattando piccoli alberi ai residui, migliori lentamente $\hat{f}$ nelle aree in cui non va bene.
-
Il parametro di shrinkage $\nu$ rallenta ulteriormente il processo, permettendo a più alberi, di forme diverse, di “attaccare” i residui.
Il boosting è molto utile quando hai molti dati e ti aspetti alberi decisionali molto complessi. È stato usato per risolvere molti problemi impegnativi di classificazione e regressione, tra cui analisi del rischio, sentiment analysis, advertising predittivo, modelli di prezzo, stima delle vendite e diagnosi dei pazienti, tra gli altri.
In sostanza, questi algoritmi combinano le previsioni di più alberi decisionali per migliorare prestazioni complessive e stabilità. Compresi gli algoritmi avanzati, per lo scopo di questo tutorial procederemo con modelli ad albero decisionali semplici.
Costruire modelli ad albero decisionale passo dopo passo in R
Abbiamo visto molta teoria e l’intuizione dietro i modelli ad albero decisionale e le loro varianti, ma nulla batte la pratica: costruiamo questi modelli e valutarne le prestazioni in modo graduale.
Preparare i dati per il modeling
Per i seguenti esempi, useremo il famoso Boston Housing Dataset.
Il dataset Boston Housing contiene informazioni sul mercato immobiliare di Boston, Massachusetts, negli anni ’70. Ha 506 osservazioni e 14 variabili, di cui 13 feature e 1 variabile target.
Le feature nel Boston Housing dataset sono:
- CRIM: Tasso di criminalità pro capite per città
- ZN: Quota di terreno residenziale destinata a lotti oltre 25.000 piedi quadrati
- INDUS: Quota di acri destinati ad attività non retail per città
- CHAS: Variabile fittizia del fiume Charles (= 1 se il tratto confina con il fiume; 0 altrimenti)
- NOX: Concentrazione di ossidi di azoto (parti per 10 milioni)
- RM: Numero medio di stanze per abitazione
- AGE: Quota di unità occupate dai proprietari costruite prima del 1940
- DIS: Distanze ponderate da cinque centri occupazionali di Boston
- RAD: Indice di accessibilità alle autostrade radiali
- TAX: Aliquota dell’imposta patrimoniale a valore pieno per $10.000
- PTRATIO: Rapporto alunni-insegnanti per città
- Black: quota di persone nere per città
- LSTAT: Percentuale della popolazione a status socioeconomico più basso
La variabile target è MEDV, che rappresenta il valore mediano delle case occupate dai proprietari in migliaia di dollari.
L’obiettivo è prevedere il valore mediano delle case occupate dai proprietari (in migliaia di dollari) sulla base delle feature fornite.
In R, i dati sono forniti in un pacchetto chiamato “MASS.” Dovrai installare più pacchetti per questo tutorial e caricarli. Poiché sarebbe ripetitivo, mostriamo il processo con il pacchetto MASS una volta, e lo ripeterai ogni volta che vedi un nuovo pacchetto usato in questa guida.
# install the package
install.packages("MASS")
# Load the MASS package
library(MASS)
# Load the Boston Housing dataset
data(Boston)Spesso è necessario esplorare i dati con visualizzazioni ed eseguire passi di pre-processing prima di passare al modeling. Diamo un’occhiata alla distribuzione delle variabili tramite istogrammi.
Ecco il codice per crearli:
# Load the library
library(tidymodels)
library(tidyr)
# Prepare the dataset for ggplot2
boston_data_long <- Boston %>%
pivot_longer(cols = everything(),
names_to = "variable",
values_to = "value")
# Create a histogram for all numeric variables in one plot
boston_histograms <- ggplot(boston_data_long, aes(x = value)) +
geom_histogram(bins = 30, color = "black", fill = "lightblue") +
facet_wrap(~variable, scales = "free", ncol = 4) +
labs(title = "Histograms of Numeric Variables in the Boston Housing Dataset",
x = "Value",
y = "Frequency") +
theme_minimal()
# Plot the histograms
print(boston_histograms)E l’output appare così:
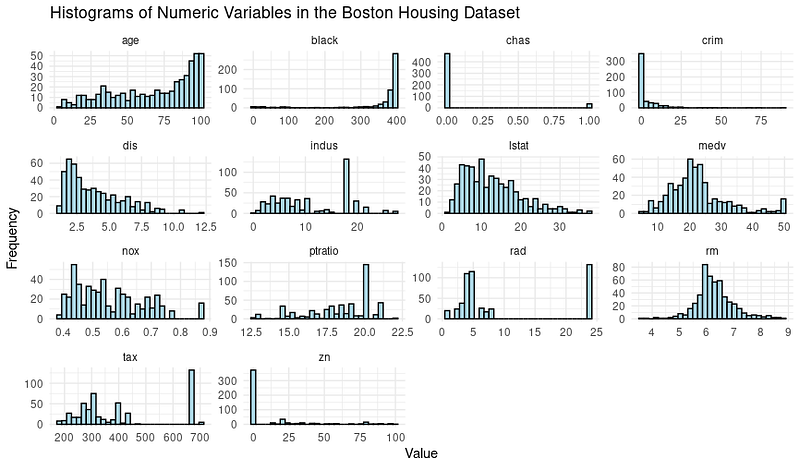
Notiamo alcuni outlier, soprattutto nelle colonne come RAD, TAX e NOX. Il nostro obiettivo in questo tutorial è concentrarci sulla fase di modeling con alberi decisionali; quindi dividiamo il dataset in training e test set.
# Split the data into training and testing sets
set.seed(123)
data_split <- initial_split(Boston, prop = 0.75)
train_data <- training(data_split)
test_data <- testing(data_split)Passiamo ora al modeling e alla valutazione delle prestazioni del modello.
Modeling con un semplice albero decisionale
Usando la funzione decision_tree() del pacchetto Tidymodels in R, è semplice creare prima una specifica di modello ad albero decisionale e poi adattare il modello ai dati di training.
# Create a decision tree model specification
tree_spec <- decision_tree() %>%
set_engine("rpart") %>%
set_mode("regression")
# Fit the model to the training data
tree_fit <- tree_spec %>%
fit(medv ~ ., data = train_data)Qui usiamo la modalità “regression” e, per un albero decisionale di classificazione, dovremmo usare la modalità “classification”.
Valutare le prestazioni del modeling con l’albero decisionale
Per valutare le prestazioni del modello, useremo il pacchetto Tidymodels per calcolare la root mean squared error (RMSE) e il valore R-squared per il nostro modello ad albero decisionale sui dati di test.
# Make predictions on the testing data
predictions <- tree_fit %>%
predict(test_data) %>%
pull(.pred)
# Calculate RMSE and R-squared
metrics <- metric_set(rmse, rsq)
model_performance <- test_data %>%
mutate(predictions = predictions) %>%
metrics(truth = medv, estimate = predictions)
print(model_performance)Otterrai un output con due metriche di prestazione: Root Mean Squared Error (RMSE) e R-squared (R²).
.metric .estimator .estimate
<chr> <chr> <dbl>
1 rmse standard 5.22
2 rsq standard 0.689Analizzare i risultati del modello
Dunque, i risultati del nostro modello sono sufficienti?
- RMSE (Root Mean Squared Error): misura la differenza media tra valori predetti e veri. Nel tuo caso, l’RMSE è 5,22, il che significa che, in media, le previsioni del modello ad albero decisionale si discostano di circa 5,22 unità dai valori reali. Un valore di RMSE più basso è generalmente migliore, poiché indica errori di previsione più piccoli.
- R-squared (R²): misura quanto bene il modello spiega la varianza della variabile target. Varia da 0 a 1, con valori più alti che indicano un miglior adattamento. Nel tuo caso, l’R² è 0,689, il che significa che il modello spiega circa il 68,9% della varianza della variabile target (MEDV).
Possiamo anche ottimizzare gli iperparametri per spremere prestazioni extra oppure passare a modelli più complessi come Random Forest e XGBoost sacrificando un po’ di interpretabilità.
Prevedere gli esiti con il modello ad albero decisionale
Una volta soddisfatto del modello, è il momento di farlo prevedere.
È lo stesso procedimento usato con i dati di test tramite la funzione predict(), ma dobbiamo fornire un nuovo set di dati che imiti le informazioni su una nuova casa a Boston. È uno scenario plausibile quando il modello va in produzione.
# Make predictions on new data
new_data <- tribble(
~crim, ~zn, ~indus, ~chas, ~nox, ~rm, ~age, ~dis, ~rad, ~tax, ~ptratio, ~black, ~lstat,
0.03237, 0, 2.18, 0, 0.458, 6.998, 45.8, 6.0622, 3, 222, 18.7, 394.63, 2.94
)
predictions <- predict(tree_fit, new_data)
print(predictions)E otterrai il valore mediano previsto (in migliaia di dollari) per questa particolare casa:
# A tibble: 1 × 1
.pred
<dbl>
1 37.8Con questo, hai gli step per costruire un modello ad albero decisionale: concentriamoci ora su come interpretare cosa accade nel modello, per te e per gli stakeholder che useranno la soluzione appena creata.
Interpretare l’albero decisionale
Il vantaggio più significativo, come detto, è l’interpretabilità dei modelli ad albero decisionale. Visualizziamo l’albero decisionale per comprendere meglio il modello:
# Load the library
library(rpart.plot)
# Plot the decision tree
rpart.plot(tree_fit$fit, type = 4, extra = 101, under = TRUE, cex = 0.8, box.palette = "auto")Vedrai un grafico come questo:
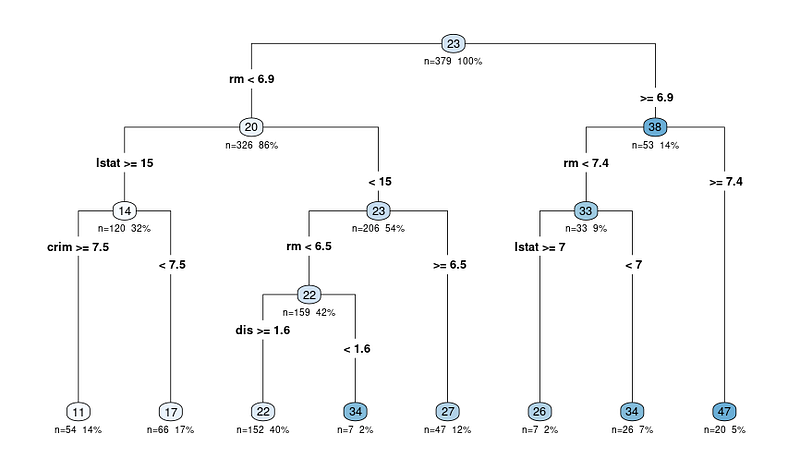
Il diagramma prodotto dalla funzione rpart.plot mostra una rappresentazione ad albero del modello. In questo diagramma, ogni nodo rappresenta uno split nell’albero basato sulle variabili predittive. Il diagramma include varie informazioni utili per interpretare l’albero decisionale:
I diagrammi ad albero iniziano con il nodo radice
I nodi sono rappresentati da cerchi e collegati da linee, a mostrare la struttura gerarchica dell’albero decisionale. L’albero inizia con un nodo radice in cima, poi si dirama in nodi interni, conducendo infine ai nodi terminali o foglie in basso.
Il criterio di split per ciascun nodo interno
Ogni nodo interno mostra il criterio di split, ovvero la variabile predittiva e il valore usato per suddividere i dati in due sottoinsiemi.
Per esempio, un nodo potrebbe mostrare “RM < 6.8”, indicando che le osservazioni con numero medio di stanze per abitazione (RM) inferiore a 6,8 seguiranno il ramo sinistro, mentre quelle con RM maggiore o uguale a 6,8 seguiranno il ramo destro.
N: numero di osservazioni dopo lo split
Il valore n in ciascun nodo rappresenta il numero di osservazioni nel dataset che ricadono in quel nodo. Per esempio, se un nodo mostra "n = 100", significa che 100 osservazioni nel dataset soddisfano i criteri dei nodi genitori di quel nodo.
X%: la quota delle osservazioni totali del dataset che ha raggiunto quel nodo
La percentuale ti aiuta a capire la dimensione relativa di ciascun nodo rispetto all’intero dataset, mostrando come i dati vengono suddivisi e distribuiti nell’albero. Una percentuale più alta indica che una porzione maggiore dei dati ha seguito il percorso decisionale che porta a quello specifico nodo; una più bassa indica una porzione minore.
Il valore predetto per ciascun nodo
Il valore predetto in ciascun nodo è mostrato come un numero in un cerchio colorato (nodo). In un albero di regressione, è il valore medio della variabile target per tutte le osservazioni che ricadono in quel nodo.
Per esempio, l’ultimo nodo foglia che mostra 47 significa che il valore medio della variabile target (nel nostro caso, il valore mediano delle case occupate dai proprietari) per tutte le osservazioni in quel nodo è 47.
Parti dal nodo radice e segui i rami
Quando interpreti qualsiasi risultato, parti dal nodo radice e segui i rami in base ai criteri di split fino a raggiungere un nodo terminale. Il valore predetto nel nodo terminale fornisce la previsione del modello per una data osservazione e la ragione dietro la decisione.
Estrarre le regole dall’albero decisionale
Se preferisci ancora estrarre le regole in forma testuale (invece di attraversare il diagramma), puoi farlo usando la stessa libreria con cui abbiamo creato il grafico.
Ecco il codice:
rules <- rpart.rules(tree_fit$fit)
print(rules)E vedrai un output con i valori predetti e le regole seguite per arrivare a quel valore, come sotto:
medv
11 when rm < 6.9 & lstat >= 15 & crim >= 7.5
17 when rm < 6.9 & lstat >= 15 & crim < 7.5
22 when rm < 6.5 & lstat < 15 & dis >= 1.6
26 when rm is 6.9 to 7.4 & lstat >= 7
27 when rm is 6.5 to 6.9 & lstat < 15
34 when rm < 6.5 & lstat < 15 & dis < 1.6
34 when rm is 6.9 to 7.4 & lstat < 7
47 when rm >= 7.4Ora che vedi le regole, potresti chiederti come la decisione possa essere presa con 3–4 variabili quando ne forniamo molte di più all’albero decisionale.
Ebbene, alcune variabili sono più importanti di altre. Capiremo meglio questo concetto.
Capire le variabili importanti negli alberi decisionali
Abbiamo già visto il diagramma dell’albero e come funziona il modello. Un ultimo aspetto dell’interpretazione è capire quali sono le variabili importanti nel dataset.
Ecco perché è cruciale:
- Selezione delle feature. Identificare le variabili importanti ti aiuta a concentrarti sulle feature rilevanti ed eventualmente rimuovere quelle meno importanti, semplificando il modello e riducendo il rumore.
- Conoscenza del dominio. Capire quali feature sono più importanti può aiutarti a comprendere meglio le relazioni tra le variabili e la variabile target nel contesto del tuo problema specifico.
- Interpretazione del modello. Conoscere le feature chiave che guidano le previsioni del modello offre insight preziosi sul processo decisionale.
Negli alberi decisionali, l’importanza delle variabili è solitamente determinata dalle feature utilizzate per gli split nei nodi. Le feature usate per gli split in alto nell’albero o usate più frequentemente possono essere considerate più importanti.
L’importanza di una variabile può essere quantificata dalla riduzione nella misura di impurezza (ad es., indice di Gini o mean squared error) che apporta quando è usata per uno split. Il pacchetto “VIP” in R semplifica tutto e il grafico può essere ottenuto con il codice seguente:
# Load the necessary library
library(vip)
# Create a variable importance plot
var_importance <- vip::vip(tree_fit, num_features = 10)
print(var_importance)E otterrai il grafico di importanza delle variabili qui sotto:
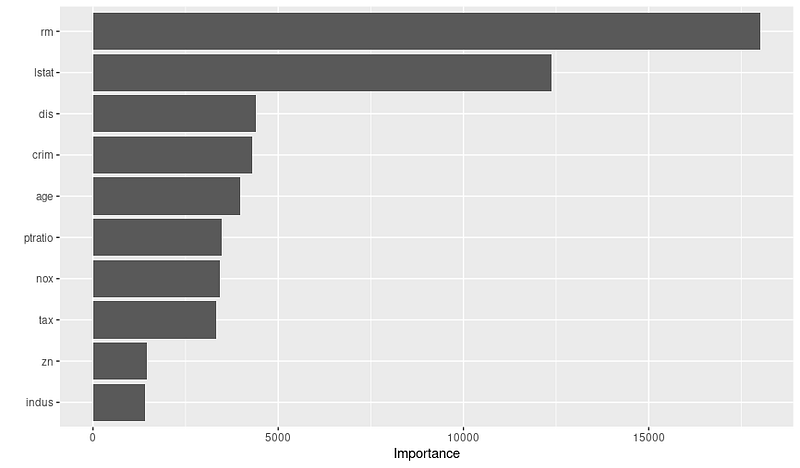
Una volta visto il grafico, potresti fare ulteriori ricerche sul perché queste variabili siano importanti, collaborando con esperti di dominio. Per esempio, in base al grafico sopra, possiamo dedurre le 3 variabili più importanti e la razionalità:
- RM: Il numero medio di stanze per abitazione è una feature molto importante, suggerendo che le case con più stanze tendono ad avere valori mediani più alti.
- LSTAT: La percentuale della popolazione con status socioeconomico più basso è un’altra variabile significativa, indicando che i quartieri a status più basso tendono ad avere valori mediani delle case inferiori.
- DIS: La distanza ponderata dai centri occupazionali è una variabile rilevante, mostrando che le case più vicine ai principali centri occupazionali tendono ad avere valori mediani più alti.
Ricorda quindi di controllare il grafico di importanza delle variabili prima di finalizzare il modello; può aiutarti a creare e selezionare feature migliori per ottimizzare le prestazioni.
Conclusione
In questo tutorial abbiamo esplorato i concetti fondamentali degli alberi decisionali e abbiamo affrontato non solo la costruzione dei modelli ma anche la loro interpretazione. Gli alberi decisionali sono modelli potenti e interpretabili sia per attività di classificazione che di regressione, rendendoli uno strumento essenziale nell’arsenale di un data scientist.
Man mano che sviluppi le tue competenze, ti invitiamo ad approfondire il mondo degli alberi decisionali, esplorare algoritmi alternativi e migliorare le tue abilità di programmazione in R. Ecco alcune risorse per il prossimo passo:
- Fondamenti di Machine Learning in R
- Introduzione alla Feature Engineering in R
- Modeling con Tidymodels in R
- Machine Learning con modelli basati su alberi in R
Senza dubbio, ampliare le tue conoscenze e sperimentare nuovi strumenti e tecniche ti permetterà di affrontare sfide diverse e fornire insight di valore nei tuoi progetti.




