
Last chance! 50% off DataCamp Premium
Sale ends in
Stel, je ontwikkelt een spamdetectiesysteem voor e-mail. In eerste instantie markeer je een e-mail misschien als verdacht als die bepaalde trefwoorden bevat. Maar wat als je ontdekt dat deze e-mail van een vertrouwde afzender komt? Of dat hij op een ongebruikelijk tijdstip is verzonden? Elk stukje nieuwe informatie verschuift de kans dat de e-mail spam is. Dit dynamisch bijwerken van kansen op basis van nieuw bewijs ligt aan de basis van voorwaardelijke waarschijnlijkheid, een concept dat veel moderne data science-toepassingen aandrijft, van e-mailfiltering tot fraudedetectie.
Voor wie net begint met kansbegrippen biedt de Introduction to Probability Rules Cheat Sheet een handig naslagwerk met kernprincipes en formules. De cursus Introduction to Statistics legt een solide basis door kansverdelingen en hun eigenschappen te verkennen, die de basis vormen om te begrijpen hoe voorwaardelijke waarschijnlijkheid in de praktijk werkt. Deze bronnen bieden een gestructureerd pad om sterke fundamenten te ontwikkelen in de concepten die we in dit artikel bespreken.
Voorwaardelijke waarschijnlijkheid meet hoe waarschijnlijk het is dat een gebeurtenis optreedt wanneer we weten dat een andere gebeurtenis al heeft plaatsgevonden. Wanneer we nieuwe informatie over een gebeurtenis ontvangen, passen we onze kansberekeningen dienovereenkomstig aan.
Om dit concept te begrijpen, bekijken we een voorbeeld met speelkaarten. Trek je een kaart uit een standaardspel, dan zijn er 52 mogelijke uitkomsten. Als je een koning wilt trekken, is je initiële kans 4/52 (ongeveer 7,7%), omdat er vier koningen in het spel zitten. Maar wat als iemand je vertelt dat de kaart die je trok een plaatje is? Deze nieuwe informatie verandert alles: je kans op een koning is nu veel hoger, namelijk 4/12 (ongeveer 33,3%), aangezien er in totaal slechts twaalf plaatjeskaarten zijn.
Deze relatie tussen kansen heeft een precieze wiskundige definitie:
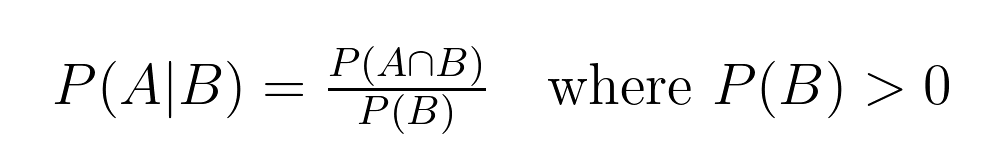
Met deze formule berekenen we voorwaardelijke waarschijnlijkheid, waarbij:
In ons kaartenvoorbeeld:
Om beter te begrijpen hoe voorwaardelijke waarschijnlijkheid in de praktijk werkt, kunnen we een boomdiagram gebruiken. Boomdiagrammen zijn vooral handig omdat ze laten zien hoe elk nieuw stukje informatie onze kansen verandert:
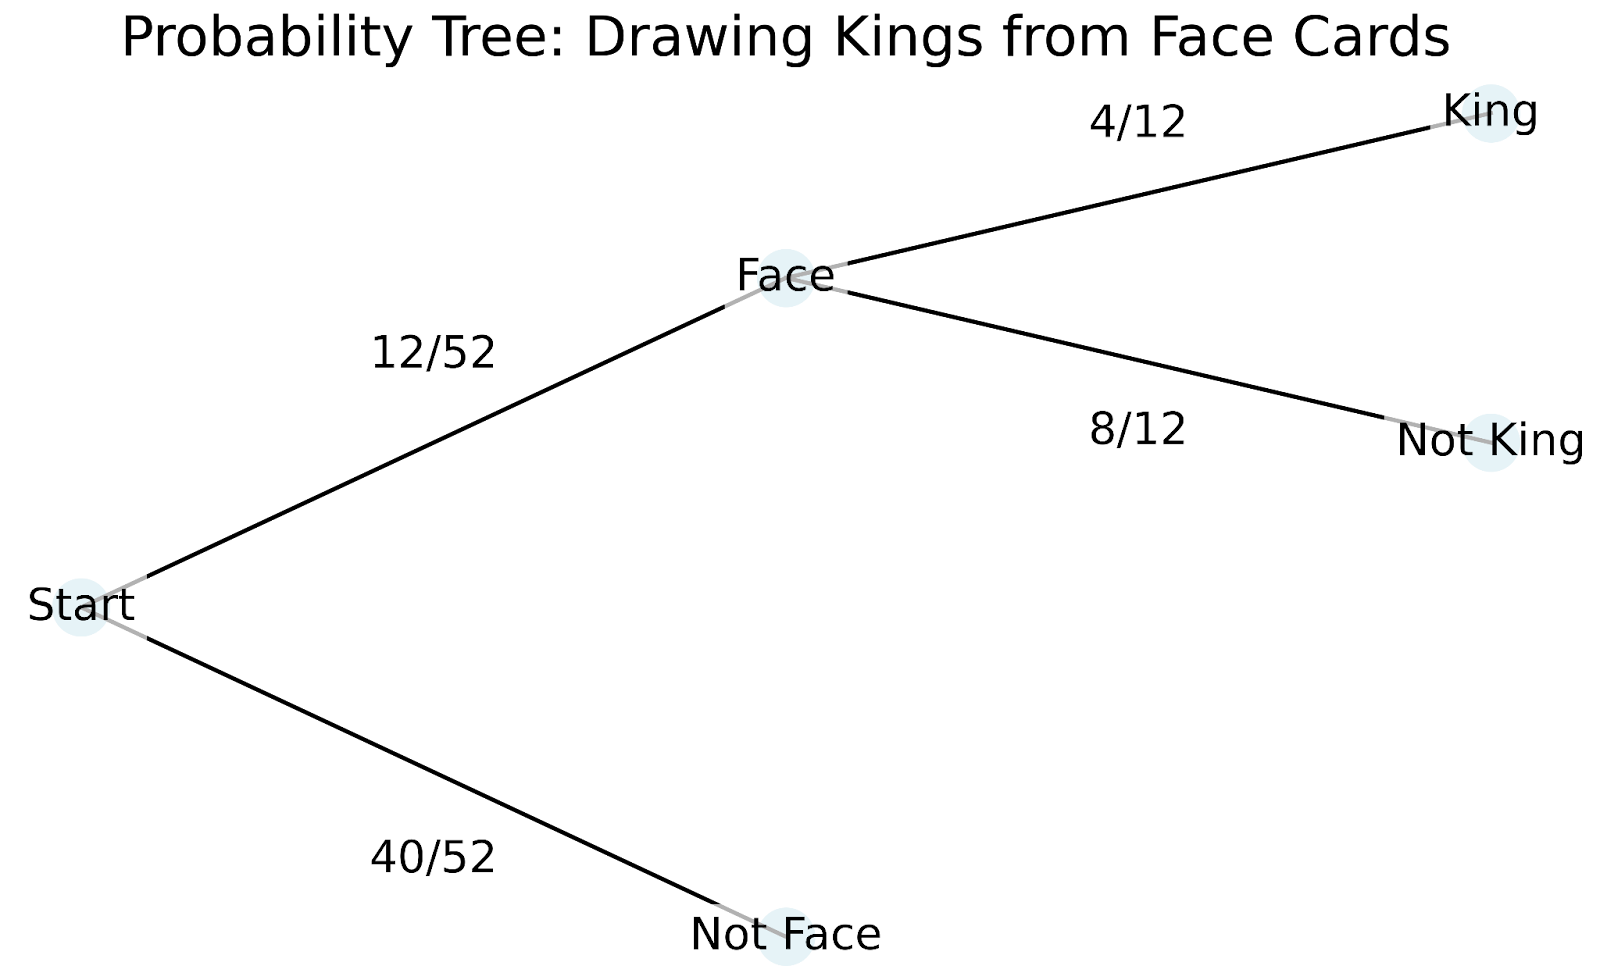
Laten we stap voor stap bekijken hoe dit boomdiagram werkt:
Het boomdiagram helpt ons enkele kernbegrippen in voorwaardelijke waarschijnlijkheid te begrijpen:
Het mooie van voorwaardelijke waarschijnlijkheid is dat je je kansen kunt bijwerken naarmate je nieuwe informatie krijgt. Net zoals we onze kans op een koning hebben aangepast van 7,7% naar 33,3% toen we hoorden dat we een plaatje hadden, geeft voorwaardelijke waarschijnlijkheid ons een formele manier om kansen te herberekenen op basis van nieuw bewijs.
De wiskundige structuur van voorwaardelijke waarschijnlijkheid biedt ons gereedschap om complexe scenario’s met meerdere gebeurtenissen te analyseren. Laten we de belangrijkste eigenschappen bekijken.
Deze wiskundige eigenschappen helpen ons complexere problemen efficiënter op te lossen:
Als twee gebeurtenissen A en B onafhankelijk zijn, weten we dat het optreden van de ene de kans op de andere niet beïnvloedt. Wiskundig: P(A|B) = P(A), wat je leest als: "de kans op A gegeven B is gelijk aan de kans op A."
Als we bijvoorbeeld een dobbelsteen gooien en een munt opwerpen, verandert kop op de munt de kans op een zes niet. De formule laat zien: P(Zes|Kop) = P(Zes) = 1/6
Voor elke gebeurtenis A gegeven voorwaarde B moeten de kansen op A en het complement A' (uitgesproken als "A prime") optellen tot 1. Wiskundig: P(A|B) + P(A'|B) = 1, wat je leest als: “De kans op A gegeven B plus de kans op A complement gegeven B is gelijk aan 1.”
In ons eerdere kaartenvoorbeeld: P(Koning|Plaatje) + P(Geen koning|Plaatje) = 4/12 + 8/12 = 1
De vermenigvuldigingsregel koppelt gezamenlijke kansen aan voorwaardelijke kansen: P(A ∩ B) = P(A|B) × P(B). We zeggen: "De kans op A doorsnede B is gelijk aan de kans op A gegeven B maal de kans op B."
Dit breidt zich uit naar meerdere gebeurtenissen via de kettingregel. Voor drie gebeurtenissen A, B en C: P(A ∩ B ∩ C) = P(A|B ∩ C) × P(B|C) × P(C). Dat wil zeggen: "De kans op A doorsnede B doorsnede C is gelijk aan de kans op A gegeven B doorsnede C maal de kans op B gegeven C maal de kans op C."
Laten we dit in actie zien met een reeks kaarttrekkingen:
P(K ∩ Q ∩ A) = P(A|K ∩ Q) × P(Q|K) × P(K) = (4/50) × (4/51) × (4/52)
De kettingregel is bijzonder waardevol in machine learning, vooral in Bayesiaanse netwerken waar we complexe afhankelijkheden tussen meerdere variabelen moeten modelleren. Bij data-analyse komen we vaak situaties tegen waarin gebeurtenissen een natuurlijke volgorde volgen, en de kettingregel helpt ons deze complexe scenario’s op te delen in eenvoudiger, beter hanteerbare berekeningen.
Laten we twee van de meest voorkomende voorbeelden doornemen en ook nadenken over hoe voorwaardelijke waarschijnlijkheid in je werk kan voorkomen.
Deze twee voorbeelden zijn heel gebruikelijk en de moeite waard om te bestuderen, zeker als je gaat solliciteren:
Als we een dobbelsteen werpen, begint onze uitkomstenruimte met zes mogelijkheden: {1, 2, 3, 4, 5, 6}. Gedeeltelijke informatie over de worp verandert onze kansberekeningen op een specifieke manier. Zo gaat dat:
Initiële kans op een 6: P(6) = 1/6
Als we horen dat de worp even is, reduceert onze uitkomstenruimte tot {2, 4, 6}: P(6 | even) = 1/3
Een zak bevat 5 blauwe knikkers en 3 rode knikkers. Wanneer we zonder terugleggen trekken, beïnvloedt elke trekking de kansen van latere trekkingen.
Eerste trekking - kans op blauw: P(blauw₁) = 5/8
Tweede trekking, gegeven dat de eerste blauw was: P(blauw₂ | blauw₁) = 4/7
Dit voorbeeld vult ons eerdere kaartenvoorbeeld aan door sequentiële afhankelijkheden te benadrukken.
Medische tests zijn een perfecte toepassing van voorwaardelijke waarschijnlijkheid bij het beoordelen van testnauwkeurigheid. Voor elke diagnostische test moeten we vier belangrijke voorwaardelijke kansen begrijpen:
Bij het beoordelen van de prestaties van deze test gebruiken medisch specialisten deze voorwaardelijke kansen om:
Als we bijvoorbeeld 1000 patiënten testen en 100 positieve resultaten krijgen, kunnen we met deze voorwaardelijke kansen schatten hoeveel daarvan echte positieven zijn en hoeveel vals-positieven. Deze analyse helpt medisch professionals de risico’s van het missen van een diagnose af te wegen tegen de kosten en onrust van valse alarmen.
Beleggingsfirma’s gebruiken voorwaardelijke waarschijnlijkheid om marktrisico’s te evalueren. Denk aan een portfoliomanager die de markvolatiliteit volgt:
De dagelijkse markvolatiliteit kan Laag (L), Midden (M), of Hoog (H) zijn.
Historische data laat zien:
Deze informatie helpt managers om:
Onze verkenning van medische tests benadrukte een belangrijk onderscheid: de kans om een ziekte te hebben gegeven een positieve test verschilt van de kans op een positieve test gegeven de ziekte. De stelling van Bayes biedt een formeel kader om deze relatie te navigeren, zodat we onze kansinschattingen kunnen bijwerken wanneer nieuw bewijs opduikt.
De stelling van Bayes drukt de relatie uit tussen twee voorwaardelijke kansen: P(A|B) = [P(B|A) × P(A)] / P(B). We lezen deze vergelijking zo: "De kans op A gegeven B is gelijk aan de kans op B gegeven A maal de kans op A, gedeeld door de kans op B."
Elk onderdeel speelt een rol:
Laten we zien hoe dit in de praktijk werkt met ons scenario van medische tests, nu uitgebreid om de volledige Bayesiaanse analyse te tonen.
Beschouw een medische aandoening die 2% van de bevolking treft. Een nieuwe diagnostische test heeft:
Wanneer een patiënt positief test, hoe moeten we onze overtuiging over hun aandoening bijwerken?
Laten we dit stap voor stap oplossen:
Deze analyse laat zien dat zelfs met een positieve test de kans op de aandoening slechts ongeveer 16,2% is — veel hoger dan de initiële 2%, maar misschien lager dan je intuïtief zou verwachten.
De stelling van Bayes blinkt uit wanneer we meerdere stukjes bewijs ontvangen. De posterior-kans van elke berekening wordt de prior-kans voor de volgende update. Als onze patiënt bijvoorbeeld een tweede positieve test krijgt:
Dit sequentiële updaten biedt een wiskundig kader om nieuw bewijs op te nemen in onze kansinschattingen. Het mooie van Bayesiaanse inferentie is dat het kwantificeert hoe onze overtuigingen zouden moeten veranderen naarmate we nieuwe informatie verzamelen, en zo een formele methode biedt om kansen bij te werken in het licht van bewijs.
Laten we bekijken hoe voorwaardelijke waarschijnlijkheid voorkomt in data science.
De Naive Bayes-classificator, een van de meest eenvoudige maar krachtige tools in machine learning, past de stelling van Bayes toe om categorieën te voorspellen op basis van featurekansen. Bij het classificeren van e-mail als spam of niet-spam bijvoorbeeld, berekent het algoritme de voorwaardelijke kans dat een e-mail spam is gegeven de woorden die hij bevat. Hoewel het de "naïeve" aanname maakt dat features onafhankelijk zijn, werkt deze vereenvoudiging in de praktijk vaak verrassend goed.
Beslisbomen hanteren een andere benadering van voorwaardelijke waarschijnlijkheid door data te splitsen op basis van featurewaarden om voorwaardelijke deelverzamelingen te creëren. Bij elk knooppunt stelt de boom vragen als "Wat is de kans op onze doelvariabele gegeven deze specifieke featurewaarde?" Deze splitsingen gaan door totdat we zuivere of bijna zuivere deelverzamelingen bereiken, waarmee we in feite een kaart van voorwaardelijke kansen maken die onze voorspellingen sturen.
Kredietscoresystemen gebruiken voorwaardelijke kansen om de waarschijnlijkheid van wanbetaling te evalueren gegeven verschillende klantkenmerken. Zo kan een bank de kans op wanbetaling berekenen gegeven inkomensniveau, kredietgeschiedenis en werkstatus. Deze berekeningen worden geavanceerder wanneer meerdere afhankelijke risico’s worden meegenomen, zoals hoe de kans op hypotheekwanbetaling verandert gegeven zowel een recessie als stijgende rente. Beleggingsrisicomodellen gebruiken voorwaardelijke kansen om Value at Risk (VaR) te schatten, waarbij ze de kans op specifieke verliesniveaus berekenen gegeven de huidige marktomstandigheden. Portfoliomanagers gebruiken deze voorwaardelijke kansen om asset-allocaties aan te passen en te begrijpen hoe het risico van de ene belegging kan veranderen gegeven de prestaties van andere beleggingen in de portefeuille.
Bayesiaanse netwerken vormen de meest directe toepassing van voorwaardelijke waarschijnlijkheid in machine learning. Ze modelleren relaties tussen variabelen als een gerichte graaf waarbij de toestand van elke knoop afhangt van zijn ouders. Deze netwerken excelleren bij taken als medische diagnose, waar de kans op verschillende aandoeningen afhangt van meerdere onderling verbonden symptomen en testresultaten.
Probabilistische grafische modellen gebruiken voorwaardelijke afhankelijkheden om complexe relaties in data weer te geven, waardoor ze waardevol zijn voor taken als beeldherkenning en natuurlijke taalverwerking. Zelfs deep learning-modellen, hoewel niet expliciet probabilistisch, geven voorwaardelijke kansen in hun laatste lagen wanneer ze classificaties maken. De softmax-functie, vaak gebruikt in neurale netwerken, zet ruwe scores om in voorwaardelijke kansen en vertelt ons de waarschijnlijkheid van elke mogelijke klasse gegeven de inputdata.
Bij het werken met voorwaardelijke waarschijnlijkheid leiden drie belangrijke misvattingen vaak tot onjuiste conclusies.
Tot slot bekijken we enkele complexere ideeën die voortbouwen op wat we geoefend hebben.
Wanneer we van discrete naar continue kansverdelingen gaan, komen we een interessante uitdaging tegen: specifieke punten in een continue verdeling hebben kans nul. Neem het exact meten van iemands lengte: we kunnen zeggen dat de kans dat iemand tussen 170 en 171 centimeter is betekenisvol is, maar de kans dat iemand precies 170,5432... centimeter is, is technisch gezien nul. Toch willen we vaak conditioneren op zulke precieze metingen. Reguliere voorwaardelijke waarschijnlijkheid biedt een wiskundig kader om hiermee om te gaan, door onze basisconcepten uit te breiden naar continue gevallen via dichtheidsfuncties en maatvoering (measure theory). Deze uitbreiding maakt uitspraken als "de kansverdeling van iemands gewicht, gegeven dat hij precies 170,5 centimeter lang is" zinvol.
Jeffrey-conditionalisatie breidt traditionele voorwaardelijke waarschijnlijkheid uit naar situaties waarin ons nieuwe bewijs niet zeker is, maar een eigen waarschijnlijkheid heeft. In tegenstelling tot standaard conditionering, waarbij we uitgaan van absolute zekerheid over onze nieuwe informatie, stelt Jeffrey’s regel ons in staat onze overtuigingen bij te werken op basis van onzeker bewijs. Dit past beter bij realistische situaties waarin nieuwe informatie vaak een zekere mate van onzekerheid kent. In plaats van bijvoorbeeld met zekerheid te weten dat een medische test positief is, kunnen we horen dat de kans op positief 80% is. Jeffrey’s regel biedt een formele methode om kansen bij te werken in deze meer genuanceerde situaties.
Voorwaardelijke waarschijnlijkheid biedt een wiskundig kader om onze overtuigingen bij te werken naarmate nieuwe informatie beschikbaar komt. In dit artikel hebben we gezien hoe dit concept wordt toegepast in uiteenlopende domeinen, van medische diagnostiek tot financiële risicoanalyse. De principes die we hebben verkend helpen ons te begrijpen hoe kans verandert met nieuw bewijs, en maken beter geïnformeerde beslissingen mogelijk in data science-toepassingen. Dit inzicht is bijzonder waardevol bij het werken met classificatie-algoritmen, risicomodellen en machinelearningsystemen waarin kansen continu worden bijgewerkt.
Terwijl je je expertise in kansrekening en statistische inferentie verder uitbouwt, kunnen verschillende cursussen je begrip van deze concepten vanuit een Bayesiaans perspectief verdiepen. Onze cursus Fundamentals of Bayesian Data Analysis in R introduceert kernprincipes en hun praktische toepassingen, terwijl onze cursus Bayesian Modeling with RJAGS laat zien hoe je deze concepten implementeert met krachtige statistische tools. Voor Python-gebruikers biedt onze Bayesian Data Analysis in Python-cursus praktische ervaring met het toepassen van deze methoden op realistische problemen. Elke cursus biedt een pad om je kennis van kansrekening en de toepassingen ervan in moderne data science uit te breiden.
Leer met DataCamp
Cursus
Cursus
blog
Adel Nehme
15 min


