Bir e-posta için spam tespit sistemi geliştirdiğinizi hayal edin. Başlangıçta, belirli anahtar kelimeler içeriyorsa bir e-postayı şüpheli olarak işaretleyebilirsiniz. Peki ya bu e-postanın güvenilir bir gönderenden geldiğini öğrenseniz? Ya da olağandışı bir saatte gönderildiğini? Her yeni bilgi parçası, e-postanın spam olma olasılığını değiştirir. Yeni kanıtlara göre olasılıkların bu dinamik şekilde güncellenmesi, e-posta filtrelemeden dolandırıcılık tespitine kadar birçok modern veri bilimi uygulamasını güçlendiren bir kavram olan koşullu olasılığın özünde yatar.
Olasılık kavramlarıyla yolculuğuna yeni başlayanlar için, Olasılık Kurallarına Giriş Hızlı Referans temel ilkeler ve formüller için faydalı bir başvuru sunar. İstatistiğe Giriş kursu, olasılık dağılımları ve özelliklerini inceleyerek, koşullu olasılığın pratikte nasıl çalıştığını anlamanın temelini oluşturur. Bu kaynaklar, bu makalede ele alacağımız kavramlarda güçlü bir temel oluşturmak için yapılandırılmış bir yol sağlar.
Koşullu Olasılık Nedir?
Koşullu olasılık, bir olayın gerçekleşme olasılığını, başka bir olayın zaten gerçekleştiğini bildiğimizde ölçer. Bir olay hakkında yeni bilgi aldığımızda, olasılık hesaplarımızı buna göre ayarlarız.
Bu kavramı anlamak için iskambil kartlarıyla bir örnek inceleyelim. Standart bir desteden bir kart çektiğinizde 52 olası sonuç vardır. Bir papaz (king) çekmek istiyorsanız, destede dört papaz olduğundan başlangıç olasılığınız 4/52 (yaklaşık %7,7)’dir. Peki biri size çektiğiniz kartın bir resimli kart olduğunu söylerse ne olur? Bu yeni bilgi her şeyi değiştirir – artık elinizde papaz olma olasılığı 4/12 (yaklaşık %33,3) ile çok daha yüksektir; çünkü toplamda yalnızca on iki resimli kart vardır.
Olasılıklar arasındaki bu ilişkinin kesin bir matematiksel tanımı vardır:
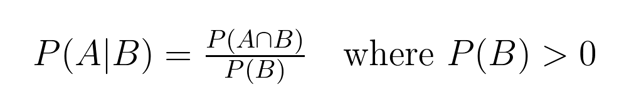
Bu formül koşullu olasılığı hesaplamamıza yardımcı olur; burada:
- P(A|B), B olayı gerçekleştiğinde A olayının gerçekleşme olasılığını gösterir. Bu, "B verildiğinde A’nın olasılığı" olarak okunur.
- P(A∩B), A ve B olaylarının birlikte gerçekleşme olasılığını, yani ortak olasılığı gösterir. Bu, "A kesişim B’nin olasılığı" olarak okunur.
- P(B), B olayının gerçekleşme olasılığını gösterir.
Kart örneğimizde:
- A olayı "bir Papaz çekmek"tir
- B olayı "bir resimli kart çekmek"tir
- P(A|B) = 4/12 (resimli kart olduğu verildiğinde papaz gelme olasılığı)
- P(A∩B) = 4/52 (bir papaz çekme olasılığı; papaz zaten resimli karttır)
- P(B) = 12/52 (herhangi bir resimli kart çekme olasılığı)
Koşullu olasılığın pratikte nasıl çalıştığını daha iyi anlamak için bir ağaç diyagramı kullanabiliriz. Ağaç diyagramları özellikle faydalıdır; çünkü her yeni bilginin olasılıklarımızı nasıl değiştirdiğini gösterir:
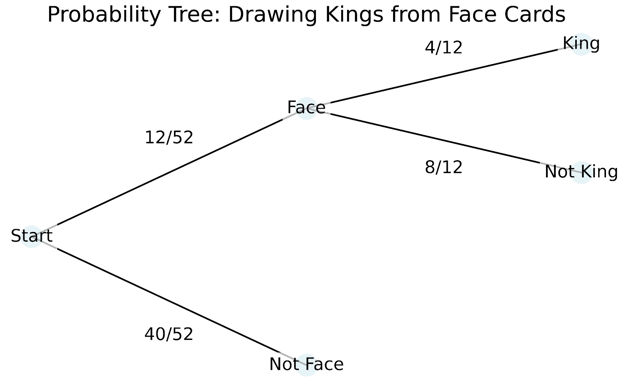
Bu ağaç diyagramının nasıl çalıştığını adım adım inceleyelim:
- Kökten (en soldaki noktadan) 52 kartın tamamıyla başlarız.
- İlk dallar ilk bilgimizi gösterir – kart resimli mi değil mi?
- Resimli kart dalını izlersek, ikinci bilgiye göre tekrar ayrılır – papaz mı?
Ağaç diyagramı, koşullu olasılıktaki birkaç temel kavramı anlamamıza yardımcı olur:
- Örnek Uzayı: Senaryomuzdaki tüm olası sonuçlardır. Başlangıç örnek uzayı 52 karttır; ancak resimli kartımız olduğunu öğrendiğimizde 12 karta "indirgenir".
- Olaylar: İlgilendiğimiz belirli sonuçlardır; örneğin "resimli kart çekmek" veya "papaz çekmek". Ağaçtaki dallar farklı olayları temsil eder.
- Ortak Olasılık: Birden fazla olayın birlikte gerçekleşme olasılığıdır. Ağacımızda bunu bir yol boyunca olasılıkları çarparak bulabiliriz. Örneğin, papaz çekme VE bunun resimli kart olması olasılığı (12/52) × (4/12) = 4/52’dir.
- Marjinal (Koşulsuz) Olasılık: Herhangi bir başka bilgiyi dikkate almadan bir olayın gerçekleşme olasılığıdır. Örneğimizde bu, kart hakkında başka bir şey bilmeden önce papaz çekmenin başlangıçtaki 4/52 olasılığı gibidir.
Koşullu olasılığın güzelliği, yeni bilgiler edindikçe olasılıklarımızı güncellememize olanak tanımasıdır. Resimli kartımız olduğunu öğrendiğimizde papaz olma olasılığımızı %7,7’den %33,3’e nasıl ayarladıysak, koşullu olasılık da yeni kanıtlara dayanarak olasılıkları yeniden hesaplamanın resmî bir yolunu sunar.
Koşullu olasılığın matematiksel yapısı, birden çok olayı içeren karmaşık senaryoları analiz etmemiz için araçlar sağlar. Temel özellikleri inceleyelim.
Koşullu olasılığın temel özellikleri
Bu matematiksel özellikler, karmaşık problemleri daha verimli çözmemize yardımcı olur:
1. Bağımsızlık özelliği
İki olay A ve B bağımsız olduğunda, birinin gerçekleşmesi diğerinin olasılığını etkilemez. Matematiksel olarak: P(A|B) = P(A). Bu, "B verildiğinde A’nın olasılığı, A’nın olasılığına eşittir" şeklinde okunur.
Örneğin, bir zar atıp bir madeni para çevirdiğimizde, parada yazı-tura sonucunun tura gelmesi, altı gelme olasılığını değiştirmez. Formül bize şunu gösterir: P(Altı|Tura) = P(Altı) = 1/6
2. Tümleyenin (tamamlayanın) kuralı
B koşulu verildiğinde herhangi bir A olayı için, A ve onun tümleyeni A' ("A üst" olarak okunur) olasılıklarının toplamı 1 olmalıdır. Matematiksel olarak: P(A|B) + P(A'|B) = 1; bu, “B verildiğinde A’nın olasılığı ile B verildiğinde A’nın tümleyeni olasılığının toplamı 1’e eşittir” şeklinde okunur.
Önceki kart örneğimizde: P(Papaz|Resimli Kart) + P(Papaz Değil|Resimli Kart) = 4/12 + 8/12 = 1
Çarpma kuralı ve zincir kuralı
Çarpma kuralı, ortak olasılıkları koşullu olasılıklarla ilişkilendirir: P(A ∩ B) = P(A|B) × P(B). "A kesişim B’nin olasılığı, B verildiğinde A’nın olasılığı ile B’nin olasılığının çarpımına eşittir" deriz.
Bu, çoklu olaylara zincir kuralıyla genişler. Üç olay A, B ve C için: P(A ∩ B ∩ C) = P(A|B ∩ C) × P(B|C) × P(C). Yani, "A kesişim B kesişim C’nin olasılığı, B kesişim C verildiğinde A’nın olasılığı ile C verildiğinde B’nin olasılığı ve C’nin olasılığının çarpımına eşittir."
Bunu bir kart çekme dizisiyle uygulamalı görelim:
- Bir papaz (K) çekmek
- Kalan kartlardan bir kız (Q) çekmek
- Kalan kartlardan bir as (A) çekmek
P(K ∩ Q ∩ A) = P(A|K ∩ Q) × P(Q|K) × P(K) = (4/50) × (4/51) × (4/52)
Zincir kuralı, özellikle birden çok değişken arasındaki karmaşık bağımlılıkları modellememiz gerektiği Bayesyen ağlarda, makine öğreniminde çok değerlidir. Verileri analiz ederken, olayların doğal bir sırayı izlediği durumlarla sıkça karşılaşırız ve zincir kuralı, bu karmaşık senaryoları daha basit ve yönetilebilir hesaplamalara ayrıştırmamıza yardımcı olur.
Koşullu Olasılığı Açıklayan Örnekler
En yaygın iki örneği gözden geçirelim ve koşullu olasılığın işinizde nasıl karşınıza çıkabileceğini de düşünelim.
Klasik örnekler
Bu iki örnek çok yaygındır ve özellikle mülakata giriyorsanız çalışmaya değerdir:
Zar atışları: Azalmış örnek uzaylarını anlamak
Bir zar attığımızda örnek uzayımız altı olasılıkla başlar: {1, 2, 3, 4, 5, 6}. Atış hakkında kısmi bilgi edinmek, olasılık hesaplarımızı belirli bir şekilde değiştirir. Nasıl olduğuna bakalım:
6 gelme başlangıç olasılığı: P(6) = 1/6
Atışın çift olduğunu öğrenirsek, örnek uzayımız {2, 4, 6}’ya iner: P(6 | çift) = 1/3
Bilyeler: Art arda bağımlılıklar
Bir torbada 5 mavi ve 3 kırmızı bilye vardır. Yerine koymadan bilye çektiğimizde, her çekiş sonraki çekişlerin olasılıklarını etkiler.
İlk çekiş – mavinin olasılığı: P(mavi₁) = 5/8
İkinci çekiş, ilki mavi ise: P(mavi₂ | mavi₁) = 4/7
Bu örnek, art arda bağımlılıkları vurgulayarak önceki kart örneğimizi tamamlar.
Gerçek dünya örnekleri
Tıbbi testler: Test doğruluğunu değerlendirme
Tıbbi testler, test doğruluğunu değerlendirmede koşullu olasılığın mükemmel bir uygulamasını sunar. Her teşhis testi için dört temel koşullu olasılığı anlamamız gerekir:
- P(T+ | D+): Hasta hastayken pozitif test sonucu alma olasılığı (duyarlılık)
- P(T- | D-): Hasta hasta değilken negatif test sonucu alma olasılığı (özgüllük)
- P(T+ | D-): Hasta hasta değilken pozitif test sonucu alma olasılığı (yalancı pozitif oranı)
- P(T- | D+): Hasta hastayken negatif test sonucu alma olasılığı (yalancı negatif oranı)
Bu testin performansını değerlendirirken, sağlık profesyonelleri bu koşullu olasılıkları şunlar için kullanır:
- Farklı hasta popülasyonlarında test doğruluğunu karşılaştırmak
- Ne zaman birden fazla testin gerekebileceğini belirlemek
- Pozitif/negatif sonuçlar için uygun eşikleri belirlemek
Örneğin, 1000 hastayı test edip 100 pozitif sonuç alırsak, kaçının gerçek pozitif, kaçının yalancı pozitif olduğunu tahmin etmek için bu koşullu olasılıkları kullanabiliriz. Bu analiz, sağlık profesyonellerinin bir tanıyı atlama riskini, yanlış alarmların maliyeti ve yarattığı kaygıyla dengelemesine yardımcı olur.
Finansal risk değerlendirmesi
Yatırım şirketleri, piyasa risklerini değerlendirmek için koşullu olasılığı kullanır. Piyasa oynaklığını izleyen bir portföy yöneticisini düşünün:
Günlük piyasa oynaklığı Düşük (L), Orta (M) veya Yüksek (H) olabilir.
Tarihsel veriler şunu gösterir:
- P(Yarın H | Bugün H) = 0,70
- P(Yarın M | Bugün H) = 0,25
- P(Yarın L | Bugün H) = 0,05
Bu bilgiler yöneticilere şunlarda yardımcı olur:
- Mevcut piyasa koşullarına göre portföy tahsislerini ayarlamak
- Otomatik alım-satım sistemleri için risk eşikleri belirlemek
- Süregelen yüksek oynaklık dönemleri için olağanüstü durum planları geliştirmek
Koşullu Olasılık ve Bayes Teoremi
Tıbbi testlerle ilgili incelememiz önemli bir ayrımı vurguladı: Pozitif test verildiğinde hastalığa sahip olma olasılığı, hastalığa sahip olunduğunda pozitif test çıkma olasılığından farklıdır. Bayes Teoremi, bu ilişkiyi yönetmek için resmî bir çerçeve sunar ve yeni kanıtlar ortaya çıktıkça olasılık tahminlerimizi güncellemeye olanak tanır.
Bayes Teoremini Anlamak
Bayes Teoremi, iki koşullu olasılık arasındaki ilişkiyi ifade eder: P(A|B) = [P(B|A) × P(A)] / P(B). Bu denklemi şöyle okuruz: "B verildiğinde A’nın olasılığı, A verildiğinde B’nin olasılığı ile A’nın olasılığının çarpımının, B’nin olasılığına bölünmesine eşittir."
Her bileşenin bir rolü vardır:
- P(A): Önsel olasılık – B kanıtını görmeden önce A hakkında başlangıç inancımız
- P(B|A): Olabilirlik – A doğruysa B kanıtının ne kadar olası olduğu
- P(B): B kanıtını gözlemleme toplam olasılığı
- P(A|B): Art-olası olasılık – B kanıtını gördükten sonra A hakkındaki güncellenmiş inancımız
Bunun pratikte nasıl çalıştığını, artık tam Bayesyen analizini gösterecek şekilde genişlettiğimiz tıbbi test senaryomuzla görelim.
Bir tıbbi test örneği
Nüfusun %2’sini etkileyen bir tıbbi durumu ele alalım. Yeni bir teşhis testinin özellikleri:
- %95 duyarlılık: P(pozitif test | duruma sahip) = 0,95
- %90 özgüllük: P(negatif test | duruma sahip değil) = 0,90
Bir hasta pozitif çıktığında, bu kişi hakkındaki inancımızı nasıl güncellemeliyiz?
Bunu adım adım çözelim:
- Önsel olasılık (testten önce): P(durum) = 0,02 (nüfusta %2)
- Durum varken pozitif test olasılığı: P(pozitif|durum) = 0,95 (test duyarlılığı)
- Pozitif testin toplam olasılığı: P(pozitif) = P(pozitif|durum) × P(durum) + P(pozitif|durum yok) × P(durum yok) = 0,95 × 0,02 + 0,10 × 0,98 = 0,019 + 0,098 = 0,117
- Art-olası olasılık (Bayes Teoremi ile): P(durum|pozitif) = [0,95 × 0,02] / 0,117 ≈ 0,162 yani %16,2
Bu analiz, pozitif bir test sonucuyla bile duruma sahip olma olasılığının yalnızca yaklaşık %16,2 olduğunu ortaya koyar – başlangıçtaki %2’den çok daha yüksek, ancak sezginin öngörebileceğinden belki daha düşüktür.
Bayesyen güncellemenin gücü
Bayes Teoremi, birden fazla kanıt aldığımızda parıldar. Her hesaplamanın art-olasılığı, bir sonraki güncelleme için önsel olur. Örneğin, hastamız ikinci kez pozitif çıkarsa:
- Yeni önsel: P(durum) = 0,162 (ilk hesaplamamızdan)
- Olabirlik: P(pozitif|durum) = 0,95
- Yeni art-olasılığı hesaplayın...
Bu sıralı güncelleme, yeni kanıtları olasılık tahminlerimize dahil etmek için matematiksel bir çerçeve sunar. Bayesyen çıkarımın güzelliği, yeni bilgiler topladıkça inançlarımızın nasıl değişmesi gerektiğini nicelleştirebilmesinde yatar; kanıtlar ışığında olasılıkları güncellemenin resmî bir yöntemini sağlar.
Veri Biliminde Uygulamalar
Koşullu olasılığın veri biliminde nasıl karşımıza çıktığına bakalım.
Öngörücü modelleme
Naive Bayes sınıflandırıcı, makine öğreniminin en yalın ama güçlü araçlarından biri olarak, özellik olasılıklarına dayanarak kategorileri tahmin etmek için Bayes Teoremi’ni uygular. Örneğin, bir e-postayı spam veya spam değil olarak sınıflandırırken, algoritma, içerdiği kelimeler verildiğinde e-postanın spam olma koşullu olasılığını hesaplar. Özelliklerin bağımsız olduğu yönündeki "naif" varsayımı yapsa da, bu basitleştirme pratikte çoğu zaman şaşırtıcı derecede iyi çalışır.
Karar ağaçları koşullu olasılığa farklı bir yaklaşım getirir; verileri özellik değerlerine göre böler ve koşullu alt kümeler oluşturur. Her düğümde ağaç, "Bu belirli özellik değeri verildiğinde hedef değişkenimizin olasılığı nedir?" gibi sorular sorar. Bu bölmeler, saf veya neredeyse saf alt kümelere ulaşana kadar devam eder; esasen tahminlerimizi yönlendiren koşullu olasılıkların bir haritasını oluşturur.
Risk yönetimi
Kredi puanlama sistemleri, çeşitli müşteri özellikleri verildiğinde temerrüt olasılığını değerlendirmek için koşullu olasılıkları kullanır. Örneğin, bir banka gelir düzeyi, kredi geçmişi ve istihdam durumu verildiğinde temerrüt olasılığını hesaplayabilir. Bu hesaplamalar, bir durgunluk ve faiz artışı birlikte gerçekleştiğinde ipotek temerrüt olasılığının nasıl değişebileceği gibi, birden çok bağımlı riski dikkate aldığımızda daha sofistike hale gelir. Yatırım risk modelleri, mevcut piyasa koşulları verildiğinde belirli kayıp seviyelerinin olasılığını hesaplayarak Riskteki Değer’i (VaR) tahmin etmek için koşullu olasılıkları kullanır. Portföy yöneticileri, portföydeki diğer yatırım araçlarının performansı verildiğinde bir yatırımın riskinin nasıl değişebileceğini anlayarak varlık tahsislerini bu koşullu olasılıklara göre ayarlar.
Makine öğrenimi
Bayesyen ağlar, değişkenler arasındaki ilişkileri, her düğümün durumunun ebeveynlerine bağlı olduğu yönlendirilmiş bir grafik olarak modelleyerek, koşullu olasılığın makine öğrenimindeki en doğrudan uygulamasını temsil eder. Bu ağlar, çeşitli koşulların olasılığının çoklu ve birbiriyle bağlantılı semptomlar ve test sonuçlarına bağlı olduğu tıbbi teşhis gibi görevlerde mükemmeldir.
Olasılıksal grafik modelleri, verilerdeki karmaşık ilişkileri temsil etmek için koşullu bağımlılıkları kullanır; bu da onları görüntü tanıma ve doğal dil işleme gibi görevler için değerli kılar. Açıkça olasılıksal olmasalar da, derin öğrenme modelleri sınıflandırma yaparken son katmanlarında koşullu olasılıklar üretir. Sinir ağlarında yaygın olarak kullanılan softmax fonksiyonu, ham skorları koşullu olasılıklara dönüştürerek, giriş verileri verildiğinde her olası sınıfın olasılığını bize söyler.
Yaygın Tuzaklar ve Yanlış Yorumlamalar
Koşullu olasılıkla çalışırken, üç temel yanlış anlama sıklıkla hatalı sonuçlara yol açar.
- Tersine çevrim yanılgısı (inverse fallacy) ya da tersin karıştırılması, P(A|B) ile P(B|A)’yı birbirine karıştırdığımızda ortaya çıkar. Bunu tıbbi test örneğimizde gördük – pozitif test verildiğinde bir duruma sahip olma olasılığı, duruma sahip olduğunuzda pozitif test çıkma olasılığından farklıdır.
- Taban oranı ihmalidir (base rate neglect), koşullu olasılıklara odaklanıp bir olayın temel olasılığını göz ardı ettiğimizde meydana gelir. Örneğin, nadir bir hastalık yalnızca 10.000 kişide 1 kişiyi etkiliyorsa, hastalık çok nadir olduğu için son derece doğru bir test bile çoğunlukla yalancı pozitif üretebilir.
- Üçüncü tuzak, olasılıkları güncellerken kanıtı yanlış tartmayı içerir. İnsanlar genellikle yakın tarihli veya çarpıcı kanıtlara fazla ağırlık verirken, istikrarlı arka plan bilgilerini hafife alma eğilimindedir. Örneğin finansal işlemlerde, yatırımcılar uzun vadeli piyasa olasılıklarını görmezden gelip yakın piyasa haberlerine aşırı tepki verebilir.
İleri Konular ve Diğer Hususlar
Son olarak, pratiğini yaptığımız temellerin üzerine inşa edilen bazı daha karmaşık fikirlere bakalım.
Sıfır olasılıklı olaylara koşullama
Ayrık olasılık dağılımlarından sürekli dağılımlara geçtiğimizde ilginç bir zorlukla karşılaşırız: Sürekli bir dağılımdaki belirli noktaların olasılığı sıfırdır. Birinin tam boyunu ölçmeyi düşünün – birinin 170 ile 171 santimetre arasında olma olasılığı anlamlıdır; ancak tam olarak 170,5432... santimetre olma olasılığı teknik olarak sıfırdır. Yine de sıklıkla bu kadar kesin ölçümlere koşullamak isteriz. Düzenli koşullu olasılık, bu durumları ele almak için bir matematiksel çerçeve sağlar; temel kavramlarımızı yoğunluk fonksiyonları ve ölçü kuramı aracılığıyla sürekli durumlara genişletir. Bu genişleme, "tam olarak 170,5 santimetre boyunda olduğu verildiğinde bir kişinin ağırlığının olasılık dağılımı" gibi ifadeleri anlamlandırmamıza olanak tanır.
Kısmi koşullu olasılık ve genişletmeler
Jeffrey koşullaması, yeni kanıtımızın kesin olmadığı ancak kendi olasılığıyla geldiği durumlara geleneksel koşullu olasılığı genişletir. Standart koşullamada yeni bilgimiz hakkında mutlak kesinlik varsayarken, Jeffrey’nin kuralı belirsiz kanıtlara dayanarak inançlarımızı güncellememize olanak tanır. Bu, yeni bilgilerin çoğunlukla belirli bir belirsizlik derecesiyle geldiği gerçek dünya senaryolarıyla daha iyi örtüşür. Örneğin, bir tıbbi testin kesin olarak pozitif olduğunu bilmek yerine, pozitif olmasının %80 olası olduğunu öğrenebiliriz. Jeffrey’nin kuralı, bu daha incelikli durumlarda olasılıkları güncellemenin resmî bir yöntemini sağlar.
Sonuç
Koşullu olasılık, yeni bilgiler ortaya çıktıkça inançlarımızı güncellemek için bir matematiksel çerçeve sağlar. Bu makale boyunca, bu kavramın tıbbi teşhisten finansal risk değerlendirmesine kadar çeşitli alanlarda nasıl uygulandığını gördük. İncelediğimiz ilkeler, yeni kanıtlarla olasılığın nasıl değiştiğini anlamamıza yardımcı olur ve veri bilimi uygulamalarında daha bilinçli kararlar almamızı sağlar. Bu anlayış, olasılık güncellemelerinin sürekli gerçekleştiği sınıflandırma algoritmaları, risk modelleri ve makine öğrenimi sistemleriyle çalışırken özellikle değerlidir.
Olasılık ve istatistiksel çıkarım konularındaki uzmanlığınızı geliştirmeye devam ederken, bu kavramları Bayesyen bir bakış açısıyla derinleştirebilecek çeşitli kurslar mevcuttur. R ile Bayesyen Veri Analizinin Temelleri kursumuz, temel ilkeleri ve pratik uygulamalarını tanıtırken, RJAGS ile Bayesyen Modelleme kursumuz bu kavramları güçlü istatistiksel araçlarla nasıl uygulayacağınızı gösterir. Python kullanıcıları için, Python ile Bayesyen Veri Analizi kursumuz bu yöntemleri gerçek dünya problemlerine uygulamada uygulamalı deneyim sunar. Her kurs, modern veri biliminde olasılık ve uygulamalarına ilişkin bilginizi genişletmeniz için bir yol sağlar.





Bir e-posta için spam tespit sistemi geliştirdiğinizi hayal edin. Başlangıçta, belirli anahtar kelimeler içeriyorsa bir e-postayı şüpheli olarak işaretleyebilirsiniz. Peki ya bu e-postanın güvenilir bir gönderenden geldiğini öğrenseniz? Ya da olağandışı bir saatte gönderildiğini? Her yeni bilgi parçası, e-postanın spam olma olasılığını değiştirir. Yeni kanıtlara göre olasılıkların bu dinamik şekilde güncellenmesi, e-posta filtrelemeden dolandırıcılık tespitine kadar birçok modern veri bilimi uygulamasını güçlendiren bir kavram olan koşullu olasılığın özünde yatar.
Olasılık kavramlarıyla yolculuğuna yeni başlayanlar için, Olasılık Kurallarına Giriş Hızlı Referans temel ilkeler ve formüller için faydalı bir başvuru sunar. İstatistiğe Giriş kursu, olasılık dağılımları ve özelliklerini inceleyerek, koşullu olasılığın pratikte nasıl çalıştığını anlamanın temelini oluşturur. Bu kaynaklar, bu makalede ele alacağımız kavramlarda güçlü bir temel oluşturmak için yapılandırılmış bir yol sağlar.
Koşullu Olasılık Nedir?
Koşullu olasılık, bir olayın gerçekleşme olasılığını, başka bir olayın zaten gerçekleştiğini bildiğimizde ölçer. Bir olay hakkında yeni bilgi aldığımızda, olasılık hesaplarımızı buna göre ayarlarız.
Bu kavramı anlamak için iskambil kartlarıyla bir örnek inceleyelim. Standart bir desteden bir kart çektiğinizde 52 olası sonuç vardır. Bir papaz (king) çekmek istiyorsanız, destede dört papaz olduğundan başlangıç olasılığınız 4/52 (yaklaşık %7,7)’dir. Peki biri size çektiğiniz kartın bir resimli kart olduğunu söylerse ne olur? Bu yeni bilgi her şeyi değiştirir – artık elinizde papaz olma olasılığı 4/12 (yaklaşık %33,3) ile çok daha yüksektir; çünkü toplamda yalnızca on iki resimli kart vardır.
Olasılıklar arasındaki bu ilişkinin kesin bir matematiksel tanımı vardır:
Bu formül koşullu olasılığı hesaplamamıza yardımcı olur; burada:
Kart örneğimizde:
Koşullu olasılığın pratikte nasıl çalıştığını daha iyi anlamak için bir ağaç diyagramı kullanabiliriz. Ağaç diyagramları özellikle faydalıdır; çünkü her yeni bilginin olasılıklarımızı nasıl değiştirdiğini gösterir:
Bu ağaç diyagramının nasıl çalıştığını adım adım inceleyelim:
Ağaç diyagramı, koşullu olasılıktaki birkaç temel kavramı anlamamıza yardımcı olur:
Koşullu olasılığın güzelliği, yeni bilgiler edindikçe olasılıklarımızı güncellememize olanak tanımasıdır. Resimli kartımız olduğunu öğrendiğimizde papaz olma olasılığımızı %7,7’den %33,3’e nasıl ayarladıysak, koşullu olasılık da yeni kanıtlara dayanarak olasılıkları yeniden hesaplamanın resmî bir yolunu sunar.
Koşullu Olasılık Formülü
Koşullu olasılığın matematiksel yapısı, birden çok olayı içeren karmaşık senaryoları analiz etmemiz için araçlar sağlar. Temel özellikleri inceleyelim.
Koşullu olasılığın temel özellikleri
Bu matematiksel özellikler, karmaşık problemleri daha verimli çözmemize yardımcı olur:
1. Bağımsızlık özelliği
İki olay A ve B bağımsız olduğunda, birinin gerçekleşmesi diğerinin olasılığını etkilemez. Matematiksel olarak: P(A|B) = P(A). Bu, "B verildiğinde A’nın olasılığı, A’nın olasılığına eşittir" şeklinde okunur.
Örneğin, bir zar atıp bir madeni para çevirdiğimizde, parada yazı-tura sonucunun tura gelmesi, altı gelme olasılığını değiştirmez. Formül bize şunu gösterir: P(Altı|Tura) = P(Altı) = 1/6
2. Tümleyenin (tamamlayanın) kuralı
B koşulu verildiğinde herhangi bir A olayı için, A ve onun tümleyeni A' ("A üst" olarak okunur) olasılıklarının toplamı 1 olmalıdır. Matematiksel olarak: P(A|B) + P(A'|B) = 1; bu, “B verildiğinde A’nın olasılığı ile B verildiğinde A’nın tümleyeni olasılığının toplamı 1’e eşittir” şeklinde okunur.
Önceki kart örneğimizde: P(Papaz|Resimli Kart) + P(Papaz Değil|Resimli Kart) = 4/12 + 8/12 = 1
Çarpma kuralı ve zincir kuralı
Çarpma kuralı, ortak olasılıkları koşullu olasılıklarla ilişkilendirir: P(A ∩ B) = P(A|B) × P(B). "A kesişim B’nin olasılığı, B verildiğinde A’nın olasılığı ile B’nin olasılığının çarpımına eşittir" deriz.
Bu, çoklu olaylara zincir kuralıyla genişler. Üç olay A, B ve C için: P(A ∩ B ∩ C) = P(A|B ∩ C) × P(B|C) × P(C). Yani, "A kesişim B kesişim C’nin olasılığı, B kesişim C verildiğinde A’nın olasılığı ile C verildiğinde B’nin olasılığı ve C’nin olasılığının çarpımına eşittir."
Bunu bir kart çekme dizisiyle uygulamalı görelim:
P(K ∩ Q ∩ A) = P(A|K ∩ Q) × P(Q|K) × P(K) = (4/50) × (4/51) × (4/52)
Zincir kuralı, özellikle birden çok değişken arasındaki karmaşık bağımlılıkları modellememiz gerektiği Bayesyen ağlarda, makine öğreniminde çok değerlidir. Verileri analiz ederken, olayların doğal bir sırayı izlediği durumlarla sıkça karşılaşırız ve zincir kuralı, bu karmaşık senaryoları daha basit ve yönetilebilir hesaplamalara ayrıştırmamıza yardımcı olur.
Koşullu Olasılığı Açıklayan Örnekler
En yaygın iki örneği gözden geçirelim ve koşullu olasılığın işinizde nasıl karşınıza çıkabileceğini de düşünelim.
Klasik örnekler
Bu iki örnek çok yaygındır ve özellikle mülakata giriyorsanız çalışmaya değerdir:
Zar atışları: Azalmış örnek uzaylarını anlamak
Bir zar attığımızda örnek uzayımız altı olasılıkla başlar: {1, 2, 3, 4, 5, 6}. Atış hakkında kısmi bilgi edinmek, olasılık hesaplarımızı belirli bir şekilde değiştirir. Nasıl olduğuna bakalım:
6 gelme başlangıç olasılığı: P(6) = 1/6
Atışın çift olduğunu öğrenirsek, örnek uzayımız {2, 4, 6}’ya iner: P(6 | çift) = 1/3
Bilyeler: Art arda bağımlılıklar
Bir torbada 5 mavi ve 3 kırmızı bilye vardır. Yerine koymadan bilye çektiğimizde, her çekiş sonraki çekişlerin olasılıklarını etkiler.
İlk çekiş – mavinin olasılığı: P(mavi₁) = 5/8
İkinci çekiş, ilki mavi ise: P(mavi₂ | mavi₁) = 4/7
Bu örnek, art arda bağımlılıkları vurgulayarak önceki kart örneğimizi tamamlar.
Gerçek dünya örnekleri
Tıbbi testler: Test doğruluğunu değerlendirme
Tıbbi testler, test doğruluğunu değerlendirmede koşullu olasılığın mükemmel bir uygulamasını sunar. Her teşhis testi için dört temel koşullu olasılığı anlamamız gerekir:
Bu testin performansını değerlendirirken, sağlık profesyonelleri bu koşullu olasılıkları şunlar için kullanır:
Örneğin, 1000 hastayı test edip 100 pozitif sonuç alırsak, kaçının gerçek pozitif, kaçının yalancı pozitif olduğunu tahmin etmek için bu koşullu olasılıkları kullanabiliriz. Bu analiz, sağlık profesyonellerinin bir tanıyı atlama riskini, yanlış alarmların maliyeti ve yarattığı kaygıyla dengelemesine yardımcı olur.
Finansal risk değerlendirmesi
Yatırım şirketleri, piyasa risklerini değerlendirmek için koşullu olasılığı kullanır. Piyasa oynaklığını izleyen bir portföy yöneticisini düşünün:
Günlük piyasa oynaklığı Düşük (L), Orta (M) veya Yüksek (H) olabilir.
Tarihsel veriler şunu gösterir:
Bu bilgiler yöneticilere şunlarda yardımcı olur:
Koşullu Olasılık ve Bayes Teoremi
Tıbbi testlerle ilgili incelememiz önemli bir ayrımı vurguladı: Pozitif test verildiğinde hastalığa sahip olma olasılığı, hastalığa sahip olunduğunda pozitif test çıkma olasılığından farklıdır. Bayes Teoremi, bu ilişkiyi yönetmek için resmî bir çerçeve sunar ve yeni kanıtlar ortaya çıktıkça olasılık tahminlerimizi güncellemeye olanak tanır.
Bayes Teoremini Anlamak
Bayes Teoremi, iki koşullu olasılık arasındaki ilişkiyi ifade eder: P(A|B) = [P(B|A) × P(A)] / P(B). Bu denklemi şöyle okuruz: "B verildiğinde A’nın olasılığı, A verildiğinde B’nin olasılığı ile A’nın olasılığının çarpımının, B’nin olasılığına bölünmesine eşittir."
Her bileşenin bir rolü vardır:
Bunun pratikte nasıl çalıştığını, artık tam Bayesyen analizini gösterecek şekilde genişlettiğimiz tıbbi test senaryomuzla görelim.
Bir tıbbi test örneği
Nüfusun %2’sini etkileyen bir tıbbi durumu ele alalım. Yeni bir teşhis testinin özellikleri:
Bir hasta pozitif çıktığında, bu kişi hakkındaki inancımızı nasıl güncellemeliyiz?
Bunu adım adım çözelim:
Bu analiz, pozitif bir test sonucuyla bile duruma sahip olma olasılığının yalnızca yaklaşık %16,2 olduğunu ortaya koyar – başlangıçtaki %2’den çok daha yüksek, ancak sezginin öngörebileceğinden belki daha düşüktür.
Bayesyen güncellemenin gücü
Bayes Teoremi, birden fazla kanıt aldığımızda parıldar. Her hesaplamanın art-olasılığı, bir sonraki güncelleme için önsel olur. Örneğin, hastamız ikinci kez pozitif çıkarsa:
Bu sıralı güncelleme, yeni kanıtları olasılık tahminlerimize dahil etmek için matematiksel bir çerçeve sunar. Bayesyen çıkarımın güzelliği, yeni bilgiler topladıkça inançlarımızın nasıl değişmesi gerektiğini nicelleştirebilmesinde yatar; kanıtlar ışığında olasılıkları güncellemenin resmî bir yöntemini sağlar.
Veri Biliminde Uygulamalar
Koşullu olasılığın veri biliminde nasıl karşımıza çıktığına bakalım.
Öngörücü modelleme
Naive Bayes sınıflandırıcı, makine öğreniminin en yalın ama güçlü araçlarından biri olarak, özellik olasılıklarına dayanarak kategorileri tahmin etmek için Bayes Teoremi’ni uygular. Örneğin, bir e-postayı spam veya spam değil olarak sınıflandırırken, algoritma, içerdiği kelimeler verildiğinde e-postanın spam olma koşullu olasılığını hesaplar. Özelliklerin bağımsız olduğu yönündeki "naif" varsayımı yapsa da, bu basitleştirme pratikte çoğu zaman şaşırtıcı derecede iyi çalışır.
Karar ağaçları koşullu olasılığa farklı bir yaklaşım getirir; verileri özellik değerlerine göre böler ve koşullu alt kümeler oluşturur. Her düğümde ağaç, "Bu belirli özellik değeri verildiğinde hedef değişkenimizin olasılığı nedir?" gibi sorular sorar. Bu bölmeler, saf veya neredeyse saf alt kümelere ulaşana kadar devam eder; esasen tahminlerimizi yönlendiren koşullu olasılıkların bir haritasını oluşturur.
Risk yönetimi
Kredi puanlama sistemleri, çeşitli müşteri özellikleri verildiğinde temerrüt olasılığını değerlendirmek için koşullu olasılıkları kullanır. Örneğin, bir banka gelir düzeyi, kredi geçmişi ve istihdam durumu verildiğinde temerrüt olasılığını hesaplayabilir. Bu hesaplamalar, bir durgunluk ve faiz artışı birlikte gerçekleştiğinde ipotek temerrüt olasılığının nasıl değişebileceği gibi, birden çok bağımlı riski dikkate aldığımızda daha sofistike hale gelir. Yatırım risk modelleri, mevcut piyasa koşulları verildiğinde belirli kayıp seviyelerinin olasılığını hesaplayarak Riskteki Değer’i (VaR) tahmin etmek için koşullu olasılıkları kullanır. Portföy yöneticileri, portföydeki diğer yatırım araçlarının performansı verildiğinde bir yatırımın riskinin nasıl değişebileceğini anlayarak varlık tahsislerini bu koşullu olasılıklara göre ayarlar.
Makine öğrenimi
Bayesyen ağlar, değişkenler arasındaki ilişkileri, her düğümün durumunun ebeveynlerine bağlı olduğu yönlendirilmiş bir grafik olarak modelleyerek, koşullu olasılığın makine öğrenimindeki en doğrudan uygulamasını temsil eder. Bu ağlar, çeşitli koşulların olasılığının çoklu ve birbiriyle bağlantılı semptomlar ve test sonuçlarına bağlı olduğu tıbbi teşhis gibi görevlerde mükemmeldir.
Olasılıksal grafik modelleri, verilerdeki karmaşık ilişkileri temsil etmek için koşullu bağımlılıkları kullanır; bu da onları görüntü tanıma ve doğal dil işleme gibi görevler için değerli kılar. Açıkça olasılıksal olmasalar da, derin öğrenme modelleri sınıflandırma yaparken son katmanlarında koşullu olasılıklar üretir. Sinir ağlarında yaygın olarak kullanılan softmax fonksiyonu, ham skorları koşullu olasılıklara dönüştürerek, giriş verileri verildiğinde her olası sınıfın olasılığını bize söyler.
Yaygın Tuzaklar ve Yanlış Yorumlamalar
Koşullu olasılıkla çalışırken, üç temel yanlış anlama sıklıkla hatalı sonuçlara yol açar.
İleri Konular ve Diğer Hususlar
Son olarak, pratiğini yaptığımız temellerin üzerine inşa edilen bazı daha karmaşık fikirlere bakalım.
Sıfır olasılıklı olaylara koşullama
Ayrık olasılık dağılımlarından sürekli dağılımlara geçtiğimizde ilginç bir zorlukla karşılaşırız: Sürekli bir dağılımdaki belirli noktaların olasılığı sıfırdır. Birinin tam boyunu ölçmeyi düşünün – birinin 170 ile 171 santimetre arasında olma olasılığı anlamlıdır; ancak tam olarak 170,5432... santimetre olma olasılığı teknik olarak sıfırdır. Yine de sıklıkla bu kadar kesin ölçümlere koşullamak isteriz. Düzenli koşullu olasılık, bu durumları ele almak için bir matematiksel çerçeve sağlar; temel kavramlarımızı yoğunluk fonksiyonları ve ölçü kuramı aracılığıyla sürekli durumlara genişletir. Bu genişleme, "tam olarak 170,5 santimetre boyunda olduğu verildiğinde bir kişinin ağırlığının olasılık dağılımı" gibi ifadeleri anlamlandırmamıza olanak tanır.
Kısmi koşullu olasılık ve genişletmeler
Jeffrey koşullaması, yeni kanıtımızın kesin olmadığı ancak kendi olasılığıyla geldiği durumlara geleneksel koşullu olasılığı genişletir. Standart koşullamada yeni bilgimiz hakkında mutlak kesinlik varsayarken, Jeffrey’nin kuralı belirsiz kanıtlara dayanarak inançlarımızı güncellememize olanak tanır. Bu, yeni bilgilerin çoğunlukla belirli bir belirsizlik derecesiyle geldiği gerçek dünya senaryolarıyla daha iyi örtüşür. Örneğin, bir tıbbi testin kesin olarak pozitif olduğunu bilmek yerine, pozitif olmasının %80 olası olduğunu öğrenebiliriz. Jeffrey’nin kuralı, bu daha incelikli durumlarda olasılıkları güncellemenin resmî bir yöntemini sağlar.
Sonuç
Koşullu olasılık, yeni bilgiler ortaya çıktıkça inançlarımızı güncellemek için bir matematiksel çerçeve sağlar. Bu makale boyunca, bu kavramın tıbbi teşhisten finansal risk değerlendirmesine kadar çeşitli alanlarda nasıl uygulandığını gördük. İncelediğimiz ilkeler, yeni kanıtlarla olasılığın nasıl değiştiğini anlamamıza yardımcı olur ve veri bilimi uygulamalarında daha bilinçli kararlar almamızı sağlar. Bu anlayış, olasılık güncellemelerinin sürekli gerçekleştiği sınıflandırma algoritmaları, risk modelleri ve makine öğrenimi sistemleriyle çalışırken özellikle değerlidir.
Olasılık ve istatistiksel çıkarım konularındaki uzmanlığınızı geliştirmeye devam ederken, bu kavramları Bayesyen bir bakış açısıyla derinleştirebilecek çeşitli kurslar mevcuttur. R ile Bayesyen Veri Analizinin Temelleri kursumuz, temel ilkeleri ve pratik uygulamalarını tanıtırken, RJAGS ile Bayesyen Modelleme kursumuz bu kavramları güçlü istatistiksel araçlarla nasıl uygulayacağınızı gösterir. Python kullanıcıları için, Python ile Bayesyen Veri Analizi kursumuz bu yöntemleri gerçek dünya problemlerine uygulamada uygulamalı deneyim sunar. Her kurs, modern veri biliminde olasılık ve uygulamalarına ilişkin bilginizi genişletmeniz için bir yol sağlar.