
Last chance! 50% off DataCamp Premium
Sale ends in
Bayangkan Anda sedang mengembangkan sistem deteksi spam untuk email. Awalnya, Anda mungkin menandai email sebagai mencurigakan jika berisi kata kunci tertentu. Namun bagaimana jika Anda mengetahui email ini berasal dari pengirim tepercaya? Atau jika email tersebut dikirim pada jam yang tidak biasa? Setiap informasi baru mengubah probabilitas email tersebut merupakan spam. Pemutakhiran probabilitas secara dinamis berdasarkan bukti baru inilah inti dari probabilitas bersyarat, konsep yang menggerakkan banyak aplikasi data science modern, dari penyaringan email hingga deteksi penipuan.
Bagi yang baru mulai mempelajari konsep probabilitas, Introduction to Probability Rules Cheat Sheet menyediakan referensi yang membantu untuk prinsip dan rumus inti. Kursus Introduction to Statistics membangun fondasi yang kuat dengan mengeksplorasi distribusi probabilitas dan sifat-sifatnya, yang menjadi dasar untuk memahami cara kerja probabilitas bersyarat dalam praktik. Sumber daya ini menawarkan jalur terstruktur untuk membangun fundamental yang kuat atas konsep-konsep yang akan kita bahas dalam artikel ini.
Probabilitas bersyarat mengukur seberapa besar kemungkinan suatu peristiwa terjadi ketika kita mengetahui peristiwa lain sudah terjadi. Saat kita menerima informasi baru tentang suatu peristiwa, kita menyesuaikan perhitungan probabilitas kita sesuai dengan itu.
Untuk memahami konsep ini, mari kita eksplorasi contoh dengan kartu remi. Ketika Anda menarik satu kartu dari setumpuk standar, ada 52 kemungkinan hasil. Jika Anda ingin menarik raja, probabilitas awalnya adalah 4/52 (sekitar 7,7%) karena ada empat raja dalam satu setumpuk. Namun bagaimana jika seseorang memberi tahu Anda bahwa kartu yang Anda ambil adalah kartu bergambar (face card)? Informasi baru ini mengubah segalanya — probabilitas Anda memiliki raja kini jauh lebih tinggi yaitu 4/12 (sekitar 33,3%), karena hanya ada dua belas kartu bergambar secara total.
Hubungan antara probabilitas ini memiliki definisi matematis yang tepat:
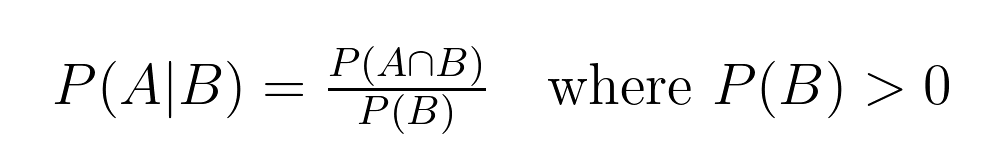
Rumus ini membantu kita menghitung probabilitas bersyarat, di mana:
Dalam contoh kartu kita:
Untuk lebih memahami bagaimana probabilitas bersyarat bekerja dalam praktik, kita dapat menggunakan diagram pohon. Diagram pohon sangat membantu karena menunjukkan bagaimana setiap potongan informasi baru mengubah probabilitas kita:
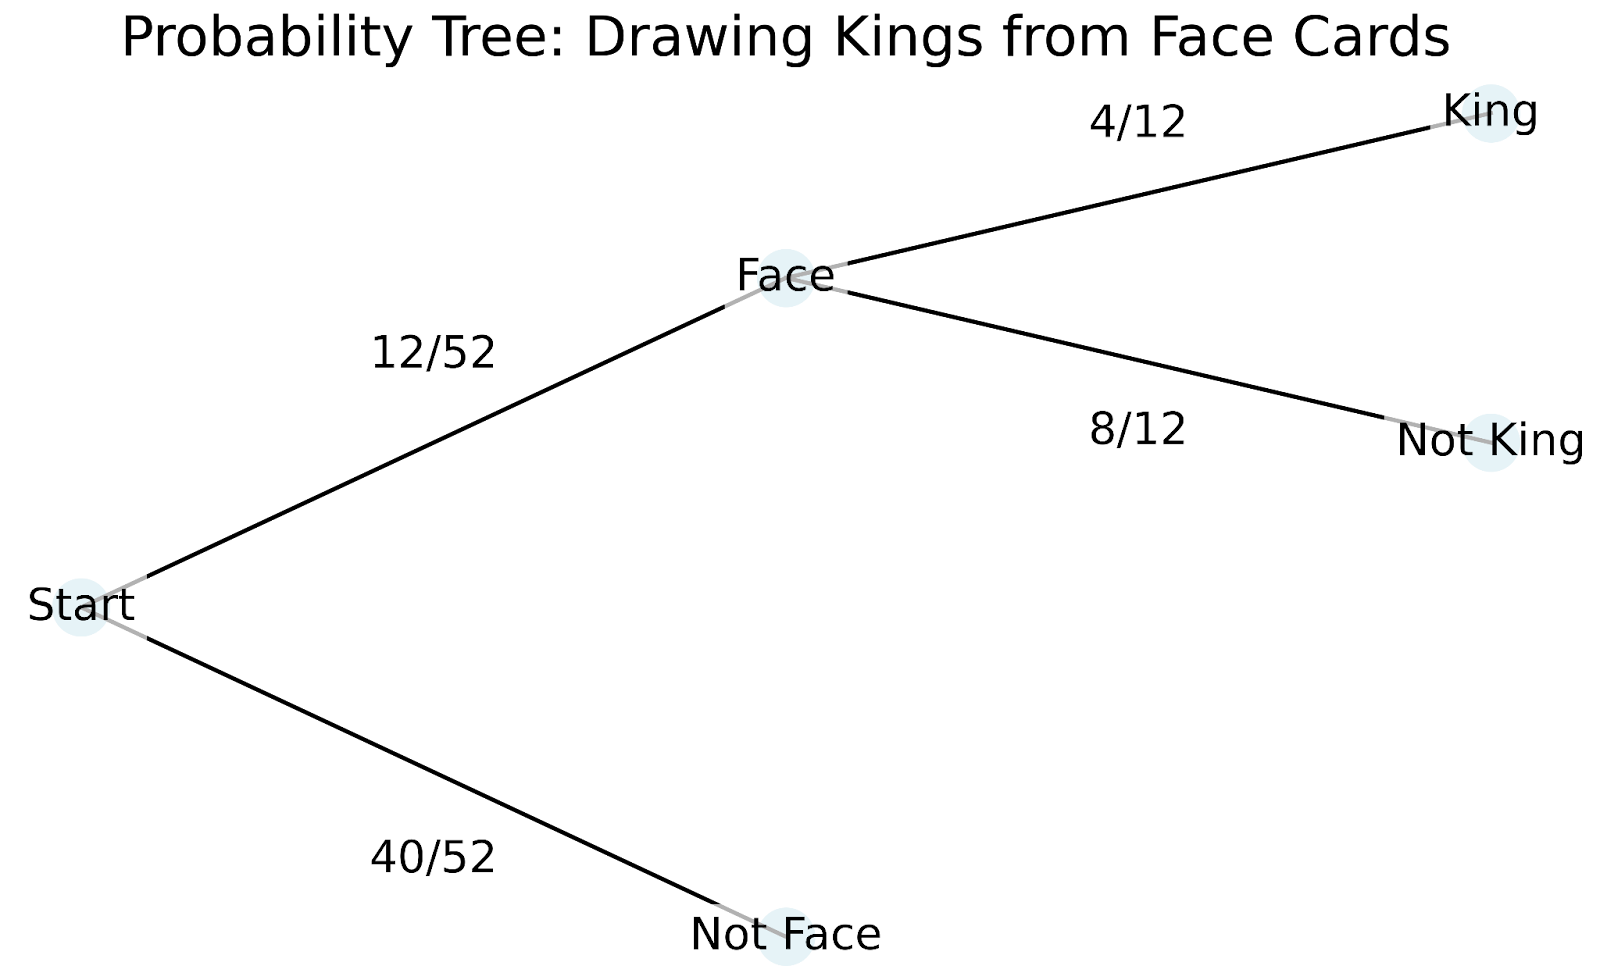
Mari kita telusuri cara kerja diagram pohon ini:
Diagram pohon membantu kita memahami beberapa konsep kunci dalam probabilitas bersyarat:
Keindahan probabilitas bersyarat adalah kemampuannya untuk memperbarui probabilitas seiring kita memperoleh informasi baru. Sama seperti kita menyesuaikan probabilitas memiliki raja dari 7,7% menjadi 33,3% saat mengetahui kita memiliki kartu bergambar, probabilitas bersyarat memberi kita cara formal untuk menghitung ulang probabilitas berdasarkan bukti baru.
Struktur matematis probabilitas bersyarat memberi kita alat untuk menganalisis skenario kompleks yang melibatkan banyak peristiwa. Mari kita jelajahi sifat-sifat kuncinya.
Sifat-sifat matematis ini membantu kita menyelesaikan masalah kompleks dengan lebih efisien:
Ketika dua peristiwa A dan B saling bebas, kita tahu bahwa terjadinya salah satunya tidak memengaruhi probabilitas yang lain. Secara matematis: P(A|B) = P(A), yang dibaca: "probabilitas A diberikan B sama dengan probabilitas A."
Sebagai contoh, jika kita melempar dadu dan melempar koin, mendapatkan gambar pada koin tidak mengubah probabilitas mendapatkan enam pada dadu. Rumusnya menunjukkan: P(Enam|Gambar) = P(Enam) = 1/6
Untuk sembarang peristiwa A dengan syarat B, probabilitas A dan komplemennya A' (dibaca "A prime") harus berjumlah 1. Secara matematis: P(A|B) + P(A'|B) = 1, yang dibaca: “Probabilitas A diberikan B ditambah probabilitas komplemen A diberikan B sama dengan 1.”
Dalam contoh kartu sebelumnya: P(Raja|Kartu Bergambar) + P(Bukan Raja|Kartu Bergambar) = 4/12 + 8/12 = 1
Aturan perkalian mengaitkan probabilitas gabungan dengan probabilitas bersyarat: P(A ∩ B) = P(A|B) × P(B). Kita mengatakan, "Probabilitas A irisan B sama dengan probabilitas A diberikan B dikali probabilitas B."
Ini meluas ke banyak peristiwa melalui aturan rantai. Untuk tiga peristiwa A, B, dan C: P(A ∩ B ∩ C) = P(A|B ∩ C) × P(B|C) × P(C). Artinya, "Probabilitas A irisan B irisan C sama dengan probabilitas A diberikan B irisan C dikali probabilitas B diberikan C dikali probabilitas C."
Mari kita lihat ini dalam aksi dengan urutan pengambilan kartu:
P(K ∩ Q ∩ A) = P(A|K ∩ Q) × P(Q|K) × P(K) = (4/50) × (4/51) × (4/52)
Aturan rantai menjadi sangat berharga dalam machine learning, khususnya dalam jaringan Bayesian di mana kita perlu memodelkan ketergantungan kompleks antara banyak variabel. Saat menganalisis data, kita sering menjumpai situasi di mana peristiwa mengikuti urutan alami, dan aturan rantai membantu kita menguraikan skenario kompleks ini menjadi perhitungan yang lebih sederhana dan mudah ditangani.
Mari kita tinjau dua contoh paling umum dan pikirkan juga bagaimana probabilitas bersyarat mungkin muncul dalam pekerjaan Anda.
Dua contoh ini sangat umum dan layak dipelajari, terutama jika Anda sedang menghadapi wawancara:
Saat kita melempar dadu, ruang sampel kita dimulai dengan enam kemungkinan: {1, 2, 3, 4, 5, 6}. Mengetahui sebagian informasi tentang hasil lemparan mengubah perhitungan probabilitas kita dengan cara tertentu. Mari kita lihat caranya:
Probabilitas awal mendapatkan 6: P(6) = 1/6
Jika kita tahu hasilnya genap, ruang sampel menyusut menjadi {2, 4, 6}: P(6 | genap) = 1/3
Sebuah kantong berisi 5 kelereng biru dan 3 kelereng merah. Saat kita mengambil kelereng tanpa pengembalian, setiap pengambilan memengaruhi probabilitas pengambilan berikutnya.
Pengambilan pertama - probabilitas biru: P(biru₁) = 5/8
Pengambilan kedua, dengan asumsi pertama biru: P(biru₂ | biru₁) = 4/7
Contoh ini melengkapi contoh kartu sebelumnya dengan menyoroti ketergantungan berurutan.
Tes medis adalah aplikasi sempurna dari probabilitas bersyarat dalam menilai akurasi tes. Untuk tes diagnostik apa pun, kita perlu memahami empat probabilitas bersyarat kunci:
Saat mengevaluasi kinerja tes ini, tenaga medis menggunakan probabilitas bersyarat ini untuk:
Misalnya, jika kita menguji 1000 pasien dan mendapatkan 100 hasil positif, kita dapat menggunakan probabilitas bersyarat ini untuk memperkirakan berapa banyak yang benar-benar positif versus positif palsu. Analisis ini membantu tenaga medis menyeimbangkan risiko melewatkan diagnosis dengan biaya dan kecemasan akibat alarm palsu.
Perusahaan investasi menggunakan probabilitas bersyarat untuk mengevaluasi risiko pasar. Pertimbangkan seorang manajer portofolio yang melacak volatilitas pasar:
Volatilitas pasar harian dapat Rendah (L), Sedang (M), atau Tinggi (H).
Data historis menunjukkan:
Informasi ini membantu manajer untuk:
Pembahasan kita tentang pengujian medis menyoroti perbedaan penting: Probabilitas memiliki penyakit dengan asumsi tes positif berbeda dari probabilitas tes positif dengan asumsi memiliki penyakit. Teorema Bayes menyediakan kerangka formal untuk menavigasi hubungan ini, memungkinkan kita memperbarui estimasi probabilitas saat bukti baru muncul.
Teorema Bayes mengekspresikan hubungan antara dua probabilitas bersyarat: P(A|B) = [P(B|A) × P(A)] / P(B). Kita membaca persamaan ini demikian: "Probabilitas A diberikan B sama dengan probabilitas B diberikan A dikali probabilitas A, dibagi dengan probabilitas B."
Setiap komponen memiliki peran:
Mari kita lihat bagaimana ini bekerja dalam praktik dengan skenario pengujian medis kita, kini diperluas untuk menunjukkan analisis Bayesian lengkap.
Pertimbangkan suatu kondisi medis yang menyerang 2% populasi. Sebuah tes diagnostik baru memiliki:
Ketika seorang pasien mendapat hasil positif, bagaimana kita harus memperbarui keyakinan tentang kondisinya?
Mari kita selesaikan langkah demi langkah:
Analisis ini mengungkapkan bahwa meskipun hasilnya positif, probabilitas memiliki kondisi tersebut hanya sekitar 16,2% — jauh lebih tinggi daripada 2% awal, namun mungkin lebih rendah daripada yang diperkirakan secara intuitif.
Teorema Bayes bersinar ketika kita menerima beberapa potong bukti. Probabilitas posterior dari setiap perhitungan menjadi probabilitas prior untuk pembaruan berikutnya. Misalnya, jika pasien kita mendapatkan tes positif kedua:
Pembaruan berurutan ini menyediakan kerangka matematis untuk memasukkan bukti baru ke dalam estimasi probabilitas kita. Keindahan inferensi Bayesian terletak pada kemampuannya untuk mengkuantifikasi bagaimana keyakinan kita seharusnya berubah saat kita mengumpulkan informasi baru, menyediakan metode formal untuk memperbarui probabilitas berdasarkan bukti.
Mari kita lihat bagaimana probabilitas bersyarat muncul dalam data science.
Klasifikator Naive Bayes, salah satu alat yang paling sederhana namun kuat dalam machine learning, menerapkan Teorema Bayes untuk memprediksi kategori berdasarkan probabilitas fitur. Saat mengklasifikasikan email sebagai spam atau bukan spam, misalnya, algoritma menghitung probabilitas bersyarat sebuah email merupakan spam mengingat kata-kata yang dikandungnya. Meski membuat asumsi "naif" bahwa fitur saling bebas, penyederhanaan ini sering kali bekerja sangat baik dalam praktik.
Pohon keputusan mengambil pendekatan berbeda terhadap probabilitas bersyarat, dengan membagi data berdasarkan nilai fitur untuk membuat subset bersyarat. Pada setiap simpul, pohon mengajukan pertanyaan seperti "Berapa probabilitas variabel target kita mengingat nilai fitur tertentu ini?" Pembagian ini berlanjut hingga kita mencapai subset yang murni atau hampir murni, pada dasarnya membuat peta probabilitas bersyarat yang memandu prediksi kita.
Sistem skor kredit menggunakan probabilitas bersyarat untuk mengevaluasi kemungkinan gagal bayar pinjaman mengingat berbagai karakteristik nasabah. Misalnya, bank dapat menghitung probabilitas gagal bayar dengan mempertimbangkan tingkat pendapatan, riwayat kredit, dan status pekerjaan. Perhitungan ini menjadi lebih canggih saat mempertimbangkan banyak risiko yang saling bergantung, seperti bagaimana probabilitas gagal bayar hipotek dapat berubah jika terjadi resesi dan kenaikan suku bunga sekaligus. Model risiko investasi menggunakan probabilitas bersyarat untuk memperkirakan Value at Risk (VaR), dengan menghitung probabilitas tingkat kerugian tertentu mengingat kondisi pasar saat ini. Manajer portofolio menggunakan probabilitas bersyarat ini untuk menyesuaikan alokasi aset, memahami bagaimana risiko satu investasi dapat berubah mengingat kinerja investasi lain dalam portofolio.
Jaringan Bayesian merupakan aplikasi paling langsung dari probabilitas bersyarat dalam machine learning, memodelkan hubungan antar variabel sebagai graf berarah di mana keadaan setiap simpul bergantung pada "orang tua"-nya. Jaringan ini unggul untuk tugas seperti diagnosis medis, di mana probabilitas berbagai kondisi bergantung pada banyak gejala dan hasil tes yang saling terkait.
Probabilistic graphical models menggunakan ketergantungan bersyarat untuk merepresentasikan hubungan kompleks dalam data, sehingga berguna untuk tugas seperti pengenalan gambar dan pemrosesan bahasa alami. Bahkan model deep learning, meskipun tidak secara eksplisit probabilistik, menghasilkan probabilitas bersyarat di lapisan akhirnya saat melakukan klasifikasi. Fungsi softmax, yang umum digunakan dalam jaringan saraf, mengubah skor mentah menjadi probabilitas bersyarat, memberi tahu kita kemungkinan setiap kelas yang mungkin mengingat data masukan.
Saat bekerja dengan probabilitas bersyarat, tiga kesalahpahaman utama sering kali mengarah pada kesimpulan yang keliru.
Terakhir, mari kita lihat beberapa gagasan yang lebih rumit yang dibangun dari apa yang telah kita praktikkan.
Saat kita berpindah dari distribusi probabilitas diskret ke kontinu, kita menghadapi tantangan menarik: titik tertentu dalam distribusi kontinu memiliki probabilitas nol. Pertimbangkan mengukur tinggi seseorang secara tepat — meskipun kita bisa mengatakan probabilitas seseorang memiliki tinggi antara 170 dan 171 sentimeter itu bermakna, probabilitas seseorang memiliki tinggi tepat 170,5432... sentimeter secara teknis adalah nol. Namun kita sering ingin melakukan pengkondisian pada pengukuran setepat itu. Probabilitas bersyarat reguler menyediakan kerangka matematis untuk menangani situasi ini, memperluas konsep dasar kita ke kasus kontinu melalui penggunaan fungsi densitas dan teori ukuran (measure theory). Perluasan ini memungkinkan kita memaknai pernyataan seperti "distribusi probabilitas berat seseorang, dengan asumsi tinggi badannya tepat 170,5 sentimeter."
Jeffrey conditionalization memperluas probabilitas bersyarat tradisional ke situasi di mana bukti baru kita tidak pasti tetapi memiliki probabilitasnya sendiri. Berbeda dengan pengkondisian standar yang mengasumsikan kepastian absolut atas informasi baru, aturan Jeffrey memungkinkan kita memperbarui keyakinan berdasarkan bukti yang tidak pasti. Ini lebih cocok dengan skenario dunia nyata di mana informasi baru sering disertai tingkat ketidakpastian. Misalnya, alih-alih mengetahui dengan pasti bahwa tes medis positif, kita mungkin mengetahui bahwa kemungkinan positif adalah 80%. Aturan Jeffrey menyediakan metode formal untuk memperbarui probabilitas dalam situasi yang lebih bernuansa ini.
Probabilitas bersyarat menyediakan kerangka matematis untuk memperbarui keyakinan kita ketika informasi baru muncul. Sepanjang artikel ini, kita telah melihat bagaimana konsep ini berlaku di berbagai bidang, dari diagnosis medis hingga penilaian risiko finansial. Prinsip-prinsip yang kita jelajahi membantu kita memahami bagaimana probabilitas berubah dengan bukti baru, sehingga memungkinkan pengambilan keputusan yang lebih tepat dalam aplikasi data science. Pemahaman ini menjadi sangat berharga saat bekerja dengan algoritma klasifikasi, model risiko, dan sistem machine learning di mana pembaruan probabilitas terjadi secara terus-menerus.
Saat Anda terus membangun keahlian dalam probabilitas dan inferensi statistik, beberapa kursus dapat meningkatkan pemahaman Anda tentang konsep-konsep ini melalui lensa Bayesian. Kursus Fundamentals of Bayesian Data Analysis in R kami memperkenalkan prinsip-prinsip kunci dan penerapannya secara praktis, sementara kursus Bayesian Modeling with RJAGS menunjukkan cara mengimplementasikan konsep-konsep ini menggunakan alat statistik yang andal. Bagi pengguna Python, kursus Bayesian Data Analysis in Python kami menawarkan pengalaman langsung menerapkan metode ini pada masalah dunia nyata. Setiap kursus menyediakan jalur untuk memperluas pengetahuan Anda mengenai probabilitas dan penerapannya dalam data science modern.
Belajar bersama DataCamp
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt




