Vai al contenuto principale

ELT spiegato: l’integrazione dei dati nell’era del cloud

Scopri il processo ELT (Extract, Load, Transform) e il suo ruolo nell’architettura dati moderna. Impara come l’ELT migliora l’integrazione e l’elaborazione dei dati.
Aggiornato 29 set 2026  · 7 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

Il panorama dell’architettura dei dati sta evolvendo, spinto dal crescente uso delle tecnologie cloud e dall’adozione del modern data stack. Di conseguenza, i processi ELT sono sempre più diffusi. Ma in cosa consiste esattamente questo processo?

In questo articolo esploreremo l’ELT e il suo ruolo nelle architetture dati avanzate.

Che cos’è l’ELT?

ELT sta per Extract, Load, Transform. È un processo di integrazione dei dati che prevede l’estrazione dei dati da varie fonti, il caricamento in un sistema di archiviazione e la trasformazione in un formato facilmente analizzabile.

Il processo ELT è ampiamente utilizzato nelle architetture del modern data stack, dove i dati vengono archiviati, trasformati e analizzati in un data lake o in un data warehouse.

Come funziona l’ELT?

Come suggerisce il nome, l’ELT prevede tre passaggi principali: Extract, Load e Transform. Vediamo ogni passaggio più nel dettaglio.

1. Extract

Il primo passaggio del processo ELT è l’estrazione dei dati da diverse fonti come database, file, API o servizi web. Questo può essere fatto con strumenti ELT dedicati o con script personalizzati scritti dagli sviluppatori.

Alcuni esempi di piattaforme per l’estrazione dei dati includono Airbyte e Fivetran. Per scrivere script personalizzati, Apache Spark e Python sono ampiamente utilizzati. 

I dati estratti possono essere strutturati, semi-strutturati o non strutturati e possono provenire da diversi tipi di sistemi, come database relazionali, database NoSQL o archiviazione cloud.

2. Load

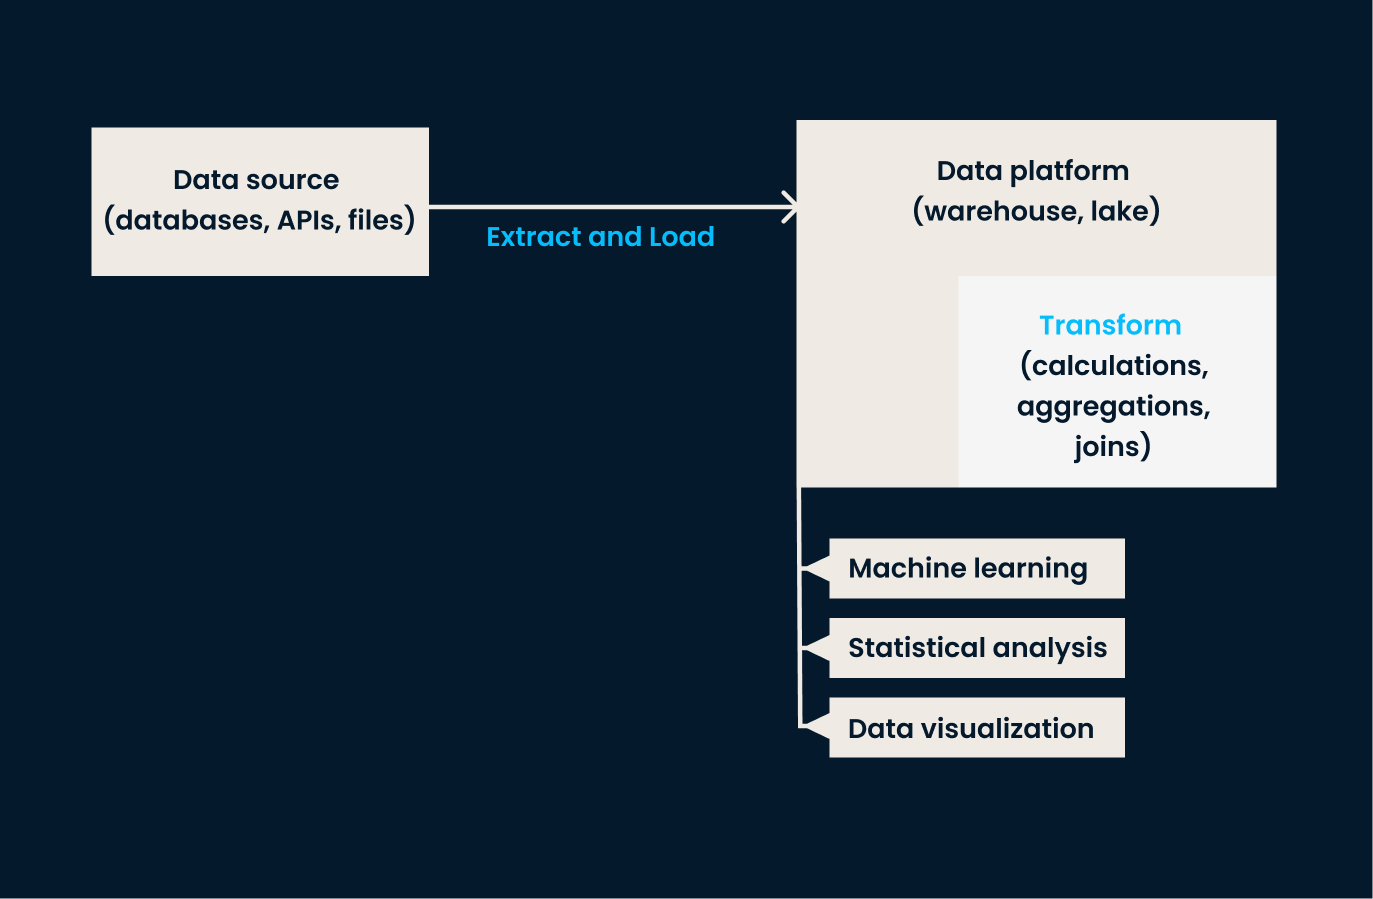
Una volta estratti, i dati vengono caricati in un sistema di archiviazione centralizzato come un data lake o un data warehouse. Questo passaggio prevede l’organizzazione e l’archiviazione dei dati estratti nel loro formato grezzo, senza alcuna trasformazione.

Di solito sono i data engineer a occuparsi di questo passaggio, caricando i dati su piattaforme come:

Queste piattaforme consentono di caricare rapidamente grandi volumi di dati e offrono un’unica fonte di verità per tutti i diversi tipi di dati raccolti da varie fonti.

3. Transform

L’ultimo passaggio del processo ELT è la trasformazione dei dati grezzi in un formato ottimizzato per analisi e reportistica. Ciò comporta la pulizia, il filtraggio, l’aggregazione e la strutturazione dei dati in modo che gli strumenti di business intelligence e analytics possano utilizzarli.

Di solito di questo passaggio si occupano data engineer o data scientist, che possono utilizzare strumenti come:
  • Query SQL
  • Apache Spark
  • Librerie Python come Pandas o NumPy

Pipeline di dati ELT

Pipeline di dati ELT: le fasi di estrazione e caricamento avvengono prima che ai dati venga applicata qualsiasi trasformazione. Il passaggio di trasformazione viene eseguito all’interno della piattaforma dati.

La trasformazione dei dati avviene all’interno del data warehouse o del data lake, il che facilita la gestione di grandi volumi di dati. Con le tecnologie cloud moderne, questo processo può essere eseguito in quasi tempo reale, offrendo alle organizzazioni accesso a dati aggiornati e accurati per le analisi.

Vuoi saperne di più sull’uso di Python per l’ELT? Il corso ETL and ELT in Python potrebbe essere proprio quello che ti serve.

Vantaggi dell’ELT

L’ELT offre molti vantaggi, ecco i principali:

  • Scalabilità: l’ELT consente di estrarre, caricare e trasformare grandi quantità di dati più velocemente rispetto ai processi ETL tradizionali, grazie alla potenza del cloud computing.
  • Flessibilità: l’ELT permette di integrare dati da varie fonti, inclusi dati strutturati, semi-strutturati e non strutturati.
  • Rapidità delle insight in tempo reale: i dati grezzi archiviati in un data lake o data warehouse possono essere trasformati rapidamente on-demand, offrendo insight in tempo reale per decisioni più veloci.

ELT vs ETL

Confrontiamo ora le differenze tra ELT ed ETL.

Come accennato, l’ELT è un approccio più recente all’elaborazione dei dati, in cui i dati vengono prima caricati in un repository centrale, consentendo di eseguire le trasformazioni dopo il caricamento.

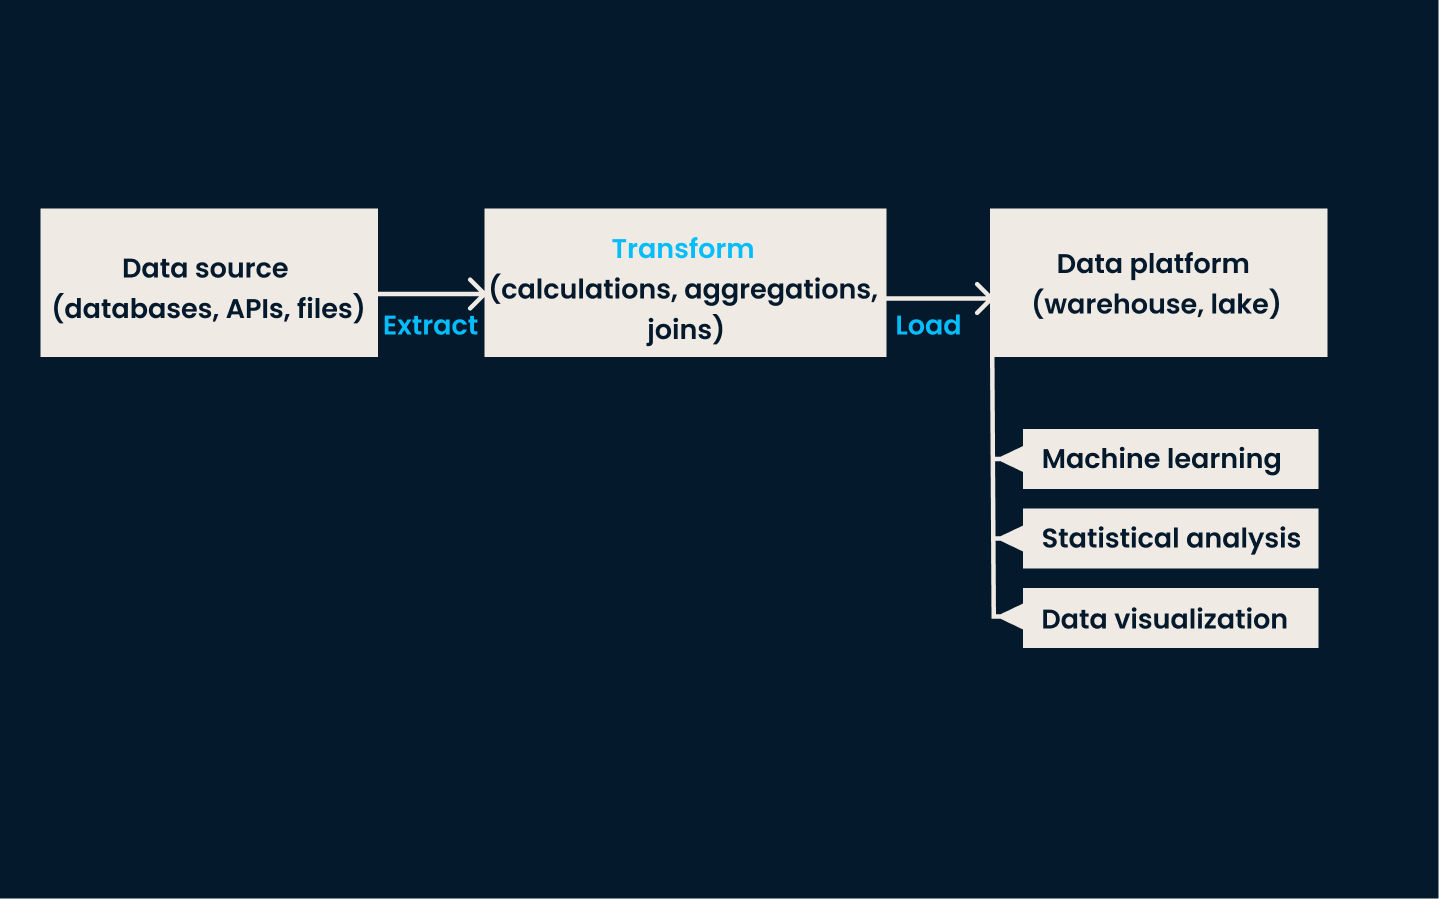
Al contrario, l’ETL (Extract, Transform, Load) è una metodologia tradizionale in cui i dati vengono trasformati prima di essere caricati nel sistema di destinazione. Queste differenze fondamentali incidono non solo sul processo, ma anche su velocità, costi e sicurezza.
Pipeline di dati ETL

Pipeline ETL: il passaggio di trasformazione avviene prima del caricamento dei dati sulla piattaforma di destinazione. In genere, la trasformazione avviene su un server separato e non nella piattaforma dati stessa.

Processo

L’ELT segue un approccio "prima carico, poi trasformo" in cui i dati vengono caricati in un sistema di storage nel loro formato grezzo e successivamente trasformati per l’analisi. 

L’ETL, invece, segue un approccio "extract-transform-load" in cui i dati vengono estratti da varie fonti, poi trasformati e infine caricati in un data warehouse.

Velocità

L’approccio ELT è noto per la maggiore velocità di elaborazione dei dati, poiché elimina la necessità di un’area di staging intermedia. Ciò consente analisi in tempo reale o quasi tempo reale. 

Al contrario, l’ETL può richiedere più tempo a causa dei numerosi passaggi necessari per trasformare e caricare i dati.

Costi

Inoltre, l’ELT elimina la necessità di costosi software ETL, poiché le trasformazioni possono essere eseguite con query SQL o altri strumenti open source.

Al contrario, i processi ETL tradizionali tendono a integrarsi meglio con infrastrutture on-premise, dove le fonti dati sono limitate e le risorse hardware sono meno scalabili rispetto agli ambienti basati su cloud. Le infrastrutture on-premise hanno spesso costi più elevati rispetto a quelle cloud.

Sicurezza

Infine, l’ELT consente la cifratura dei dati e il data masking delle informazioni personali identificabili (PII) durante il processo di caricamento, poiché avviene in un repository centrale sicuro. 

Nei processi ETL occorre garantire la sicurezza dei dati durante l’estrazione e la trasformazione. Tuttavia, ciò risulta più complesso, dato che i dati devono passare per ulteriori storage di staging e vengono spesso elaborati su server separati.

Casi d’uso dell’ELT

Grazie alla maggiore velocità di elaborazione e alle analitiche nel cloud, il processo ELT eccelle in alcuni casi d’uso rispetto all’ETL.

Ecco alcune applicazioni comuni del processo ELT:

  • Reportistica in tempo reale sulle app: l’ELT consente alle aziende di ottenere insight in tempo reale sul comportamento degli utenti nelle app.
  • Data warehousing: molte organizzazioni utilizzano l’ELT per caricare e trasformare i dati in un data warehouse centralizzato per finalità di reportistica e analytics.
  • Integrazione dati basata su cloud: con l’ascesa delle tecnologie cloud, l’ELT è diventata una scelta popolare per integrare fonti dati da applicazioni on-premise e cloud.

Strumenti e tecnologie ELT

Sono disponibili vari strumenti e tecnologie per implementare processi ELT. Tra questi:

Data warehouse e data lake

Nella fase di caricamento del processo ELT, i data lake e i data warehouse sono fondamentali per fornire uno spazio di archiviazione dati centralizzato all’interno dell’azienda.

Ecco le piattaforme dati cloud più diffuse:

  • Amazon Redshift: un servizio di data warehouse nel cloud che gestisce enormi quantità di dati in modo rapido ed efficiente.
  • Google BigQuery: un data warehouse serverless e scalabile che consente query veloci su grandi dataset.
  • Snowflake: un data warehouse basato sul cloud che supporta i processi ELT e offre sicurezza e prestazioni avanzate.
  • Amazon S3: un servizio di archiviazione cloud che può essere usato come data lake per conservare dati grezzi, poi trasformabili con query SQL o altri strumenti.

Strumenti ELT open source

Molte organizzazioni sfruttano anche strumenti open source per i loro processi ELT, per via della convenienza economica.

Questi strumenti possono aiutare nelle diverse fasi del processo ELT:

  • Apache Airflow: usato per l’automazione dei workflow e la schedulazione di processi ETL/ELT.
  • dbt: software open source per trasformare i dati in un data warehouse usando SQL.
  • Airbyte: piattaforma open source di integrazione dei dati che supporta sia processi ELT che ETL.
  • Singer: strumento open source utilizzato nei processi ELT ed ETL con un approccio modulare.
  • Apache NiFi: strumento open source di integrazione dati che supporta instradamento, trasformazione e mediazione tra sistemi.

Gli strumenti open source si adattano perfettamente ai processi ELT perché offrono flessibilità, supporto da parte degli sviluppatori e numerose opzioni di integrazione.

Script personalizzati

Gli sviluppatori possono anche scegliere di usare script creati con linguaggi di programmazione per una maggiore personalizzazione. In genere ciò comporta l’uso di pacchetti e librerie per elaborare e trasformare i dati.

Alcuni linguaggi comunemente usati per questi script includono:

  • Python: l’uso di librerie come Pandas, NumPy e SQLAlchemy può aiutare nell’estrazione, caricamento e trasformazione dei dati.
  • Apache Spark: utilizzato per l’elaborazione e l’analisi di big data, spesso con linguaggi come Python (PySpark), Java e Scala.
  • R: il framework tidyverse, insieme ad altre librerie R come dplyr e data.table, può essere usato per l’estrazione e la trasformazione dei dati.
  • SQL: le query SQL possono essere usate per i compiti di trasformazione, e SQL Server Integration Services (SSIS) è uno strumento ETL diffuso che supporta anche processi ELT.
  • Scala: spesso usata con Apache Spark per l’elaborazione di big data e compiti ELT.
  • Java: comunemente usata con framework di big data come Apache Hadoop e Apache Spark per processi ELT.

Considerazioni finali

In conclusione, l’ELT è una tendenza nuova ed emergente nell’elaborazione dei dati che offre molti vantaggi rispetto ai metodi ETL tradizionali. Consente trasformazioni più rapide ed efficienti e offre maggiore flessibilità e scalabilità. 

Se stai pensando di approfondire l’ELT o altri concetti di data engineering, potrebbero interessarti la nostra Data Engineer Certification o il nostro Career Track Data Engineer in Python.

FAQs

In che modo l’ELT gestisce i problemi di qualità e coerenza dei dati?

L’ELT gestisce la qualità e la coerenza dei dati sfruttando le funzionalità del data warehouse o del data lake dove i dati sono archiviati. I controlli di qualità, la pulizia e i processi di validazione vengono applicati durante la fase di trasformazione per garantire coerenza e accuratezza. Strumenti come dbt (data build tool) possono essere utilizzati per creare pipeline di trasformazione che includano questi controlli di qualità, aiutando a mantenere elevati standard di integrità dei dati.

L’ELT può essere utilizzato per lo streaming dei dati in tempo reale? Se sì, come?

Sì, l’ELT può essere utilizzato per lo streaming dei dati in tempo reale. Ciò si ottiene integrando strumenti di ingestione real-time come Apache Kafka o AWS Kinesis nella pipeline ELT. Questi strumenti possono trasmettere continuamente i dati in un data lake o data warehouse, dove le trasformazioni possono essere applicate in quasi tempo reale utilizzando strumenti come Apache Spark o trasformazioni basate su SQL, abilitando analisi e decisioni tempestive.

In che modo l’ELT si integra con i workflow di machine learning?

L’ELT si integra con i workflow di machine learning fornendo una solida pipeline dati che alimenta i modelli con dati puliti e trasformati. Una volta caricati i dati in un data warehouse, possono essere trasformati e preparati per il machine learning con strumenti come Apache Spark MLlib o librerie Python come scikit-learn. Questa integrazione consente pre-processing, training e valutazione dei modelli nello stesso ambiente, migliorando efficienza e scalabilità.

Quali sono le considerazioni di sicurezza nell’implementare l’ELT in ambienti cloud?

Nell’implementare l’ELT in ambienti cloud, le considerazioni sulla sicurezza includono cifratura dei dati, controllo degli accessi e data masking. I dati dovrebbero essere cifrati in transito e a riposo per proteggere le informazioni sensibili. Meccanismi di controllo degli accessi, come il role-based access control (RBAC), dovrebbero essere implementati per garantire che solo gli utenti autorizzati possano accedere e manipolare i dati. Tecniche di data masking possono essere applicate per proteggere le informazioni personali identificabili (PII) durante i processi di caricamento e trasformazione.

Come affrontano i data engineer la sfida dell’evoluzione degli schemi nei processi ELT?

I professionisti dei dati gestiscono l’evoluzione degli schemi nei processi ELT utilizzando strumenti e pratiche di gestione degli schemi che supportano i cambiamenti nel tempo. Ciò include l’uso di strumenti come Apache Avro o JSON Schema per una serializzazione flessibile dei dati e l’evoluzione degli schemi. Inoltre, si possono adottare strategie di versioning e script automatizzati di migrazione degli schemi per gestire i cambiamenti senza interrompere la pipeline. Anche i data catalog e gli strumenti di gestione dei metadati svolgono un ruolo cruciale nel tracciare e documentare le modifiche agli schemi per garantire coerenza e affidabilità dei dati.


Austin Chia's photo
Author
Austin Chia
LinkedIn

Sono Austin, blogger e autore tech con anni di esperienza come data scientist e data analyst nel settore sanitario. Partito dalla biologia, oggi aiuto altri a fare lo stesso passaggio attraverso il mio blog tecnologico. La mia passione per la tecnologia mi ha portato a collaborare come autore con decine di aziende SaaS, ispirando altre persone e condividendo le mie esperienze.

Argomenti
Data Engineering

Approfondisci data engineering ed elaborazione dati con questi corsi!

Corso

ETL and ELT in Python

4 ore
40K
Impara a creare pipeline di dati efficaci, efficienti e affidabili usando i principi di estrazione, trasformazione e caricamento.
Vedi i dettagliRight Arrow
Inizia Il Corso
Mostra altroRight Arrow
Correlato

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

Mostra AltroMostra Altro

