
Corso
Pulizia dei dati in Python
4 ore
161.4K
Quando inizi un nuovo progetto sui dati, i dati che acquisisci raramente sono perfetti per l’analisi fin da subito. Per questo è fondamentale dedicare all’inizio di ogni nuovo progetto del tempo alla pulizia dei dati.
Pulire i dati significa rimuovere errori, outlier e incongruenze e assicurarsi che tutti i dati siano in un formato adatto alla tua analisi. I dati che contengono molti errori o che non sono stati sottoposti a questo processo di pulizia sono chiamati dirty data (dati “sporchi”).
Questo passaggio può sembrare opzionale a molti professionisti junior, ma sappi che è cruciale! Senza una corretta pulizia dei dati, il tuo modello può arrivare a una conclusione sbagliata, il tuo grafico può mostrare una tendenza fasulla e le tue statistiche possono risultare completamente inaccurate.
Considera un dataset estremamente piccolo. Tu e i tuoi amici state dividendo le caramelle in parti uguali e devi determinare quante ne spettano a ciascuno. Inserisci i dati nella tabella qui sotto.
|
Persona |
Numero di caramelle |
|
Peter |
5 |
|
Sandy |
20 |
|
Sandy |
20 |
|
Joseph |
3 |
|
Amed |
12 |
Ora, se calcoli la media della colonna “Numero di caramelle”, potresti concludere che a ciascuno spettano 12 caramelle.
Tuttavia, se provi a dare 12 caramelle a ogni persona, finirai le caramelle prima che tutti ricevano la loro parte, perché Sandy è stata duplicata nella tabella. Nel tuo mucchio ci sono solo 40 caramelle invece di 60 (e, in realtà, solo 4 persone, non 5)!
Se non dedichi tempo alla pulizia del dataset, rischi che l’analisi arrivi a una conclusione sbagliata.
Nel caso di dividere caramelle tra amici, la conseguenza peggiore potrebbe essere un’amicizia irritata. Ma nel mondo del lavoro, trascurare la pulizia del dataset potrebbe portare ad analisi che suggeriscono il prodotto sbagliato da lanciare, il numero errato di assunzioni, l’investimento nel titolo sbagliato o persino l’addebito del prezzo sbagliato a un cliente!
La pulizia dei dati è ancora più importante con analisi complesse. In questi casi, potresti non avere un’aspettativa netta su quali dovrebbero essere i risultati, il che significa che potresti non riconoscere quando sono sbagliati.
Una pulizia accurata dei dati, insieme a test attenti, aiuta a ridurre queste preoccupazioni. In questo tutorial, vedremo ciò che devi sapere sul processo di pulizia dei dati in Python.
Esistono molti tipi di errori e incongruenze che possono rendere i dati “sporchi”. Vediamo alcuni dei tipi più comuni e perché sono problematici.
I dataset incompleti sono estremamente comuni. Il tuo dataset può avere diversi anni mancanti, contenere solo alcune informazioni su un cliente o non includere l’intera gamma di prodotti della tua azienda.
I valori mancanti possono avere molteplici effetti sull’analisi. Grandi porzioni di dati cruciali mancanti possono introdurre bias nei risultati. Inoltre, i valori NaN o le celle mancanti in un DataFrame possono mandare in errore del codice Python, causando molta frustrazione durante la costruzione del modello.
Gli outlier sono valori molto lontani dalla norma e non rappresentativi dei dati. Possono derivare da un refuso o da circostanze eccezionali. È importante distinguere i veri outlier da situazioni estreme ma informative. Gli outlier possono distorcere i risultati, suggerendo infine la risposta sbagliata.
Come abbiamo visto sopra, le voci duplicate possono sovrarappresentare un elemento nell’analisi, portando a conclusioni errate. Fai attenzione sia ai duplicati ripetuti più volte sia a quelli con informazioni in conflitto o aggiornate.
A volte, i valori nel dataset sono semplicemente sbagliati. Potresti avere l’ortografia errata del nome di un cliente, il numero di prodotto sbagliato, informazioni obsolete o dati etichettati in modo scorretto.
Può essere difficile stabilire se i dati sono errati, motivo per cui è così importante verificare la fonte! Ricorda: la tua analisi è valida solo quanto i tuoi dati.
Le incongruenze possono presentarsi in molte forme. Possono esserci inserimenti incoerenti, che possono indicare un refuso o un errore. Se vedi un cliente ringiovanire, un ingrediente che cambia ID o un prodotto con due prezzi simultanei, vale la pena approfondire per assicurarsi che sia tutto corretto.
Un’altra tipologia problematica è l’incoerenza nel formato dei dati. Valori diversi possono essere riportati in unità differenti (chilometri vs miglia vs pollici), in stili diversi (Mese Giorno, Anno vs Giorno-Mese-Anno), in tipi di dato differenti (float vs integer) o persino in formati di file diversi (.jpg vs .png).
Queste incongruenze renderanno difficile, se non impossibile, l’interpretazione corretta dei valori da parte del tuo codice. Ciò può portare ad analisi scorrette o a codice che non gira affatto.
È essenziale comprendere il tuo dataset prima di usarlo in analisi complesse. Per sviluppare questa comprensione, dovresti fare un po’ di esplorazione dei dati. Puoi considerare questo passaggio come l’analisi prima dell’analisi.
Vediamo alcuni passaggi tipici per condurre un’esplorazione su un dataset in formato tabellare:
Tutto ciò può sembrare superfluo rispetto all’analisi che vuoi fare, ma ci sono alcune ragioni importanti per cui dovresti sempre seguire questi passaggi. Innanzitutto, questo lavoro ti fornirà un’ottima comprensione dei limiti del tuo dataset, essenziale per poter fidarti dei risultati finali.
In secondo luogo, l’esplorazione può indicarti tendenze e analisi importanti a cui non avevi pensato. Queste possono arricchire l’analisi prevista o introdurre un fattore di complessità da considerare.
In terzo luogo, questa pre-analisi può essere il primo indizio di dove potresti avere dati “sporchi”. Potrebbe essere la prima volta in cui vedi un outlier, ti accorgi che le categorie sono il doppio di quelle previste o scopri che il metodo di raccolta è cambiato rispetto all’anno precedente. Sono tutti elementi critici che dovrebbero spingerti a essere curioso sul tuo dataset.
Per maggiori informazioni sull’esplorazione dei dati, dai un’occhiata al corso di Data Exploration in Python di DataCamp o a questo tutorial per principianti assoluti.
Entriamo nel dettaglio con alcune tecniche di pulizia dei dati in Python affrontando come gestire alcuni problemi comuni di dati “sporchi”.
Invariabilmente, con un dataset grande, alcuni campi saranno mancanti in una o più voci. Non solo questo significa perdere dati preziosi, ma le voci NaN possono mandare in crisi alcune funzioni Python, rendendo il modello inaccurato.
Quando trovi un valore mancante, puoi scegliere se eliminare quella voce dall’analisi o imputare un valore ragionevole al suo posto. Se il dataset è abbastanza piccolo, ti suggerisco di visualizzare le righe che contengono valori mancanti per determinare la strategia migliore.
import pandas as pd # Identify rows with NaN valuesrows_with_nan = df[df.isnull().any(axis=1)] #View the rows with NaN valuesprint(rows_with_nan)Eliminare una voce non è in genere la prima scelta, perché significa togliere dall’analisi informazioni potenzialmente preziose.
Tuttavia, a volte l’eliminazione è l’opzione migliore, ad esempio se la voce non fornisce abbastanza altre informazioni da giustificarne la conservazione (come quando è solo una data senza informazioni utili).
L’eliminazione è anche il modo più semplice per gestire le voci con valori mancanti. Quindi, se hai poco tempo e il resto della voce non è importante per l’analisi, eliminare le voci con NaN è un’opzione.
Puoi usare il metodo .dropna() della libreria Pandas per rimuovere dal DataFrame le righe che contengono NaN.
import pandas as pd # Assuming df is your DataFramedf.dropna(inplace=True)Il metodo generalmente preferito per gestire i valori mancanti è imputare un valore ragionevole. Trovare un buon valore da imputare è un’arte a sé, ma esistono diversi metodi consolidati che possono essere un buon punto di partenza.
Il metodo .fillna() di Pandas imputa i valori mancanti usando la media, in modo da non alterare la distribuzione.
import pandas as pd # Assuming df is your DataFrame# Replace NaN values with the mean of the columndf.fillna(df.mean(), inplace=True)Anche la libreria scikit-learn offre una semplice funzione di imputazione che funziona bene.
from sklearn.impute import SimpleImputerimport pandas as pd # Assuming df is your DataFrameimputer = SimpleImputer(strategy='mean')df_imputed = pd.DataFrame(imputer.fit_transform(df), columns=df.columns)Se ti serve un metodo più complesso, puoi considerare un’imputazione con KNN o regressione per trovare un buon valore. In definitiva, il metodo dipenderà dai tuoi dati, dalle tue esigenze e dalle risorse disponibili.
Gli outlier sono un po’ complicati da gestire. Alcuni apparenti outlier sono in realtà dati importanti, come la reazione dei mercati a crisi come il COVID-19 o la Grande Recessione. Altri, invece, possono essere refusi o circostanze rare e irrilevanti, e andrebbero rimossi.
Capire la differenza spesso è una questione di contesto, che l’esplorazione precedente dovrebbe averti aiutato a sviluppare, e di avere chiaro l’obiettivo dell’analisi.
Molti outlier sono visibili quando i dati sono rappresentati graficamente, ma puoi anche usare metodi statistici per identificarli.
Un metodo comune è calcolare lo Z-score per ogni punto dati ed eliminare i valori con Z-score estremo.
import numpy as npimport pandas as pd # Generate some sample datanp.random.seed(0)data = np.random.randint(low=0, high=11, size=1000)# Add some outliersdata[0] = 100data[1] = -100 # Calculate Z-scoresz_scores = (data - np.mean(data)) / np.std(data) # Identify outliers based on Z-score threshold (e.g., 3)threshold = 3outliers = np.where(np.abs(z_scores) > threshold)[0] print("Outliers identified using Z-score method:")print(data[outliers])Un altro metodo è calcolare l’intervallo interquartile (IQR) della distribuzione e classificare come potenziali outlier i valori minori di Q1 − (1,5 × IQR) o maggiori di Q3 + (1,5 × IQR).
import numpy as npimport pandas as pd # Generate some sample datanp.random.seed(0)data = np.random.randint(low=0, high=11, size=1000)# Add some outliersdata[0] = 100data[1] = -100 # Calculate quartiles and IQRq1 = np.percentile(data, 25)q3 = np.percentile(data, 75)iqr = q3 - q1 # Identify outliers based on IQRlower_bound = q1 - (1.5 * iqr)upper_bound = q3 + (1.5 * iqr)outliers = np.where((data < lower_bound) | (data > upper_bound))[0] print("Outliers identified using IQR method:")print(data[outliers])Una volta identificati gli outlier e stabilito che sono problematici, esistono vari metodi per gestirli. Se l’outlier è dovuto a un errore, potrebbe essere possibile correggerlo direttamente.
In altri casi, si può rimuovere l’outlier dal dataset o sostituirlo con un valore meno estremo che mantenga la forma complessiva della distribuzione.
Il capping è un metodo in cui imposti un tetto, o soglia, sulla distribuzione dei dati e sostituisci i valori al di fuori di quei limiti con un valore specificato.
import pandas as pdimport numpy as np # Create a sample DataFrame with outliersdata = { 'A': [100, 90, 85, 88, 110, 115, 120, 130, 140], 'B': [1, 2, 3, 4, 5, 6, 7, 8, 9]}df = pd.DataFrame(data) # Define the lower and upper thresholds for capping (Here I used the 5th and 95th percentiles)lower_threshold = df.quantile(0.05)upper_threshold = df.quantile(0.95) # Cap outlierscapped_df = df.clip(lower=lower_threshold, upper=upper_threshold, axis=1) print("Original DataFrame:")print(df)print("\nCapped DataFrame:")print(capped_df)In alcuni casi, puoi trasformare i dati per rendere gli outlier meno impattanti, ad esempio con una trasformazione con radice quadrata o una trasformazione logaritmica.
Fai attenzione quando trasformi i dati, perché potresti introdurre nuovi problemi se non sei prudente. Ecco alcune considerazioni prima di decidere di trasformare i dati.
Per saperne di più sulle trasformazioni dei dati, ti consiglio un corso di statistica come Introduction to Statistics in Python o Statistics Fundamentals with Python di DataCamp.
Abbiamo già visto come i duplicati possano mandare all’aria le analisi. Per fortuna, Python rende semplice identificare e gestire i duplicati.
Usando il metodo duplicated() della libreria pandas, puoi identificare facilmente le righe duplicate in un DataFrame per esaminarle.
import pandas as pd# Assuming 'df' is your DataFrameduplicate_rows = df[df.duplicated()]Questo restituirà un DataFrame con le righe duplicate. Una volta ottenuto questo DataFrame, ti incoraggio a dare un’occhiata ai duplicati se non sono troppi.
Molti duplicati potrebbero essere copie esatte e possono semplicemente essere rimossi con il metodo drop_duplicates() di Pandas:
# Removing duplicatescleaned_df = df.drop_duplicates()In alcuni casi, potrebbe essere più appropriato unire i record duplicati aggregando le informazioni. Ad esempio, se i duplicati rappresentano più voci per la stessa entità, possiamo unirle utilizzando funzioni di aggregazione:
# Merging duplicates by aggregating valuesmerged_df = df.groupby(list_of_columns).agg({'column_to_merge': 'sum'})Questo combinerà le righe duplicate in una sola, aggregando i valori in base alle funzioni specificate come somma, media, ecc.
import pandas as pd#Sample DataFramedata = { 'customer_id' : [102, 102, 101, 103, 102] 'product_id' : ['A', 'B', 'A', 'C', 'B'] 'quantity_sold : [5, 3, 2, 1, 4]}df = pd.DataFrame(data)df}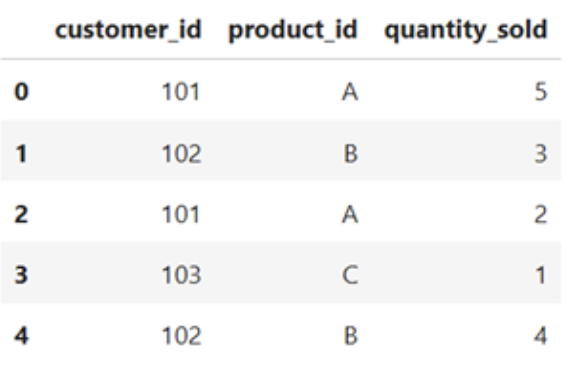
# Merging duplicates by aggregating valuesmerged_df = df.groupby(['cutomer_id', 'product_id']).agg({'quantity_sold': 'sum'}).reset_index()merged_df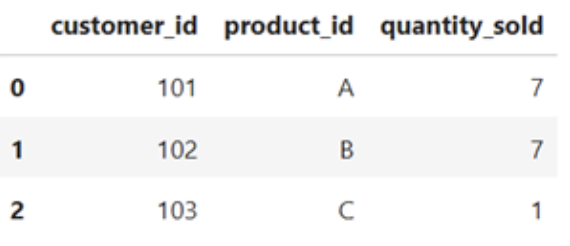
Tipi diversi di incongruenze richiedono soluzioni diverse. Le incongruenze dovute a inserimenti errati o refusi potrebbero dover essere corrette da una fonte competente. In alternativa, i dati errati possono essere sostituiti tramite imputazione, come se fossero valori mancanti, o rimossi del tutto dal dataset, a seconda dei casi.
Le incongruenze nel formato dei dati possono essere corrette con metodi di standardizzazione. Per rimuovere gli spazi iniziali e finali da una stringa, puoi usare .strip(). I metodi .upper() e .lower() standardizzano il maiuscolo/minuscolo nelle stringhe. E convertire le date in datetime tramite pd.to_datetime standardizza il formato delle date.
Puoi anche assicurarti che ogni valore in una colonna di un DataFrame abbia lo stesso tipo di dato usando il metodo .astype().
Altre correzioni di incongruenze di formattazione che potresti dover effettuare includono:
value_mapping = {'M': 'Male', 'F': 'Female'}standardized_value = value_mapping.get('M', 'Unknown')La trasformazione dei dati e il feature engineering sono tecniche di preprocessing per trasformare dati grezzi in un formato più adatto agli algoritmi di machine learning e all’analisi statistica. In questa sezione, esploreremo brevemente alcune tecniche comuni di trasformazione dei dati e feature engineering in Python.
Normalizzazione e standardizzazione sono due tecniche usate per portare le feature su scale simili, aspetto importante per molti algoritmi di machine learning.
La normalizzazione ridimensiona i dati a un intervallo fisso, di solito tra 0 e 1. In questo modo tutte le feature sono sulla stessa scala e si evita che alcune dominino sulle altre a causa di magnitudini maggiori.
from sklearn.preprocessing import MinMaxScaler

scaler = MinMaxScaler()
scaled_data = scaler.fit_transform(data)
La standardizzazione, invece, trasforma i dati affinché abbiano media pari a 0 e deviazione standard pari a 1. Questa tecnica è utile quando i dati hanno scale diverse e intervalli variabili, e garantisce che ogni feature abbia un impatto comparabile sul modello.
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
standardized_data = scaler.fit_transform(data)
Le caratteristiche specifiche dei tuoi dati e i requisiti del modello che intendi usare determineranno come scalarli. Scopri di più sulla differenza tra normalizzazione e standardizzazione nel tutorial dedicato Normalization vs. Standardization: How to Know the Difference.
La codifica delle variabili categoriche è un passaggio essenziale di preprocessing quando si lavora con feature non numeriche. Le variabili categoriche rappresentano dati qualitativi, come tipi, classi o etichette. Per usare queste variabili negli algoritmi di machine learning, vanno convertite in un formato numerico.
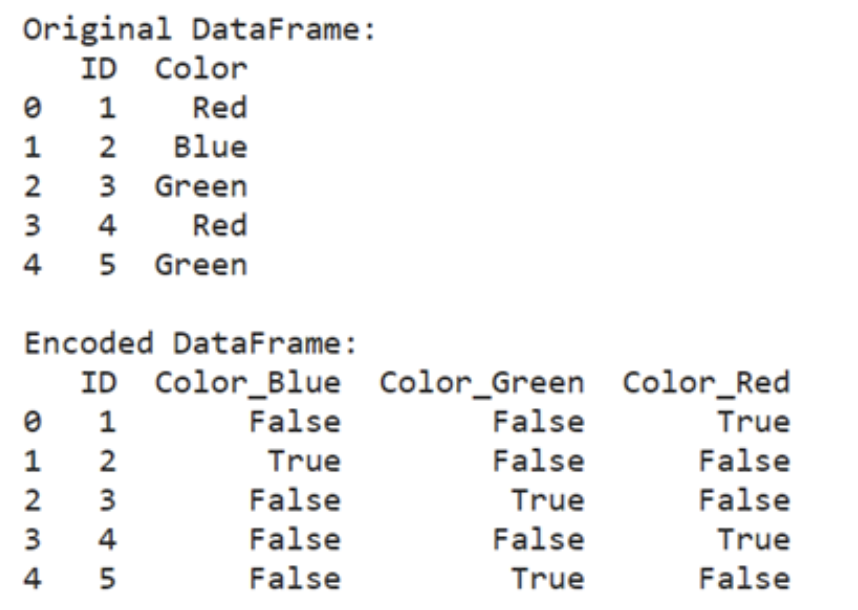
Una tecnica comune è la one-hot encoding, che trasforma ogni categoria in un vettore binario. Questo metodo è particolarmente utile con variabili categoriche nominali, in cui non esiste un ordine o una gerarchia intrinseca tra le categorie.
import pandas as pd

encoded_data = pd.get_dummies(data, columns=['categorical_column'])
import pandas as pd

# Create a sample DataFrame with a categorical column
data = {
    'ID': [1, 2, 3, 4, 5],
    'Color': ['Red', 'Blue', 'Green', 'Red', 'Blue']
}
df = pd.DataFrame(data)

# Perform one-hot encoding
encoded_data = pd.get_dummies(df, columns=['Color'])

print("Original DataFrame")
print(df)

print("\nEncoded DataFrame:")
print(encoded_data)
Un altro approccio è la label encoding, che assegna un intero univoco a ciascuna categoria. Ogni categoria è mappata a un valore numerico, convertendo di fatto etichette categoriche in numeri ordinali. Questo metodo è adatto per variabili categoriche ordinali, dove esiste un ordine naturale tra le categorie.
from sklearn.preprocessing import LabelEncoderencoder = LabelEncoder()encoded_data['categorical_column'] = encoder.fit_transform(data['categorical_column'])from sklearn.preprocessing import LabelEncoderimport pandas as pd#Create a sample DataFrame with categorical column data = { 'ID' : [1, 2, 3, 4, 5] 'Color' : [ 'Red', 'Blue', 'Green', 'Red', 'Green' ]}df = pd.DataFrame(data)#Perform label encodingencoder = LabelEncoder()df ['Color_LabelEncoded'] = encoder.fit_transform(df['Color'])print("Original DataFrame:")print(df[['ID', 'Color']])print("\nDataFrame with Label Encoded Column:")print(df[['ID', 'Color_LabelEncoded']])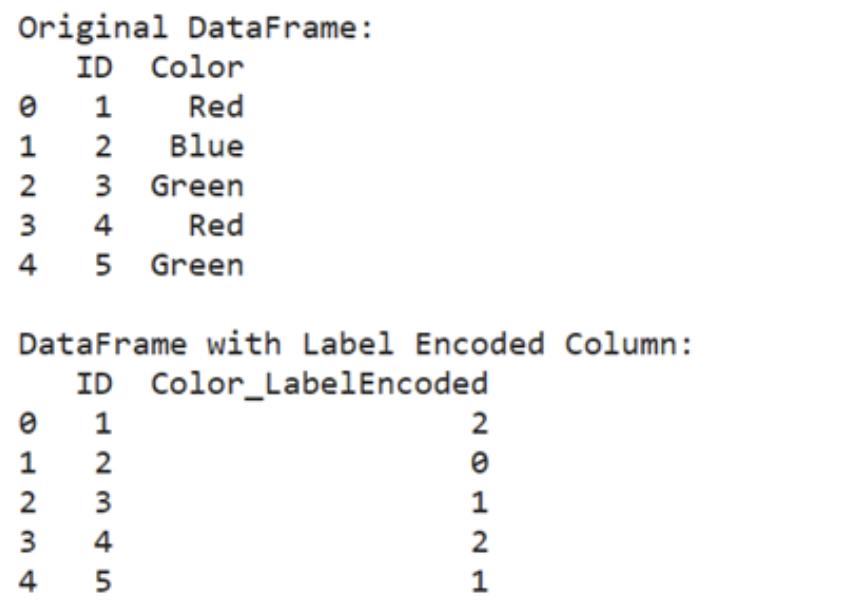
È importante scegliere il metodo di codifica appropriato in base alla natura della variabile categorica e ai requisiti dell’algoritmo. La one-hot encoding è in genere preferita per le variabili nominali, mentre la label encoding è adatta alle variabili ordinali.
Il feature engineering è una fase nello sviluppo dei modelli di machine learning che riguarda la creazione di nuove feature o la modifica di quelle esistenti. Questo processo è comune quando i dati grezzi non contengono feature che contribuiscono direttamente al compito di apprendimento o quando le feature esistenti non sono in una forma che l’algoritmo possa usare efficacemente.
Immagina di lavorare con un dataset di prezzi delle case e di voler prevedere il prezzo di vendita sulla base di feature come numero di stanze, metratura dell’area abitabile e condizioni dell’immobile. Tuttavia, il dataset non include una feature che catturi direttamente la condizione complessiva della casa.
In questo caso, puoi creare una nuova feature combinando feature esistenti o estraendo informazioni rilevanti.
Ad esempio, potresti creare una feature chiamata "Condizione complessiva" aggregando le valutazioni di singole componenti della casa, come stato della cucina, qualità della cantina, età dell’immobile, ristrutturazioni recenti, ecc.
Nei casi in cui la relazione tra feature e variabile target è non lineare, è possibile generare feature polinomiali elevando le feature esistenti a potenze diverse. Questo approccio aiuta a catturare relazioni complesse tra variabili che potrebbero non essere separabili linearmente.
from sklearn.preprocessing import PolynomialFeatures

poly = PolynomialFeatures(degree=2)
polynomial_features = poly.fit_transform(data)
In altri casi, potresti avere a che fare con dataset ad alta dimensionalità o multicollinearità tra le feature. Tecniche come l’Analisi delle Componenti Principali (PCA) possono essere utilizzate per ridurre la dimensionalità mantenendo la maggior parte delle informazioni rilevanti.
from sklearn.decomposition import PCA

pca = PCA(n_components=2)
transformed_features = pca.fit_transform(data)
Il feature engineering assicura di avere i dati giusti nel formato giusto per il tuo modello. Esistono molte tecniche e quelle da usare dipendono fortemente da ciò che vuoi ottenere.
Dai un’occhiata a questo corso sul feature engineering per altre tecniche utili.
La pulizia dei dati è un passaggio critico in qualsiasi progetto di analisi o machine learning. Ecco alcune buone pratiche da tenere a mente per rendere più snello il processo:
Tieni sempre l’originale!
Questo è il consiglio più importante nella pulizia dei dati. Conserva una copia dei file grezzi separata dalle versioni pulite ed elaborate. Così avrai sempre un punto di riferimento e potrai tornare facilmente ai dati originali se necessario.
Personalmente, faccio sempre una copia del file grezzo prima di qualsiasi modifica e aggiungo il suffisso “-RAW” al nome del file, così so qual è l’originale.
Aggiungi commenti al codice per spiegare lo scopo di ogni passaggio di pulizia e le eventuali assunzioni fatte.
Vuoi essere sicuro che gli sforzi di pulizia non cambino significativamente la distribuzione o introducano bias indesiderati. Ripetere l’esplorazione dei dati dopo la pulizia può aiutarti a verificare di essere sulla strada giusta.
Se il processo di pulizia è lungo o automatizzato, potresti voler mantenere un documento separato in cui registri i dettagli di ogni passaggio.
Dettagli come la data, l’azione specifica intrapresa e gli eventuali problemi riscontrati possono tornare utili in futuro.
Ricorda di archiviare questo documento in un luogo facilmente accessibile, ad esempio nella stessa cartella del progetto dei dati o del codice. Nel caso di una pipeline automatizzata e aggiornata regolarmente, valuta di rendere questo log una parte automatica del processo di pulizia. Ti permetterà di controllare che tutto funzioni senza intoppi.
Identifica i compiti di pulizia più comuni e incapsulali in funzioni riutilizzabili. In questo modo potrai applicare gli stessi passaggi a più dataset. È particolarmente utile se hai abbreviazioni specifiche della tua azienda da mappare.
Usa la Data Cleaning Checklist di DataCamp per assicurarti di non dimenticare nulla!
La pulizia dei dati non è solo un compito noioso; è un passaggio fondamentale che costituisce la base di ogni progetto di analisi e machine learning di successo. Assicurando che i tuoi dati siano accurati, coerenti e affidabili, poni le basi per prendere decisioni informate e ricavare insight significativi.
I dati “sporchi” possono portare a conclusioni errate e analisi fallaci, con conseguenze significative, che tu stia dividendo caramelle tra amici o prendendo decisioni di business. Investire tempo e impegno nella pulizia dei dati ripaga nel lungo periodo, garantendo analisi affidabili e risultati azionabili.
Per ulteriori informazioni ed esercizi interattivi, dai un’occhiata al corso di pulizia dei dati di DataCamp. Per una sfida pratica, prova questo code-along sulla pulizia dei dati.
Inizia oggi il tuo percorso di pulizia dei dati!
Corso
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



