
Corso
Introduzione ai modelli Claude
3 ore
14.7K
Anthropic ha rilasciato Claude Sonnet 5 il 30 giugno 2026, con un messaggio chiaro: è il modello Sonnet più agentico mai distribuito dall’azienda. Sa pianificare, usare strumenti come browser e terminali e funzionare in autonomia a un livello che, fino a poco tempo fa, era alla portata solo dei modelli di classe Opus più grandi.
Il claim principale è che Sonnet 5 si avvicina a Opus 4.8 su ragionamento, uso di strumenti, coding e knowledge work, ma a un prezzo più basso. Sul benchmark di coding agentico pubblicato da Anthropic, Sonnet 5 ottiene il 63,2% contro il 69,2% di Opus 4.8 e il 58,1% di Sonnet 4.6. Su un benchmark di knowledge work, Sonnet 5 supera addirittura di poco Opus 4.8.
In questo articolo vedremo tutte le novità di Claude Sonnet 5: le nuove funzioni, i benchmark e quanto costa. Se vuoi più contesto su Anthropic, leggi la nostra guida recente ai comandi slash di Claude Code e il nostro approfondimento su Claude Tag.
Claude Sonnet 5 è il modello di fascia media di Anthropic, sotto la linea Opus e pensato per gestire lavori agentici che prima richiedevano i più costosi modelli Opus. Sostituisce Sonnet 4.6, lanciato a febbraio 2026, e usa un tokenizer aggiornato che cambia il modo in cui il modello elabora il testo.
Per molti sviluppatori, l’era agentica è iniziata con i modelli Sonnet come Claude Sonnet 3.5, 3.6 e 3.7, i primi rilasci Claude a mostrare vera abilità in coding e uso di strumenti. Più di recente, i progressi agentici più netti si erano spostati sui modelli di classe Opus, e Sonnet 5 è il tentativo di Anthropic di riportare la fascia media verso il fronte più avanzato.
Fonte: Anthropic
Il dato più significativo è il rapporto costo-prestazioni. I grafici di Anthropic mostrano che Sonnet 4.6 era ben al di sotto di Opus 4.8 nelle valutazioni BrowseComp (ricerca agentica) e OSWorld-Verified (uso del computer). Ora Sonnet 5 e Opus 4.8 coprono un’unica fascia: Sonnet 5 offre un costo inferiore, mentre Opus 4.8 mantiene un’accuratezza più alta a un prezzo maggiore.
I miglioramenti di Sonnet 5 ruotano attorno a un tema: portare a termine i compiti agentici senza fermarsi prima della fine. Ecco le capacità che spiccano.
Il cambiamento pratico più grande di Sonnet 5 è la capacità di seguire un task fino in fondo. I tester early-access di Anthropic hanno riportato che il modello completa attività complesse in cui le versioni precedenti di Sonnet tendevano a bloccarsi a metà, e che controlla il proprio output senza che gli venga chiesto.
Per immaginarlo nel tuo lavoro, pensa di affidare al modello un incarico che tocca due sistemi: recuperare i test falliti da una run CI e poi aprire una pull request con la correzione. I modelli Sonnet precedenti spesso si fermavano dopo la prima metà. L’esempio di Anthropic riguardava l’aggiornamento dei tier degli account Salesforce e l’invio di un annuncio di lancio ai contatti enterprise in un’unica passata, un flusso che, secondo un ingegnere di Zapier, prima si bloccava a metà.
Per chi costruisce agenti, questa è la differenza tra un modello che abbozza un piano e uno che lo esegue. Riduce il numero di volte in cui un umano deve intervenire per dare una spinta all’agente.
Sonnet 5 supporta livelli di sforzo regolabili, così puoi alzare o abbassare la profondità di ragionamento a seconda del compito e del budget. Anthropic lo presenta come un modo per trovare il punto giusto tra Sonnet 5 e Opus 4.8, invece di sceglierne uno e tenerselo.
Al livello di ragionamento Extra High, Sonnet 5 si comporta all’incirca come Opus 4.8 a livello medio-alto su OSWorld-Verified e BrowseComp. La nota dolente è che far girare Sonnet 5 a quel livello può costare più di Opus 4.8 a un’impostazione di ragionamento comparabile, quindi Opus 4.8 resta la scelta migliore per alcune attività ad alta accuratezza.
Se già usi Claude Code, i livelli di sforzo ti suoneranno familiari. Trattiamo il comando /effort e i relativi livelli nel nostro tutorial sui comandi slash di Claude Code.
Sonnet 5 arriva con miglioramenti di sicurezza misurabili rispetto a Sonnet 4.6, aspetto cruciale quando un agente tocca sistemi live. Le valutazioni pre-deployment di Anthropic hanno rilevato che rifiuta meglio le richieste malevole e resiste di più ai tentativi di hijack negli attacchi di prompt injection.
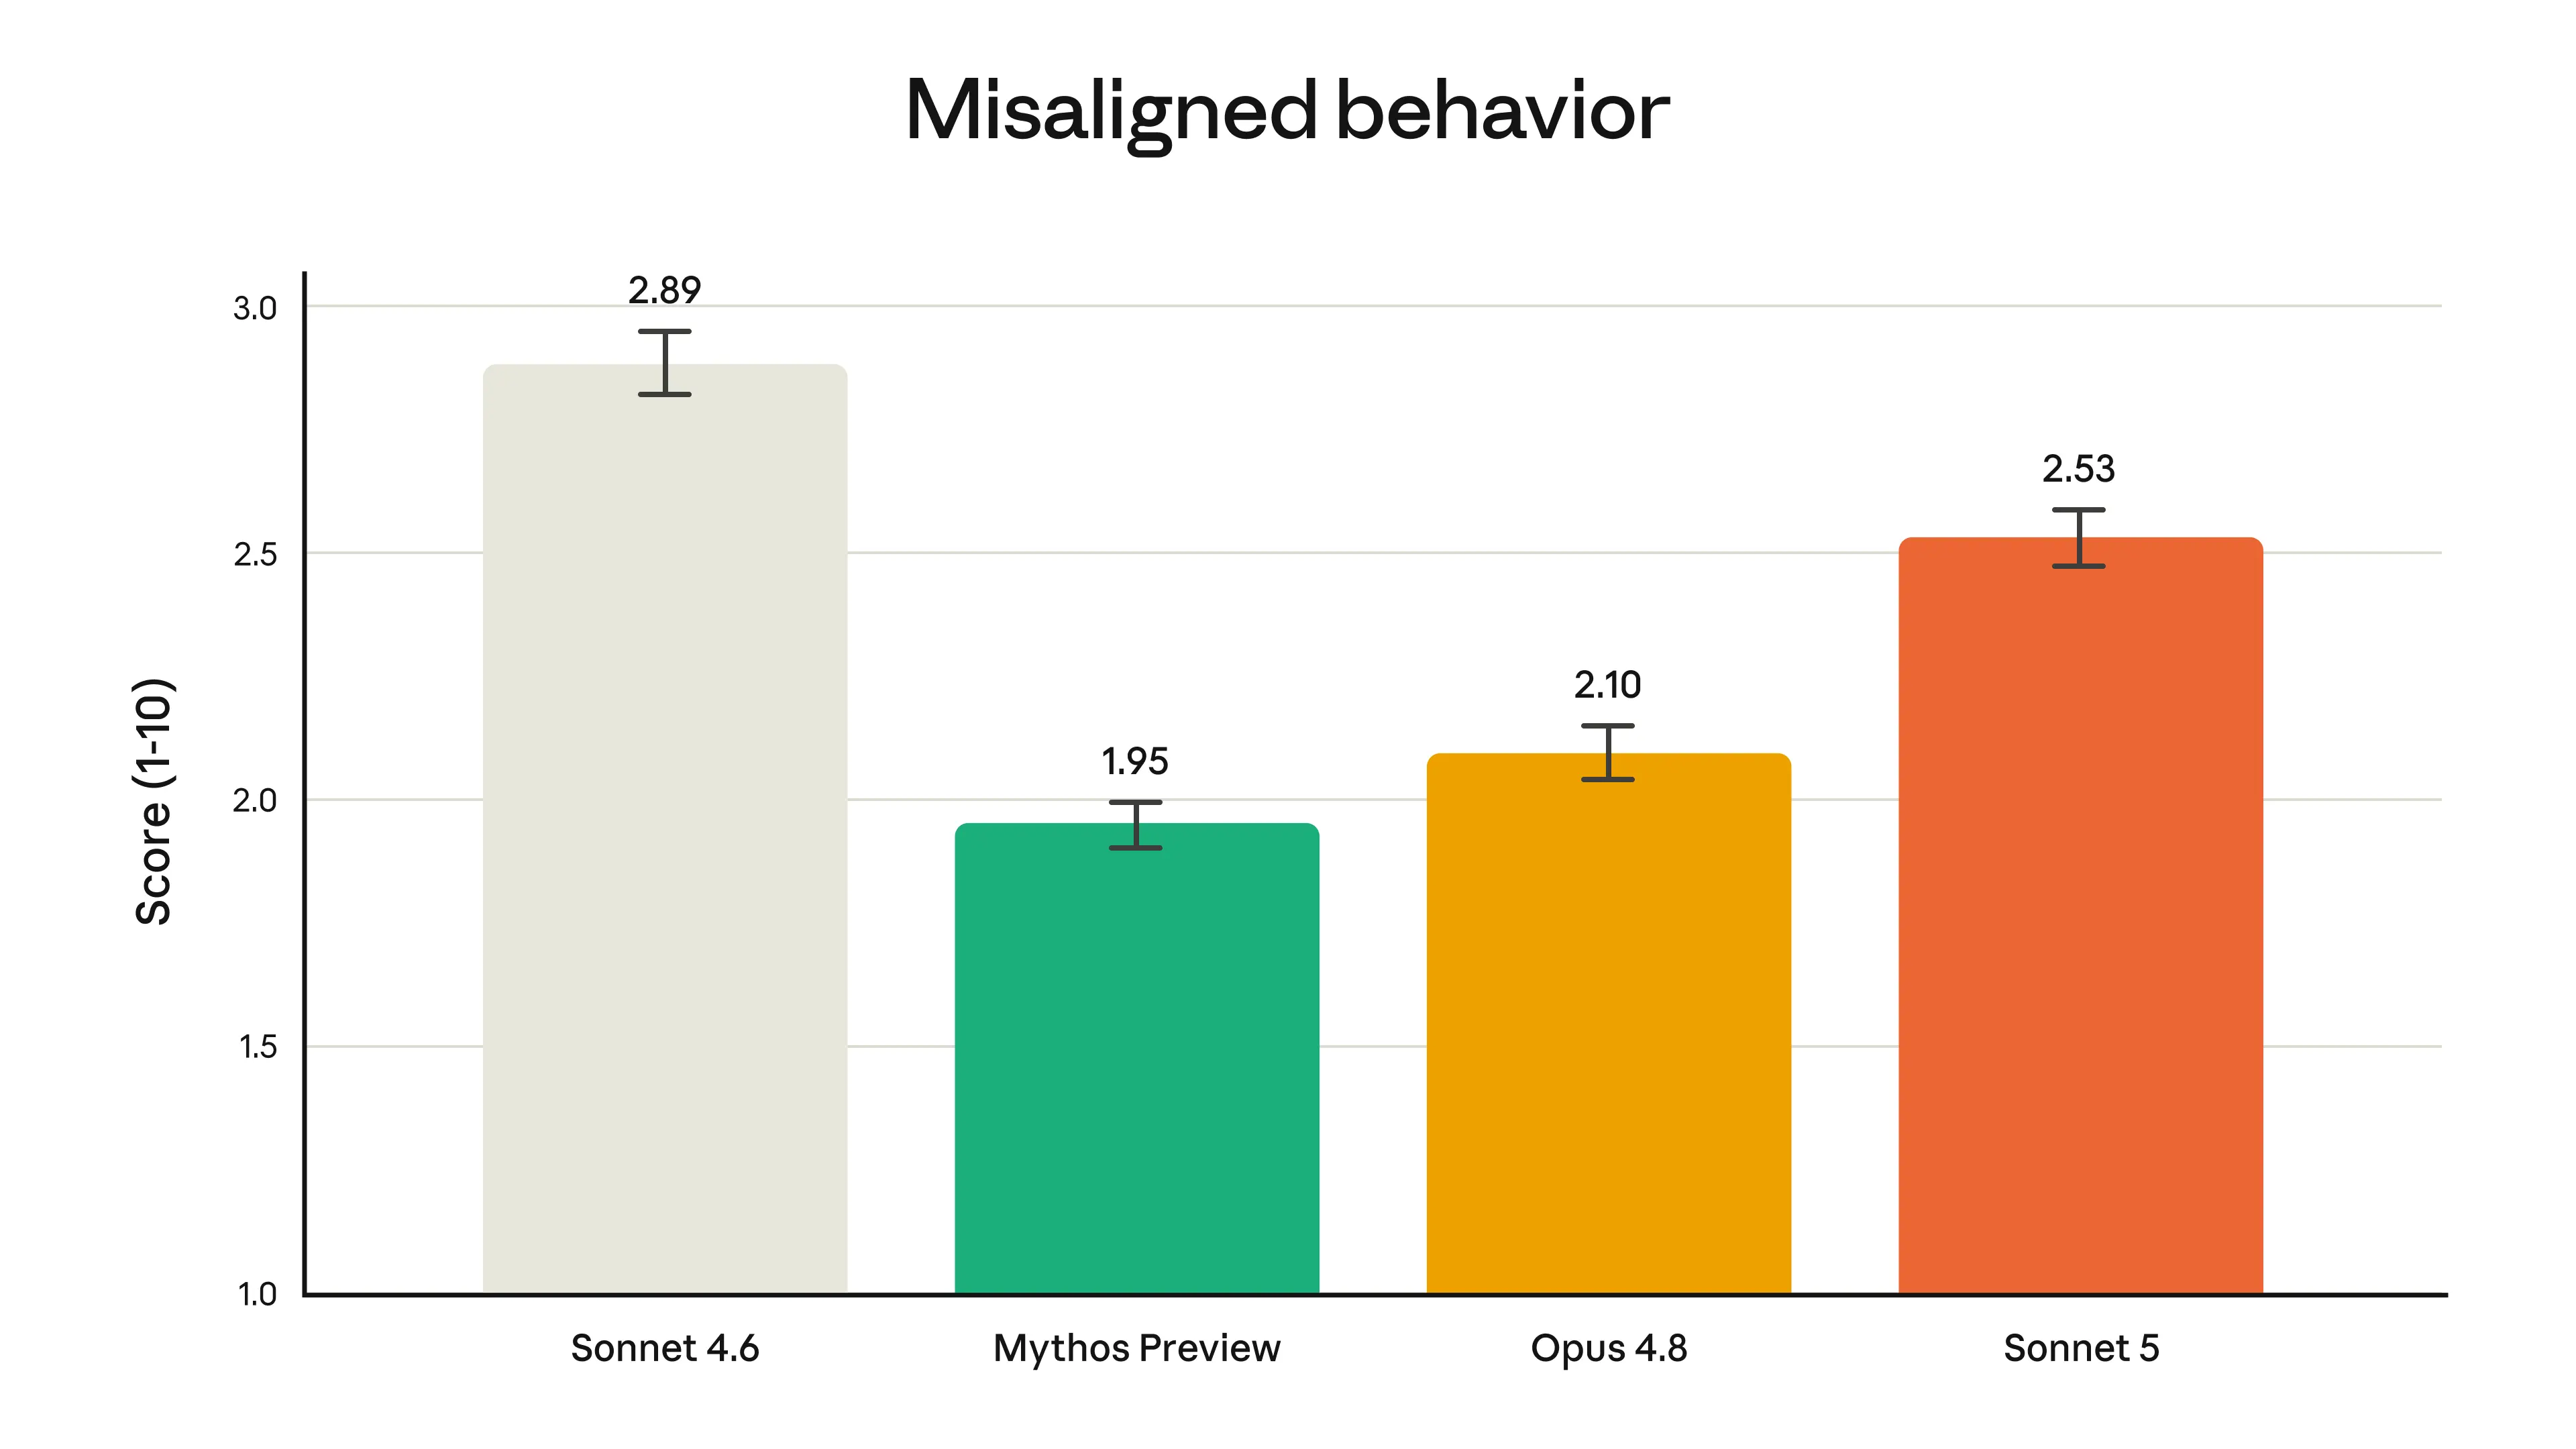
Il modello mostra anche tassi più bassi di allucinazioni e piaggeria rispetto a Sonnet 4.6, e ha ottenuto punteggi inferiori (più sicuri) nell’audit comportamentale automatizzato di Anthropic, che copre comportamenti disallineati come cooperazione con abusi e inganno. Il cofondatore di Lovable lo ha detto in modo semplice: un modello che sa quando dire di no è importante quanto uno che sa costruire.
La precisazione è che Sonnet 5 mostra ancora tassi più alti di comportamento disallineato rispetto al più capace Opus 4.8 e a Claude Mythos Preview, quindi è più sicuro del suo predecessore ma non è il modello più sicuro nella lineup di Anthropic.
Fonte: Anthropic
Sonnet 5 parte con protezioni cyber in tempo reale attivate di default, le stesse presenti in Claude Opus 4.7 e 4.8. Rilevano e bloccano l’uso cyber pericoloso mentre avviene.
Nelle valutazioni di Anthropic, Sonnet 5 ha capacità cyber pericolose sostanzialmente più deboli rispetto a Opus 4.8 e Mythos 5. In un test costruito con Mozilla per sviluppare exploit di vulnerabilità in Firefox 147, né Sonnet 5 né Sonnet 4.6 hanno mai prodotto un exploit funzionante (entrambi 0,0%), anche se Sonnet 5 ha mostrato un tasso di successo parziale leggermente più alto, che Anthropic attribuisce a guadagni di intelligenza generale piuttosto che a training specifico cyber.
Per i ricercatori di sicurezza che necessitano di barriere ridotte, Anthropic consiglia invece Opus 4.8. Le protezioni di Sonnet 5 sono meno rigide di quelle introdotte con Fable 5, che bloccavano una gamma più ampia di attività di cybersecurity.
La narrazione di Anthropic sui benchmark di Sonnet 5 è coerente: è un miglioramento netto rispetto a Sonnet 4.6 e si posiziona appena sotto Opus 4.8 nelle valutazioni pubblicate finora. I numeri sotto provengono dai materiali di lancio di Anthropic. Una nota di cautela: alcuni revisori terzi hanno riportato cifre diverse sugli stessi benchmark, probabilmente per differenze in dataset, impostazioni di contesto o scaffold degli agenti; quindi considera i numeri di copertina come dipendenti dalla configurazione.
| Sonnet 5 | Sonnet 4.6 | Opus 4.8 Per riferimento |
|
|---|---|---|---|
| Coding agentico SWE-bench Pro |
63,2% | 58,1% | 69,2% |
| Coding agentico Terminal-Bench 2.1 |
80,4% | 67,0% | 82,7% |
| Ragionamento multidisciplinare Humanity's Last Exam |
43,2% senza strumenti 57,4% con strumenti |
34,6% senza strumenti 46,8% con strumenti |
49,8% senza strumenti 57,9% con strumenti |
| Uso del computer OSWorld-Verified |
81,2% | 78,5% | 83,4% |
| Knowledge work GDPval-AA v2 |
1618 | 1395 | 1615 |
Nel benchmark di coding agentico pubblicato da Anthropic, Sonnet 5 ottiene il 63,2%, contro il 69,2% di Opus 4.8 e il 58,1% di Sonnet 4.6. Questo benchmark misura se un modello sa scrivere, eseguire e correggere codice su più passaggi, invece di produrre un singolo snippet.
Il divario con Opus 4.8 è di circa 6 punti, mentre il salto rispetto a Sonnet 4.6 è di circa 5 punti. Per gli sviluppatori, significa che Sonnet 5 è un upgrade chiaro rispetto al precedente modello di fascia media, pur senza eguagliare il top di gamma.
Fonte: Anthropic
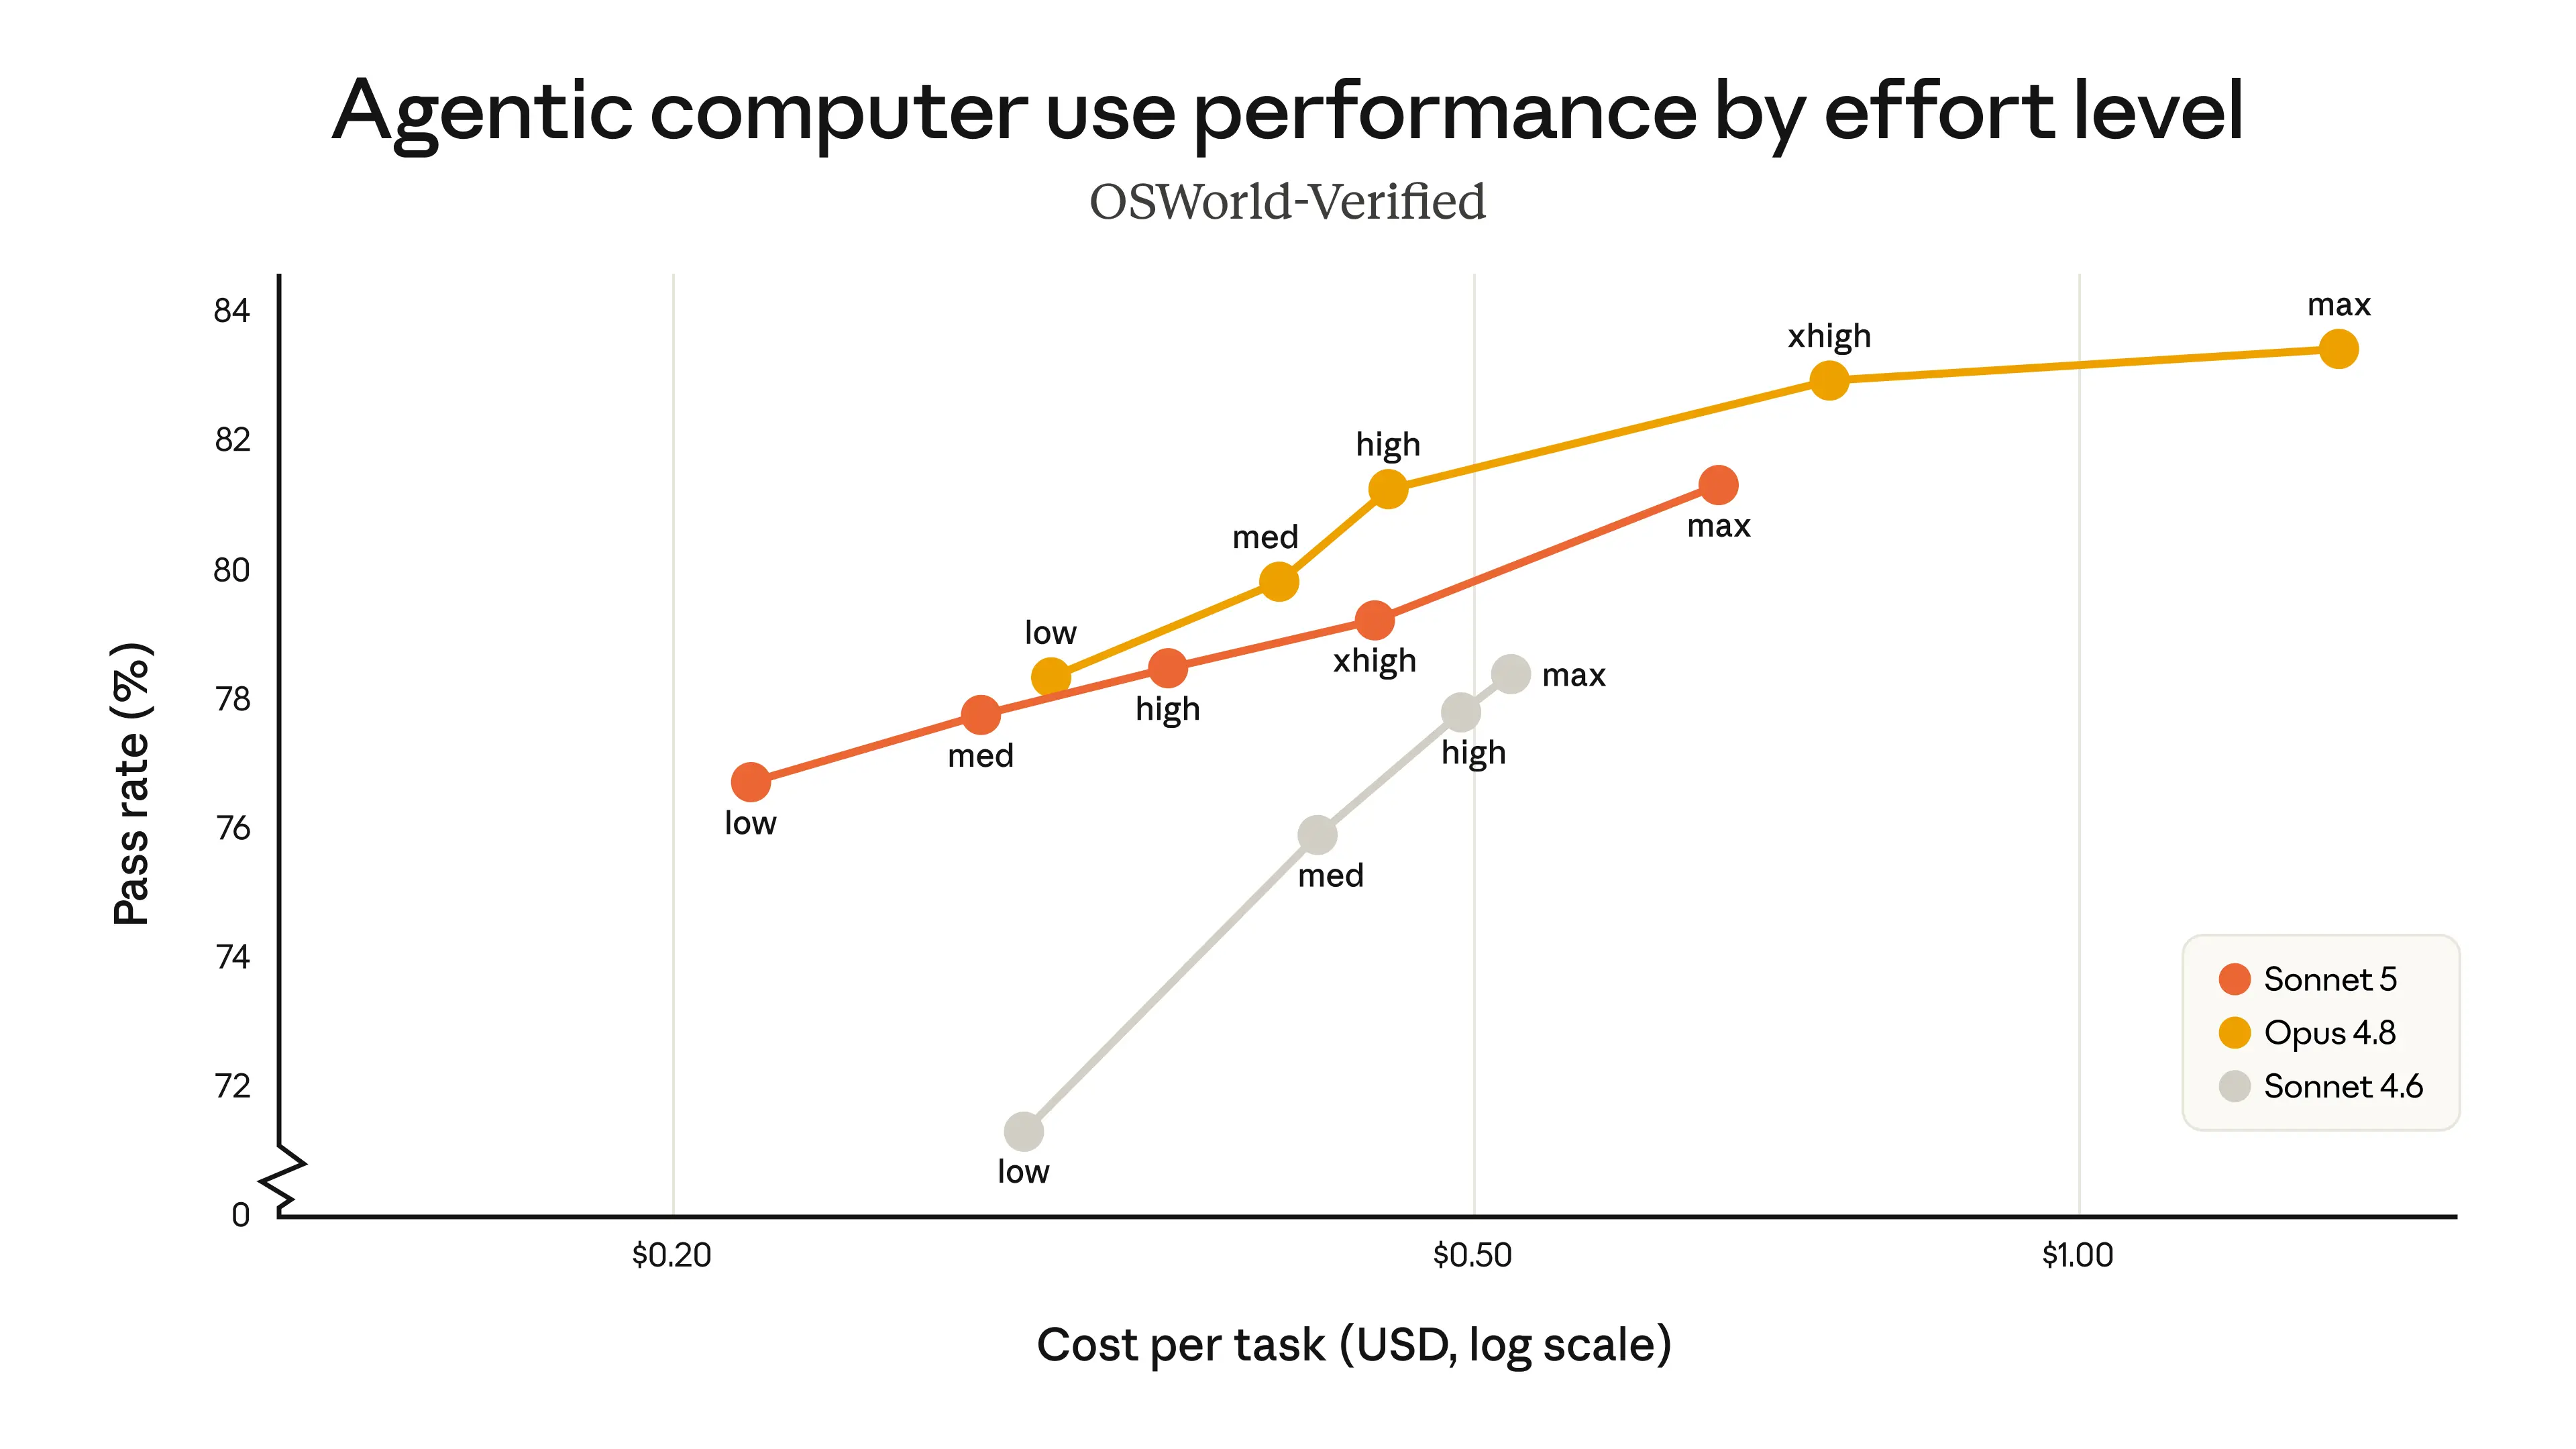
OSWorld-Verified misura la capacità di usare il computer, controllando un desktop per completare task reali, mentre BrowseComp misura la ricerca web agentica. Anthropic ha aggiornato la metodologia OSWorld-Verified e ora riporta Sonnet 4.6 al 78,5% nel setup rivisto.
Su entrambe le valutazioni, Sonnet 5 è un miglioramento netto rispetto a Sonnet 4.6 a ogni livello di sforzo, mentre Opus 4.8 resta la scelta con accuratezza più alta. Con sforzo Extra High, Sonnet 5 raggiunge circa la performance medio-alta di Opus 4.8, ma a quel punto il vantaggio di costo si assottiglia: per questo Anthropic presenta i due modelli come un’unica fascia costo-accuratezza più che un upgrade lineare.
Su un benchmark di knowledge work, Sonnet 5 supera di poco Opus 4.8, secondo quanto riportato da TechCrunch. È notevole perché Opus 4.8 è di solito associato alle decisioni più difficili e alla ricerca più profonda.
Anthropic ha anche aggiornato il suo valutatore per Humanity's Last Exam e ora riporta Sonnet 4.6 al 34,6% (senza strumenti) e 46,8% (con strumenti), motivo per cui quei numeri differiscono dal lancio originale di Sonnet 4.6. Per chi lavora sul campo, il risultato nel knowledge work suggerisce che Sonnet 5 è valido per attività di analisi e ricerca che prima sembravano territorio di Opus.
Per un contesto più ampio sulla posizione della fascia Sonnet, torna utile il nostro confronto Sakana Fugu vs Claude Fable 5. In quel confronto, il più avanzato Claude Fable 5 ha ottenuto l’80,3% su SWE-Bench Pro e il 59,0% su Humanity's Last Exam (senza strumenti), ben al di sopra delle cifre di fascia media qui riportate.
Ed è proprio questo il senso. La lineup di Anthropic va dal Sonnet 5, agentico e a costo più basso, fino a Opus 4.8 e alle classi Mythos e Fable, con ogni fascia che scambia costo con accuratezza sui problemi più difficili.
Claude Sonnet 5 è disponibile ovunque dal giorno del lancio. È il modello predefinito per i piani Free e Pro, ed è disponibile per gli utenti Max, Team ed Enterprise, oltre che in Claude Code e sulla Claude Platform.
Gli sviluppatori possono chiamarlo tramite la Claude API usando l’ID modello claude-sonnet-5. La tariffazione funziona in due fasi:
Un dettaglio da considerare a budget: Sonnet 5 usa un tokenizer aggiornato, quindi lo stesso input può corrispondere a più token rispetto a prima, circa da 1,0 a 1,35 volte a seconda del tipo di contenuto. Anthropic ha impostato il prezzo introduttivo in modo che la transizione da Sonnet 4.6 sia approssimativamente neutra sui costi. L’azienda ha anche aumentato i rate limit su Chat, Cowork, Claude Code e Claude Platform per gestire l’uso di token più elevato che i livelli di sforzo più alti comportano.
Per chi vuole un confronto rapido, ecco come si allineano i tre modelli secondo le cifre pubblicate da Anthropic.
| Modello | Coding agentico | OSWorld-Verified | Prezzo input/output (per 1M token) |
|---|---|---|---|
| Sonnet 5 | 63,2% | Migliora rispetto a 4.6 a tutti i livelli di sforzo | 2 $ / 10 $ (intro), poi 3 $ / 15 $ |
| Sonnet 4.6 | 58,1% | 78,5% (rivisto) | 3 $ / 15 $ |
| Opus 4.8 | 69,2% | Scelta a maggiore accuratezza | 5 $ / 25 $ |
Sonnet 5 è la dichiarazione più chiara di Anthropic che la capacità agentica è ormai l’aspettativa di base a ogni fascia di prezzo, non una funzione solo da flagship. Il fattore distintivo non è più chi fa meglio il lavoro agentico, ma chi lo fa in modo economico e affidabile senza supervisione umana.
Ciò che trovo più interessante è il prezzo introduttivo. Sembra che Anthropic voglia che i clienti testino Sonnet 5 su carichi reali al costo più basso possibile durante la finestra di migrazione, una mossa che suona come un tentativo deliberato di spostare le persone da Opus 4.8 per il lavoro agentico di routine e liberarne la capacità. Sotto il profilo del prezzo, batte anche GPT-5.5 di OpenAI e Gemini 3.1 Pro di Google, anche se Gemini 3.5 Flash resta più economico.
Se stai costruendo agenti che eseguono task prolungati e multi-step, Sonnet 5 sembra il nuovo default da provare per primo, passando a Opus 4.8 solo quando un compito richiede davvero l’extra di accuratezza. L’onesta precisazione è che alcuni revisori terzi vedono in Sonnet 5 uno scambio tra profondità di ragionamento e velocità di coding; quindi, per scienza a livello PhD o lavori con molta navigazione, Opus 4.8 potrebbe restare la scelta più sicura.
Se vuoi mettere le mani in pasta con l’automazione per cui è pensato Sonnet 5, ti consiglio il nostro tutorial su Claude Code Routines, che spiega come far girare un agente di coding a orario nel cloud.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



