Cours
Coder avec l’aide de l’IA pour les développeurs
1 h 30 min
10.7K
Z.ai a lancé GLM-5.3-Flash, la déclinaison optimisée pour les coûts de son fleuron GLM-5.3, initialement publiée en aperçu anonyme avant d’être révélée publiquement sous le nom de code "Ox Alpha". Qwen3.8-Flash-Next est arrivé le même jour : le segment des LLM à budget serré s’est donc animé très vite.
Si vous suivez la course entre les laboratoires chinois open-weight et la frontière occidentale, ce modèle mérite votre attention.
La promesse est simple : des performances en code et en agents proches de l’état de l’art, pour une fraction du coût.
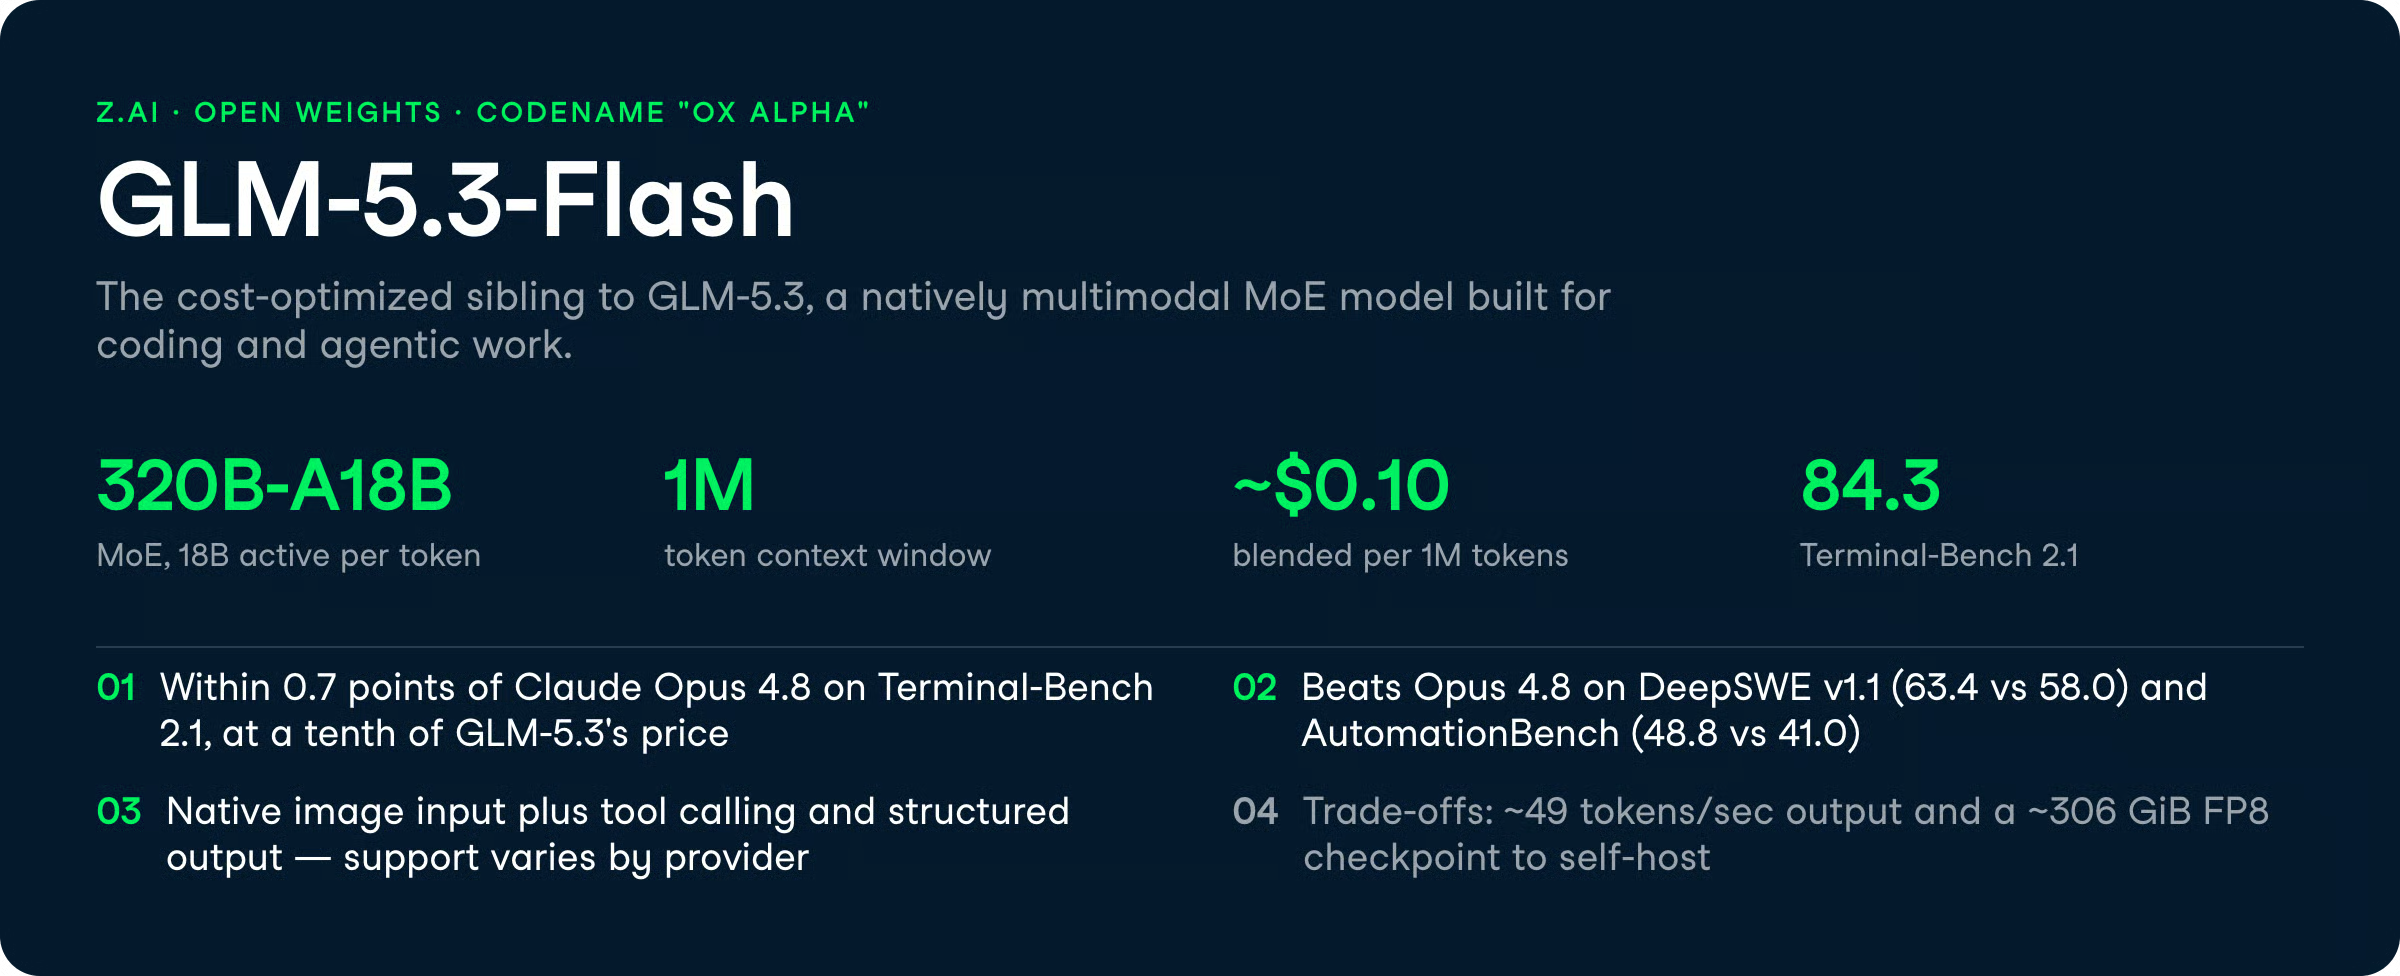
GLM-5.3-Flash obtient 84,3 sur Terminal-Bench 2.1, ce qui le place à portée de Claude Opus 4.8 (85,0) et de GPT-5.6 Terra (87,4).
Il adopte une architecture mixture-of-experts en configuration 320B-A18B (320 milliards de paramètres agrégés, 18 milliards actifs par token), prend en charge une fenêtre de contexte d’1 million de tokens, et est nativement multimodal.
Dans cet article, nous passons en revue les nouveautés de GLM-5.3-Flash : ses fonctionnalités et ses benchmarks. Pour voir le modèle à l’œuvre, consultez notre tutoriel GLM-5.3-Flash, où nous l’utilisons avec CrewAI pour créer une équipe d’analystes financiers multi-agents.
Si vous souhaitez le comparer à l’autre modèle économique sorti le même jour, lisez notre guide sur Qwen3.8-Flash-Next. Et pour un modèle MoE similaire exécuté en local, suivez notre tutoriel sur l’exécution de DeepSeek-V4-Flash-0731.
GLM-5.3-Flash est le modèle optimisé pour les coûts de Z.ai au sein de la famille GLM-5.3. Il est moins capable que le fleuron GLM-5.3, mais nettement moins cher.
Artificial Analysis l’évalue à un indice d’intelligence de 57, contre 60 pour GLM-5.3.
Le compromis porte sur la vitesse et le coût : Flash est facturé à environ un dixième du prix de GLM-5.2, soit environ un neuvième du prix moyen de GLM-5.3, et il génère plus lentement par token.
Le modèle a d’abord été diffusé en aperçu anonyme avant d’être nommé, et la communauté lui a rapidement attribué le nom de code "Ox Alpha".
Le checkpoint public est disponible sous zai-org/GLM-5.3-Flash sur Hugging Face, avec prise en charge du long contexte (~1 M de tokens) et des capacités d’appel d’outils et multimodales exposées via l’écosystème associé.
Le benchmark le plus pertinent ici est Terminal-Bench 2.1, où GLM-5.3-Flash atteint 84,3. C’est au-dessus des 82,7 observés pour DeepSeek-V4-Flash-0731, et seulement 0,7 point derrière Claude Opus 4.8. Pour un modèle dont le prix moyen pondéré par l’usage est estimé à ~0,10 $ par 1 M de tokens, c’est l’axe principal de cette sortie.
GLM-5.3-Flash s’adresse aux développeurs qui veulent des performances en agents et en code sans les tarifs d’un modèle phare.
Voici les capacités qui comptent pour un usage concret.
Vous pouvez exécuter des agents de codage et des workflows d’automatisation à un coût compatible avec des volumes élevés.
GLM-5.3-Flash obtient 84,3 sur Terminal-Bench 2.1 et 63,4 sur DeepSWE v1.1, en forte hausse par rapport aux 46,2 de GLM-5.2 sur la même évaluation DeepSWE.
Pour les praticiens, l’intérêt est de lancer des tâches de codage qui seraient coûteuses sur des modèles de classe Opus.
Plusieurs comparatifs présentent Flash comme "solide" pour le code et les agents d’automatisation, à un coût nettement inférieur à GLM-5.3. Le saut sur DeepSWE par rapport à GLM-5.2 suggère des gains réels en codage, et pas seulement un effet de benchmark.
Vous pouvez fournir des bases de code entières, de longs documents ou des traces multi-fichiers d’agents dans une seule requête.
GLM-5.3-Flash prend en charge une fenêtre de contexte d’1 million de tokens, comme GLM-5.3 ainsi que les fenêtres d’1 million de tokens de GPT-5.6 Terra et de Claude Sonnet 5.
Cependant, des retours de la communauté évoquent une dérive de l’attention à des longueurs extrêmes au-delà d’environ 700 000 tokens, une limite partagée par la plupart des pairs offrant de grands contextes.
La restitution est bonne sur plusieurs centaines de milliers de tokens, mais n’attendez pas une récupération parfaite à l’extrémité de la fenêtre.
Vous pouvez connecter GLM-5.3-Flash à des frameworks d’agents via des appels de fonction et des schémas JSON contraints. Le modèle obtient 78,4 sur Toolathlon et 48,8 sur AutomationBench, ce dernier score étant en forte hausse par rapport aux 26,2 de GLM-5.2.
Point d’attention : le support varie selon les fournisseurs.
Certains gateways n’activent pas les sorties structurées, et la gestion du system prompt diffère entre hébergeurs ; vous devrez peut-être adapter votre schéma d’outils et le mode JSON selon l’endpoint.
Vous pouvez transmettre des images avec le texte pour lire des graphiques, analyser des documents et raisonner visuellement.
GLM-5.3-Flash atteint 89,4 % sur CharXiv-R, 80,5 sur MMVU et 78,0 sur Chartography, des scores indiquant une gestion solide des graphiques et des documents visuels.
Le support multimodal est natif plutôt qu’additionnel. Comme pour l’appel d’outils, l’interface exacte dépend toutefois du fournisseur : un simple checkout sur Hugging Face peut ne pas exposer tout ce que propose l’API hébergée.
GLM-5.3-Flash obtient 57 sur l’Artificial Analysis Intelligence Index v4.1.1 pour 0,045 $ par tâche (tarif promotionnel). Z.ai affirme que ce niveau d’intelligence coûtait auparavant environ dix fois plus.
L’évaluation en six benchmarks ci-dessous compare Flash à GLM-5.2, DeepSeek-V4-Vision-Exp, Claude Opus 4.8, GPT-5.6 Terra et Gemini 3.7 Flash.
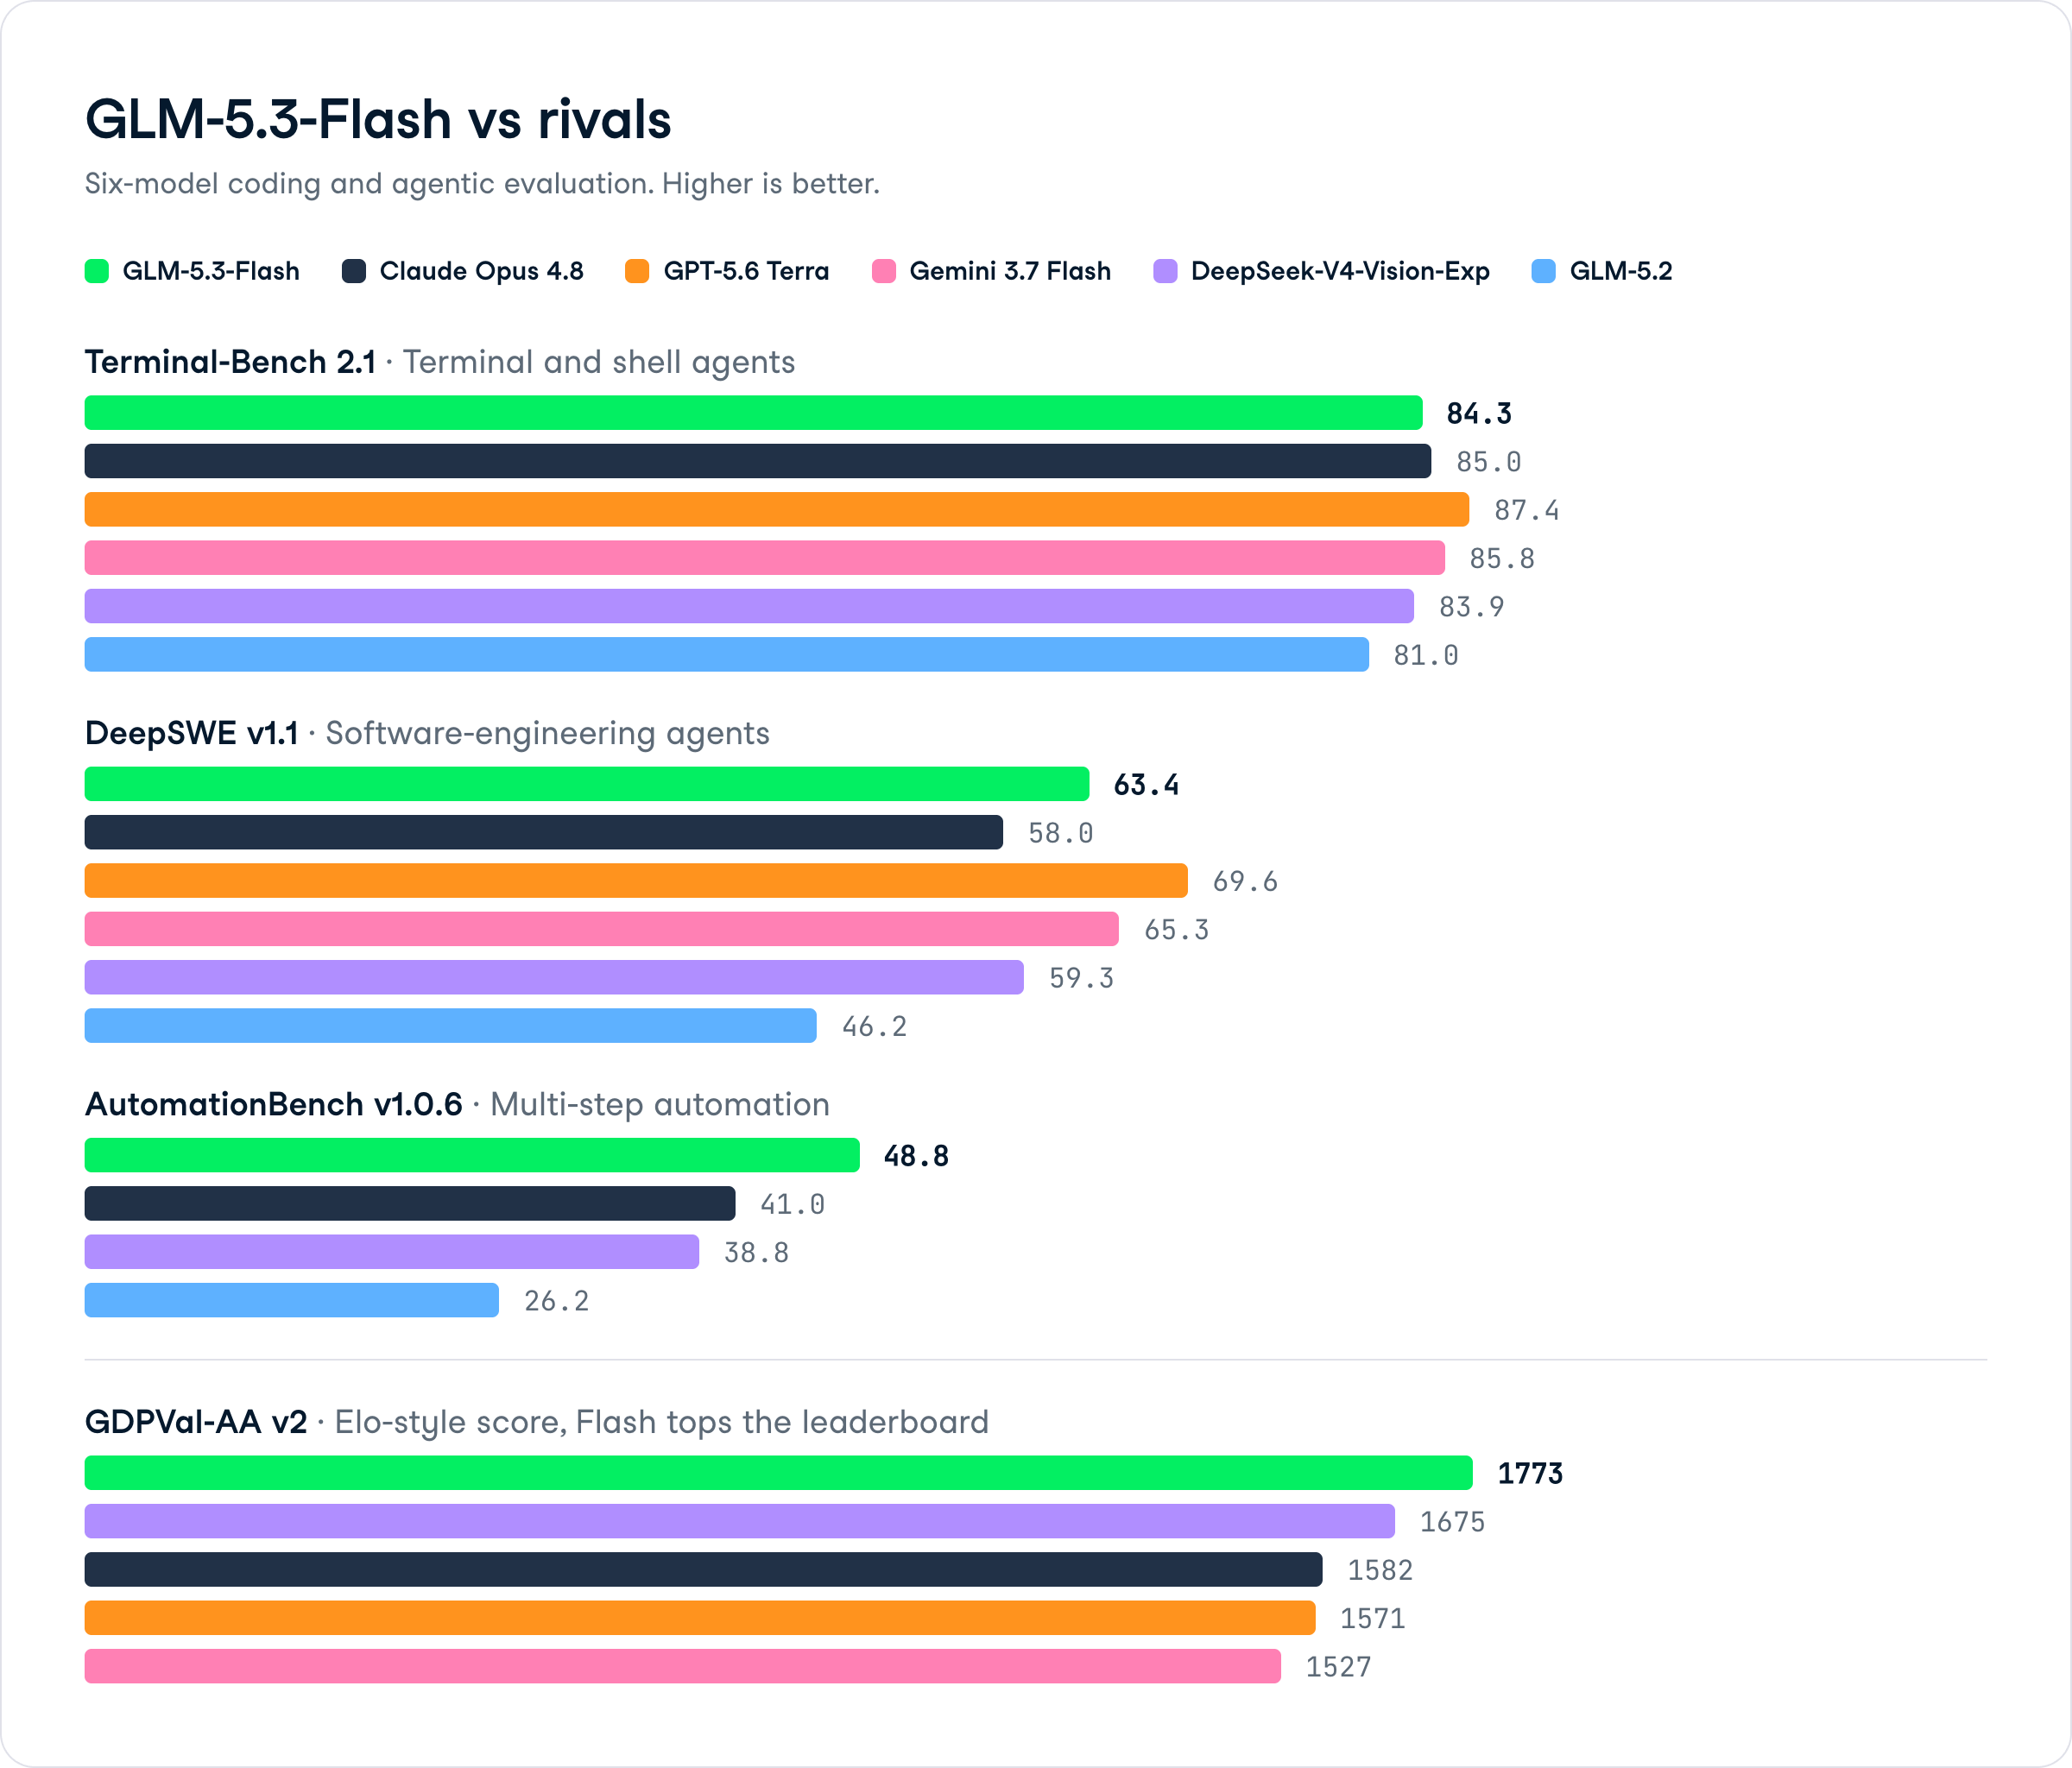
Sur ce benchmark d’agents en génie logiciel, GLM-5.3-Flash atteint 63,4, devant Claude Opus 4.8 (58,0) et DeepSeek-V4-Vision-Exp (59,3), et en hausse par rapport aux 46,2 de GLM-5.2.
Il est devancé par GPT-5.6 Terra (69,6) et Gemini 3.7 Flash (65,3), mais battre Claude à un coût « Flash » est ici l’enseignement clé.
GLM-5.3-Flash obtient 48,8 sur des workflows d’automatisation multi-étapes, soit l’avance la plus marquée sur Claude Opus 4.8 (41,0) et DeepSeek-V4-Vision-Exp (38,8) parmi l’ensemble des benchmarks.
GLM-5.2 obtenait 26,2 ; c’est donc aussi l’amélioration générationnelle la plus nette.
Sur cette évaluation générale en développement et programmation, Flash prend la tête avec 1773, devant DeepSeek-V4-Vision-Exp (1675), Claude Opus 4.8 (1582), GPT-5.6 Terra (1571) et Gemini 3.7 Flash (1527).
Flash obtient 84,3 sur des tâches d’agents terminal et shell, juste sous Claude Opus 4.8 (85,0) et Gemini 3.7 Flash (85,8), et derrière GPT-5.6 Terra (87,4). Il devance légèrement GLM-5.2 (81,0) et DeepSeek-V4-Vision-Exp (83,9). Compétitif, sans dominer.
GLM-5.3-Flash est disponible via l’API de Z.ai et auprès de plusieurs gateways tiers, dont Baseten, Deep Infra, Venice AI et Requesty.
Le checkpoint public zai-org/GLM-5.3-Flash est sur Hugging Face pour un auto-hébergement.
La grille tarifaire officielle de Z.ai et sa promotion à durée limitée sont les suivantes :
Apidog indique un prix moyen pondéré par l’usage d’environ 0,10 $ par 1 M de tokens pour Flash, contre ~0,90 $ pour GLM-5.3.
Les gateways tiers appliquent d’autres tarifs : EmpirioLabs à 0,07 $ en entrée / 0,25 $ en sortie, Venice AI à 0,09 $ / 0,31 $, et Requesty à 0,14 $ / 0,45 $ avec une promo -55 % annoncée jusqu’au 9 septembre 2026.
Le revers de la médaille : le débit et le matériel.
Flash sert à ~49 tokens/s contre ~86 pour GLM-5.3, et Artificial Analysis lui attribue 2/4 en vitesse.
L’auto-hébergement n’est pas léger non plus : le checkpoint FP8 pèse ~306 GiB rien qu’en poids, hors KV-cache et runtime, ce qui requiert plusieurs GPU à grande mémoire (comptez >4×80 GiB) plutôt qu’une seule carte.
Le choix dépend du coût, de l’indice d’intelligence et du débit. Le tableau ci-dessous résume le compromis.
| Attribut | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Indice d’intelligence (Artificial Analysis) | 57 | 60 |
| Prix moyen / 1 M de tokens | ~0,10 $ | ~0,90 $ |
| Vitesse de sortie | ~49 tokens/s | ~86 tokens/s |
| Temps jusqu’au premier token | ~1,52 s | ~1,57 s |
| Terminal-Bench 2.1 | 84,3 | N/A dans les notes |
| Fenêtre de contexte | 1 M | 1 M |
Choisissez Flash si le coût par token est votre contrainte et que vos usages portent sur le code ou les agents. Optez pour GLM-5.3 si vous avez besoin de quelques points d’intelligence en plus et d’un débit presque doublé.
Les deux modèles ont été lancés le 26 août 2026, sur le même segment agentique à budget serré. GLM-5.3-Flash devance légèrement Qwen3.8-Flash-Next sur leur benchmark commun (DeepSWE v1.1 : 63,4 vs 58,7), mais leurs conceptions diffèrent suffisamment pour que le choix dépende davantage de votre charge de travail que d’un score isolé.
| GLM-5.3-Flash | Qwen3.8-Flash-Next | |
|---|---|---|
| Architecture | 320B total / 18B actifs | 125B total / 6B actifs |
| Contexte natif | 1 M de tokens | 262 K (1 M avec YaRN) |
| DeepSWE v1.1 | 63,4 | 58,7 |
| Prix d’entrée | ~0,075 $/1 M (promo) | 0,16 $/1 M |
| Multimodal | Oui (natif) | Oui (natif) |
GLM-5.3-Flash active trois fois plus de paramètres par token, ce qui explique probablement l’avance sur DeepSWE et le score à Terminal-Bench 2.1 (84,3).
Qwen3.8-Flash-Next se distingue par de meilleurs scores rapportés sur SWE-bench Pro (62,5) et des benchmarks « office » et agents comme CoWorkBench (73,9) et JobBench (55,7), pour lesquels GLM ne publie pas d’équivalents.
Côté prix, GLM est moins cher pendant sa fenêtre promotionnelle. En efficacité paramétrique, Qwen en fait plus avec une empreinte active plus réduite. En auto-hébergement, le checkpoint plus petit de Qwen est nettement plus simple à faire tourner en local.
Si votre priorité est les agents de codage et le débit agentique brut, GLM-5.3-Flash affiche les meilleurs chiffres là où la comparaison est directe. Si vos workflows sont orientés bureautique, multimodal, ou bénéficient d’un checkpoint local plus compact, commencez par tester Qwen3.8-Flash-Next.
Consultez notre guide complet de Qwen3.8-Flash-Next pour une analyse détaillée.
Avec GLM-5.3-Flash, Z.ai mise clairement sur le segment agentique à budget serré : se hisser à un ou deux points d’Opus 4.8 et de GPT-5.6 Terra sur les évaluations de code, puis les sous-coter d’un ordre de grandeur sur le prix.
Les 84,3 sur Terminal-Bench 2.1 pour environ 0,10 $ le million de tokens en prix moyen, c’est l’argument — et il est convaincant pour le code et l’automatisation à grande échelle.
Les limites viennent de la vitesse et de l’infrastructure.
À ~49 tokens/s, ce n’est pas le modèle pour du streaming sensible à la latence, et le checkpoint FP8 d’environ 306 GiB exclut un déploiement local « casual ». Les premiers testeurs sur r/opencodeCLI ont signalé des files d’attente et des démarrages lents sous charge, même si la GA a probablement amélioré la situation.
Selon nous, si votre contrainte majeure est le coût par token et que vos usages sont le code ou les agents, GLM-5.3-Flash mérite un test face à GPT-5.6 Terra et Claude Opus 4.8 avant de vous engager.
Si vous avez besoin de 3 points d’indice d’intelligence en plus et d’un débit plus rapide, le GLM-5.3 « complet » est là pour ça. Il sort aussi le même jour que Qwen3.8-Flash-Next : le segment budget vaut la peine d’être comparé dès maintenant.
Pour vous familiariser avec ce type de modèles, nous recommandons notre parcours de compétences AI Fundamentals pour poser les bases, puis notre tutoriel sur l’exécution locale d’un modèle MoE Flash pour la mise en pratique.
Les meilleurs cours DataCamp
Cours
Cours
Cours
blog
Lynn Heidmann
blog
blog
Kurtis Pykes
9 min
Tutoriel
Tutoriel
Josef Waples
8 min
Tutoriel
Laiba Siddiqui
14 min