Kurs
KI-gestütztes Programmieren für Entwickler
1 Std. 30 Min.
10.7K
Z.ai hat GLM-5.3-Flash veröffentlicht, den kostenoptimierten Ableger des Flaggschiffs GLM-5.3. Zunächst erschien es anonym in einer Preview und wurde dann öffentlich als "Ox Alpha" enthüllt. Am selben Tag startete auch Qwen3.8-Flash-Next – das Budget-Segment der LLMs war damit sofort belebt.
Wenn du das Rennen zwischen offenen chinesischen Labs und der westlichen Spitze verfolgst, lohnt sich hier ein genauer Blick.
Die Kernaussage ist simpel: Nahezu Top-Leistung bei Coding und Agenten – zu einem Bruchteil der Kosten.
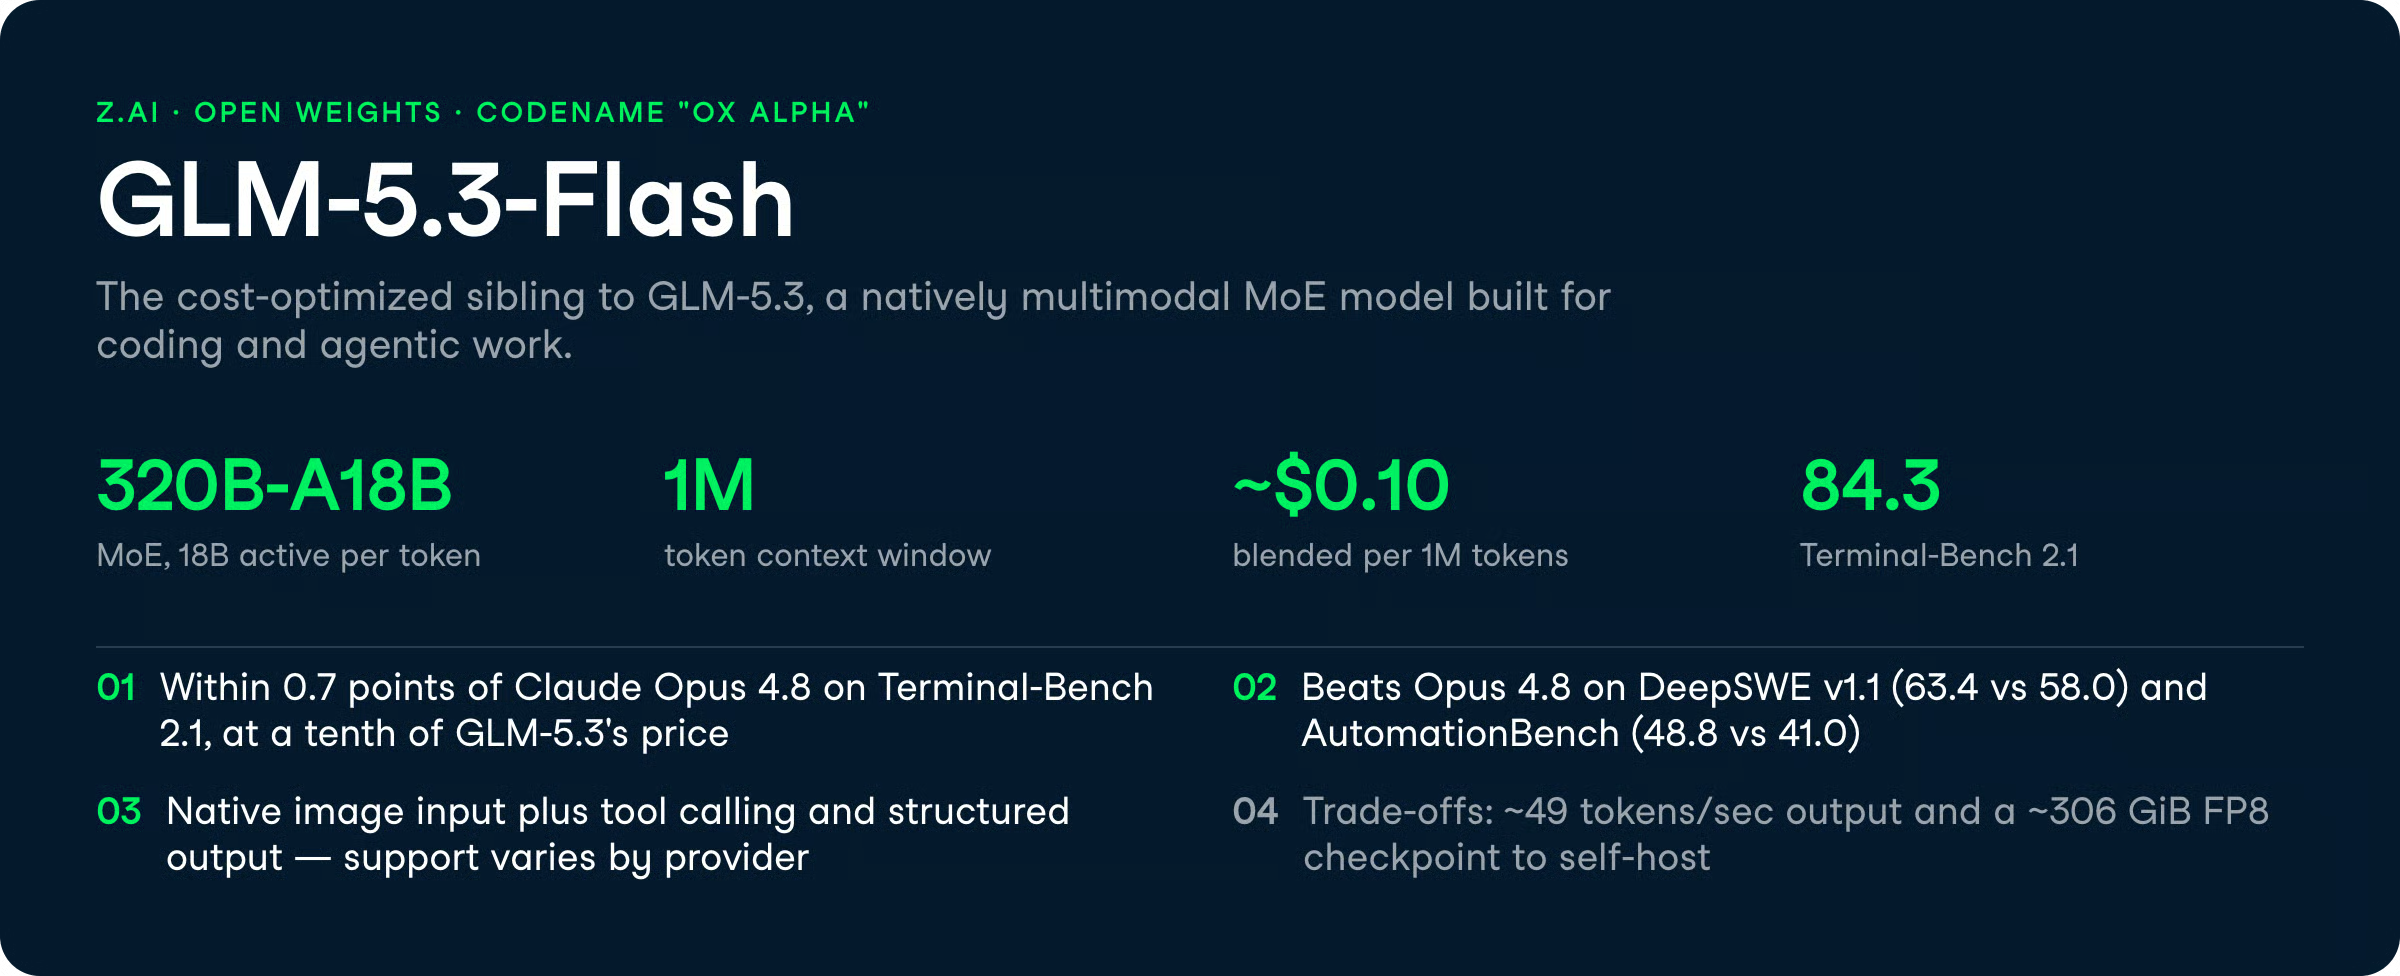
GLM-5.3-Flash erreicht 84,3 auf dem Terminal-Bench 2.1 und liegt damit in Schlagdistanz zu Claude Opus 4.8 (85,0) und GPT-5.6 Terra (87,4).
Es nutzt ein Mixture-of-Experts-Design in einer 320B-A18B-Konfiguration (320B Gesamtparameter, 18B aktiv pro Token), unterstützt ein 1M-Token-Kontextfenster und ist nativ multimodal.
In diesem Artikel gehe ich alle Neuerungen bei GLM-5.3-Flash durch, stelle die Features vor und beleuchte die Benchmarks. Um das Modell in Aktion zu sehen, schau dir unser GLM-5.3-Flash-Tutorial an – dort nutzen wir es mit CrewAI, um ein multiagentisches Team für Finanzanalysen aufzubauen.
Wenn du es mit dem anderen Budget-Modell vergleichen willst, das am gleichen Tag erschien, lies unseren Guide zu Qwen3.8-Flash-Next. Und für ein ähnliches MoE-Modell, das wir lokal ausgeführt haben, empfehlen wir unser Tutorial zum lokalen Betrieb von DeepSeek-V4-Flash-0731.
GLM-5.3-Flash ist Z.ais kostenoptimiertes Modell der GLM-5.3-Familie. Es liegt bei den Fähigkeiten unter dem Vollformat-Flaggschiff GLM-5.3, beim Preis aber deutlich darunter.
Artificial Analysis bewertet es mit einem Intelligenzindex von 57, gegenüber 60 für GLM-5.3.
Der Trade-off sind Geschwindigkeit und Kosten: Flash kostet etwa ein Zehntel von GLM-5.2 bzw. rund ein Neuntel des gemischten GLM-5.3-Preises, läuft dafür pro Token langsamer.
Das Modell erschien zuerst anonym in einer Preview, bevor es benannt wurde. Die Community gab ihm schnell den Codenamen "Ox Alpha".
Das öffentliche Checkpoint ist als zai-org/GLM-5.3-Flash auf Hugging Face verfügbar, mit Langkontext-Unterstützung (~1M Tokens) sowie Tool-Calling und Multimodalität über das umgebende Ökosystem.
Der wichtigste Benchmark ist hier der Terminal-Bench 2.1, auf dem GLM-5.3-Flash 84,3 erreicht. Das liegt über den 82,7, die wir für DeepSeek-V4-Flash-0731 sahen, und nur 0,7 Punkte hinter Claude Opus 4.8. Für ein Modell mit einem gemischt nutzungsgewichteten Preis von etwa $0,10 pro 1M Tokens ist das die Story dieses Releases.
GLM-5.3-Flash ist für Entwickler gebaut, die starke Agenten- und Coding-Leistung ohne Flaggschiff-Preise brauchen.
Das sind die praxisrelevanten Fähigkeiten.
Du kannst Coding-Agenten und Automations-Workflows zu einem Preis betreiben, der hohen Durchsatz realistisch macht.
GLM-5.3-Flash erzielt 84,3 auf Terminal-Bench 2.1 und 63,4 auf DeepSWE v1.1 – ein deutlicher Sprung gegenüber 46,2 bei GLM-5.2 im gleichen DeepSWE-Eval.
Für Praktiker liegt der Reiz darin, Coding-Aufgaben zu fahren, die auf Opus-Klasse-Modellen teuer wären.
Manche Vergleiche positionieren Flash als „stark“ für Coding- und Automations-Agenten bei deutlich geringeren Kosten als GLM-5.3, und der DeepSWE-Sprung über GLM-5.2 legt nahe, dass die Coding-Verbesserungen real sind und nicht nur benchmark-spezifisch.
Du kannst ganze Codebasen, lange Dokumente oder mehrteilige Agent-Traces in einer einzigen Anfrage verarbeiten.
GLM-5.3-Flash unterstützt ein 1M-Token-Kontextfenster – wie GLM-5.3 sowie die 1M-Fenster von GPT-5.6 Terra und Claude Sonnet 5.
Allerdings berichten Community-Posts von einem Aufmerksamkeits-„Drift“ bei extremen Längen jenseits von etwa 700K Tokens – eine Einschränkung, die die meisten Modelle mit großem Kontextfenster teilen.
Die Wiedererkennung über mehrere hunderttausend Tokens gilt als gut, aber am äußersten Rand des Fensters solltest du keine perfekte Trefferquote erwarten.
Du kannst GLM-5.3-Flash mit Funktionsaufrufen und erzwungenen JSON-Schemata in Agenten-Frameworks einbinden. Das Modell erreicht 78,4 auf Toolathlon und 48,8 auf AutomationBench – Letzteres ist ein großer Sprung gegenüber 26,2 bei GLM-5.2.
Wichtig zu beachten: Die Unterstützung variiert je nach Anbieter.
Manche Gateways kennzeichnen strukturierte Ausgaben als nicht unterstützt, und die Handhabung von Systemprompts unterscheidet sich zwischen gehosteten Providern. Du musst Tool-Schema und JSON-Modus ggf. pro Endpoint anpassen.
Du kannst Bilder zusammen mit Text übergeben – für Diagrammlesen, Dokumentanalyse und visuelles Reasoning.
GLM-5.3-Flash erzielt 89,4% auf CharXiv-R, 80,5 auf MMVU und 78,0 auf Chartography – solide Werte für Diagramm- und visuelle Dokumentverarbeitung.
Die Multimodalität ist nativ statt nachträglich aufgesetzt. Wie beim Tool-Calling hängt die genaue Oberfläche aber vom Provider ab. Ein reines Hugging-Face-Checkout zeigt ggf. nicht alles, was die gehostete API bietet.
GLM-5.3-Flash erzielt 57 auf dem Artificial Analysis Intelligence Index v4.1.1 bei $0,045 pro Task (rabattiert). Z.ai sagt, dieses Intelligenzniveau habe zuvor etwa das Zehnfache gekostet.
Die folgende Auswertung über sechs Benchmarks vergleicht Flash mit GLM-5.2, DeepSeek-V4-Vision-Exp, Claude Opus 4.8, GPT-5.6 Terra und Gemini 3.7 Flash.
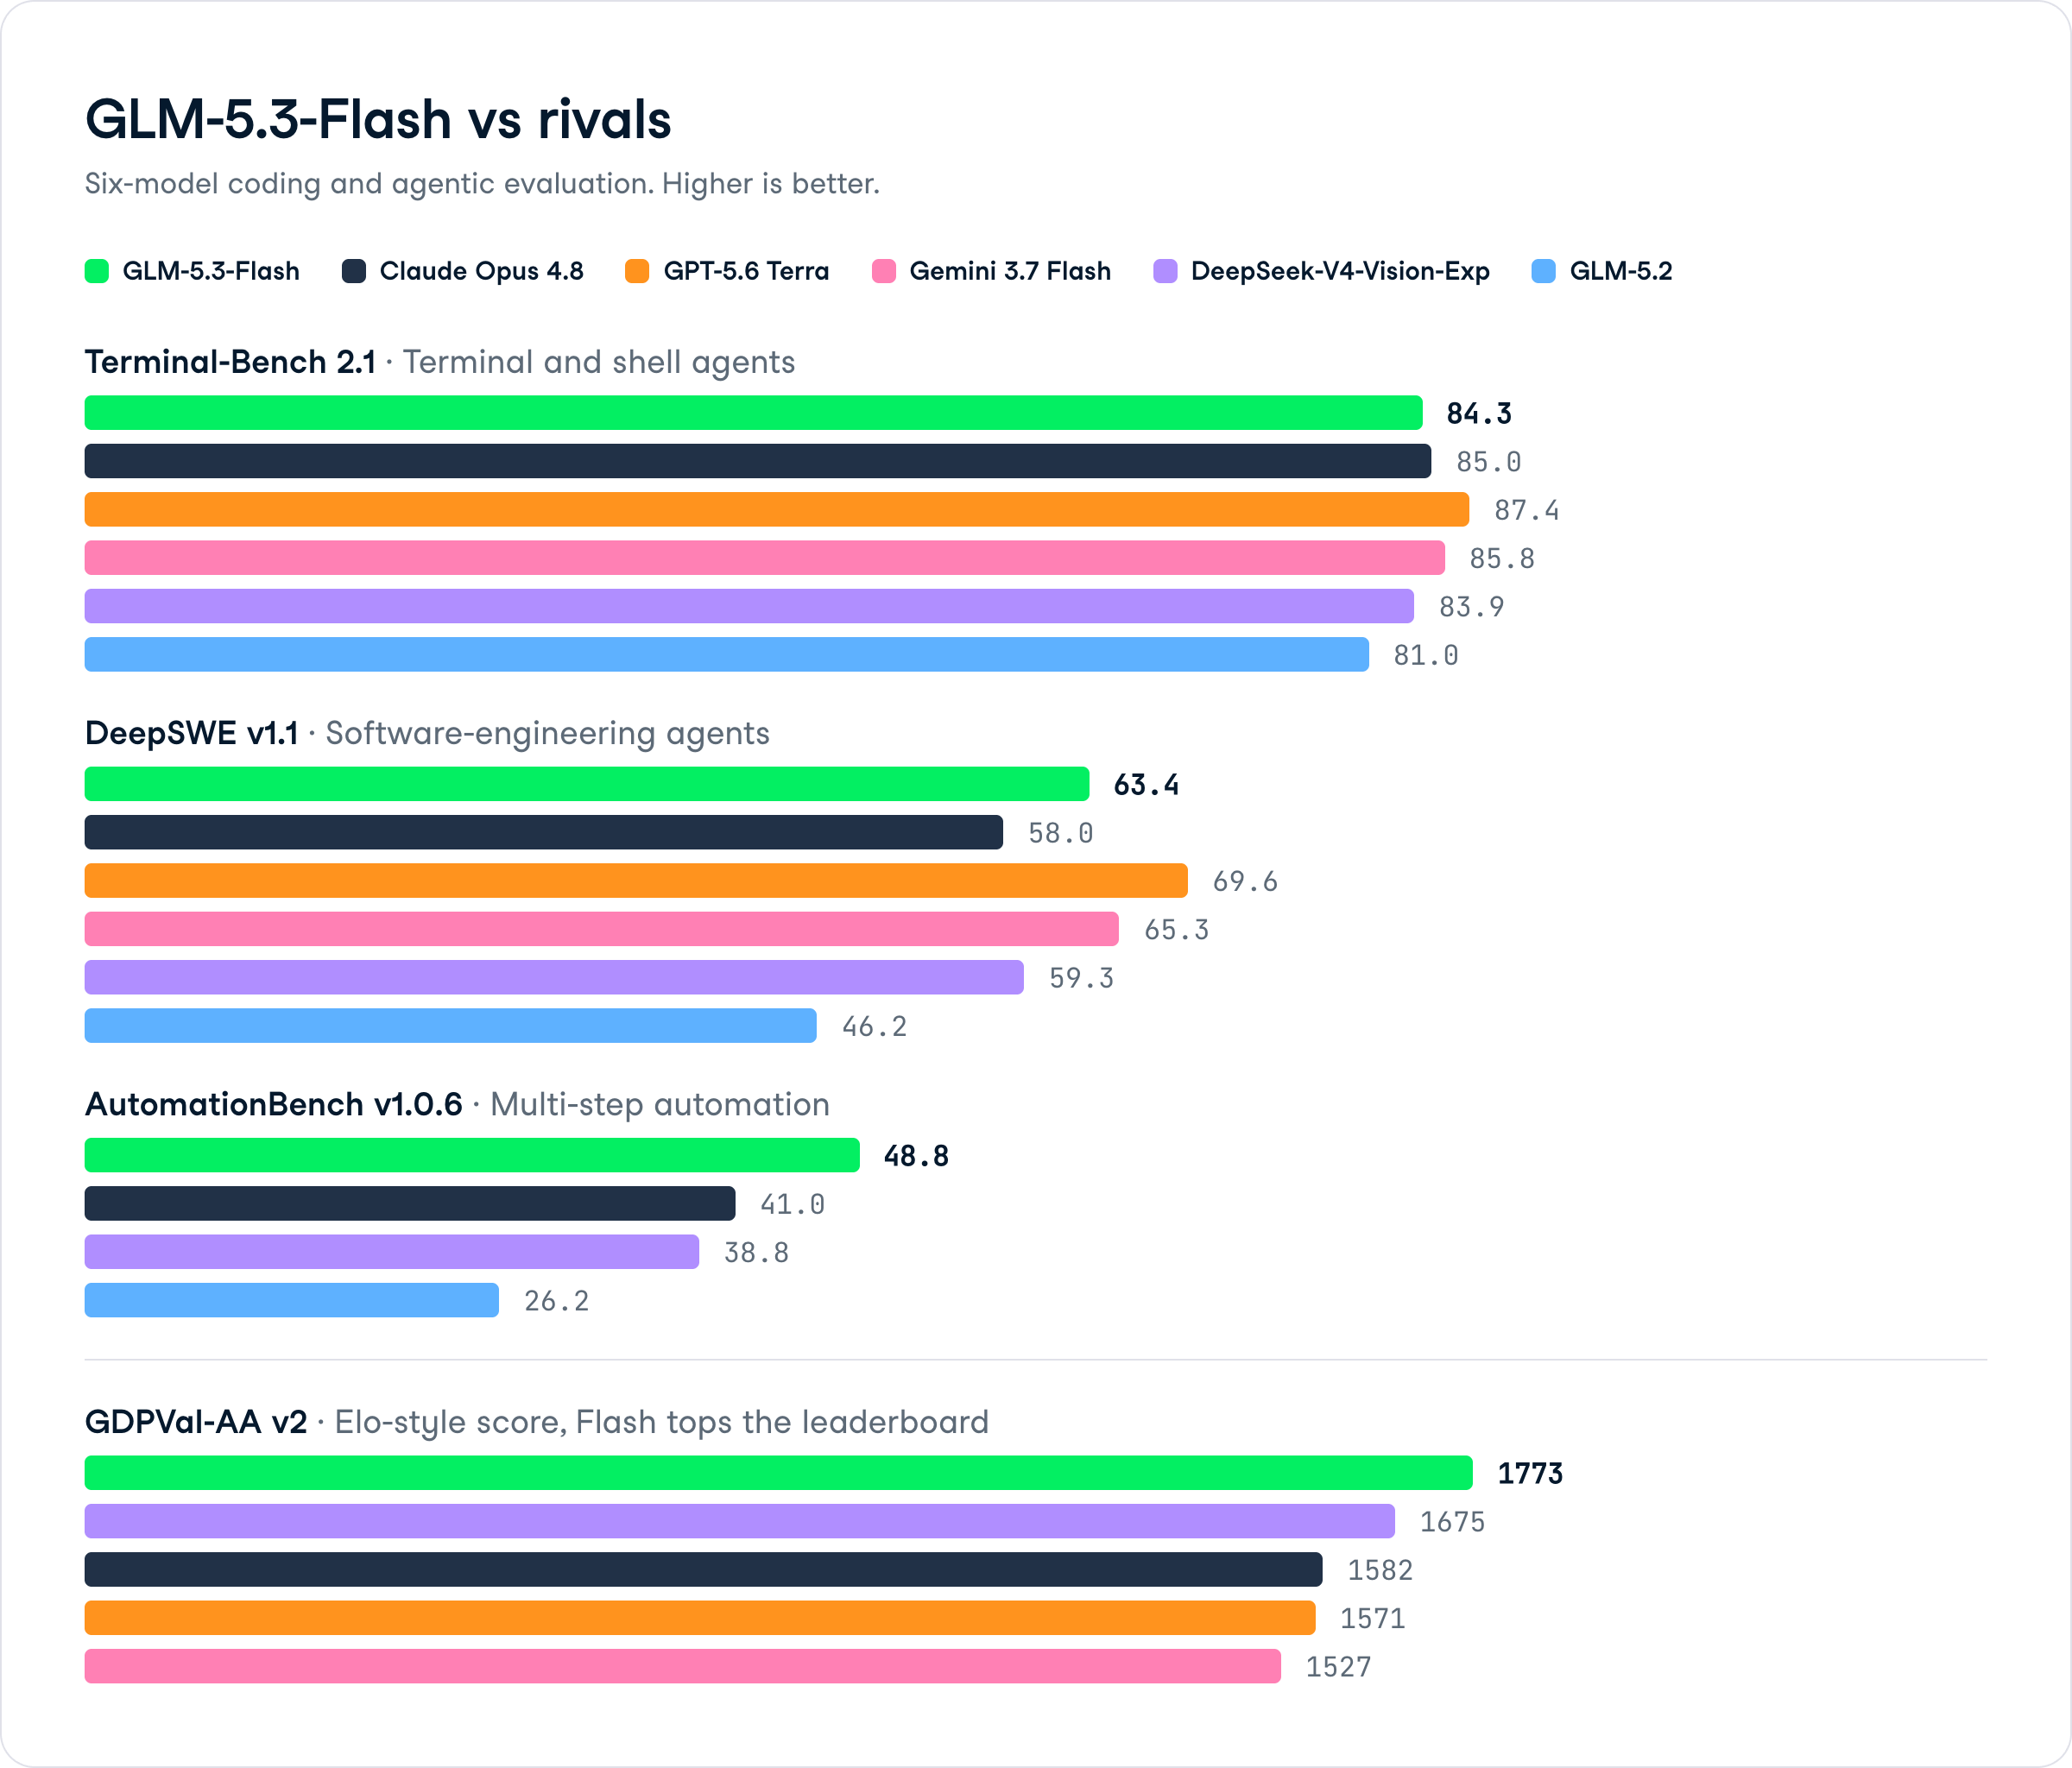
Auf diesem Benchmark für Software-Engineering-Agenten erreicht GLM-5.3-Flash 63,4 – vor Claude Opus 4.8 (58,0) und DeepSeek-V4-Vision-Exp (59,3) und deutlich über GLM-5.2 (46,2).
Es liegt hinter GPT-5.6 Terra (69,6) und Gemini 3.7 Flash (65,3), aber Claude zum Flash-Preis zu schlagen, ist hier die praxisrelevante Schlagzeile.
GLM-5.3-Flash erzielt 48,8 bei mehrstufigen Automations-Workflows – der größte Vorsprung gegenüber Claude Opus 4.8 (41,0) und DeepSeek-V4-Vision-Exp (38,8) innerhalb des Sets.
GLM-5.2 lag bei 26,2 – das ist auch die stärkste Verbesserung von Generation zu Generation.
In dieser allgemeinen Entwicklungs- und Programmierauswertung führt Flash mit 1773 das Feld an – vor DeepSeek-V4-Vision-Exp (1675), Claude Opus 4.8 (1582), GPT-5.6 Terra (1571) und Gemini 3.7 Flash (1527).
Flash erreicht 84,3 bei Terminal- und Shell-Agentenaufgaben, liegt damit knapp unter Claude Opus 4.8 (85,0) und Gemini 3.7 Flash (85,8) und hinter GPT-5.6 Terra (87,4). Es übertrifft GLM-5.2 (81,0) und DeepSeek-V4-Vision-Exp (83,9). Wettbewerbsfähig, aber nicht dominant.
GLM-5.3-Flash ist über Z.ais API und verschiedene Drittanbieter-Gateways verfügbar, darunter Baseten, Deep Infra, Venice AI und Requesty.
Das öffentliche Checkpoint zai-org/GLM-5.3-Flash liegt auf Hugging Face für Self-Hosting.
Z.ais offizielle Listenpreise und das zeitlich begrenzte Angebot lauten wie folgt:
Apidog meldet einen gemischten, nutzungsgewichteten Preis von rund $0,10 pro 1M Tokens für Flash, gegenüber etwa $0,90 für GLM-5.3.
Drittanbieter bepreisen unterschiedlich: EmpirioLabs bei $0,07 Input / $0,25 Output, Venice AI bei $0,09 / $0,31 und Requesty bei $0,14 / $0,45 mit einem 55%-Rabatt bis 9. Sep. 2026.
Der Haken sind Durchsatz und Hardware.
Flash liefert ~49 Tokens/Sek. gegenüber ~86 bei GLM-5.3, und Artificial Analysis bewertet die Geschwindigkeit mit 2/4.
Self-Hosting ist ebenfalls nicht leichtgewichtig: Das FP8-Checkpoint umfasst ~306 GiB allein an Gewichten – vor KV-Cache und Laufzeit. Du brauchst also mehrere GPUs mit viel Speicher (denke >4×80 GiB) statt einer einzelnen Karte.
Die Wahl hängt von Kosten vs. Intelligenzindex und Durchsatz ab. Die Tabelle unten fasst den Trade-off zusammen.
| Attribut | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Intelligenzindex (Artificial Analysis) | 57 | 60 |
| Gemischter Preis / 1M Tokens | ~$0,10 | ~$0,90 |
| Ausgabegeschwindigkeit | ~49 Tokens/Sek. | ~86 Tokens/Sek. |
| Zeit bis zum ersten Token | ~1,52 s | ~1,57 s |
| Terminal-Bench 2.1 | 84,3 | N/A in den Notizen |
| Kontextfenster | 1M | 1M |
Wähle Flash, wenn Kosten pro Token der Engpass sind und du vor allem Coding oder Agenten betreibst. Wähle GLM-5.3, wenn du die zusätzlichen Punkte im Intelligenzindex und rund den doppelten Durchsatz brauchst.
Beide Modelle starteten am 26. August 2026 und zielen auf dasselbe Budget-Agenten-Segment. GLM-5.3-Flash liegt im einzigen direkt geteilten Benchmark (DeepSWE v1.1: 63,4 vs. 58,7) vorne, aber die Modelle sind unterschiedlich genug gebaut, dass die Wahl stärker von deinem Workload als von einem Einzelwert abhängt.
| GLM-5.3-Flash | Qwen3.8-Flash-Next | |
|---|---|---|
| Architektur | 320B gesamt / 18B aktiv | 125B gesamt / 6B aktiv |
| Nativer Kontext | 1M Tokens | 262K (1M mit YaRN) |
| DeepSWE v1.1 | 63,4 | 58,7 |
| Input-Preis | ~$0,075/1M (Promo) | $0,16/1M |
| Multimodal | Ja (nativ) | Ja (nativ) |
GLM-5.3-Flash aktiviert pro Token dreimal so viele Parameter, was den Vorsprung bei DeepSWE und das Terminal-Bench-2.1-Ergebnis (84,3) plausibel erklärt.
Qwen3.8-Flash-Next kontert mit stärkeren gemeldeten Werten auf SWE-bench Pro (62,5) sowie Office- und Agenten-Benchmarks wie CoWorkBench (73,9) und JobBench (55,7), wo GLM keine vergleichbaren Zahlen veröffentlicht.
Beim Preis ist GLM während des Promo-Zeitfensters günstiger. Bei der Parametereffizienz holt Qwen mehr aus einer kleineren aktiven Größe heraus. Für Self-Hosting ist Qwens kleineres Checkpoint deutlich leichter lokal zu betreiben.
Wenn dir Coding-Agenten und roher Agenten-Durchsatz am wichtigsten sind, hat GLM-5.3-Flash dort die stärkeren direkt vergleichbaren Zahlen. Sind deine Workflows eher Office-lastig, multimodal oder profitieren von einem kleineren Self-Hosting-Checkpoint, ist Qwen3.8-Flash-Next einen ersten Test wert.
Sieh dir unseren kompletten Guide zu Qwen3.8-Flash-Next für die volle Analyse an.
GLM-5.3-Flash ist Z.ais klare Wette auf das Budget-Agenten-Segment: Bei Coding-Evals bis auf ein bis zwei Punkte an Opus 4.8 und GPT-5.6 Terra heranrücken – und sie beim Preis um Größenordnungen unterbieten.
Die 84,3 auf Terminal-Bench 2.1 zu rund $0,10 gemischt pro 1M Tokens sind das Angebot – und es ist stark für hohen Durchsatz bei Coding und Automation.
Die Einschränkungen liegen bei Geschwindigkeit und Infrastruktur.
Mit ~49 Tokens/Sek. ist es nicht das Modell für latenzkritisches Streaming, und das ~306 GiB große FP8-Checkpoint schließt eine beiläufige lokale Bereitstellung aus. Frühe Preview-Nutzer auf r/opencodeCLI berichteten unter Last von Warteschlangen und langsamen Starts, wobei GA das wahrscheinlich verbessert hat.
Mein Fazit: Wenn Kosten pro Token dein bindender Engpass sind und dein Schwerpunkt auf Coding oder Agenten liegt, lohnt sich GLM-5.3-Flash im Vergleich mit GPT-5.6 Terra und Claude Opus 4.8 vor einer Entscheidung.
Wenn du die zusätzlichen 3 Punkte im Intelligenzindex und höheren Durchsatz brauchst, hat das volle GLM-5.3 seinen Zweck. Da Qwen3.8-Flash-Next am selben Tag gelandet ist, lohnt sich das Stöbern im Budget-Segment aktuell besonders.
Wenn du sicher im Umgang mit solchen Modellen werden willst, empfehle ich unseren AI Fundamentals Skill Track für die Grundlagen und anschließend unser Tutorial zum lokalen Betrieb eines MoE-Flash-Modells für die Praxis.
Top-DataCamp-Kurse
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Nisha Arya Ahmed
15 Min.
Blog
Nathaniel Taylor-Leach
4 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Josef Waples
3 Min.