Curso
Codificação com IA para Desenvolvedores
1 h 30 min
10.8K
A Z.ai lançou o GLM-5.3-Flash, a versão otimizada para custo do seu carro-chefe GLM-5.3, que chegou primeiro sob um codinome anônimo e depois foi revelado publicamente como "Ox Alpha". O Qwen3.8-Flash-Next foi lançado no mesmo dia, então o segmento de LLMs econômicos ficou movimentado rapidamente.
Se você vem acompanhando a disputa entre os laboratórios chineses de open weights e a fronteira ocidental, vale dar uma olhada.
A principal proposta é simples: desempenho de codificação e agentes próximo ao topo por uma fração do custo.
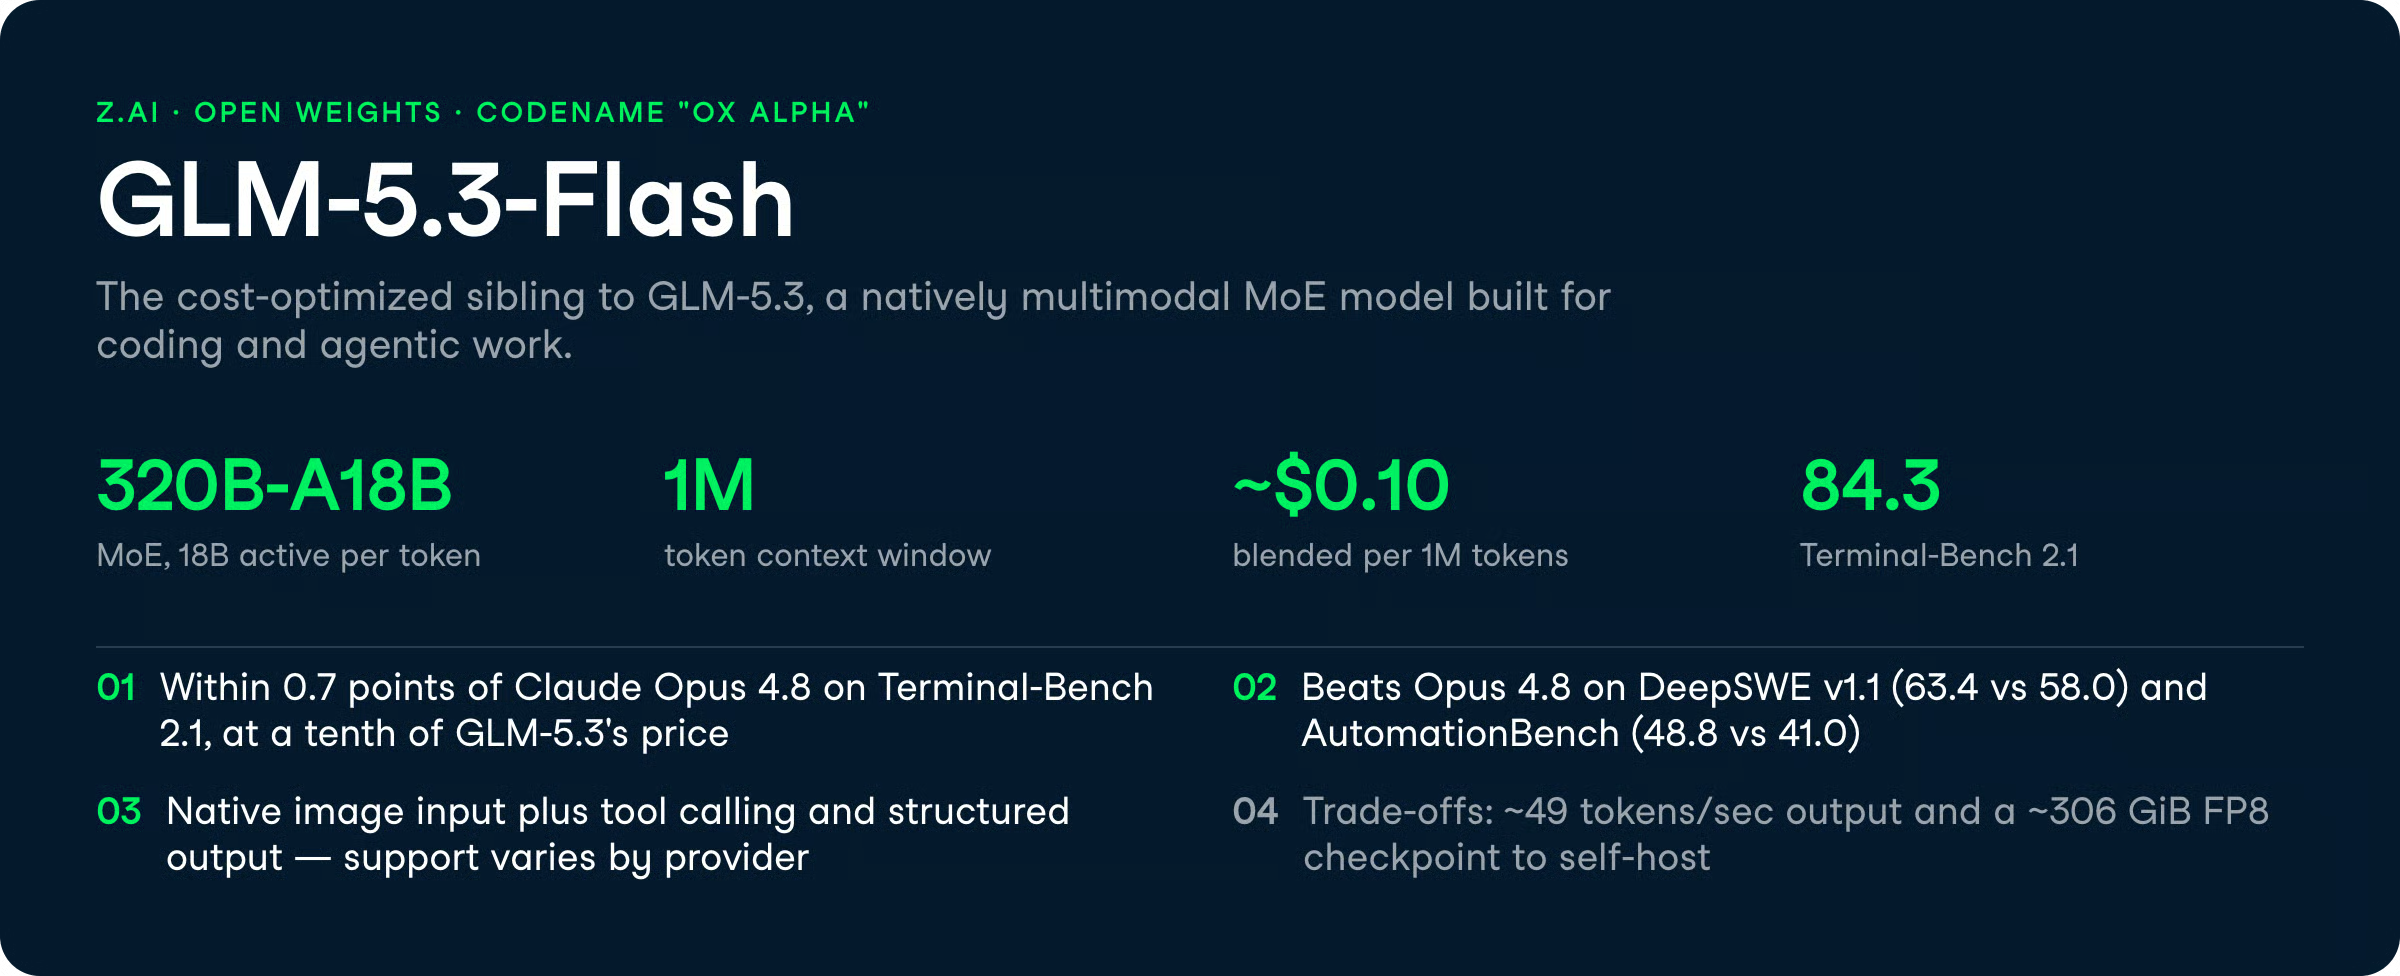
O GLM-5.3-Flash marca 84,3 no Terminal-Bench 2.1, o que o coloca perto do Claude Opus 4.8 (85,0) e do GPT-5.6 Terra (87,4).
Ele usa um design mixture-of-experts na configuração 320B-A18B (320B parâmetros agregados, 18B ativos por token), oferece janela de contexto de 1M tokens e é multimodal nativo.
Neste artigo, eu cubro tudo que há de novo no GLM-5.3-Flash, detalhando os recursos e explorando os benchmarks. Para ver o modelo em ação, confira nosso tutorial do GLM-5.3-Flash, em que usamos o CrewAI para criar uma equipe de analistas financeiros multiagente.
Se você quer compará-lo com o outro modelo econômico lançado no mesmo dia, veja nosso guia do Qwen3.8-Flash-Next e, para um MoE semelhante que rodamos localmente, confira o tutorial sobre como executar o DeepSeek-V4-Flash-0731.
O GLM-5.3-Flash é o modelo otimizado para custo da família GLM-5.3 da Z.ai, abaixo do GLM-5.3 completo em capacidade, mas muito abaixo em preço.
O Artificial Analysis o classifica com índice de inteligência 57, versus 60 do GLM-5.3.
A troca está em velocidade e custo: o Flash atende por cerca de um décimo do preço do GLM-5.2, ou aproximadamente um nono do preço médio do GLM-5.3, e roda mais devagar por token.
O modelo saiu primeiro como preview anônimo antes de receber o nome, e a comunidade rapidamente o apelidou de "Ox Alpha".
O checkpoint público está disponível como zai-org/GLM-5.3-Flash no Hugging Face, com suporte a longo contexto (~1M tokens) e recursos de tool calling e multimodal expostos pelo ecossistema ao redor.
O benchmark que mais importa aqui é o Terminal-Bench 2.1, onde o GLM-5.3-Flash atinge 84,3. Isso supera os 82,7 que vimos no DeepSeek-V4-Flash-0731 e fica a apenas 0,7 ponto do Claude Opus 4.8. Para um modelo com preço médio ponderado de uso estimado em ~US$ 0,10 por 1M de tokens, esse é o grande destaque do lançamento.
O GLM-5.3-Flash foi feito para desenvolvedores que precisam de desempenho em agentes e codificação sem pagar preço de flagship.
Veja as capacidades que mais contam no dia a dia.
Você consegue rodar agentes de código e fluxos de automação a um preço que viabiliza uso em alto volume.
O GLM-5.3-Flash marca 84,3 no Terminal-Bench 2.1 e 63,4 no DeepSWE v1.1, uma alta acentuada em relação aos 46,2 do GLM-5.2 no mesmo DeepSWE.
Para quem está na prática, o apelo é executar tarefas de código que custariam caro em modelos da classe Opus.
Algumas comparações posicionam o Flash como "forte" para codificação e agentes de automação com custo bem menor que o GLM-5.3, e o salto no DeepSWE em relação ao GLM-5.2 sugere que os ganhos de codificação são reais, não apenas efeito de benchmark.
Você pode enviar bases de código inteiras, documentos longos ou traces multiarquivo em uma única requisição.
O GLM-5.3-Flash suporta uma janela de contexto de 1M tokens, acompanhando o GLM-5.3 e os 1M de janelas do GPT-5.6 Terra e do Claude Sonnet 5.
Porém, alguns relatos da comunidade mencionam "deriva" de atenção em comprimentos extremos além de ~700K tokens, limitação que a maioria dos pares com contexto amplo também compartilha.
Há bons relatos de recall em centenas de milhares de tokens, mas não assuma recuperação perfeita no limite da janela.
Você pode integrar o GLM-5.3-Flash a frameworks de agentes com function calls e esquemas JSON obrigatórios. O modelo marca 78,4 no Toolathlon e 48,8 no AutomationBench, este último um salto grande comparado aos 26,2 do GLM-5.2.
Um ponto de atenção: o suporte varia por provedor.
Alguns gateways sinalizam que saída estruturada não é suportada, e o tratamento do system prompt difere entre serviços hospedados. Você pode precisar ajustar seu esquema de ferramentas e o modo JSON por endpoint.
Você pode enviar imagens junto com texto para leitura de gráficos, análise de documentos e raciocínio visual.
O GLM-5.3-Flash marca 89,4% no CharXiv-R, 80,5 no MMVU e 78,0 no Chartography, indicando bom desempenho com gráficos e documentos visuais.
O suporte multimodal é nativo, mas, assim como em tool calling, a superfície exata depende do provedor que você usa. Um checkout simples no Hugging Face pode não expor tudo que a API hospedada oferece.
O GLM-5.3-Flash marca 57 no Artificial Analysis Intelligence Index v4.1.1 a US$ 0,045 por tarefa (com desconto). A Z.ai afirma que esse nível de inteligência antes custava cerca de dez vezes mais.
A avaliação com seis benchmarks abaixo compara o Flash com o GLM-5.2, DeepSeek-V4-Vision-Exp, Claude Opus 4.8, GPT-5.6 Terra e Gemini 3.7 Flash.
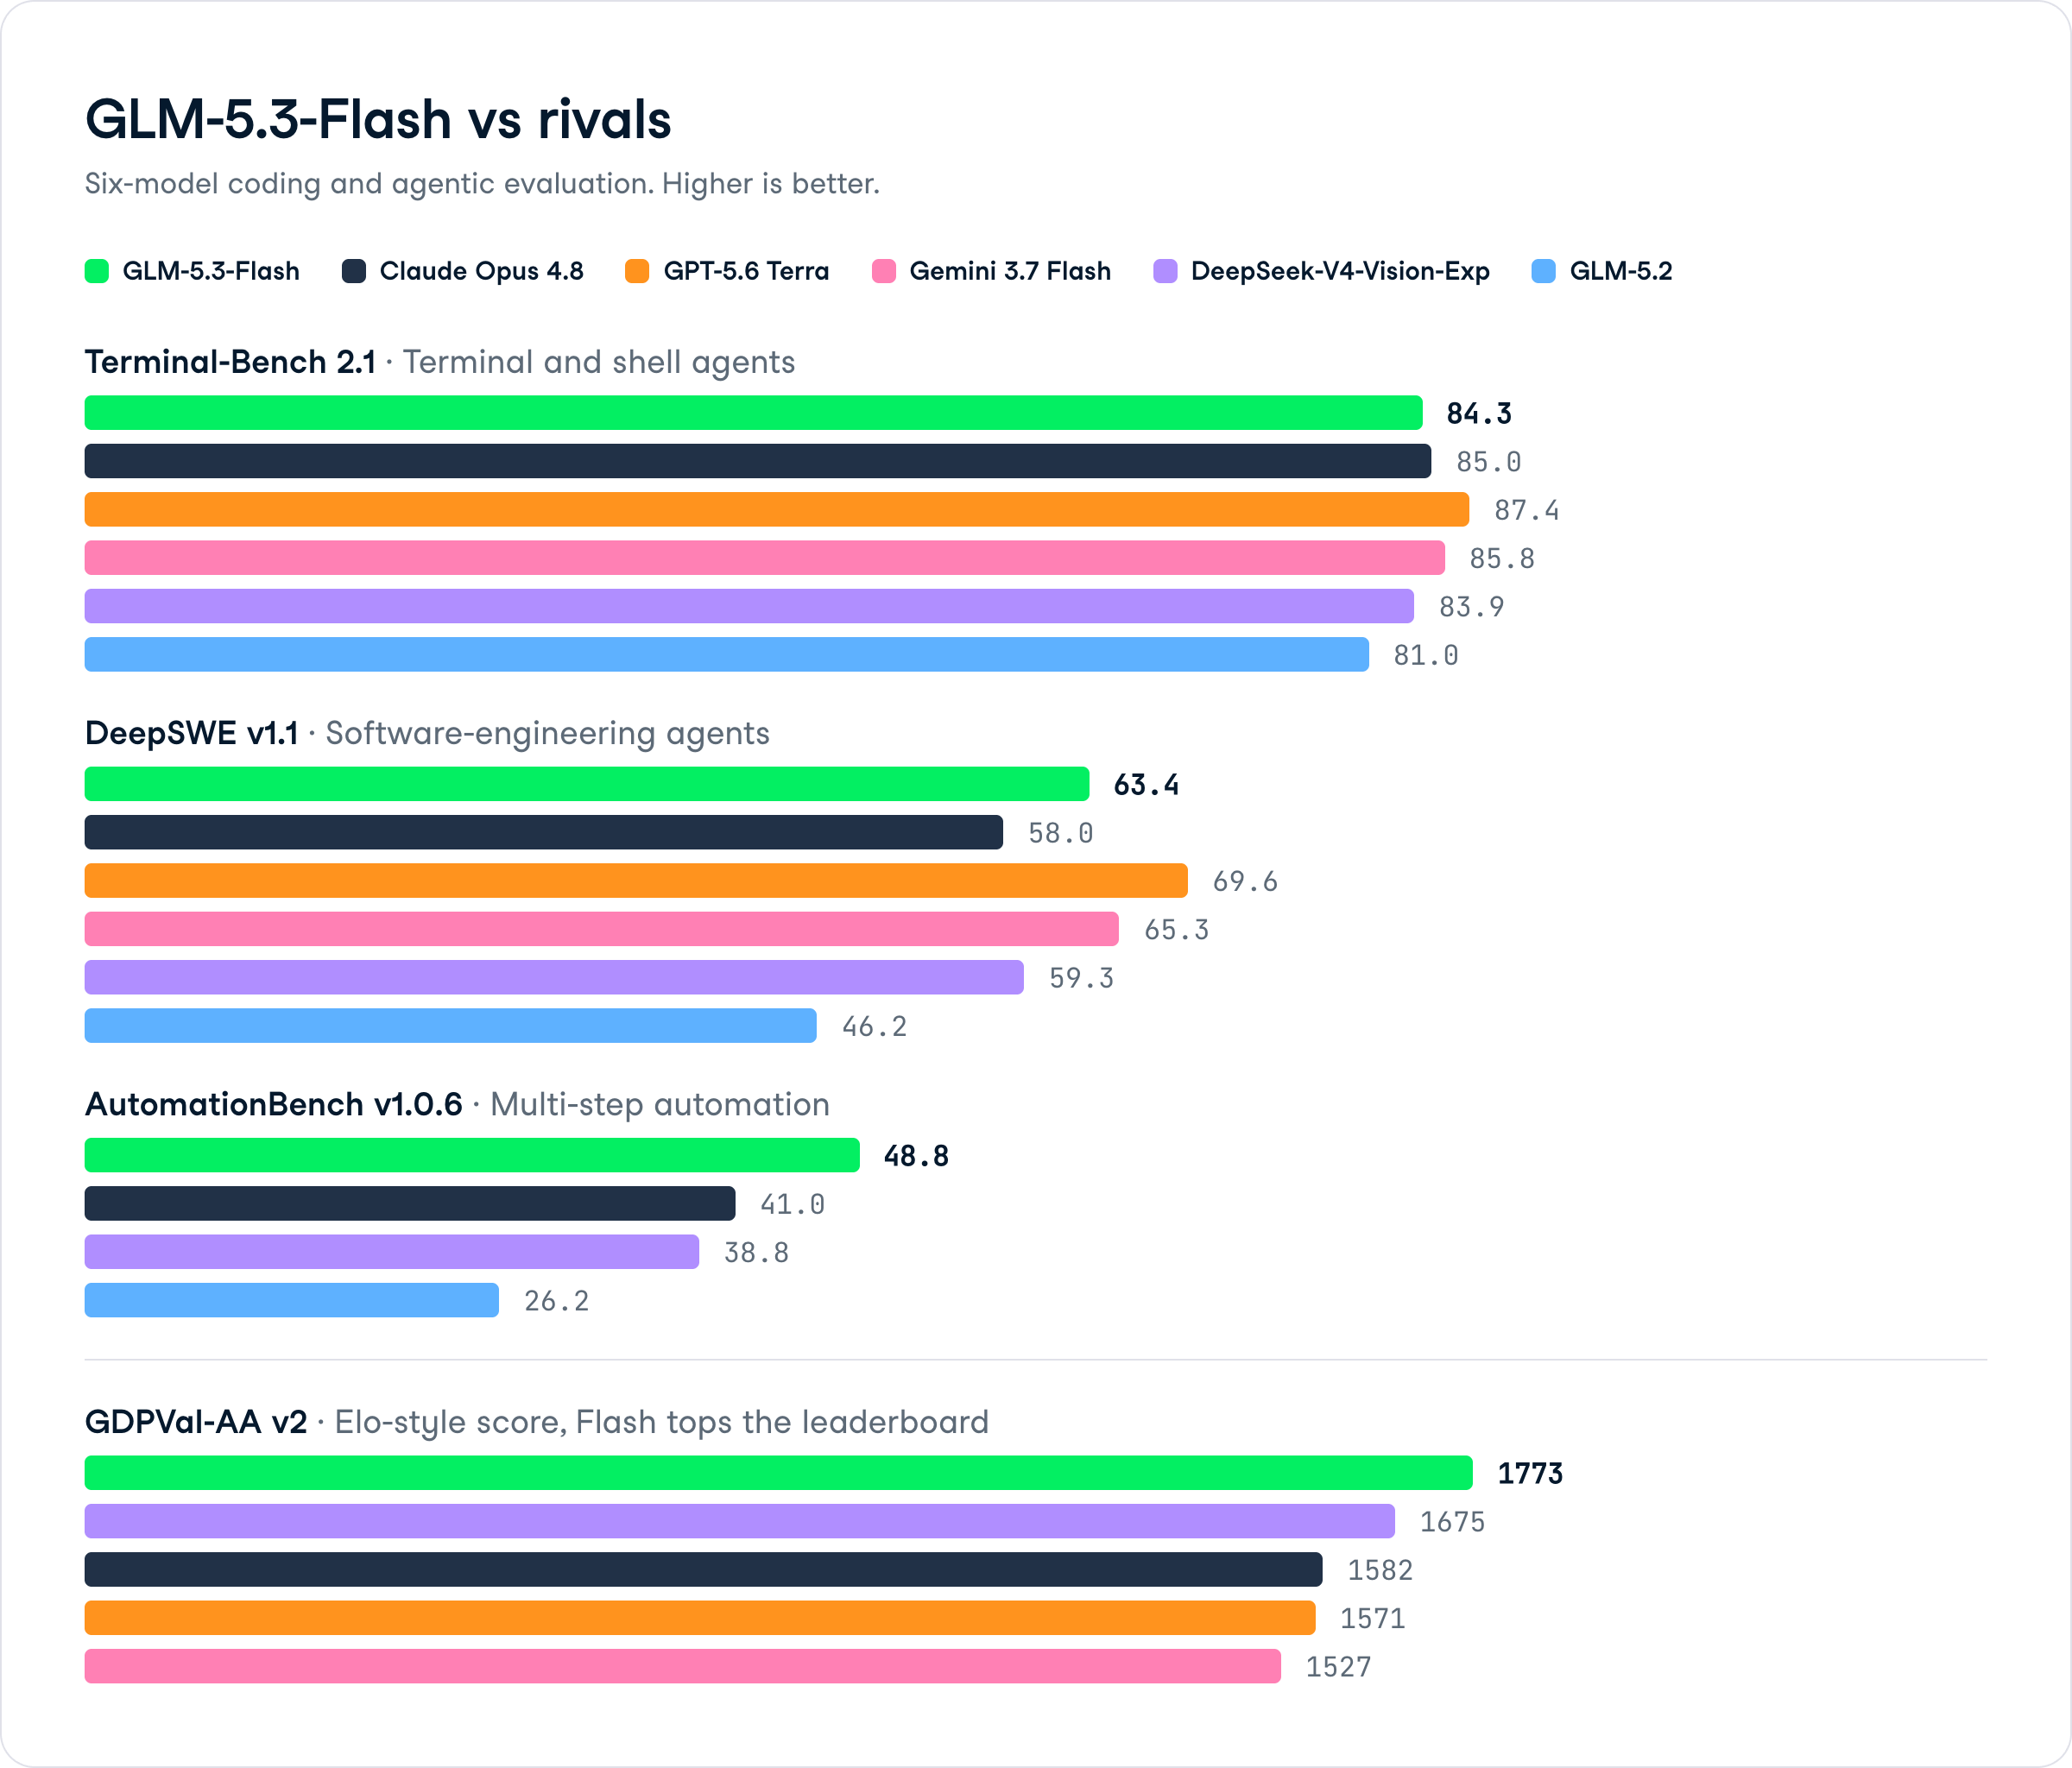
Neste benchmark de agentes de engenharia de software, o GLM-5.3-Flash marca 63,4, à frente do Claude Opus 4.8 (58,0) e do DeepSeek-V4-Vision-Exp (59,3), e acima dos 46,2 do GLM-5.2.
Fica atrás do GPT-5.6 Terra (69,6) e do Gemini 3.7 Flash (65,3), mas vencer o Claude com custo de Flash é o destaque prático aqui.
O GLM-5.3-Flash marca 48,8 em fluxos de automação multi-etapas, a maior vantagem sobre Claude Opus 4.8 (41,0) e DeepSeek-V4-Vision-Exp (38,8) entre todos os benchmarks do conjunto.
O GLM-5.2 marcou 26,2, então este também é o avanço mais acentuado de uma geração para outra.
Nesta avaliação geral de desenvolvimento e programação, o Flash lidera com 1773, à frente de DeepSeek-V4-Vision-Exp (1675), Claude Opus 4.8 (1582), GPT-5.6 Terra (1571) e Gemini 3.7 Flash (1527).
O Flash marca 84,3 em tarefas de terminal e shell para agentes, ficando logo abaixo do Claude Opus 4.8 (85,0) e do Gemini 3.7 Flash (85,8), e atrás do GPT-5.6 Terra (87,4). Supera por pouco o GLM-5.2 (81,0) e o DeepSeek-V4-Vision-Exp (83,9). Competitivo, não dominante.
O GLM-5.3-Flash está disponível pela API da Z.ai e por vários gateways de terceiros, incluindo Baseten, Deep Infra, Venice AI e Requesty.
O checkpoint público zai-org/GLM-5.3-Flash está no Hugging Face para self-hosting.
Os preços oficiais de tabela da Z.ai e a promoção por tempo limitado são:
A Apidog reporta um preço médio ponderado de uso em torno de US$ 0,10 por 1M tokens para o Flash, contra cerca de US$ 0,90 para o GLM-5.3.
Gateways de terceiros cobram de formas distintas: EmpirioLabs a US$ 0,07 entrada / US$ 0,25 saída, Venice AI a US$ 0,09 / US$ 0,31 e Requesty a US$ 0,14 / US$ 0,45 com promoção de 55% até 9 set 2026.
O porém está em throughput e hardware.
O Flash atende a ~49 tokens/s versus ~86 do GLM-5.3, e o Artificial Analysis o classifica com 2/4 em velocidade.
Self-hosting também não é leve: o checkpoint FP8 tem ~306 GiB só em pesos, antes de KV-cache e runtime, então você precisa de várias GPUs com muita memória (pense em >4×80 GiB) em vez de uma única placa.
A escolha entre os dois depende de custo versus índice de inteligência e throughput. A tabela abaixo resume a troca.
| Atributo | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Índice de inteligência (Artificial Analysis) | 57 | 60 |
| Preço médio / 1M tokens | ~US$ 0,10 | ~US$ 0,90 |
| Velocidade de saída | ~49 tokens/s | ~86 tokens/s |
| Tempo até o primeiro token | ~1,52 s | ~1,57 s |
| Terminal-Bench 2.1 | 84,3 | N/D nas notas |
| Janela de contexto | 1M | 1M |
Escolha o Flash quando o custo por token for a principal restrição e seu trabalho for codificação ou agentes. Escolha o GLM-5.3 quando precisar do índice de inteligência extra e de aproximadamente o dobro de throughput.
Ambos os modelos foram lançados em 26 de agosto de 2026, mirando o mesmo segmento econômico para agentes. O GLM-5.3-Flash supera o Qwen3.8-Flash-Next no único benchmark que compartilham diretamente (DeepSWE v1.1: 63,4 vs 58,7), mas as arquiteturas são diferentes o suficiente para que a escolha dependa mais do seu workload do que de um único número.
| GLM-5.3-Flash | Qwen3.8-Flash-Next | |
|---|---|---|
| Arquitetura | 320B total / 18B ativos | 125B total / 6B ativos |
| Contexto nativo | 1M tokens | 262K (1M com YaRN) |
| DeepSWE v1.1 | 63,4 | 58,7 |
| Preço de entrada | ~US$ 0,075/1M (promo) | US$ 0,16/1M |
| Multimodal | Sim (nativo) | Sim (nativo) |
O GLM-5.3-Flash ativa três vezes mais parâmetros por token, o que provavelmente explica a liderança no DeepSWE e o resultado no Terminal-Bench 2.1 (84,3).
O Qwen3.8-Flash-Next contra-ataca com notas mais fortes reportadas no SWE-bench Pro (62,5) e em benchmarks de escritório e agentes como CoWorkBench (73,9) e JobBench (55,7), onde o GLM não publica números comparáveis.
Em preço, o GLM é mais barato durante a janela promocional. Em eficiência de parâmetros, o Qwen faz mais com um footprint ativo menor. Em self-hosting, o checkpoint menor do Qwen é significativamente mais fácil de rodar localmente.
Se sua prioridade são agentes de codificação e throughput bruto de agentes, o GLM-5.3-Flash tem números melhores onde a comparação é direta. Se seus fluxos são mais voltados a escritório, multimodais ou se beneficiam de um checkpoint menor para rodar localmente, vale testar primeiro o Qwen3.8-Flash-Next.
Veja nosso guia completo do Qwen3.8-Flash-Next para todos os detalhes.
O GLM-5.3-Flash mostra a aposta clara da Z.ai no segmento econômico para agentes: chegar a um ou dois pontos de distância de Opus 4.8 e GPT-5.6 Terra em avaliações de codificação e, ao mesmo tempo, reduzir o preço em uma ordem de grandeza.
Os 84,3 no Terminal-Bench 2.1 a cerca de US$ 0,10 por 1M de tokens (média ponderada) são o argumento — e é forte para codificação e automação em alto volume.
As limitações ficam por conta da velocidade e da infraestrutura.
Com ~49 tokens/s, não é o modelo para streaming sensível à latência, e o checkpoint FP8 de ~306 GiB inviabiliza deploy local casual. Usuários do preview inicial no r/opencodeCLI relataram filas e inícios lentos sob carga, embora a GA provavelmente já tenha melhorado isso.
Na minha visão, se custo por token é sua restrição e seu trabalho é codificação ou agentes, vale testar o GLM-5.3-Flash contra o GPT-5.6 Terra e o Claude Opus 4.8 antes de decidir.
Se você precisa dos 3 pontos extras no índice de inteligência e de throughput mais alto, o GLM-5.3 completo existe por um motivo. Ele também chega no mesmo dia do Qwen3.8-Flash-Next, então vale comparar opções no segmento econômico agora.
Se quiser ganhar confiança trabalhando com modelos desse tipo, recomendo nossa trilha de habilidades AI Fundamentals para construir a base e, depois, o tutorial sobre rodar um modelo MoE Flash localmente para a prática.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Richie Cotton
7 min
blog
Abid Ali Awan
8 min
Tutorial
Josep Ferrer
11 min
Tutorial
DataCamp Team
2 min
Tutorial
Abid Ali Awan
12 min