
Khóa học
Lập trình với AI dành cho Developer
1 giờ 30 phút
10.7K
Z.ai đã phát hành GLM-5.3-Flash, phiên bản tối ưu chi phí của mẫu chủ lực GLM-5.3, và nó xuất hiện trước công chúng với tên mã xem trước ẩn danh trước khi được tiết lộ là "Ox Alpha." Qwen3.8-Flash-Next ra mắt cùng ngày, khiến phân khúc LLM giá rẻ trở nên sôi động ngay lập tức.
Nếu bạn đang theo dõi cuộc đua giữa các phòng thí nghiệm Trung Quốc mở trọng số và tuyến đầu phương Tây, mẫu này đáng để ý.
Tuyên bố chính rất đơn giản: hiệu năng mã hóa và tác tử gần mức tiên tiến với chi phí chỉ bằng một phần nhỏ.
GLM-5.3-Flash đạt 84,3 trên Terminal-Bench 2.1, đưa nó vào khoảng cách bám đuổi Claude Opus 4.8 (85,0) và GPT-5.6 Terra (87,4).
Nó sử dụng thiết kế mixture-of-experts theo cấu hình 320B-A18B (320B tham số tổng, 18B kích hoạt mỗi token), hỗ trợ cửa sổ ngữ cảnh 1M token và đa phương thức gốc.
Trong bài viết này, tôi sẽ điểm qua mọi thứ mới ở GLM-5.3-Flash, xem các tính năng và khám phá điểm chuẩn. Để xem mô hình hoạt động thực tế, hãy xem hướng dẫn GLM-5.3-Flash của chúng tôi, trong đó chúng tôi dùng CrewAI để tạo một đội ngũ phân tích tài chính đa tác tử.
Nếu bạn muốn so sánh với mẫu giá rẻ khác ra mắt cùng ngày, xem bài hướng dẫn về Qwen3.8-Flash-Next, và với một mẫu MoE tương tự mà chúng tôi đã chạy cục bộ, xem hướng dẫn về chạy DeepSeek-V4-Flash-0731.
GLM-5.3-Flash là mẫu tối ưu chi phí trong họ GLM-5.3 của Z.ai, xếp dưới mẫu chủ lực GLM-5.3 về năng lực nhưng thấp hơn rất nhiều về giá.
Artificial Analysis chấm nó ở chỉ số trí tuệ 57, so với 60 của GLM-5.3.
Sự đánh đổi là tốc độ và chi phí: Flash phục vụ với chi phí xấp xỉ một phần mười GLM-5.2, hoặc khoảng một phần chín giá pha trộn của GLM-5.3 và chạy chậm hơn trên mỗi token.
Mô hình được phát hành trước dưới dạng xem trước ẩn danh trước khi được đặt tên, và cộng đồng nhanh chóng gắn tên mã "Ox Alpha" cho nó.
Checkpoint công khai có sẵn dưới dạng zai-org/GLM-5.3-Flash trên Hugging Face, với hỗ trợ ngữ cảnh dài (~1M token) và khả năng gọi công cụ và đa phương thức được cung cấp qua hệ sinh thái xung quanh.
Điểm chuẩn quan trọng nhất ở đây là Terminal-Bench 2.1, nơi GLM-5.3-Flash đạt 84,3. Con số này cao hơn mức 82,7 chúng tôi thấy ở DeepSeek-V4-Flash-0731, và chỉ kém Claude Opus 4.8 đúng 0,7 điểm. Với mô hình có giá pha trộn theo mức sử dụng ước khoảng $0,10 mỗi 1M token, đó chính là câu chuyện của lần phát hành này.
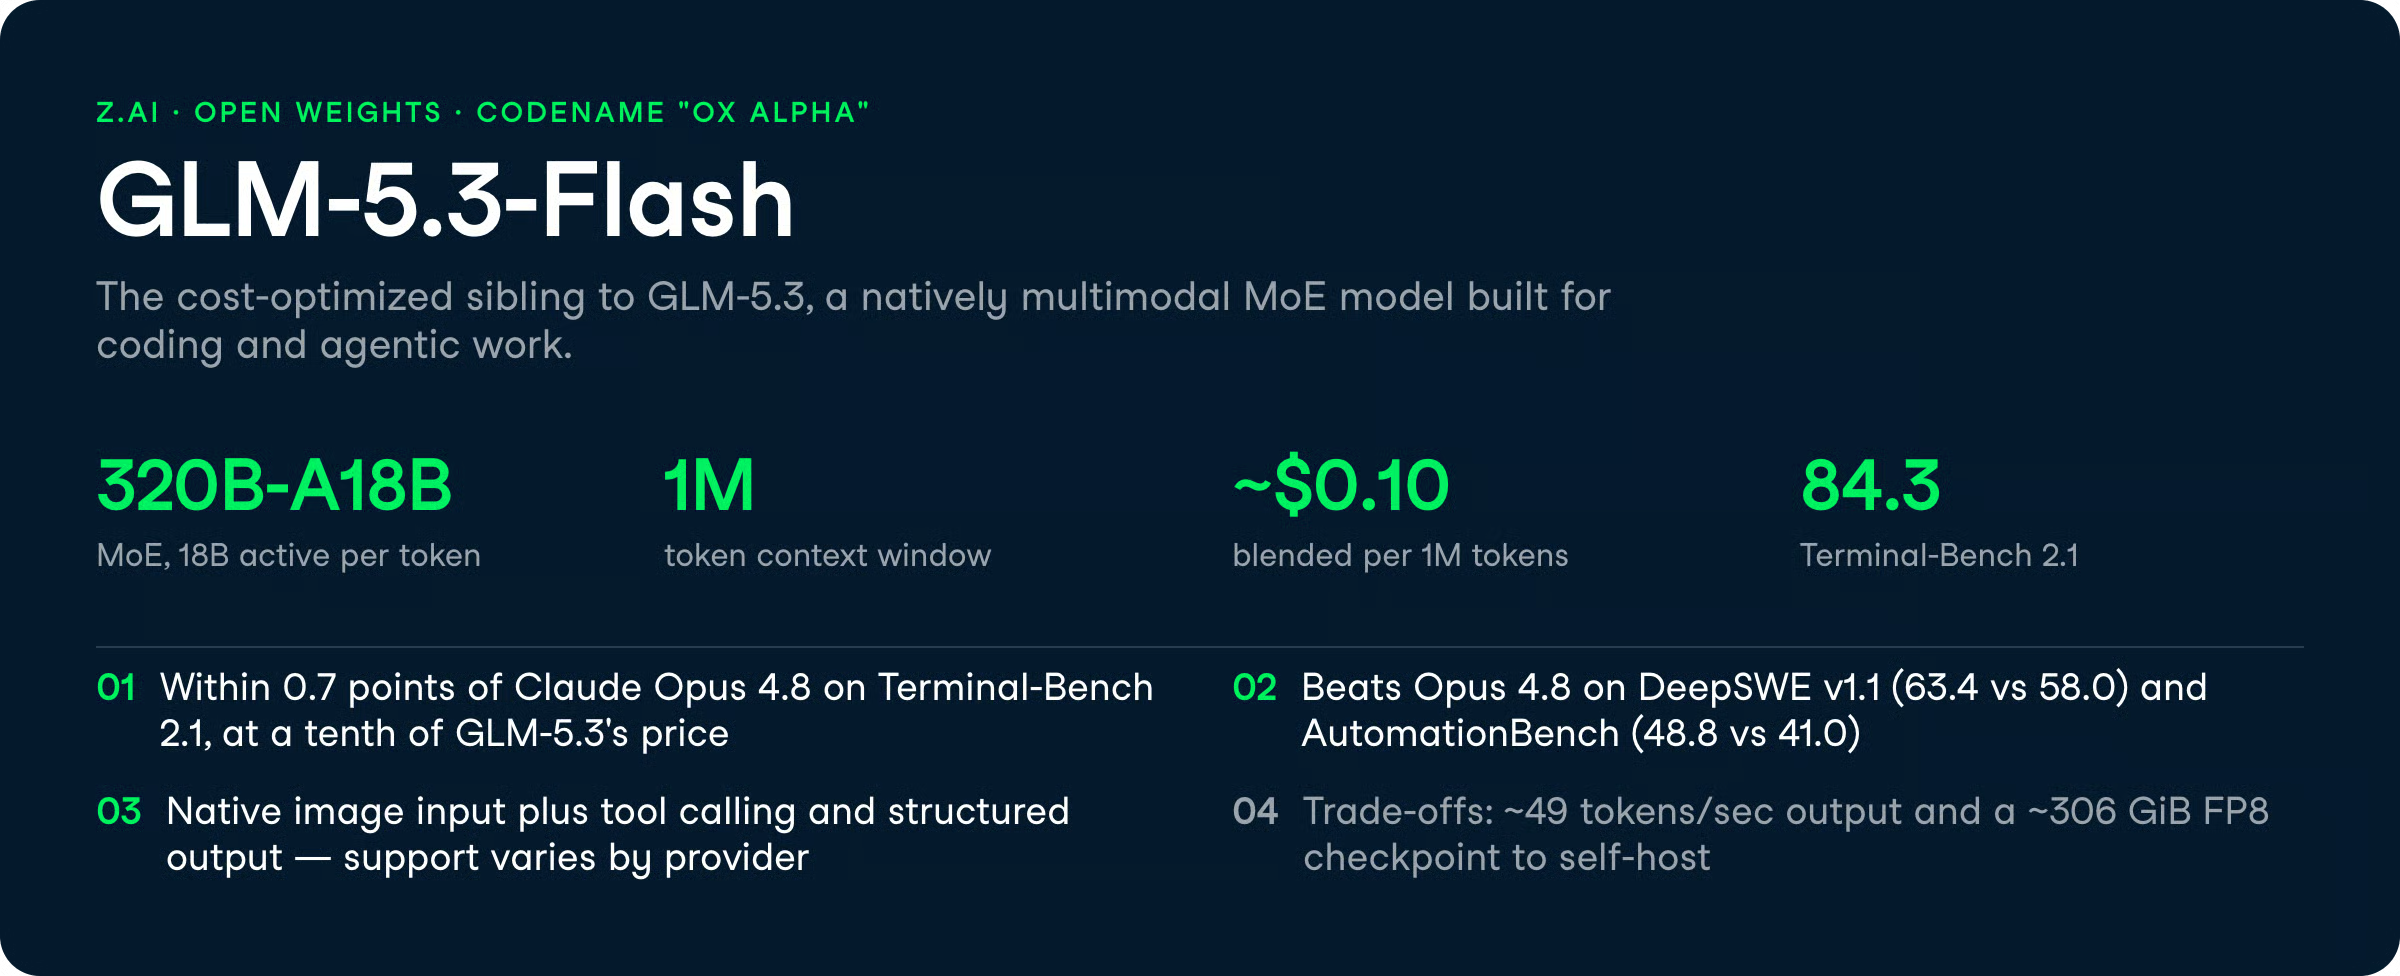
GLM-5.3-Flash được xây dựng cho các nhà phát triển muốn hiệu năng tác tử và mã hóa mà không cần mức giá của mẫu chủ lực.
Dưới đây là những năng lực quan trọng cho công việc thực tế.
Bạn có thể chạy tác tử mã hóa và quy trình tự động hóa với mức giá khiến việc sử dụng khối lượng lớn trở nên khả thi.
GLM-5.3-Flash đạt 84,3 trên Terminal-Bench 2.1 và 63,4 trên DeepSWE v1.1, tăng mạnh so với mức 46,2 của GLM-5.2 trên cùng bài đánh giá DeepSWE.
Với người làm thực hành, sức hút nằm ở việc chạy các tác vụ mã hóa vốn sẽ tốn kém trên các mẫu hạng Opus.
Một số so sánh mô tả Flash là "mạnh" cho mã hóa và tác tử tự động với chi phí thấp hơn đáng kể so với GLM-5.3, và cú nhảy DeepSWE so với GLM-5.2 cho thấy cải thiện mã hóa là thực chất chứ không chỉ do điểm chuẩn cụ thể.
Bạn có thể nạp toàn bộ codebase, tài liệu dài, hoặc vết truy vết tác tử nhiều tệp vào một yêu cầu duy nhất.
GLM-5.3-Flash hỗ trợ cửa sổ ngữ cảnh 1M token, tương đương GLM-5.3 và các cửa sổ 1M trên GPT-5.6 Terra và Claude Sonnet 5.
Tuy vậy, một số báo cáo cộng đồng đề cập đến hiện tượng "trôi" attention ở độ dài cực hạn vượt khoảng 700K token, một hạn chế mà hầu hết các đối thủ có ngữ cảnh lớn đều gặp.
Khả năng hồi tưởng tốt trên hàng trăm nghìn token được ghi nhận, nhưng đừng kỳ vọng truy hồi hoàn hảo ở cuối cửa sổ.
Bạn có thể tích hợp GLM-5.3-Flash vào các khung tác tử với lời gọi hàm và ràng buộc lược đồ JSON. Mô hình đạt 78,4 trên Toolathlon và 48,8 trên AutomationBench, trong đó chỉ số sau tăng lớn từ mức 26,2 của GLM-5.2.
Một điểm cần lưu ý: hỗ trợ thay đổi tùy nhà cung cấp.
Một số cổng đánh dấu đầu ra có cấu trúc là không được hỗ trợ, và cách xử lý system prompt khác nhau giữa các nhà cung cấp dịch vụ, vì vậy bạn có thể cần điều chỉnh lược đồ công cụ và chế độ JSON theo từng endpoint.
Bạn có thể gửi hình ảnh kèm văn bản cho tác vụ đọc biểu đồ, phân tích tài liệu và suy luận thị giác.
GLM-5.3-Flash đạt 89,4% trên CharXiv-R, 80,5 trên MMVU và 78,0 trên Chartography, cho thấy khả năng xử lý biểu đồ và tài liệu trực quan vững vàng.
Hỗ trợ đa phương thức là gốc chứ không phải gắn thêm, tuy nhiên, cũng như gọi công cụ, bề mặt tính năng cụ thể tùy thuộc nhà cung cấp bạn dùng. Một bản checkout trần trên Hugging Face có thể không phơi bày mọi thứ như API được lưu trữ.
GLM-5.3-Flash đạt 57 trên Artificial Analysis Intelligence Index v4.1.1 với chi phí $0,045 mỗi tác vụ (đã chiết khấu). Z.ai cho biết mức trí tuệ đó trước đây có chi phí cao gấp khoảng mười lần.
Bảng đánh giá sáu tiêu chí dưới đây so sánh Flash với GLM-5.2, DeepSeek-V4-Vision-Exp, Claude Opus 4.8, GPT-5.6 Terra và Gemini 3.7 Flash.
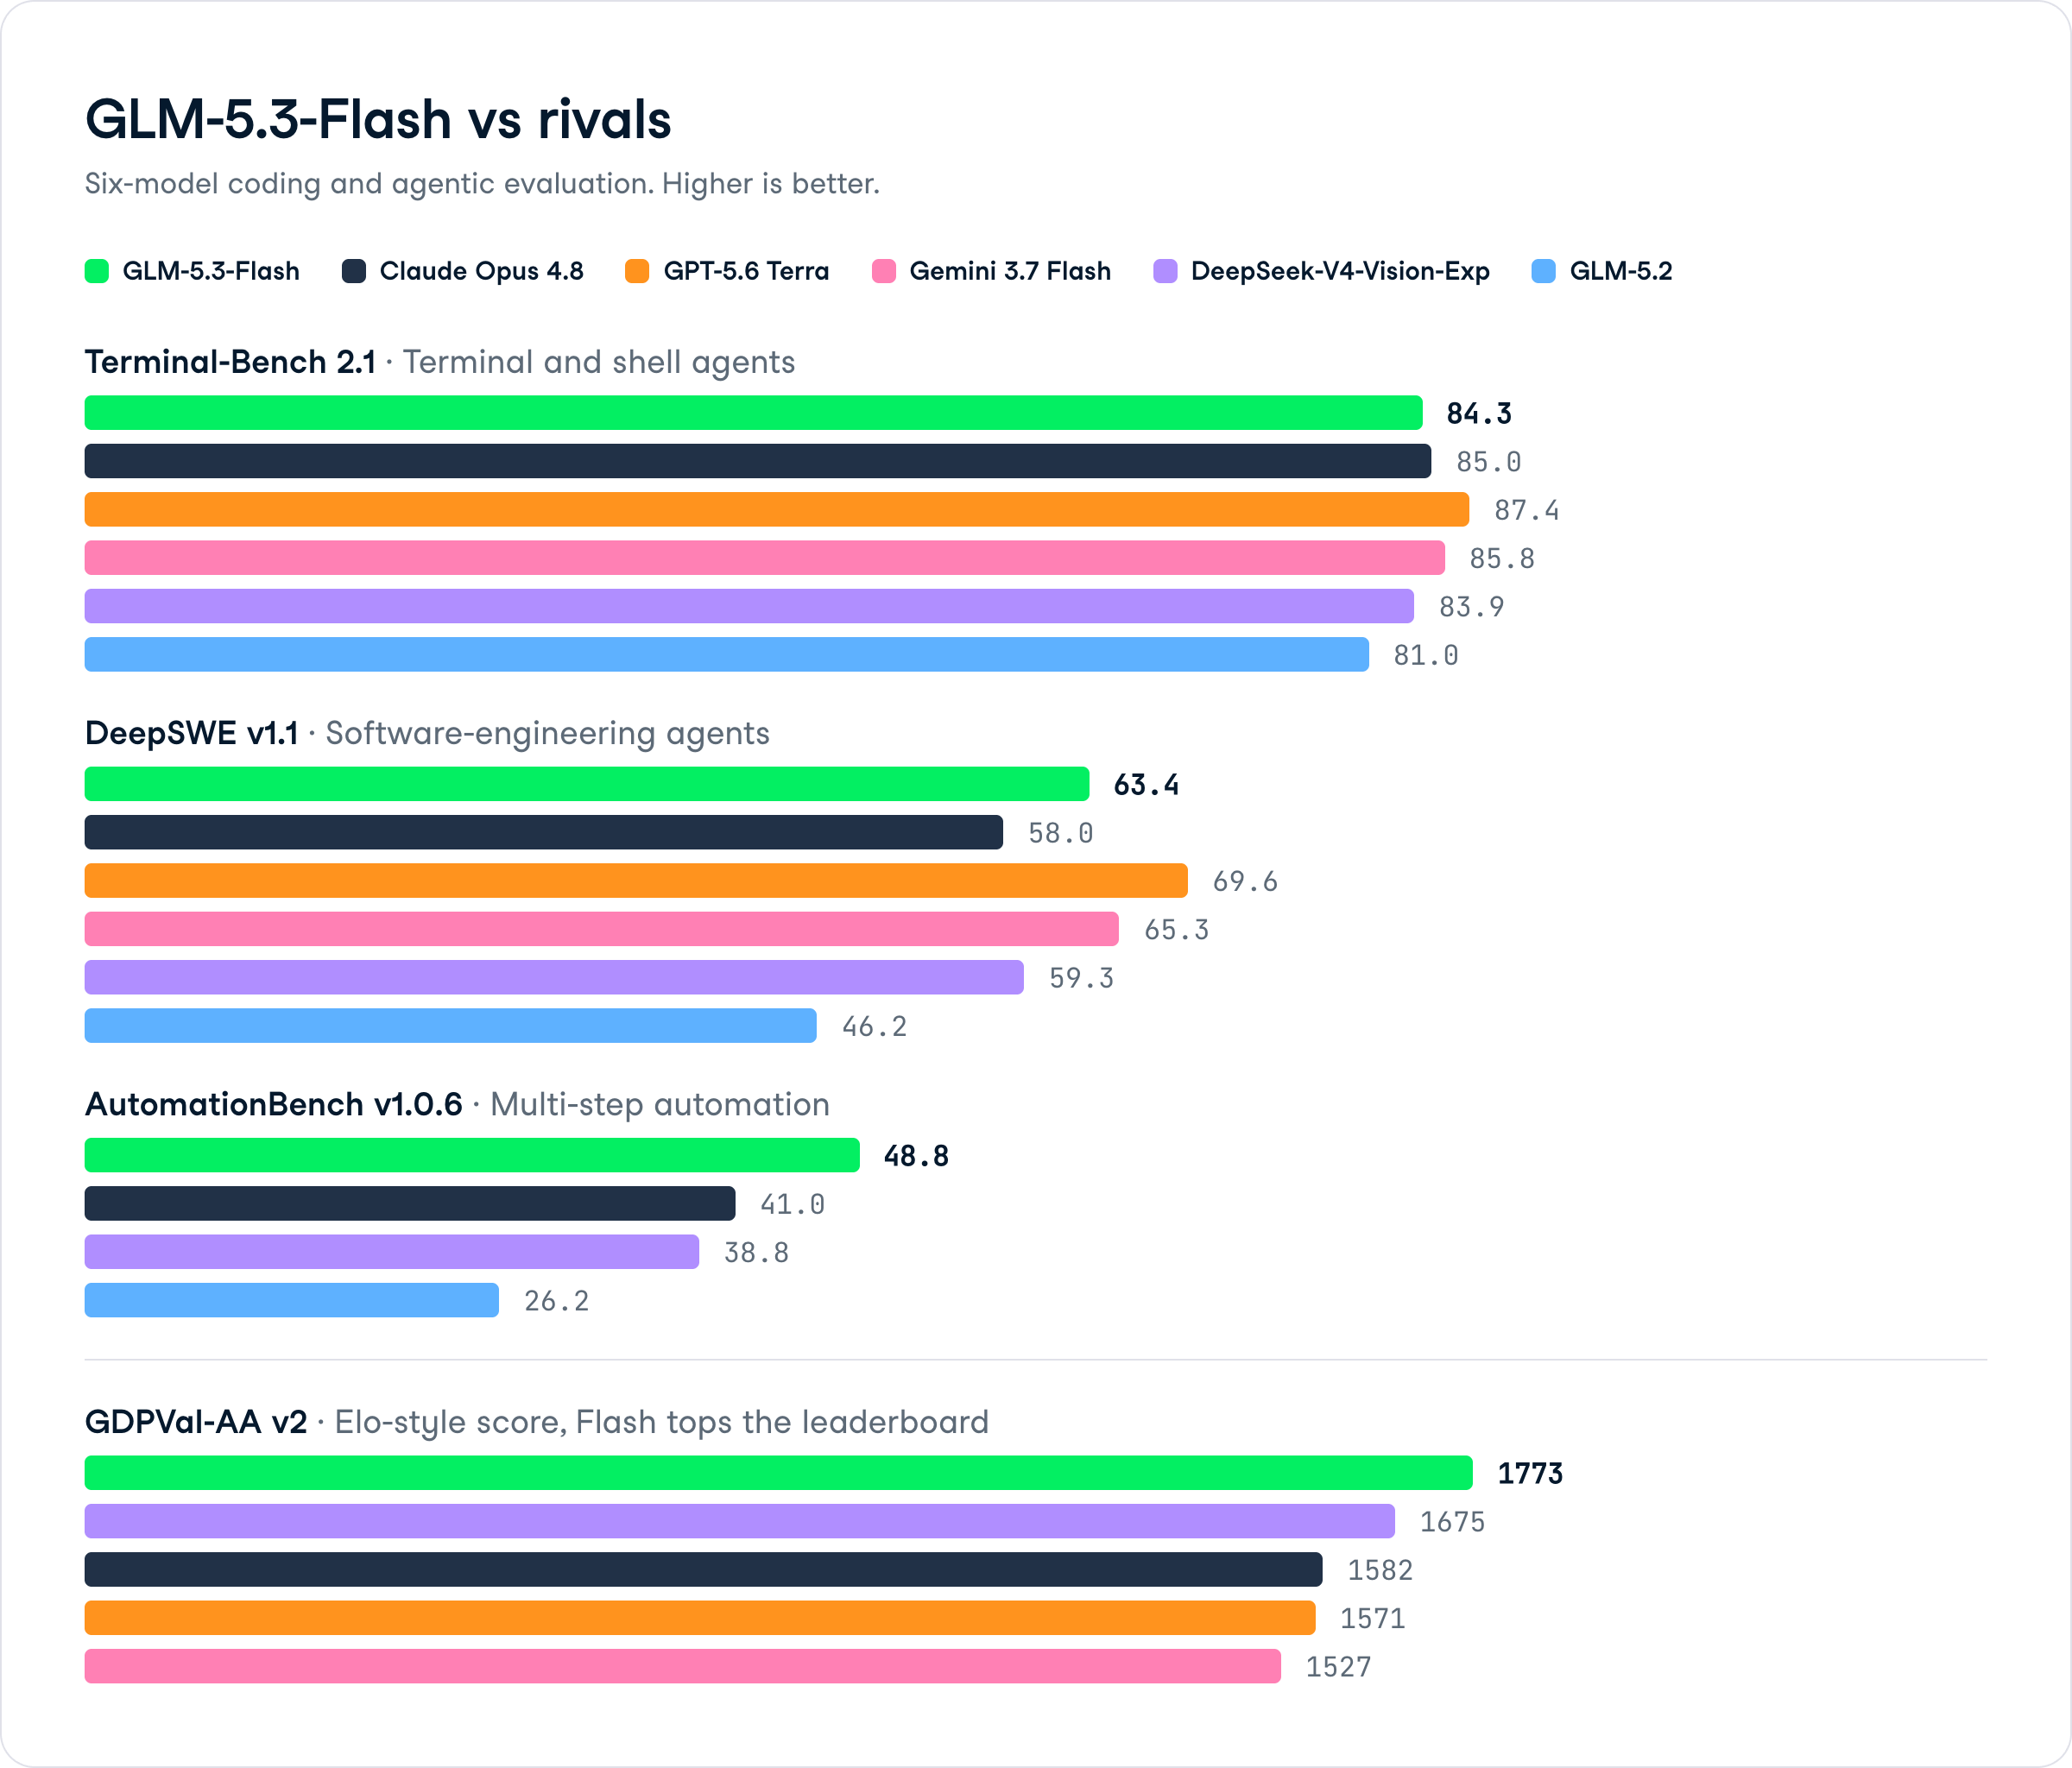
Trên bài đánh giá tác tử kỹ thuật phần mềm này, GLM-5.3-Flash đạt 63,4, vượt Claude Opus 4.8 (58,0) và DeepSeek-V4-Vision-Exp (59,3), và tăng so với 46,2 của GLM-5.2.
Nó thua GPT-5.6 Terra (69,6) và Gemini 3.7 Flash (65,3), nhưng vượt Claude ở mức chi phí của Flash mới là điểm đáng chú ý thực tiễn.
GLM-5.3-Flash đạt 48,8 trên các quy trình tự động nhiều bước, mức dẫn lớn nhất so với Claude Opus 4.8 (41,0) và DeepSeek-V4-Vision-Exp (38,8) trong mọi bài đánh giá của bộ này.
GLM-5.2 đạt 26,2, nên đây cũng là cải thiện thế hệ-qua-thế hệ mạnh nhất.
Trên bài đánh giá phát triển và lập trình tổng quát này, Flash đứng đầu bảng với 1773, vượt DeepSeek-V4-Vision-Exp (1675), Claude Opus 4.8 (1582), GPT-5.6 Terra (1571) và Gemini 3.7 Flash (1527).
Flash đạt 84,3 trên tác vụ tác tử terminal và shell, chỉ dưới Claude Opus 4.8 (85,0) và Gemini 3.7 Flash (85,8), và sau GPT-5.6 Terra (87,4). Nó nhỉnh hơn GLM-5.2 (81,0) và DeepSeek-V4-Vision-Exp (83,9). Cạnh tranh, không thống trị.
GLM-5.3-Flash có sẵn qua API của Z.ai và qua nhiều cổng bên thứ ba, gồm Baseten, Deep Infra, Venice AI và Requesty.
Checkpoint công khai zai-org/GLM-5.3-Flash có trên Hugging Face để tự lưu trữ.
Bảng giá cơ bản chính thức của Z.ai và chương trình khuyến mãi thời gian có hạn như sau:
Apidog báo giá pha trộn theo mức sử dụng khoảng $0,10 mỗi 1M token cho Flash, so với khoảng $0,90 cho GLM-5.3.
Các cổng bên thứ ba định giá khác nhau: EmpirioLabs ở mức $0,07 đầu vào / $0,25 đầu ra, Venice AI ở $0,09 / $0,31, và Requesty ở $0,14 / $0,45 với khuyến mãi giảm 55% ghi nhận đến ngày 9 Tháng 9, 2026.
Điểm vướng là thông lượng và phần cứng.
Flash phục vụ ở ~49 token/giây so với ~86 của GLM-5.3, và Artificial Analysis chấm 2/4 về tốc độ.
Tự lưu trữ cũng không gọn nhẹ: checkpoint FP8 ~306 GiB chỉ riêng trọng số trước KV-cache và runtime, nên bạn cần nhiều GPU bộ nhớ lớn (hãy nghĩ tới >4×80 GiB) chứ không phải một card đơn lẻ.
Lựa chọn giữa hai mẫu phụ thuộc vào chi phí so với chỉ số trí tuệ và thông lượng. Bảng dưới tóm tắt sự đánh đổi.
| Thuộc tính | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Chỉ số trí tuệ (Artificial Analysis) | 57 | 60 |
| Giá pha trộn / 1M token | ~$0,10 | ~$0,90 |
| Tốc độ đầu ra | ~49 token/giây | ~86 token/giây |
| Thời gian đến token đầu tiên | ~1,52 s | ~1,57 s |
| Terminal-Bench 2.1 | 84,3 | N/A trong ghi chú |
| Cửa sổ ngữ cảnh | 1M | 1M |
Chọn Flash khi chi phí mỗi token là ràng buộc và công việc của bạn là mã hóa hoặc tác tử. Chọn GLM-5.3 khi bạn cần thêm điểm chỉ số trí tuệ và thông lượng gần gấp đôi.
Cả hai mẫu đều ra mắt ngày 26 Tháng 8, 2026, nhắm vào cùng phân khúc tác tử giá rẻ. GLM-5.3-Flash nhỉnh hơn Qwen3.8-Flash-Next ở bài đánh giá mà cả hai cùng công bố trực tiếp (DeepSWE v1.1: 63,4 so với 58,7), nhưng hai mẫu được xây dựng đủ khác biệt để lựa chọn phụ thuộc vào khối công việc của bạn hơn là một điểm số đơn lẻ.
| GLM-5.3-Flash | Qwen3.8-Flash-Next | |
|---|---|---|
| Kiến trúc | 320B tổng / 18B kích hoạt | 125B tổng / 6B kích hoạt |
| Ngữ cảnh gốc | 1M token | 262K (1M với YaRN) |
| DeepSWE v1.1 | 63,4 | 58,7 |
| Giá đầu vào | ~$0,075/1M (khuyến mãi) | $0,16/1M |
| Đa phương thức | Có (gốc) | Có (gốc) |
GLM-5.3-Flash kích hoạt số tham số mỗi token gấp ba lần, điều này có lẽ giải thích ưu thế trên DeepSWE và kết quả Terminal-Bench 2.1 (84,3).
Qwen3.8-Flash-Next đối trọng với các điểm báo cáo mạnh hơn trên SWE-bench Pro (62,5) và các bài đánh giá văn phòng và tác tử như CoWorkBench (73,9) và JobBench (55,7), nơi GLM không công bố số liệu tương ứng.
Về giá, GLM rẻ hơn trong thời gian khuyến mãi. Về hiệu quả tham số, Qwen làm được nhiều hơn với footprint kích hoạt nhỏ hơn. Về tự lưu trữ, checkpoint nhỏ hơn của Qwen dễ chạy cục bộ hơn đáng kể.
Nếu ưu tiên của bạn là tác tử mã hóa và thông lượng tác tử thô, GLM-5.3-Flash có các con số mạnh ở nơi có so sánh trực tiếp. Nếu quy trình của bạn thiên về văn phòng, đa phương thức, hoặc hưởng lợi từ checkpoint tự lưu trữ nhỏ hơn, Qwen3.8-Flash-Next đáng để thử trước.
Xem hướng dẫn đầy đủ về Qwen3.8-Flash-Next để có phân tích chi tiết.
GLM-5.3-Flash cho thấy Z.ai đặt cược rõ ràng vào phân khúc tác tử giá rẻ: tiến sát Opus 4.8 và GPT-5.6 Terra trên các bài đánh giá mã hóa, rồi giảm giá mạnh theo cấp số nhân.
Mức 84,3 trên Terminal-Bench 2.1 với giá pha trộn khoảng $0,10 cho mỗi 1M token là lời chào hàng, và đó là đề xuất vững chắc cho mã hóa và tự động hóa khối lượng lớn.
Hạn chế đến từ tốc độ và hạ tầng.
Ở ~49 token/giây, đây không phải là mô hình cho streaming nhạy độ trễ, và checkpoint FP8 ~306 GiB khiến việc triển khai cục bộ bình thường trở nên bất khả. Người dùng xem trước sớm trên r/opencodeCLI báo thời gian chờ hàng đợi và khởi động chậm khi tải nặng, dù GA có lẽ đã cải thiện.
Theo tôi, nếu chi phí mỗi token là ràng buộc và công việc của bạn là mã hóa hoặc tác tử, GLM-5.3-Flash đáng để thử so với GPT-5.6 Terra và Claude Opus 4.8 trước khi bạn quyết định.
Nếu bạn cần thêm 3 điểm chỉ số trí tuệ và thông lượng nhanh hơn, GLM-5.3 đầy đủ tồn tại vì lý do đó. Nó cũng ra mắt cùng ngày với Qwen3.8-Flash-Next, nên phân khúc giá rẻ hiện rất đáng để khảo giá.
Nếu bạn muốn làm quen với các mô hình như thế này, tôi khuyến nghị lộ trình kỹ năng AI Fundamentals để xây nền tảng, rồi xem hướng dẫn về chạy một mô hình MoE Flash cục bộ để thực hành.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
