
Corso
Sviluppare applicazioni LLM con LangChain
3 ore
51.2K
Immagina di raccontare a un amico una storia lunga, per poi accorgerti che ha dimenticato l'inizio quando arrivi alla battuta finale. Questa frustrazione è esattamente ciò che accade quando un'IA esaurisce la "memoria a breve termine", costringendola a eliminare dettagli cruciali per fare spazio a quelli nuovi.
Nel mondo dei Large Language Model (LLM), questa capacità di attenzione è definita dalla finestra di contesto.
Man mano che i modelli diventano più potenti e le dimensioni del contesto aumentano, capire come funzionano queste finestre diventa fondamentale per costruire sistemi di IA affidabili e scalabili. In questa guida, vedremo le basi delle finestre di contesto, i compromessi nell'ampliarle e le strategie per usarle in modo efficace.
Per andare oltre la teoria e imparare a gestire i limiti di contesto in applicazioni Python reali, dai un'occhiata al nostro corso Developing LLM Applications with LangChain.
La finestra di contesto di un modello di IA determina la quantità di testo che può mantenere nella sua memoria di lavoro mentre genera una risposta. Limita per quanto tempo si può portare avanti una conversazione senza dimenticare i dettagli delle interazioni precedenti.
Puoi pensarla come la memoria a breve termine di un essere umano. Conserva temporaneamente informazioni da conversazioni precedenti per usarle nel compito in corso.
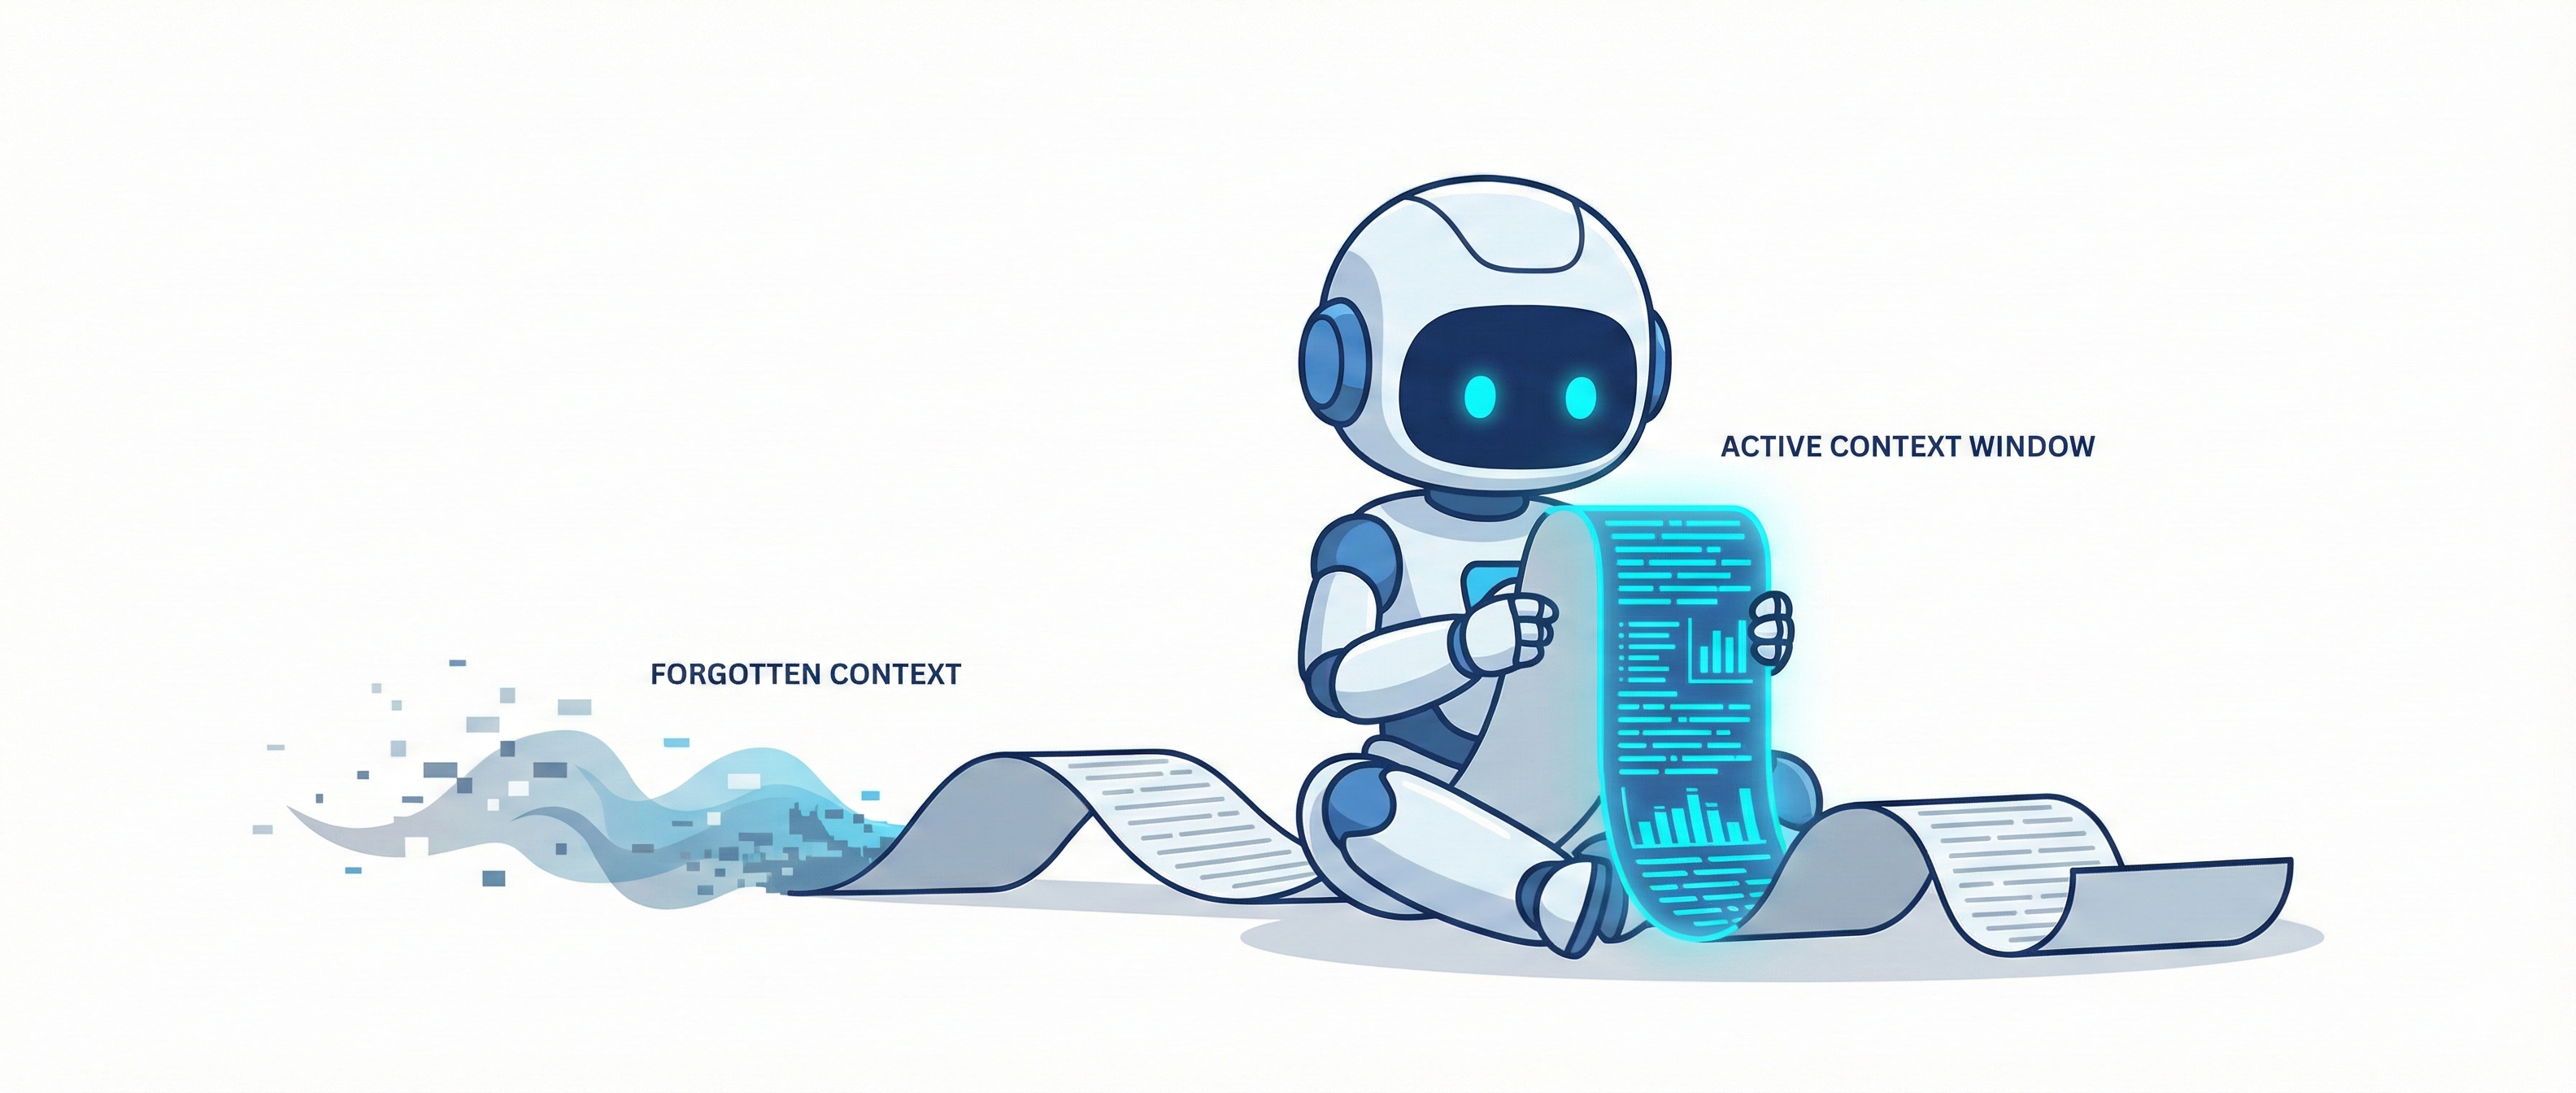
Le finestre di contesto influiscono su vari aspetti, tra cui la qualità del ragionamento, la profondità della conversazione e la capacità del modello di personalizzare efficacemente le risposte. Determinano anche la dimensione massima dell'input che può elaborare in una sola volta. Quando un prompt o il contesto di una conversazione supera tale limite, il modello tronca (taglia) le parti iniziali del testo per fare spazio.
Per capire più chiaramente cosa significa, vediamo alcuni concetti di base alla base dei modelli di IA e delle finestre di contesto.
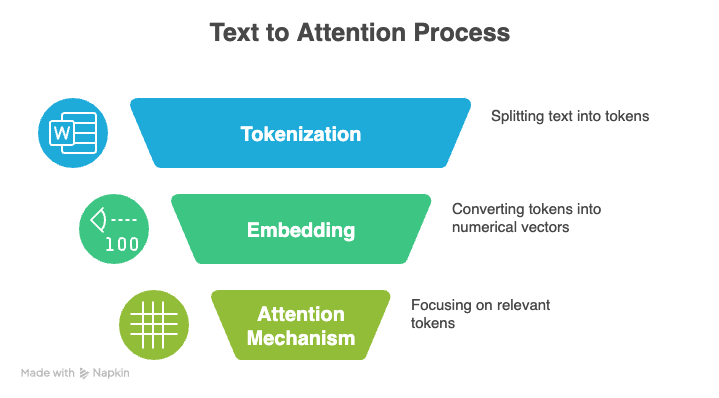
Tre concetti fondamentali sono alla base degli LLM: tokenizzazione, meccanismo di attenzione e codifica posizionale.
La tokenizzazione è il processo di conversione del testo grezzo in una sequenza di unità più piccole, o token, che un LLM può elaborare. Questi token possono rappresentare intere parole, singoli caratteri o persino sillabe parziali. L'insieme completo dei token unici riconosciuti da un modello è chiamato vocabolario.
Ad esempio, la frase “Hello, world” potrebbe essere tokenizzata in [“Hello”, “,”, “ world”].
Durante l'addestramento o l'inferenza, ogni token è trasformato in un intero univoco, e il modello legge questi numeri invece del testo originale. Analizza la sequenza numerica, impara come i token si relazionano tra loro e genera nuovo testo prevedendo il prossimo token probabile.
Una tokenizzazione efficiente incide molto sulla quantità di informazioni che entra nella finestra di contesto di un modello. Quando un tokenizer può rappresentare il testo con meno token, più contenuto entra nella stessa finestra.
I tokenizer che rappresentano parole o frasi comuni come singoli token sono particolarmente efficaci perché riducono il conteggio dei token, permettendo al modello di gestire documenti più lunghi entro i limiti del suo contesto.
Il cosiddetto meccanismo di attenzione è un'altra base dei moderni LLM. Aiuta un modello a concentrarsi sulle parti più rilevanti dell'input quando genera un output.
Invece di trattare ogni token allo stesso modo, il modello confronta la rappresentazione corrente con tutte le altre rappresentazioni dei token e assegna un punteggio a ciascun confronto. Questa ponderazione selettiva consente al modello di elaborare sequenze lunghe e comprendere il contesto in modo più efficace.
L'attenzione si basa su tre componenti: Query, Key e Value.
Query: Il segnale inviato dal token corrente per "cercare" informazioni pertinenti nel resto della sequenza.
Key: L'identificatore di ciascun token nella sequenza che determina quanto bene corrisponde al segnale di ricerca.
Value: Il contenuto informativo effettivo che viene recuperato e usato quando si trova una corrispondenza tra una Query e una Key.
Il modello calcola i punteggi di somiglianza tra query e key, converte tali punteggi in pesi usando la funzione di attivazione softmax e poi produce l'output finale come somma pesata dei value.
La self-attention confronta il token corrente con ogni altro token nella sequenza. Ciò crea un costo computazionale quadratico: raddoppiare la finestra di contesto quadruplica la potenza di calcolo e la memoria richieste.
Con l'espansione delle finestre di contesto, i costi crescono rapidamente; per questo i modelli si affidano a ottimizzazioni come attenzione sparsa, approssimazione a basso rango o suddivisione in blocchi per mantenere il calcolo gestibile.
I transformer, che alimentano i moderni modelli linguistici, non comprendono naturalmente l'ordine dei token. Per questo si affidano alla codifica posizionale per incorporare queste informazioni.
La codifica posizionale aggiunge a ciascun token un piccolo segnale che aiuta il modello a comprendere distanza e disposizione relativa.
Il metodo specifico di rappresentazione posizionale definisce anche fino a che punto il modello può tracciare in modo affidabile le relazioni all'interno di una sequenza, determinando la dimensione e l'efficacia della sua finestra di contesto. Confrontiamo alcuni metodi popolari:
Embedding posizionali assoluti: Il modello apprende un vettore separato per ogni posizione nella sequenza, come dare a ogni token un indirizzo fisso. Funziona per sequenze più brevi, ma il modello non può gestire posizioni oltre quelle su cui è stato addestrato, rendendo difficile estendere la finestra di contesto.
Codifiche sinusoidali: Le posizioni sono codificate con onde sinusoidali e cosinusoidali ripetute, che danno a ogni token un pattern unico in base alla sua posizione. Generalizzano meglio a lunghezze non viste rispetto agli embedding assoluti, anche se diventano meno stabili con sequenze estremamente lunghe.
Codifiche posizionali relative: Invece di indicare posizioni esatte, il modello apprende la distanza tra i token. Ciò aiuta a generalizzare a sequenze più lunghe, ma il limite complessivo del contesto dipende comunque dall'architettura e dalla memoria del modello.
Rotary Positional Embeddings (RoPE): RoPE codifica la posizione ruotando la rappresentazione vettoriale di ciascun token in base alla sua posizione assoluta, calcolando la distanza dagli altri token. Questo metodo rimane stabile con la crescita delle sequenze e supporta finestre di contesto molto più ampie.
ALiBi (Attention Linear Biases): ALiBi applica un semplice bias basato sulla distanza all'interno del meccanismo di attenzione, così i token più vicini ricevono naturalmente un peso maggiore. Scala bene su sequenze lunghe.
Ti consiglio di consultare questo tutorial su come funzionano i transformer per una panoramica dettagliata.
Se il contesto supera la finestra di contesto, il modello può troncare o ignorare le parti iniziali, perdendo potenzialmente informazioni importanti. Per questo i ricercatori sperimentano continuamente nuove tecniche per spingere questi limiti e abilitare finestre di contesto più lunghe.
Fino al 2022, i modelli GPT di OpenAI dominavano il panorama. Il primo modello GPT, rilasciato nel 2018, supportava una finestra da 512 token. Le due versioni successive, nel 2019 e nel 2020, hanno raddoppiato ciascuna quel limite, raggiungendo 2.048 token per GPT-3. I modelli successivi hanno continuato a estendere questi confini fino a un milione di token (GPT-4.1).
Di recente, OpenAI è stata raggiunta o addirittura superata dalla concorrenza. Le versioni Gemini 2.5 e 3 Pro di Google eguagliano questa dimensione di finestra fino a un milione di token, rendendo possibile elaborare in un'unica passata interi libri, grandi codebase e carichi di lavoro multi-documento.
La serie Claude Sonnet 4.5 di Anthropic sta attualmente testando la stessa dimensione della finestra di contesto in beta, espandendosi dalla dimensione originaria di 200.000 token.
Le famiglie di modelli open source come Llama e Mistral si collocano generalmente nell'intervallo 100k–200k, offrendo prestazioni di lungo contesto rispettabili pur rimanendo pratici da distribuire in locale o da perfezionare.
Eccezioni degne di nota includono Llama Maverick, che supporta una finestra da 1 milione di token progettata per il ragionamento generico su documenti lunghi. Nel frattempo, Llama Scout spinge il limite ancora oltre con una capacità enorme di 10 milioni di token, specificamente ingegnerizzata per elaborare intere codebase o archivi legali in un'unica passata.
Tuttavia, il rilascio di GPT-5.2 proprio questa settimana ha segnato un cambio di strategia. Invece di inseguire un contesto infinito, OpenAI ha limitato il suo nuovo modello di punta a una finestra da 400.000 token, scambiando la pura dimensione con un "richiamo perfetto" e capacità di ragionamento superiori che evitano i problemi di distrazione comuni nei modelli più grandi.
Le differenze nella dimensione della finestra di contesto plasmano le prestazioni di ciascun modello nei flussi di lavoro reali. Finestre di contesto estese alimentano modelli con forte accuratezza, coerenza e ragionamento a lungo raggio, ma richiedono anche più calcolo e una selezione del contesto più attenta.
I modelli di fascia media restano efficienti e riescono comunque a gestire documenti lunghi e chat estese, sebbene necessitino della giusta struttura per input molto grandi.
I seguenti casi d'uso evidenziano come i punti di forza dei modelli con grandi finestre di contesto emergano nelle applicazioni reali.
Con spazio sufficiente per contenere interi report, trascrizioni, codebase o articoli scientifici in una volta sola, un modello può tracciare pattern, collegare dettagli distanti e mantenere una comprensione coerente dall'inizio alla fine. Questo offre molte aree di applicazione:
Legale: Finestre ampie consentono ai modelli di analizzare contratti completi, confrontare clausole tra più documenti e tracciare riferimenti nascosti in documenti lunghi.
Sanità: I team possono esaminare linee guida cliniche corpose, storie dei pazienti o dataset multi-studio preservando un contesto importante che finestre più piccole perderebbero.
Ricerca: Un modello con ampia finestra può leggere articoli completi e rassegne in un'unica passata e far emergere connessioni che appaiono solo quando l'intero documento è visibile.
Finestre di contesto più grandi rendono l'AI conversazionale più naturale perché il modello può ricordare più parti della conversazione senza dimenticare i messaggi precedenti.
Nel customer service, questo porta a interazioni più fluide e personalizzate. Il modello può usare preferenze passate e conversazioni precedenti per fornire risposte più accurate e pertinenti.
Le finestre di contesto estese supportano un ragionamento complesso tra testo, audio e immagini dando al modello spazio sufficiente per contenere tutte le modalità insieme invece di elaborarle in isolamento.
Quando l'intera trascrizione, i frame visivi e il materiale scritto correlato rientrano in un'unica finestra, il modello può confrontare dettagli tra formati, tracciare relazioni e costruire una comprensione unificata del contesto.
Questo elimina i vuoti che si creano quando le informazioni devono essere suddivise o riassunte e consente al modello di ragionare sull'intero set di input in una sola volta.
Le grandi finestre di contesto sbloccano potenti capacità dei modelli, ma introducono anche nuove sfide prestazionali man mano che le dimensioni dell'input crescono. Anche i modelli avanzati faticano a mantenere un'attenzione perfetta su sequenze estremamente lunghe, quindi non sempre usano le informazioni da ogni parte del contesto in modo affidabile come ci si aspetterebbe.
Un problema comune nei modelli a lungo contesto è l'effetto “lost in the middle”. I modelli ricordano piuttosto bene l'inizio e la fine di una lunga sequenza, ma spesso mancano o ignorano dettagli importanti sepolti nel mezzo. Questo può portare a risposte più deboli, anche quando l'intero contesto è disponibile.
Strutturare l'input in modo intelligente aiuta a evitare questo problema per i compiti importanti. Significa suddividerlo in sezioni chiare o ripetere i punti chiave in modo che il modello non li trascuri.
I costi possono aumentare rapidamente con l'incremento della dimensione della finestra di contesto. Ogni token aggiuntivo aumenta la dimensione del calcolo dell'attenzione, il che fa crescere il tempo di inferenza, i requisiti di memoria GPU e il carico complessivo del sistema.
Per gestirlo, servono modi più efficaci di fornire informazioni al modello. Tecniche come recupero selettivo, suddivisione gerarchica o riepiloghi rapidi aiutano a mantenere l'input più piccolo, così il modello non viene sovraccaricato.
Finestre grandi introducono anche preoccupazioni relative a sicurezza e privacy. Quando fornisci più input al modello, aumenta la probabilità di esporre dati sensibili.
Per questo i team hanno bisogno di solide regole di gestione dei dati, procedure di redazione e controlli di accesso per assicurarsi che le grandi finestre di contesto non creino nuovi rischi.
In molti casi, informazioni inutili o debolmente correlate aumentano il carico cognitivo per il modello, elevando il rischio di allucinazioni e pattern errati. Input lunghi introducono anche rumore che può distorcere la comprensione del compito da parte del modello.
In pratica, prestazioni di alta qualità derivano spesso da un contesto accuratamente curato, garantendo che il modello veda le informazioni giuste invece di essere esposto semplicemente alla maggiore quantità possibile.
Diversi metodi possono essere impiegati per sfruttare al meglio le finestre di contesto. Tra questi ci sono la Retrieval Augmented Generation (RAG), il context engineering, il chunking e la scelta del modello.
La Retrieval Augmented Generation (RAG) funziona recuperando informazioni aggiuntive da un database esterno e fornendole al modello ogni volta che serve contesto.
Invece di stipare interi documenti nella finestra di contesto, RAG archivia tutto separatamente e recupera solo i pezzi che contano per la domanda corrente. Mantiene così il contesto piccolo, pur dando al modello tutte le informazioni di cui ha bisogno.
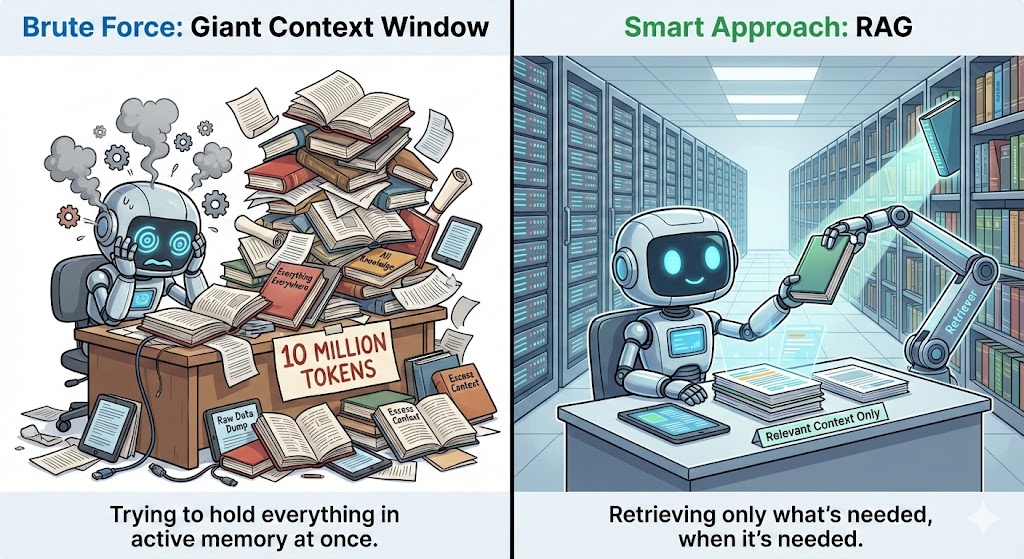
Lo fa usando embedding o ricerca vettoriale per trovare i frammenti più rilevanti e inviando tali frammenti al modello in modo pulito e strutturato. Questo aumenta l'accuratezza, assicurando che il modello possa usare informazioni extra pertinenti oltre ai suoi dati di addestramento.
Il context engineering si concentra sul fornire ai modelli informazioni pertinenti invece di sovraccaricarli con dettagli inutili. Strategie efficaci includono segmentare documenti lunghi, riassumere le sezioni a basso valore e usare passaggi di pre-elaborazione leggeri per evidenziare i punti principali.
La ricerca semantica aiuta a identificare il testo che conta per la query corrente. Puoi anche migliorare i risultati spostando le informazioni più critiche all'inizio o alla fine del contesto, poiché i modelli tendono a ricordare meglio quei punti.
Il chunking suddivide documenti lunghi in sezioni più piccole e coerenti. L'idea è raggruppare il contenuto in base all'argomento, alla struttura o al compito che supporta.
Questo mantiene ogni blocco coerente e aiuta il modello a restare concentrato invece di perdersi in un enorme blocco di testo. Se vuoi saperne di più, dai un'occhiata a questo articolo su strategie di chunking avanzate.
Il chunking semantico raggruppa frasi che condividono un significato simile invece di tagliare il testo a limiti di caratteri casuali. Divide il contenuto in punti di interruzione naturali come cambi di argomento, transizioni di paragrafo o intestazioni di sezione.
Il chunking basato sui compiti va oltre, modellando ogni blocco attorno alla domanda specifica a cui stai cercando di rispondere. Ogni sezione contiene quindi solo le informazioni effettivamente rilevanti per quel compito.
I compiti che coinvolgono analisi a livello di documento, ragionamento su più file o conversazioni di lunga durata traggono beneficio da modelli con finestre nell'intervallo 200k–1M. Per compiti più mirati come riassunti, revisione del codice o Q&A brevi, modelli nell'intervallo 100k–200k offrono spesso il miglior equilibrio tra velocità, costo e accuratezza.
Finestre più piccole possono comunque funzionare bene se abbinate a solidi sistemi di recupero. Un buon sistema RAG o il Model Context Protocol (MCP) può recuperare le informazioni giuste su richiesta, così il modello non deve tenere tutto in memoria.
Prima di concludere, diamo un'occhiata alla direzione verso cui si sta muovendo la tecnologia in tema di finestre di contesto.
Le architetture dei futuri modelli si stanno orientando verso finestre di contesto dinamiche, invece che di dimensioni fisse.
I ricercatori stanno esplorando approcci che combinano i punti di forza dei transformer con nuovi sistemi di memoria a lungo raggio, dando vita a modelli che possono archiviare e richiamare informazioni senza affidarsi solo ai meccanismi di attenzione.
Queste architetture superano i limiti attuali passando da finestre di contesto statiche a livelli di memoria dinamici che crescono con il compito.
I sistemi di memoria sono un'altra area di innovazione. Si prevede che i modelli futuri si baseranno maggiormente su sistemi di memoria sensibili al contesto che si estendono oltre una singola sessione e forniscono continuità nel tempo.
Invece di trattare ogni conversazione come un nuovo inizio, questi sistemi memorizzano preferenze chiave, decisioni passate e temi ricorrenti in un livello di memoria strutturato che può essere richiamato quando rilevante.
Questo sposta la personalizzazione da reattiva a proattiva, permettendo al modello di comprendere gli utenti in modo più olistico e supportare obiettivi di lungo periodo con molta più coerenza.
Anche il recupero esterno sta evolvendo. Attualmente, RAG funziona come un motore di ricerca, portando testo rilevante nel prompt. Versioni avanzate come Corrective Retrieval-Augmented Generation (CRAG) sono già emerse, ma è solo l'inizio.
In futuro, il recupero sembrerà più integrato, quasi come se il modello avesse una propria memoria esterna. Raccoglierà, comprimerà e riproporrà automaticamente le informazioni con un intervento minimo dell'utente.
La memoria persistente cambierà anche il modo in cui interagiamo con l'IA. Invece di dimenticare tutto alla fine di una sessione, il modello ricorderà dettagli importanti per giorni, settimane o addirittura mesi. Man mano che apprende il tuo stile, le tue abitudini e le tue priorità, potrà offrirti risposte più su misura e utili, senza bisogno che tu ti ripeta.
Strumenti come Mem0 stanno già aprendo la strada, fungendo da livello di memoria dedicato tra applicazioni e LLM. Tuttavia, guardando avanti, ci aspettiamo di vedere sempre più di queste capacità integrate direttamente nelle architetture dei modelli piuttosto che fare affidamento su livelli esterni.
Finestre più grandi sbloccano nuovi flussi di lavoro potenti, ma introducono anche sfide di attenzione, costi computazionali più alti e rischi di qualità quando si sovraccarica il contesto. Questo rende essenziale una gestione strategica del contesto.
Tecniche come l'augmentazione tramite recupero, il chunking semantico e il context engineering aiutano i modelli a rimanere concentrati, efficienti e affidabili anche mentre le loro capacità si espandono.
Guardando avanti, i migliori sistemi basati su LLM combinano strumenti intelligenti e una solida comprensione di come il contesto influisce sul ragionamento. Applicando questi principi, i team possono cogliere i vantaggi dei modelli a lungo contesto, preparandosi al contempo alla prossima generazione di architetture che spingeranno ancora oltre i confini del contesto.
Porta le tue basi di Python al livello successivo con lo skill track Developing Large Language Models. È progettato per guidarti dalle basi del codice alla creazione e al fine-tuning delle tue potenti applicazioni di IA.
Corsi sugli LLM
Corso
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



