
Corso
Lavorare con Llama 3
2 ore
15.6K
Meta ha rilasciato da poco Meta Movie Gen, un evento al tempo stesso importante e in parte inatteso nel panorama della generazione da testo a video—non credo che Meta fosse sul radar di molti per quanto riguarda la generazione video.
Considerato l’ambiente competitivo, con diverse aziende di primo piano come OpenAI già al lavoro su modelli solidi come Sora, il rilascio di Meta è degno di nota.
Il modello si comporta bene su vari compiti, superando o eguagliando la qualità delle soluzioni di player affermati come Runway Gen3, LumaLabs e, in particolare, Sora di OpenAI.
In questo blog, vedremo cos’è Meta Movie Gen, come funziona, quali sono le sue capacità e i suoi limiti, e le considerazioni di sicurezza legate al suo utilizzo.
Se vuoi una panoramica del campo della generazione video, ti consiglio questo articolo sui migliori generatori video AI.
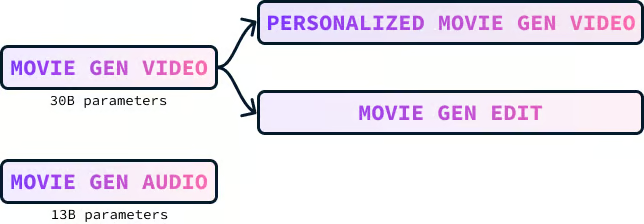
Meta Movie Gen è una collezione di modelli fondamentali per generare vari tipi di media, tra cui testo-in-video, testo-in-audio e testo-in-immagine. Comprende quattro modelli:
Movie Gen Video è un modello da 30 miliardi di parametri progettato per creare immagini e video a partire da descrizioni testuali. Il modello può generare video di alta qualità fino a 16 secondi che corrispondono al prompt testuale fornito. Può produrre contenuti in dimensioni, risoluzioni e durate diverse.
Ecco un esempio di video generato con il prompt:
“Un bradipo con occhiali da sole rosa è sdraiato su un salvagente a forma di donut in una piscina. Il bradipo tiene in mano una bevanda tropicale. L’ambientazione è tropicale. La luce del sole proietta un’ombra.”
Il modello ha il potenziale per rivoluzionare i flussi di lavoro di editing video in vari settori. La sua capacità di comprendere ed eseguire con precisione istruzioni di editing basate su testo potrebbe migliorare sensibilmente il processo di montaggio, rendendolo più rapido, efficiente e accessibile a un pubblico più ampio. Questa tecnologia potrebbe giovare a cineasti, creator, educatori e a chiunque lavori con contenuti video.
L’addestramento del modello Movie Gen Video ha coinvolto diversi elementi chiave: raccolta e preparazione dei dati, il processo di training vero e proprio, il fine-tuning per migliorare la qualità e le tecniche di upsampling usate per ottenere output ad alta risoluzione.
Il modello Movie Gen Video è stato addestrato su un enorme dataset contenente centinaia di milioni di coppie video-testo e oltre un miliardo di coppie immagine-testo.
Ogni video del dataset passa attraverso un rigoroso processo di curatela che prevede filtri per qualità visiva, caratteristiche del movimento e pertinenza dei contenuti. Il filtraggio mira a selezionare video con movimento non banale, riprese a singola inquadratura e un’ampia varietà di concetti, con una parte significativa che include esseri umani.
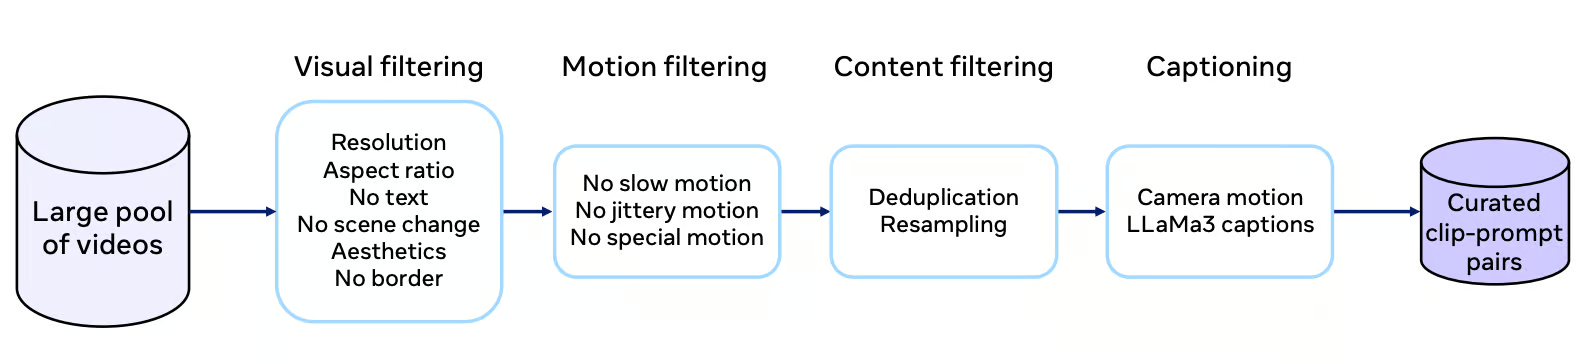
Fonte: articolo di ricerca su Movie Gen
Caption di alta qualità sono fondamentali per addestrare il modello in modo efficace. Movie Gen Video usa il modello LLaMa3-Video per generare didascalie dettagliate che descrivono accuratamente il contenuto del video. Queste didascalie vanno oltre la semplice etichettatura degli oggetti; includono descrizioni di azioni, movimenti di camera e persino informazioni sull’illuminazione. Questa ricchezza testuale aiuta il modello a imparare una comprensione più sfumata della narrazione visiva.
Il processo di addestramento di Movie Gen Video è suddiviso in diverse fasi per migliorarne efficienza e scalabilità.
Il modello viene inizialmente addestrato sul compito testo-in-immagine usando immagini a bassa risoluzione. Questa fase di "riscaldamento" consente al modello di apprendere concetti visivi fondamentali prima di affrontare il compito più complesso della generazione video.
Successivamente il modello è addestrato congiuntamente sia sui compiti testo-in-immagine che testo-in-video, aumentando progressivamente la risoluzione dei dati in input. Questo approccio congiunto aiuta il modello a sfruttare l’abbondanza e la diversità dei dataset immagine-testo imparando al contempo le complessità della generazione video.
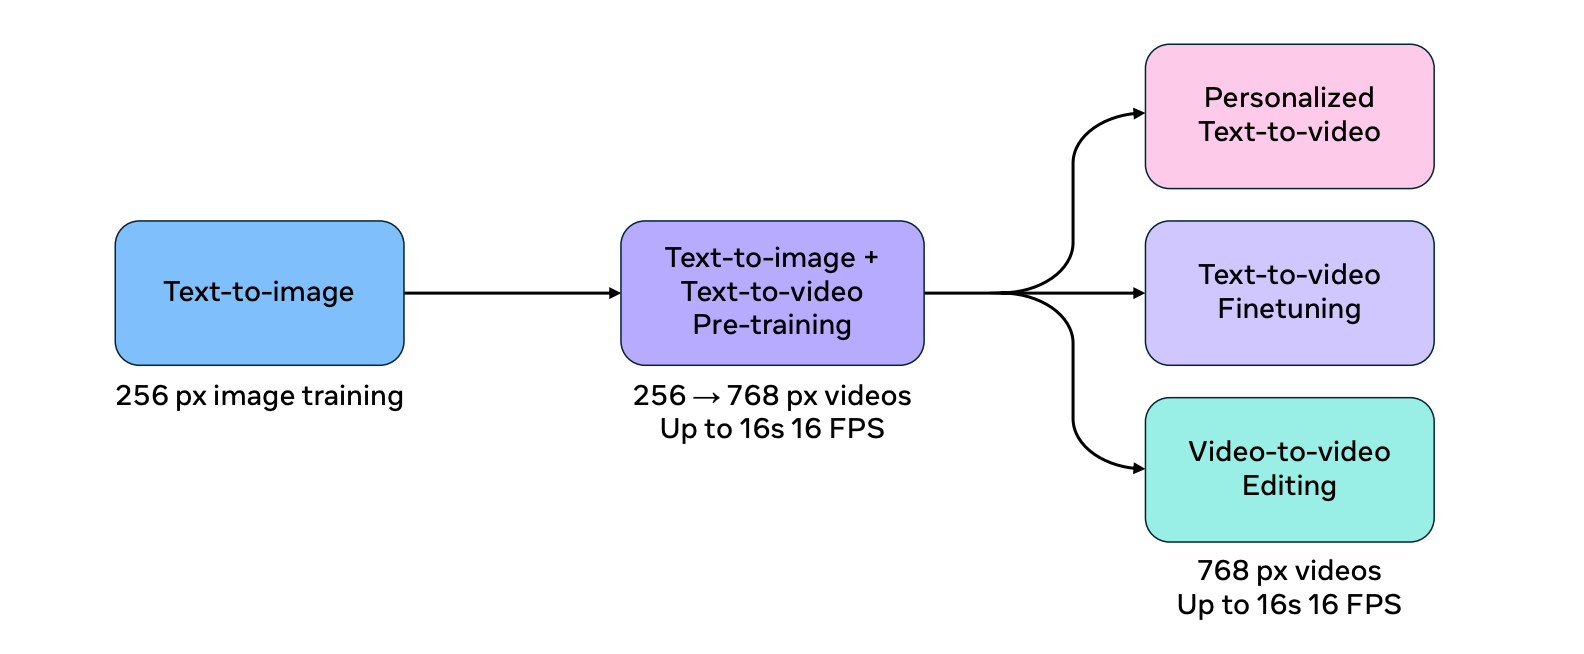
Fonte: articolo di ricerca su Movie Gen
Per gestire le richieste computazionali dei dati video, Movie Gen Video usa un modello Temporal Autoencoder (TAE) per comprimere e decomprimere i video nel tempo. È analogo allo zippare e unzippare file su un computer, consentendo al modello di lavorare con una rappresentazione più gestibile dei dati video.
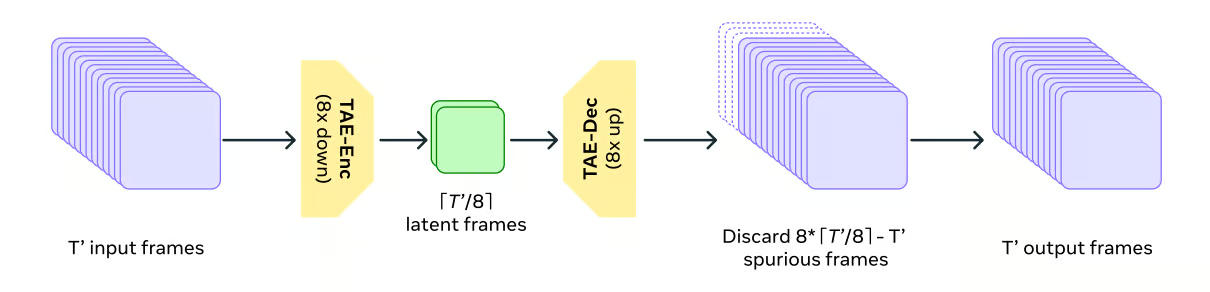
Fonte: articolo di ricerca su Movie Gen
Movie Gen Video utilizza un obiettivo di training chiamato Flow Matching. Invece di generare direttamente il video finale, il flow matching guida il modello a trasformare gradualmente un campione di rumore casuale nell’output video desiderato, passo dopo passo.
Flow Matching prevede la previsione della velocità dei campioni nello spazio latente, anziché prevedere direttamente i campioni stessi. Questo metodo è più efficiente e performante rispetto ai tradizionali metodi basati sulla diffusione.
Per migliorare qualità ed estetica dei video generati, il modello subisce un fine-tuning supervisionato utilizzando un sottoinsieme più piccolo di video curati manualmente con didascalie di alta qualità. È come un artista che affina la propria tecnica grazie alla guida di un esperto, ottenendo output video più realistici e piacevoli alla vista.
Il modello Movie Gen Video finale è creato facendo la media di più modelli addestrati con dataset, iperparametri e checkpoint di pretraining differenti. Questa tecnica aiuta a combinare i punti di forza di modelli diversi, portando a prestazioni più robuste e affidabili.
Il modello produce video a una risoluzione di 768 pixel e usa l’upsampling per portare la risoluzione a Full HD 1080p, ottenendo video più nitidi e visivamente più gradevoli. Questo approccio è comune perché offre una soluzione computazionalmente efficiente: il modello base elabora meno token pur producendo output ad alta risoluzione.
Lo Spatial Upsampler funziona come un modello di generazione video-to-video. Prende in input il video a bassa risoluzione, lo porta alla risoluzione target tramite interpolazione bilineare e poi lo codifica in uno spazio latente usando un Variational Autoencoder (VAE) frame-wise.
Un modello nello spazio latente genera quindi i latenti del video HD, condizionato sui latenti codificati del video a bassa risoluzione. Infine, il decoder del VAE trasforma i latenti del video HD risultante di nuovo nello spazio dei pixel, producendo l’output finale ad alta risoluzione.
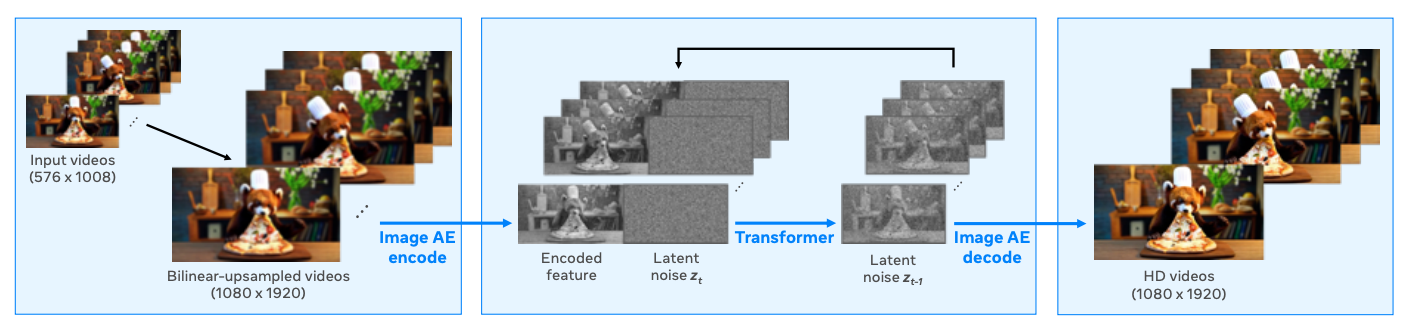
Fonte: articolo di ricerca su Movie Gen
Valutare un modello testo-in-video è più impegnativo rispetto a un modello testo-in-immagine a causa della dimensione temporale aggiuntiva. Il team di Meta ha utilizzato tre misure principali per valutare il modello:
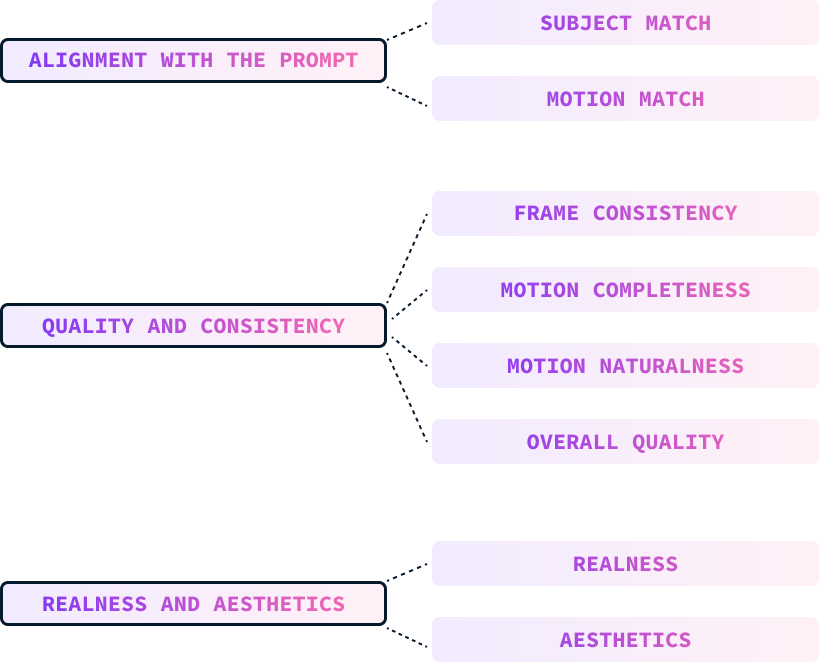
Questi parametri sono valutati manualmente da persone che assegnano un punteggio ai video secondo tali criteri.
L’allineamento al prompt misura quanto bene il video generato corrisponde al testo in input, incluse descrizioni del soggetto, del movimento, dello sfondo e altri dettagli. Questo è ulteriormente suddiviso in:
La qualità e la coerenza del video generato sono valutate indipendentemente dal prompt testuale. Questa misura è suddivisa in:
Ai valutatori è stato chiesto di giudicare la capacità del modello di produrre video fotorealistici e gradevoli esteticamente. Questo criterio è suddiviso in:
I dati di benchmark sono stati progettati per valutare in modo completo le generazioni video. Includono 1.000 prompt che coprono vari aspetti di test, come attività umane, animali, natura, fisica e soggetti o attività insolite.
Il loro benchmark è oltre tre volte più grande di quelli usati in studi precedenti. Ogni prompt è etichettato con un livello di movimento (alto, medio, basso) per valutare la qualità della generazione a diverse intensità di movimento.
La valutazione usa l’intero set di prompt ed esamina metriche specifiche di test, concentrandosi in particolare su come i modelli gestiscono soggetti e movimenti insoliti per testarne le capacità di generalizzazione.
Il seguente diagramma mostra una suddivisione dei prompt usati nella valutazione. A sinistra, è riportata la distribuzione dei concetti dei prompt. A destra, vediamo sostantivi e verbi comuni usati nei prompt (più grande è la parola, più è frequente):
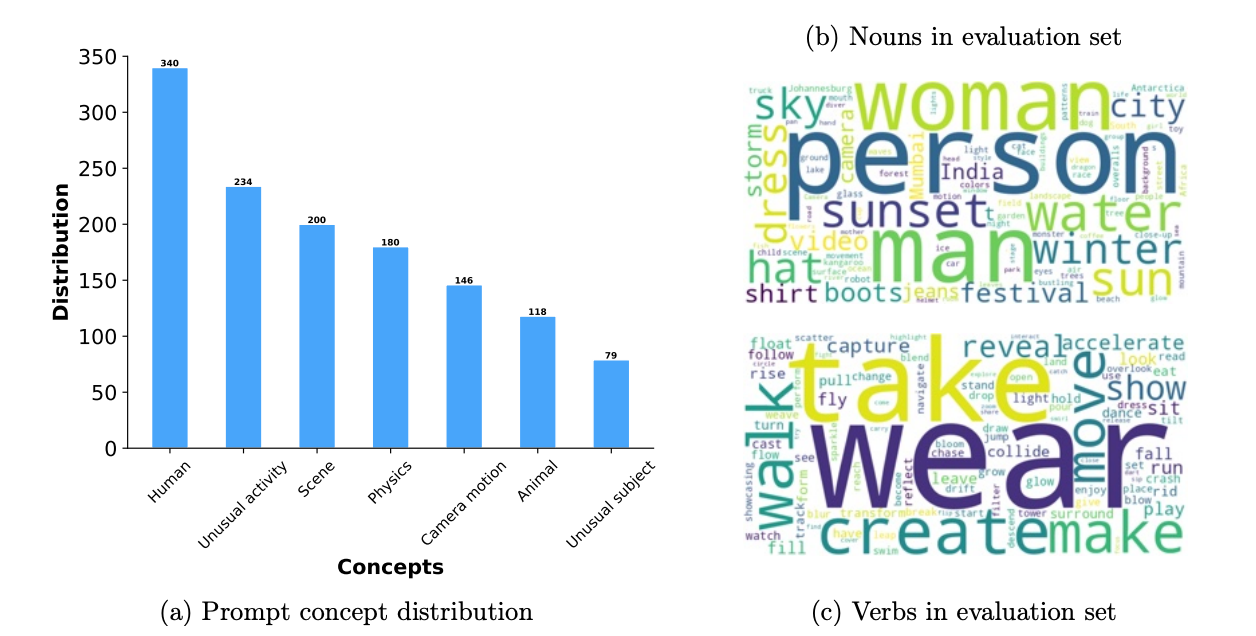
Fonte: articolo di ricerca su Movie Gen
La tabella seguente mostra i risultati della valutazione umana dei video prodotti da diversi modelli su vari criteri di valutazione. I numeri rappresentano i tassi netti di vittoria, calcolati come (Win % - Loss %). Vanno da -100 (sconfitta completa) a 100 (vittoria completa), con 0 che indica un pareggio.
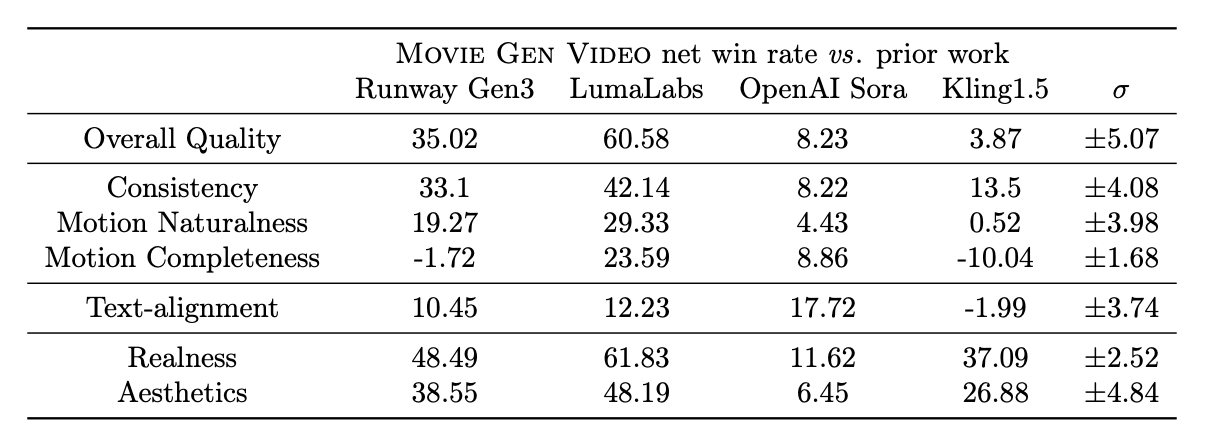
Fonte: articolo di ricerca su Movie Gen
Secondo i loro esperimenti, Movie Gen Video ha prestazioni solide nella generazione testo-in-video, superando diversi modelli esistenti, inclusi sistemi commerciali come Runway Gen3 e LumaLabs, in base a valutazioni umane utilizzando il MovieGen Video Bench. In particolare, Movie Gen Video mostra vantaggi significativi in:
Sebbene MovieGen superi in generale altri modelli, Kling1.5 a volte genera video con ampiezza di movimento maggiore, sebbene al costo di distorsioni e incoerenze. Ciò evidenzia il trade-off tra completezza del movimento e qualità visiva, dove Movie Gen Video privilegia la generazione di movimento realistico e coerente rispetto al semplice massimizzare l’ampiezza del movimento.
Di seguito alcuni screenshot dalla presentazione Meta Connect 2024 che mostrano esempi di confronto di prompt di generazione video:
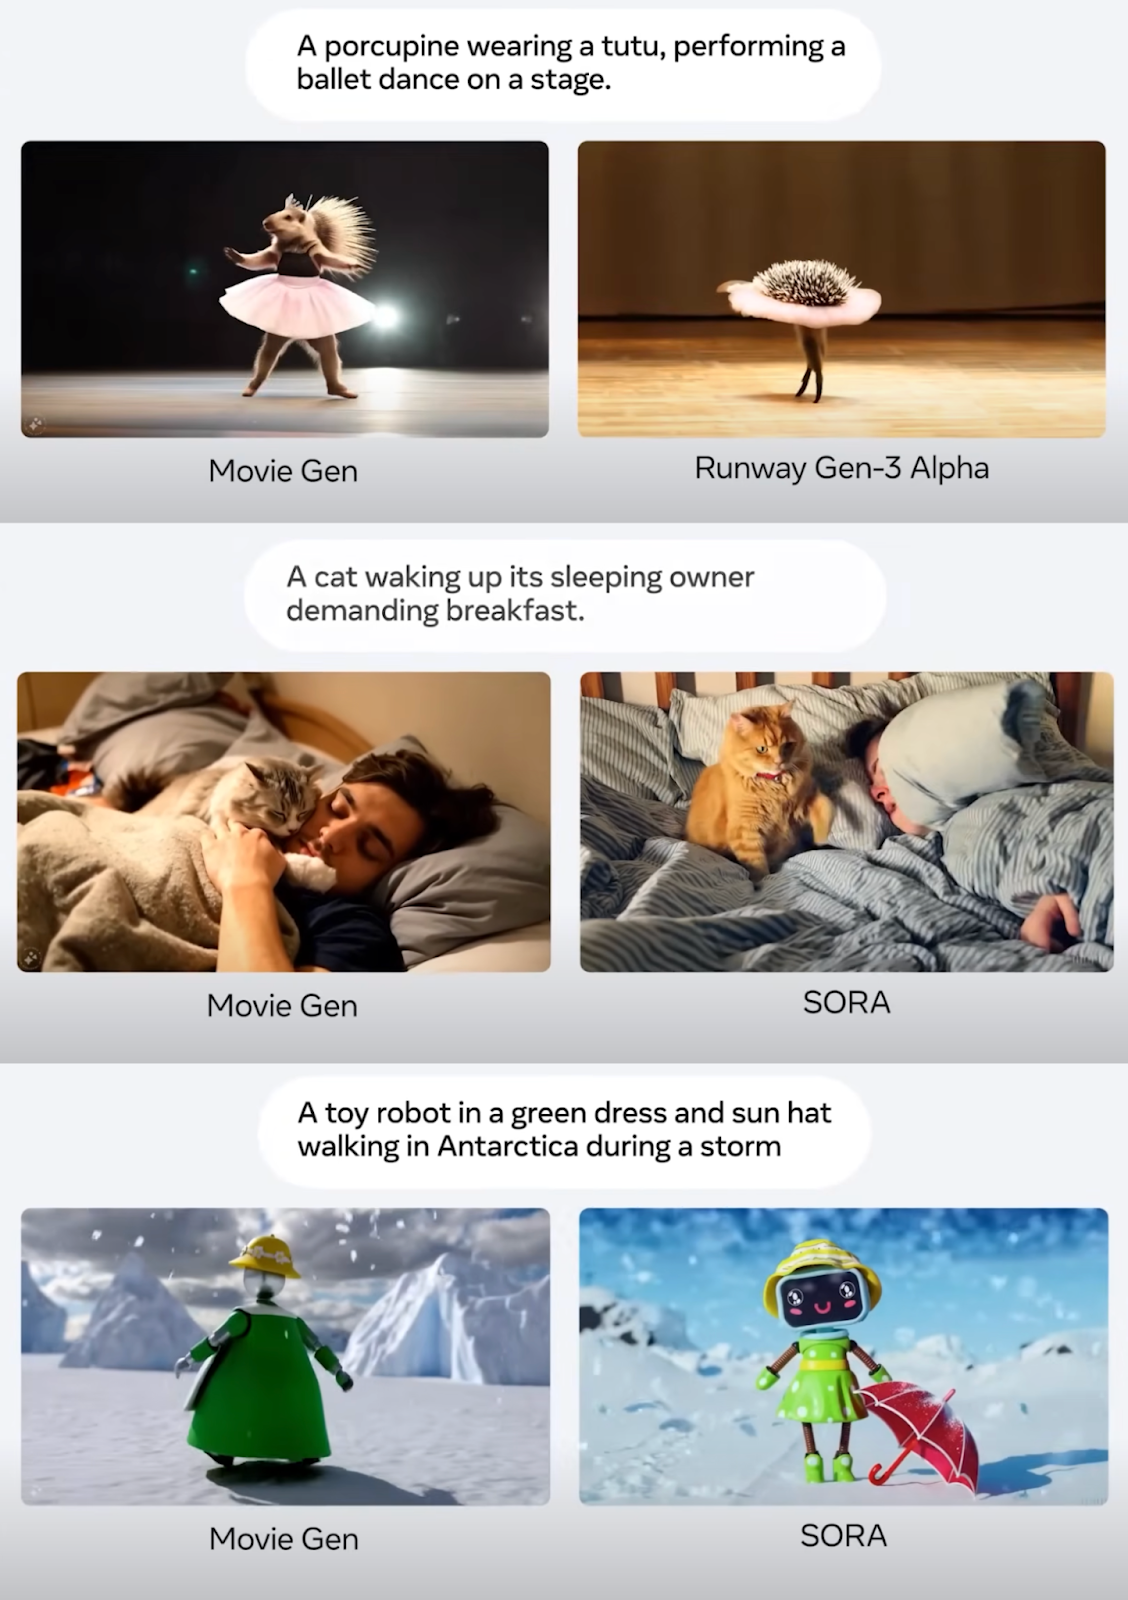
Fonte: articolo di ricerca su Movie Gen
Ecco alcuni esempi di confronto della personalizzazione video in cui si usa una foto per generare un video personalizzato:
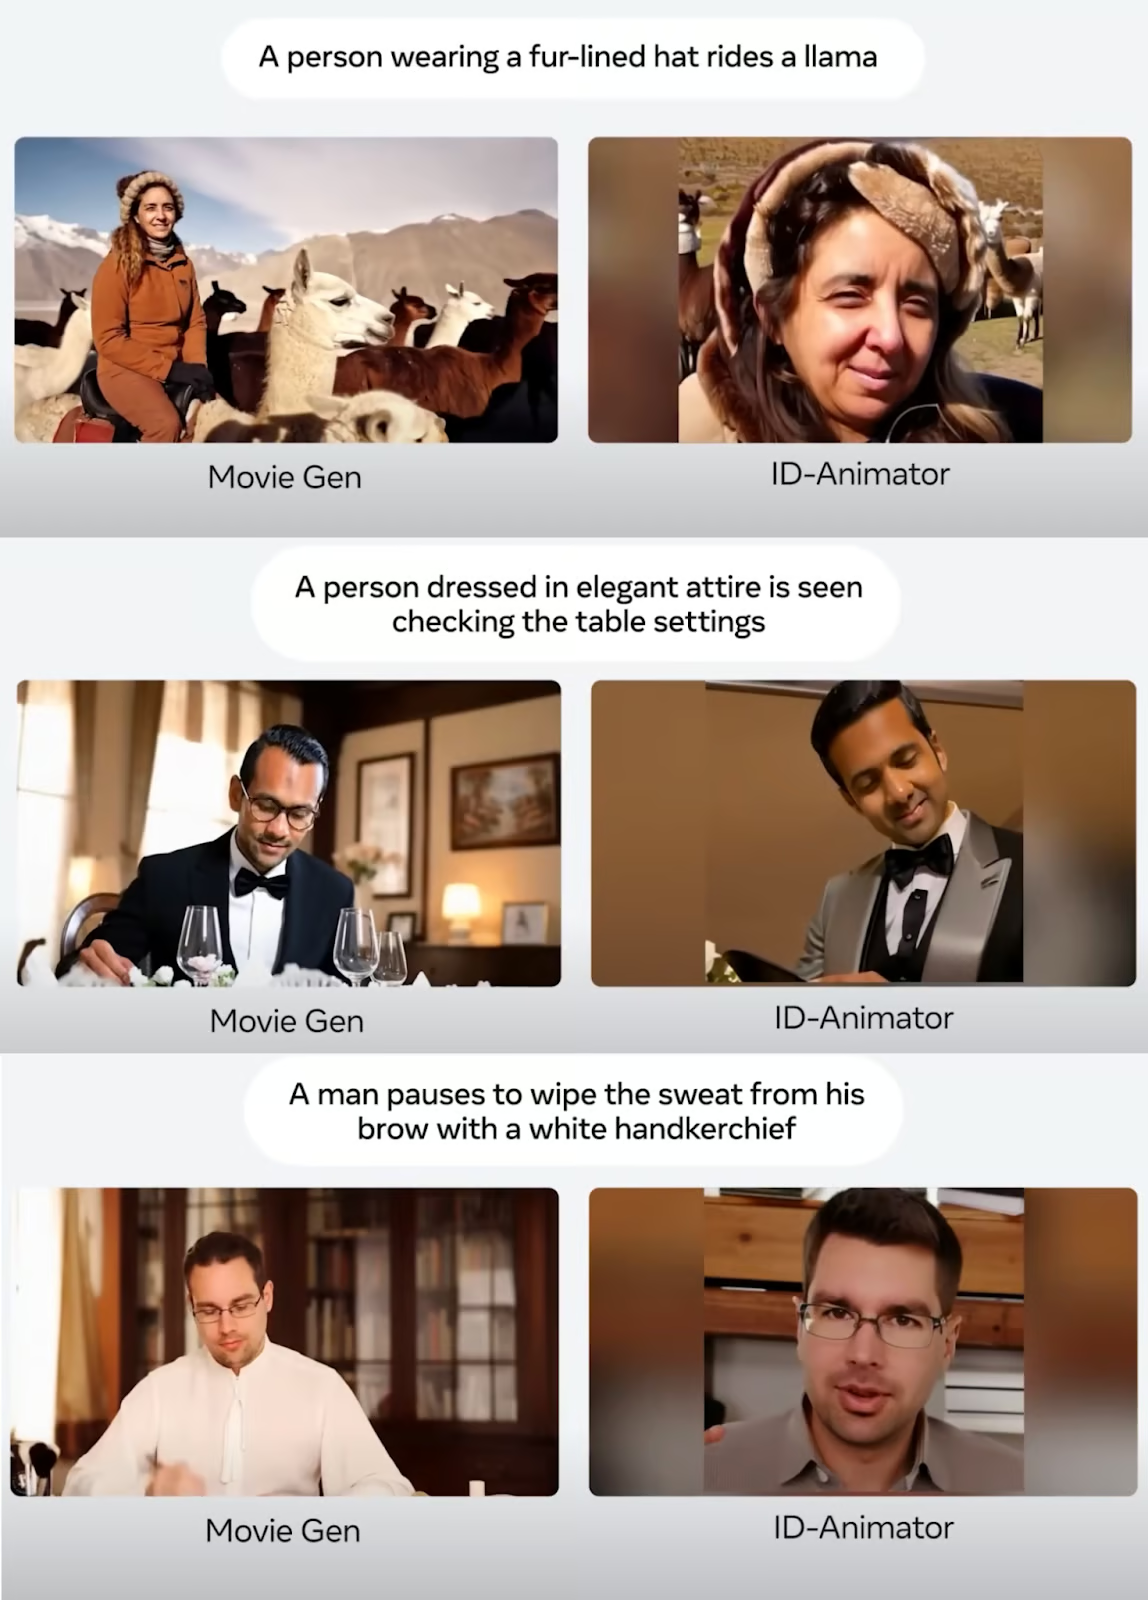
Fonte: articolo di ricerca su Movie Gen
Infine, gli screenshot qui sotto mostrano esempi di confronto sull’editing video:
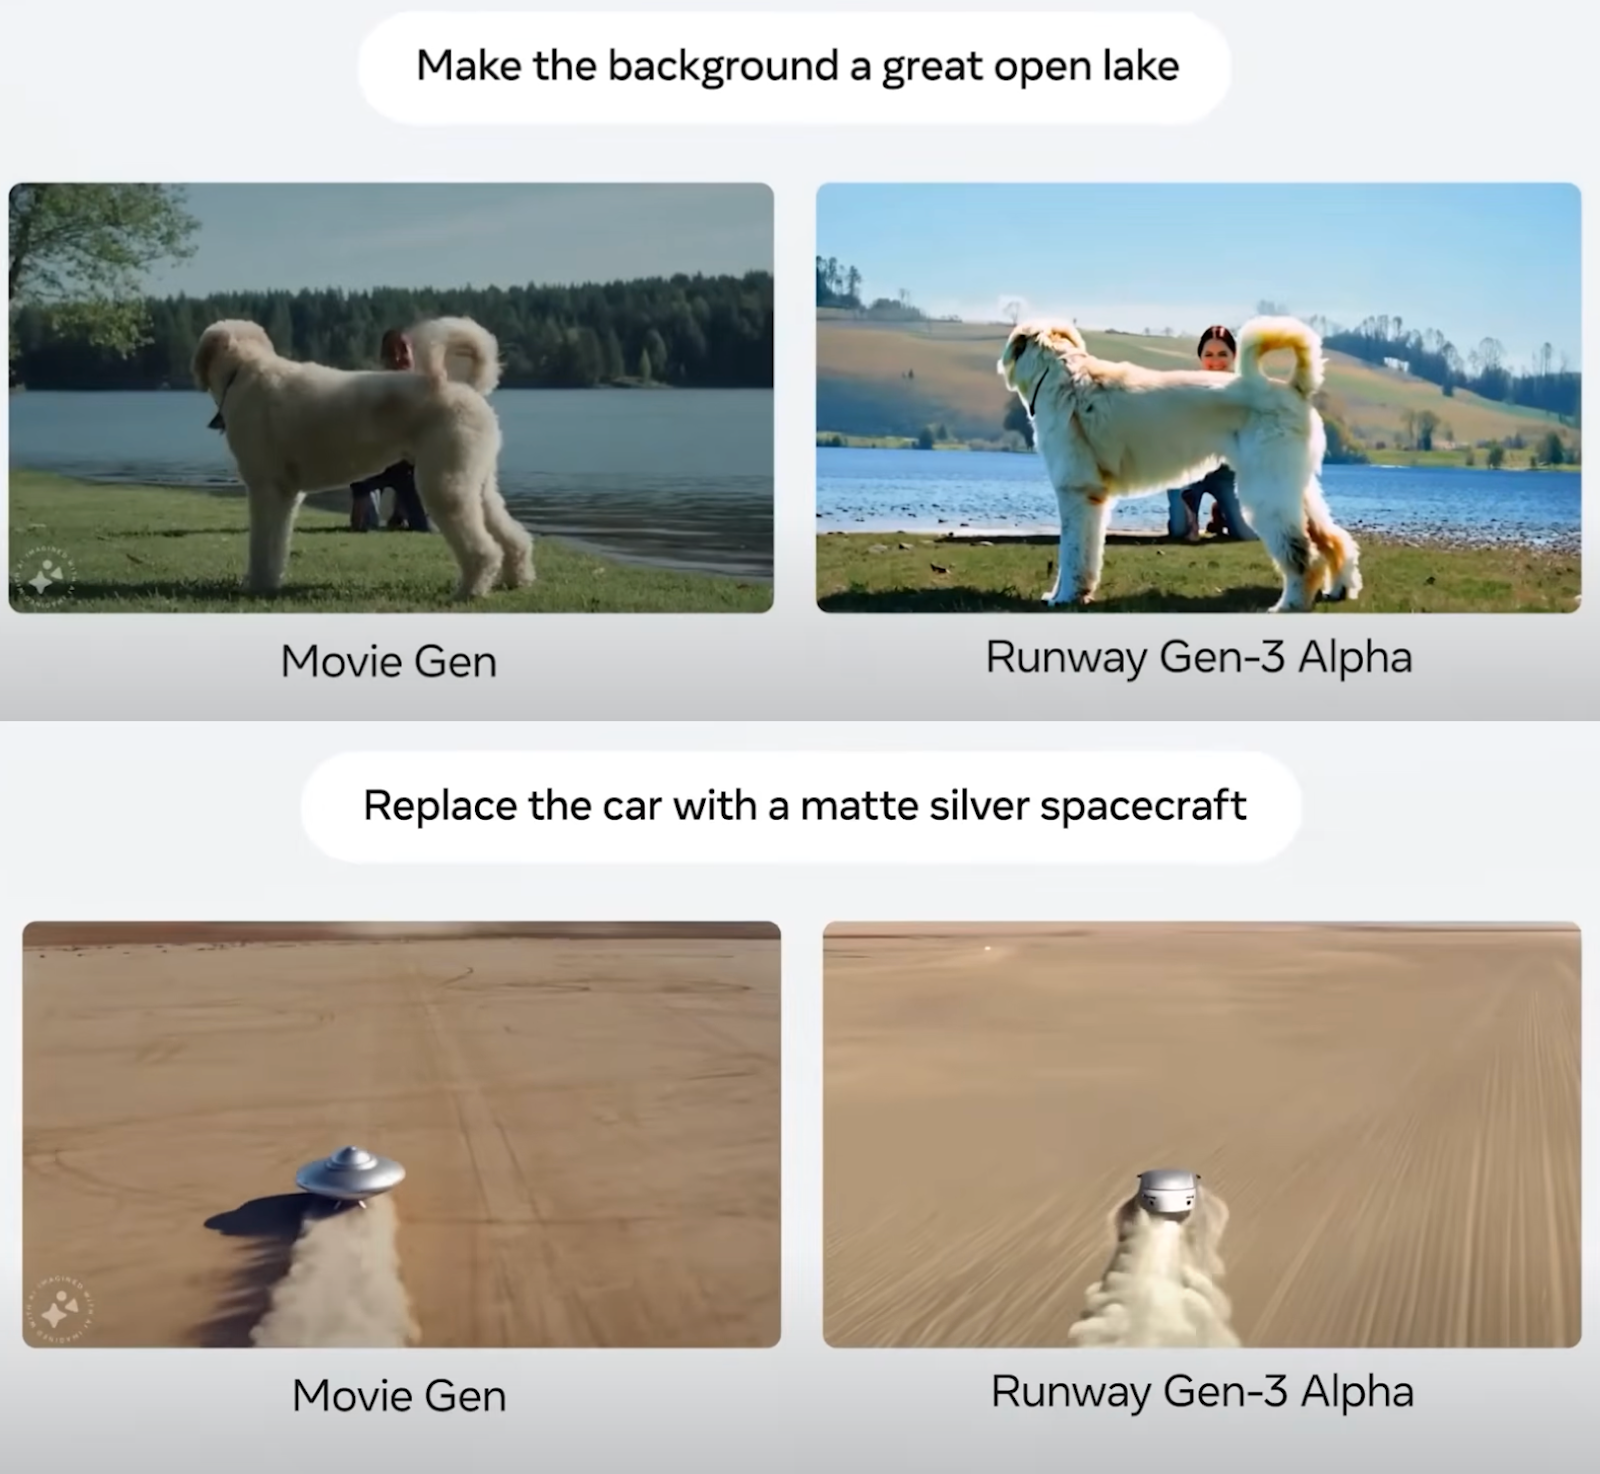
Fonte: articolo di ricerca su Movie Gen
In generale, sembra che Meta Movie Gen abbia alzato l’asticella e fissato un nuovo standard per i modelli testo-in-video. La procedura di valutazione illustrata nel paper appare equa ma, ovviamente, è difficile saperlo con certezza finché questi modelli non saranno pubblicamente disponibili e terze parti neutrali potranno confrontarli.
Sebbene Meta Movie Gen sia eccellente nella generazione di media, ci sono ancora aree da migliorare.
Il modello a volte fatica con scene complesse che coinvolgono geometrie intricate, manipolazione di oggetti e simulazioni fisiche realistiche. Ad esempio, generare interazioni convincenti tra oggetti, rappresentare accuratamente trasformazioni di stato (come fusione o frantumazione) e simulare realisticamente gli effetti di gravità o collisioni può ancora rappresentare una sfida per i modelli.
La sincronizzazione audio può essere problematica in alcuni scenari. In particolare, quando si tratta di movimenti visivamente piccoli, occlusi o che richiedono un alto livello di comprensione visiva per generare il suono corrispondente, i modelli possono faticare a ottenere una sincronizzazione perfetta. Esempi di tali sfide includono sincronizzare accuratamente i passi con una persona che cammina, generare suoni appropriati per oggetti parzialmente nascosti alla vista e riconoscere movimenti sottili delle mani su una chitarra per produrre le note corrette.
Inoltre, il modello Movie Gen Audio, nella sua forma attuale, non supporta la generazione di voce.
Video realistici generati dall’AI comportano notevoli rischi e sfide etiche che devono essere considerate. Questi rischi includono la manipolazione della fiducia e la diffusione di disinformazione tramite deepfake, che potrebbero danneggiare reputazioni, disinformare il pubblico e danneggiare le aziende.
Da un lato, potrebbe essere una funzione di Instagram che mi permette di creare un video carino con me protagonista da condividere con gli amici, ma dall’altro, la stessa funzione rende possibile creare un video falso di qualcun altro. Con il migliorare di queste tecnologie, potrebbe diventare impossibile distinguerle dalla realtà.
I contenuti generati dall’AI pongono minacce alla privacy, potenzialmente portando a estorsione, ricatto o cyberbullismo.
Inoltre, questi strumenti di AI potrebbero minare arte e copyright imitando stili artistici unici senza attribuzione. Le soluzioni includono la diffusione della consapevolezza e l’educazione alla media literacy, l’investimento in tecnologie di rilevamento, la definizione di quadri legali ed etici e l’uso di watermarking per l’autenticazione.
Sebbene la generazione video con AI abbia un grande potenziale, richiede una gestione attenta per mantenere fiducia e autenticità.
Meta è stata trasparente con i suoi sviluppi in ambito AI open-sourcizzando i modelli Llama. Tuttavia, per motivi di sicurezza, i modelli Meta Movie Gen non verranno ancora rilasciati. Secondo il loro articolo, sono necessari ulteriori miglioramenti e considerazioni di sicurezza prima del deployment.
In questo post abbiamo presentato i modelli Movie Gen di Meta, una suite di modelli di AI per generare ed editare video usando prompt testuali.
Abbiamo esplorato i quattro modelli distinti, le loro capacità e come funzionano. Attraverso un’analisi comparativa, abbiamo mostrato come Meta Movie Gen si posiziona rispetto ad altri strumenti di generazione video con AI.
Pur avendo fissato un nuovo punto di riferimento nel campo, il potenziale uso improprio della tecnologia solleva preoccupazioni significative. Meta ha riconosciuto questi rischi e sta adottando un approccio cauto al rilascio dei modelli.
Per saperne di più sull’ecosistema di Meta AI, ti consiglio questi blog:
Impara l'AI con questi corsi!
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



