
वीडियो में पानी के रिफ्लेक्शंस काबिले-तारीफ हैं। मुझे स्लॉथ के चेहरे पर पड़ती परछाइयाँ भी काफी रोचक लगीं। ऐसे छोटे-छोटे विवरण, जब अच्छी तरह से किए जाते हैं, तो अक्सर नज़र नहीं आते। लेकिन जब खराब होते हैं, तो वे चुभते हैं और भ्रम को तोड़ देते हैं।
Movie Gen Audio मॉडल
Movie Gen Audio एक 13-बिलियन-पैरामीटर मॉडल है जो वीडियो की सामग्री से मेल खाते साउंडट्रैक बना सकता है। यह टेक्स्ट प्रॉम्प्ट से भी ऑडियो जनरेट कर सकता है।
यह उच्च-गुणवत्ता, 48kHz ऑडियो बनाता है जो अलग-अलग लंबाई के वीडियो—यहाँ तक कि कई मिनट लंबे—से भी सिंक रहता है। मॉडल एंबिएंट साउंड्स, वीडियो में अनदेखे स्रोतों से मेल खाते ध्वनि प्रभाव, क्रियाओं के साथ सिंक होने वाले साउंड इफेक्ट्स और उपयुक्त बैकग्राउंड म्यूजिक भी बना सकता है।
यहाँ एक उदाहरण है कि कैसे एक वीडियो के लिए निम्न प्रॉम्प्ट से म्यूजिक और साउंड इफेक्ट्स जनरेट किए गए:
“Rustling leaves and snapping twigs, with an orchestral music track.”
ध्यान दें कि म्यूजिक ट्रैक का मूड प्रॉम्प्ट में मौजूद नहीं था। मॉडल वीडियो की सामग्री से मूड समझने में सक्षम था।
Personalized Movie Gen Video मॉडल
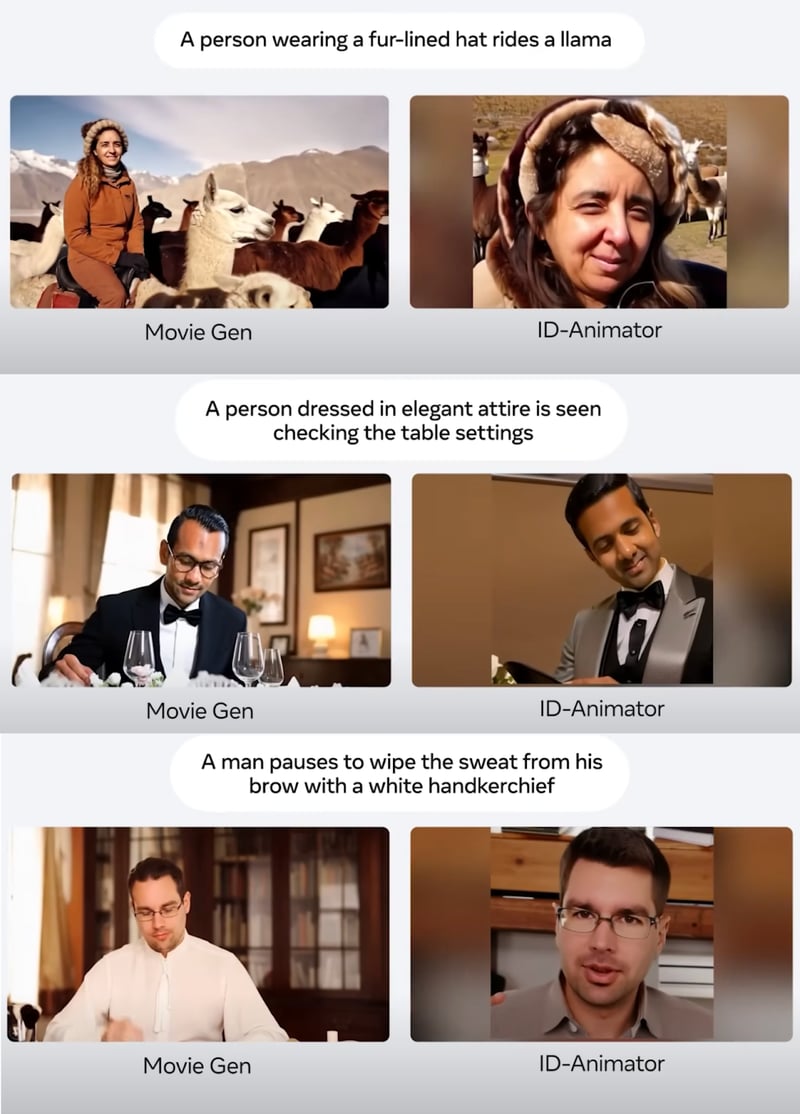
Movie Gen Video मॉडल किसी चुने हुए व्यक्ति की टेक्स्ट विवरण और उसकी एक तस्वीर के आधार पर वीडियो बना सकता है। वीडियो में व्यक्ति की पहचान बरकरार रहती है जबकि वह टेक्स्ट प्रॉम्प्ट का अनुसरण करता है।
निम्न उदाहरण उस व्यक्ति की सेल्फी को इस प्रॉम्प्ट के साथ जोड़कर बनाया गया है:
“A woman DJ spins records on a rooftop in LA. She is wearing a pink jacket and giant headphones. There is a cheetah next to the woman. The background is a cityscape.”
मेरी राय में, यह मॉडल उनका नगीना है क्योंकि यदि इसे उनके अन्य उत्पादों—जैसे Instagram—में शामिल किया जाए तो इसकी जबरदस्त संभावनाएँ हैं। कल्पना कीजिए, उपयोगकर्ता केवल एक तस्वीर और एक टेक्स्ट प्रॉम्प्ट से खुद को अलग-अलग परिदृश्यों में दिखाते वीडियो बना सकें। इससे रचनात्मक और आकर्षक सामग्री में उछाल आ सकता है।
Movie Gen Edit मॉडल
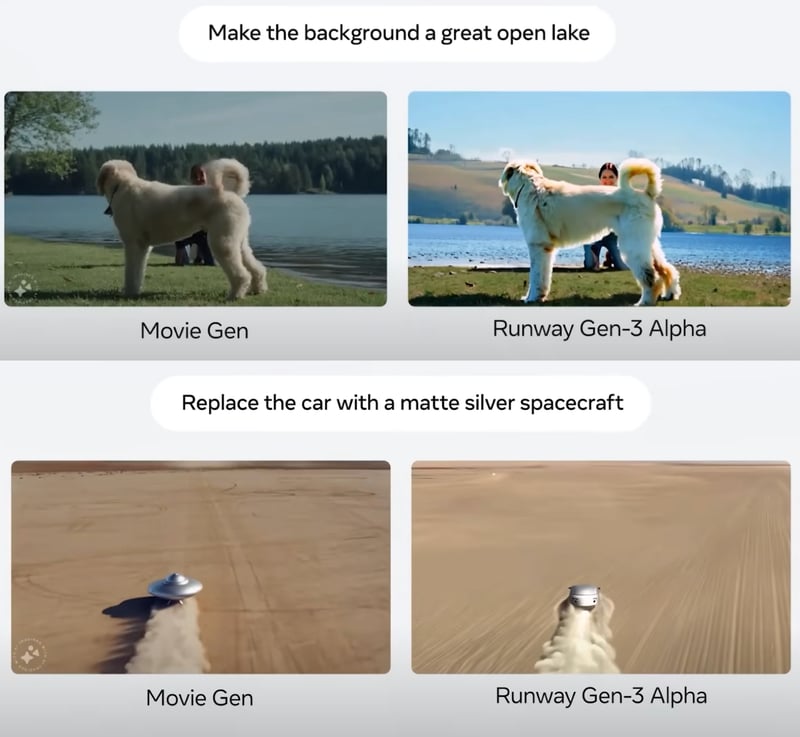
Movie Gen Edit मॉडल हमें केवल टेक्स्ट निर्देशों का उपयोग करके वास्तविक और काल्पनिक वीडियो में विस्तृत और रचनात्मक बदलाव आसानी से करने देता है।
यह मॉडल विभिन्न उद्योगों में वीडियो एडिटिंग वर्कफ़्लो को बदलने की क्षमता रखता है। टेक्स्ट-आधारित एडिटिंग निर्देशों को सटीक रूप से समझने और लागू करने की इसकी क्षमता संपादन प्रक्रिया को तेज़, अधिक कुशल और व्यापक उपयोगकर्ता समूह के लिए सुलभ बना सकती है। यह तकनीक फिल्म निर्माताओं, कंटेंट क्रिएटर्स, शिक्षकों और किसी भी ऐसे व्यक्ति के लिए लाभदायक हो सकती है जो वीडियो सामग्री के साथ काम करता है।
Movie Gen Video कैसे काम करता है?
Movie Gen Video मॉडल के प्रशिक्षण में कई प्रमुख घटक शामिल थे: डेटा संग्रह और तैयारी, स्वयं प्रशिक्षण प्रक्रिया, गुणवत्ता बढ़ाने के लिए फाइन-ट्यूनिंग, और उच्च-रेज़ोल्यूशन आउटपुट पाने के लिए उपयोग की गई अपसैंपलिंग तकनीकें।
डेटा और प्री-प्रोसेसिंग
Movie Gen Video मॉडल को सैकड़ों मिलियन वीडियो-टेक्स्ट पेयर्स और एक बिलियन से अधिक इमेज-टेक्स्ट पेयर्स वाले विशाल डेटासेट पर प्रशिक्षित किया गया।
डेटासेट के प्रत्येक वीडियो को एक सख्त क्यूरेशन प्रक्रिया से गुजारा जाता है, जिसमें विज़ुअल गुणवत्ता, मोशन विशेषताएँ और सामग्री प्रासंगिकता के लिए फ़िल्टरिंग शामिल है। फ़िल्टरिंग का उद्देश्य गैर-तुच्छ मोशन, सिंगल-शॉट कैमरा वर्क और विविध अवधारणाओं—जिनमें से काफी हिस्सा मनुष्यों को दर्शाता है—वाले वीडियो चुनना है।
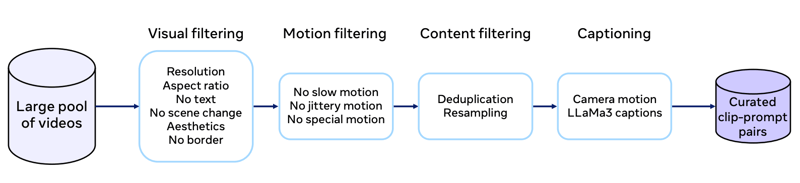
स्रोत: Movie Gen रिसर्च पेपर
उच्च-गुणवत्ता वाले कैप्शन मॉडल को प्रभावी ढंग से प्रशिक्षित करने के लिए बहुत महत्वपूर्ण हैं। Movie Gen Video LLaMa3-Video मॉडल का उपयोग कर विस्तृत कैप्शन बनाता है जो वीडियो सामग्री का सटीक वर्णन करते हैं। ये कैप्शन केवल ऑब्जेक्ट लेबलिंग से आगे बढ़कर क्रियाओं, कैमरा मूवमेंट और यहाँ तक कि लाइटिंग की जानकारी भी शामिल करते हैं। यह समृद्ध टेक्स्टुअल जानकारी मॉडल को विज़ुअल स्टोरीटेलिंग की अधिक सूक्ष्म समझ सीखने में मदद करती है।
ट्रेनिंग प्रक्रिया
Movie Gen Video के प्रशिक्षण को दक्षता और स्केलेबिलिटी बढ़ाने के लिए कई चरणों में बाँटा गया है।
सबसे पहले मॉडल को लोअर-रेज़ोल्यूशन इमेज का उपयोग करके टेक्स्ट-टू-इमेज कार्य पर प्रशिक्षित किया जाता है। यह “वॉर्म-अप” चरण मॉडल को वीडियो जनरेशन जैसे अधिक जटिल कार्य से पहले बुनियादी विज़ुअल अवधारणाएँ सीखने देता है।
इसके बाद मॉडल को टेक्स्ट-टू-इमेज और टेक्स्ट-टू-वीडियो दोनों कार्यों पर संयुक्त रूप से प्रशिक्षित किया जाता है, और इनपुट डेटा के रेज़ोल्यूशन को क्रमिक रूप से बढ़ाया जाता है। यह संयुक्त प्रशिक्षण दृष्टिकोण मॉडल को इमेज-टेक्स्ट डेटासेट्स की प्रचुरता और विविधता का लाभ उठाने में मदद करता है, साथ ही वीडियो जनरेशन की जटिलताएँ भी सिखाता है।
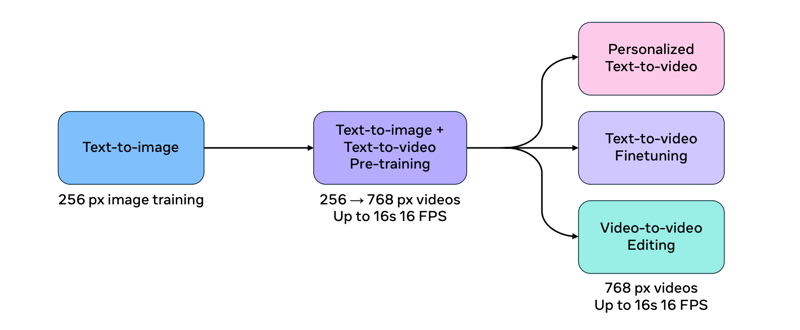
स्रोत: Movie Gen रिसर्च पेपर
वीडियो डेटा की कम्प्यूटेशनल मांगों को संभालने के लिए, Movie Gen Video समय के साथ वीडियो को कंप्रेस और डिकंप्रेस करने हेतु Temporal Autoencoder (TAE) मॉडल का उपयोग करता है। यह कंप्यूटर पर फ़ाइलों को ज़िप और अनज़िप करने के समान है, जिससे मॉडल वीडियो डेटा के अधिक प्रबंधनीय प्रतिनिधित्व के साथ काम कर पाता है।
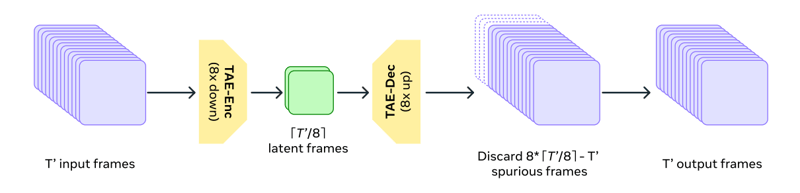
स्रोत: Movie Gen रिसर्च पेपर
Movie Gen Video एक प्रशिक्षण उद्देश्य Flow Matching का उपयोग करता है। अंतिम वीडियो को सीधे जनरेट करने के बजाय, फ्लो मैचिंग मॉडल को रैंडम नॉइज़ के सैंपल को चरण-दर-चरण इच्छित वीडियो आउटपुट में धीरे-धीरे बदलने के लिए मार्गदर्शन करता है।
Flow Matching में सैंपल्स की प्रत्यक्ष भविष्यवाणी करने के बजाय लैटेंट स्पेस में सैंपल्स की वेलोसिटी की भविष्यवाणी शामिल होती है। यह तरीका पारंपरिक डिफ्यूज़न-आधारित विधियों की तुलना में अधिक कुशल और बेहतर प्रदर्शन वाला है।
फाइन-ट्यूनिंग
जेनरेटेड वीडियो की गुणवत्ता और एस्थेटिक्स में सुधार के लिए, मॉडल को उच्च-गुणवत्ता वाले कैप्शन के साथ मैन्युअली क्यूरेट किए गए छोटे सेट के वीडियो पर सुपरवाइज़्ड फाइन-ट्यूनिंग से गुजारा जाता है। यह ठीक वैसा है जैसे कोई कलाकार विशेषज्ञ मार्गदर्शन के माध्यम से अपनी तकनीक को निखारता है, जिससे अधिक आकर्षक और यथार्थपरक वीडियो आउटपुट मिलते हैं।
अंतिम Movie Gen Video मॉडल अलग-अलग डेटासेट्स, हाइपरपैरामीटर्स और प्री-ट्रेनिंग चेकपॉइंट्स के साथ प्रशिक्षित कई मॉडलों का एवरेज लेकर बनाया जाता है। यह तकनीक विभिन्न मॉडलों की ताकतों को जोड़ने में मदद करती है, जिससे अधिक मज़बूत और भरोसेमंद प्रदर्शन मिलता है।
अपसैंपलिंग
मॉडल 768 पिक्सेल के रेज़ोल्यूशन पर वीडियो बनाता है और अपसैंपलिंग का उपयोग कर रेज़ोल्यूशन को फुल HD 1080p में बदलता है, जिससे वीडियो अधिक शार्प और दृष्टिगत रूप से आकर्षक बनते हैं। यह तरीका आम है क्योंकि यह कम्प्यूटेशनली कुशल समाधान देता है—बेस मॉडल कम टोकन प्रोसेस कर सकता है और फिर भी हाई-रेज़ोल्यूशन आउटपुट दे सकता है।
Spatial Upsampler वीडियो-टू-वीडियो जनरेशन मॉडल के रूप में कार्य करता है। यह लोअर-रेज़ोल्यूशन वीडियो को इनपुट के रूप में लेता है, बाइलीनियर इंटरपोलेशन का उपयोग कर उसे टार्गेट रेज़ोल्यूशन तक अपसैंपल करता है, और फिर फ्रेम-वाइज़ Variational Autoencoder (VAE) का उपयोग करके उसे लैटेंट स्पेस में एन्कोड करता है।
इसके बाद एक लैटेंट स्पेस मॉडल, लोअर-रेज़ोल्यूशन वीडियो के एन्कोडेड लैटेंट्स पर कंडीशन होकर HD वीडियो के लैटेंट्स जनरेट करता है। अंत में, VAE डिकोडर परिणामी HD वीडियो लैटेंट्स को पिक्सेल स्पेस में बदलता है और अंतिम हाई-रेज़ोल्यूशन आउटपुट बनाता है।
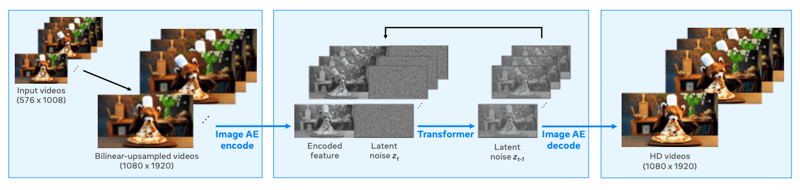
स्रोत: Movie Gen रिसर्च पेपर
Movie Gen मॉडल का मूल्यांकन
टेक्स्ट-टू-वीडियो मॉडल का मूल्यांकन टेक्स्ट-टू-इमेज मॉडल से अधिक चुनौतीपूर्ण है क्योंकि इसमें टेम्पोरल डायमेंशन जुड़ जाता है। मेटा टीम ने मॉडल को परखने के लिए तीन मुख्य मीट्रिक इस्तेमाल किए:
- प्रॉम्प्ट के साथ एलाइनमेंट
- गुणवत्ता और स्थिरता
- यथार्थता और एस्थेटिक्स
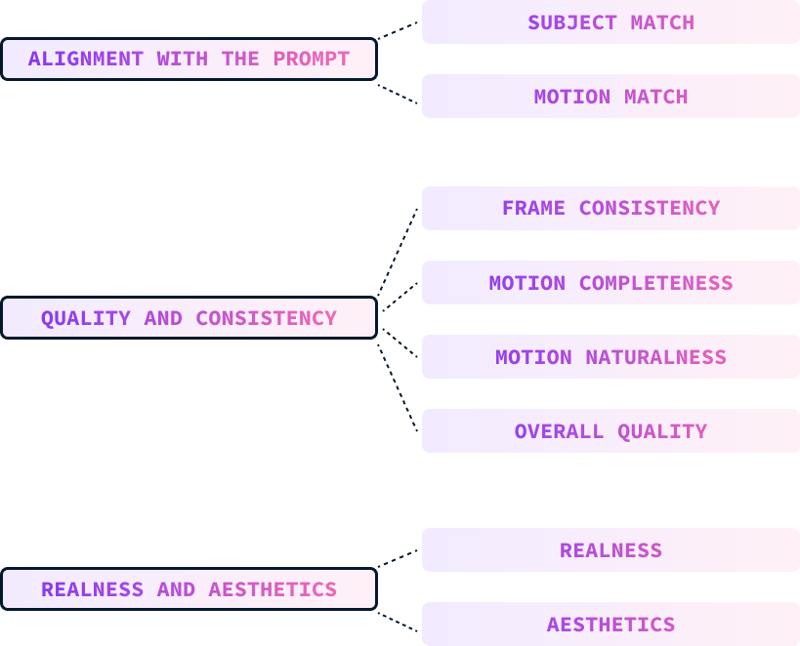
इन पैरामीटर्स का मूल्यांकन मनुष्य मैन्युअली करते हैं, जो इन्हीं मानकों के अनुसार वीडियो को ग्रेड देते हैं।
प्रॉम्प्ट के साथ एलाइनमेंट
प्रॉम्प्ट एलाइनमेंट मापता है कि जेनरेटेड वीडियो इनपुट टेक्स्ट प्रॉम्प्ट से कितनी अच्छी तरह मेल खाता है, जिसमें विषय, मोशन, बैकग्राउंड और अन्य विवरणों के वर्णन शामिल हैं। इसे आगे बाँटा जाता है:
- सब्जेक्ट मैच: विषय की उपस्थिति, बैकग्राउंड, लाइटिंग और स्टाइल के एलाइनमेंट पर केंद्रित।
- मोशन मैच: मोशन-संबंधी विवरणों के एलाइनमेंट का आकलन।
गुणवत्ता और स्थिरता
जेनरेटेड वीडियो की गुणवत्ता और स्थिरता का मूल्यांकन टेक्स्ट प्रॉम्प्ट से स्वतंत्र रूप से किया जाता है। इसे निम्न भागों में बाँटा गया है:
- फ्रेम स्थिरता: ऑब्जेक्ट की उपस्थिति, लाइटिंग और बैकग्राउंड में फ्रेम्स के बीच असंगतियाँ या आर्टिफैक्ट्स की जाँच।
- मोशन पूर्णता: वीडियो में पर्याप्त मात्रा में मोशन है या नहीं, खासकर असामान्य विषयों या गतिविधियों के लिए।
- मोशन नैचुरलनेस: यथार्थता और स्वाभाविकता का आकलन—जैसे अंगों की गति, हाव-भाव, और भौतिकी का पालन।
- समग्र गुणवत्ता: उपरोक्त तीन उप-धुरियों के संतुलन पर आधारित समग्र निर्णय।
यथार्थता और एस्थेटिक्स
मूल्यांकनकर्ताओं से मॉडल की फोटो-यथार्थपरक और सौंदर्यपूर्ण रूप से आकर्षक वीडियो बनाने की क्षमता को रेट करने को कहा गया। इस मानदंड को निम्न भागों में बाँटा गया है:
- यथार्थता: वीडियो वास्तविक वीडियो जैसा कितना दिखता है, या काल्पनिक प्रॉम्प्ट्स के लिए, वास्तविक आर्ट स्टाइल की कितनी अच्छी नकल करता है।
- एस्थेटिक्स: सामग्री, लाइटिंग, रंग और कैमरा इफेक्ट्स जैसे कारकों के आधार पर विज़ुअल अपील का आकलन।
मूल्यांकन बेंचमार्क
बेंचमार्क डेटा को वीडियो जेनरेशन का समग्र मूल्यांकन करने के लिए डिज़ाइन किया गया था। इसमें 1,000 प्रॉम्प्ट शामिल हैं जो मानव गतिविधि, जानवर, प्रकृति, भौतिकी और असामान्य विषयों या गतिविधियों जैसे विभिन्न परीक्षण पहलुओं को कवर करते हैं।
उनका बेंचमार्क पूर्ववर्ती अध्ययनों में उपयोग किए गए बेंचमार्क्स से तीन गुना से भी बड़ा है। प्रत्येक प्रॉम्प्ट को मोशन स्तर (उच्च, मध्यम, निम्न) के टैग के साथ एनोटेट किया गया है ताकि अलग-अलग मोशन तीव्रताओं में जेनरेशन गुणवत्ता का आकलन किया जा सके।
मूल्यांकन पूरे प्रॉम्प्ट सेट का उपयोग करता है और विशिष्ट परीक्षण मीट्रिक को देखता है, विशेष रूप से इस पर ध्यान केंद्रित करते हुए कि मॉडल असामान्य विषयों और मोशन को कितनी अच्छी तरह संभालते हैं, ताकि उनकी सामान्यीकरण क्षमता को परखा जा सके।
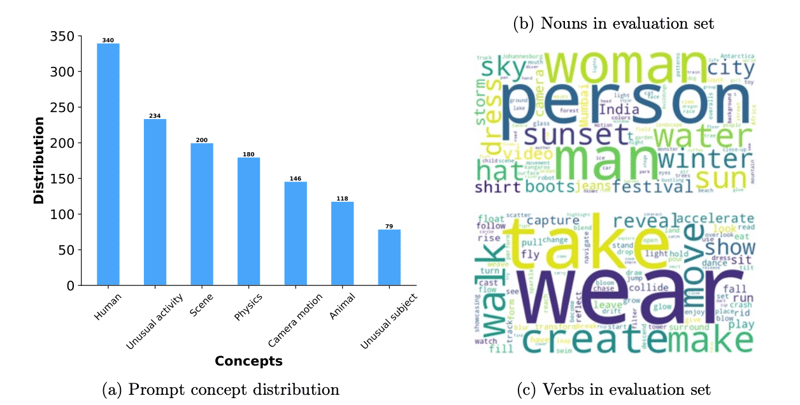
निम्न आरेख मूल्यांकन में उपयोग किए गए प्रॉम्प्ट्स का ब्रेकडाउन दिखाता है। बाईं ओर, प्रॉम्प्ट्स की अवधारणाओं का वितरण दिया गया है। दाईं ओर, प्रॉम्प्ट्स में उपयोग किए गए सामान्य संज्ञा और क्रियाएँ दिखाई गई हैं (शब्द जितना बड़ा, उतनी अधिक बार उसका उपयोग):
स्रोत: Movie Gen रिसर्च पेपर
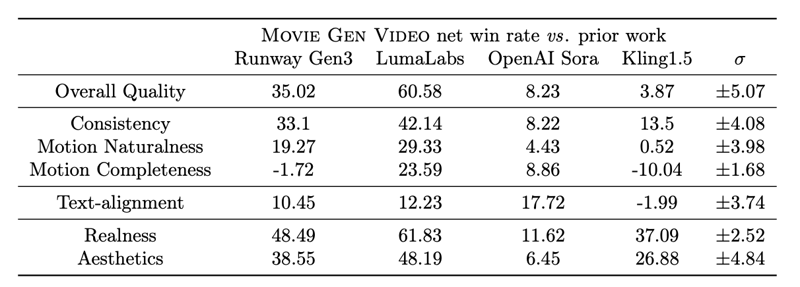
नीचे दी गई तालिका विभिन्न मॉडलों द्वारा तैयार किए गए वीडियो के मानवीय मूल्यांकन के परिणाम कई मानदंडों पर दिखाती है। संख्याएँ नेट विन रेट दर्शाती हैं, जिनकी गणना (विन % - लॉस %) के रूप में होती है। यह -100 (पूर्ण हार) से 100 (पूर्ण जीत) तक होता है, जहाँ 0 बराबरी को इंगित करता है।
स्रोत: Movie Gen रिसर्च पेपर
Meta Movie Gen बनाम Sora बनाम Runway Gen 3
उनके प्रयोगों के अनुसार, Movie Gen Video टेक्स्ट-टू-वीडियो जनरेशन में मजबूत प्रदर्शन करता है और मानव मूल्यांकन (MovieGen Video Bench) के आधार पर Runway Gen3 और LumaLabs जैसे कई मौजूदा मॉडलों—जिनमें कमर्शियल सिस्टम भी शामिल हैं—से बेहतर साबित होता है। विशेष रूप से, Movie Gen Video में निम्न पहलुओं में महत्वपूर्ण बढ़त दिखती है:
- समग्र गुणवत्ता: मूल्यांकनकर्ताओं ने Movie Gen के आउटपुट्स को लगातार उच्च समग्र गुणवत्ता वाला रेट किया, खासकर विज़ुअल फिडेलिटी, मोशन नैचुरलनेस और टेक्स्ट प्रॉम्प्ट्स के साथ एलाइनमेंट के संदर्भ में।
- मोशन नैचुरलनेस और स्थिरता: Movie Gen प्राकृतिक और सुसंगत मोशन वाले वीडियो जनरेट करने में उल्लेखनीय बढ़त दिखाता है, और इन पहलुओं में Runway Gen3 तथा OpenAI के Sora से बेहतर प्रदर्शन करता है। यह ताकत संभवतः फ्लो मैचिंग प्रशिक्षण उद्देश्य और प्रशिक्षण के दौरान वीडियो डेटा के व्यापक उपयोग के माध्यम से वास्तविक विश्व भौतिकी को सीखने और सिम्युलेट करने की मॉडल की क्षमता से आती है।
- यथार्थता और एस्थेटिक्स: Movie Gen Runway Gen3, LumaLabs और Kling1.5 की तुलना में अधिक यथार्थता और सौंदर्य अपील वाले वीडियो जनरेट करने में भी उत्कृष्ट है।
जहाँ MovieGen सामान्यतः अन्य मॉडलों से बेहतर है, वहीं Kling1.5 कभी-कभी अधिक बड़े मोशन परिमाण वाले वीडियो बनाता है, हालाँकि इसके साथ विकृतियाँ और असंगतियाँ भी आती हैं। यह मोशन पूर्णता और विज़ुअल गुणवत्ता के बीच के ट्रेड-ऑफ को रेखांकित करता है, जहाँ Movie Gen Video केवल अधिकतम मूवमेंट परिमाण बढ़ाने के बजाय यथार्थपरक और सुसंगत मोशन को प्राथमिकता देता है।
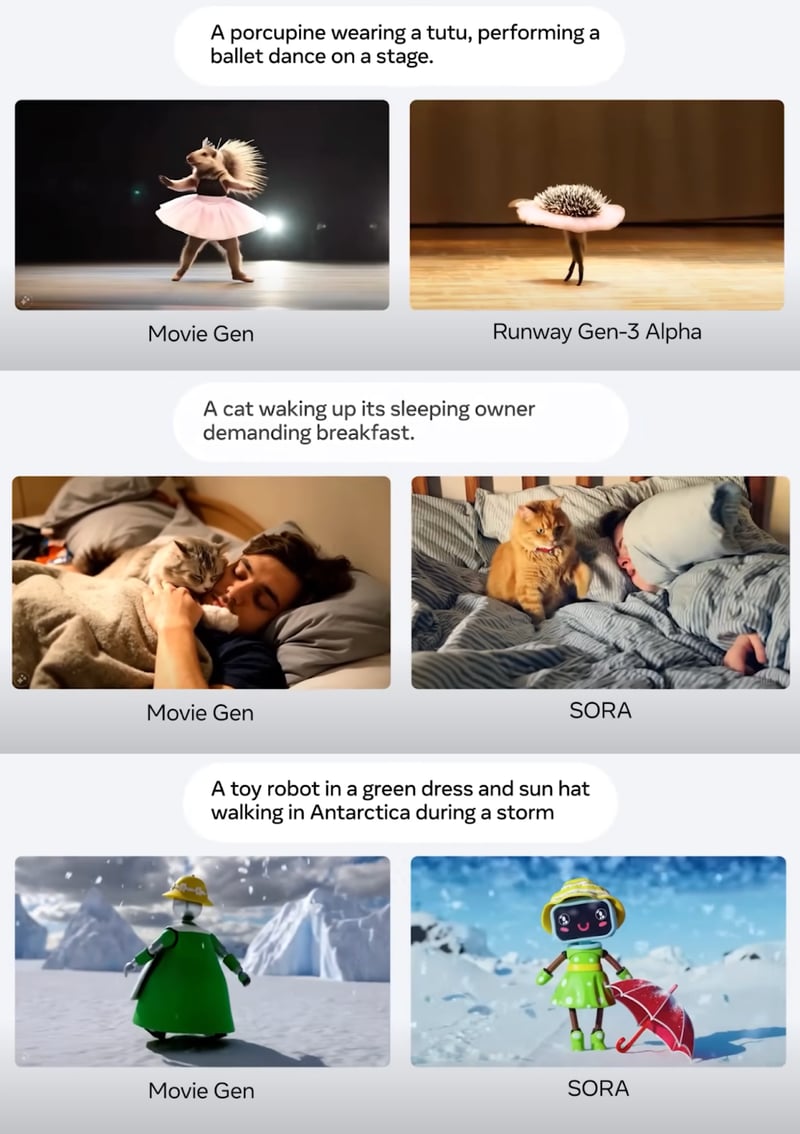
नीचे Meta Connect 2024 प्रेजेंटेशन से कुछ स्क्रीनशॉट्स हैं, जो वीडियो जनरेशन प्रॉम्प्ट्स के कुछ तुलना उदाहरण दिखाते हैं:
स्रोत: Movie Gen रिसर्च पेपर
यहाँ फोटो का उपयोग कर पर्सनलाइज़्ड वीडियो बनाने के कुछ तुलना उदाहरण दिए गए हैं:
स्रोत: Movie Gen रिसर्च पेपर
अंत में, नीचे दिए गए स्क्रीनशॉट्स वीडियो एडिटिंग के तुलना उदाहरण दिखाते हैं:
स्रोत: Movie Gen रिसर्च पेपर
कुल मिलाकर, लगता है कि मेटा मूवी जेन ने मानक को आगे बढ़ाया है और टेक्स्ट-टू-वीडियो मॉडलों में नया बेंचमार्क स्थापित किया है। पेपर में रेखांकित मूल्यांकन प्रक्रिया निष्पक्ष प्रतीत होती है, लेकिन बेशक, इसे पब्लिक रूप से उपलब्ध कराए जाने और तटस्थ तृतीय पक्षों द्वारा तुलना किए जाने तक निश्चित रूप से कहना कठिन है।
मॉडल की सीमाएँ
जबकि मेटा मूवी जेन मीडिया जनरेशन में बेहतरीन दिखता है, फिर भी सुधार की गुंजाइश है।
मॉडल कभी-कभी जटिल दृश्यों में जूझता है, जिनमें पेचीदा ज्योमेट्री, ऑब्जेक्ट मैनीपुलेशन और यथार्थपरक भौतिकी सिमुलेशन शामिल हैं। उदाहरण के लिए, ऑब्जेक्ट्स के बीच विश्वसनीय इंटरेक्शन बनाना, स्टेट ट्रांसफॉर्मेशन (जैसे पिघलना या टूटना) को सटीकता से दर्शाना, और गुरुत्वाकर्षण या टक्करों के प्रभावों का यथार्थपरक सिमुलेशन करना अभी भी चुनौतीपूर्ण हो सकता है।
कुछ स्थितियों में ऑडियो सिंक्रोनाइज़ेशन समस्या बन सकता है। विशेष रूप से, जब ऐसे मोशन्स से निपटना हो जो दृश्य रूप से छोटे हों, आंशिक रूप से ढके हों, या संबंधित ध्वनि बनाने के लिए उच्च स्तर की विज़ुअल समझ की आवश्यकता हो, तो मॉडल्स के लिए पूर्ण सिंक्रोनाइज़ेशन पाना कठिन हो सकता है। ऐसी चुनौतियों के उदाहरणों में चलते व्यक्ति के कदमों की सही टाइमिंग, आंशिक रूप से छिपी वस्तुओं के उपयुक्त ध्वनि उत्पन्न करना, और गिटार पर सूक्ष्म हाथों की हरकतों को पहचानकर सही संगीत नोट्स बनाना शामिल हैं।
इसके अलावा, वर्तमान डिज़ाइन के अनुसार Movie Gen Audio मॉडल वॉयस जेनरेशन को सपोर्ट नहीं करता।
सुरक्षा विचार और मॉडल रिलीज़
यथार्थपरक AI-जनरेटेड वीडियो महत्वपूर्ण जोखिम और नैतिक चुनौतियाँ लेकर आते हैं। इन जोखिमों में डीपफेक्स के माध्यम से भरोसे में हेरफेर और गलत सूचना का प्रसार शामिल है, जो साख को नुकसान पहुँचा सकते हैं, जनता को गुमराह कर सकते हैं और व्यवसायों को हानि पहुँचा सकते हैं।
एक ओर, यह Instagram की ऐसी सुविधा हो सकती है जो मुझे खुद को दिखाते हुए एक बढ़िया वीडियो बनाने दे जिसे मैं दोस्तों से साझा कर सकूँ, लेकिन दूसरी ओर, वही सुविधा मुझे किसी और का फेक वीडियो बनाने में सक्षम कर देती है। जैसे-जैसे ये तकनीकें बेहतर होती जाएँगी, वास्तविक और नकली में फर्क करना असंभव हो सकता है।
AI-जनित सामग्री गोपनीयता के लिए खतरे पैदा करती है, जो उगाही, ब्लैकमेल या साइबरबुलिंग तक ले जा सकते हैं।
इसके अलावा, ये AI टूल्स बिना श्रेय दिए अनूठी कला शैलियों की नकल कर कला और कॉपीराइट को कमजोर कर सकते हैं। समाधानों में मीडिया साक्षरता पर जागरूकता और शिक्षा फैलाना, डिटेक्शन टेक्नोलॉजी में निवेश, कानूनी और नैतिक ढाँचे स्थापित करना, और प्रमाणीकरण के लिए वॉटरमार्किंग का उपयोग शामिल हैं।
हालाँकि AI वीडियो जनरेशन में बड़ी संभावनाएँ हैं, भरोसा और प्रामाणिकता बनाए रखने के लिए इसे सावधानी से संभालना आवश्यक है।
मेटा ने Llama मॉडलों को ओपन-सोर्स कर अपनी AI प्रगति में पारदर्शिता दिखाई है। फिर भी, सुरक्षा कारणों से, मेटा मूवी जेन मॉडल्स फिलहाल जारी नहीं किए जाएँगे। उनके लेख के अनुसार, इन्हें तैनात करने से पहले कई सुधार और सुरक्षा विचार आवश्यक हैं।
निष्कर्ष
इस ब्लॉग पोस्ट में, हमने मेटा के मूवी जेन मॉडलों—टेक्स्ट प्रॉम्प्ट्स का उपयोग कर वीडियो बनाने और एडिट करने वाले AI मॉडलों के एक सूट—का परिचय दिया।
हमने चारों मॉडलों, उनकी क्षमताओं और उनके काम करने के तरीकों का अन्वेषण किया। तुलनात्मक विश्लेषण के माध्यम से, हमने दिखाया कि मेटा मूवी जेन अन्य AI वीडियो जनरेशन टूल्स के मुकाबले कैसा ठहरता है।
जहाँ मेटा मूवी जेन ने इस क्षेत्र में नया मानक स्थापित किया है, वहीं तकनीक के दुरुपयोग की संभावनाएँ गंभीर चिंताएँ उठाती हैं। मेटा ने इन जोखिमों को स्वीकार किया है और इन मॉडलों को रिलीज़ करने के मामले में सतर्क दृष्टिकोण अपना रहा है।
Meta AI के इकोसिस्टम के बारे में और जानने के लिए, मैं ये ब्लॉग्स सुझाता हूँ:
FAQs
Meta Movie Gen कब रिलीज़ होगा?
मेटा ने मूवी जेन के लिए कोई विशिष्ट रिलीज़ डेट घोषित नहीं की है। फिलहाल, कंपनी अनुसंधान और विकास पर केंद्रित है, ताकि व्यापक रिलीज़ से पहले मॉडल की क्षमताओं में सुधार किया जा सके और संभावित मुद्दों को संबोधित किया जा सके। भले ही आधिकारिक टाइमलाइन नहीं है, मुझे लगता है कि मेटा शुरुआत में मूवी जेन की सुविधाएँ सीधे पूरा मॉडल जारी करने के बजाय Instagram या Facebook जैसे मौजूदा प्लेटफ़ॉर्म में इंटीग्रेट कर सकता है।
Meta Movie Gen कितना लंबा वीडियो बना सकता है?
वर्तमान में, मेटा मूवी जेन 16 सेकंड तक के वीडियो जनरेट कर सकता है। यह सीमा संभवतः लंबे, उच्च-गुणवत्ता वाले वीडियो जनरेट करने की कम्प्यूटेशनल मांगों के कारण है। भविष्य में विकास अधिकतम वीडियो लंबाई बढ़ा सकते हैं।
क्या Meta Movie Gen ओपन-सोर्स होगा?
मेटा ने यह पुष्टि नहीं की है कि मूवी जेन ओपन-सोर्स होगा या नहीं। हालाँकि, उनके कुछ AI मॉडल—जैसे Llama—ओपन-सोर्स किए गए हैं। संभव है कि वे मूवी जेन के कुछ हिस्सों को ओपन-सोर्स करें या व्यापक AI समुदाय द्वारा अनुसंधान और विकास को प्रोत्साहित करने के लिए किसी विशिष्ट लाइसेंस के तहत रिलीज़ करें।
Meta Movie Gen का वीडियो क्वालिटी क्या है?
मेटा मूवी जेन 1080p HD रेज़ोल्यूशन में वीडियो जनरेट करता है, जो विभिन्न अनुप्रयोगों के लिए उपयुक्त उच्च-गुणवत्ता वाला आउटपुट प्रदान करता है।

मेटा ने हाल ही में Meta Movie Gen जारी किया है, जो टेक्स्ट-टू-वीडियो जनरेशन परिदृश्य में एक महत्वपूर्ण और कुछ हद तक अप्रत्याशित घटना है—मेरा नहीं लगता कि वीडियो जनरेशन के मामले में मेटा बहुत लोगों के रडार पर था।
प्रतिस्पर्धी माहौल को देखते हुए, जहां OpenAI जैसी कई हाई-प्रोफाइल कंपनियाँ पहले से Sora जैसे मजबूत मॉडलों पर काम कर रही हैं, मेटा का यह रिलीज़ उल्लेखनीय है।
यह मॉडल विभिन्न कार्यों में अच्छा प्रदर्शन करता है, स्थापित खिलाड़ियों जैसे Runway Gen3, LumaLabs और विशेष रूप से OpenAI के Sora के प्रस्तावों की गुणवत्ता से बेहतर या बराबर परिणाम देता है।
इस ब्लॉग में, मैं कवर करूँगा कि मेटा मूवी जेन क्या है, यह कैसे काम करता है, इसकी क्षमताएँ और सीमाएँ क्या हैं, और इसके उपयोग से जुड़ी सुरक्षा संबंधी बातें।
यदि आप वीडियो जनरेशन क्षेत्र का एक ओवरव्यू चाहते हैं, तो मैं शीर्ष AI वीडियो जेनरेटर पर इस लेख को देखने की सलाह देता हूँ।
Meta Movie Gen क्या है?
मेटा मूवी जेन विभिन्न प्रकार के मीडिया—टेक्स्ट-टू-वीडियो, टेक्स्ट-टू-ऑडियो और टेक्स्ट-टू-इमेज—जनरेट करने के लिए फाउंडेशनल मॉडलों का एक संग्रह है। इसमें चार मॉडल शामिल हैं:
Movie Gen Video मॉडल
Movie Gen Video एक 30-बिलियन-पैरामीटर मॉडल है, जिसे टेक्स्ट विवरणों के आधार पर इमेज और वीडियो बनाने के लिए डिज़ाइन किया गया है। यह मॉडल दिए गए टेक्स्ट प्रॉम्प्ट से मेल खाते हुए 16 सेकंड तक के उच्च-गुणवत्ता वाले वीडियो जनरेट कर सकता है। यह अलग-अलग आकार, रेज़ोल्यूशन और लंबाई में सामग्री बना सकता है।
यहाँ एक प्रॉम्प्ट से जेनरेट किए गए वीडियो का उदाहरण है:
“A sloth with pink sunglasses lays on a donut float in a pool. The sloth is holding a tropical drink. The world is tropical. The sunlight casts a shadow.”