
Curso
Trabajar con Llama 3
2 h
15.4K
Meta ha lanzado recientemente Meta Movie Gen, un movimiento importante y, en parte, inesperado dentro del panorama de la generación de texto a vídeo. No creo que Meta estuviera en el radar de mucha gente en lo que respecta a generación de vídeo.
Dado el entorno competitivo, con varias empresas de primer nivel como OpenAI trabajando ya en modelos potentes como Sora, el lanzamiento de Meta es digno de mención.
El modelo rinde bien en varias tareas y supera o iguala la calidad de las propuestas de actores consolidados como Runway Gen3, LumaLabs y, especialmente, Sora de OpenAI.
En este blog, voy a contarte qué es Meta Movie Gen, cómo funciona, sus capacidades y limitaciones, y las consideraciones de seguridad en torno a su uso.
Si quieres una visión general del campo de la generación de vídeo, te recomiendo este artículo sobre los mejores generadores de vídeo con IA.
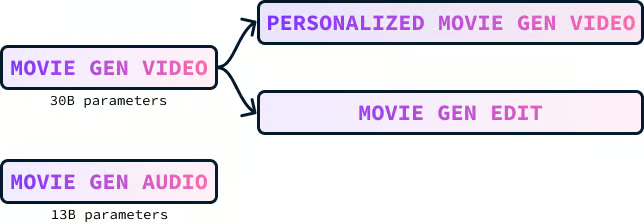
Meta Movie Gen es un conjunto de modelos fundamentales para generar distintos tipos de contenido multimedia, incluidos texto a vídeo, texto a audio y texto a imagen. Consta de cuatro modelos:
Movie Gen Video es un modelo de 30.000 millones de parámetros diseñado para crear imágenes y vídeos a partir de descripciones de texto. Puede generar vídeos de alta calidad de hasta 16 segundos que se ajustan al prompt proporcionado. Produce contenido en distintos tamaños, resoluciones y duraciones.
Aquí tienes un ejemplo de vídeo generado con el prompt:
«Un perezoso con gafas de sol rosas descansa en un flotador con forma de donut en una piscina. El perezoso sostiene una bebida tropical. El entorno es tropical. La luz del sol proyecta una sombra.»
Este modelo puede revolucionar los flujos de trabajo de edición de vídeo en múltiples sectores. Su capacidad para entender y ejecutar instrucciones de edición en texto podría agilizar de forma notable el proceso, haciéndolo más rápido, eficiente y accesible para más gente. Cineastas, creadores de contenido, docentes y cualquier persona que trabaje con vídeo podrían beneficiarse de esta tecnología.
El entrenamiento de Movie Gen Video implicó varios componentes clave: recopilación y preparación de datos, el propio proceso de entrenamiento, ajuste fino para mejorar la calidad y técnicas de aumento de resolución para lograr salidas en alta definición.
Movie Gen Video se entrenó con un conjunto de datos masivo que contiene cientos de millones de pares vídeo-texto y más de mil millones de pares imagen-texto.
Cada vídeo del dataset pasa por un riguroso proceso de curación que filtra por calidad visual, características de movimiento y relevancia del contenido. El filtrado busca vídeos con movimiento no trivial, cámara a un solo plano y una amplia diversidad de conceptos, con una parte importante protagonizada por personas.
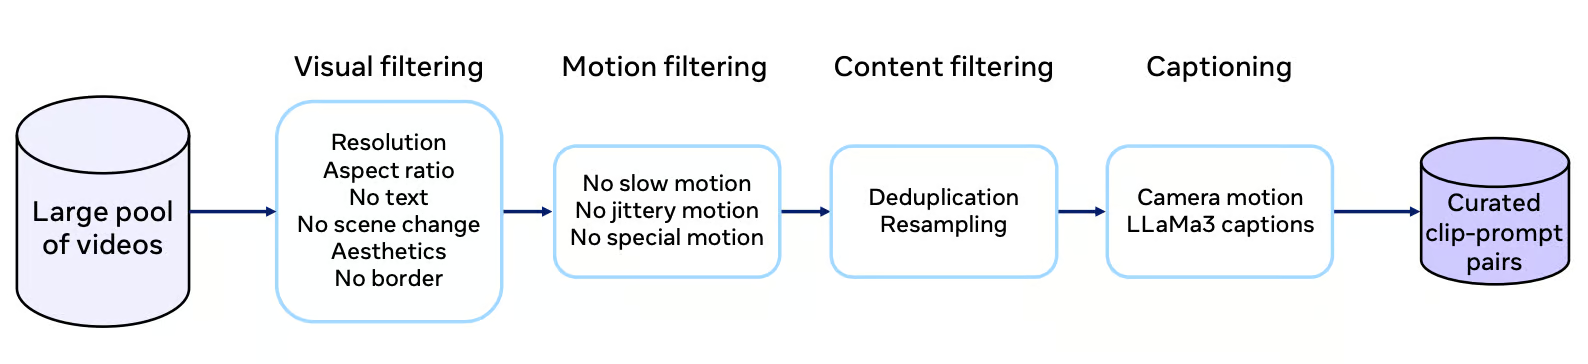
Fuente: artículo de investigación de Movie Gen
Los subtítulos de alta calidad son cruciales para entrenar el modelo de forma eficaz. Movie Gen Video utiliza el modelo LLaMa3-Video para generar descripciones detalladas que reflejan con precisión el contenido del vídeo. Estas descripciones van más allá de etiquetar objetos: incluyen acciones, movimientos de cámara e incluso información de iluminación. Esta riqueza textual ayuda al modelo a aprender una comprensión más matizada de la narrativa visual.
El entrenamiento de Movie Gen Video se divide en varias fases para mejorar la eficiencia y la escalabilidad.
Primero se entrena en la tarea de texto a imagen usando imágenes de baja resolución. Esta fase de «calentamiento» permite aprender conceptos visuales fundamentales antes de abordar la tarea más compleja de generar vídeo.
Después, se entrena conjuntamente en las tareas de texto a imagen y texto a vídeo, aumentando progresivamente la resolución de los datos de entrada. Este enfoque conjunto permite aprovechar la abundancia y diversidad de datasets imagen-texto a la vez que aprende las complejidades de la generación de vídeo.
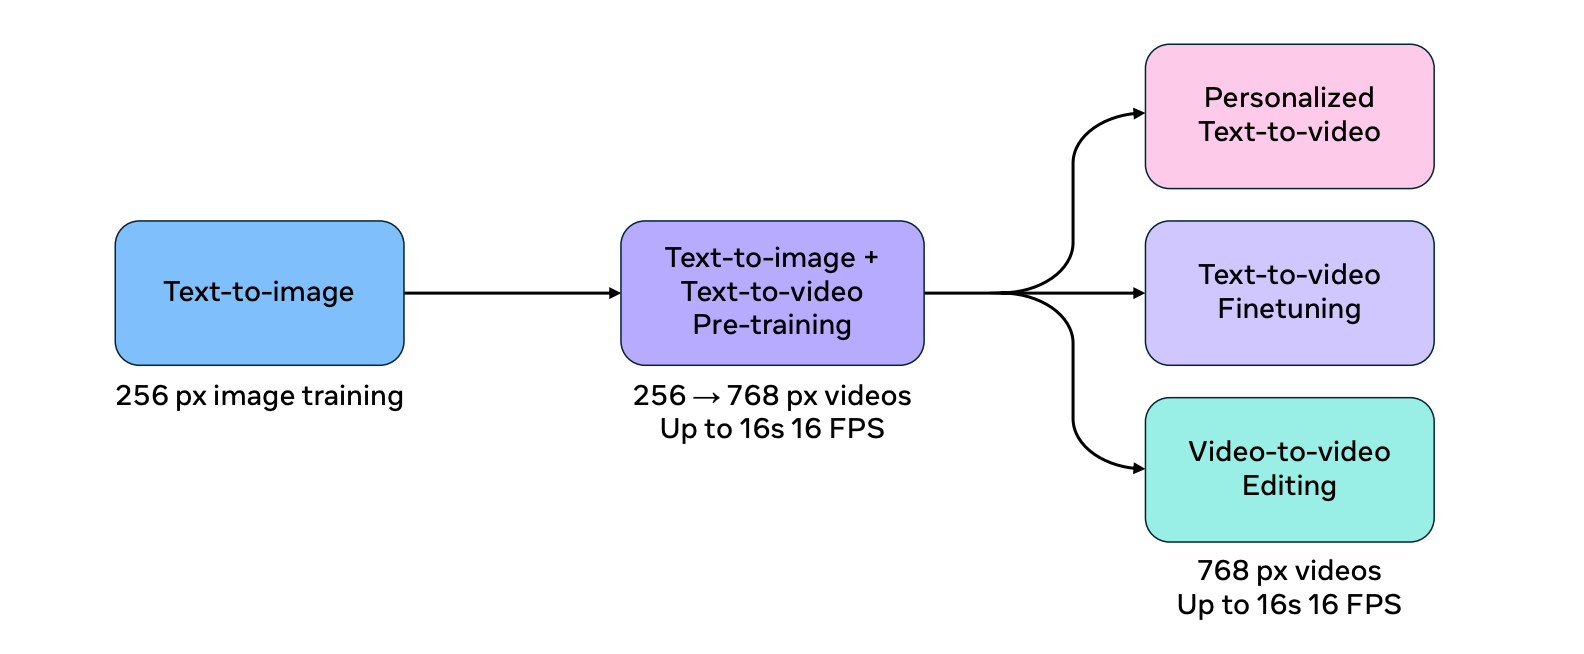
Fuente: artículo de investigación de Movie Gen
Para gestionar las exigencias computacionales del vídeo, Movie Gen Video emplea un modelo Temporal Autoencoder (TAE) para comprimir y descomprimir en el tiempo. Es análogo a comprimir y descomprimir archivos en un ordenador, lo que permite trabajar con una representación más manejable del vídeo.
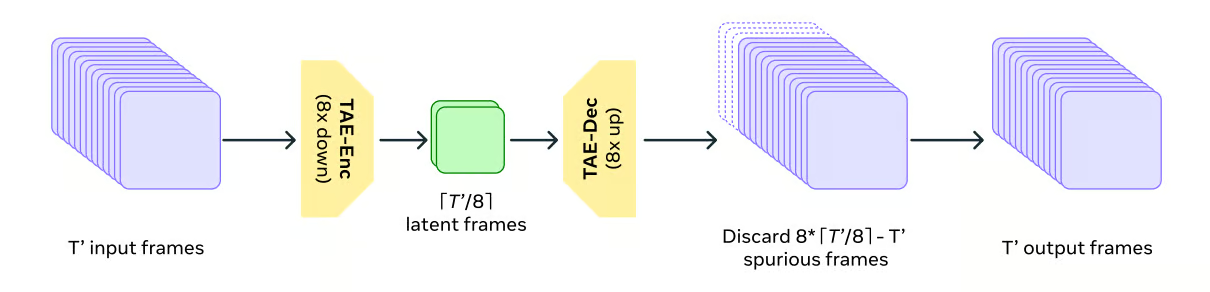
Fuente: artículo de investigación de Movie Gen
Movie Gen Video utiliza un objetivo de entrenamiento llamado Flow Matching. En lugar de generar directamente el vídeo final, este enfoque guía al modelo para transformar de forma gradual una muestra de ruido aleatorio en el resultado deseado, paso a paso.
Flow Matching consiste en predecir la velocidad de las muestras en el espacio latente, en lugar de predecir directamente las propias muestras. Este método es más eficiente y ofrece mejor rendimiento que los enfoques tradicionales basados en difusión.
Para mejorar la calidad y la estética de los vídeos generados, el modelo se somete a ajuste fino supervisado con un conjunto más pequeño de vídeos curados manualmente con subtítulos de alta calidad. Es como si un artista perfeccionara su técnica con orientación experta, logrando resultados más realistas y atractivos.
El modelo final de Movie Gen Video se obtiene promediando varios modelos entrenados con distintos datasets, hiperparámetros y checkpoints de preentrenamiento. Esta técnica combina las fortalezas de cada modelo y aporta un rendimiento más robusto y fiable.
El modelo produce vídeos a una resolución de 768 píxeles y utiliza upsampling para llevar la resolución a Full HD 1080p, logrando vídeos más nítidos y atractivos. Este enfoque es común porque resulta computacionalmente eficiente: el modelo base procesa menos tokens y aun así entrega salidas en alta resolución.
El Spatial Upsampler funciona como un modelo de generación de vídeo a vídeo. Toma como entrada el vídeo de menor resolución, lo remuestrea a la resolución objetivo mediante interpolación bilineal y luego lo codifica en un espacio latente con un Variational Autoencoder (VAE) por fotogramas.
Un modelo en el espacio latente genera después los latentes del vídeo en HD condicionados por los latentes codificados del vídeo de menor resolución. Por último, el decodificador del VAE transforma esos latentes HD de nuevo al espacio de píxeles, produciendo la salida final en alta resolución.
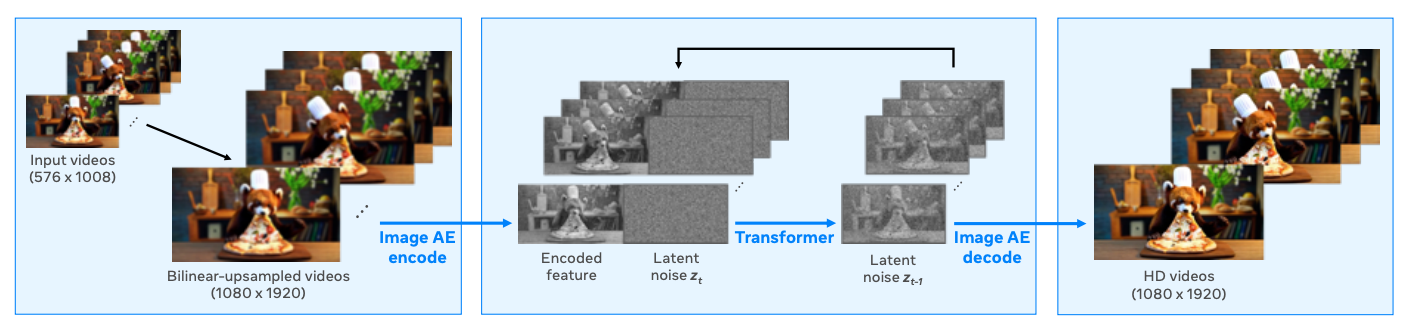
Fuente: artículo de investigación de Movie Gen
Evaluar un modelo de texto a vídeo es más complejo que uno de texto a imagen por la dimensión temporal añadida. El equipo de Meta usó tres medidas principales para evaluar el modelo:
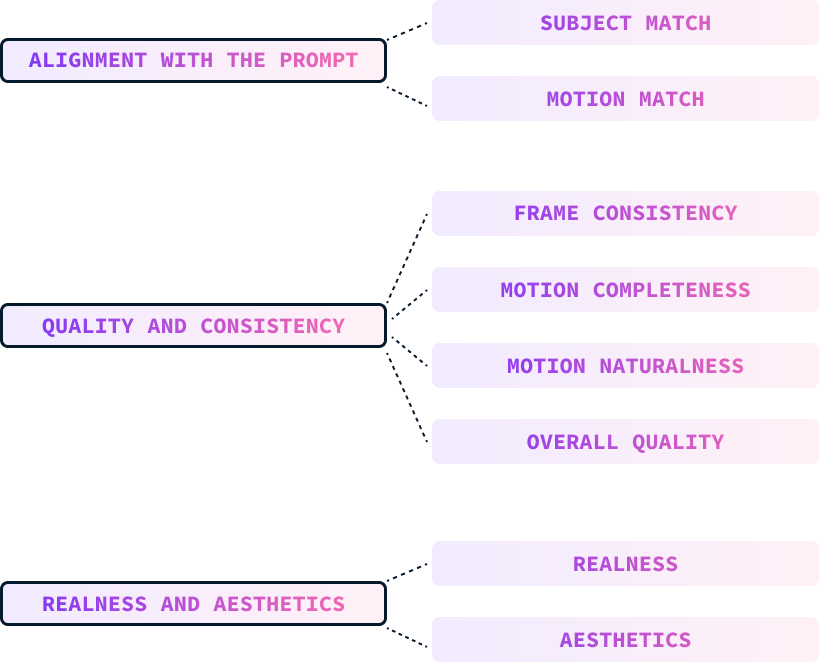
Estos parámetros se evalúan manualmente por personas que puntúan los vídeos según estos criterios.
Mide hasta qué punto el vídeo generado coincide con el prompt de entrada, incluidas las descripciones del sujeto, el movimiento, el fondo y otros detalles. A su vez se desglosa en:
La calidad y la consistencia del vídeo generado se evalúan independientemente del prompt. Este criterio se desglosa en:
Se pidió a los evaluadores que valoraran la capacidad del modelo para producir vídeos fotorrealistas y estéticamente atractivos. Este criterio se divide en:
El conjunto de evaluación se diseñó para medir de forma integral la generación de vídeos. Incluye 1.000 prompts que cubren aspectos como actividad humana, animales, naturaleza, física y sujetos o acciones inusuales.
Su benchmark es más de tres veces mayor que los usados en trabajos previos. Cada prompt se etiqueta con un nivel de movimiento (alto, medio, bajo) para evaluar la calidad de generación en distintas intensidades de movimiento.
La evaluación usa todo el conjunto de prompts y examina métricas específicas, con especial atención a cómo gestionan los modelos sujetos y movimientos inusuales para poner a prueba su capacidad de generalización.
El siguiente diagrama muestra un desglose de los prompts usados en la evaluación. A la izquierda, la distribución de conceptos; a la derecha, los sustantivos y verbos más frecuentes dentro de los prompts (cuanto más grande la palabra, más frecuente):
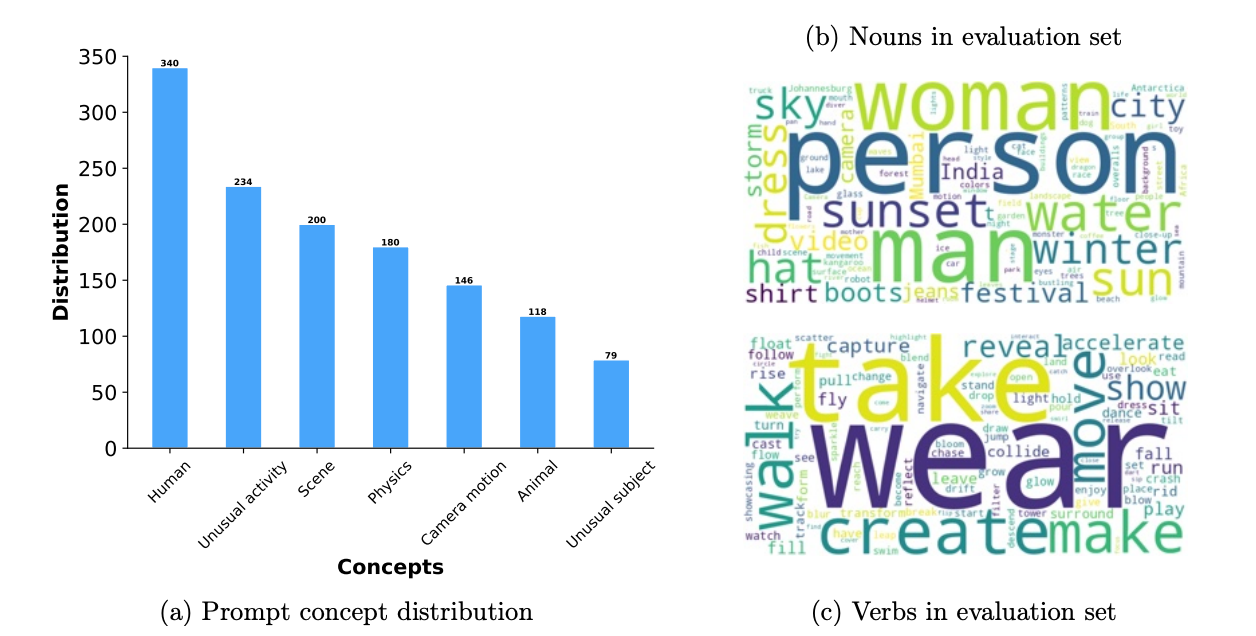
Fuente: artículo de investigación de Movie Gen
La siguiente tabla muestra los resultados de la evaluación humana de los vídeos producidos por distintos modelos en varios criterios. Los números representan tasas netas de victoria calculadas como (Porcentaje de victorias - Porcentaje de derrotas). Van de -100 (derrota total) a 100 (victoria total), con 0 indicando empate.
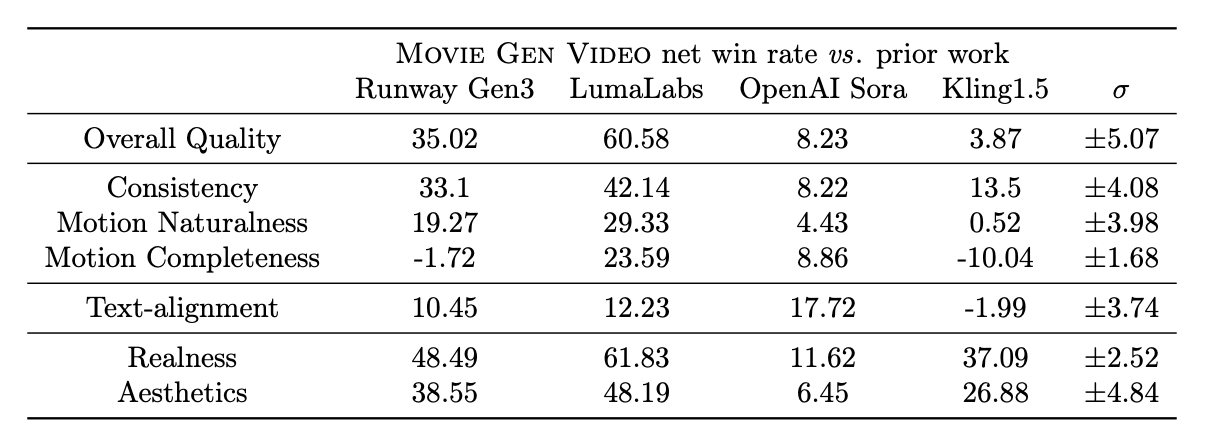
Fuente: artículo de investigación de Movie Gen
Según sus experimentos, Movie Gen Video ofrece un rendimiento sólido en generación de texto a vídeo y supera a varios modelos existentes, incluidos sistemas comerciales como Runway Gen3 y LumaLabs, basándose en evaluaciones humanas con MovieGen Video Bench. En concreto, Movie Gen Video destaca en:
Aunque, en general, MovieGen supera a otros modelos, Kling1.5 a veces genera vídeos con mayor magnitud de movimiento, aunque a costa de distorsiones e incoherencias. Esto pone de relieve la disyuntiva entre integridad del movimiento y calidad visual, donde Movie Gen Video prioriza un movimiento realista y consistente frente a maximizar simplemente la cantidad de movimiento.
A continuación, algunas capturas de la presentación de Meta Connect 2024 con ejemplos comparativos de prompts de generación de vídeo:
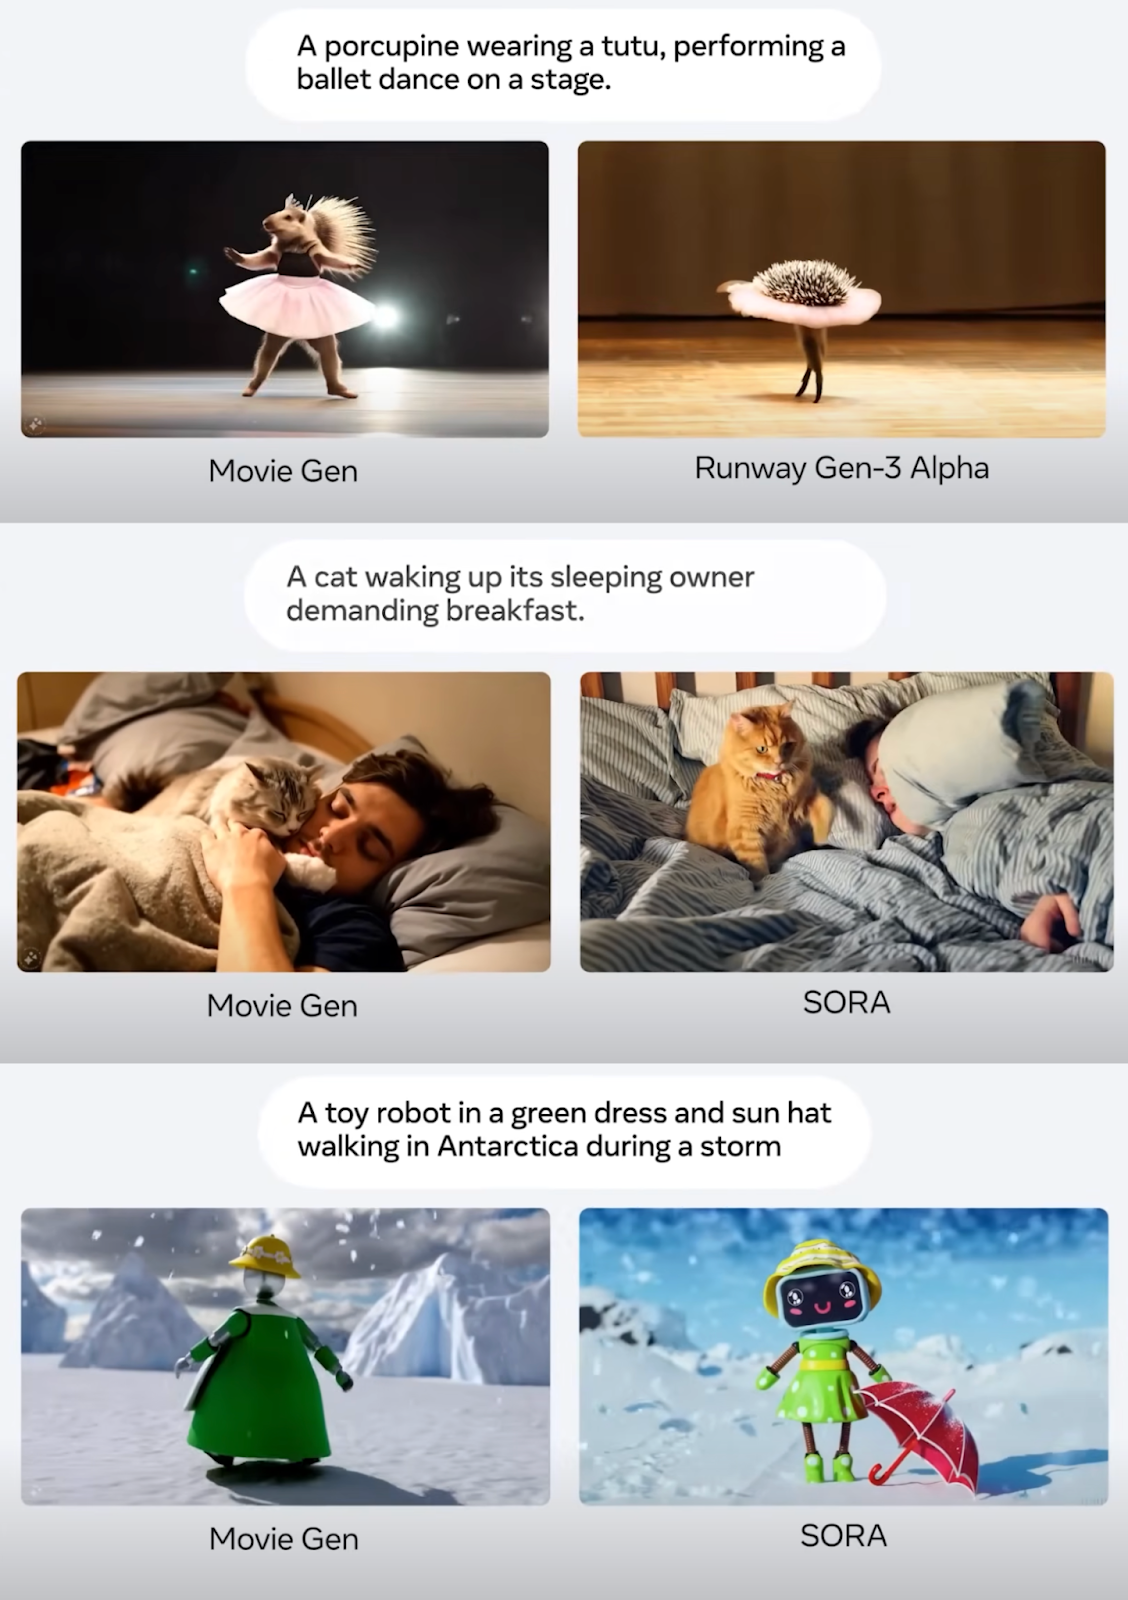
Fuente: artículo de investigación de Movie Gen
Aquí tienes algunos ejemplos comparativos de personalización de vídeo en los que se usa una foto para generar un vídeo personalizado:
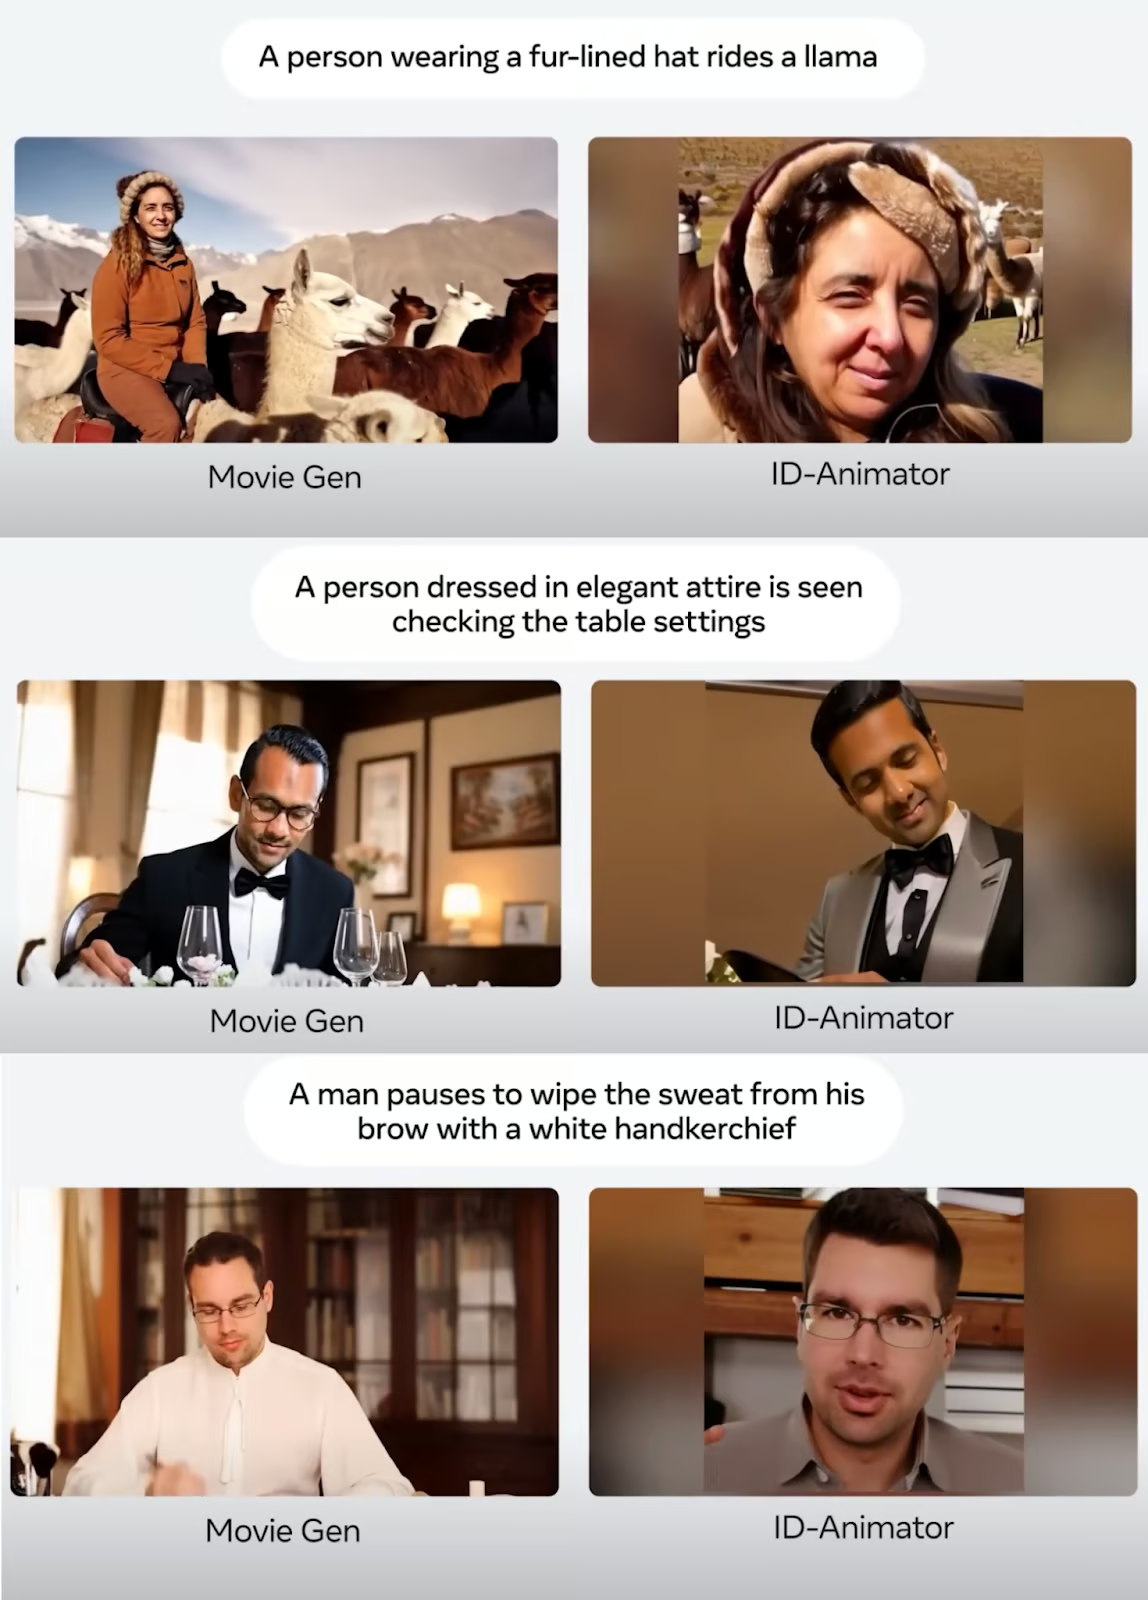
Fuente: artículo de investigación de Movie Gen
Por último, las capturas siguientes muestran ejemplos comparativos de edición de vídeo:
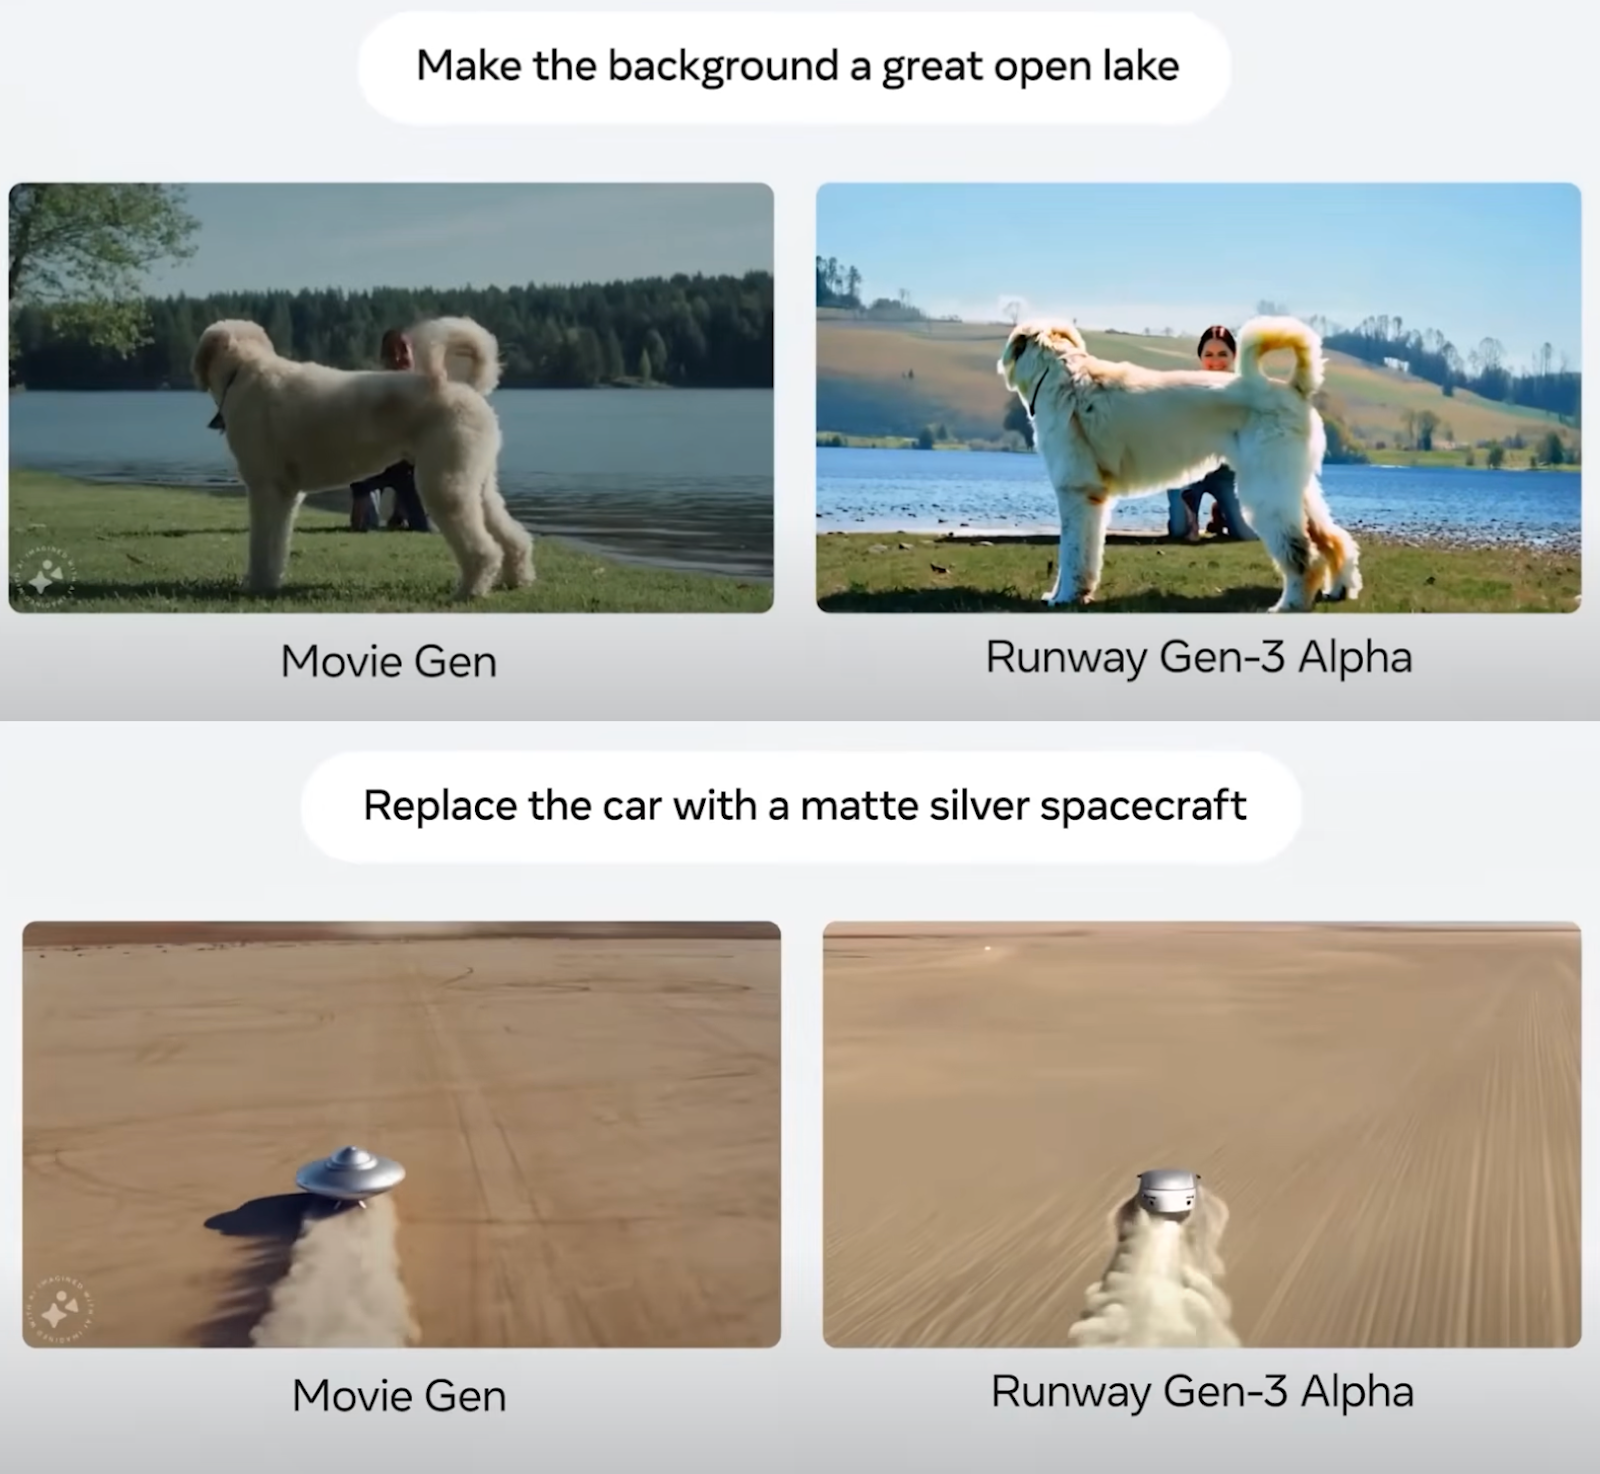
Fuente: artículo de investigación de Movie Gen
En conjunto, parece que Meta Movie Gen ha subido el listón y ha marcado un nuevo estándar en modelos de texto a vídeo. El procedimiento de evaluación que se presenta en el paper parece justo, pero, claro, es difícil asegurarlo hasta que estos modelos estén disponibles públicamente y terceros neutrales puedan compararlos.
Aunque Meta Movie Gen muestra un gran nivel en generación multimedia, aún hay margen de mejora.
A veces tiene dificultades con escenas complejas que implican geometrías intrincadas, manipulación de objetos y simulaciones físicas realistas. Por ejemplo, puede resultarle complicado generar interacciones convincentes entre objetos, representar con precisión transformaciones de estado (como derretirse o hacerse añicos) o simular fielmente efectos de gravedad o colisiones.
La sincronización del audio también puede fallar en ciertos escenarios. En particular, cuando se trata de movimientos visualmente pequeños, ocultos u otros que requieren una comprensión visual elevada para generar el sonido correspondiente, el modelo puede no lograr una sincronización perfecta. Ejemplos: acompasar con precisión los pasos de una persona que camina, generar sonidos adecuados para objetos parcialmente ocultos o reconocer sutiles movimientos de la mano en una guitarra para producir las notas correctas.
Además, el modelo Movie Gen Audio, tal y como está diseñado ahora, no soporta la generación de voz.
Los vídeos realistas generados por IA conllevan importantes riesgos y desafíos éticos que deben considerarse. Entre ellos, la manipulación de la confianza y la desinformación mediante deepfakes, con potencial para dañar reputaciones, desinformar al público y perjudicar a empresas.
Por un lado, podría ser una función de Instagram para crear un vídeo chulo conmigo dentro y compartirlo con mis amigos; por otro, esa misma función permitiría crear un vídeo falso de otra persona. A medida que estas tecnologías mejoren, distinguirlas de lo real puede volverse imposible.
El contenido generado por IA plantea amenazas a la privacidad, pudiendo derivar en extorsión, chantaje o ciberacoso.
Además, estas herramientas podrían socavar el arte y los derechos de autor al imitar estilos únicos sin atribución. Entre las soluciones están fomentar la alfabetización mediática, invertir en tecnología de detección, establecer marcos legales y éticos, y usar marcas de agua para autenticar.
Aunque la generación de vídeo con IA tiene un gran potencial, requiere un manejo cuidadoso para mantener la confianza y la autenticidad.
Meta ha sido abierta con sus avances en IA, publicando en abierto los modelos Llama. Sin embargo, por motivos de seguridad, los modelos de Meta Movie Gen aún no se van a publicar. Según su artículo, son necesarias múltiples mejoras y consideraciones de seguridad antes de su despliegue.
En este post hemos presentado los modelos Movie Gen de Meta, una serie de modelos de IA para generar y editar vídeos a partir de prompts de texto.
Hemos explorado sus cuatro modelos, sus capacidades y cómo funcionan. Con una comparativa, hemos visto cómo se sitúa Meta Movie Gen frente a otras herramientas de generación de vídeo con IA.
Aunque Meta Movie Gen ha marcado un nuevo referente en el campo, el posible uso indebido de la tecnología plantea preocupaciones importantes. Meta reconoce estos riesgos y está adoptando un enfoque prudente para su lanzamiento.
Para saber más sobre el ecosistema de Meta AI, te recomiendo estos blogs:
¡Aprende IA con estos cursos!
Curso
Curso
programa