

Che cos’è SAM2?
SAM2 è un foundation model sviluppato da Meta per la segmentazione visiva promptable in immagini e video. A differenza del suo predecessore, SAM, che si concentrava principalmente su immagini statiche, SAM2 è progettato anche per gestire le complessità della segmentazione video.
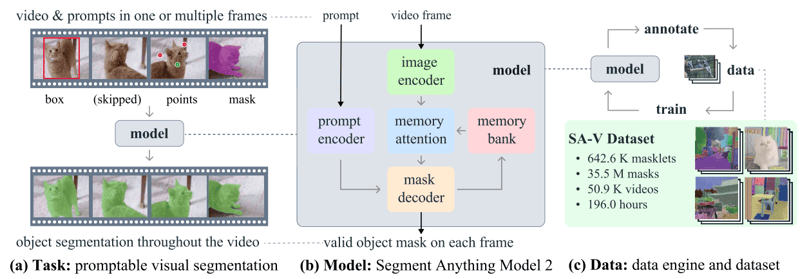
SAM2 - Task, Model e Dati (Fonte: Ravi et al., 2024)
Impiega un’architettura transformer con memoria in streaming, che abilita l’elaborazione video in tempo reale. L’addestramento di SAM 2 ha coinvolto un dataset vasto e variegato, che include il nuovo dataset SA-V con oltre 600.000 annotazioni di masklet su 51.000 video.
Il suo data engine, che consente raccolta dati interattiva e miglioramento del modello, conferisce al modello la capacità di segmentare qualsiasi cosa. Questo motore permette a SAM 2 di apprendere e adattarsi continuamente, rendendolo più efficiente nel gestire dati nuovi e impegnativi. Tuttavia, per task specifici di dominio o oggetti rari, il fine-tuning è essenziale per ottenere prestazioni ottimali.
Perché fare fine-tuning di SAM2?
Nel contesto di SAM 2, il fine-tuning è il processo di ulteriore addestramento del modello pre-addestrato SAM 2 su un dataset specifico, per migliorarne le prestazioni su uno specifico task o dominio. Sebbene SAM 2 sia uno strumento potente addestrato su un dataset ampio e diversificato, la sua natura generalista potrebbe non offrire sempre risultati ottimali per task specializzati o rari.
Per esempio, se stai lavorando a un progetto di imaging medico che richiede l’identificazione di specifici tipi di tumore, le prestazioni del modello potrebbero non essere sufficienti a causa dell’addestramento generalista.
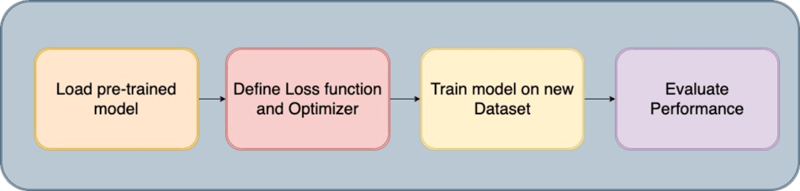
Il processo di fine-tuning
Il fine-tuning di SAM 2 affronta questo limite permettendoti di adattare il modello al tuo dataset. Questo processo migliora l’accuratezza del modello e lo rende più efficace per il tuo caso d’uso.
Ecco i principali vantaggi del fine-tuning di SAM 2:
- Maggiore accuratezza: facendo fine-tuning del modello sul tuo dataset specifico, puoi aumentarne significativamente l’accuratezza, garantendo prestazioni migliori nella tua applicazione.
- Segmentazione specializzata: il fine-tuning consente al modello di diventare abile nel segmentare specifici tipi di oggetti, stili visivi o ambienti rilevanti per il tuo progetto, fornendo risultati su misura che un modello generalista potrebbe non ottenere.
- Efficienza: il fine-tuning è spesso più efficiente rispetto all’addestramento da zero. Richiede in genere meno dati e tempo, risultando una soluzione pratica per adattare rapidamente il modello a task nuovi o di nicchia.
Primi passi con il fine-tuning di SAM 2: prerequisiti
Per iniziare con il fine-tuning di SAM 2, ti serviranno i seguenti prerequisiti:
- Accesso al modello e al codebase di SAM 2: assicurati di avere accesso al modello SAM 2 e al suo codebase. Puoi scaricare il modello pre-addestrato di SAM 2 dal repository GitHub di Meta.
- Un dataset adatto: ti servirà un dataset che includa maschere di segmentazione ground truth. Per questo tutorial useremo il dataset Chest CT Segmentation, che puoi scaricare e preparare per l’addestramento.
- Risorse computazionali: il fine-tuning di SAM 2 richiede hardware con potenza di calcolo adeguata. Le GPU sono altamente raccomandate per rendere il processo efficiente e gestibile, soprattutto con dataset grandi o modelli complessi. In questo esempio, viene utilizzata una GPU A100 su Google Colab.
Software e altri requisiti:
- Python 3.11 o superiore
- PyTorch
- OpenCV: installalo usando !pip install opencv-python
Preparazione del dataset per il fine-tuning di SAM 2
La qualità del dataset è cruciale per il fine-tuning del modello SAM 2. Immagini o video annotati di alta qualità con maschere di segmentazione accurate sono essenziali per ottenere prestazioni ottimali. Annotazioni precise permettono al modello di apprendere le caratteristiche corrette, migliorando l’accuratezza della segmentazione e la robustezza nelle applicazioni reali.
1. Acquisizione dei dati
Il primo passo consiste nell’acquisire il dataset, che costituisce l’ossatura del processo di training. Abbiamo reperito i dati da Kaggle, una piattaforma affidabile che offre una vasta gamma di dataset. Usando le API di Kaggle, abbiamo scaricato i dati nel formato richiesto, assicurandoci che immagini e relative maschere di segmentazione fossero pronte per l’elaborazione successiva.
2. Estrazione e pulizia dei dati
Dopo aver scaricato i dataset, abbiamo eseguito i seguenti passaggi:
- Decompressione e pulizia: estrai i dati dagli archivi zip scaricati ed elimina i file non necessari per risparmiare spazio su disco.
- Estrazione degli ID: gli identificatori univoci (ID) per immagini e maschere vengono estratti per garantire la corretta associazione tra di essi durante l’addestramento.
- Rimozione dei file superflui: elimina eventuali file rumorosi o irrilevanti, come alcune immagini con problemi noti, per mantenere l’integrità del dataset.
3. Conversione in formati utilizzabili
Poiché il modello SAM2 richiede input in formati specifici, abbiamo convertito i dati come segue:
- Da DICOM a NumPy: le immagini DICOM sono state lette e salvate come array NumPy, poi ridimensionate a una dimensione standard di 512×512 pixel.
- Da NRRD a NumPy per le maschere: allo stesso modo, i file NRRD contenenti le maschere di polmoni, cuore e trachea sono stati elaborati e salvati come array NumPy. Queste maschere sono poi state rimodellate per corrispondere alle immagini.
- Conversione in JPG/PNG: per una migliore visualizzazione e compatibilità, gli array NumPy sono stati convertiti in formati JPG/PNG. Questo passaggio includeva la normalizzazione dei valori di intensità dell’immagine e l’allineamento corretto delle maschere.
4. Salvataggio e organizzazione dei dati
Le immagini e le maschere elaborate vengono quindi organizzate in cartelle dedicate per un accesso semplice durante il fine-tuning. Inoltre, i percorsi di queste immagini e maschere vengono scritti in un file CSV (train.csv) per facilitare il caricamento dei dati durante l’addestramento.
5. Visualizzazione e validazione
Il passaggio finale prevede la validazione del dataset per garantirne l’accuratezza:
- Visualizzazione: abbiamo visualizzato le coppie immagine‑maschera sovrapponendo le maschere alle immagini. Questo ci ha aiutato a verificare l’allineamento e l’accuratezza delle maschere.
- Ispezione: ispezionando alcuni campioni, abbiamo potuto confermare che il dataset era preparato correttamente e pronto per il fine-tuning.
Qui trovi un notebook rapido che ti guida nel codice per la creazione del dataset. Puoi seguire questo percorso di creazione dei dati oppure usare direttamente qualsiasi dataset disponibile online nello stesso formato indicato nei prerequisiti.
Fine-tuning di SAM2
Segment Anything Model 2 comprende diversi componenti, ma il trucco per un fine-tuning più veloce è addestrare solo i componenti leggeri, come il decoder di maschere e il prompt encoder, invece dell’intero modello. I passaggi per il fine-tuning sono i seguenti:
Passaggio 1: installa SAM-2
Per iniziare il processo di fine-tuning, dobbiamo installare la libreria SAM-2, fondamentale per il Segment Anything Model (SAM2). Questo modello è progettato per gestire efficacemente vari task di segmentazione. L’installazione prevede il clonaggio del repository SAM-2 da GitHub e l’installazione delle dipendenze necessarie.
!git clone https://github.com/facebookresearch/segment-anything-2
%cd /content/segment-anything-2
!pip install -q -e .Questo snippet garantisce che la libreria SAM2 sia installata correttamente e pronta per essere usata nel nostro flusso di fine-tuning.
Passaggio 2: scarica il dataset
Una volta installata la libreria SAM-2, il passo successivo è acquisire il dataset che useremo per il fine-tuning. Utilizziamo un dataset disponibile su Kaggle, nello specifico un dataset di segmentazione da TAC toracica contenente immagini e maschere di polmoni, cuore e trachea.
Il dataset contiene:
- images.zip: immagini in formato RGB
- masks.zip: maschere di segmentazione in formato RGB
- train.csv: file CSV con i nomi delle immagini
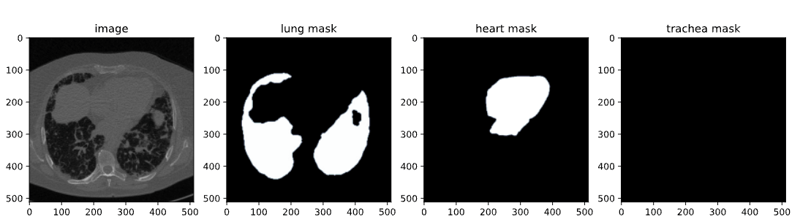
Immagine dal dataset di scansioni TC
In questo blog useremo solo immagini e maschere dei polmoni per la segmentazione. Le API di Kaggle ci consentono di scaricare i dataset direttamente nel nostro ambiente. Iniziamo caricando il file kaggle.json da Kaggle per accedere facilmente a qualsiasi dataset.
Per ottenere kaggle.json, vai alla scheda Settings sotto il tuo profilo utente e seleziona Create New Token. Questo avvierà il download di kaggle.json, un file contenente le tue credenziali API.
# get dataset from Kaggle
from google.colab import files
files.upload() # This will prompt you to upload the kaggle.json file
!mkdir -p ~/.kaggle
!mv kaggle.json ~/.kaggle/
!chmod 600 ~/.kaggle/kaggle.json
!kaggle datasets download -d polomarco/chest-ct-segmentationDecomprimi i dati:
!unzip chest-ct-segmentation.zip -d chest-ct-segmentationCon il dataset pronto, iniziamo il processo di fine-tuning. Come accennato, la chiave è fare fine-tuning solo dei componenti leggeri di SAM2, come il decoder di maschere e il prompt encoder, invece dell’intero modello. Questo approccio è più efficiente e richiede meno risorse.
Passaggio 3: scarica i checkpoint di SAM-2
Per il fine-tuning, dobbiamo partire dai pesi pre-addestrati del modello SAM2. Questi pesi, chiamati "checkpoint", sono il punto di partenza per l’ulteriore addestramento. I checkpoint sono stati addestrati su un’ampia varietà di immagini e, facendone il fine-tuning sul nostro dataset specifico, possiamo ottenere prestazioni migliori sui nostri task target.
!wget -O sam2_hiera_tiny.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_tiny.pt"
!wget -O sam2_hiera_small.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_small.pt"
!wget -O sam2_hiera_base_plus.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_base_plus.pt"
!wget -O sam2_hiera_large.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_large.pt"In questo passaggio scarichiamo vari checkpoint di SAM‑2 che corrispondono a diverse dimensioni del modello (ad es. tiny, small, base_plus, large). La scelta del checkpoint può essere adattata in base alle risorse computazionali disponibili e al task specifico.
Passaggio 4: preparazione dei dati
Una volta scaricato il dataset, il passaggio successivo è prepararlo per l’addestramento. Questo comporta la suddivisione del dataset in set di training e di test e la creazione di strutture di dati che possano essere fornite al modello SAM 2 durante il fine-tuning.
%cd /content/segment-anything-2
import os
import pandas as pd
import cv2
import torch
import torch.nn.utils
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.colors as mcolors
from sklearn.model_selection import train_test_split
from sam2.build_sam import build_sam2
from sam2.sam2_image_predictor import SAM2ImagePredictor
# Path to the chest-ct-segmentation dataset folder
data_dir = "/content/segment-anything-2/chest-ct-segmentation"
images_dir = os.path.join(data_dir, "images/images")
masks_dir = os.path.join(data_dir, "masks/masks")
# Load the train.csv file
train_df = pd.read_csv(os.path.join(data_dir, "train.csv"))
# Split the data into two halves: one for training and one for testing
train_df, test_df = train_test_split(train_df, test_size=0.2, random_state=42)
# Prepare the training data list
train_data = []
for index, row in train_df.iterrows():
image_name = row['ImageId']
mask_name = row['MaskId']
# Append image and corresponding mask paths
train_data.append({
"image": os.path.join(images_dir, image_name),
"annotation": os.path.join(masks_dir, mask_name)
})
# Prepare the testing data list (if needed for inference or evaluation later)
test_data = []
for index, row in test_df.iterrows():
image_name = row['ImageId']
mask_name = row['MaskId']
# Append image and corresponding mask paths
test_data.append({
"image": os.path.join(images_dir, image_name),
"annotation": os.path.join(masks_dir, mask_name)
})
Suddividiamo il dataset in un set di training (80%) e uno di test (20%) per poter valutare le prestazioni del modello dopo l’addestramento. I dati di training verranno utilizzati per il fine-tuning del modello SAM 2, mentre i dati di test verranno usati per inferenza e valutazione.
Dopo aver suddiviso il dataset in training e test, il passaggio successivo prevede la creazione di maschere binarie, la selezione di punti chiave all’interno di queste maschere e la visualizzazione di questi elementi per assicurarsi che i dati siano elaborati correttamente.
1. Lettura e ridimensionamento delle immagini: il processo inizia selezionando casualmente un’immagine e la sua maschera corrispondente dal dataset. L’immagine viene convertita da BGR a RGB, che è il formato colore standard per la maggior parte dei modelli di deep learning. L’annotazione corrispondente (maschera) viene letta in modalità scala di grigi. Successivamente, sia l’immagine sia la maschera di annotazione vengono ridimensionate a una dimensione massima di 1024 pixel, mantenendo il rapporto d’aspetto, in modo da rientrare nei requisiti di input del modello e ridurre il carico computazionale.
def read_batch(data, visualize_data=False):
# Select a random entry
ent = data[np.random.randint(len(data))]
# Get full paths
Img = cv2.imread(ent["image"])[..., ::-1] # Convert BGR to RGB
ann_map = cv2.imread(ent["annotation"], cv2.IMREAD_GRAYSCALE) # Read annotation as grayscale
if Img is None or ann_map is None:
print(f"Error: Could not read image or mask from path {ent['image']} or {ent['annotation']}")
return None, None, None, 0
# Resize image and mask
r = np.min([1024 / Img.shape[1], 1024 / Img.shape[0]]) # Scaling factor
Img = cv2.resize(Img, (int(Img.shape[1] * r), int(Img.shape[0] * r)))
ann_map = cv2.resize(ann_map, (int(ann_map.shape[1] * r), int(ann_map.shape[0] * r)), interpolation=cv2.INTER_NEAREST)
2. Binarizzazione delle maschere di segmentazione: la maschera di annotazione multi‑classe (che potrebbe avere più classi di oggetti etichettate con diversi valori di pixel) viene convertita in una maschera binaria. Questa maschera evidenzia tutte le regioni di interesse nell’immagine, semplificando il task di segmentazione a un problema di classificazione binaria: oggetto vs. sfondo. La maschera binaria viene poi erosa usando un kernel 5×5.
L’erosione riduce leggermente la dimensione della maschera, aiutando a evitare effetti di bordo durante la selezione dei punti. In questo modo i punti selezionati si trovano all’interno dell’oggetto e non vicino ai margini, che potrebbero essere rumorosi o ambigui.
I punti chiave vengono selezionati all’interno della maschera erosa. Questi punti fungono da prompt durante il fine-tuning, guidando il modello su dove concentrare l’attenzione. I punti vengono scelti casualmente dall’interno degli oggetti per garantire che siano rappresentativi e non influenzati da bordi rumorosi.
### Continuation of read_batch() ###
# Initialize a single binary mask
binary_mask = np.zeros_like(ann_map, dtype=np.uint8)
points = []
# Get binary masks and combine them into a single mask
inds = np.unique(ann_map)[1:] # Skip the background (index 0)
for ind in inds:
mask = (ann_map == ind).astype(np.uint8) # Create binary mask for each unique index
binary_mask = np.maximum(binary_mask, mask) # Combine with the existing binary mask
# Erode the combined binary mask to avoid boundary points
eroded_mask = cv2.erode(binary_mask, np.ones((5, 5), np.uint8), iterations=1)
# Get all coordinates inside the eroded mask and choose a random point
coords = np.argwhere(eroded_mask > 0)
if len(coords) > 0:
for _ in inds: # Select as many points as there are unique labels
yx = np.array(coords[np.random.randint(len(coords))])
points.append([yx[1], yx[0]])
points = np.array(points)
3. Visualizzazione: questo passaggio è fondamentale per verificare che le fasi di preprocessing siano state eseguite correttamente. Ispezionando visivamente i punti sulla maschera binarizzata, puoi assicurarti che il modello riceverà input adeguati durante l’addestramento. Infine, la maschera binaria viene rimodellata e formattata correttamente (con dimensioni adatte all’input del modello) e i punti vengono anch’essi rimodellati per l’uso nel training. La funzione restituisce l’immagine elaborata, la maschera binaria, i punti selezionati e il numero di maschere rilevate.
### Continuation of read_batch() ###
if visualize_data:
# Plotting the images and points
plt.figure(figsize=(15, 5))
# Original Image
plt.subplot(1, 3, 1)
plt.title('Original Image')
plt.imshow(img)
plt.axis('off')
# Segmentation Mask (binary_mask)
plt.subplot(1, 3, 2)
plt.title('Binarized Mask')
plt.imshow(binary_mask, cmap='gray')
plt.axis('off')
# Mask with Points in Different Colors
plt.subplot(1, 3, 3)
plt.title('Binarized Mask with Points')
plt.imshow(binary_mask, cmap='gray')
# Plot points in different colors
colors = list(mcolors.TABLEAU_COLORS.values())
for i, point in enumerate(points):
plt.scatter(point[0], point[1], c=colors[i % len(colors)], s=100, label=f'Point {i+1}') # Corrected to plot y, x order
# plt.legend()
plt.axis('off')
plt.tight_layout()
plt.show()
binary_mask = np.expand_dims(binary_mask, axis=-1) # Now shape is (1024, 1024, 1)
binary_mask = binary_mask.transpose((2, 0, 1))
points = np.expand_dims(points, axis=1)
# Return the image, binarized mask, points, and number of masks
return img, binary_mask, points, len(inds)
# Visualize the data
Img1, masks1, points1, num_masks = read_batch(train_data, visualize_data=True)
Il codice precedente restituisce la figura seguente, che contiene l’immagine originale dal dataset insieme alla sua maschera binarizzata e alla maschera binarizzata con i punti.
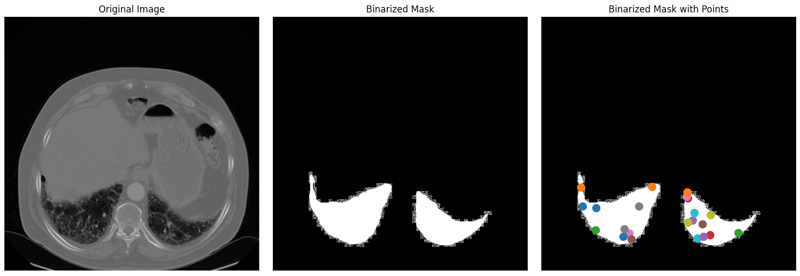
Immagine originale, maschera binarizzata e maschera binarizzata con punti per il dataset.
Passaggio 5: fine-tuning del modello SAM2
Il fine-tuning del modello SAM2 prevede diversi passaggi, tra cui il caricamento del modello, la configurazione dell’optimizer e dello scheduler e l’aggiornamento iterativo dei pesi del modello in base ai dati di training.
Carica i checkpoint del modello:
sam2_checkpoint = "sam2_hiera_small.pt" # @param ["sam2_hiera_tiny.pt", "sam2_hiera_small.pt", "sam2_hiera_base_plus.pt", "sam2_hiera_large.pt"]
model_cfg = "sam2_hiera_s.yaml" # @param ["sam2_hiera_t.yaml", "sam2_hiera_s.yaml", "sam2_hiera_b+.yaml", "sam2_hiera_l.yaml"]
sam2_model = build_sam2(model_cfg, sam2_checkpoint, device="cuda")
predictor = SAM2ImagePredictor(sam2_model)
Iniziamo costruendo il modello SAM2 usando i checkpoint pre‑addestrati. Il modello viene quindi incapsulato in una classe predictor, che semplifica l’impostazione delle immagini, la codifica dei prompt e il decoding delle maschere.
Configura gli iperparametri
Configuriamo diversi iperparametri per garantire un apprendimento efficace del modello, come learning rate, weight decay e passi di accumulo del gradiente. Questi iperparametri controllano il processo di apprendimento, inclusa la velocità di aggiornamento dei pesi e la prevenzione dell’overfitting. Sentiti libero di sperimentare.
# Train mask decoder.
predictor.model.sam_mask_decoder.train(True)
# Train prompt encoder.
predictor.model.sam_prompt_encoder.train(True)
# Configure optimizer.
optimizer=torch.optim.AdamW(params=predictor.model.parameters(),lr=0.0001,weight_decay=1e-4) #1e-5, weight_decay = 4e-5
# Mix precision.
scaler = torch.cuda.amp.GradScaler()
# No. of steps to train the model.
NO_OF_STEPS = 3000 # @param
# Fine-tuned model name.
FINE_TUNED_MODEL_NAME = "fine_tuned_sam2"
L’optimizer è responsabile dell’aggiornamento dei pesi del modello, mentre lo scheduler regola il learning rate durante l’addestramento per migliorare la convergenza. Ottimizzando questi parametri, possiamo ottenere una segmentazione più accurata.
Avvia l’addestramento
Il processo di fine-tuning è iterativo: a ogni step, un batch di immagini e maschere solo dei polmoni viene passato attraverso il modello, e la loss viene calcolata e utilizzata per aggiornare i pesi.
# Initialize scheduler
scheduler = torch.optim.lr_scheduler.StepLR(optimizer, step_size=500, gamma=0.2) # 500 , 250, gamma = 0.1
accumulation_steps = 4 # Number of steps to accumulate gradients before updating
for step in range(1, NO_OF_STEPS + 1):
with torch.cuda.amp.autocast():
image, mask, input_point, num_masks = read_batch(train_data, visualize_data=False)
if image is None or mask is None or num_masks == 0:
continue
input_label = np.ones((num_masks, 1))
if not isinstance(input_point, np.ndarray) or not isinstance(input_label, np.ndarray):
continue
if input_point.size == 0 or input_label.size == 0:
continue
predictor.set_image(image)
mask_input, unnorm_coords, labels, unnorm_box = predictor._prep_prompts(input_point, input_label, box=None, mask_logits=None, normalize_coords=True)
if unnorm_coords is None or labels is None or unnorm_coords.shape[0] == 0 or labels.shape[0] == 0:
continue
sparse_embeddings, dense_embeddings = predictor.model.sam_prompt_encoder(
points=(unnorm_coords, labels), boxes=None, masks=None,
)
batched_mode = unnorm_coords.shape[0] > 1
high_res_features = [feat_level[-1].unsqueeze(0) for feat_level in predictor._features["high_res_feats"]]
low_res_masks, prd_scores, _, _ = predictor.model.sam_mask_decoder(
image_embeddings=predictor._features["image_embed"][-1].unsqueeze(0),
image_pe=predictor.model.sam_prompt_encoder.get_dense_pe(),
sparse_prompt_embeddings=sparse_embeddings,
dense_prompt_embeddings=dense_embeddings,
multimask_output=True,
repeat_image=batched_mode,
high_res_features=high_res_features,
)
prd_masks = predictor._transforms.postprocess_masks(low_res_masks, predictor._orig_hw[-1])
gt_mask = torch.tensor(mask.astype(np.float32)).cuda()
prd_mask = torch.sigmoid(prd_masks[:, 0])
seg_loss = (-gt_mask * torch.log(prd_mask + 0.000001) - (1 - gt_mask) * torch.log((1 - prd_mask) + 0.00001)).mean()
inter = (gt_mask * (prd_mask > 0.5)).sum(1).sum(1)
iou = inter / (gt_mask.sum(1).sum(1) + (prd_mask > 0.5).sum(1).sum(1) - inter)
score_loss = torch.abs(prd_scores[:, 0] - iou).mean()
loss = seg_loss + score_loss * 0.05
# Apply gradient accumulation
loss = loss / accumulation_steps
scaler.scale(loss).backward()
# Clip gradients
torch.nn.utils.clip_grad_norm_(predictor.model.parameters(), max_norm=1.0)
if step % accumulation_steps == 0:
scaler.step(optimizer)
scaler.update()
predictor.model.zero_grad()
# Update scheduler
scheduler.step()
if step % 500 == 0:
FINE_TUNED_MODEL = FINE_TUNED_MODEL_NAME + "_" + str(step) + ".torch"
torch.save(predictor.model.state_dict(), FINE_TUNED_MODEL)
if step == 1:
mean_iou = 0
mean_iou = mean_iou * 0.99 + 0.01 * np.mean(iou.cpu().detach().numpy())
if step % 100 == 0:
print("Step " + str(step) + ":\t", "Accuracy (IoU) = ", mean_iou)
A ogni iterazione, il modello elabora un batch di immagini, calcola le maschere di segmentazione e le confronta con il ground truth per calcolare la loss. Questa loss viene poi usata per aggiornare i pesi del modello, migliorandone gradualmente le prestazioni. Dopo circa 3000 epoche di training, otteniamo un’accuratezza (IoU - Intersection over Union) di circa il 72%.
Passaggio 6: inferenza con il modello fine-tuned
Il modello può quindi essere utilizzato per l’inferenza, dove prevede maschere di segmentazione su immagini nuove e non viste. Inizia con le funzioni helper read_images e get_points per ottenere l’immagine di inferenza e la sua maschera insieme ai punti chiave.
def read_image(image_path, mask_path): # read and resize image and mask
img = cv2.imread(image_path)[..., ::-1] # Convert BGR to RGB
mask = cv2.imread(mask_path, 0)
r = np.min([1024 / img.shape[1], 1024 / img.shape[0]])
img = cv2.resize(img, (int(img.shape[1] * r), int(img.shape[0] * r)))
mask = cv2.resize(mask, (int(mask.shape[1] * r), int(mask.shape[0] * r)), interpolation=cv2.INTER_NEAREST)
return img, mask
def get_points(mask, num_points): # Sample points inside the input mask
points = []
coords = np.argwhere(mask > 0)
for i in range(num_points):
yx = np.array(coords[np.random.randint(len(coords))])
points.append([[yx[1], yx[0]]])
return np.array(points)Poi carica le immagini campione per l’inferenza, insieme ai nuovi pesi fine‑tuned, ed esegui l’inferenza impostando torch.no_grad().
# Randomly select a test image from the test_data
selected_entry = random.choice(test_data)
image_path = selected_entry['image']
mask_path = selected_entry['annotation']
# Load the selected image and mask
image, mask = read_image(image_path, mask_path)
# Generate random points for the input
num_samples = 30 # Number of points per segment to sample
input_points = get_points(mask, num_samples)
# Load the fine-tuned model
FINE_TUNED_MODEL_WEIGHTS = "fine_tuned_sam2_1000.torch"
sam2_model = build_sam2(model_cfg, sam2_checkpoint, device="cuda")
# Build net and load weights
predictor = SAM2ImagePredictor(sam2_model)
predictor.model.load_state_dict(torch.load(FINE_TUNED_MODEL_WEIGHTS))
# Perform inference and predict masks
with torch.no_grad():
predictor.set_image(image)
masks, scores, logits = predictor.predict(
point_coords=input_points,
point_labels=np.ones([input_points.shape[0], 1])
)
# Process the predicted masks and sort by scores
np_masks = np.array(masks[:, 0])
np_scores = scores[:, 0]
sorted_masks = np_masks[np.argsort(np_scores)][::-1]
# Initialize segmentation map and occupancy mask
seg_map = np.zeros_like(sorted_masks[0], dtype=np.uint8)
occupancy_mask = np.zeros_like(sorted_masks[0], dtype=bool)
# Combine masks to create the final segmentation map
for i in range(sorted_masks.shape[0]):
mask = sorted_masks[i]
if (mask * occupancy_mask).sum() / mask.sum() > 0.15:
continue
mask_bool = mask.astype(bool)
mask_bool[occupancy_mask] = False # Set overlapping areas to False in the mask
seg_map[mask_bool] = i + 1 # Use boolean mask to index seg_map
occupancy_mask[mask_bool] = True # Update occupancy_mask
# Visualization: Show the original image, mask, and final segmentation side by side
plt.figure(figsize=(18, 6))
plt.subplot(1, 3, 1)
plt.title('Test Image')
plt.imshow(image)
plt.axis('off')
plt.subplot(1, 3, 2)
plt.title('Original Mask')
plt.imshow(mask, cmap='gray')
plt.axis('off')
plt.subplot(1, 3, 3)
plt.title('Final Segmentation')
plt.imshow(seg_map, cmap='jet')
plt.axis('off')
plt.tight_layout()
plt.show()In questo passaggio, utilizziamo il modello fine‑tuned per generare maschere di segmentazione per le immagini di test. Le maschere previste vengono poi visualizzate insieme alle immagini originali e alle maschere ground truth per valutarne le prestazioni.
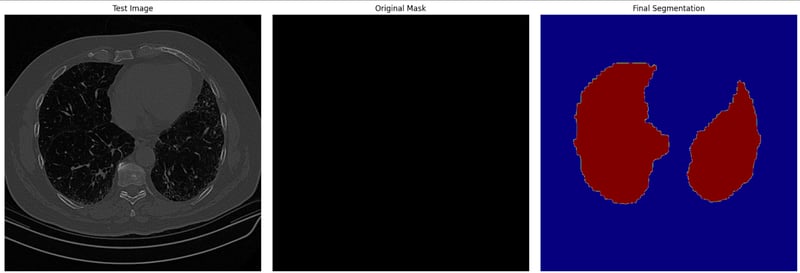
Immagine di segmentazione finale sui dati di test
Conclusione
Il fine-tuning di SAM2 offre un modo pratico per potenziarne le capacità su task specifici. Che tu stia lavorando su imaging medico, veicoli autonomi o video editing, il fine-tuning ti consente di usare SAM2 per le tue esigenze. Seguendo questa guida, puoi adattare SAM2 ai tuoi progetti e ottenere risultati di segmentazione all’avanguardia.
Per casi d’uso più avanzati, valuta il fine-tuning di ulteriori componenti di SAM2, come l’image encoder. Sebbene ciò richieda più risorse, offre maggiore flessibilità e miglioramenti prestazionali.

Sono una Google Developers Expert in ML (Gen AI), una Kaggle 3x Expert e una Women Techmakers Ambassador con oltre 3 anni di esperienza nel tech. Ho co-fondato una startup health-tech nel 2020 e sto conseguendo un master in informatica al Georgia Tech, con specializzazione in machine learning.





Segment Anything Model 2 (SAM 2) di Meta è stato il primo modello unificato di Meta in grado di segmentare oggetti sia in immagini sia in video in tempo reale. Da allora è stato superato da SAM3, di cui puoi leggere nel nostro tutorial su SAM3.
Ma perché fare fine-tuning di SAM 2 se può già segmentare qualsiasi cosa?
Anche se SAM 2 è potente già out‑of‑the‑box, le sue prestazioni su task rari o specifici di un dominio potrebbero non essere sempre all’altezza. Il fine-tuning ti permette di adattare SAM2 alle tue esigenze, migliorandone accuratezza ed efficienza per il tuo caso d’uso.
In questo articolo ti guiderò passo dopo passo attraverso il processo di fine-tuning di SAM 2.