

Khóa học
Làm việc với Llama 3
2 giờ
15.7K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleGần đây Meta đã ra mắt Meta Movie Gen, một sự kiện vừa đáng chú ý vừa có phần bất ngờ trong bối cảnh tạo video từ văn bản—tôi không nghĩ Meta nằm trong tầm ngắm của nhiều người khi nói đến tạo video.
Xét môi trường cạnh tranh, với một số công ty nổi bật như OpenAI đã phát triển các mô hình vững vàng như Sora, việc Meta phát hành là điều đáng lưu ý.
Mô hình này hoạt động tốt trên nhiều tác vụ, vượt trội hoặc sánh ngang chất lượng với các sản phẩm từ những tên tuổi như Runway Gen3, LumaLabs và đặc biệt là Sora của OpenAI.
Trong bài blog này, tôi sẽ trình bày Meta Movie Gen là gì, cách nó hoạt động, các khả năng và hạn chế, cùng những cân nhắc về an toàn khi sử dụng.
Nếu bạn muốn có cái nhìn tổng quan về lĩnh vực tạo video, tôi khuyên bạn nên xem bài viết này về các bộ tạo video AI hàng đầu.
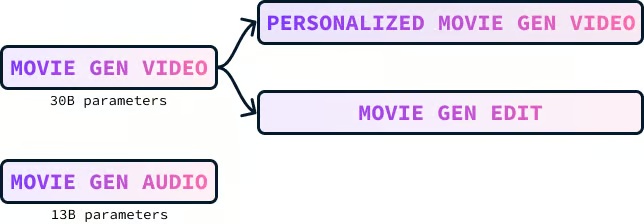
Meta Movie Gen là một tập hợp các mô hình nền tảng để tạo nhiều loại phương tiện, bao gồm văn bản thành video, văn bản thành âm thanh và văn bản thành hình ảnh. Nó gồm bốn mô hình:
Movie Gen Video là mô hình 30 tỷ tham số, được thiết kế để tạo hình ảnh và video dựa trên mô tả văn bản. Mô hình có thể tạo video chất lượng cao dài tối đa 16 giây phù hợp với lời nhắc văn bản đã cho. Nó có thể tạo nội dung ở các kích cỡ, độ phân giải và độ dài khác nhau.
Dưới đây là ví dụ về một video được tạo với lời nhắc:
“Một con lười đeo kính râm màu hồng nằm trên phao hình bánh donut trong hồ bơi. Con lười cầm một ly nước nhiệt đới. Thế giới là vùng nhiệt đới. Ánh nắng tạo bóng.”
Mô hình này có tiềm năng cách mạng hóa quy trình dựng phim trong nhiều ngành. Khả năng hiểu và thực thi chính xác các hướng dẫn chỉnh sửa dựa trên văn bản có thể cải thiện đáng kể quy trình chỉnh sửa, giúp nhanh hơn, hiệu quả hơn và tiếp cận được nhiều người dùng hơn. Công nghệ này có thể mang lại lợi ích cho nhà làm phim, nhà sáng tạo nội dung, nhà giáo dục và bất kỳ ai làm việc với nội dung video.
Việc huấn luyện mô hình Movie Gen Video gồm một số thành phần chính: thu thập và chuẩn bị dữ liệu, quá trình huấn luyện, tinh chỉnh để nâng cao chất lượng và kỹ thuật tăng mẫu dùng để đạt đầu ra độ phân giải cao.
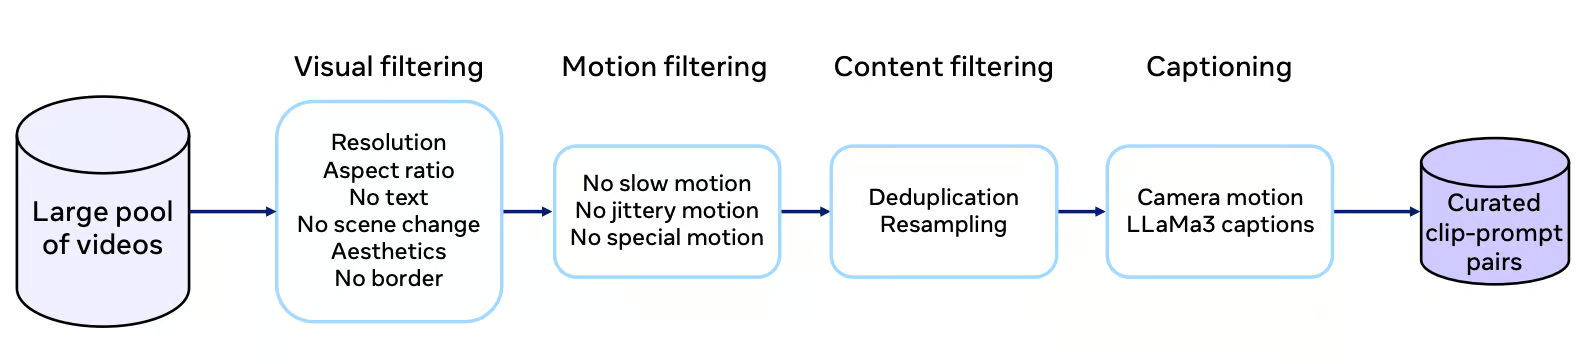
Mô hình Movie Gen Video được huấn luyện trên một bộ dữ liệu khổng lồ chứa hàng trăm triệu cặp video-văn bản và hơn một tỷ cặp hình ảnh-văn bản.
Mỗi video trong bộ dữ liệu trải qua quy trình tuyển chọn nghiêm ngặt bao gồm lọc theo chất lượng hình ảnh, đặc trưng chuyển động và mức độ liên quan nội dung. Quá trình lọc nhằm chọn video có chuyển động không tầm thường, quay máy một cú liên tục, và đa dạng khái niệm, trong đó có phần lớn chứa con người.
Nguồn: Bài báo nghiên cứu Movie Gen
Chú thích chất lượng cao rất quan trọng để huấn luyện hiệu quả. Movie Gen Video dùng mô hình LLaMa3-Video để tạo chú thích chi tiết mô tả chính xác nội dung video. Những chú thích này không chỉ dán nhãn đối tượng; chúng còn bao gồm mô tả hành động, chuyển động máy quay và cả thông tin ánh sáng. Nguồn thông tin văn bản phong phú này giúp mô hình học được hiểu biết tinh tế hơn về kể chuyện bằng hình ảnh.
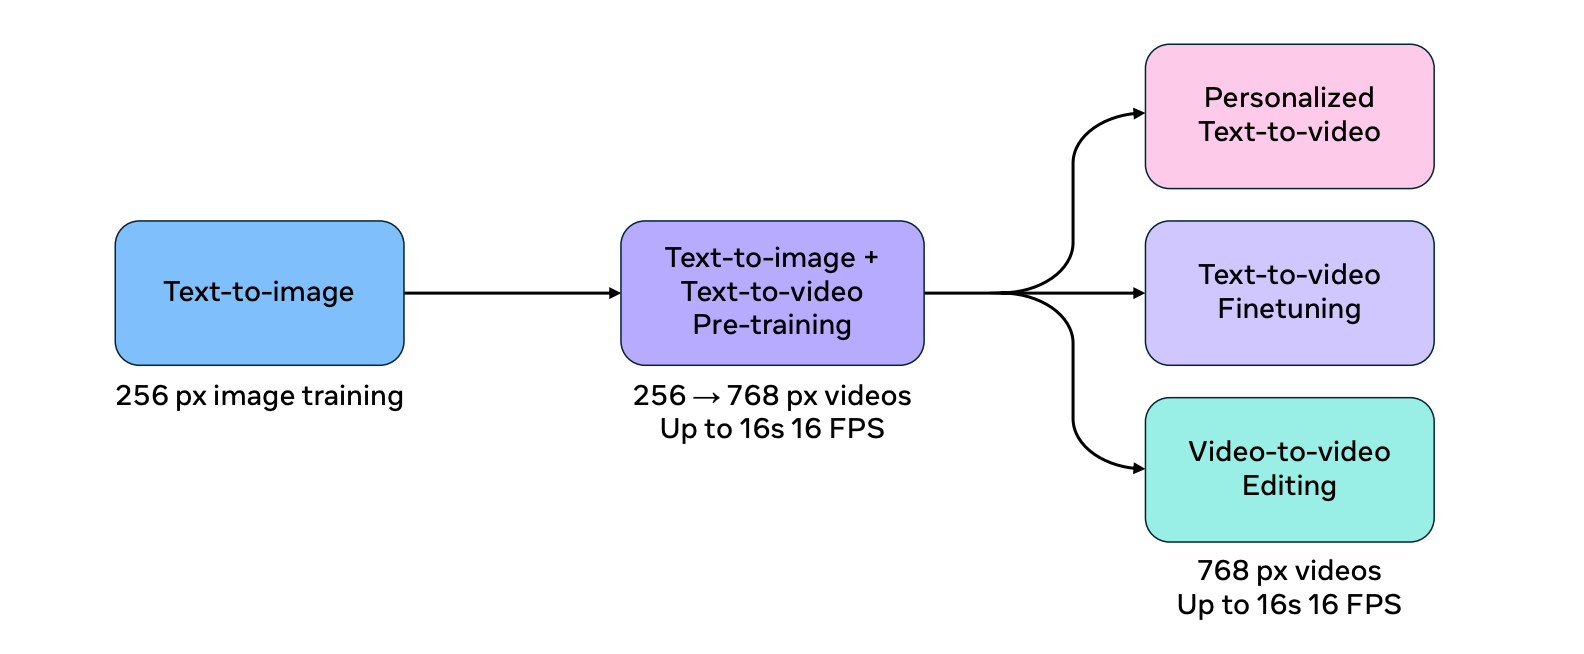
Quy trình huấn luyện Movie Gen Video được chia thành vài giai đoạn để nâng cao hiệu quả và khả năng mở rộng của mô hình.
Mô hình trước tiên được huấn luyện trên tác vụ văn bản-thành-hình ảnh với hình ảnh độ phân giải thấp hơn. Giai đoạn "làm nóng" này cho phép mô hình học các khái niệm thị giác nền tảng trước khi xử lý nhiệm vụ phức tạp hơn là tạo video.
Sau đó mô hình được huấn luyện đồng thời trên cả hai tác vụ văn bản-thành-hình ảnh và văn bản-thành-video, tăng dần độ phân giải của dữ liệu đầu vào. Cách huấn luyện chung này giúp mô hình tận dụng sự phong phú và đa dạng của các bộ dữ liệu hình ảnh-văn bản, đồng thời học được tính phức tạp của tạo video.
Nguồn: Bài báo nghiên cứu Movie Gen
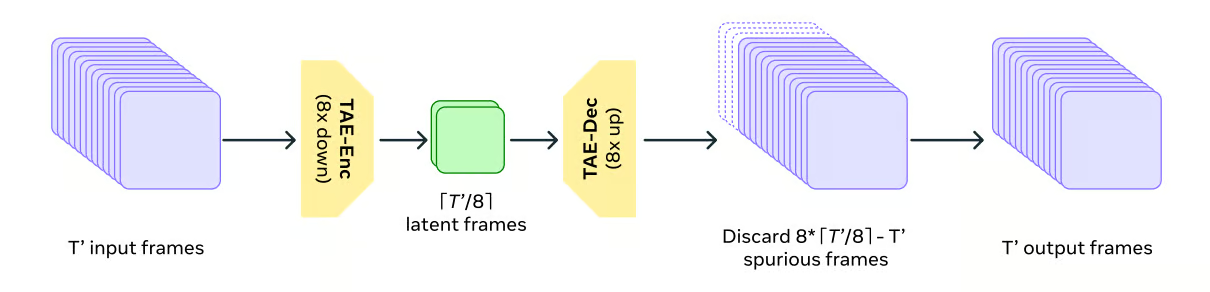
Để xử lý nhu cầu tính toán của dữ liệu video, Movie Gen Video dùng mô hình Temporal Autoencoder (TAE) để nén và giải nén video theo chiều thời gian. Điều này tương tự như nén và giải nén tệp trên máy tính, cho phép mô hình làm việc với biểu diễn dữ liệu video dễ quản lý hơn.
Nguồn: Bài báo nghiên cứu Movie Gen
Movie Gen Video dùng mục tiêu huấn luyện gọi là Flow Matching. Thay vì trực tiếp tạo video cuối cùng, flow matching dẫn dắt mô hình dần dần biến đổi một mẫu nhiễu ngẫu nhiên thành video mong muốn, từng bước một.
Flow Matching liên quan đến việc dự đoán vận tốc của các mẫu trong không gian ẩn thay vì dự đoán trực tiếp các mẫu đó. Phương pháp này hiệu quả và hiệu năng cao hơn so với các phương pháp khuếch tán truyền thống.
Để cải thiện chất lượng và tính thẩm mỹ của video tạo ra, mô hình được tinh chỉnh có giám sát bằng một tập nhỏ video được tuyển chọn thủ công với chú thích chất lượng cao. Điều này giống như một nghệ sĩ rèn giũa kỹ thuật dưới sự hướng dẫn của chuyên gia, dẫn tới đầu ra video hấp dẫn và chân thực hơn.
Mô hình Movie Gen Video cuối cùng được tạo bằng cách trung bình nhiều mô hình được huấn luyện với các bộ dữ liệu, siêu tham số và mốc tiền huấn luyện khác nhau. Kỹ thuật này giúp kết hợp thế mạnh của các mô hình khác nhau, mang lại hiệu năng ổn định và đáng tin cậy hơn.
Mô hình tạo video ở độ phân giải 768 pixel và dùng tăng mẫu để chuyển đổi độ phân giải lên full HD 1080p, cho ra video sắc nét và hấp dẫn hơn. Cách tiếp cận này thường được dùng vì hiệu quả tính toán, khi mô hình gốc xử lý ít token hơn mà vẫn tạo đầu ra độ phân giải cao.
Spatial Upsampler hoạt động như một mô hình tạo video-từ-video. Nó nhận video độ phân giải thấp làm đầu vào, tăng mẫu lên độ phân giải mục tiêu bằng nội suy song tuyến, sau đó mã hóa nó vào không gian ẩn bằng một Variational Autoencoder (VAE) theo từng khung hình.
Sau đó một mô hình không gian ẩn sẽ tạo các latent của video HD, có điều kiện dựa trên latent đã mã hóa của video độ phân giải thấp. Cuối cùng, bộ giải mã VAE biến đổi các latent video HD kết quả trở lại không gian điểm ảnh, tạo ra đầu ra độ phân giải cao cuối cùng.
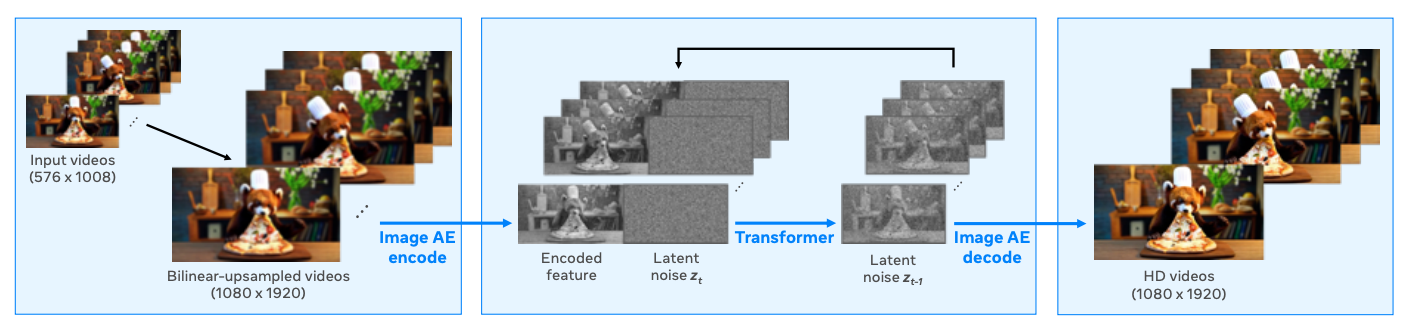
Nguồn: Bài báo nghiên cứu Movie Gen
Đánh giá mô hình văn bản-thành-video khó hơn văn bản-thành-hình ảnh do thêm chiều thời gian. Nhóm Meta sử dụng ba thước đo chính để đánh giá mô hình:
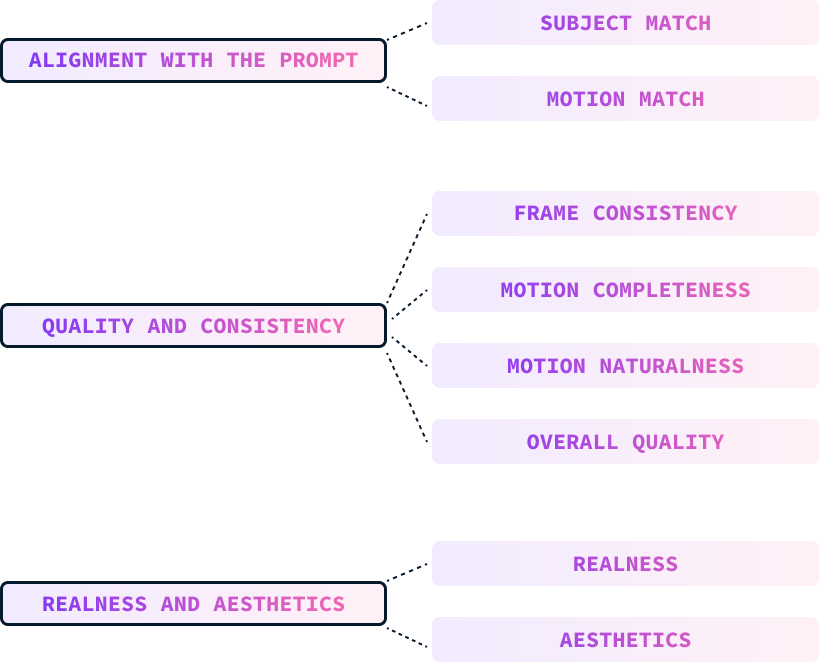
Các tham số này được đánh giá thủ công bởi con người, những người chấm điểm video theo các tham số đó.
Mức độ khớp với lời nhắc đo lường mức độ video tạo ra phù hợp với lời nhắc văn bản đầu vào, gồm mô tả về chủ thể, chuyển động, nền và chi tiết khác. Chỉ số này được chia nhỏ thành:
Chất lượng và tính nhất quán của video tạo ra được đánh giá độc lập với lời nhắc. Chỉ số này được chia thành:
Người đánh giá được yêu cầu chấm điểm khả năng của mô hình trong việc tạo video giống ảnh chụp thật và có tính thẩm mỹ cao. Tiêu chí này chia thành:
Bộ dữ liệu chuẩn được thiết kế để đánh giá việc tạo video một cách toàn diện. Nó gồm 1.000 lời nhắc bao quát nhiều khía cạnh kiểm thử như hoạt động của con người, động vật, thiên nhiên, vật lý và các chủ thể hay hoạt động bất thường.
Chuẩn của họ lớn hơn hơn ba lần so với các nghiên cứu trước. Mỗi lời nhắc được gắn mức độ chuyển động (cao, trung bình, thấp) để đánh giá chất lượng tạo theo cường độ chuyển động khác nhau.
Việc đánh giá sử dụng toàn bộ tập lời nhắc và xem xét các tiêu chí kiểm thử cụ thể, đặc biệt tập trung vào cách các mô hình xử lý chủ thể và chuyển động bất thường để kiểm tra khả năng khái quát hóa.
Biểu đồ sau cho thấy phân tích các lời nhắc được dùng trong đánh giá. Bên trái là phân bố các khái niệm của lời nhắc. Bên phải là các danh từ và động từ thường gặp trong lời nhắc (chữ càng to càng xuất hiện nhiều):
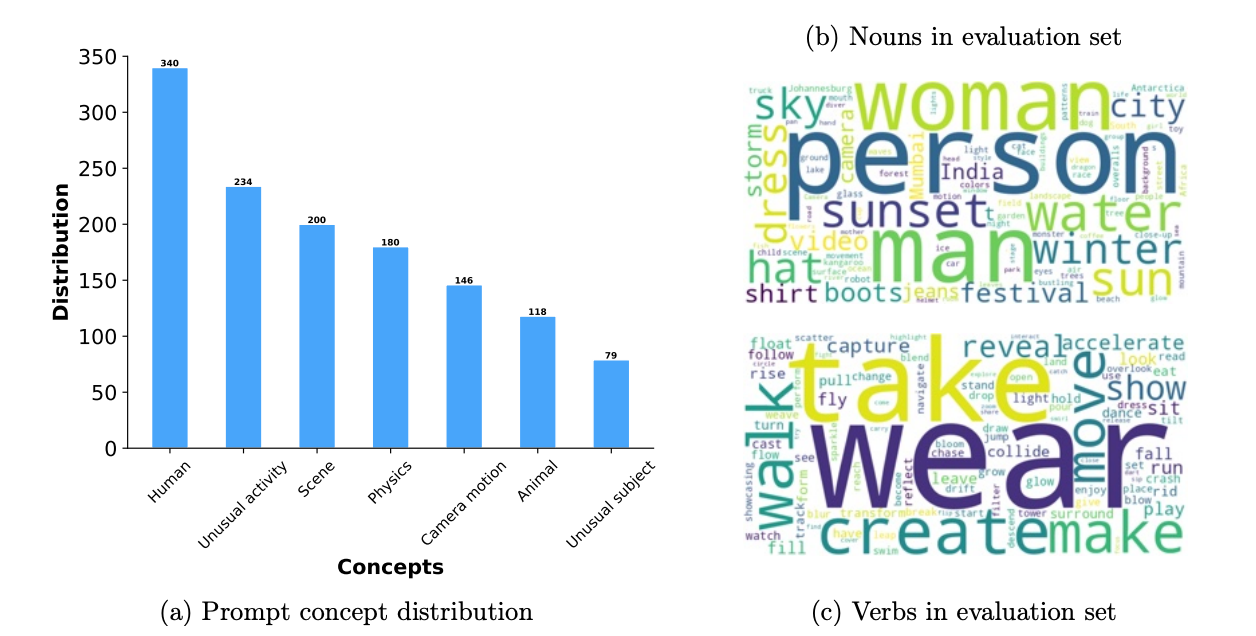
Nguồn: Bài báo nghiên cứu Movie Gen
Bảng dưới đây cho thấy kết quả đánh giá của con người đối với video do các mô hình khác nhau tạo ra theo nhiều tiêu chí. Các con số thể hiện tỷ lệ thắng ròng được tính là (Tỷ lệ thắng % - Tỷ lệ thua %). Phạm vi từ -100 (thua hoàn toàn) đến 100 (thắng hoàn toàn), 0 là hòa.
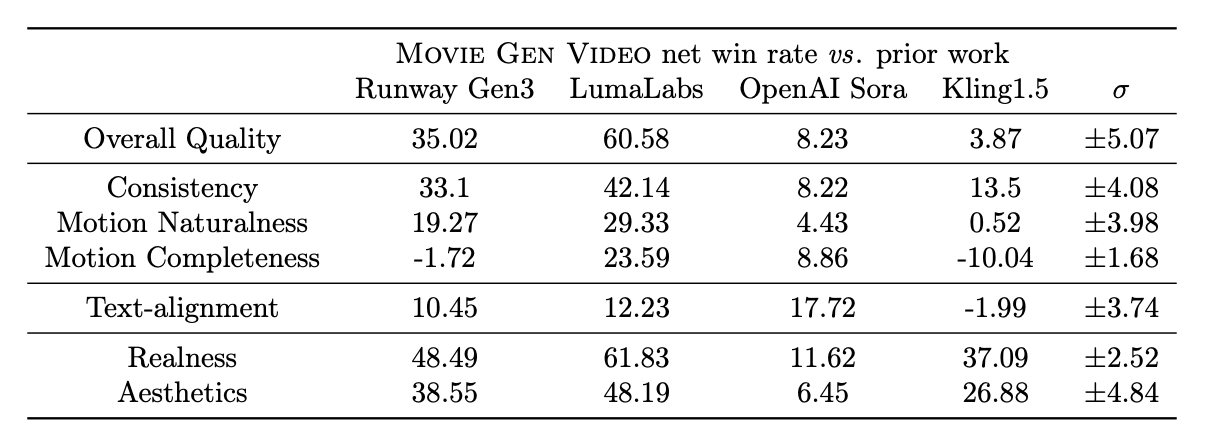
Nguồn: Bài báo nghiên cứu Movie Gen
Theo các thí nghiệm của họ, Movie Gen Video có hiệu năng mạnh trong tạo video từ văn bản, vượt trội một số mô hình hiện có, bao gồm các hệ thống thương mại như Runway Gen3 và LumaLabs, dựa trên đánh giá của con người bằng MovieGen Video Bench. Cụ thể, Movie Gen Video thể hiện ưu thế rõ rệt ở:
Trong khi MovieGen nhìn chung vượt trội so với các mô hình khác, đôi khi Kling1.5 tạo video có biên độ chuyển động lớn hơn, dù phải đánh đổi bằng méo hình và thiếu nhất quán. Điều này làm nổi bật sự đánh đổi giữa độ đầy đủ chuyển động và chất lượng hình ảnh, nơi Movie Gen Video ưu tiên tạo chuyển động chân thực và nhất quán thay vì chỉ tối đa hóa biên độ chuyển động.
Dưới đây là một số ảnh chụp màn hình từ buổi trình bày tại Meta Connect 2024 cho thấy vài ví dụ so sánh các lời nhắc tạo video:
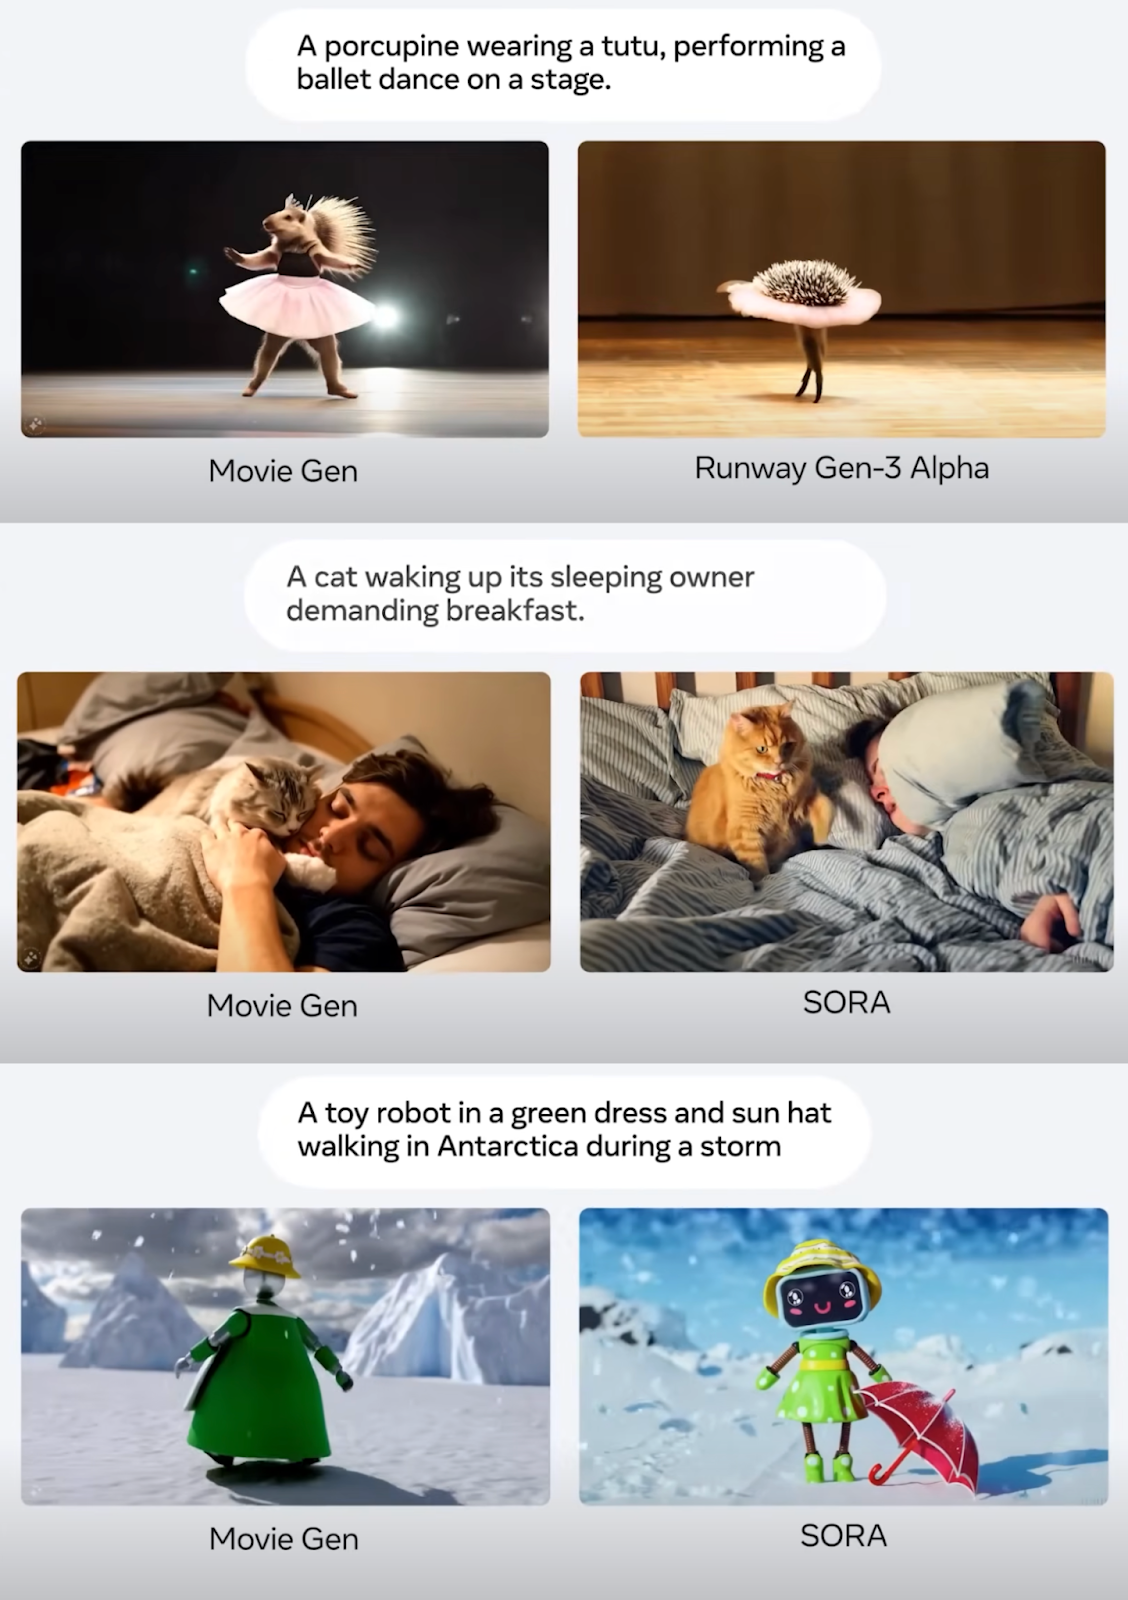
Nguồn: Bài báo nghiên cứu Movie Gen
Dưới đây là một số ví dụ so sánh về cá nhân hóa video, trong đó một bức ảnh được dùng để tạo video cá nhân hóa:
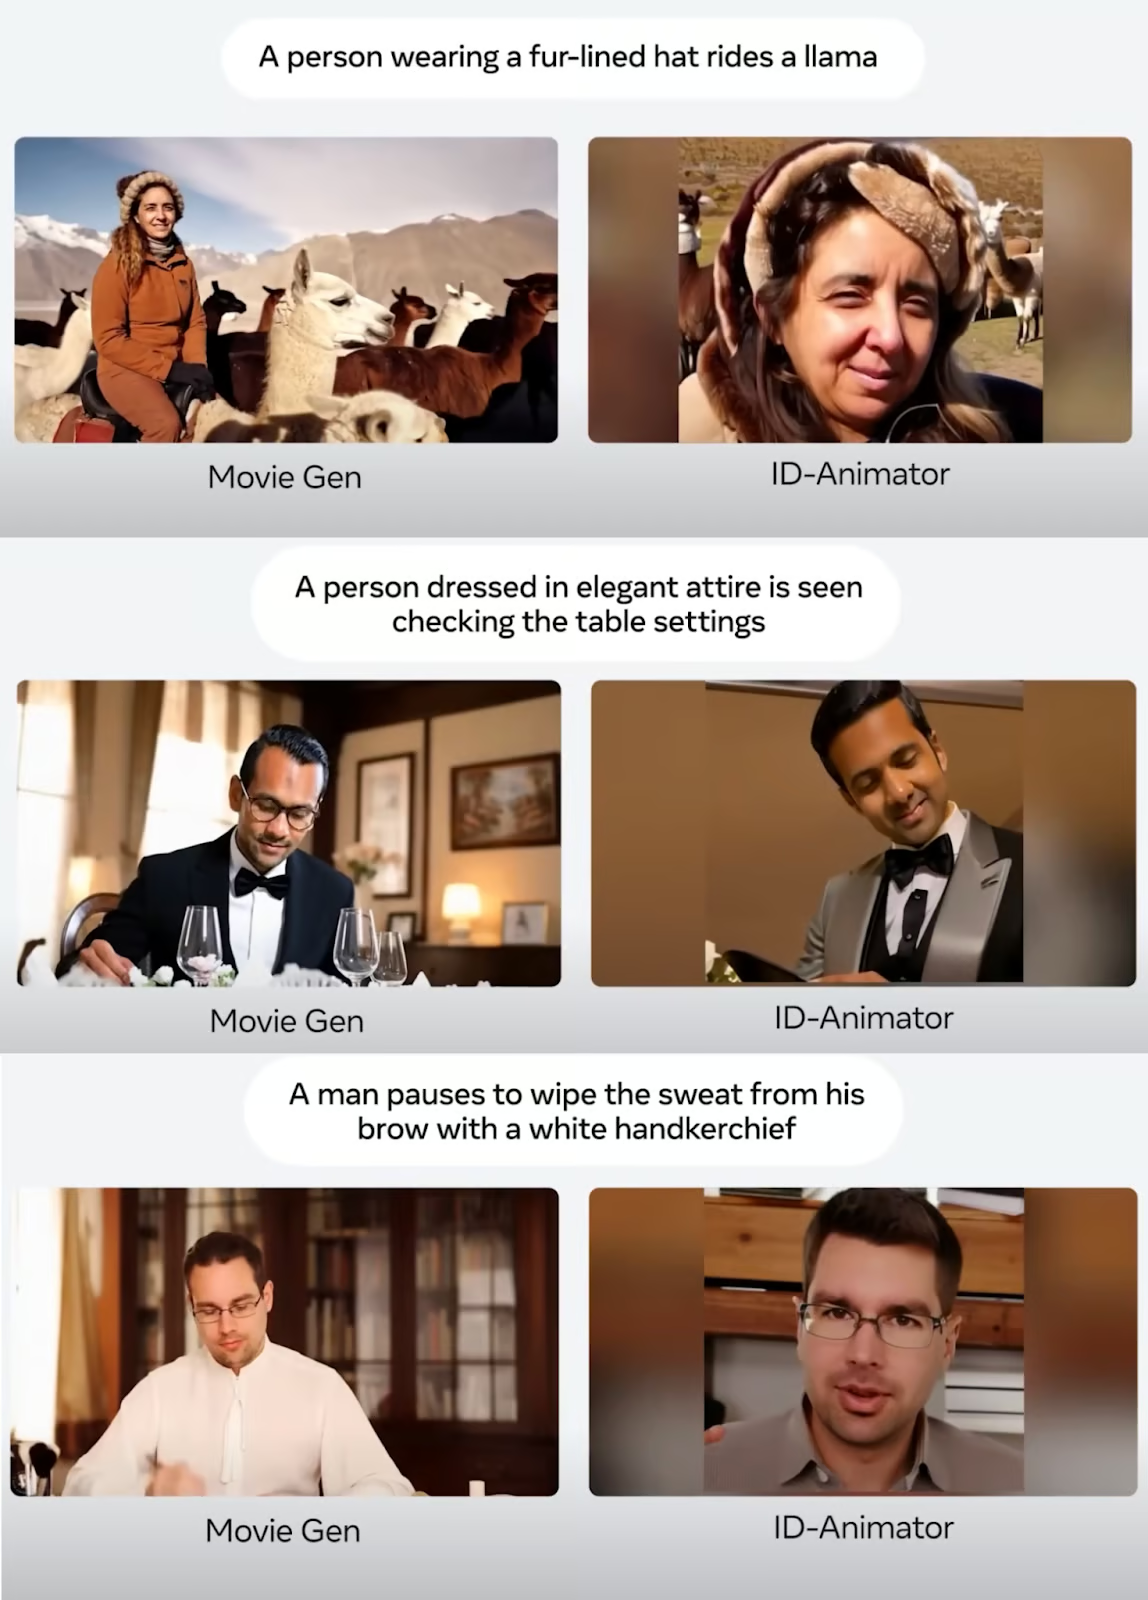
Nguồn: Bài báo nghiên cứu Movie Gen
Cuối cùng, các ảnh chụp màn hình dưới đây cho thấy ví dụ so sánh về chỉnh sửa video:
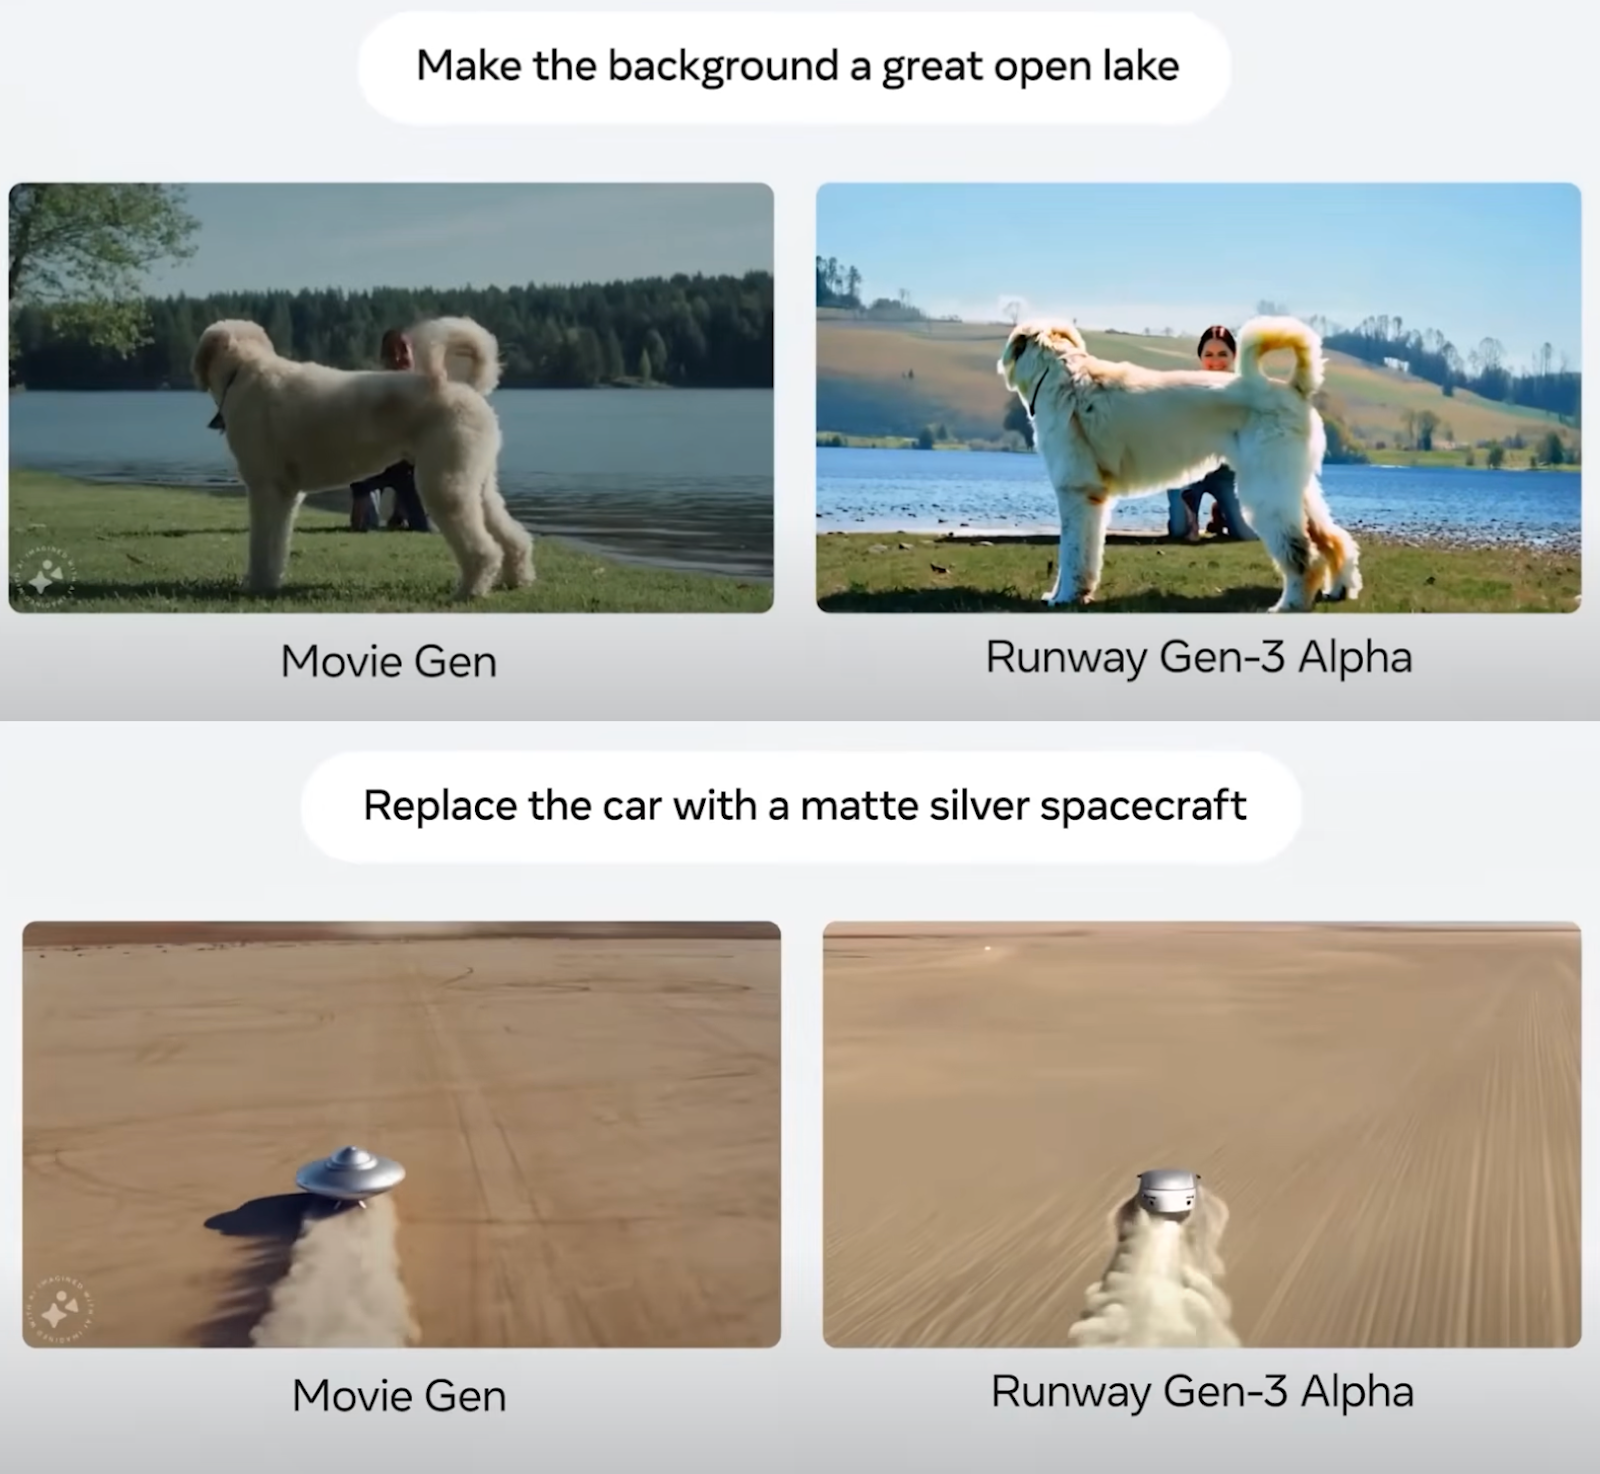
Nguồn: Bài báo nghiên cứu Movie Gen
Tổng thể, có vẻ Meta Movie Gen đã nâng tiêu chuẩn và đặt ra chuẩn mực mới cho các mô hình văn bản-thành-video. Quy trình đánh giá được nêu trong bài báo có vẻ công bằng nhưng dĩ nhiên, khó có thể chắc chắn trừ khi các mô hình này được phát hành công khai và bên thứ ba trung lập có thể so sánh.
Dù Meta Movie Gen thể hiện rất tốt trong tạo phương tiện, vẫn còn những điểm cần cải thiện.
Mô hình đôi khi gặp khó với cảnh phức tạp liên quan đến hình học tinh vi, thao tác đối tượng và mô phỏng vật lý chân thực. Ví dụ, tạo tương tác thuyết phục giữa các đối tượng, mô tả chính xác biến đổi trạng thái (như tan chảy hoặc vỡ vụn), và mô phỏng thực tế tác động của trọng lực hay va chạm vẫn có thể là thách thức.
Đồng bộ âm thanh có thể gặp vấn đề trong một số tình huống. Cụ thể, khi xử lý chuyển động nhỏ về mặt thị giác, bị che khuất, hoặc đòi hỏi mức độ hiểu thị giác cao để tạo âm thanh tương ứng, các mô hình có thể khó đạt đồng bộ hoàn hảo. Ví dụ thách thức gồm đồng bộ chính xác tiếng bước chân với người đi bộ, tạo âm thanh phù hợp cho các vật thể bị che khuất một phần, và nhận biết những cử động tay tinh tế trên đàn guitar để phát ra nốt nhạc đúng.
Ngoài ra, mô hình Movie Gen Audio hiện tại chưa hỗ trợ tạo giọng nói.
Các video do AI tạo ra một cách chân thực mang đến nhiều rủi ro và thách thức đạo đức cần được cân nhắc. Những rủi ro này bao gồm thao túng niềm tin và lan truyền thông tin sai lệch qua deepfake, có thể làm tổn hại danh tiếng, đánh lừa công chúng và gây hại cho doanh nghiệp.
Một mặt, đây có thể là tính năng Instagram cho phép tôi tạo video hay ho có mặt tôi để chia sẻ với bạn bè, nhưng mặt khác, chính tính năng đó cũng khiến tôi có thể tạo video giả về người khác. Khi những công nghệ này tiến bộ, có thể sẽ không thể phân biệt chúng với đồ thật.
Nội dung do AI tạo ra cũng đặt ra mối đe dọa về quyền riêng tư, tiềm ẩn nguy cơ tống tiền, tống tụ và bắt nạt trên mạng.
Hơn nữa, các công cụ AI này có thể làm suy yếu nghệ thuật và bản quyền bằng cách bắt chước phong cách nghệ thuật độc đáo mà không ghi công. Giải pháp bao gồm nâng cao nhận thức và giáo dục về hiểu biết truyền thông, đầu tư vào công nghệ phát hiện, thiết lập các khuôn khổ pháp lý và đạo đức, cũng như dùng watermark để xác thực.
Dù tạo video bằng AI có tiềm năng lớn, cần xử lý cẩn trọng để duy trì niềm tin và tính xác thực.
Meta khá cởi mở với các phát triển AI khi mã nguồn mở các mô hình Llama. Tuy nhiên, vì lý do an toàn, các mô hình Meta Movie Gen sẽ chưa được phát hành. Theo bài viết của họ, cần nhiều cải tiến và cân nhắc an toàn trước khi triển khai.
Trong bài viết này, chúng tôi đã giới thiệu các mô hình Movie Gen của Meta, một bộ mô hình AI để tạo và chỉnh sửa video bằng lời nhắc văn bản.
Chúng tôi đã khám phá bốn mô hình riêng biệt, khả năng của chúng và cách chúng hoạt động. Qua phân tích so sánh, chúng tôi cho thấy Meta Movie Gen sánh vai với các công cụ tạo video AI khác như thế nào.
Dù Meta Movie Gen đã đặt ra chuẩn mực mới trong lĩnh vực này, nguy cơ lạm dụng công nghệ vẫn gây lo ngại đáng kể. Meta đã thừa nhận các rủi ro này và đang thận trọng trong việc phát hành các mô hình.
Để tìm hiểu thêm về hệ sinh thái Meta AI, tôi khuyến nghị các blog sau:
Học AI với các khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
