
Kursus
Bekerja dengan Llama 3
2 jam
15.5K
Meta baru-baru ini merilis Meta Movie Gen, sebuah peristiwa yang signifikan sekaligus agak tak terduga dalam lanskap generasi teks-ke-video—saya rasa Meta tidak masuk dalam radar banyak orang untuk urusan generasi video.
Mengingat lingkungan yang kompetitif, dengan beberapa perusahaan profil tinggi seperti OpenAI yang sudah mengerjakan model tangguh seperti Sora, rilis Meta patut dicatat.
Model ini berkinerja baik di berbagai tugas, melampaui atau menyamai kualitas penawaran dari para pemain mapan seperti Runway Gen3, LumaLabs, dan, khususnya, Sora dari OpenAI.
Dalam blog ini, saya akan membahas apa itu Meta Movie Gen, cara kerjanya, kemampuan serta keterbatasannya, dan pertimbangan keamanan seputar penggunaannya.
Jika Anda ingin mendapatkan gambaran umum tentang bidang generasi video, saya menyarankan untuk membaca artikel ini tentang generator video AI terbaik.
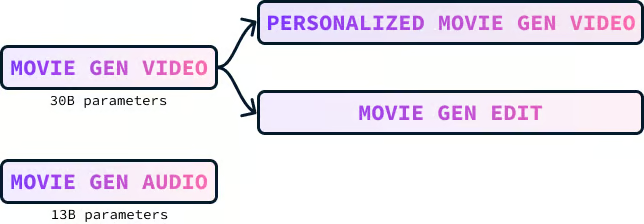
Meta Movie Gen adalah kumpulan model fondasi untuk menghasilkan berbagai jenis media, termasuk teks-ke-video, teks-ke-audio, dan teks-ke-gambar. Paket ini terdiri dari empat model:
Movie Gen Video adalah model dengan 30 miliar parameter yang dirancang untuk membuat gambar dan video berdasarkan deskripsi teks. Model ini dapat menghasilkan video berkualitas tinggi hingga 16 detik yang sesuai dengan prompt teks yang diberikan. Ia dapat menghasilkan konten dalam berbagai ukuran, resolusi, dan durasi.
Berikut contoh video yang dihasilkan dengan prompt:
“Seekor kukang dengan kacamata hitam merah muda berbaring di pelampung donat di kolam. Kukang itu memegang minuman tropis. Dunianya bernuansa tropis. Sinar matahari menimbulkan bayangan.”
Model ini berpotensi merevolusi alur kerja penyuntingan video di berbagai industri. Kemampuannya untuk secara akurat memahami dan mengeksekusi instruksi penyuntingan berbasis teks dapat meningkatkan proses penyuntingan secara signifikan, menjadikannya lebih cepat, efisien, dan mudah diakses oleh lebih banyak pengguna. Teknologi ini dapat menguntungkan pembuat film, kreator konten, pendidik, dan siapa pun yang bekerja dengan konten video.
Pelatihan model Movie Gen Video melibatkan beberapa komponen kunci: pengumpulan dan penyiapan data, proses pelatihan itu sendiri, fine-tuning untuk peningkatan kualitas, serta teknik upsampling yang digunakan untuk mencapai keluaran beresolusi tinggi.
Model Movie Gen Video dilatih pada dataset masif yang berisi ratusan juta pasangan video-teks dan lebih dari satu miliar pasangan gambar-teks.
Setiap video dalam dataset menjalani proses kurasi ketat yang melibatkan penyaringan untuk kualitas visual, karakteristik gerak, dan relevansi konten. Proses penyaringan bertujuan memilih video dengan gerakan non-sepele, pengambilan gambar satu bidikan, dan ragam konsep yang luas, termasuk porsi signifikan yang menampilkan manusia.
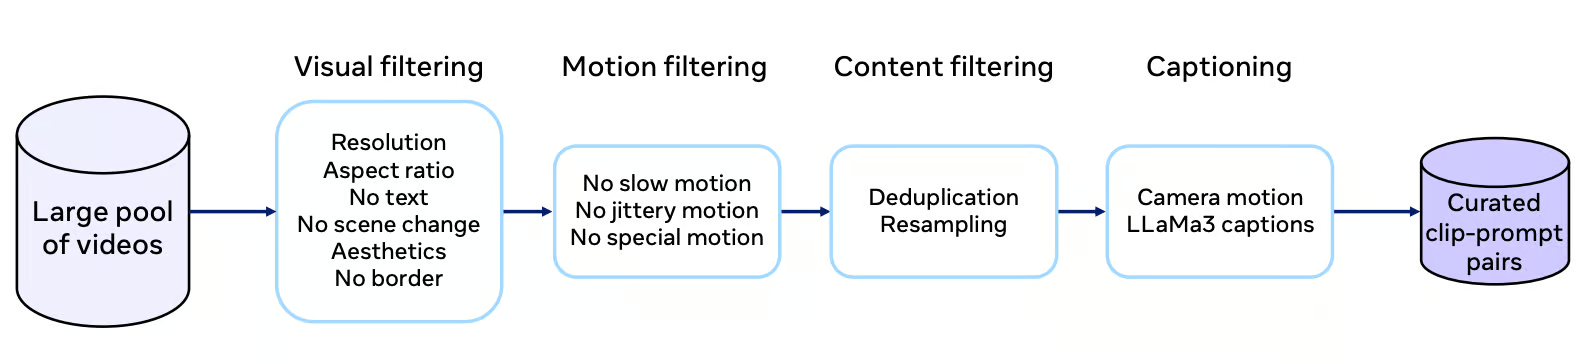
Sumber: Makalah riset Movie Gen
Keterangan (caption) berkualitas tinggi sangat penting untuk melatih model secara efektif. Movie Gen Video menggunakan model LLaMa3-Video untuk menghasilkan keterangan mendetail yang secara akurat menggambarkan konten video. Keterangan ini melampaui sekadar pelabelan objek; mencakup deskripsi aksi, pergerakan kamera, hingga informasi pencahayaan. Informasi tekstual yang kaya ini membantu model mempelajari pemahaman yang lebih bernuansa tentang penceritaan visual.
Proses pelatihan untuk Movie Gen Video dibagi menjadi beberapa tahap guna meningkatkan efisiensi dan skalabilitas model.
Model terlebih dahulu dilatih pada tugas teks-ke-gambar menggunakan gambar beresolusi lebih rendah. Fase "pemanasan" ini memungkinkan model mempelajari konsep visual dasar sebelum menangani tugas yang lebih kompleks, yaitu generasi video.
Model kemudian dilatih secara bersama pada tugas teks-ke-gambar dan teks-ke-video, dengan peningkatan bertahap pada resolusi data masukan. Pendekatan pelatihan bersama ini membantu model memanfaatkan kelimpahan dan keragaman dataset gambar-teks sekaligus mempelajari kompleksitas generasi video.
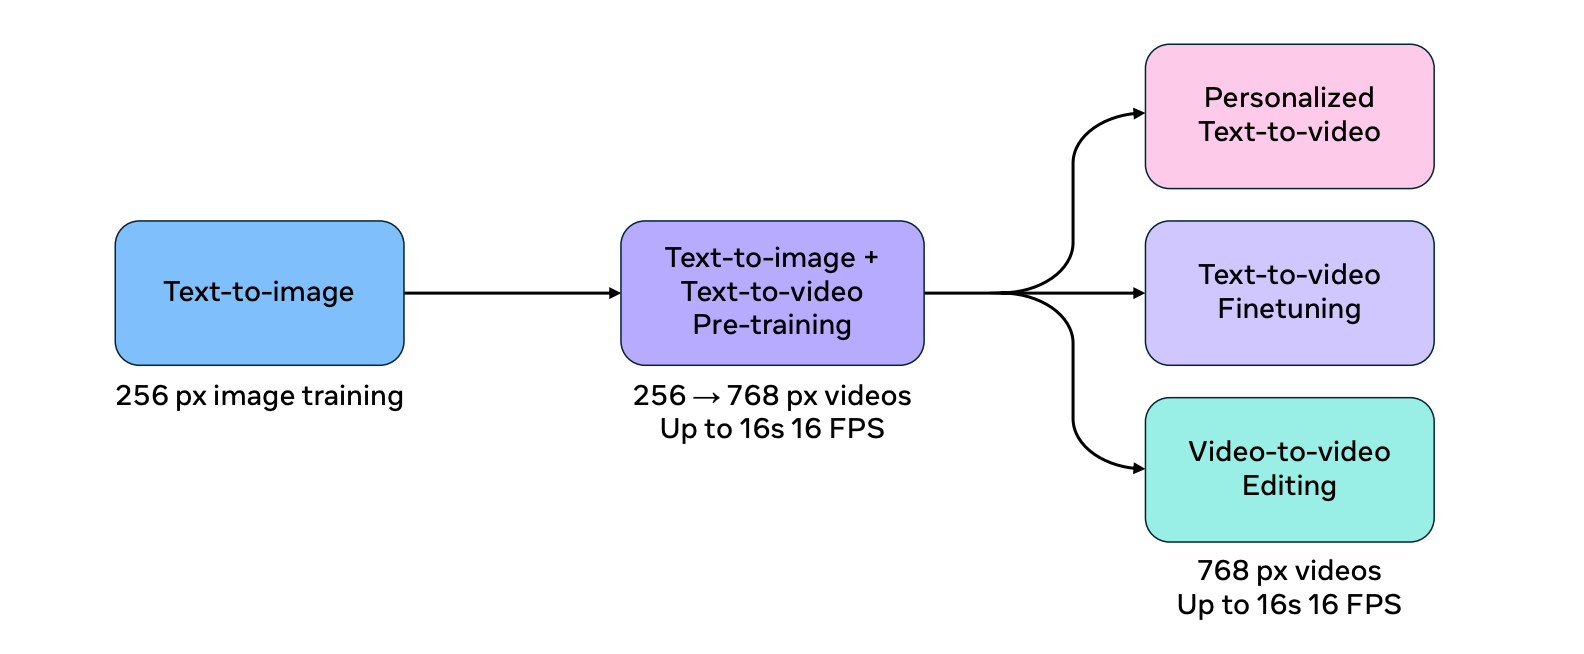
Sumber: Makalah riset Movie Gen
Untuk menangani tuntutan komputasi data video, Movie Gen Video menggunakan model Temporal Autoencoder (TAE) untuk mengompresi dan mendekompr esi video secara temporal. Ini dianalogikan dengan men-zip dan mengekstrak file di komputer, memungkinkan model bekerja dengan representasi data video yang lebih mudah ditangani.
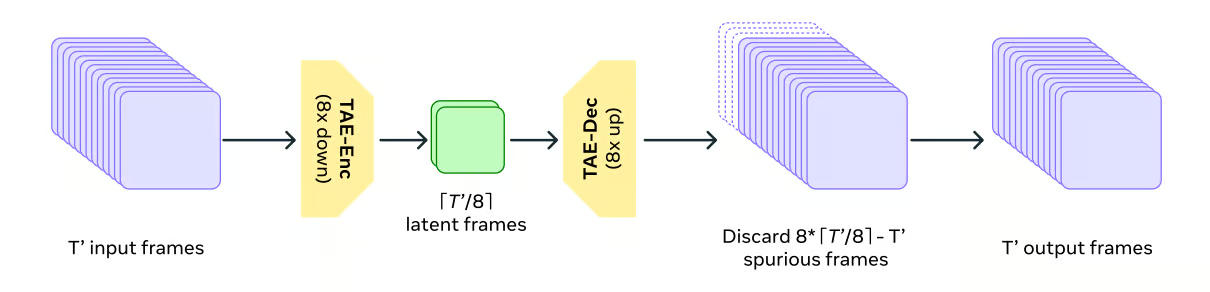
Sumber: Makalah riset Movie Gen
Movie Gen Video menggunakan tujuan pelatihan yang disebut Flow Matching. Alih-alih langsung menghasilkan video akhir, flow matching membimbing model untuk secara bertahap mengubah sampel noise acak menjadi keluaran video yang diinginkan, selangkah demi selangkah.
Flow Matching melibatkan prediksi kecepatan sampel di ruang laten alih-alih langsung memprediksi sampelnya. Metode ini lebih efisien dan berkinerja lebih baik dibandingkan metode difusi tradisional.
Untuk meningkatkan kualitas dan estetika video yang dihasilkan, model menjalani fine-tuning terawasi menggunakan kumpulan video terkurasi secara manual dengan keterangan berkualitas tinggi. Ini ibarat seniman yang menyempurnakan tekniknya melalui bimbingan ahli, menghasilkan keluaran video yang lebih menarik secara visual dan realistis.
Model Movie Gen Video final dibuat dengan merata-ratakan beberapa model yang dilatih dengan dataset, hiperparameter, dan titik pemeriksaan prapelatihan yang berbeda. Teknik ini membantu menggabungkan kekuatan berbagai model, menghasilkan performa yang lebih tangguh dan andal.
Model menghasilkan video pada resolusi 768 piksel dan menggunakan upsampling untuk menaikkan resolusi ke full HD 1080p, menghasilkan video yang lebih tajam dan lebih menarik secara visual. Pendekatan ini lazim digunakan karena memberikan solusi yang efisien secara komputasi mengingat model dasar dapat memproses lebih sedikit token namun tetap menghasilkan keluaran beresolusi tinggi.
Spatial Upsampler berfungsi sebagai model video-ke-video. Ia mengambil video beresolusi lebih rendah sebagai masukan, meningkatkan resolusinya ke target menggunakan interpolasi bilinear, lalu mengkodekannya ke ruang laten menggunakan Variational Autoencoder (VAE) per bingkai.
Model ruang laten kemudian menghasilkan laten video HD yang dikondisikan pada laten terenkode dari video beresolusi lebih rendah. Terakhir, dekoder VAE mengubah laten video HD tersebut kembali ke ruang piksel, menghasilkan keluaran akhir beresolusi tinggi.
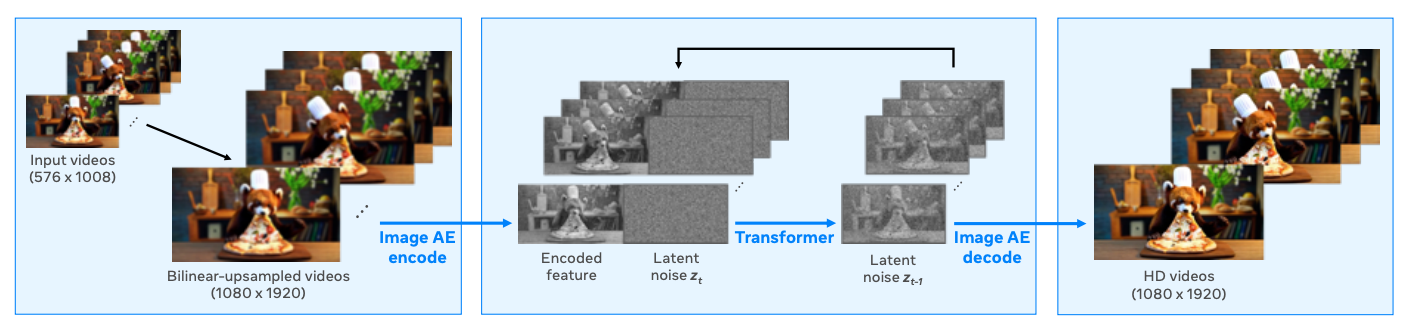
Sumber: Makalah riset Movie Gen
Mengevaluasi model teks-ke-video lebih menantang dibandingkan teks-ke-gambar karena adanya dimensi temporal. Tim Meta menggunakan tiga ukuran utama untuk mengevaluasi model:
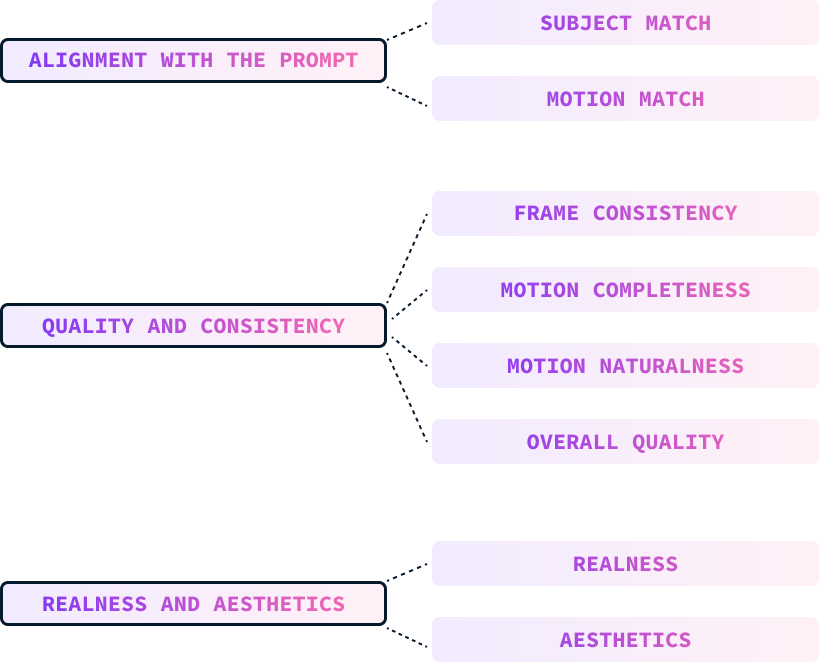
Parameter-parameter ini dievaluasi secara manual oleh manusia yang memberi nilai pada video sesuai parameter tersebut.
Kesesuaian prompt mengukur seberapa baik video yang dihasilkan cocok dengan prompt teks masukan, termasuk deskripsi subjek, gerakan, latar, dan detail lain. Ini diuraikan lebih lanjut menjadi:
Kualitas dan konsistensi video yang dihasilkan dievaluasi terlepas dari prompt teks. Ukuran ini dipecah menjadi:
Para evaluator diminta menilai kemampuan model dalam menghasilkan video yang fotorealistik dan sedap dipandang. Kriteria ini dibagi menjadi:
Data tolok ukur dirancang untuk mengevaluasi generasi video secara komprehensif. Terdiri dari 1.000 prompt yang mencakup berbagai aspek pengujian, seperti aktivitas manusia, hewan, alam, fisika, dan subjek atau aktivitas yang tidak biasa.
Tolok ukur mereka lebih dari tiga kali lebih besar dibandingkan yang digunakan dalam studi sebelumnya. Setiap prompt diberi tag tingkat gerak (tinggi, sedang, rendah) untuk menilai kualitas generasi pada intensitas gerak yang berbeda.
Evaluasi menggunakan seluruh set prompt dan menelaah metrik pengujian spesifik, dengan fokus khusus pada seberapa baik model menangani subjek dan gerak yang tidak biasa untuk menguji kemampuan generalisasi.
Diagram berikut menunjukkan rincian prompt yang digunakan dalam evaluasi. Di kiri, kita diberi distribusi konsep dari prompt. Di kanan, kita melihat nomina dan verba umum yang digunakan dalam prompt (semakin besar kata, semakin sering kemunculannya):
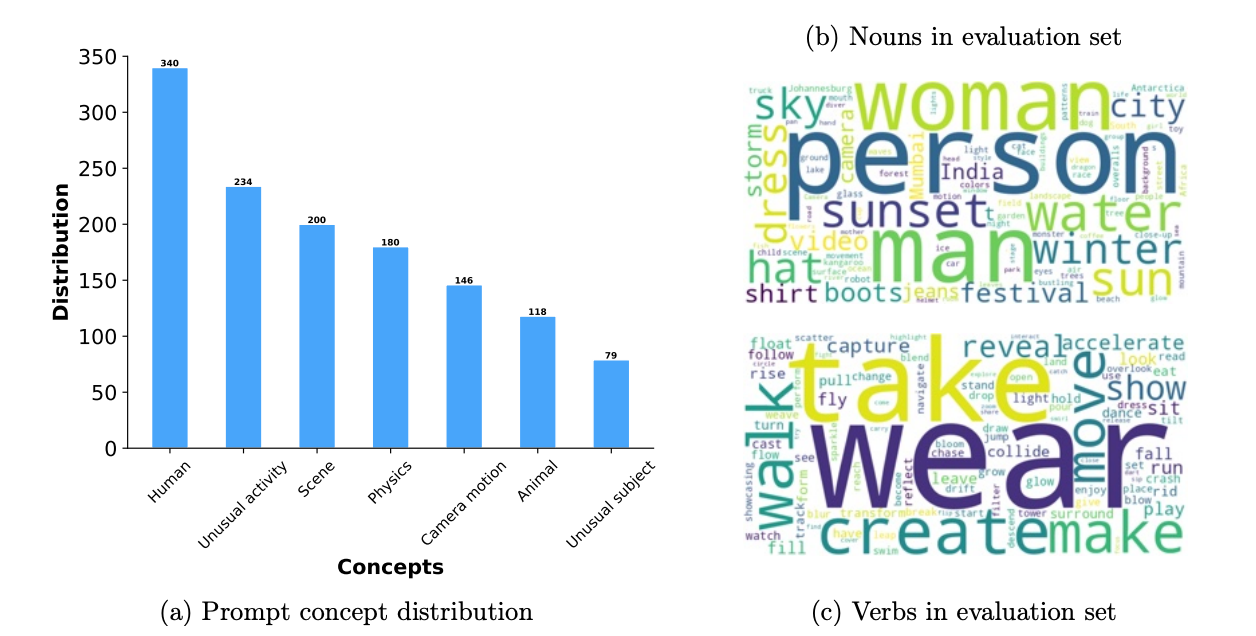
Sumber: Makalah riset Movie Gen
Tabel di bawah menunjukkan hasil evaluasi manusia atas video yang dihasilkan oleh model berbeda pada beberapa kriteria evaluasi. Angka mewakili tingkat kemenangan bersih yang dihitung sebagai (Persen Menang - Persen Kalah). Rentangnya dari -100 (kalah total) hingga 100 (menang total), dengan 0 menunjukkan seri.
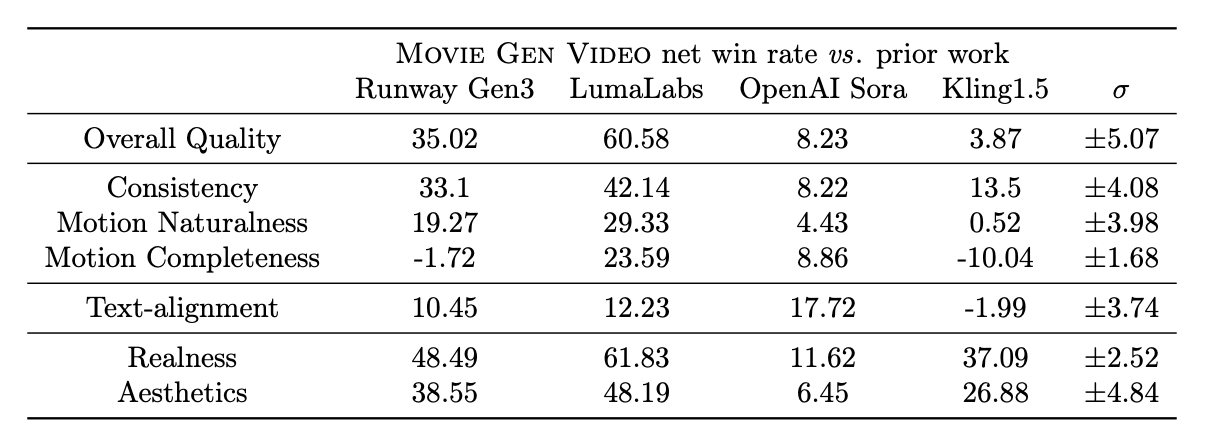
Sumber: Makalah riset Movie Gen
Menurut eksperimen mereka, Movie Gen Video memiliki performa kuat dalam generasi teks-ke-video, melampaui beberapa model yang ada, termasuk sistem komersial seperti Runway Gen3 dan LumaLabs, berdasarkan evaluasi manusia menggunakan MovieGen Video Bench. Secara khusus, Movie Gen Video menunjukkan keunggulan signifikan dalam:
Meskipun MovieGen umumnya melampaui model lain, Kling1.5 kadang menghasilkan video dengan magnitudo gerak lebih besar, meski dengan konsekuensi distorsi dan inkonsistensi. Ini menyoroti pertukaran antara kelengkapan gerak dan kualitas visual, di mana Movie Gen Video memprioritaskan menghasilkan gerak yang realistis dan konsisten daripada sekadar memaksimalkan besaran gerak.
Di bawah ini beberapa cuplikan dari presentasi Meta Connect 2024 yang menampilkan beberapa contoh perbandingan prompt generasi video:
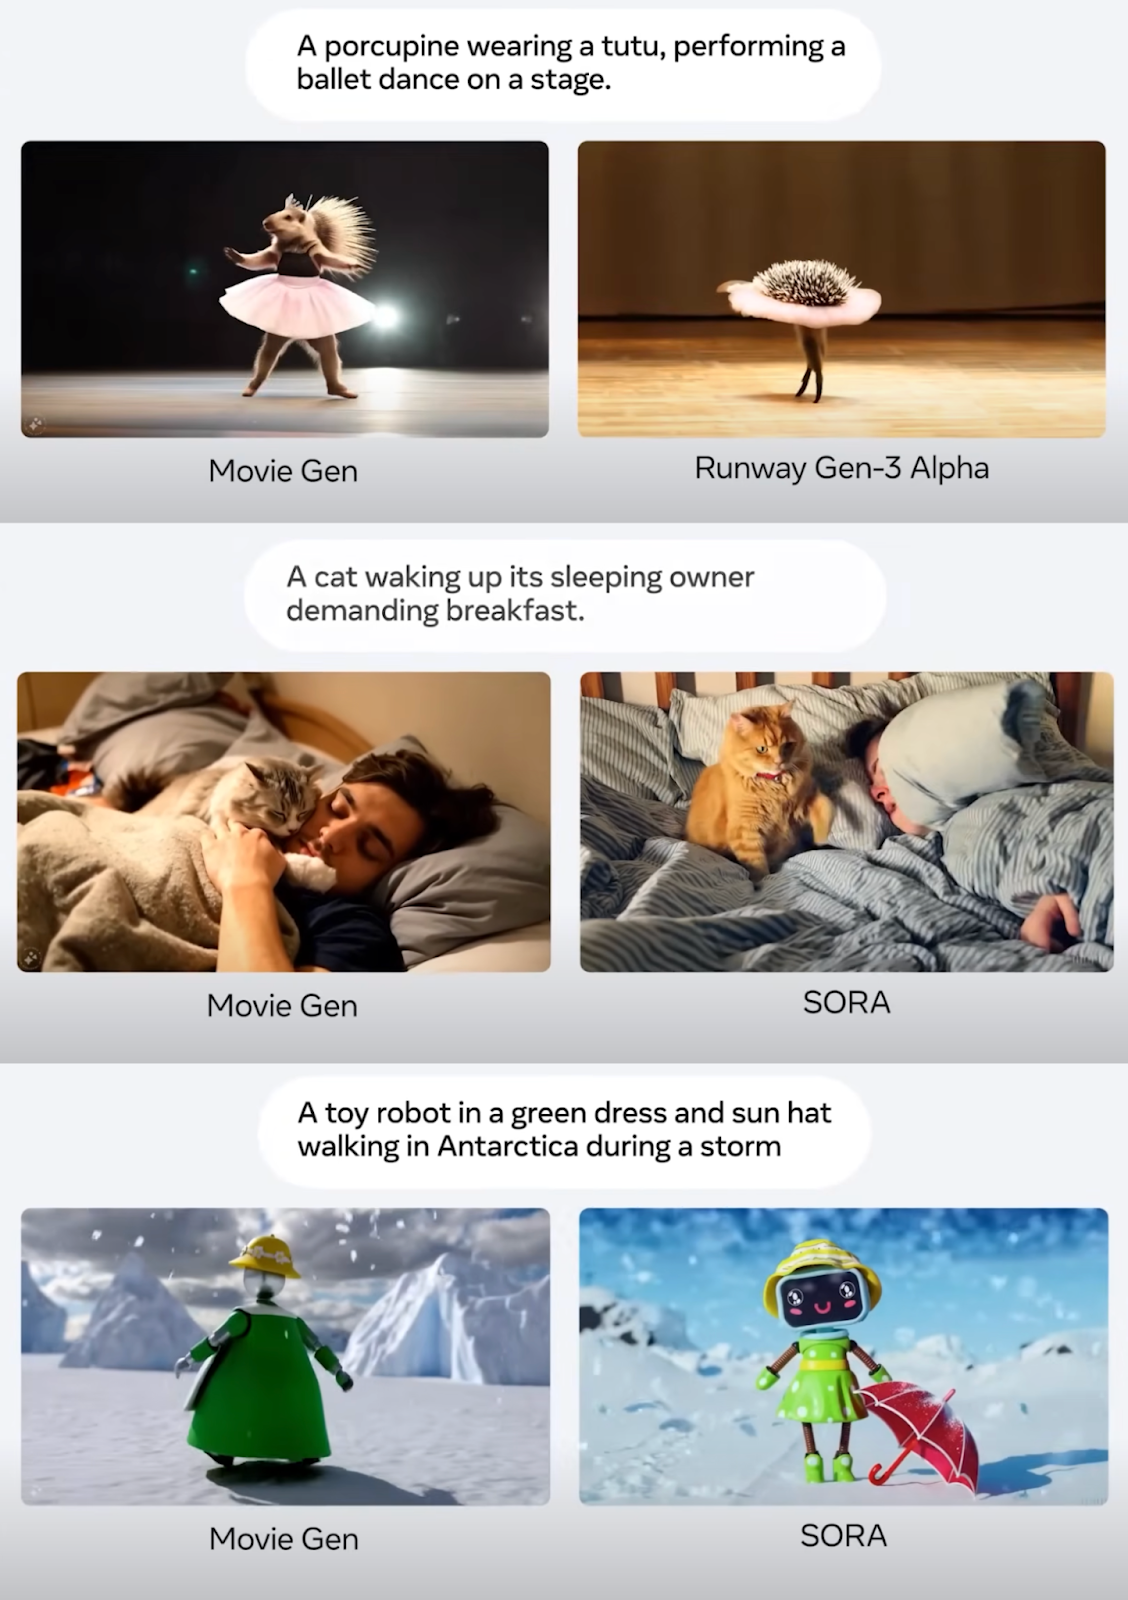
Sumber: Makalah riset Movie Gen
Berikut beberapa contoh perbandingan personalisasi video di mana sebuah foto digunakan untuk menghasilkan video yang dipersonalisasi:
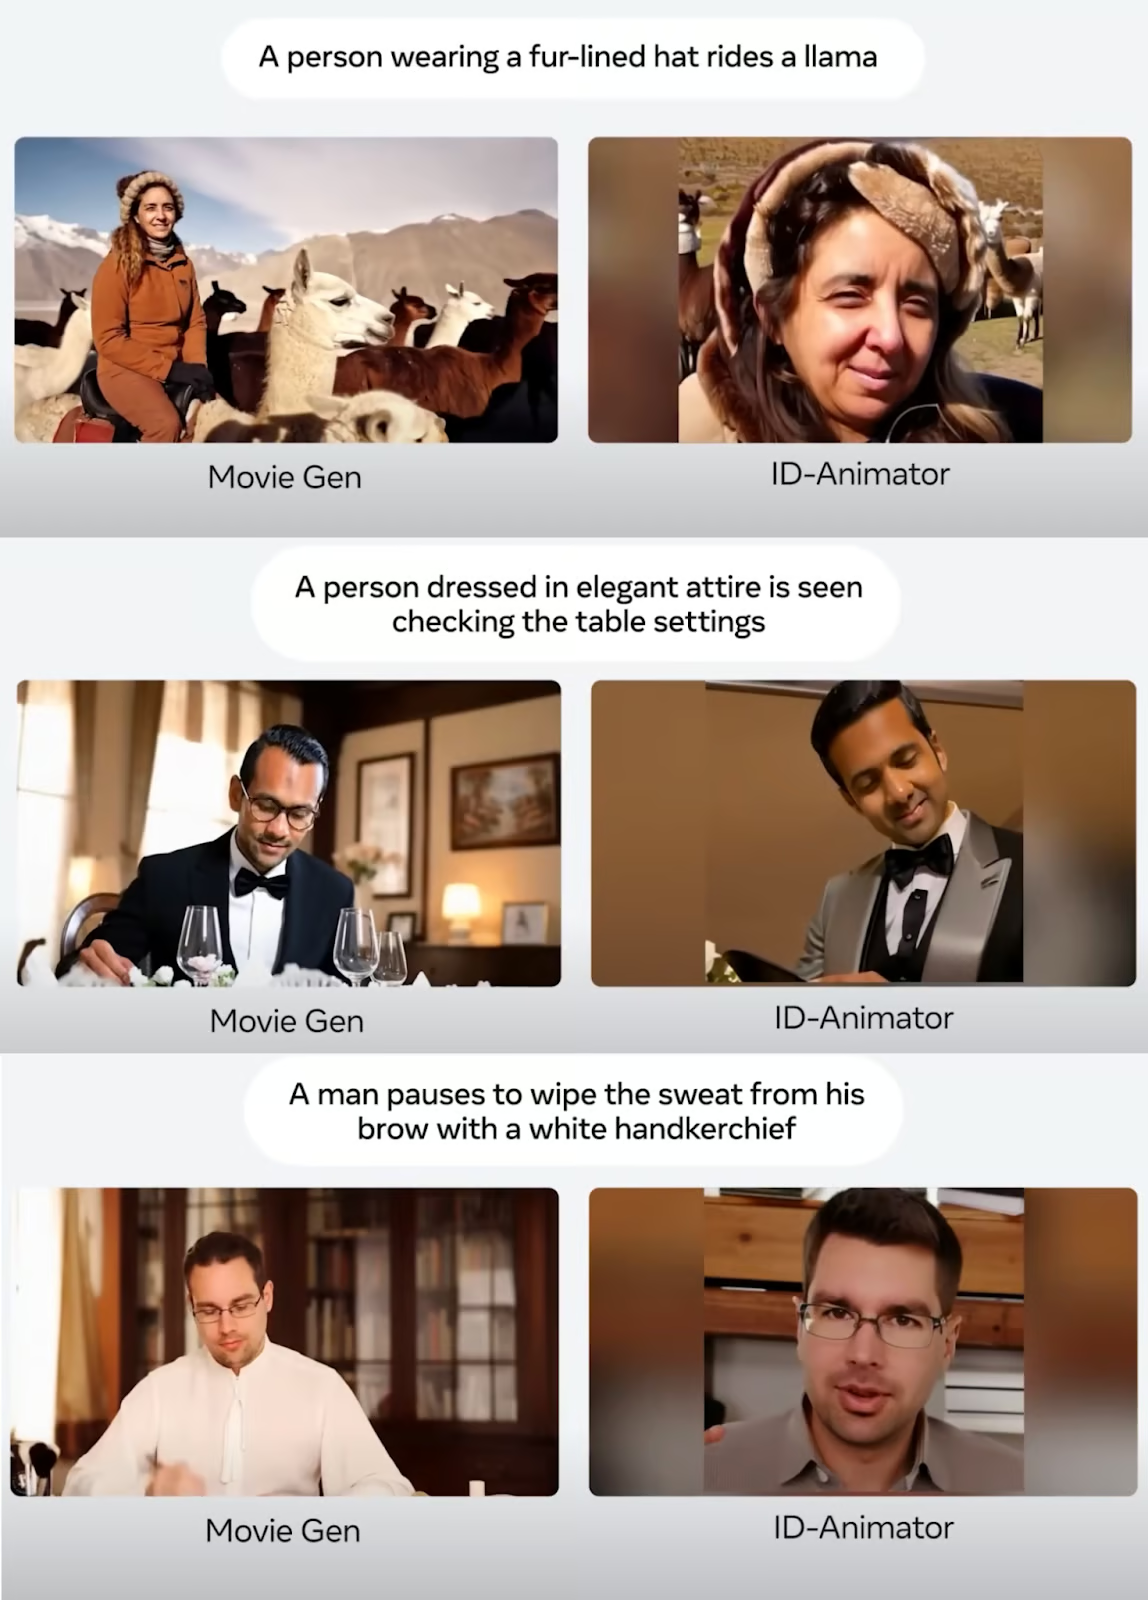
Sumber: Makalah riset Movie Gen
Terakhir, cuplikan di bawah menampilkan contoh perbandingan penyuntingan video:
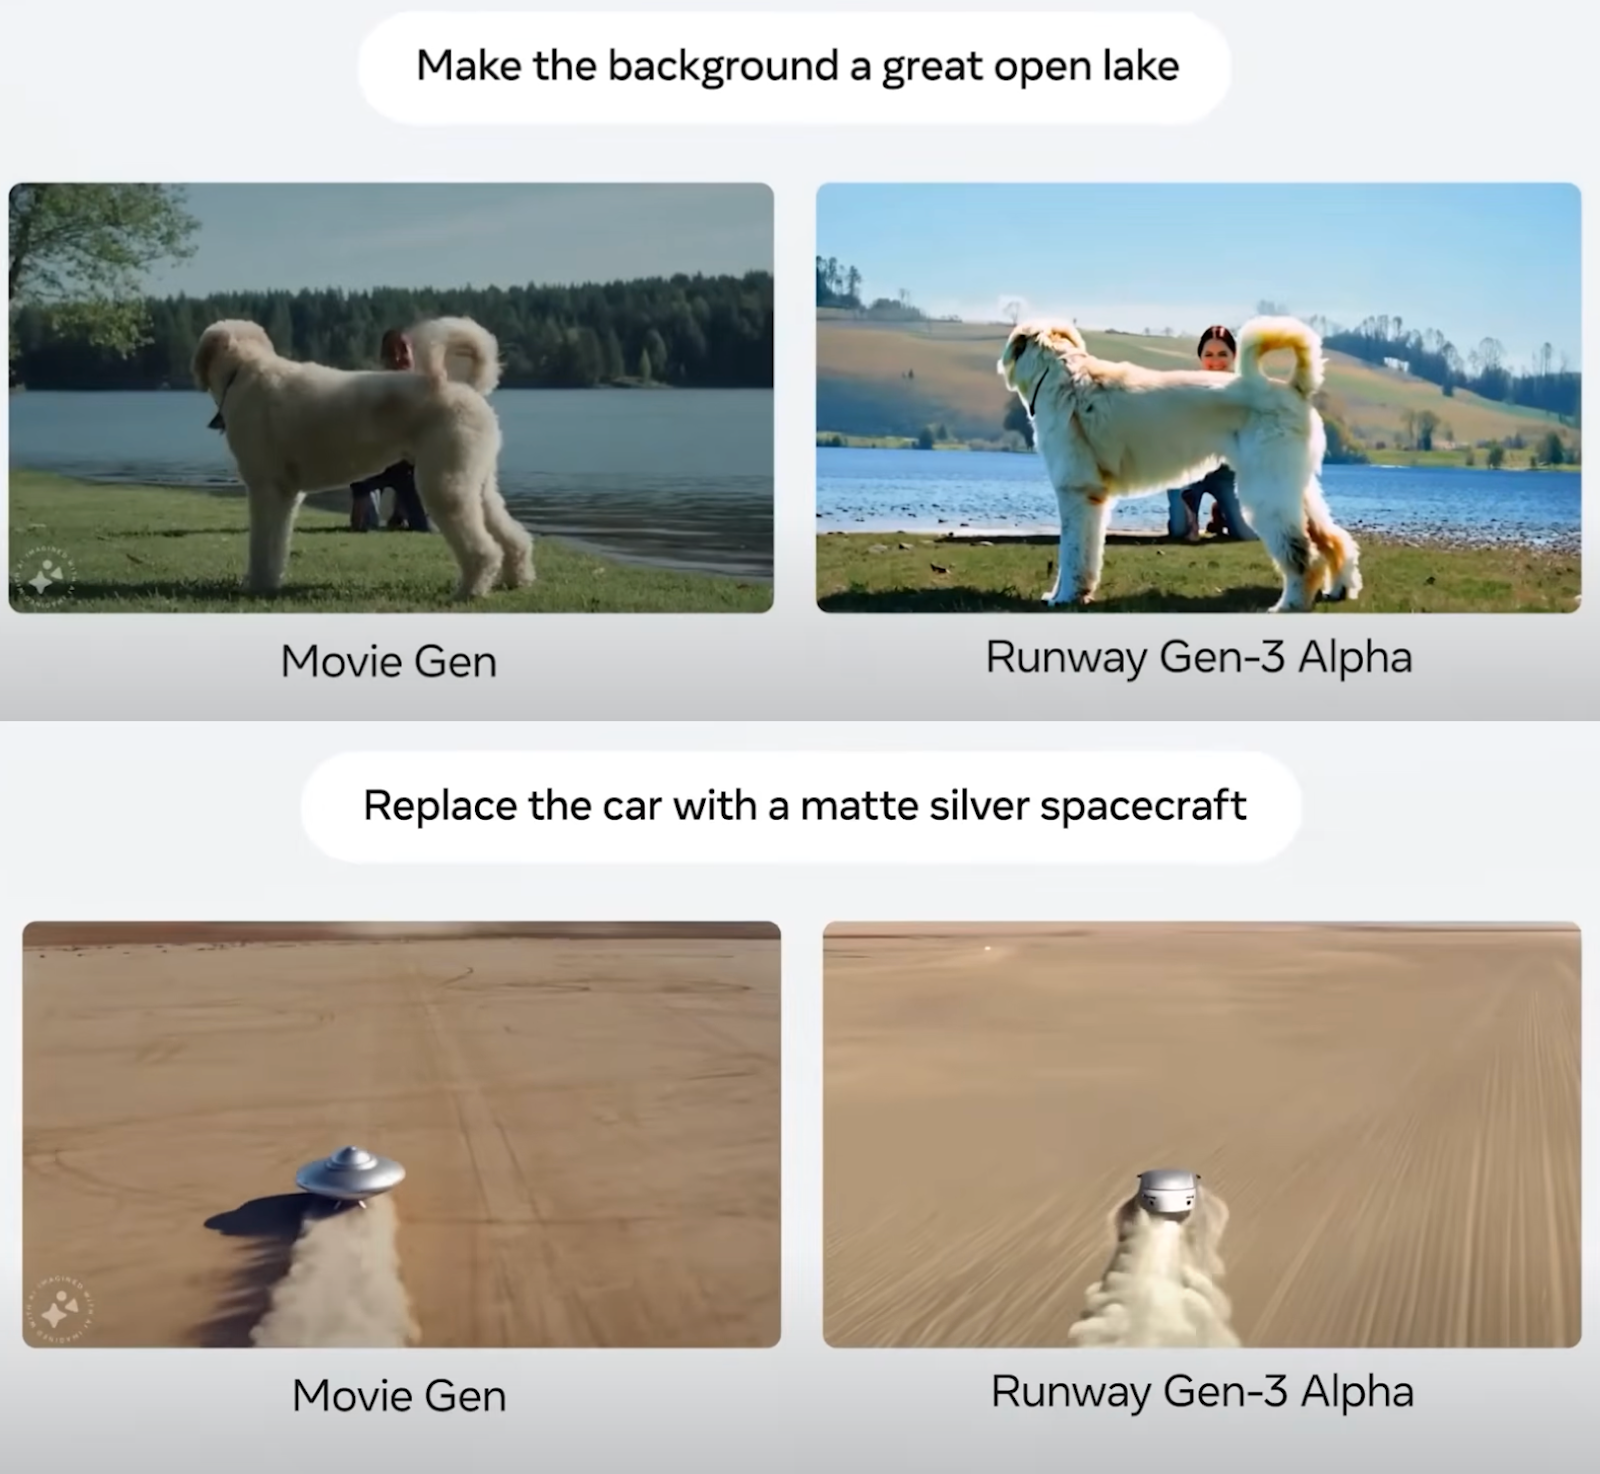
Sumber: Makalah riset Movie Gen
Secara keseluruhan, tampaknya Meta Movie Gen mendorong batas dan menetapkan standar baru pada model teks-ke-video. Prosedur evaluasi yang disorot dalam makalah tampak adil, tetapi tentu saja, sulit untuk memastikan hingga model-model ini tersedia untuk publik dan pihak ketiga yang netral dapat membandingkannya.
Meskipun Meta Movie Gen terlihat unggul dalam generasi media, masih ada area yang perlu ditingkatkan.
Model terkadang kesulitan dengan adegan kompleks yang melibatkan geometri rumit, manipulasi objek, dan simulasi fisika yang realistis. Misalnya, menghasilkan interaksi antarbenda yang meyakinkan, menggambarkan transformasi keadaan secara akurat (seperti meleleh atau pecah), dan mensimulasikan efek gravitasi atau tumbukan secara realistis masih dapat menjadi tantangan bagi model.
Sinkronisasi audio bisa bermasalah dalam skenario tertentu. Secara khusus, saat berurusan dengan gerakan yang secara visual kecil, terhalang, atau memerlukan pemahaman visual tingkat tinggi untuk menghasilkan suara yang sesuai, model mungkin kesulitan mencapai sinkronisasi sempurna. Contohnya termasuk menyelaraskan langkah kaki secara akurat dengan orang yang berjalan, menghasilkan suara yang tepat untuk objek yang sebagian tersembunyi dari pandangan, dan mengenali gerakan tangan halus pada gitar untuk menghasilkan nada musik yang benar.
Selain itu, model Movie Gen Audio, dalam desain saat ini, belum mendukung generasi suara manusia.
Video realistis yang dihasilkan AI membawa risiko dan tantangan etika signifikan yang harus dipertimbangkan. Risiko ini mencakup manipulasi kepercayaan dan penyebaran misinformasi melalui deepfake, yang dapat merusak reputasi, menyesatkan publik, dan merugikan bisnis.
Di satu sisi, ini bisa menjadi fitur Instagram yang memungkinkan saya membuat video keren dengan diri saya di dalamnya untuk dibagikan kepada teman-teman, namun di sisi lain, fitur yang sama memungkinkan saya membuat video palsu tentang orang lain. Seiring peningkatan teknologi ini, mungkin akan menjadi mustahil membedakannya dari yang asli.
Konten yang dihasilkan AI menimbulkan ancaman privasi, yang berpotensi mengarah pada pemerasan, pemerasan digital, atau perundungan siber.
Selain itu, alat AI ini dapat merusak seni dan hak cipta dengan meniru gaya seni unik tanpa kredit. Solusinya meliputi penyebaran kesadaran dan edukasi literasi media, investasi dalam teknologi deteksi, pembentukan kerangka hukum dan etika, serta menerapkan watermarking untuk autentikasi.
Walau generasi video AI memiliki potensi besar, teknologi ini memerlukan penanganan cermat untuk menjaga kepercayaan dan keaslian.
Meta bersikap terbuka dengan pengembangan AI-nya dengan membuka sumber model Llama. Namun, demi alasan keamanan, model Meta Movie Gen belum akan dirilis. Menurut artikel mereka, diperlukan berbagai peningkatan dan pertimbangan keamanan sebelum penerapan.
Dalam postingan blog ini, kami memperkenalkan model Movie Gen dari Meta, serangkaian model AI untuk menghasilkan dan menyunting video menggunakan prompt teks.
Kami mengeksplorasi empat model yang berbeda, kemampuannya, dan cara kerjanya. Melalui analisis perbandingan, kami menampilkan bagaimana posisi Meta Movie Gen dibandingkan alat generasi video AI lainnya.
Walau Meta Movie Gen menetapkan tolok ukur baru di bidang ini, potensi penyalahgunaan teknologi menimbulkan kekhawatiran signifikan. Meta mengakui risiko ini dan mengambil pendekatan hati-hati untuk merilis model-model tersebut.
Untuk mempelajari lebih lanjut tentang ekosistem Meta AI, saya merekomendasikan blog berikut:
Pelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Program
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




