
{count, plural, one {Cursus} other {Cursussen}}
Werken met Llama 3
{hours} uur
15.6K
Meta heeft onlangs Meta Movie Gen uitgebracht, wat zowel een belangrijk als enigszins onverwacht moment is in het landschap van tekst-naar-video-generatie—ik denk niet dat Meta bij veel mensen op de radar stond als het om videogeneratie gaat.
Gezien de competitieve omgeving, met verschillende toonaangevende bedrijven zoals OpenAI die al werken aan robuuste modellen zoals Sora, is Meta's release opvallend.
Het model presteert goed op verschillende taken en overtreft of evenaart de kwaliteit van gevestigde spelers zoals Runway Gen3, LumaLabs en, met name, Sora van OpenAI.
In deze blog vertel ik wat Meta Movie Gen is, hoe het werkt, wat de mogelijkheden en beperkingen zijn, en welke veiligheidsaspecten bij het gebruik komen kijken.
Als je een overzicht wilt van het veld van videogeneratie, raad ik dit artikel aan over de beste AI-videogenerators.
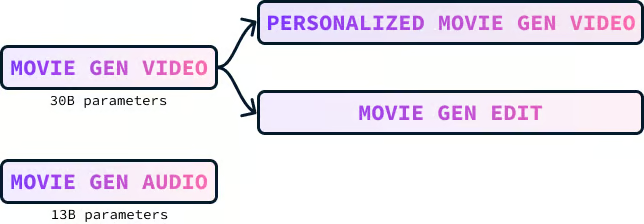
Meta Movie Gen is een verzameling basis-modellen voor het genereren van verschillende soorten media, waaronder tekst-naar-video, tekst-naar-audio en tekst-naar-afbeelding. Het bestaat uit vier modellen:
Movie Gen Video is een model met 30 miljard parameters, ontworpen om afbeeldingen en video’s te maken op basis van tekstbeschrijvingen. Het model kan hoogwaardige video’s tot 16 seconden genereren die aansluiten op de opgegeven prompt. Het kan content produceren in verschillende formaten, resoluties en lengtes.
Hier is een voorbeeld van een video die is gegenereerd met de prompt:
“Een luiaard met roze zonnebril ligt op een donut-drijver in een zwembad. De luiaard houdt een tropisch drankje vast. De wereld is tropisch. Het zonlicht werpt een schaduw.”
Het model heeft de potentie om videobewerkingsworkflows in verschillende sectoren te veranderen. Het vermogen om tekstgebaseerde bewerkingsinstructies nauwkeurig te begrijpen en uit te voeren, kan het bewerkingsproces aanzienlijk verbeteren: sneller, efficiënter en toegankelijker voor een bredere groep gebruikers. Deze technologie kan filmmakers, contentmakers, docenten en iedereen die met videocontent werkt ten goede komen.
De training van het Movie Gen Video-model omvatte meerdere kernelementen: gegevensverzameling en -voorbereiding, het trainingsproces zelf, fine-tuning voor verbeterde kwaliteit en de upsampling-technieken die zijn gebruikt om hoge resoluties te bereiken.
Het Movie Gen Video-model is getraind op een enorme dataset met honderden miljoenen video-tekstparen en meer dan een miljard afbeelding-tekstparen.
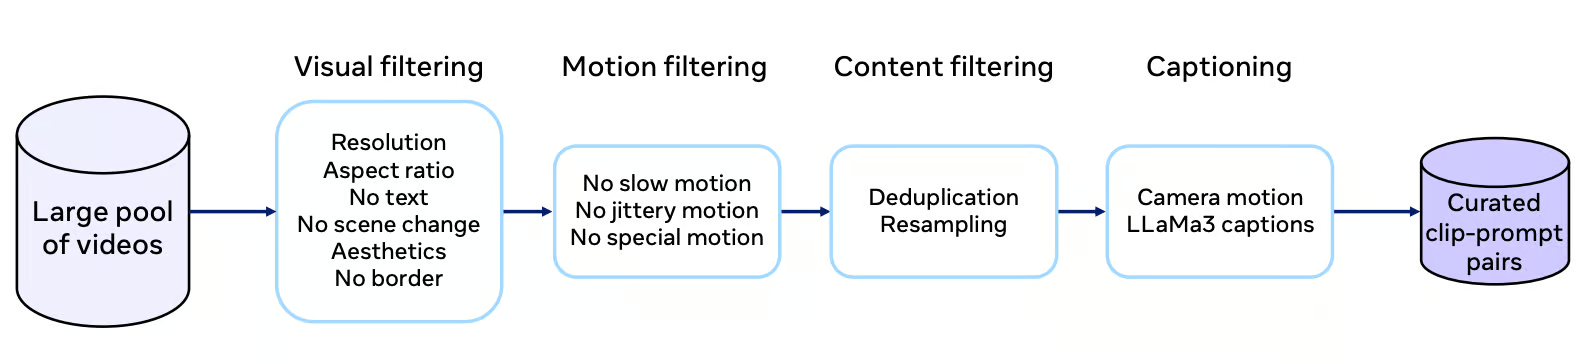
Elke video in de dataset ondergaat een rigoureus curatieproces met filtering op visuele kwaliteit, bewegingskenmerken en relevantie van de inhoud. Het filterproces is gericht op video’s met niet-triviale beweging, single-shot camerawerk en een divers scala aan concepten, waarvan een aanzienlijk deel met mensen.
Bron: Movie Gen-onderzoeksartikel
Hoogwaardige bijschriften zijn erg belangrijk voor een effectieve training van het model. Movie Gen Video gebruikt het LLaMa3-Video-model om gedetailleerde bijschriften te genereren die de video-inhoud nauwkeurig beschrijven. Deze bijschriften gaan verder dan het simpelweg labelen van objecten; ze bevatten beschrijvingen van acties, camerabewegingen en zelfs informatie over belichting. Deze rijke tekstuele informatie helpt het model een meer genuanceerd begrip van visueel vertellen te leren.
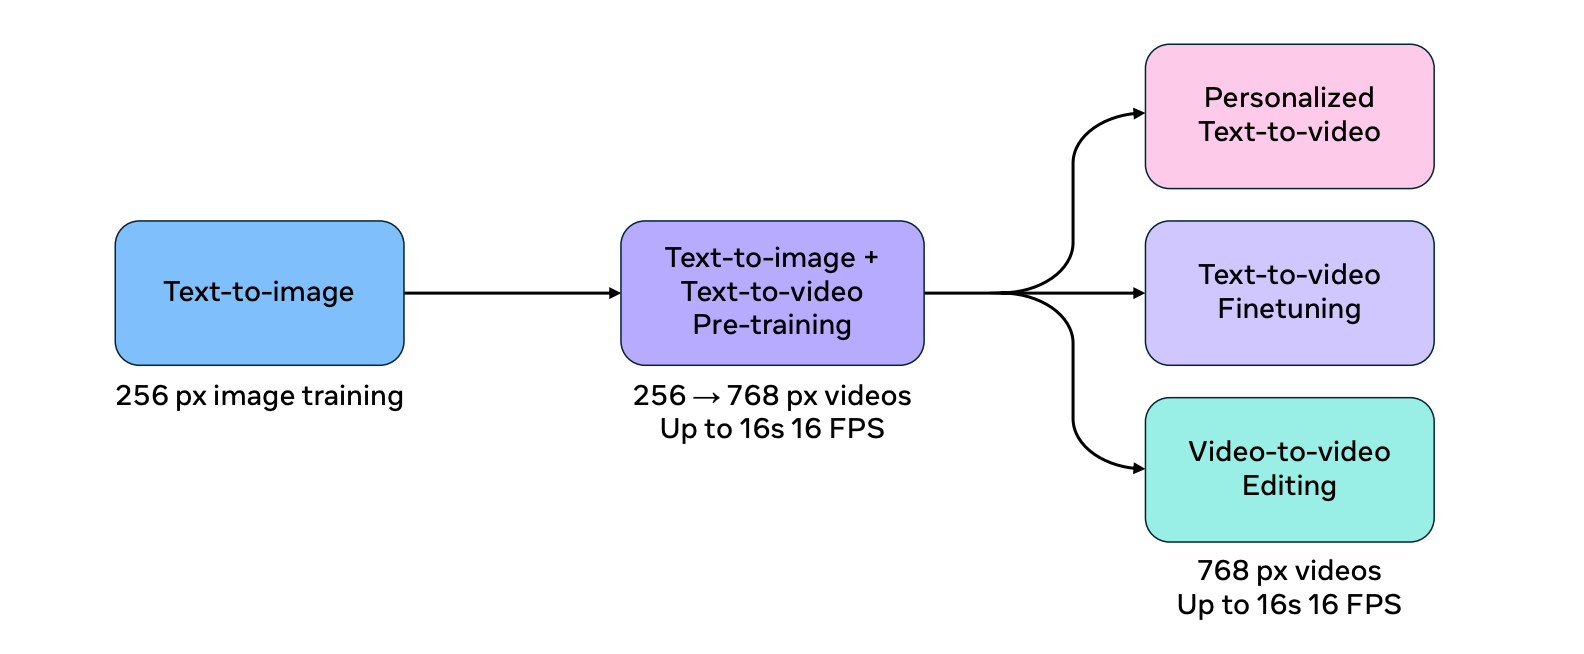
Het trainingsproces voor Movie Gen Video is opgedeeld in meerdere fasen om efficiëntie en schaalbaarheid te verbeteren.
Het model wordt eerst getraind op de tekst-naar-afbeeldingstaak met afbeeldingen met lagere resolutie. Deze "opwarmfase" laat het model fundamentele visuele concepten leren voordat het de complexere taak van videogeneratie aanpakt.
Vervolgens wordt het model gezamenlijk getraind op zowel de tekst-naar-afbeelding- als de tekst-naar-videotaken, waarbij de resolutie van de invoergegevens geleidelijk wordt verhoogd. Deze gezamenlijke trainingsaanpak helpt het model de overvloed en diversiteit van afbeelding-tekstdatasets te benutten, terwijl het ook de complexiteit van videogeneratie leert.
Bron: Movie Gen-onderzoeksartikel
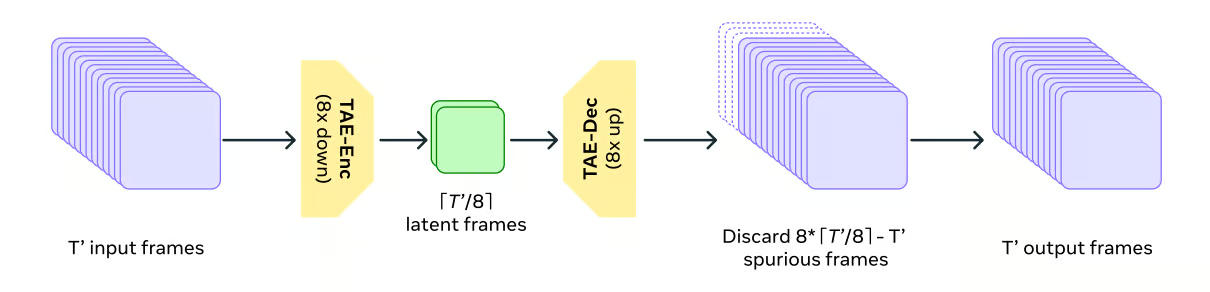
Om de rekenkundige eisen van videodata aan te kunnen, gebruikt Movie Gen Video een Temporal Autoencoder-model (TAE) om video’s in de tijd te comprimeren en decomprimeren. Dit is vergelijkbaar met het zippen en unzippen van bestanden op een computer, waardoor het model met een beter hanteerbare representatie van videodata kan werken.
Bron: Movie Gen-onderzoeksartikel
Movie Gen Video gebruikt een trainingsdoel genaamd Flow Matching. In plaats van direct de uiteindelijke video te genereren, begeleidt flow matching het model om stap voor stap een sample van willekeurige ruis geleidelijk om te vormen tot de gewenste video-output.
Flow Matching houdt in dat de snelheid (velocity) van samples in de latente ruimte wordt voorspeld in plaats van direct de samples zelf. Deze methode is efficiënter en performanter dan traditionele diffusie-gebaseerde methoden.
Om de kwaliteit en esthetiek van de gegenereerde video’s te verbeteren, ondergaat het model begeleide fine-tuning met een kleinere set handmatig gecureerde video’s met hoogwaardige bijschriften. Dit is als een kunstenaar die zijn techniek verfijnt met deskundige begeleiding, wat leidt tot visueel aantrekkelijkere en realistischer video-uitvoer.
Het uiteindelijke Movie Gen Video-model wordt gemaakt door meerdere modellen, getraind met verschillende datasets, hyperparameters en pretrain-checkpoints, te middelen. Deze techniek helpt de sterke punten van verschillende modellen te combineren, wat leidt tot robuustere en betrouwbaardere prestaties.
Het model produceert video’s met een resolutie van 768 pixels en gebruikt upsampling om de resolutie op te krikken naar full HD 1080p, wat resulteert in scherpere en visueel aantrekkelijkere video’s. Deze aanpak is gangbaar omdat het een rekenkundig efficiënte oplossing biedt: het basismodel kan minder tokens verwerken en toch high-res outputs leveren.
De Spatial Upsampler fungeert als een video-naar-video-generatiemodel. Hij neemt de video met lagere resolutie als input, schaalt deze op naar de doelformaat met bilineaire interpolatie, en codeert hem vervolgens in een latente ruimte met een frame-gewijze Variational Autoencoder (VAE).
Een latente-ruimtemodel genereert vervolgens de latenten van de HD-video, geconditioneerd op de gecodeerde latenten van de video met lagere resolutie. Ten slotte zet de VAE-decoder de resulterende HD-videolatenten terug naar pixelruimte, wat de uiteindelijke hoge-resolutie-output oplevert.
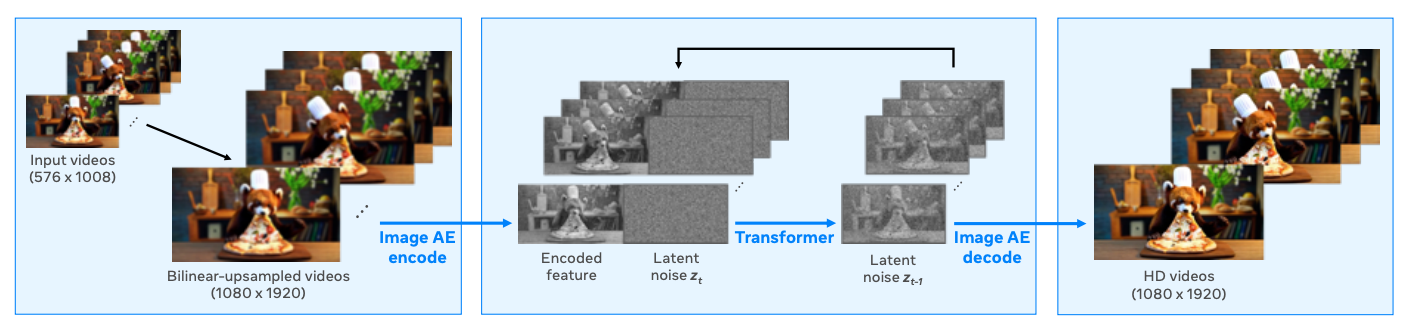
Bron: Movie Gen-onderzoeksartikel
Het evalueren van een tekst-naar-video-model is uitdagender dan een tekst-naar-beeld-model vanwege de extra temporele dimensie. Het Meta-team gebruikte drie hoofdmaatstaven om het model te evalueren:
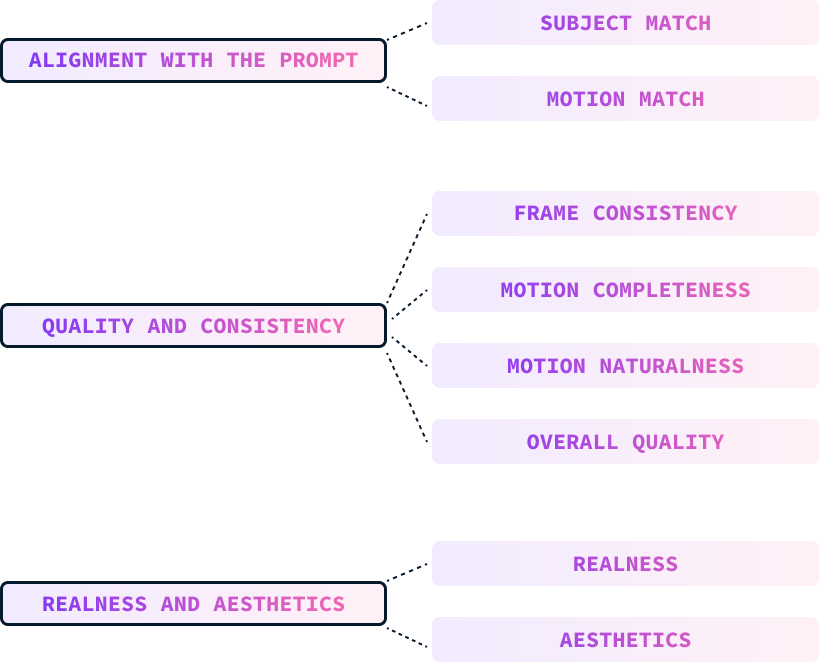
Deze parameters worden handmatig beoordeeld door mensen die de video’s volgens deze parameters rangschikken.
Promptafstemming meet hoe goed de gegenereerde video overeenkomt met de invoertekstprompt, inclusief beschrijvingen van onderwerp, beweging, achtergrond en andere details. Dit is verder onderverdeeld in:
De kwaliteit en consistentie van de gegenereerde video worden onafhankelijk van de tekstprompt beoordeeld. Deze maatstaf is onderverdeeld in:
Beoordelaars werd gevraagd om het vermogen van het model om fotorealistische en esthetisch aantrekkelijke video’s te produceren te beoordelen. Dit criterium is onderverdeeld in:
De benchmarkdata is ontworpen om videogeneraties uitgebreid te evalueren. Het omvat 1.000 prompts die verschillende testaspecten bestrijken, zoals menselijke activiteit, dieren, natuur, fysica en ongewone onderwerpen of activiteiten.
Hun benchmark is meer dan drie keer zo groot als die in eerdere studies. Elke prompt is gelabeld met een bewegingsniveau (hoog, medium, laag) om de generatiekwaliteit over verschillende bewegingsintensiteiten te beoordelen.
De evaluatie gebruikt de volledige promptset en bekijkt specifieke testmaatstaven, met name de vraag hoe goed modellen ongewone onderwerpen en bewegingen aankunnen om hun generalisatievermogen te testen.
Het volgende diagram toont een uitsplitsing van de prompts die in de evaluatie zijn gebruikt. Links zien we de verdeling van de concepten van de prompts. Aan de rechterkant zien we veelgebruikte zelfstandige naamwoorden en werkwoorden in de prompts (hoe groter het woord, hoe vaker het voorkomt):
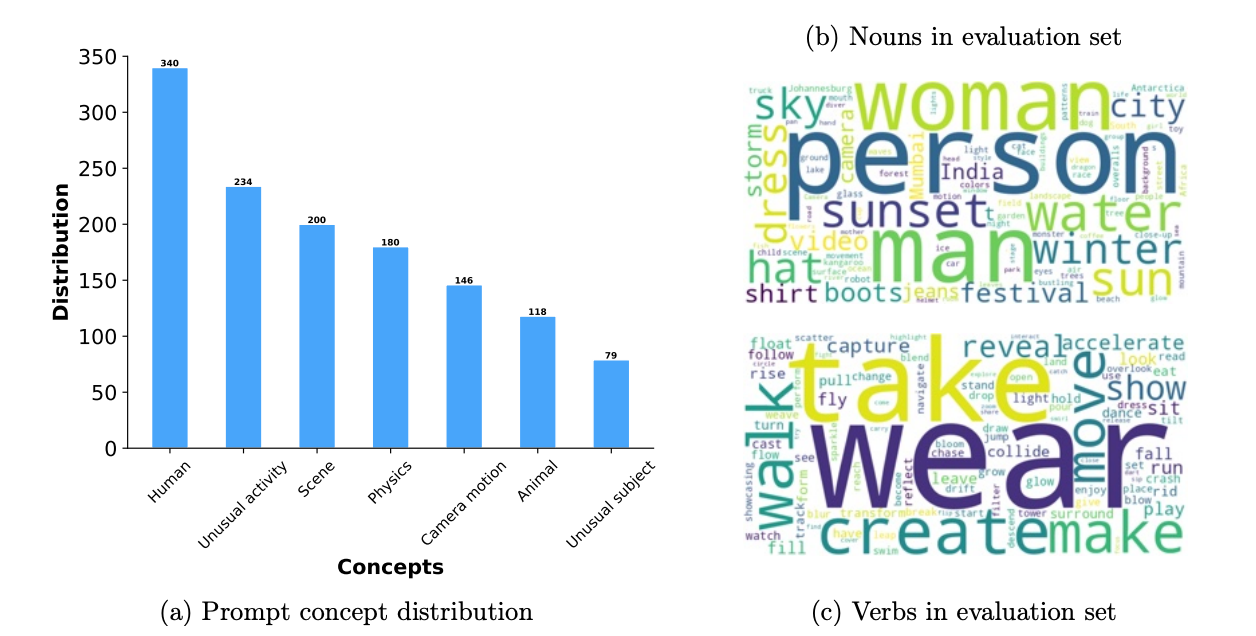
Bron: Movie Gen-onderzoeksartikel
De onderstaande tabel toont de resultaten van de menselijke evaluatie van de video’s die door verschillende modellen zijn geproduceerd op meerdere evaluatiecriteria. De cijfers vertegenwoordigen netto winstpercentages, berekend als (Win % - Verlies %). Dit loopt van -100 (volledig verlies) tot 100 (volledige winst), waarbij 0 op gelijkspel duidt.
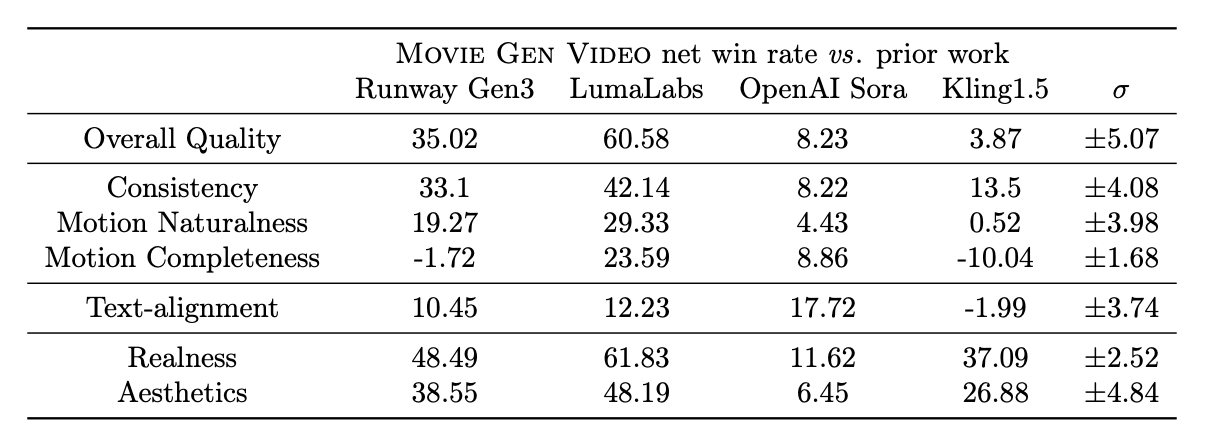
Bron: Movie Gen-onderzoeksartikel
Volgens hun experimenten presteert Movie Gen Video sterk in tekst-naar-videogeneratie en overtreft het verschillende bestaande modellen, waaronder commerciële systemen zoals Runway Gen3 en LumaLabs, op basis van menselijke evaluaties met de MovieGen Video Bench. Specifiek laat Movie Gen Video aanzienlijke voordelen zien in:
Hoewel MovieGen over het algemeen beter presteert dan andere modellen, genereert Kling1.5 soms video’s met grotere bewegingsomvang, zij het ten koste van vervormingen en inconsistenties. Dit benadrukt de afweging tussen volledigheid van beweging en visuele kwaliteit, waarbij Movie Gen Video prioriteit geeft aan realistische en consistente beweging boven het simpelweg maximaliseren van de bewegingsomvang.
Hieronder staan enkele screenshots uit de Meta Connect 2024-presentatie met een paar vergelijkingsvoorbeelden van videogeneratieprompts:
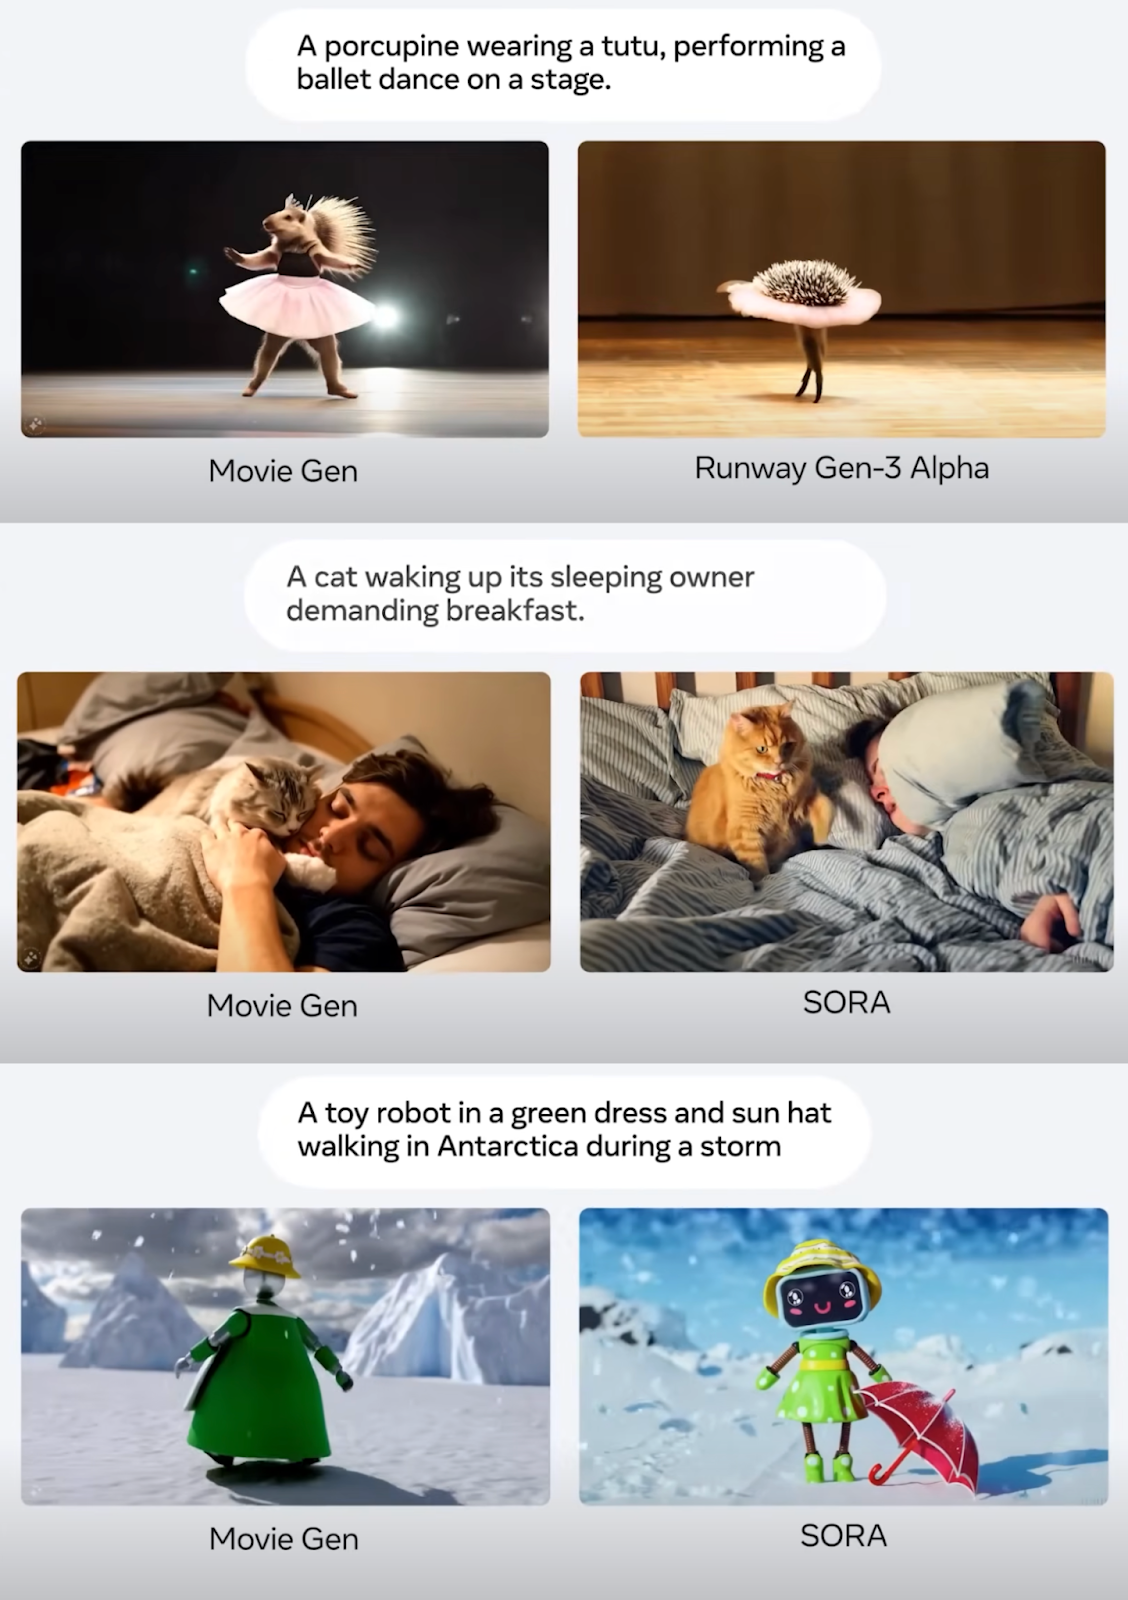
Bron: Movie Gen-onderzoeksartikel
Hier zijn enkele vergelijkingsvoorbeelden van videopersonalisatie, waarbij een foto wordt gebruikt om een gepersonaliseerde video te genereren:
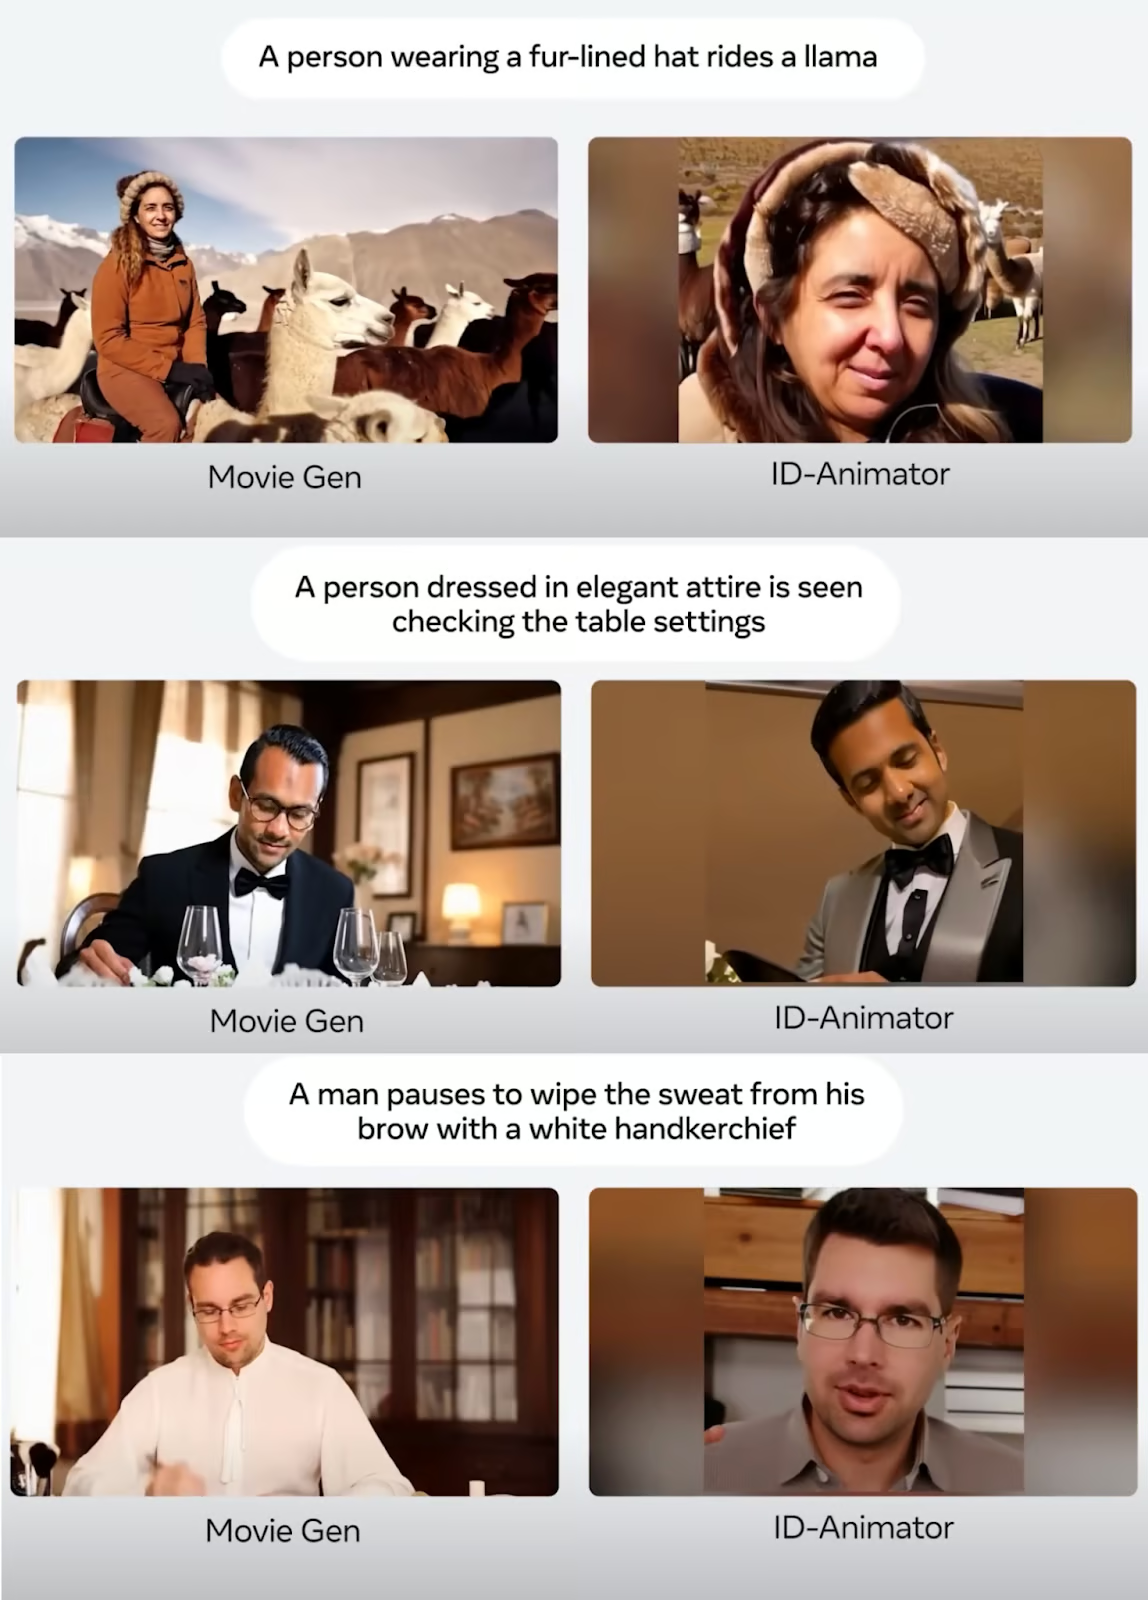
Bron: Movie Gen-onderzoeksartikel
Tot slot tonen de onderstaande screenshots vergelijkingsvoorbeelden van videobewerking:
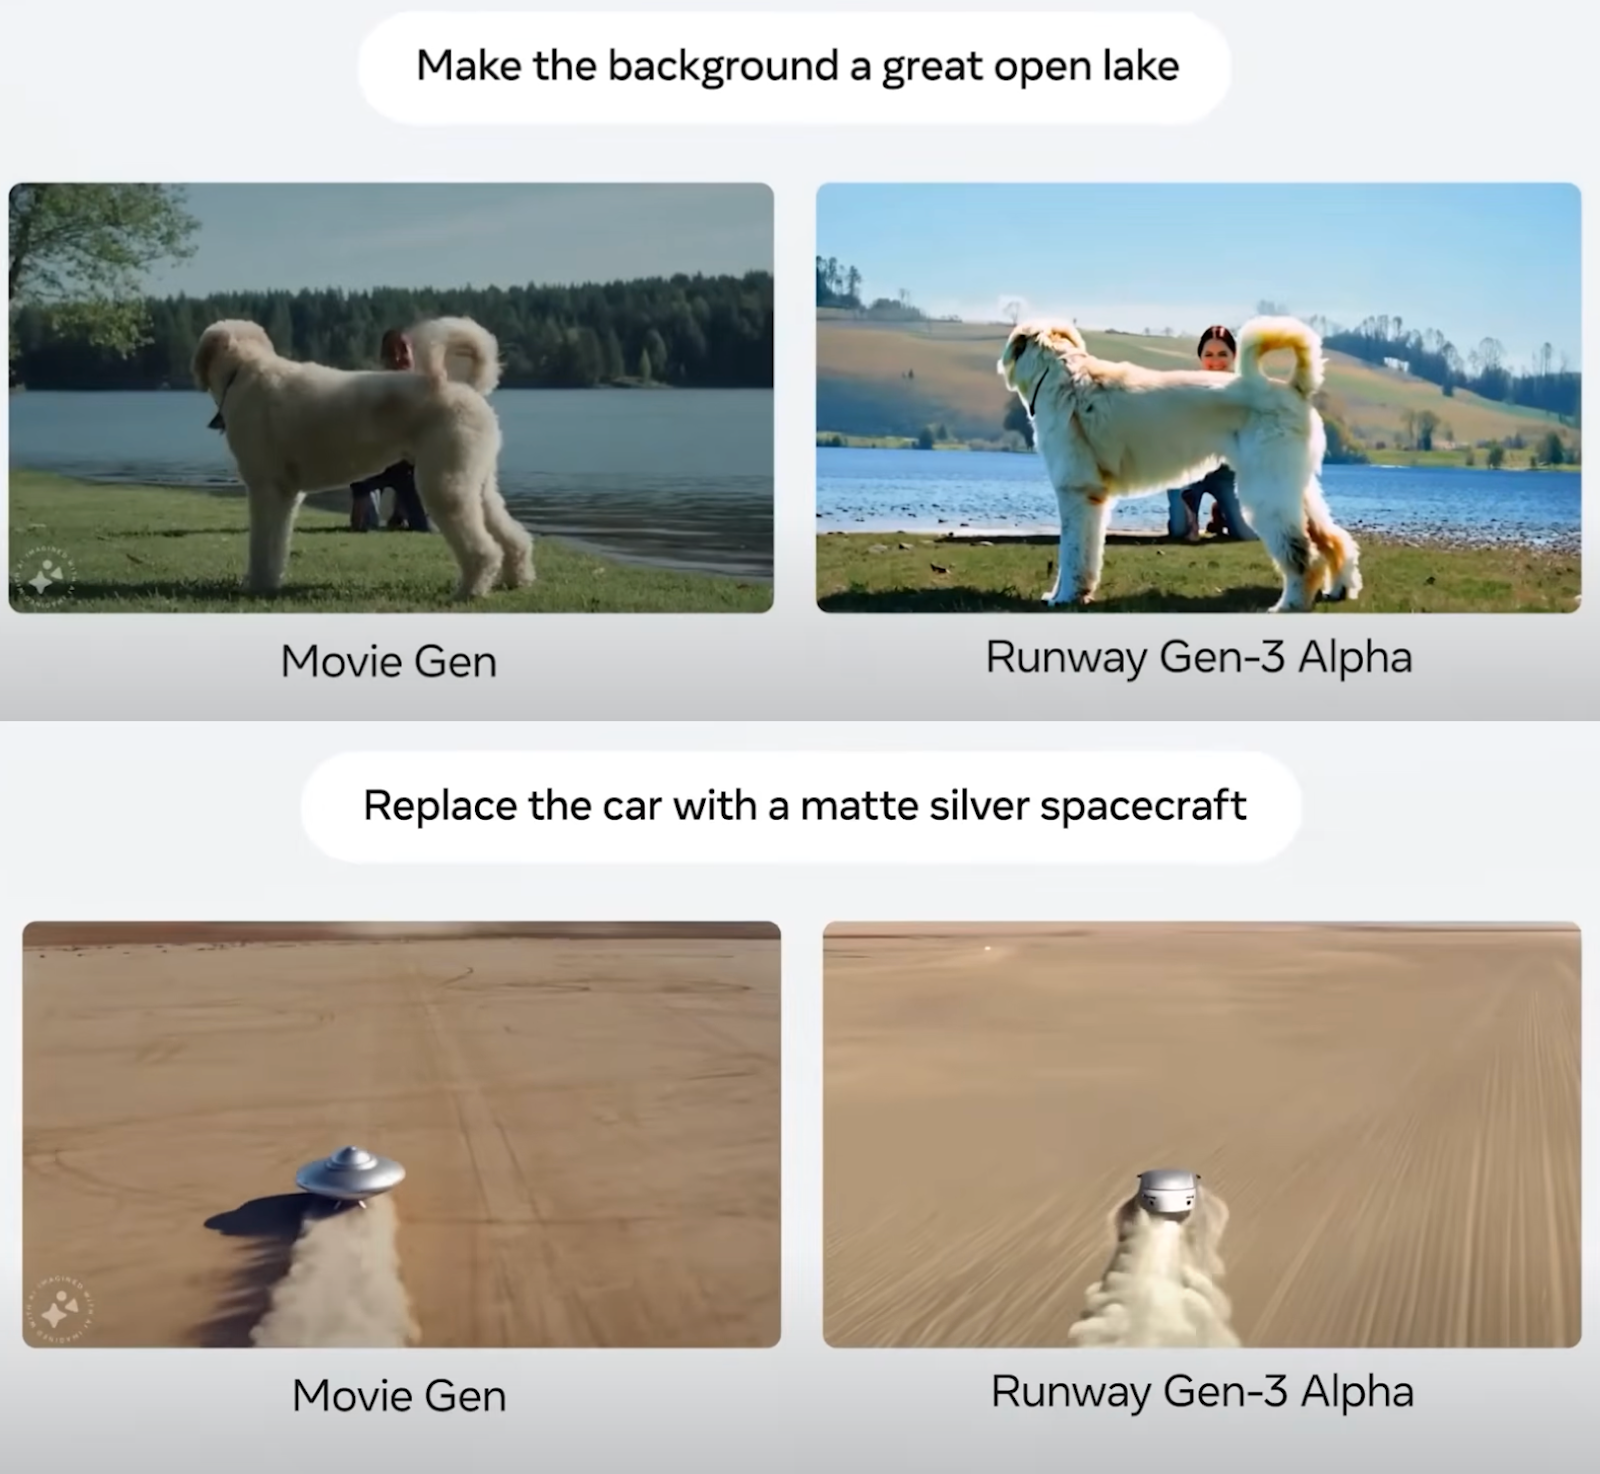
Bron: Movie Gen-onderzoeksartikel
Al met al lijkt het erop dat Meta Movie Gen de lat heeft verhoogd en een nieuwe standaard heeft gezet voor tekst-naar-videomodellen. De evaluatieprocedure in het artikel oogt eerlijk, maar het is natuurlijk lastig om het zeker te weten totdat deze modellen openbaar beschikbaar zijn en neutrale derden ze kunnen vergelijken.
Hoewel Meta Movie Gen er sterk uitziet in mediageneratie, zijn er nog steeds verbeterpunten.
Het model heeft soms moeite met complexe scènes met ingewikkelde geometrie, objectmanipulatie en realistische simulaties van natuurkunde. Zo kan het nog een uitdaging zijn om overtuigende interacties tussen objecten te genereren, toestandsveranderingen (zoals smelten of versplinteren) nauwkeurig weer te geven en de effecten van zwaartekracht of botsingen realistisch te simuleren.
Audiosynchronisatie kan in bepaalde scenario’s problematisch zijn. Vooral bij bewegingen die visueel klein zijn, verborgen (geoccludeerd) zijn of een hoog niveau van visueel begrip vereisen om het bijbehorende geluid te genereren, kunnen de modellen moeite hebben met perfecte synchronisatie. Voorbeelden hiervan zijn het nauwkeurig synchroniseren van voetstappen met een lopend persoon, passende geluiden genereren voor objecten die gedeeltelijk uit het zicht zijn, en subtiele handbewegingen op een gitaar herkennen om de juiste muzikale noten te produceren.
Daarnaast ondersteunt het Movie Gen Audio-model in de huidige vorm geen stemgeneratie.
Realistische AI-gegenereerde video’s brengen aanzienlijke risico’s en ethische uitdagingen met zich mee die moeten worden meegewogen. Deze risico’s omvatten het manipuleren van vertrouwen en de verspreiding van desinformatie via deepfakes, wat reputaties kan schaden, het publiek kan misleiden en bedrijven kan benadelen.
Aan de ene kant kan het een Instagram-functie zijn waarmee ik een coole video van mezelf kan maken om met vrienden te delen, maar aan de andere kant maakt diezelfde functie het mogelijk om een nepvideo van iemand anders te maken. Naarmate deze technologieën verbeteren, wordt het mogelijk onmogelijk om ze van echt te onderscheiden.
AI-gegenereerde content vormt privacy-dreigingen, wat kan leiden tot afpersing, chantage of cyberpesten.
Bovendien kunnen deze AI-tools kunst en auteursrecht ondermijnen door unieke stijlen na te bootsen zonder erkenning. Oplossingen omvatten het vergroten van bewustzijn en educatie over mediawijsheid, investeren in detectietechnologie, het opzetten van juridische en ethische kaders en het toepassen van watermerken voor authenticatie.
Hoewel AI-videogeneratie veel potentieel heeft, vereist het zorgvuldige omgang om vertrouwen en authenticiteit te behouden.
Meta is open geweest over zijn AI-ontwikkelingen door de Llama-modellen open source te maken. Maar om veiligheidsredenen worden de Meta Movie Gen-modellen voorlopig niet vrijgegeven. Volgens hun artikel zijn meerdere verbeteringen en veiligheidsmaatregelen nodig voordat ze kunnen worden uitgerold.
In deze blogpost hebben we de Movie Gen-modellen van Meta geïntroduceerd, een suite van AI-modellen voor het genereren en bewerken van video’s met tekstprompts.
We hebben de vier afzonderlijke modellen, hun mogelijkheden en hoe ze werken verkend. Via een vergelijkende analyse lieten we zien hoe Meta Movie Gen zich verhoudt tot andere AI-videogeneratietools.
Hoewel Meta Movie Gen een nieuwe benchmark heeft gezet in dit veld, roept het potentiële misbruik van de technologie grote zorgen op. Meta erkent deze risico’s en kiest voor een voorzichtige aanpak bij het vrijgeven van deze modellen.
Wil je meer leren over het ecosysteem van Meta AI? Dan raad ik deze blogs aan:
Leer AI met deze cursussen!
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

