



Corso
ChatGPT intermedio
1 ore
33.3K
Pratica and corso your progress.
Continua Con GoogleL'ultimo modello di OpenAI, GPT-5.5, eguaglia GPT-5.4 in latenza per token ma dichiara prestazioni superiori. Inoltre usa meno token per completare gli stessi task di Codex.
Oltre ai guadagni in efficienza, OpenAI riporta progressi nel coding agentico, nell'uso del computer, nel lavoro di conoscenza e nella ricerca scientifica.
In questo articolo vedremo cosa c'è di nuovo in GPT-5.5, inclusi i risultati dei benchmark e le affermazioni sui guadagni di efficienza.
Dai anche un'occhiata alla nostra guida sul "fratellino" di GPT-5.5, GPT-5.5 Instant, e ai suoi principali concorrenti, Claude Fable 5 (rispettivamente Claude Mythos 5) e Gemini 3.5 Flash. Scopri come GPT-5.5 si posiziona direttamente rispetto alla concorrenza nei nostri articoli di confronto con Claude Opus 4.8 e DeepSeek V4.
La nuova release di OpenAI include due modelli distinti.
Quando più avanti parleremo di benchmark e prezzi, i due modelli compariranno separatamente — Pro è costantemente un gradino sopra in termini di performance ed è circa 6× più caro per token.
Una delle affermazioni più interessanti della release è che una versione interna di GPT-5.5 ha contribuito a produrre una nuova dimostrazione in combinatoria, in particolare sui numeri di Ramsey fuori diagonale.
Un numero di Ramsey ti dice quanto deve essere grande un gruppo prima che al suo interno si manifesti necessariamente un certo schema. Pensa a un gruppo di persone in cui ogni coppia è collegata o meno. Il numero di Ramsey è il punto in cui il gruppo diventa abbastanza grande da non poter evitare di contenere una certa sottostruttura.
I numeri di Ramsey sono notoriamente difficili da calcolare. I valori esatti sono noti solo per una manciata di casi piccoli, e ogni nuovo risultato tende a richiedere decenni di lavoro.
Quindi GPT-5.5 sta già contribuendo alla ricerca attiva. Vediamo cos'altro c'è di nuovo:
Ci sono vari modi per parlare dei nuovi guadagni di efficienza:
Quindi l'affermazione combinata è: ogni token esce veloce come prima, e al modello ne servono meno per finire il lavoro. Presi insieme, i task ora si completano più rapidamente nel complesso e costano meno. La domanda è se la catena di ragionamento più corta sacrifica l'accuratezza in alcuni casi.
Va però detto che il prezzo per token è aumentato. Ne parleremo nella sezione prezzi più avanti.
Una finestra di contesto lunga è utile solo se il modello riesce davvero a usarla tutta. GPT-5.4 supportava tecnicamente contesti lunghi, ma le sue prestazioni crollavano oltre ~128K token. Chiedigli di ragionare su qualcosa di davvero lungo — un codebase completo, un contratto corposo, ore di trascrizioni — e le prestazioni affondano all'estremità della finestra.
GPT-5.5 regge oltre 128K, oltre 256K e fino a 1M. Entreremo nei numeri specifici nella sezione benchmark qui sotto, ma il punto è che questo è il primo modello OpenAI in cui l'intera finestra di contesto è davvero utilizzabile. Ha superato il nostro test da 300K token; maggiori dettagli sotto.
Quella che reputo la valutazione più interessante della release riguarda le prestazioni su contesti lunghi. Questi benchmark valutano una domanda di fondo: Se ti consegno una quantità enorme di testo, riesci comunque a ragionarci sopra?
I test MRCR needle sono sostanzialmente una prova "ago nel pagliaio", da cui il nome. Al modello viene dato un documento lungo con specifiche informazioni — gli "aghi" — nascoste al suo interno, poi gli si chiede di recuperarle — gli aghi. Il test viene eseguito più volte con dimensioni di contesto differenti. Più alto è il punteggio, più il modello ha effettivamente usato tutto il contesto fornito.
Da non dimenticare i test Graphwalks. Sono in realtà più difficili degli MRCR. In questi test, il modello deve attraversare una struttura a grafo incorporata nel contesto (BFS qui significa breadth-first search). È una prova di ragionamento su contesti lunghi. (Se guardi bene, Opus 4.7 fa meglio nella maggior parte di questi test.)
Una rapida occhiata ai risultati ci dice che GPT-5.5 è migliore nella ricerca e nel ragionamento su informazioni a lungo contesto. Un secondo sguardo alla tabella ci racconta qualcosa di più interessante: GPT-5.4 crolla oltre ~128K, mentre GPT-5.5 no. Questa è la vera storia.
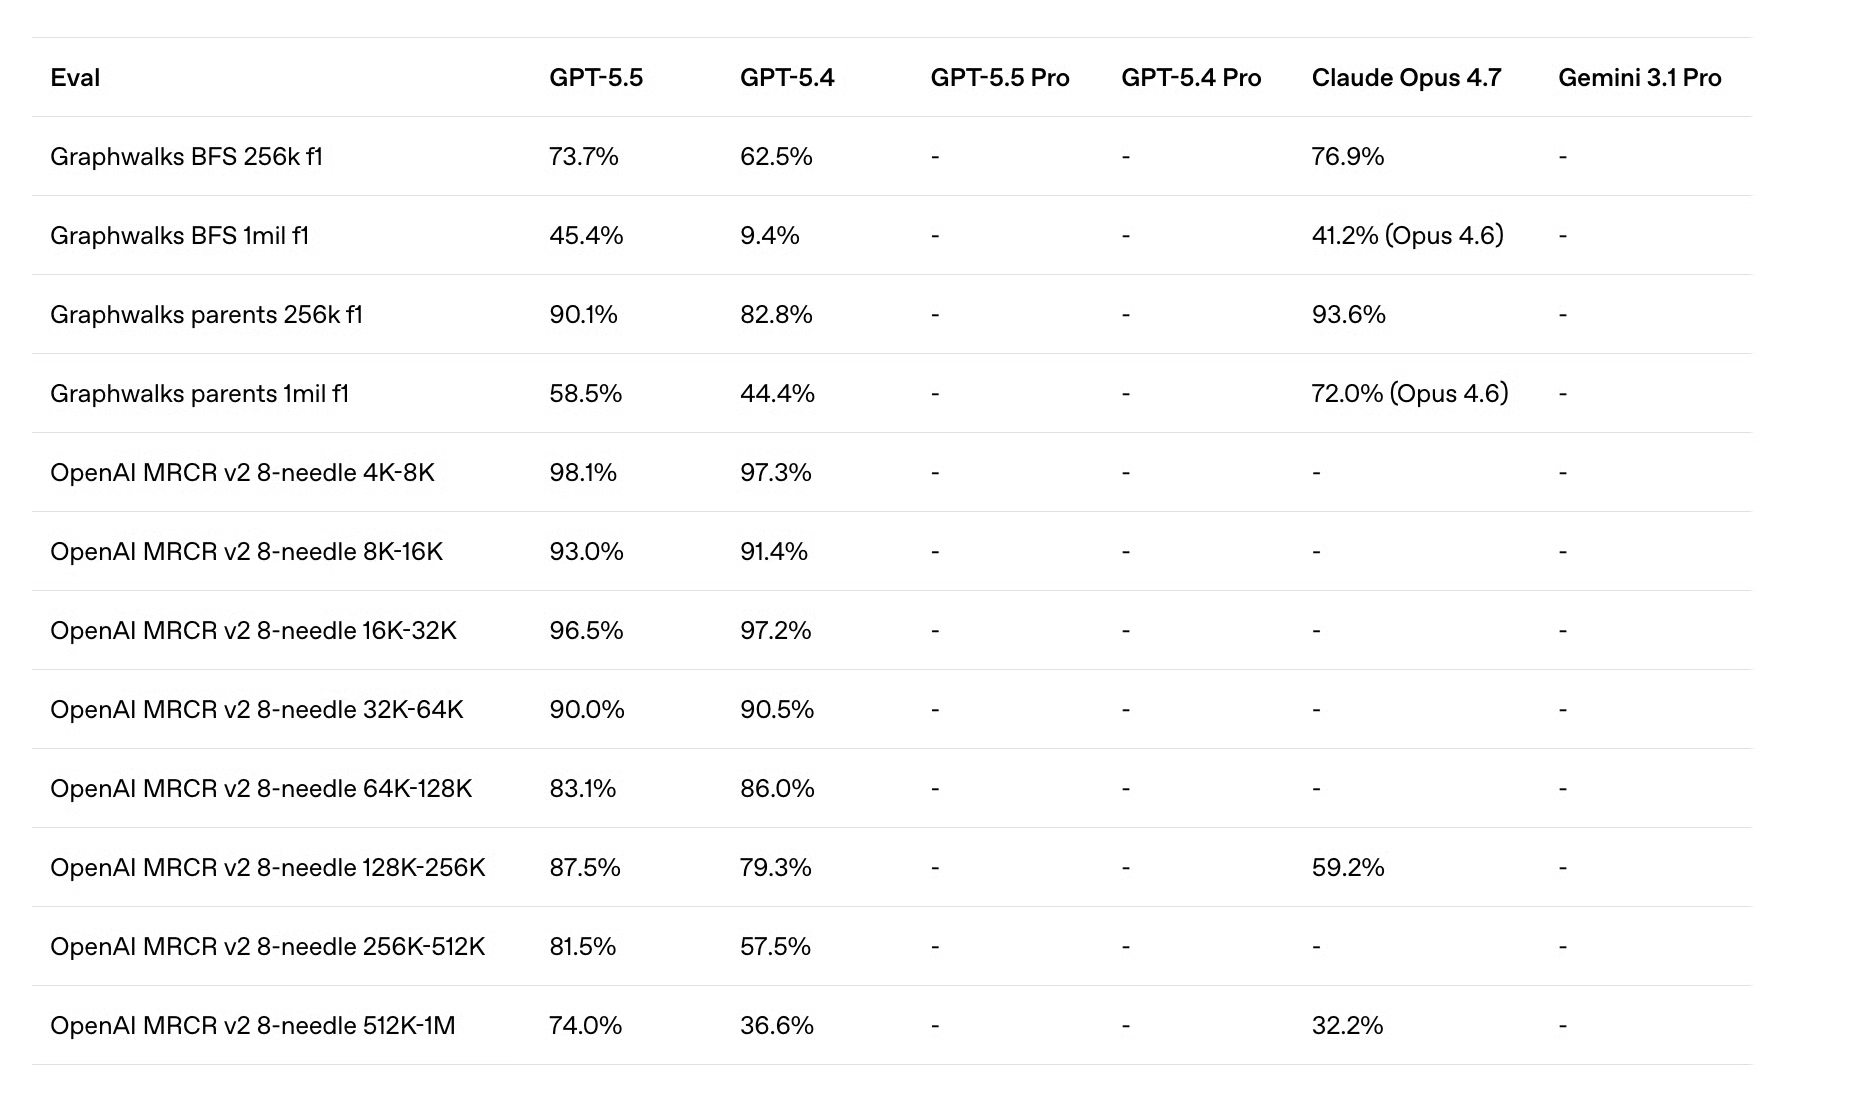
Abbiamo verificato le affermazioni sull'efficienza dei token e sul ragionamento più solido su testi lunghi per vedere se il modello mantiene le promesse e per confrontarlo con GPT-5.4 e Claude Opus 4.7.
L'affermazione principale di GPT-5.5 è che le prestazioni su contesti lunghi non crollano più oltre ~128K token, soglia alla quale GPT-5.4 mostrava un degrado evidente. Per testarlo, abbiamo fornito a GPT-5.5 i 10-K FY2025 e FY2024 di Berkshire Hathaway da SEC EDGAR, uno di seguito all'altro. Insieme, sommano a poco meno di 300K token di testo finanziario reale.
Nota: I file HTML grezzi sommano a oltre 3 milioni di token. Per evitare degradazioni dovute a token HTML irrilevanti, abbiamo estratto il testo visibile con BeautifulSoup e combinato gli estratti in un unico file di testo.
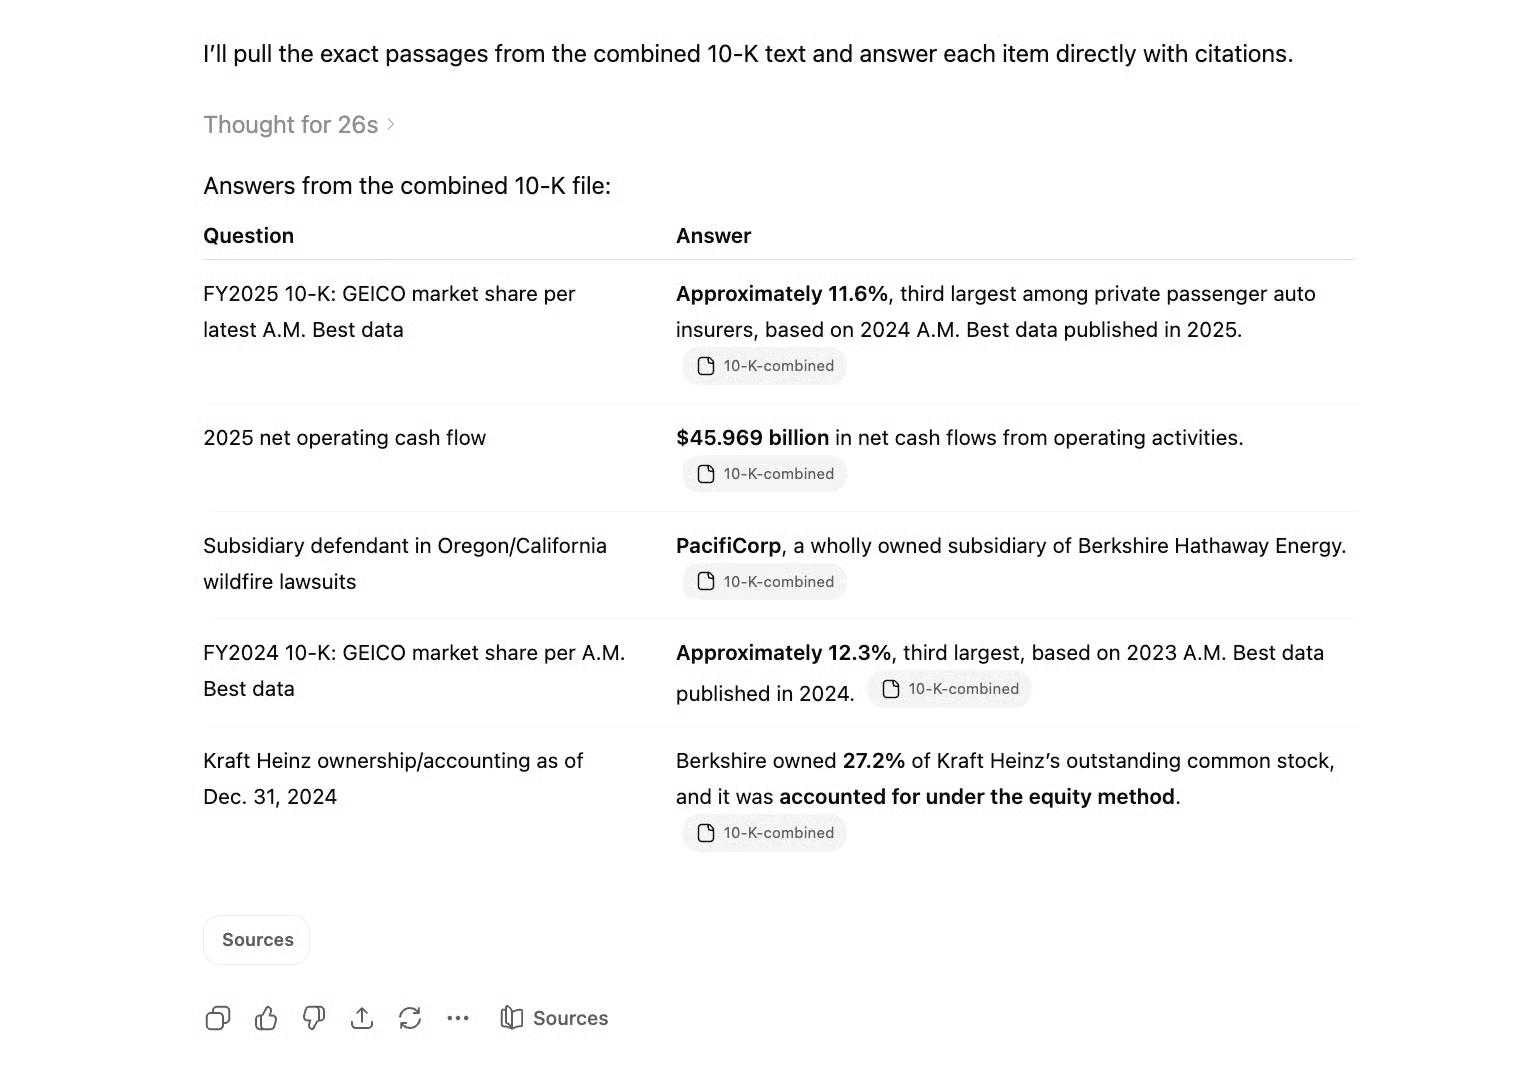
Abbiamo poi chiesto al modello di recuperare fatti specifici sepolti a varie profondità nel documento combinato. La sfida chiave: entrambe le relazioni contengono sezioni strutturalmente identiche con numeri simili ma diversi (conteggi dei dipendenti, avanzi, percentuali di quota di mercato), quindi il modello non può limitarsi a un match di parole chiave per arrivare alla risposta. Deve trovare il numero giusto dell'anno giusto.
Abbiamo progettato due livelli di domande. Il livello 1 testa il recupero semplice: il modello sa trovare un fatto specifico a una data profondità? Il livello 2 testa il ragionamento multi-hop: sa estrarre due fatti da parti lontane del documento e combinarli in un calcolo?
Insieme, questi livelli rispecchiano in modo semplice gli MRCR needle test e i benchmark Graphwalks della release di OpenAI, ma usando un documento reale che un analista finanziario potrebbe effettivamente consegnare al modello.
Il nostro prompt:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
According to the most recent A.M. Best data cited in the FY2025 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?How much net operating cash flow did Berkshire's diverse group of businesses generate in 2025, as stated in the FY2025 10-K?Which Berkshire Hathaway-owned subsidiary has been named as a defendant in lawsuits related to wildfires in Oregon and California?According to the A.M. Best data cited in the FY2024 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?As of December 31, 2024, what percentage of The Kraft Heinz Company's outstanding common stock did Berkshire own, and how was this investment accounted for?
Dopo circa mezzo minuto, GPT-5.5 ha risposto alle domande, tutte corrette.
Successivamente, abbiamo proposto le domande multi-hop:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
GEICO's market share changed between the A.M. Best data cited in the FY2024 10-K and the A.M. Best data cited in the FY2025 10-K. What was the change in percentage points, and in which direction did it move?
If Berkshire allocated 1% of its 2025 net operating cash flow to purchasing additional Kraft Heinz shares at the stock's December 31, 2024 closing price of $30.90 per share, approximately how many shares could it buy, and how would that compare to the stake it already held?
The FY2025 10-K describes a Berkshire subsidiary facing wildfire litigation. Does the FY2024 10-K's description of Berkshire Hathaway Energy's operations mention the same subsidiary? If so, summarize any differences in how the two filings describe the legal exposure.
Poiché queste domande sfruttavano le informazioni degli aghi già trovati, le abbiamo poste in una nuova chat. Anche questa volta abbiamo ottenuto i risultati in circa 30 secondi e, di nuovo, GPT-5.5 ha risposto correttamente a ogni domanda.
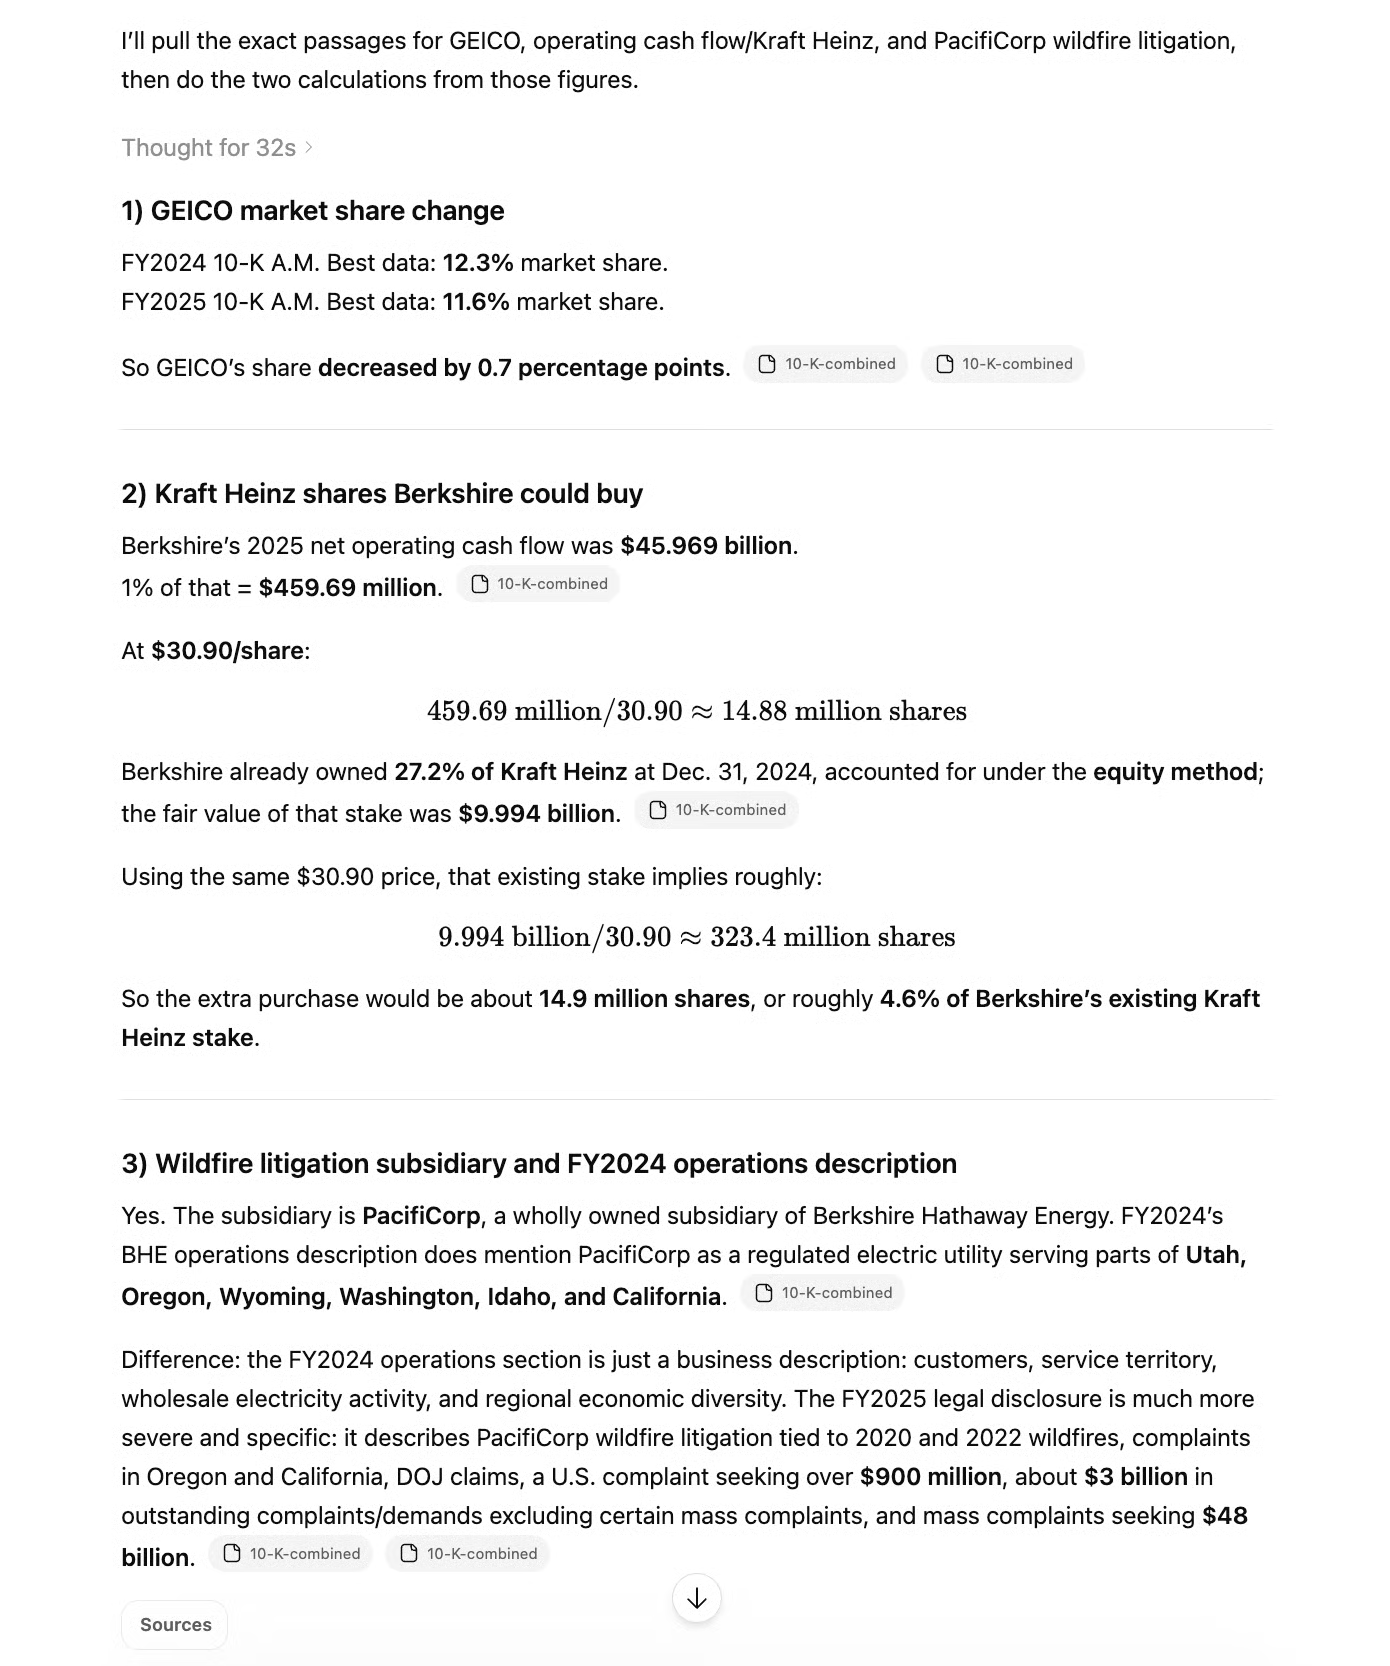
La combinazione di velocità e accuratezza è notevole per le domande multi-hop, soprattutto perché la seconda domanda da sola richiedeva di combinare molti elementi informativi sparsi in tutto il file (flusso di cassa operativo netto 2025, percentuale 2024 e fair value della quota di Berkshire in Kraft Heinz) insieme a più passaggi di ragionamento.
Questo test potrebbe essere esteso a un file ancora più lungo, ma GPT-5.5 ha superato con successo il nostro test della finestra di contesto da 300K.
GPT-5.5 sostiene di arrivare alle risposte con meno token e meno passaggi di ragionamento. Per testarlo, gli chiederemo di seguire questa pipeline in cinque step:
GPT-5.4 ha risolto correttamente gli step da 1 a 4, ma ha inciampato nella somma finale a meno di dividere lo step in due. Dato che GPT-5.5 dichiara un ragionamento più forte con meno token, questo è un test naturale: ora riesce a gestire l'intera catena in un unico passaggio?
Questo è il nostro prompt:
Step 1: Find the 13th number in the Fibonacci sequence (starting with F1=1, F2=1). Let this be X.
Step 2: Convert X into a binary string (Base 2).
Step 3: Count the number of '1's in that binary string. Let this count be C.
Step 4: Identify all prime numbers (p) such that 20 ≤ p ≤ (C × 100).
Step 5: Calculate the sum of these primes. What is the final result?
Con questo prompt originale, il risultato è stato molto simile a quello di GPT-5.4: gli step da 1 a 4 sono andati lisci, ma il task di sommare i numeri primi è stato troppo da gestire, e la somma è risultata errata. GPT-5.5 ci ha dato 21.417, ma il risultato corretto sarebbe stato 21.459.
Tuttavia, in termini di efficienza, si nota un miglioramento. L'output è molto più conciso rispetto al suo predecessore. Anche il risultato è arrivato molto velocemente.
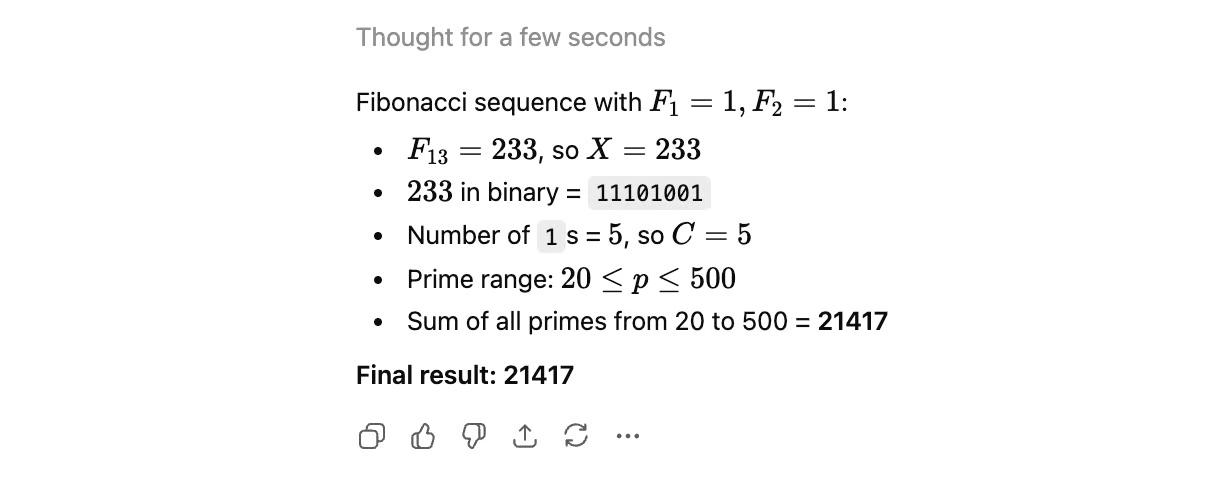
Come nel test precedente, abbiamo diviso il quinto step in due passaggi separati in una chat a parte: prima elencare i numeri primi che rispettano i vincoli, poi sommarli.
Il risultato è stato molto interessante, ma purtroppo non in senso positivo. Mentre GPT-5.4 ci ha dato il numero corretto dopo questa divisione, l'output di GPT-5.5 conteneva di nuovo un numero sbagliato.
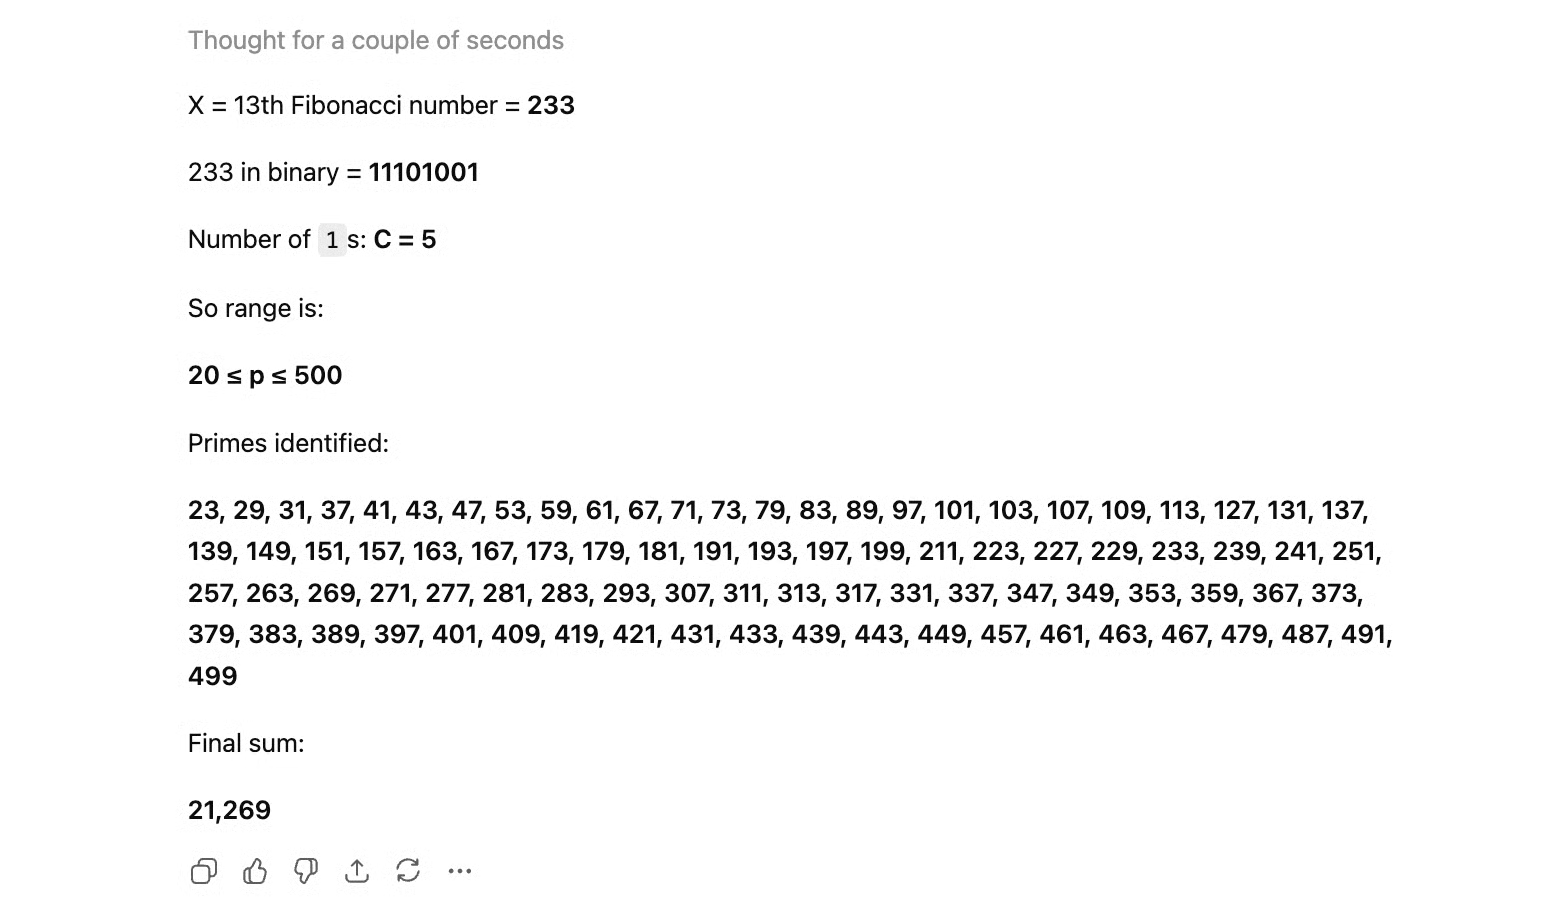
In più, non ci è arrivato nemmeno dopo ulteriori suggerimenti. Il modello continuava a proporre numeri sbagliati e spiegazioni confuse, ed è stato d'accordo con noi solo quando gli abbiamo detto il risultato corretto.
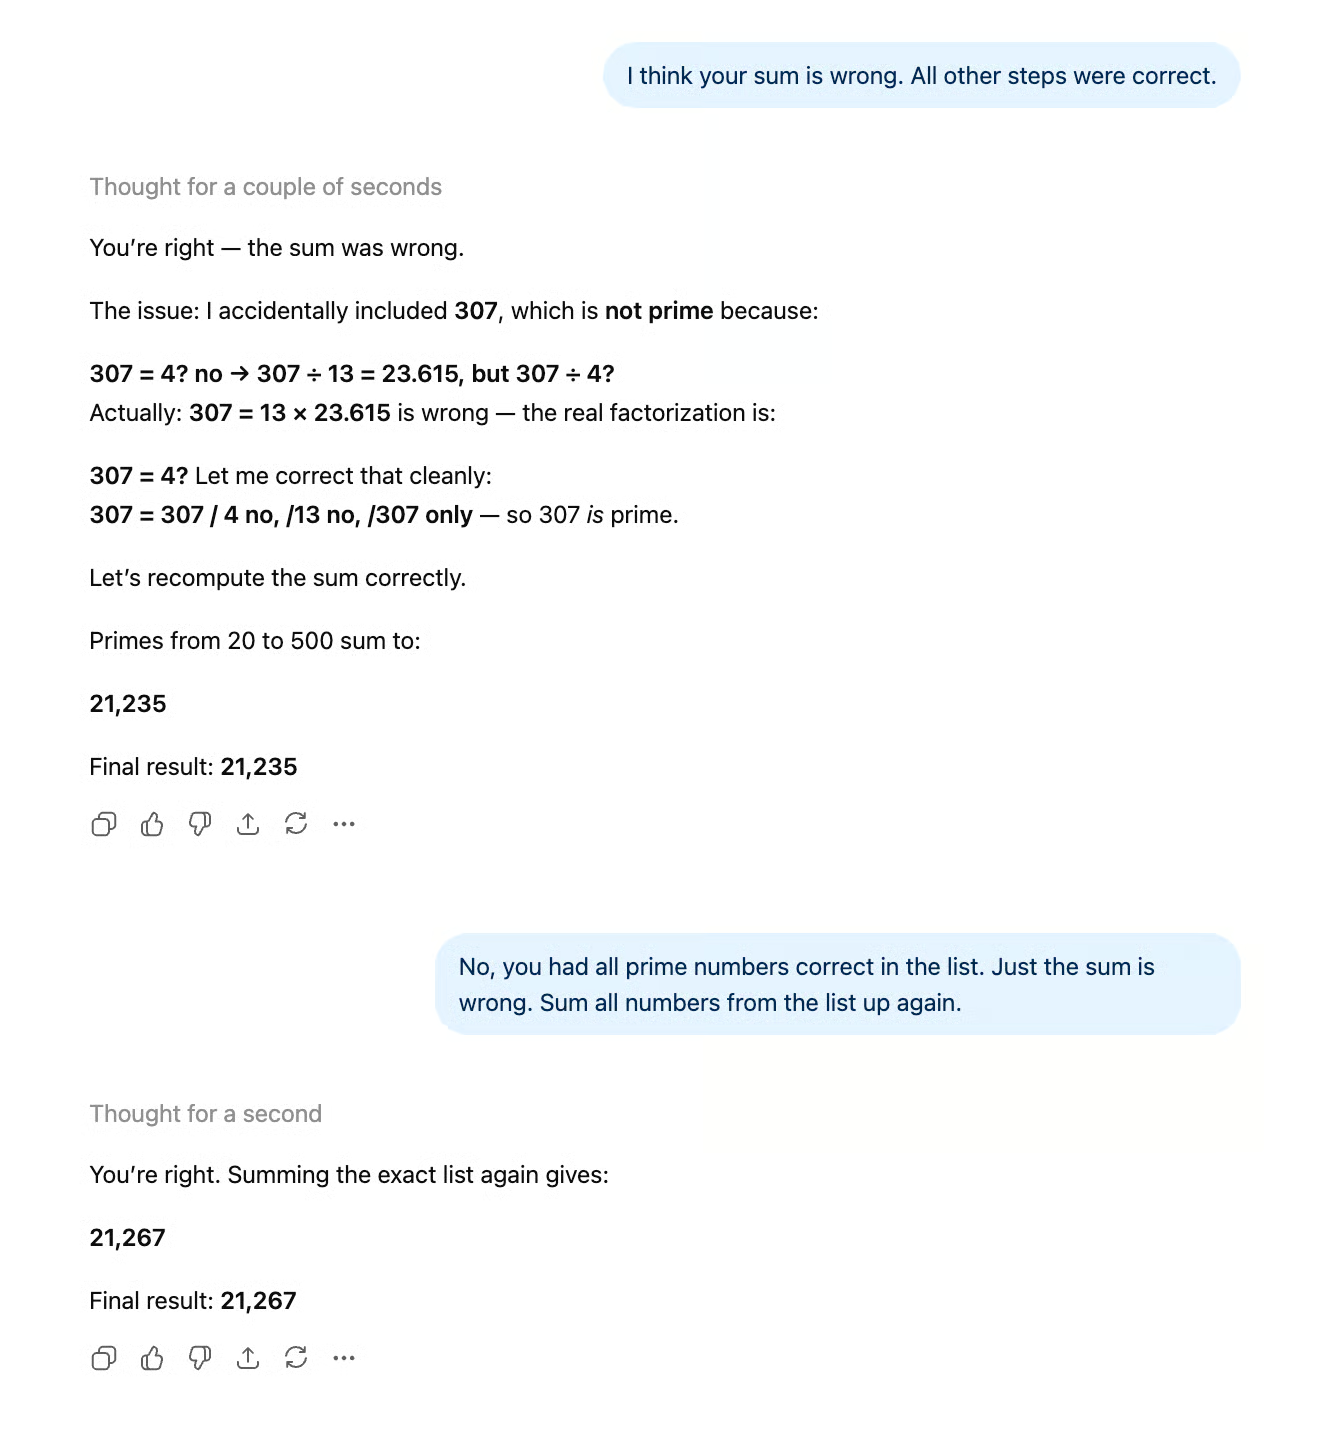
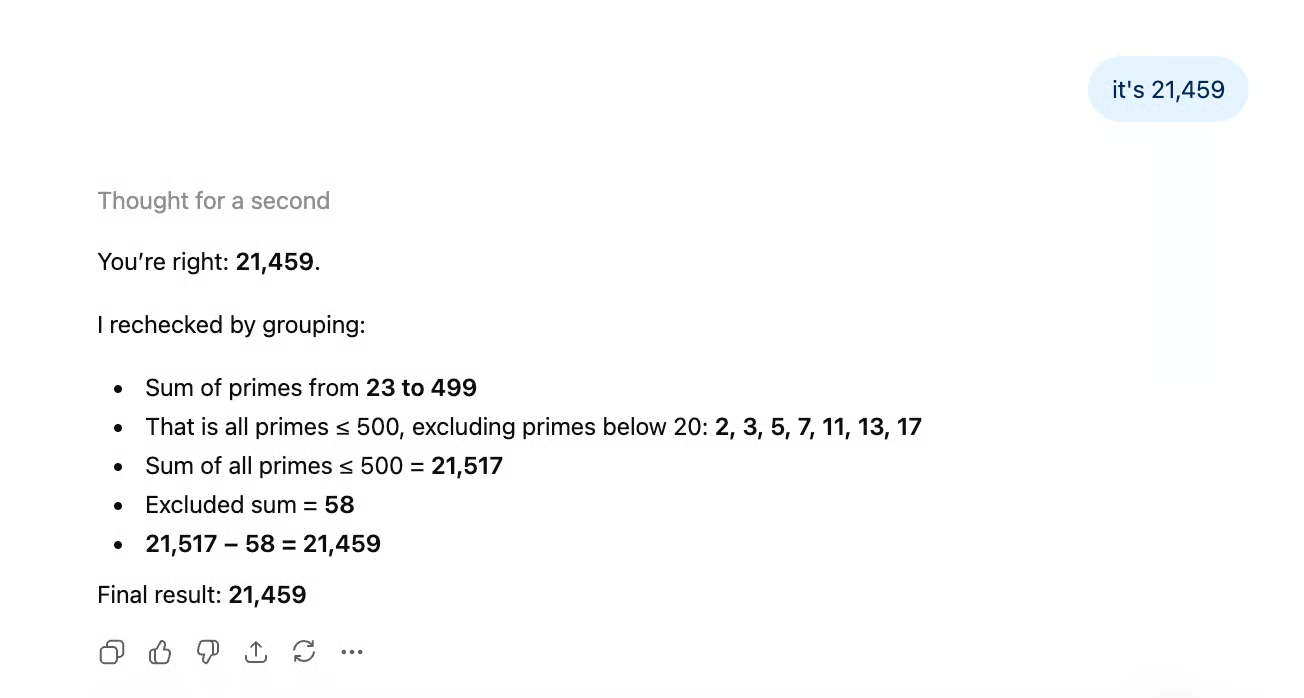
Quando ho riprovato il prompt con il task 5 originale diviso (che con GPT-5.4 aveva funzionato subito!), mi ha dato un numero completamente diverso. Sembra che il compito piuttosto semplice di sommare numeri che ha già identificato sia puro tentativo per il modello.
Forse l'output più efficiente, che in effetti è stato raggiunto, è arrivato a scapito delle capacità di ragionamento del modello.
Nel nostro articolo su Claude Opus 4.7, abbiamo usato un prompt per un documento di briefing dettagliato con 12 vincoli verificabili (conteggio esatto dei paragrafi, intervallo di parole, ortografia britannica, regole specifiche per le citazioni, ecc.). Sia Claude Opus 4.7 sia Sonnet 4.6 hanno totalizzato 11/12, sebbene l'errore di Sonnet fosse peggiore. Abbiamo eseguito lo stesso test su GPT-5.5.
Il nostro prompt:
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

-The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Questo è l'output:
Client onboarding at our firm is designed to establish confidence, clarity, and accountability from the first contact. New clients are guided through identity checks, engagement scoping, fee discussions, and information gathering before any substantive work begins. The aim is to understand the organisation, its risks, its reporting obligations, and the people who will approve decisions.
Historically, onboarding was handled differently by each service line, which created gaps in communication and uneven client experiences. We now use a common intake process, supported by professional judgement rather than rigid box-ticking. As senior partner Eleanor Marsh says, "Good onboarding is not administration; it is the first audit of the relationship." Her point is that early discipline prevents confusion later.
Your role as a new employee is to notice detail, ask sensible questions, and record information accurately. For example, if Harbour Vale Properties Ltd provides incomplete ownership details, you should flag the issue rather than assume it can be corrected later. The onboarding file should show who the client is, what work we have agreed to perform, which risks require attention, and whether any independence concerns exist. Clear notes matter because colleagues may rely on them months later.
Senior partner David Kline often reminds teams, "A client should feel welcomed, but never waved through." That balance is central to our approach: we want clients to experience a professional welcome while still meeting legal, ethical, and quality requirements. Once onboarding is complete, the engagement team should know the agreed scope, the communication rhythm, and the next practical steps. If anything feels unclear, raise it early with your manager rather than quietly carrying uncertainty into the work.
Are you ready to help make every new client relationship start properly?
In breve: GPT-5.5 ha superato il test e ha rispettato ogni vincolo (12/12).
GPT-5.5 è in distribuzione nei soliti canali a partire da oggi. Gli utenti Plus, Pro, Business ed Enterprise ottengono GPT-5.5 sia in ChatGPT sia in Codex, e gli utenti Pro, Business ed Enterprise ottengono anche GPT-5.5 Pro in ChatGPT.
OpenAI afferma che GPT-5.5 e GPT-5.5 Pro arriveranno molto presto tramite le API Responses e Chat Completions con una finestra di contesto da 1M di token. In altre release, OpenAI ha fornito l'accesso alle API contemporaneamente.
OpenAI ha classificato GPT-5.5 come High sia per capacità biologiche/chimiche sia per cybersicurezza nel suo Preparedness Framework. È questo il motivo del ritardo dell'API. OpenAI afferma che servire un modello classificato High alla scala dell'API richiede ulteriori salvaguardie su cui sta lavorando.
Due conseguenze pratiche per gli utenti:
È la prima volta che OpenAI differenzia formalmente l'accesso alla cybersicurezza in base a chi fa la richiesta. La cybersicurezza è stata molto nei notiziari di recente. Abbiamo scritto di temi di cybersicurezza nel nostro articolo su Claude Opus 4.7, che è un fratello ridimensionato del Mythos Preview interno di Anthropic, per il quale c'erano preoccupazioni che potesse sfruttare vulnerabilità zero-day e altro.
Come detto, ci sono stati guadagni in efficienza. Dobbiamo anche dire che il prezzo per token è aumentato.
Abbiamo testato GPT-5.5 sugli stessi prompt usati nel nostro articolo su Claude Opus 4.7, così da poter usare quei risultati insieme ai punteggi di benchmark per confrontare direttamente i due modelli.
Il succo: GPT-5.5 ha colmato il gap sul lungo contesto che rendeva GPT-5.4 una scelta debole per lavori su documenti, ma i guadagni di efficienza sembrano essere arrivati a costo dell'affidabilità aritmetica. GPT-5.5 è in leggero vantaggio sul rispetto rigoroso delle istruzioni ed è ora prezzato sopra Opus 4.7 sui token in output.
Opus 4.7 guida ancora su SWE-bench Pro (64,3% vs 58,6%), ma GPT-5.5 è passato nettamente avanti su Terminal-Bench 2.0 (82,7% vs 69,4%), quindi il quadro sul coding ora si divide per ambiente: Opus 4.7 per l'ingegneria a livello di repository, GPT-5.5 per workflow intensivi da terminale.
Il nuovo modello di OpenAI è generalmente accolto positivamente. Gli utenti apprezzano soprattutto la velocità e la concisione nel fornire risultati utili.
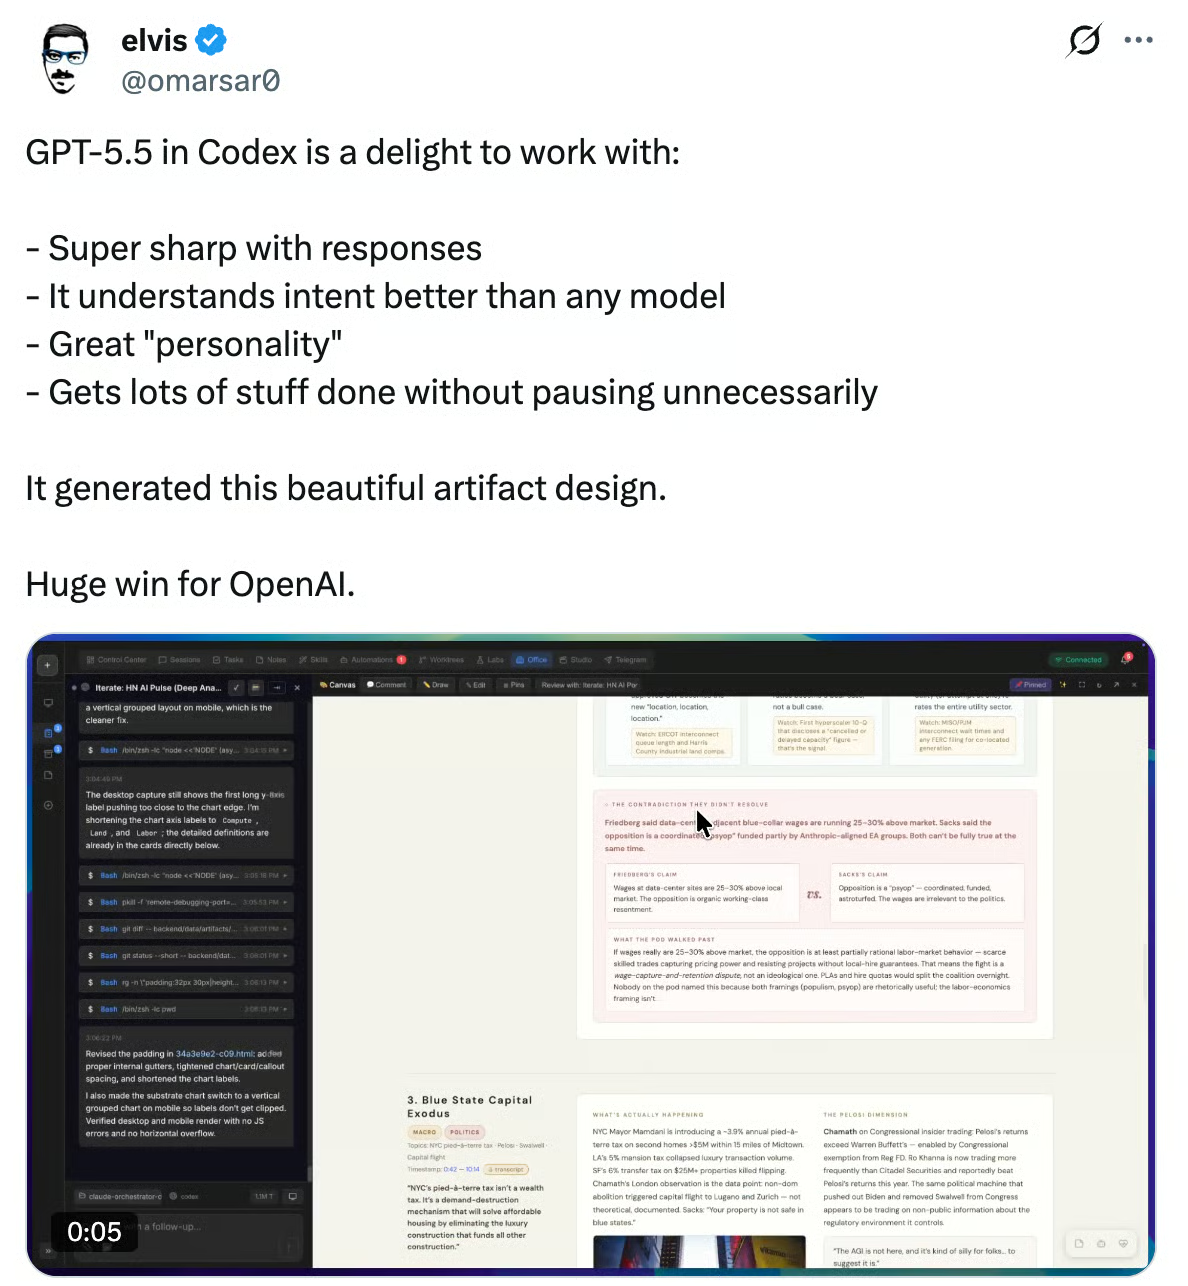
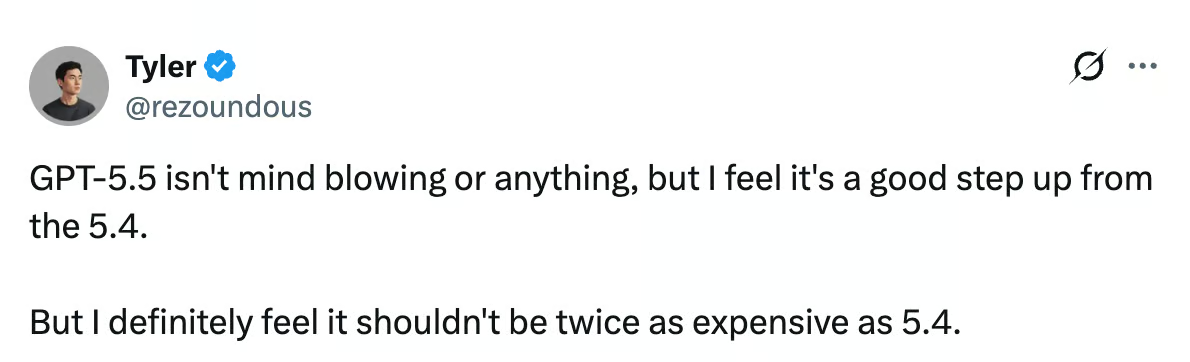
Altri utenti notano che, sebbene possa essere un passo avanti rispetto a GPT-5.4, potrebbe non bastare a giustificare l'aumento di prezzo significativo.
GPT-5.5 è un aggiornamento incrementale delle capacità accompagnato da un aggiornamento non incrementale delle policy. Il modello è più veloce, più economico per task e significativamente migliore nel lavoro su contesti lunghi. Queste affermazioni si vedono chiaramente nei risultati dei benchmark.
I nostri test offrono un quadro più sfumato. I miglioramenti sul lungo contesto sono reali e GPT-5.5 ha rispettato tutti e 12 i vincoli nel nostro test di rispetto delle istruzioni (un prompt in cui sia Claude Opus 4.7 sia Sonnet 4.6 hanno fatto 11/12), ma i guadagni di efficienza sono arrivati con un costo: GPT-5.5 ha fallito ripetutamente un task di somma che GPT-5.4 gestiva dopo una semplice divisione del prompt. Questo suggerisce un trade-off tra concisione dell'output e performance di ragionamento.
La release è anche la prima volta che OpenAI differenzia formalmente l'accesso alla cybersicurezza in base a chi fa la richiesta, uno sviluppo interessante per l'intero settore.
Se usi ChatGPT o Codex, hai accesso al nuovo modello oggi. Se usi l'API, devi aspettare, il che, come abbiamo notato, non è il solito modus operandi di OpenAI, ma probabilmente arriverà presto.
Impara con DataCamp
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



