Corso
Introduzione agli Embeddings con l'API di OpenAI
3 ore
24.1K
Pratica and corso your progress.
Continua Con GoogleIl text embedding (lo stesso concetto dei word embeddings) è una tecnica trasformativa nel campo del natural language processing (NLP) che ha migliorato il modo in cui le macchine comprendono ed elaborano il linguaggio umano.
Il text embedding converte il testo grezzo in vettori numerici, consentendo ai computer di capirlo meglio.
Il motivo è semplice: i computer ragionano solo con i numeri e non possono comprendere autonomamente le parole umane. Grazie ai text embeddings, per i computer è più facile leggere, comprendere i testi e fornire risposte più accurate alle richieste.
In questo articolo analizzeremo il significato del text embedding, la sua importanza, la sua evoluzione, i casi d'uso, i modelli principali e l'intuizione alla base.
I text embeddings sono un modo per convertire parole o frasi del testo in dati numerici che una macchina può comprendere. Puoi pensarli come la trasformazione del testo in un elenco di numeri, dove ogni numero cattura una parte del significato del testo. Questa tecnica aiuta le macchine ad afferrare il contesto e le relazioni tra le parole.
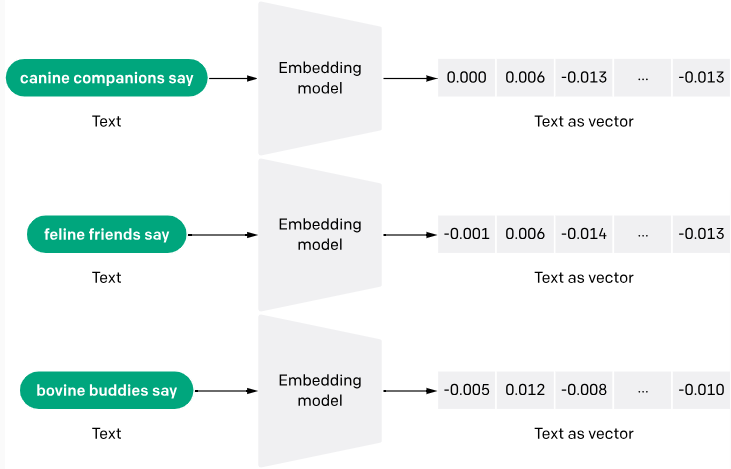
Il processo di generazione dei text embeddings spesso coinvolge reti neurali che imparano a codificare il significato semantico delle parole in vettori densi di numeri reali. Metodi come Word2Vec e GloVe sono popolari per generare questi embedding analizzando la co-occorrenza delle parole in grandi quantità di testo.
Puoi approfondire i text embeddings con le API di OpenAI e vedere un'applicazione pratica in un articolo dedicato.
I modelli linguistici tradizionali consideravano le parole come unità indipendenti. I word embeddings risolvono questo problema posizionando parole che condividono significati o contesti vicini tra loro in uno spazio multidimensionale.
Ecco altre ragioni per cui i text embeddings sono importanti:
Gli embedding aiutano i modelli a generalizzare meglio parole o frasi nuove e mai viste, usando il contesto appreso dai dati di training. Questo è particolarmente utile in lingue dinamiche in cui emergono frequentemente nuovi termini.
Gli embedding sono ampiamente usati come feature in vari compiti di machine learning, come la classificazione di documenti, l'analisi del sentiment e la traduzione automatica. Migliorano le prestazioni degli algoritmi fornendo una forma di dati ricca e condensata che cattura le proprietà testuali di base.
I text embeddings sono in grado di gestire più lingue identificando e rappresentando similarità semantiche tra idiomi diversi. Un esempio è il modello Language-agnostic BERT Sentence Embedding (LaBSE), che ha mostrato notevoli capacità nel produrre sentence embeddings cross-lingua che coprono 109 lingue.
Metodi tradizionali come la one-hot encoding possono generare dati sparsi (soprattutto perché la maggior parte delle osservazioni ha valore 0) e vettori ad alta dimensionalità, inefficaci per vocabolari grandi. Gli embedding riducono la dimensionalità e la complessità computazionale, rendendoli più adatti a gestire grandi quantità di testo.
I text embeddings sono rappresentazioni vettoriali dense di dati testuali, in cui parole e documenti con significati simili sono rappresentati da vettori simili in uno spazio vettoriale ad alta dimensionalità.
L'intuizione alla base dei text embeddings è catturare le relazioni semantiche e contestuali tra elementi testuali, permettendo ai modelli di machine learning di ragionare ed elaborare i dati testuali in modo più efficace.
Una delle intuizioni fondamentali dietro i text embeddings è l'ipotesi distribuzionale, secondo cui parole o frasi che compaiono in contesti simili tendono ad avere significati simili.
Ad esempio, considera le parole "king" e "queen". Sebbene non siano sinonimi, condividono un contesto simile legato alla regalità e alla monarchia. I text embeddings mirano a catturare questa somiglianza semantica rappresentando queste parole con vettori vicini nello spazio vettoriale.
Un'altra intuizione alla base dei text embeddings è l'idea delle operazioni nello spazio vettoriale. Rappresentando il testo come vettori numerici, possiamo usare operazioni come addizione, sottrazione e similarità coseno per catturare e manipolare le relazioni semantiche tra parole e frasi. Per esempio, considera il seguente caso:
king - man + woman ≈ queen
In questo esempio, l'operazione vettoriale "king - man + woman" potrebbe produrre un vettore molto vicino all'embedding di "queen", catturando la relazione analogica tra queste parole.
Un'altra intuizione che vorrei evidenziare è la riduzione della dimensionalità nel text embedding. Le rappresentazioni testuali sparse tradizionali, come la one-hot encoding, possono avere una dimensionalità estremamente alta (pari alla dimensione del vocabolario). I text embeddings, invece, hanno tipicamente una dimensionalità inferiore (es. 300 dimensioni), consentendo di catturare le caratteristiche più salienti del testo riducendo rumore e complessità computazionale.
Userò l'esempio di un ristorante per illustrare un'intuizione generale dei word embeddings:
Immagina di avere un corpus di recensioni di ristoranti e di voler costruire un sistema che classifichi automaticamente il sentiment di ciascuna recensione come positivo o negativo. Consiglio di usare i text embeddings per rappresentare ogni recensione come un vettore denso, in modo da catturare il significato semantico e il sentiment espresso nel testo.
Consideriamo due recensioni:
Recensione 1: "The food was delicious, and the service was excellent. I highly recommend this restaurant."
Recensione 2: "The food was mediocre, and the service was poor. I won't be going back."
Anche se queste recensioni non condividono molte parole, i loro embedding dovrebbero essere distanti tra loro nello spazio vettoriale, riflettendo i sentiment opposti espressi. Le parole dal sentiment positivo come "delicious" ed "excellent" nella Recensione 1 avranno embedding più vicini alla regione positiva dello spazio vettoriale, mentre le parole dal sentiment negativo come "mediocre" e "poor" nella Recensione 2 avranno embedding più vicini alla regione negativa.
Addestrando un modello di machine learning su questi text embeddings, esso può imparare a mappare gli schemi semantici e le informazioni di sentiment codificati negli embedding alle etichette corrispondenti (positivo o negativo), classificando con precisione nuove recensioni mai viste.
Secondo il libro “Embeddings in Natural Language Processing: Theory and Advances in Vector Representations of Meaning” di Mohammad Taher Pilehvar e Jose Camacho-Collados, i text embeddings sono stati
“resi popolari soprattutto dopo il 2013, con l'introduzione di Word2vec.”
Quell'anno ha segnato davvero una grande svolta per i text embeddings. Tuttavia, la ricerca sui text embeddings risale addirittura agli anni Cinquanta. Pur non essendo esaustiva, questa sezione copre alcune tappe fondamentali dell'evoluzione dei text embeddings.
Dagli anni '50 ai 2000, metodi come la one-hot encoding e il Bag-of-Words (BoW) erano la norma. Purtroppo, questi metodi non erano molto adeguati e presentavano alcune criticità, come:
TF-IDF (Term Frequency-Inverse Document Frequency) è stato un altro tentativo precoce negli anni '70 di catturare i testi come numeri. Questo approccio calcolava il peso di ogni parola non solo in base alla sua frequenza in un documento specifico, ma anche in base alla sua diffusione nell'intero insieme di documenti, assegnando valori più alti alle parole meno comuni. Pur migliorando la one-hot encoding offrendo maggiori informazioni, risultava comunque carente nel catturare il significato semantico delle parole.
Secondo IBM, gli anni 2000 si sono aperti con i ricercatori
“che esploravano i neural language models (NLM), i quali utilizzano reti neurali per modellare le relazioni tra le parole in uno spazio continuo. Questi primi modelli hanno posto le basi per lo sviluppo successivo dei word embeddings.”
Un esempio precoce è l'introduzione dei "Neural probabilistic language models" da parte di Bengio et al. intorno al 2000, che miravano a imparare rappresentazioni distribuite delle parole.
Successivamente, nel 2013, Word2Vec fece il suo ingresso come modello rivoluzionario che introdusse l'idea di trasformare le parole in vettori numerici. Questi vettori catturavano le somiglianze semantiche, per cui parole con significati simili finivano più vicine nello spazio vettoriale. Era come creare una mappa delle parole in base alle loro relazioni.
Nel 2014, GloVe fu presentato in un articolo di ricerca intitolato “Glove: Global Vectors for Word Representation” da Jeffery Pennington e coautori. GloVe migliorò Word2Vec comprendendo meglio i significati delle parole, considerando sia il contesto immediato di una parola sia l'uso complessivo nell'intero corpus.
In questo periodo emersero metodi come i meccanismi di attention (2017) e il Transfer Learning e il Contesto (2018).
I meccanismi di attention consentivano ai modelli di concentrarsi su parti specifiche di una frase e di assegnare loro pesi diversi in base alla loro importanza. Questo aiutava il modello a comprendere le relazioni tra le parole e come contribuivano al significato.
Ad esempio, nella frase "The quick brown fox jumps over the lazy dog", il meccanismo di attention potrebbe prestare più attenzione a "quick" e "jumps" nel predire la parola successiva, rispetto a "the" o "brown".
D'altro canto, il Transfer Learning e il Contesto hanno portato all'uso di modelli pre-addestrati. Tecniche come ULMFiT e BERT hanno permesso di effettuare il fine-tuning di questi modelli per compiti specifici. Ciò significava meno dati e potenza di calcolo necessari per alte prestazioni.
Le embedding API rappresentano un approccio recente al text embedding. Pur essendo recente, la loro graduale comparsa risale agli anni 2010, quando le soluzioni di AI basate sul cloud e i progressi nei modelli pre-addestrati stavano diventando diffusi.
Arrivando ai 2020. L'adozione delle API è cresciuta enormemente nella comunità degli sviluppatori, e così anche le embedding API. Un'embedding API semplifica l'ottenimento di embedding di testi tramite modelli pre-addestrati.
Un buon esempio di embedding API è la Embedding API di OpenAI. OpenAI ha introdotto la sua Embedding API con importanti aggiornamenti nel dicembre 2022. Questa API offre un modello unificato noto come text-embedding-ada-002, che integra le capacità di diversi modelli precedenti in un unico modello. È stato progettato per eccellere in compiti come la ricerca di testo, la ricerca di codice e la similarità tra frasi.
Vediamo alcuni casi d'uso dei text embeddings.
I word embeddings consentono ai motori di ricerca di comprendere il significato sottostante della tua query e trovare documenti pertinenti, anche se non contengono esattamente le parole che hai usato. Questo è particolarmente utile per ricerche ambigue o per trovare contenuti simili.
Piattaforme di e-commerce, social media e servizi di streaming sono esempi comuni di applicazioni che usano i text embeddings per consigliare prodotti o contenuti in base alle tue preferenze passate. Analizzando le descrizioni e le recensioni degli elementi con cui hai interagito, possono suggerire cose simili che potrebbero interessarti.
Meta (Facebook) utilizza i text embeddings per la sua ricerca sociale. Puoi saperne di più in questo abstract.
I text embeddings vanno oltre la traduzione parola per parola. Considerano il contesto e il significato del testo, portando a traduzioni più accurate e naturali.
I chatbot basati su text embeddings possono comprendere l'intento dietro le tue domande e rispondere in modo più ragionevole e coinvolgente. Possono analizzare il sentiment del tuo messaggio e adattare di conseguenza lo stile di comunicazione.
I word embeddings possono essere utilizzati per generare diversi formati di testo creativo, come descrizioni di prodotti o post sui social media. I brand possono anche usare i text embeddings per analizzare le conversazioni sui social e capire il sentiment dei clienti verso i loro prodotti o servizi.
Ecco una panoramica dei principali modelli di text embedding, tra opzioni open-source e closed-source:
Come già accennato, Word2Vec è uno dei modelli pionieristici di text embedding. È stato sviluppato da Tomas Mikolov e colleghi di Google. Word2Vec usa reti neurali poco profonde per generare vettori di parole che catturano somiglianze semantiche.
Word2Vec utilizza due architetture: Continuous Bag-of-Words (CBOW) e Skip-Gram. CBOW predice una parola in base al contesto circostante, mentre Skip-Gram predice le parole circostanti a partire da una data parola. Questo processo aiuta a codificare le relazioni semantiche tra parole.
Librerie NLP popolari come Gensim e spaCY offrono implementazioni di Word2Vec. Puoi trovare la versione open-source di Word2vec ospitata da Google e rilasciata sotto licenza Apache 2.0.
GloVe di Stanford è un altro modello ampiamente utilizzato. Si concentra sulla cattura del contesto sia locale sia globale analizzando le statistiche di co-occorrenza delle parole in un ampio corpus testuale. GloVe costruisce una matrice di co-occorrenza delle parole e poi la fattorizza per ottenere i vettori. Questo processo considera co-occorrenze sia vicine sia lontane, portando a una comprensione completa del significato delle parole.
GloVe è anch'esso open-source. I vettori GloVe pre-addestrati sono disponibili per il download e le implementazioni si trovano anche in librerie come Gensim.
FastText, sviluppato da Facebook (ora Meta), è un'estensione di Word2Vec che affronta il limite di non gestire parole fuori vocabolario (OOV). Incorpora informazioni sui sotto-parole per rappresentare i termini, consentendo di creare embedding per parole non viste.
FastText scompone le parole in n-grammi di caratteri (subword). In modo simile a Word2Vec, addestra vettori di parole basandosi su queste unità subword. Ciò permette al modello di rappresentare nuove parole in base al significato dei loro sotto-componenti.
FastText è open-source e disponibile tramite la libreria FastText. Vettori FastText pre-addestrati possono anche essere scaricati per varie lingue.
L'embedding v3 (Text-embedding-3) è l'ultima release dei modelli di embedding di OpenAI. I modelli sono disponibili in due classi: text-embedding-3-small (il modello più piccolo) e text-embedding-3-large (il modello più grande). Sono closed-source e serve un'API a pagamento per accedervi.
I modelli Text-embedding-3 trasformano il testo in rappresentazioni numeriche suddividendolo prima in token (parole o sotto-parole). Ogni token è mappato a un vettore in uno spazio ad alta dimensionalità. Un encoder Transformer analizza poi questi vettori, considerando il contesto di ogni parola in base al suo intorno.
Infine, il modello produce un singolo vettore che rappresenta l'intero testo, catturandone il significato complessivo e le relazioni tra le parole al suo interno. La versione large vanta un'architettura più complessa e una dimensionalità maggiore per una potenziale migliore accuratezza, mentre la versione small privilegia velocità ed efficienza con un'architettura più semplice e una dimensionalità inferiore.
Per saperne di più sugli embeddings di OpenAI, leggi la nostra guida: Exploring Text-Embedding-3-Large: A Comprehensive Guide to the new OpenAI Embeddings.
USE è un modello closed-source per l'embedding di frasi creato da Google AI. Converte il testo in embedding ad alta dimensionalità che riflettono i significati semantici di frasi o brevi paragrafi.
A differenza dei modelli che eseguono l'embedding di singole parole, USE gestisce intere frasi usando una rete neurale profonda pre-addestrata su un corpus testuale variegato. Questo design consente di catturare efficacemente le relazioni semantiche, producendo vettori a dimensione fissa per frasi a lunghezza variabile che migliorano l'efficienza computazionale.
Google fornisce l'accesso tramite il repository TensorFlow Hub.
In questa guida abbiamo ottenuto un'introduzione completa ai text embeddings: cosa sono, perché sono importanti e le principali tappe della loro evoluzione. Abbiamo anche esaminato i casi d'uso e i modelli più importanti.
Per imparare in profondità su AI, NLP e text embeddings, dai un'occhiata a queste risorse:
Scopri di più sull'AI con DataCamp
Corso
Programma
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



