文本嵌入(与词嵌入相同)是一种变革性的自然语言处理(NLP)技术,显著提升了机器理解与处理人类语言的能力。
文本嵌入将原始文本转换为数值向量,从而让计算机更好地理解文本。
原因很简单——计算机只以数字“思考”,无法独立理解人类的词语。得益于文本嵌入,计算机更容易阅读、理解文本,并对查询提供更准确的响应。
本文将剖析文本嵌入的含义、重要性、演进、用例、顶尖模型与直观理解。
什么是文本嵌入?
文本嵌入是一种将文本中的单词或短语转换为机器可理解的数值数据的方式。可以将其视为把文本变成一串数字,其中每个数字都捕捉了文本含义的一部分。这项技术帮助机器把握词语之间的上下文与关系。
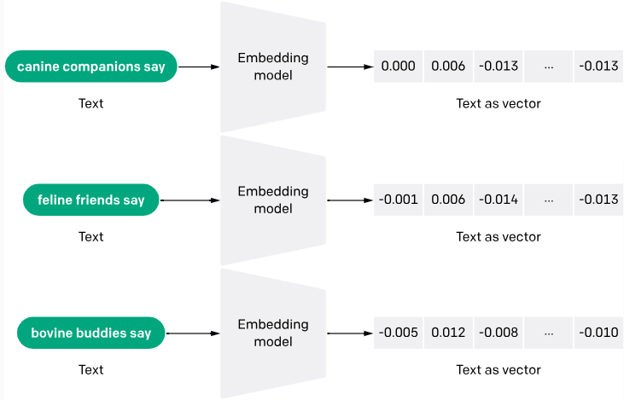
来源
生成文本嵌入的过程通常涉及神经网络,它们学习将词语的语义编码为稠密的实数向量。像Word2Vec和GloVe等方法通过分析大规模文本中词语的共现来生成这些嵌入。
您可以在另一篇文章中进一步了解使用 OpenAI API 的文本嵌入并查看一个实际应用。
为什么文本嵌入很重要?
传统语言模型将词语视为相互独立的单元。词嵌入通过在多维空间中将意义或上下文相近的词语彼此靠近来解决这一问题。
以下是文本嵌入重要的更多原因:
泛化能力
嵌入帮助模型利用从训练数据中学到的上下文,更好地对新的、未见过的词语或短语进行泛化。这在新词频繁涌现的动态语言环境中尤为有用。
改进机器学习任务
嵌入被广泛用作各类机器学习任务的特征,如文档分类、情感分析和机器翻译。它们以丰富而精炼的数据形式提供基本文本属性,从而提升算法性能。
语言无关的处理
文本嵌入能够跨多种语言识别并表示语义相似性。例如,Language-agnostic BERT Sentence Embedding(LaBSE)模型在生成覆盖 109 种语言的跨语言句子嵌入方面展现了卓越能力。
处理大型词汇表
传统方法如独热编码会生成稀疏数据(尤其是大部分观测为 0)和高维向量,对于大型词汇表效率低下。嵌入降低了维度与计算复杂度,更适合处理海量文本数据。
文本嵌入的直观理解
文本嵌入是文本数据的稠密向量表示,含义相近的词语与文档在高维向量空间中由相似的向量表示。
其直观目标是捕捉文本要素之间的语义与上下文关系,使机器学习模型能够更有效地推理与处理文本数据。
分布式假设
文本嵌入的一项核心直觉是分布式假设,即在相似上下文中出现的词语或短语往往具有相似的含义。
例如,考虑“king”和“queen”。虽然它们并非同义词,但都与王室和君主制相关,具有相似的语境。文本嵌入旨在通过将这些词表示为在向量空间中彼此接近的向量来捕捉这种语义相似性。
向量空间操作
文本嵌入的另一种直觉是向量空间操作的思想。通过将文本表示为数值向量,我们可以使用加法、减法和余弦相似度等向量空间操作来捕捉并操控词语与短语之间的语义关系。例如,考虑以下示例:
king - man + woman ≈ queen
在这个例子中,“king - man + woman”的向量运算可能得到一个与“queen”的嵌入非常接近的向量,从而捕捉这些词之间的类比关系。
降维
我想强调的另一点直觉是文本嵌入中的降维。传统的稀疏文本表示(如独热编码)维度极高(等于词汇表大小)。而文本嵌入通常维度更低(如 300 维),既能抓住文本的关键信息,又能降低噪声与计算复杂度。
餐厅案例研究
我将以餐厅为例来说明对词嵌入的一般直观理解:
假设您有一组餐厅点评语料库,希望构建一个系统,自动将每条点评的情感分类为正面或负面。我建议使用文本嵌入将每条点评表示为稠密向量,从而捕捉文本中的语义与情感。
我们来看两条点评:
点评 1:"The food was delicious, and the service was excellent. I highly recommend this restaurant."
点评 2:"The food was mediocre, and the service was poor. I won't be going back."
尽管这两条点评并没有太多相同的词,它们的嵌入在向量空间中应彼此相距较远,以反映所表达情感的对立性。点评 1 中如“delicious”和“excellent”等正面情感词的嵌入会更接近向量空间的正面区域,而点评 2 中如“mediocre”和“poor”等负面情感词则更接近负面区域。
通过在这些文本嵌入上训练机器学习模型,模型可以学习将嵌入中编码的语义模式和情感信息映射到相应的情感标签(正面或负面),从而准确分类新的、未见过的点评。
文本嵌入的演进
根据 Mohammad Taher Pilehvar 与 Jose Camacho-Collados 合著的《Embeddings in Natural Language Processing: Theory and Advances in Vector Representations of Meaning》一书,文本嵌入
“主要在 2013 年后随着 Word2vec 的引入而普及。”
那一年确实标志着文本嵌入的重大突破。然而,对文本嵌入的研究可追溯至 20 世纪 50 年代。尽管本节并不穷尽,我将涵盖文本嵌入演进中的一些重要里程碑。
早期阶段(1950 年代—2000 年代)
在 1950—2000 年代,独热编码与词袋(BoW)等方法是常态。不幸的是,这些方法能力不足,并带来如下挑战:
- 关注词频而非含义:这些方法将文档视为独立词语的集合,仅统计每个词出现的频次,忽视了词语之间的语义关系与上下文。例如,“The bank is on the river”和“I went bankrupt”会因为共享一些词而被类似对待,尽管二者含义迥异。
- 难以处理同义与一词多义:BoW 无法区分含义相近的词(同义词)或在不同上下文下具有多重含义的词(一词多义),这使得理解语言变得困难。
TF-IDF(词频-逆文档频率)是在 70 年代将文本数值化的另一次早期尝试。该方法不仅根据词在特定文档中的出现频率计算权重,还考虑其在所有文档中的常见程度,为较少见的词赋予更高的权重。尽管相比独热编码有所改进并提供了更多洞见,但仍未能充分捕捉词语的语义。
嵌入的曙光(2000 年代—2010 年代)
据IBM所述,2000 年代研究者
“开始探索神经语言模型(NLMs),即使用神经网络在连续空间中建模词语之间的关系。这些早期模型为后续词嵌入的发展奠定了基础。”
一个早期例子是 Bengio 等人在 2000 年前后提出的“神经概率语言模型”,旨在学习词语的分布式表示。
随后在 2013 年,Word2Vec横空出世,提出将词语转换为数值向量的革命性思路。这些向量能够捕捉语义相似性,使得意义相近的词在向量空间中彼此更近,如同基于关系绘制的词语地图。
2014 年,GloVe在题为《Glove: Global Vectors for Word Representation》的论文中由 Jeffery Pennington 及其合作者提出。GloVe 通过同时考虑词语的局部上下文与在整个语料中的总体使用,进一步改进了 Word2Vec 对词义的把握。
超越词语:句子与注意力(2010 年代—2020 年代)
在此期间,注意力机制(2017)以及迁移学习与上下文(2018)等方法相继出现。
注意力机制使模型能够聚焦句子中的特定部分,并根据其重要性赋予不同权重,从而帮助模型理解词语间的关系以及它们对整体含义的贡献。
例如,在句子“The quick brown fox jumps over the lazy dog”中,注意力机制在预测下一个词时,可能会比“the”或“brown”更关注“quick”和“jumps”。
另一方面,迁移学习与上下文促进了预训练模型的使用。诸如 ULMFiT 和BERT等技术允许对预训练模型进行任务微调,这意味着在保持高性能的同时,所需数据与算力更少。
嵌入 API 的出现
嵌入 API 是一种较新的文本嵌入途径。尽管较新,其逐步兴起可追溯至 2010 年代,当时云端 AI 解决方案与预训练模型的进步日益普及。
快进到 2020 年代。API 在开发者社区的采用急剧增长,嵌入 API 亦然。嵌入 API 让基于预训练模型获取文本嵌入变得更容易。
一个很好的例子是OpenAI 嵌入 API。OpenAI 于 2022 年 12 月对其嵌入 API 进行了重要更新,推出了统一模型 text-embedding-ada-002,将多个先前模型的能力整合为单一模型。该模型旨在在文本搜索、代码搜索与句子相似度等任务上表现出色。
文本嵌入的用例
我们来讨论一些文本嵌入的用例。
信息检索与搜索
词嵌入让搜索引擎理解查询背后的真实含义,并找到相关文档,即便其中不包含您使用的完全相同的词语。这对存在歧义的搜索或查找相似内容尤为有用。
电商平台、社交媒体平台与流媒体服务都是常见应用示例,它们使用文本嵌入基于您的过往偏好推荐产品或内容。通过分析您互动过的条目的描述与评论,它们可以建议您可能感兴趣的相似内容。
Meta(Facebook)在其社交搜索中使用文本嵌入。您可以在这篇摘要中了解更多。
机器翻译与聊天机器人
文本嵌入并非逐词对应翻译。它们会考虑文本的上下文与含义,从而带来更准确、听起来更自然的翻译。
由文本嵌入驱动的聊天机器人能够理解您问题背后的意图,并做出更合理且更具互动性的回应。它们可以分析您的消息情感,并据此调整交流风格。
内容创作与分析
词嵌入可用于生成多种创意文本形式,如产品描述或社交媒体帖子。品牌也可以利用文本嵌入分析社交媒体对话,了解消费者对其产品或服务的情感态度。
五大文本嵌入模型
以下是顶尖文本嵌入模型概览,涵盖开源与闭源选项:
Word2Vec
如前所述,Word2Vec 是最早的文本嵌入模型之一,由谷歌的 Tomas Mikolov 及其同事开发。Word2Vec 使用浅层神经网络生成能够捕捉语义相似性的词向量。
Word2Vec 采用两种架构:连续词袋(CBOW)与 Skip-Gram。CBOW 基于上下文预测目标词,而 Skip-Gram 则基于给定词预测其周围词语。这个过程帮助编码词语之间的语义关系。
Gensim 与 spaCy 等常用 NLP 库提供了 Word2Vec 的实现。您可以找到由谷歌托管并以 Apache 2.0 许可发布的Word2Vec 开源版本。
GloVe
斯坦福的 GloVe 是另一个广泛使用的模型。它通过分析大规模语料中词语的共现统计,同时捕捉局部与全局上下文。GloVe 构建词共现矩阵并进行分解以获得词向量,这一过程兼顾近距离与远距离的共现,从而更全面地理解词义。
GloVe 亦为开源。可下载预训练的 GloVe 向量,Gensim 等库中也提供了实现。
FastText
FastText 由 Facebook(现 Meta)开发,是对 Word2Vec 的扩展,用以解决未登录词(OOV)处理的限制。它引入子词信息来表示词语,使其能够为未见过的词生成嵌入。
FastText 将词分解为字符 n-gram(子词)。与 Word2Vec 类似,它基于这些子词单元训练词向量。这使模型能够基于组成子词的含义来表示新词。
FastText 是开源的,可通过 FastText 库使用。还可下载多种语言的预训练 FastText 向量。
embedding v3
embedding v3(Text-embedding-3)是 OpenAI 最新发布的嵌入模型系列。该系列包含两类模型:text-embedding-3-small(小型模型)与text-embedding-3-large(大型模型)。它们为闭源,需付费 API 才能访问。
Text-embedding-3 模型先将文本拆分为 token(词或子词),再将每个 token 映射到高维空间中的向量。随后 Transformer 编码器对这些向量进行分析,并基于词语的周围环境考虑其上下文。
最终,模型输出一个代表整段文本的单一向量,既捕捉其整体含义,也反映内部词语之间的关系。大型模型拥有更复杂的架构与更高的维度,潜在准确性更高;小型模型则以更简洁的架构与更低的维度优先保障速度与效率。
如需进一步了解 OpenAI 嵌入,请参阅我们的指南:Exploring Text-Embedding-3-Large: A Comprehensive Guide to the new OpenAI Embeddings。
Universal Sentence Encoder(USE)
USE 是由 Google AI 创建的闭源句子嵌入模型。它将文本转换为高维嵌入,反映句子或短段落的语义。
不同于逐词嵌入的模型,USE 使用在多样化语料上预训练的深度神经网络处理整句。这种设计能有效捕捉语义关系,为变长句子生成定长向量,从而提升计算效率。
Google 通过其 TensorFlow Hub 仓库提供访问。
开始使用文本嵌入
在本指南中,我们系统介绍了文本嵌入的概念、重要性以及其演进中的主要里程碑,并考察了文本嵌入的用例与顶尖模型。
若要深入学习 AI、NLP 与文本嵌入,请查看以下资源:


文本嵌入(与词嵌入相同)是一种变革性的自然语言处理(NLP)技术,显著提升了机器理解与处理人类语言的能力。
文本嵌入将原始文本转换为数值向量,从而让计算机更好地理解文本。
原因很简单——计算机只以数字“思考”,无法独立理解人类的词语。得益于文本嵌入,计算机更容易阅读、理解文本,并对查询提供更准确的响应。
本文将剖析文本嵌入的含义、重要性、演进、用例、顶尖模型与直观理解。
什么是文本嵌入?
文本嵌入是一种将文本中的单词或短语转换为机器可理解的数值数据的方式。可以将其视为把文本变成一串数字,其中每个数字都捕捉了文本含义的一部分。这项技术帮助机器把握词语之间的上下文与关系。
来源
生成文本嵌入的过程通常涉及神经网络,它们学习将词语的语义编码为稠密的实数向量。像Word2Vec和GloVe等方法通过分析大规模文本中词语的共现来生成这些嵌入。
您可以在另一篇文章中进一步了解使用 OpenAI API 的文本嵌入并查看一个实际应用。
为什么文本嵌入很重要?
传统语言模型将词语视为相互独立的单元。词嵌入通过在多维空间中将意义或上下文相近的词语彼此靠近来解决这一问题。
以下是文本嵌入重要的更多原因:
泛化能力
嵌入帮助模型利用从训练数据中学到的上下文,更好地对新的、未见过的词语或短语进行泛化。这在新词频繁涌现的动态语言环境中尤为有用。
改进机器学习任务
嵌入被广泛用作各类机器学习任务的特征,如文档分类、情感分析和机器翻译。它们以丰富而精炼的数据形式提供基本文本属性,从而提升算法性能。
语言无关的处理
文本嵌入能够跨多种语言识别并表示语义相似性。例如,Language-agnostic BERT Sentence Embedding(LaBSE)模型在生成覆盖 109 种语言的跨语言句子嵌入方面展现了卓越能力。
处理大型词汇表
传统方法如独热编码会生成稀疏数据(尤其是大部分观测为 0)和高维向量,对于大型词汇表效率低下。嵌入降低了维度与计算复杂度,更适合处理海量文本数据。
文本嵌入的直观理解
文本嵌入是文本数据的稠密向量表示,含义相近的词语与文档在高维向量空间中由相似的向量表示。
其直观目标是捕捉文本要素之间的语义与上下文关系,使机器学习模型能够更有效地推理与处理文本数据。
分布式假设
文本嵌入的一项核心直觉是分布式假设,即在相似上下文中出现的词语或短语往往具有相似的含义。
例如,考虑“king”和“queen”。虽然它们并非同义词,但都与王室和君主制相关,具有相似的语境。文本嵌入旨在通过将这些词表示为在向量空间中彼此接近的向量来捕捉这种语义相似性。
向量空间操作
文本嵌入的另一种直觉是向量空间操作的思想。通过将文本表示为数值向量,我们可以使用加法、减法和余弦相似度等向量空间操作来捕捉并操控词语与短语之间的语义关系。例如,考虑以下示例:
king - man + woman ≈ queen
在这个例子中,“king - man + woman”的向量运算可能得到一个与“queen”的嵌入非常接近的向量,从而捕捉这些词之间的类比关系。
降维
我想强调的另一点直觉是文本嵌入中的降维。传统的稀疏文本表示(如独热编码)维度极高(等于词汇表大小)。而文本嵌入通常维度更低(如 300 维),既能抓住文本的关键信息,又能降低噪声与计算复杂度。
餐厅案例研究
我将以餐厅为例来说明对词嵌入的一般直观理解:
假设您有一组餐厅点评语料库,希望构建一个系统,自动将每条点评的情感分类为正面或负面。我建议使用文本嵌入将每条点评表示为稠密向量,从而捕捉文本中的语义与情感。
我们来看两条点评:
点评 1:"The food was delicious, and the service was excellent. I highly recommend this restaurant."
点评 2:"The food was mediocre, and the service was poor. I won't be going back."
尽管这两条点评并没有太多相同的词,它们的嵌入在向量空间中应彼此相距较远,以反映所表达情感的对立性。点评 1 中如“delicious”和“excellent”等正面情感词的嵌入会更接近向量空间的正面区域,而点评 2 中如“mediocre”和“poor”等负面情感词则更接近负面区域。
通过在这些文本嵌入上训练机器学习模型,模型可以学习将嵌入中编码的语义模式和情感信息映射到相应的情感标签(正面或负面),从而准确分类新的、未见过的点评。
文本嵌入的演进
根据 Mohammad Taher Pilehvar 与 Jose Camacho-Collados 合著的《Embeddings in Natural Language Processing: Theory and Advances in Vector Representations of Meaning》一书,文本嵌入
“主要在 2013 年后随着 Word2vec 的引入而普及。”
那一年确实标志着文本嵌入的重大突破。然而,对文本嵌入的研究可追溯至 20 世纪 50 年代。尽管本节并不穷尽,我将涵盖文本嵌入演进中的一些重要里程碑。
早期阶段(1950 年代—2000 年代)
在 1950—2000 年代,独热编码与词袋(BoW)等方法是常态。不幸的是,这些方法能力不足,并带来如下挑战:
TF-IDF(词频-逆文档频率)是在 70 年代将文本数值化的另一次早期尝试。该方法不仅根据词在特定文档中的出现频率计算权重,还考虑其在所有文档中的常见程度,为较少见的词赋予更高的权重。尽管相比独热编码有所改进并提供了更多洞见,但仍未能充分捕捉词语的语义。
嵌入的曙光(2000 年代—2010 年代)
据IBM所述,2000 年代研究者
“开始探索神经语言模型(NLMs),即使用神经网络在连续空间中建模词语之间的关系。这些早期模型为后续词嵌入的发展奠定了基础。”
一个早期例子是 Bengio 等人在 2000 年前后提出的“神经概率语言模型”,旨在学习词语的分布式表示。
随后在 2013 年,Word2Vec横空出世,提出将词语转换为数值向量的革命性思路。这些向量能够捕捉语义相似性,使得意义相近的词在向量空间中彼此更近,如同基于关系绘制的词语地图。
2014 年,GloVe在题为《Glove: Global Vectors for Word Representation》的论文中由 Jeffery Pennington 及其合作者提出。GloVe 通过同时考虑词语的局部上下文与在整个语料中的总体使用,进一步改进了 Word2Vec 对词义的把握。
超越词语:句子与注意力(2010 年代—2020 年代)
在此期间,注意力机制(2017)以及迁移学习与上下文(2018)等方法相继出现。
注意力机制使模型能够聚焦句子中的特定部分,并根据其重要性赋予不同权重,从而帮助模型理解词语间的关系以及它们对整体含义的贡献。
例如,在句子“The quick brown fox jumps over the lazy dog”中,注意力机制在预测下一个词时,可能会比“the”或“brown”更关注“quick”和“jumps”。
另一方面,迁移学习与上下文促进了预训练模型的使用。诸如 ULMFiT 和BERT等技术允许对预训练模型进行任务微调,这意味着在保持高性能的同时,所需数据与算力更少。
嵌入 API 的出现
嵌入 API 是一种较新的文本嵌入途径。尽管较新,其逐步兴起可追溯至 2010 年代,当时云端 AI 解决方案与预训练模型的进步日益普及。
快进到 2020 年代。API 在开发者社区的采用急剧增长,嵌入 API 亦然。嵌入 API 让基于预训练模型获取文本嵌入变得更容易。
一个很好的例子是OpenAI 嵌入 API。OpenAI 于 2022 年 12 月对其嵌入 API 进行了重要更新,推出了统一模型 text-embedding-ada-002,将多个先前模型的能力整合为单一模型。该模型旨在在文本搜索、代码搜索与句子相似度等任务上表现出色。
文本嵌入的用例
我们来讨论一些文本嵌入的用例。
信息检索与搜索
词嵌入让搜索引擎理解查询背后的真实含义,并找到相关文档,即便其中不包含您使用的完全相同的词语。这对存在歧义的搜索或查找相似内容尤为有用。
电商平台、社交媒体平台与流媒体服务都是常见应用示例,它们使用文本嵌入基于您的过往偏好推荐产品或内容。通过分析您互动过的条目的描述与评论,它们可以建议您可能感兴趣的相似内容。
Meta(Facebook)在其社交搜索中使用文本嵌入。您可以在这篇摘要中了解更多。
机器翻译与聊天机器人
文本嵌入并非逐词对应翻译。它们会考虑文本的上下文与含义,从而带来更准确、听起来更自然的翻译。
由文本嵌入驱动的聊天机器人能够理解您问题背后的意图,并做出更合理且更具互动性的回应。它们可以分析您的消息情感,并据此调整交流风格。
内容创作与分析
词嵌入可用于生成多种创意文本形式,如产品描述或社交媒体帖子。品牌也可以利用文本嵌入分析社交媒体对话,了解消费者对其产品或服务的情感态度。
五大文本嵌入模型
以下是顶尖文本嵌入模型概览,涵盖开源与闭源选项:
Word2Vec
如前所述,Word2Vec 是最早的文本嵌入模型之一,由谷歌的 Tomas Mikolov 及其同事开发。Word2Vec 使用浅层神经网络生成能够捕捉语义相似性的词向量。
Word2Vec 采用两种架构:连续词袋(CBOW)与 Skip-Gram。CBOW 基于上下文预测目标词,而 Skip-Gram 则基于给定词预测其周围词语。这个过程帮助编码词语之间的语义关系。
Gensim 与 spaCy 等常用 NLP 库提供了 Word2Vec 的实现。您可以找到由谷歌托管并以 Apache 2.0 许可发布的Word2Vec 开源版本。
GloVe
斯坦福的 GloVe 是另一个广泛使用的模型。它通过分析大规模语料中词语的共现统计,同时捕捉局部与全局上下文。GloVe 构建词共现矩阵并进行分解以获得词向量,这一过程兼顾近距离与远距离的共现,从而更全面地理解词义。
GloVe 亦为开源。可下载预训练的 GloVe 向量,Gensim 等库中也提供了实现。
FastText
FastText 由 Facebook(现 Meta)开发,是对 Word2Vec 的扩展,用以解决未登录词(OOV)处理的限制。它引入子词信息来表示词语,使其能够为未见过的词生成嵌入。
FastText 将词分解为字符 n-gram(子词)。与 Word2Vec 类似,它基于这些子词单元训练词向量。这使模型能够基于组成子词的含义来表示新词。
FastText 是开源的,可通过 FastText 库使用。还可下载多种语言的预训练 FastText 向量。
embedding v3
embedding v3(Text-embedding-3)是 OpenAI 最新发布的嵌入模型系列。该系列包含两类模型:
text-embedding-3-small(小型模型)与text-embedding-3-large(大型模型)。它们为闭源,需付费 API 才能访问。Text-embedding-3 模型先将文本拆分为 token(词或子词),再将每个 token 映射到高维空间中的向量。随后 Transformer 编码器对这些向量进行分析,并基于词语的周围环境考虑其上下文。
最终,模型输出一个代表整段文本的单一向量,既捕捉其整体含义,也反映内部词语之间的关系。大型模型拥有更复杂的架构与更高的维度,潜在准确性更高;小型模型则以更简洁的架构与更低的维度优先保障速度与效率。
如需进一步了解 OpenAI 嵌入,请参阅我们的指南:Exploring Text-Embedding-3-Large: A Comprehensive Guide to the new OpenAI Embeddings。
Universal Sentence Encoder(USE)
USE 是由 Google AI 创建的闭源句子嵌入模型。它将文本转换为高维嵌入,反映句子或短段落的语义。
不同于逐词嵌入的模型,USE 使用在多样化语料上预训练的深度神经网络处理整句。这种设计能有效捕捉语义关系,为变长句子生成定长向量,从而提升计算效率。
Google 通过其 TensorFlow Hub 仓库提供访问。
开始使用文本嵌入
在本指南中,我们系统介绍了文本嵌入的概念、重要性以及其演进中的主要里程碑,并考察了文本嵌入的用例与顶尖模型。
若要深入学习 AI、NLP 与文本嵌入,请查看以下资源: