Le scoperte scientifiche raramente avvengono nel vuoto. Piuttosto, sono spesso il penultimo gradino di una scala costruita su conoscenze umane accumulate. Per capire il successo dei large language model (LLM), come ChatGPT e Google Bart, dobbiamo tornare indietro nel tempo e parlare di BERT.
Sviluppato nel 2018 dai ricercatori di Google, BERT è uno dei primi LLM. Con risultati sorprendenti, è diventato rapidamente un riferimento onnipresente nei compiti di NLP, tra cui comprensione generale del linguaggio, question answering e riconoscimento di entità nominate.
Ti interessa saperne di più sugli LLM? Inizia oggi stesso il Capitolo 1 del nostro corso Large Language Models (LLMs) Concepts.
Si può dire che BERT abbia spianato la strada alla rivoluzione dell'IA generativa a cui stiamo assistendo oggi. Pur essendo uno dei primi LLM, BERT è ancora ampiamente usato, con migliaia di modelli BERT open source, gratuiti e preaddestrati disponibili per casi d'uso specifici, come l'analisi del sentiment, l'analisi di note cliniche e il rilevamento di commenti tossici.
Curioso di BERT? Continua a leggere: esploreremo l'architettura di BERT, il funzionamento interno della tecnologia, alcune applicazioni reali e i suoi limiti.
Che cos'è BERT?
BERT (acronimo di Bidirectional Encoder Representations from Transformers) è un modello open source sviluppato da Google nel 2018. È stato un esperimento ambizioso per testare le prestazioni del cosiddetto transformer – un'innovativa architettura neurale presentata dai ricercatori di Google nel famoso paper Attention is All You Need nel 2017 – sui compiti di elaborazione del linguaggio naturale (NLP).
La chiave del successo di BERT è la sua architettura a transformer. Prima dell'avvento dei transformer, modellare il linguaggio naturale era un compito molto impegnativo. Nonostante l'ascesa di reti neurali sofisticate – in particolare ricorrenti o convoluzionali – i risultati erano solo in parte soddisfacenti.
La principale difficoltà risiedeva nel meccanismo con cui le reti neurali prevedevano la parola mancante in una frase. All'epoca, le reti neurali allo stato dell'arte si basavano sull'architettura encoder-decoder, un meccanismo potente ma dispendioso in termini di tempo e risorse, non adatto al calcolo in parallelo.
Tenendo presenti queste sfide, i ricercatori di Google hanno sviluppato il transformer, un'innovativa architettura neurale basata sul meccanismo di attenzione, come spiegato nella sezione seguente.
Come funziona BERT?
Vediamo come funziona BERT, analizzando la tecnologia alla base del modello, come viene addestrato e come elabora i dati.
Architettura e funzionalità di base
Le reti neurali ricorrenti e convoluzionali utilizzano un'elaborazione sequenziale per generare previsioni. Vale a dire, una volta addestrate su enormi dataset, possono prevedere quale parola seguirà una sequenza di parole fornite. In questo senso, erano considerate algoritmi unidirezionali o privi di contesto.
Al contrario, i modelli basati su transformer come BERT, che si fondano anch'essi sull'architettura encoder-decoder, sono bidirezionali perché predicono le parole in base sia alle parole precedenti che a quelle successive. Ciò è ottenuto tramite il meccanismo di self-attention, uno strato presente sia nell'encoder sia nel decoder. L'obiettivo dello strato di attenzione è catturare le relazioni contestuali tra le diverse parole nella frase di input.
Oggi esistono molte versioni preaddestrate di BERT, ma nell'articolo originale Google ha addestrato due versioni: BERTbase e BERTlarge con architetture neurali diverse. In sostanza, BERTbase è stato sviluppato con 12 layer transformer, 12 layer di attenzione e 110 milioni di parametri, mentre BERTlarge utilizzava 24 layer transformer, 16 layer di attenzione e 340 milioni di parametri. Come previsto, BERTlarge ha superato il fratello minore nei test di accuratezza.
Per capire in dettaglio come funziona l'architettura encoder-decoder nei transformer, ti consigliamo vivamente di leggere la nostra Introduzione all'uso dei Transformer e di Hugging Face.
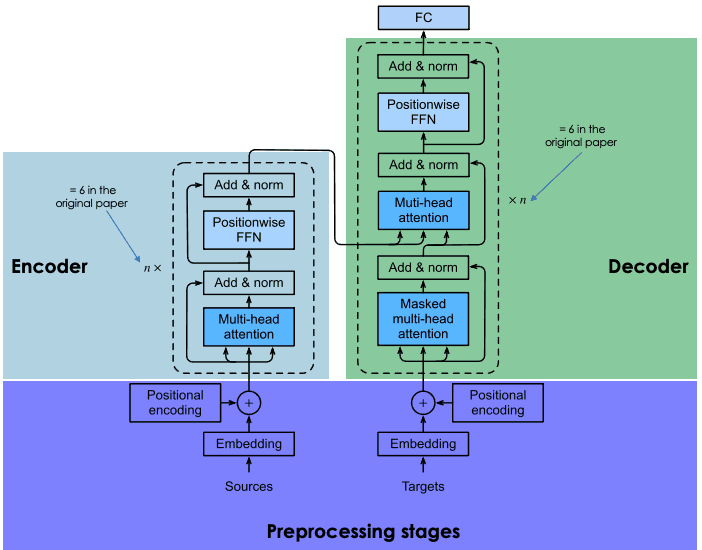
Una spiegazione dell'architettura dei transformer
Pre-training e fine-tuning
I transformer vengono addestrati da zero su un enorme corpus di dati, seguendo un processo lungo e costoso (che solo un gruppo limitato di aziende, tra cui Google, può permettersi).
Nel caso di BERT, è stato preaddestrato per quattro giorni su Wikipedia (~2,5 miliardi di parole) e su BooksCorpus di Google (~800 milioni di parole). Questo consente al modello di acquisire conoscenze non solo in inglese ma anche in molte altre lingue del mondo.
Per ottimizzare il processo di addestramento, Google ha sviluppato nuovo hardware, le cosiddette TPU (Tensor Processing Unit), progettate specificamente per i compiti di machine learning.
Per evitare interazioni inutili e costose durante l'addestramento, i ricercatori di Google hanno utilizzato tecniche di transfer learning per separare la fase di (pre)training dalla fase di fine-tuning. Questo permette agli sviluppatori di scegliere modelli preaddestrati, perfezionare le coppie input-output del compito target e riaddestrare la testa del modello preaddestrato usando dati specifici di dominio. Questa caratteristica è ciò che rende gli LLM come BERT il foundation model di infinite applicazioni costruite sopra di essi,
Il ruolo del Masked Language Modeling nell'elaborazione di BERT
L'elemento chiave per ottenere l'apprendimento bidirezionale in BERT (e in ogni LLM basato su transformer) è il meccanismo di attenzione. Questo meccanismo si basa sul masked language modeling (MLM). Mascherando una parola in una frase, questa tecnica costringe il modello ad analizzare le restanti parole in entrambe le direzioni nella frase per aumentare le probabilità di prevedere la parola mascherata. L'MLM si basa su tecniche già sperimentate nel campo della computer vision, ed è ottimo per compiti che richiedono una buona comprensione contestuale di un'intera sequenza.
BERT è stato il primo LLM ad applicare questa tecnica. In particolare, durante l'addestramento veniva mascherato in modo casuale il 15% delle parole tokenizzate. Il risultato mostra che BERT riusciva a prevedere le parole nascoste con alta accuratezza.
Curioso del masked language modeling? Dai un'occhiata al nostro corso Large Language Models (LLMs) Concepts per imparare tutti i dettagli su questa tecnica innovativa.
A cosa serve BERT? L'impatto di BERT sull'NLP
Grazie ai transformer, BERT ha raggiunto risultati all'avanguardia in molteplici compiti di NLP. Ecco alcuni dei test in cui BERT eccelle:
- Question answering. BERT è stato uno dei primi chatbot basati su transformer, con risultati impressionanti.
- Analisi del sentiment. Ad esempio, BERT ha avuto successo nel prevedere la polarità positiva o negativa nelle recensioni di film.
- Generazione di testo. Precursore dei chatbot di nuova generazione, BERT era già in grado di creare testi lunghi con prompt semplici.
- Riassunto di testi. Allo stesso modo, BERT era in grado di leggere e riassumere testi di domini complessi, tra cui diritto e sanità.
- Traduzione automatica. BERT è stato addestrato su dati scritti in più lingue. Questo lo rende un modello multilingue, quindi molto adatto alla traduzione.
- Completamento automatico. BERT può essere usato per attività di completamento automatico, ad esempio in email o servizi di messaggistica.
Applicazioni reali di BERT
Molti LLM sono stati testati in contesti sperimentali, ma non molti sono stati incorporati in applicazioni consolidate. Non è il caso di BERT, che viene usato ogni giorno da milioni di persone (anche se potremmo non esserne consapevoli).
Un ottimo esempio è la Ricerca Google. Nel 2020, Google ha annunciato di aver adottato BERT nella Ricerca Google in oltre 70 lingue. Ciò significa che Google usa BERT per classificare i contenuti e mostrare featured snippet. Con il meccanismo di attenzione, Google può ora sfruttare il contesto della tua domanda per fornire informazioni utili, come mostrato nell'esempio seguente.
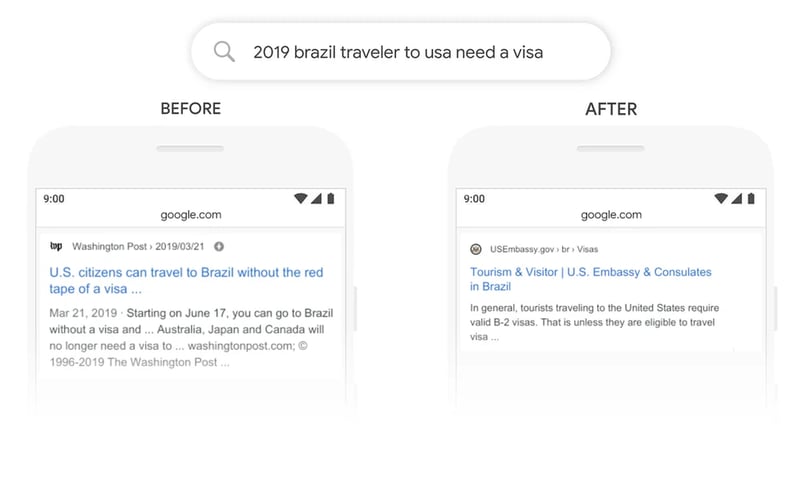
Fonte: Google
Varianti e adattamenti di BERT
Ma questa è solo una parte della storia. Il successo di BERT è dovuto in gran parte alla sua natura open source, che ha permesso agli sviluppatori di accedere al codice sorgente dell'originale BERT e creare nuove funzionalità e miglioramenti.
Questo ha portato a un buon numero di varianti di BERT. Di seguito trovi alcune delle più note:
- RoBERTa. Abbreviazione di "Robustly Optimized BERT Approach", RoBERTa è una variante di BERT creata da Meta in collaborazione con la Washington University. Considerata una versione più potente dell'originale BERT, RoBERTa è stata addestrata con un dataset 10 volte più grande di quello usato per addestrare BERT. Quanto all'architettura, la differenza più significativa è l'uso del masking dinamico invece del masking statico. Questa tecnica, che prevedeva la duplicazione dei dati di addestramento e la loro mascheratura 10 volte, ogni volta con una strategia diversa, ha permesso a RoBERTa di apprendere rappresentazioni delle parole più robuste e generalizzabili.
- DistilBERT. Dalla nascita dei primi LLM alla fine degli anni 2010, si è affermata la tendenza a costruire LLM sempre più grandi e pesanti. Ha senso, dato che sembra esserci una relazione diretta tra dimensione del modello e accuratezza. Tuttavia, è anche vero che più il modello è grande, maggiori sono le risorse necessarie per eseguirlo e, quindi, meno persone possono permetterselo. DistilBERT punta a rendere BERT più accessibile offrendo una variante più piccola, veloce, economica e leggera. Basato sull'architettura dell'originale BERT, DistilBERT utilizza tecniche di distillazione della conoscenza durante il pre-training per ridurre le dimensioni del 40% mantenendo il 97% delle capacità di comprensione del linguaggio ed essendo più veloce del 60%.
- ALBERT. Acronimo di A Lite BERT, ALBERT è stato progettato specificamente per aumentare l'efficienza di BERTlarge durante il pre-training. Poiché l'addestramento di modelli più grandi spesso comporta limitazioni di memoria, tempi di addestramento più lunghi e degrado inatteso del modello, i creatori di ALBERT hanno sviluppato due tecniche di riduzione dei parametri per ridurre il consumo di memoria e aumentare la velocità durante l'addestramento.
Se vuoi saperne di più sul movimento LLM open source, ti consigliamo vivamente di leggere il nostro post sui Top Open-Source LLM nel 2023
Fine-tuning di BERT per compiti specifici
Una delle cose migliori di BERT, e degli LLM in generale, è che il processo di pre-training è separato da quello di fine-tuning. Ciò significa che gli sviluppatori possono prendere versioni preaddestrate di BERT e personalizzarle per i propri casi d'uso specifici.
Nel caso di BERT, esistono centinaia di versioni affinate per una vasta gamma di compiti di NLP. Qui sotto trovi un elenco molto, molto limitato di versioni di BERT messe a punto:
- BERT-base-chinese. Una versione di BERTbase addestrata per compiti di NLP in cinese
- BERT-base-NER. Una versione di BERTbase personalizzata per il riconoscimento di entità nominate
- Symps_disease_bert_v3_c41. Un modello di classificazione sintomo-malattia per un chatbot in linguaggio naturale.
- BERT for Patents. è un modello addestrato da Google su oltre 100 milioni di brevetti in tutto il mondo. Si basa su BERTlarge.
Capire i limiti di BERT
BERT presenta i limiti e i problemi tradizionalmente associati agli LLM. Le previsioni di BERT si basano sempre sulla quantità e sulla qualità dei dati usati per addestrarlo. Se i dati di addestramento sono limitati, scarsi o distorti, BERT può restituire risultati imprecisi, dannosi o persino le cosiddette allucinazioni degli LLM.
Nel caso dell'originale BERT, ciò è ancora più probabile, poiché il modello è stato addestrato senza Reinforcement Learning from Human Feedback (RLHF), una tecnica standard usata dai modelli più avanzati, come ChatGPT, LLaMA 2 e Google Bard, per migliorare la sicurezza dell'IA. L'RLHF prevede l'uso del feedback umano per monitorare e indirizzare il processo di apprendimento dell'LLM durante l'addestramento, garantendo sistemi efficaci, più sicuri e affidabili.
Inoltre, sebbene possa essere considerato un modello piccolo rispetto ad altri LLM all'avanguardia, come ChatGPT, richiede comunque una notevole potenza di calcolo per essere eseguito, per non parlare dell'addestramento da zero. Pertanto, gli sviluppatori con risorse limitate potrebbero non riuscire a usarlo.
Il futuro di BERT e dell'NLP
BERT è stato uno dei primi LLM moderni. Ma, ben lontano dall'essere superato, è ancora uno degli LLM più riusciti e ampiamente utilizzati. Grazie alla sua natura open source, oggi esistono molteplici varianti e centinaia di versioni preaddestrate di BERT pensate per compiti specifici di NLP.
Se vuoi restare al passo con BERT e con gli sviluppi recenti dell'NLP, DataCamp è qui per aiutarti. Dai un'occhiata ai nostri materiali selezionati e resta sintonizzato sull'attuale rivoluzione dell'IA generativa!







Le scoperte scientifiche raramente avvengono nel vuoto. Piuttosto, sono spesso il penultimo gradino di una scala costruita su conoscenze umane accumulate. Per capire il successo dei large language model (LLM), come ChatGPT e Google Bart, dobbiamo tornare indietro nel tempo e parlare di BERT.
Sviluppato nel 2018 dai ricercatori di Google, BERT è uno dei primi LLM. Con risultati sorprendenti, è diventato rapidamente un riferimento onnipresente nei compiti di NLP, tra cui comprensione generale del linguaggio, question answering e riconoscimento di entità nominate.
Ti interessa saperne di più sugli LLM? Inizia oggi stesso il Capitolo 1 del nostro corso Large Language Models (LLMs) Concepts.
Si può dire che BERT abbia spianato la strada alla rivoluzione dell'IA generativa a cui stiamo assistendo oggi. Pur essendo uno dei primi LLM, BERT è ancora ampiamente usato, con migliaia di modelli BERT open source, gratuiti e preaddestrati disponibili per casi d'uso specifici, come l'analisi del sentiment, l'analisi di note cliniche e il rilevamento di commenti tossici.
Curioso di BERT? Continua a leggere: esploreremo l'architettura di BERT, il funzionamento interno della tecnologia, alcune applicazioni reali e i suoi limiti.
Che cos'è BERT?
BERT (acronimo di Bidirectional Encoder Representations from Transformers) è un modello open source sviluppato da Google nel 2018. È stato un esperimento ambizioso per testare le prestazioni del cosiddetto transformer – un'innovativa architettura neurale presentata dai ricercatori di Google nel famoso paper Attention is All You Need nel 2017 – sui compiti di elaborazione del linguaggio naturale (NLP).
La chiave del successo di BERT è la sua architettura a transformer. Prima dell'avvento dei transformer, modellare il linguaggio naturale era un compito molto impegnativo. Nonostante l'ascesa di reti neurali sofisticate – in particolare ricorrenti o convoluzionali – i risultati erano solo in parte soddisfacenti.
La principale difficoltà risiedeva nel meccanismo con cui le reti neurali prevedevano la parola mancante in una frase. All'epoca, le reti neurali allo stato dell'arte si basavano sull'architettura encoder-decoder, un meccanismo potente ma dispendioso in termini di tempo e risorse, non adatto al calcolo in parallelo.
Tenendo presenti queste sfide, i ricercatori di Google hanno sviluppato il transformer, un'innovativa architettura neurale basata sul meccanismo di attenzione, come spiegato nella sezione seguente.
Come funziona BERT?
Vediamo come funziona BERT, analizzando la tecnologia alla base del modello, come viene addestrato e come elabora i dati.
Architettura e funzionalità di base
Le reti neurali ricorrenti e convoluzionali utilizzano un'elaborazione sequenziale per generare previsioni. Vale a dire, una volta addestrate su enormi dataset, possono prevedere quale parola seguirà una sequenza di parole fornite. In questo senso, erano considerate algoritmi unidirezionali o privi di contesto.
Al contrario, i modelli basati su transformer come BERT, che si fondano anch'essi sull'architettura encoder-decoder, sono bidirezionali perché predicono le parole in base sia alle parole precedenti che a quelle successive. Ciò è ottenuto tramite il meccanismo di self-attention, uno strato presente sia nell'encoder sia nel decoder. L'obiettivo dello strato di attenzione è catturare le relazioni contestuali tra le diverse parole nella frase di input.
Oggi esistono molte versioni preaddestrate di BERT, ma nell'articolo originale Google ha addestrato due versioni: BERTbase e BERTlarge con architetture neurali diverse. In sostanza, BERTbase è stato sviluppato con 12 layer transformer, 12 layer di attenzione e 110 milioni di parametri, mentre BERTlarge utilizzava 24 layer transformer, 16 layer di attenzione e 340 milioni di parametri. Come previsto, BERTlarge ha superato il fratello minore nei test di accuratezza.
Per capire in dettaglio come funziona l'architettura encoder-decoder nei transformer, ti consigliamo vivamente di leggere la nostra Introduzione all'uso dei Transformer e di Hugging Face.
Una spiegazione dell'architettura dei transformer
Pre-training e fine-tuning
I transformer vengono addestrati da zero su un enorme corpus di dati, seguendo un processo lungo e costoso (che solo un gruppo limitato di aziende, tra cui Google, può permettersi).
Nel caso di BERT, è stato preaddestrato per quattro giorni su Wikipedia (~2,5 miliardi di parole) e su BooksCorpus di Google (~800 milioni di parole). Questo consente al modello di acquisire conoscenze non solo in inglese ma anche in molte altre lingue del mondo.
Per ottimizzare il processo di addestramento, Google ha sviluppato nuovo hardware, le cosiddette TPU (Tensor Processing Unit), progettate specificamente per i compiti di machine learning.
Per evitare interazioni inutili e costose durante l'addestramento, i ricercatori di Google hanno utilizzato tecniche di transfer learning per separare la fase di (pre)training dalla fase di fine-tuning. Questo permette agli sviluppatori di scegliere modelli preaddestrati, perfezionare le coppie input-output del compito target e riaddestrare la testa del modello preaddestrato usando dati specifici di dominio. Questa caratteristica è ciò che rende gli LLM come BERT il foundation model di infinite applicazioni costruite sopra di essi,
Il ruolo del Masked Language Modeling nell'elaborazione di BERT
L'elemento chiave per ottenere l'apprendimento bidirezionale in BERT (e in ogni LLM basato su transformer) è il meccanismo di attenzione. Questo meccanismo si basa sul masked language modeling (MLM). Mascherando una parola in una frase, questa tecnica costringe il modello ad analizzare le restanti parole in entrambe le direzioni nella frase per aumentare le probabilità di prevedere la parola mascherata. L'MLM si basa su tecniche già sperimentate nel campo della computer vision, ed è ottimo per compiti che richiedono una buona comprensione contestuale di un'intera sequenza.
BERT è stato il primo LLM ad applicare questa tecnica. In particolare, durante l'addestramento veniva mascherato in modo casuale il 15% delle parole tokenizzate. Il risultato mostra che BERT riusciva a prevedere le parole nascoste con alta accuratezza.
Curioso del masked language modeling? Dai un'occhiata al nostro corso Large Language Models (LLMs) Concepts per imparare tutti i dettagli su questa tecnica innovativa.
A cosa serve BERT? L'impatto di BERT sull'NLP
Grazie ai transformer, BERT ha raggiunto risultati all'avanguardia in molteplici compiti di NLP. Ecco alcuni dei test in cui BERT eccelle:
Applicazioni reali di BERT
Molti LLM sono stati testati in contesti sperimentali, ma non molti sono stati incorporati in applicazioni consolidate. Non è il caso di BERT, che viene usato ogni giorno da milioni di persone (anche se potremmo non esserne consapevoli).
Un ottimo esempio è la Ricerca Google. Nel 2020, Google ha annunciato di aver adottato BERT nella Ricerca Google in oltre 70 lingue. Ciò significa che Google usa BERT per classificare i contenuti e mostrare featured snippet. Con il meccanismo di attenzione, Google può ora sfruttare il contesto della tua domanda per fornire informazioni utili, come mostrato nell'esempio seguente.
Fonte: Google
Varianti e adattamenti di BERT
Ma questa è solo una parte della storia. Il successo di BERT è dovuto in gran parte alla sua natura open source, che ha permesso agli sviluppatori di accedere al codice sorgente dell'originale BERT e creare nuove funzionalità e miglioramenti.
Questo ha portato a un buon numero di varianti di BERT. Di seguito trovi alcune delle più note:
Se vuoi saperne di più sul movimento LLM open source, ti consigliamo vivamente di leggere il nostro post sui Top Open-Source LLM nel 2023
Fine-tuning di BERT per compiti specifici
Una delle cose migliori di BERT, e degli LLM in generale, è che il processo di pre-training è separato da quello di fine-tuning. Ciò significa che gli sviluppatori possono prendere versioni preaddestrate di BERT e personalizzarle per i propri casi d'uso specifici.
Nel caso di BERT, esistono centinaia di versioni affinate per una vasta gamma di compiti di NLP. Qui sotto trovi un elenco molto, molto limitato di versioni di BERT messe a punto:
Capire i limiti di BERT
BERT presenta i limiti e i problemi tradizionalmente associati agli LLM. Le previsioni di BERT si basano sempre sulla quantità e sulla qualità dei dati usati per addestrarlo. Se i dati di addestramento sono limitati, scarsi o distorti, BERT può restituire risultati imprecisi, dannosi o persino le cosiddette allucinazioni degli LLM.
Nel caso dell'originale BERT, ciò è ancora più probabile, poiché il modello è stato addestrato senza Reinforcement Learning from Human Feedback (RLHF), una tecnica standard usata dai modelli più avanzati, come ChatGPT, LLaMA 2 e Google Bard, per migliorare la sicurezza dell'IA. L'RLHF prevede l'uso del feedback umano per monitorare e indirizzare il processo di apprendimento dell'LLM durante l'addestramento, garantendo sistemi efficaci, più sicuri e affidabili.
Inoltre, sebbene possa essere considerato un modello piccolo rispetto ad altri LLM all'avanguardia, come ChatGPT, richiede comunque una notevole potenza di calcolo per essere eseguito, per non parlare dell'addestramento da zero. Pertanto, gli sviluppatori con risorse limitate potrebbero non riuscire a usarlo.
Il futuro di BERT e dell'NLP
BERT è stato uno dei primi LLM moderni. Ma, ben lontano dall'essere superato, è ancora uno degli LLM più riusciti e ampiamente utilizzati. Grazie alla sua natura open source, oggi esistono molteplici varianti e centinaia di versioni preaddestrate di BERT pensate per compiti specifici di NLP.
Se vuoi restare al passo con BERT e con gli sviluppi recenti dell'NLP, DataCamp è qui per aiutarti. Dai un'occhiata ai nostri materiali selezionati e resta sintonizzato sull'attuale rivoluzione dell'IA generativa!