Kurs
Einführung in Embeddings mit der OpenAI API
3 Std.
23.2K
Text Embeddings (auch Wort-Embeddings) sind eine wegweisende Technik im Bereich der Natural Language Processing (NLP), die grundlegend verbessert hat, wie Maschinen menschliche Sprache verstehen und verarbeiten.
Text Embeddings wandeln Rohtext in numerische Vektoren um, sodass Computer ihn besser interpretieren können.
Der Grund ist einfach: Computer "denken" nur in Zahlen und verstehen Wörter nicht aus sich heraus. Dank Text-Embeddings können Computer Texte leichter lesen, ihren Sinn erfassen und auf Anfragen präzisere Antworten geben.
In diesem Artikel beleuchten wir Bedeutung, Relevanz, Entwicklung, Anwendungsfälle, führende Modelle und die grundlegende Intuition hinter Text-Embeddings.
Text Embeddings sind ein Verfahren, mit dem Wörter oder Phrasen in numerische Daten übersetzt werden, die eine Maschine verarbeiten kann. Stell es dir vor wie eine Liste von Zahlen, in der jede Zahl einen Teil der Bedeutung des Textes einfängt. So erfassen Modelle Kontext und Beziehungen zwischen Wörtern.
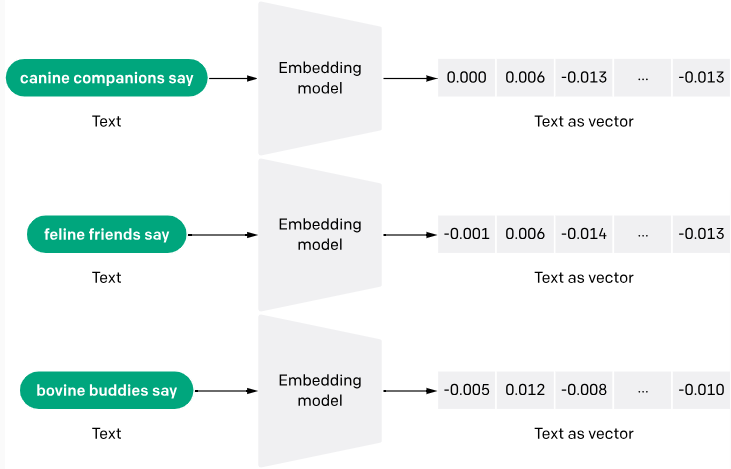
Die Erzeugung von Text-Embeddings erfolgt häufig über neuronale Netze, die die semantische Bedeutung von Wörtern in dichte Vektoren reeller Zahlen kodieren. Verfahren wie Word2Vec und GloVe sind populär und analysieren dazu das gemeinsame Auftreten von Wörtern in großen Textmengen.
Mehr über Text-Embeddings mit der OpenAI API und eine praktische Anwendung findest du in einem separaten Beitrag.
Klassische Sprachmodelle behandelten Wörter als unabhängige Einheiten. Wort-Embeddings lösen dieses Problem, indem sie Wörter mit ähnlicher Bedeutung oder in ähnlichen Kontexten in einem mehrdimensionalen Raum näher zueinander anordnen.
Weitere Gründe, warum Text-Embeddings so wichtig sind:
Embeddings helfen Modellen, neue, unbekannte Wörter oder Phrasen anhand des gelernten Kontexts aus den Trainingsdaten besser zu verallgemeinern. Das ist besonders in dynamischen Sprachen nützlich, in denen ständig neue Wörter entstehen.
Embeddings werden umfassend als Features in verschiedenen Machine-Learning-Aufgaben eingesetzt, etwa bei Dokumentklassifikation, Sentimentanalyse und maschineller Übersetzung. Sie steigern die Leistung von Algorithmen, weil sie eine dichte, bedeutungshaltige Repräsentation liefern, die zentrale Texteigenschaften einfängt.
Text-Embeddings können mehrere Sprachen abbilden, indem sie semantische Ähnlichkeiten über Sprachen hinweg erkennen und darstellen. Ein Beispiel ist das Language-agnostic BERT Sentence Embedding (LaBSE) Model, das bemerkenswerte Fähigkeiten bei der Erstellung mehrsprachiger Satz-Embeddings für 109 Sprachen gezeigt hat.
Traditionelle Methoden wie One-Hot-Encoding erzeugen spärliche Daten (da die meisten Beobachtungen 0 sind) und hochdimensionale Vektoren – ineffizient bei großen Vokabularen. Embeddings reduzieren Dimensionalität und Rechenaufwand und eignen sich dadurch deutlich besser für umfangreiche Textdaten.
Text-Embeddings sind dichte Vektorrepräsentationen von Text, bei denen Wörter und Dokumente mit ähnlicher Bedeutung durch ähnliche Vektoren in einem hochdimensionalen Raum dargestellt werden.
Die zugrunde liegende Intuition ist, semantische und kontextuelle Beziehungen zwischen Textelementen einzufangen, damit Machine-Learning-Modelle Textdaten wirkungsvoller verarbeiten und darüber „schließen" können.
Eine zentrale Intuition ist die distributionelle Hypothese: Wörter oder Phrasen, die in ähnlichen Kontexten auftreten, haben tendenziell ähnliche Bedeutungen.
Betrachte zum Beispiel „king" und „queen". Sie sind keine Synonyme, teilen aber den Kontext von Königtum und Monarchie. Embeddings zielen darauf ab, diese semantische Nähe abzubilden, indem sie die Vektoren dieser Wörter im Raum nahe beieinander platzieren.
Eine weitere Intuition sind Operationen im Vektorraum. Wenn Text als numerische Vektoren dargestellt wird, können Operationen wie Addition, Subtraktion und Kosinus-Ähnlichkeit genutzt werden, um semantische Beziehungen zu erfassen und zu manipulieren. Zum Beispiel:
king - man + woman ≈ queen
In diesem Beispiel ergibt die Operation „king - man + woman" einen Vektor, der dem Embedding von „queen" sehr nahekommt und damit die Analogie zwischen den Wörtern einfängt.
Wichtig ist auch die Dimensionalitätsreduktion in Text-Embeddings. Traditionelle, spärliche Repräsentationen wie One-Hot-Encoding haben extrem hohe Dimensionalität (entsprechend der Vokabulargröße). Embeddings haben typischerweise weniger Dimensionen (z. B. 300) und fassen die wichtigsten Merkmale eines Textes zusammen – weniger Rauschen, geringere Rechenkomplexität.
Ein Restaurantbeispiel verdeutlicht die Intuition hinter Wort-Embeddings:
Angenommen, du hast einen Korpus aus Restaurantbewertungen und willst die Stimmung jeder Bewertung automatisch als positiv oder negativ klassifizieren. Verwende Text-Embeddings, um jede Bewertung als dichten Vektor zu repräsentieren, der semantische Bedeutung und Stimmung einfängt.
Betrachte zwei Bewertungen:
Bewertung 1: „Das Essen war köstlich, und der Service hervorragend. Ich empfehle dieses Restaurant sehr."
Bewertung 2: „Das Essen war mittelmäßig, und der Service schwach. Ich komme nicht wieder."
Obwohl sie kaum identische Wörter teilen, sollten ihre Embeddings im Vektorraum weit auseinanderliegen – entsprechend der gegensätzlichen Stimmung. Positive Wörter wie „köstlich" und „hervorragend" in Bewertung 1 liegen näher an einer „positiven" Region, während „mittelmäßig" und „schwach" in Bewertung 2 näher an einer „negativen" Region liegen.
Trainierst du ein Machine-Learning-Modell auf diesen Embeddings, lernt es, semantische Muster und Stimmungsinformationen den passenden Labels (positiv/negativ) zuzuordnen und neue, unbekannte Bewertungen treffsicher zu klassifizieren.
Laut dem Buch “Embeddings in Natural Language Processing: Theory and Advances in Vector Representations of Meaning” von Mohammad Taher Pilehvar und Jose Camacho-Collados wurden Text-Embeddings
“vor allem nach 2013 mit der Einführung von Word2vec popularisiert.”
2013 markierte in der Tat einen Durchbruch. Die Forschung zu Embeddings reicht jedoch bis in die 1950er Jahre zurück. Dieser Abschnitt ist nicht vollständig, deckt aber zentrale Meilensteine ab.
Von den 1950ern bis 2000ern dominierten One-Hot-Encoding und Bag-of-Words (BoW). Diese Ansätze waren begrenzt und brachten einige Probleme mit sich, zum Beispiel:
TF-IDF (Term Frequency–Inverse Document Frequency) war ein weiterer früher Ansatz aus den 70ern. Er gewichtet Wörter nach Häufigkeit im Dokument und Seltenheit im Gesamtkorpus, sodass seltenere Wörter höher bewertet werden. Das lieferte mehr Einblick als One-Hot, erfasste aber weiterhin kaum semantische Bedeutung.
Laut IBM begannen Forscher:innen in den 2000ern damit,
“neuronale Sprachmodelle (NLMs) zu erkunden, die Beziehungen zwischen Wörtern in einem kontinuierlichen Raum abbilden. Diese frühen Modelle legten den Grundstein für spätere Wort-Embeddings.”
Ein frühes Beispiel ist das „Neural Probabilistic Language Model" von Bengio et al. um 2000, das verteilte Wortrepräsentationen lernen sollte.
2013 kam Word2Vec als revolutionäres Modell hinzu und prägte die Idee, Wörter als numerische Vektoren darzustellen. Diese Vektoren bilden semantische Ähnlichkeiten ab, sodass ähnliche Wörter im Vektorraum näher beieinander liegen – eine Art Bedeutungslandkarte.
2014 folgte GloVe im Paper “GloVe: Global Vectors for Word Representation” von Jeffrey Pennington und Co-Autor:innen. GloVe verbesserte Word2Vec, indem es sowohl lokalen Kontext als auch globale Nutzungsstatistiken im Korpus einbezog.
In dieser Phase traten Methoden wie Attention-Mechanismen (2017) sowie Transfer Learning und Kontext (2018) in den Vordergrund.
Attention ermöglicht es Modellen, sich auf besonders relevante Teile eines Satzes zu konzentrieren und ihnen je nach Bedeutung unterschiedliche Gewichte zu geben. So werden Beziehungen und Bedeutungsbeiträge einzelner Wörter besser erfasst.
In „The quick brown fox jumps over the lazy dog" würde ein Attention-Mechanismus z. B. „quick" und „jumps" stärker gewichten als „the" oder „brown".
Transfer Learning und Kontext wiederum führten vortrainierte Modelle ein. Verfahren wie ULMFiT und BERT erlauben das Finetuning auf spezifische Aufgaben – mit weniger Daten und geringerem Rechenaufwand bei hoher Performance.
Embedding-APIs sind ein neuerer Ansatz. Ihre Wurzeln reichen in die 2010er, als Cloud-KI-Lösungen und vortrainierte Modelle breiter verfügbar wurden.
In den 2020ern hat die Nutzung von APIs in der Developer-Community rasant zugenommen – ebenso die von Embedding-APIs. Eine Embedding-API erleichtert die Erzeugung von Textrepräsentationen über vortrainierte Modelle.
Ein gutes Beispiel ist die OpenAI Embedding API. OpenAI stellte im Dezember 2022 wichtige Updates vor. Das einheitliche Modell text-embedding-ada-002 vereint die Fähigkeiten mehrerer Vorgängermodelle und ist auf Aufgaben wie Textsuche, Codesuche und Satzähnlichkeit ausgelegt.
Schauen wir uns einige typische Einsatzbereiche an.
Wort-Embeddings helfen Suchsystemen, die Bedeutung deiner Anfrage zu verstehen und relevante Dokumente zu finden – auch wenn diese nicht exakt dieselben Wörter enthalten. Das ist besonders nützlich bei mehrdeutigen Suchen oder für das Auffinden ähnlicher Inhalte.
E-Commerce-, Social-Media- und Streaming-Plattformen nutzen Text-Embeddings, um Produkte oder Inhalte basierend auf deinen bisherigen Vorlieben zu empfehlen. Durch die Analyse von Beschreibungen und Bewertungen zu Artikeln, mit denen du interagiert hast, lassen sich passende Vorschläge ableiten.
Meta (Facebook) setzt Embeddings in der sozialen Suche ein. Mehr dazu in diesem Abstract.
Text-Embeddings gehen über 1:1-Übersetzungen hinaus. Sie berücksichtigen Kontext und Bedeutung und liefern so natürlichere, präzisere Übersetzungen.
Chatbots mit Text-Embeddings verstehen die Absicht hinter deinen Fragen und antworten sinnvoller und ansprechender. Sie analysieren die Stimmung deiner Nachricht und passen ihren Ton entsprechend an.
Wort-Embeddings können unterschiedliche Textformate generieren, etwa Produktbeschreibungen oder Social-Posts. Marken nutzen sie außerdem, um Gespräche in sozialen Medien auszuwerten und die Kund:innenstimmung gegenüber Produkten oder Services zu verstehen.
Hier sind führende Text-Embedding-Modelle – Open Source und proprietär:
Wie besprochen zählt Word2Vec zu den Pionieren. Entwickelt wurde es von Tomas Mikolov und Kolleg:innen bei Google. Word2Vec nutzt flache neuronale Netze, um Wortvektoren zu erzeugen, die semantische Ähnlichkeiten abbilden.
Word2Vec verwendet zwei Architekturen: Continuous Bag-of-Words (CBOW) und Skip-Gram. CBOW sagt ein Wort aus seinem Kontext vorher, Skip-Gram sagt aus einem Wort die umgebenden Wörter vorher. So werden semantische Beziehungen kodiert.
Beliebte NLP-Bibliotheken wie Gensim und spaCy bieten Implementierungen. Die Open-Source-Version von Word2Vec wird von Google gehostet (Apache-2.0-Lizenz).
GloVe von Stanford ist ein weiteres verbreitetes Modell. Es erfasst lokalen und globalen Kontext, indem es Wort-Kookkurrenzen in großen Korpora analysiert. Aus einer Kookkurrenzmatrix werden Wortvektoren über Faktorisierung gewonnen. So fließen nahe und entfernte Kookkurrenzen ein – für ein umfassendes Bedeutungsverständnis.
GloVe ist Open Source. Vorgefertigte Vektoren stehen zum Download bereit, Implementierungen gibt es u. a. in Gensim.
FastText, entwickelt von Facebook (heute Meta), erweitert Word2Vec und adressiert das Problem unbekannter Wörter (OOV). Es nutzt Subword-Informationen, um auch für ungesehene Wörter Embeddings zu bilden.
Dazu zerlegt FastText Wörter in Zeichen-n-Gramme (Subwörter) und trainiert Vektoren auf Basis dieser Einheiten – ähnlich wie Word2Vec. Neue Wörter können so über die Bedeutung ihrer Subwörter dargestellt werden.
FastText ist Open Source und als Bibliothek verfügbar. Vorgefertigte Vektoren gibt es für viele Sprachen.
Embedding v3 (Text-embedding-3) ist die jüngste Generation der OpenAI-Embedding-Modelle. Es gibt zwei Klassen: text-embedding-3-small (kleiner) und text-embedding-3-large (größer). Sie sind proprietär und erfordern eine kostenpflichtige API.
Text-embedding-3-Modelle wandeln Text in numerische Repräsentationen um, indem sie ihn zunächst in Tokens (Wörter oder Subwörter) zerlegen. Jedes Token wird einem Vektor im hochdimensionalen Raum zugeordnet. Ein Transformer-Encoder analysiert diese Vektoren und berücksichtigt den Kontext jedes Wortes anhand seiner Umgebung.
Am Ende gibt das Modell einen einzelnen Vektor für den gesamten Text aus, der Gesamtbedeutung und Wortbeziehungen einfängt. Die große Variante hat eine komplexere Architektur und höhere Dimensionalität für potenziell höhere Genauigkeit, die kleine priorisiert Geschwindigkeit und Effizienz.
Mehr zu OpenAI-Embeddings findest du in unserem Guide: Exploring Text-Embedding-3-Large: A Comprehensive Guide to the new OpenAI Embeddings.
USE ist ein proprietäres Satz-Embedding-Modell von Google AI. Es wandelt Texte in hochdimensionale Embeddings um, die die semantische Bedeutung ganzer Sätze oder kurzer Absätze widerspiegeln.
Anders als Modelle, die einzelne Wörter einbetten, verarbeitet USE komplette Sätze über ein vortrainiertes tiefes neuronales Netz auf einem vielfältigen Textkorpus. Dadurch werden semantische Beziehungen effektiv erfasst und Vektoren fester Größe für Sätze variabler Länge erzeugt – effizient in der Verarbeitung.
Zugriff bietet Google über das TensorFlow Hub Repository.
In diesem Guide hast du eine fundierte Einführung in Text-Embeddings erhalten: Definition, Bedeutung und wichtige Entwicklungsmeilensteine. Außerdem haben wir Anwendungsfälle und Top-Modelle betrachtet.
Um KI, NLP und Text-Embeddings vertieft zu lernen, empfehlen wir diese Ressourcen:
Erfahre mehr über KI mit DataCamp
Kurs
Lernpfad
Kurs