टेक्स्ट एम्बेडिंग (वर्ड एम्बेडिंग के समान) नेचुरल लैंग्वेज प्रोसेसिंग (NLP) की एक परिवर्तनकारी तकनीक है जिसने मशीनों के लिए मानव भाषा को समझने और प्रोसेस करने का तरीका बेहतर बनाया है।
टेक्स्ट एम्बेडिंग कच्चे टेक्स्ट को सांख्यिकीय वेक्टरों में बदलती है, जिससे कंप्यूटर उसे बेहतर समझ पाते हैं।
कारण सरल है — कंप्यूटर केवल संख्याओं में सोचते हैं और वे मानव शब्दों को स्वतंत्र रूप से नहीं समझ सकते। टेक्स्ट एम्बेडिंग की बदौलत कंप्यूटर के लिए टेक्स्ट पढ़ना, समझना, और क्वेरी के लिए अधिक सटीक उत्तर देना आसान हो गया है।
इस लेख में, हम टेक्स्ट एम्बेडिंग का अर्थ, उसकी महत्ता, विकास, उपयोग के मामले, शीर्ष मॉडल, और उसके पीछे की सहज समझ को समझेंगे।
टेक्स्ट एम्बेडिंग क्या हैं?
टेक्स्ट एम्बेडिंग शब्दों या वाक्यांशों को ऐसे संख्यात्मक डेटा में बदलने का तरीका है जिसे मशीन समझ सके। इसे ऐसे समझिए जैसे टेक्स्ट को संख्याओं की एक सूची में बदला जा रहा हो, जहां हर संख्या टेक्स्ट के अर्थ का एक हिस्सा पकड़ती है। यह तकनीक मशीनों को संदर्भ और शब्दों के बीच के संबंध समझने में मदद करती है।
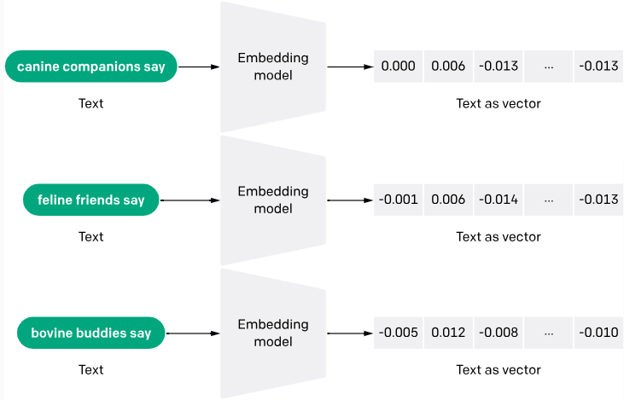
स्रोत
टेक्स्ट एम्बेडिंग बनाने की प्रक्रिया में अक्सर न्यूरल नेटवर्क शामिल होते हैं, जो शब्दों के वैचारिक (सेमांटिक) अर्थ को वास्तविक संख्याओं के सघन वेक्टरों में एन्कोड करना सीखते हैं। Word2Vec और GloVe जैसे तरीके बड़े टेक्स्ट कॉर्पस में शब्दों की सह-उपस्थिति का विश्लेषण करके ये एम्बेडिंग बनाने के लिए लोकप्रिय हैं।
आप OpenAI API के साथ टेक्स्ट एम्बेडिंग के बारे में अधिक जान सकते हैं और एक अलग लेख में व्यावहारिक अनुप्रयोग देख सकते हैं।
टेक्स्ट एम्बेडिंग महत्वपूर्ण क्यों हैं?
पारंपरिक भाषा मॉडल शब्दों को स्वतंत्र इकाइयों के रूप में देखते थे। वर्ड एम्बेडिंग इस समस्या को हल करते हैं, समान अर्थ या संदर्भ साझा करने वाले शब्दों को बहुआयामी स्पेस में एक-दूसरे के पास रखकर।
टेक्स्ट एम्बेडिंग के महत्वपूर्ण होने के कुछ और कारण यहां हैं:
जनरलाइज़ेशन
एम्बेडिंग मॉडल को प्रशिक्षण डेटा से सीखे गए संदर्भ का उपयोग करके नए, अनदेखे शब्दों या वाक्यांशों पर बेहतर तरीके से सामान्यीकरण करने में मदद करते हैं। यह विशेष रूप से गतिशील भाषाओं में उपयोगी है जहां नए शब्द अक्सर उभरते रहते हैं।
मशीन लर्निंग कार्यों में सुधार
एम्बेडिंग दस्तावेज़ वर्गीकरण, सेंटिमेंट विश्लेषण और मशीन अनुवाद जैसे विभिन्न मशीन लर्निंग कार्यों में फीचर के रूप में व्यापक रूप से उपयोग किए जाते हैं। वे समृद्ध, संघनित डेटा रूप प्रदान करके एल्गोरिद्म के प्रदर्शन में सुधार करते हैं, जो मूल पाठकीय गुणों को कैप्चर करता है।
भाषा-निरपेक्ष प्रोसेसिंग
टेक्स्ट एम्बेडिंग विभिन्न भाषाओं में वैचारिक समानताओं की पहचान करके और उनका निरूपण करके बहुभाषी डेटा को संभालने में सक्षम हैं। एक उदाहरण है Language-agnostic BERT Sentence Embedding (LaBSE) मॉडल, जिसने 109 भाषाओं को कवर करने वाली क्रॉस-लिंगुअल वाक्य एम्बेडिंग बनाने में उल्लेखनीय क्षमता दिखाई है।
बड़े शब्द-संग्रह का प्रबंधन
वन-हॉट एन्कोडिंग जैसी पारंपरिक विधियां विरल डेटा (खासकर क्योंकि अधिकांश मान 0 होते हैं) और उच्च-आयामी वेक्टर बनाती हैं, जो बड़े शब्द-संग्रह के लिए अक्षम हैं। एम्बेडिंग विमीयता और संगणनात्मक जटिलता को कम करते हैं, जिससे वे व्यापक टेक्स्ट डेटा को बेहतर तरीके से संभालने के लिए उपयुक्त बनते हैं।
टेक्स्ट एम्बेडिंग के पीछे की सहज समझ
टेक्स्ट एम्बेडिंग टेक्स्ट डेटा के सघन वेक्टर निरूपण हैं, जहां समान अर्थ वाले शब्द और दस्तावेज़ उच्च-आयामी वेक्टर स्पेस में समान वेक्टरों से दर्शाए जाते हैं।
टेक्स्ट एम्बेडिंग के पीछे की सहज समझ यह है कि वे टेक्स्ट तत्वों के बीच वैचारिक और संदर्भात्मक संबंधों को कैप्चर करें, ताकि मशीन लर्निंग मॉडल टेक्स्ट डेटा पर अधिक प्रभावी ढंग से तर्क कर सकें और उसे प्रोसेस कर सकें।
वितरणात्मक परिकल्पना
टेक्स्ट एम्बेडिंग के पीछे की मुख्य अंतर्दृष्टियों में से एक वितरणात्मक परिकल्पना है, जो कहती है कि जो शब्द या वाक्यांश समान संदर्भों में प्रकट होते हैं उनका अर्थ भी अक्सर समान होता है।
उदाहरण के लिए, "king" और "queen" शब्दों पर विचार करें। हालांकि वे पर्यायवाची नहीं हैं, फिर भी दोनों राजसत्ता और राजशाही से जुड़े समान संदर्भ साझा करते हैं। टेक्स्ट एम्बेडिंग का उद्देश्य इन शब्दों को वेक्टर स्पेस में एक-दूसरे के पास स्थित वेक्टरों से दर्शाकर इस वैचारिक समानता को कैप्चर करना है।
वेक्टर स्पेस ऑपरेशंस
टेक्स्ट एम्बेडिंग के पीछे एक और सहज समझ वेक्टर स्पेस ऑपरेशंस का विचार है। टेक्स्ट को संख्यात्मक वेक्टरों के रूप में दर्शाकर, हम जोड़, घटाव और कोसाइन समानता जैसे ऑपरेशंस का उपयोग कर सकते हैं, ताकि शब्दों और वाक्यांशों के बीच वैचारिक संबंधों को कैप्चर और संचालित किया जा सके। उदाहरण के लिए, आइए निम्न उदाहरण देखें:
king - man + woman ≈ queen
इस उदाहरण में, "king - man + woman" का वेक्टर ऑपरेशन ऐसा वेक्टर दे सकता है जो "queen" की एम्बेडिंग के बहुत करीब हो, और इन शब्दों के बीच आनुपातिक (एनालॉजिकल) संबंध को कैप्चर करे।
विमीयता न्यूनीकरण
एक और बात जिसका मैं उल्लेख करना चाहूंगा, वह है टेक्स्ट एम्बेडिंग में विमीयता न्यूनीकरण। वन-हॉट एन्कोडिंग जैसी पारंपरिक विरल टेक्स्ट निरूपण अत्यधिक उच्च विमीयता (शब्द-संग्रह के आकार के बराबर) रखते हैं। दूसरी ओर, टेक्स्ट एम्बेडिंग आम तौर पर कम विमीयता (जैसे, 300 डाइमेंशन्स) की होती हैं, जिससे वे टेक्स्ट की सबसे महत्वपूर्ण विशेषताओं को कैप्चर करते हुए शोर और संगणनात्मक जटिलता को कम कर पाती हैं।
रेस्तरां केस स्टडी
शब्द एम्बेडिंग की सामान्य सहज समझ समझाने के लिए मैं रेस्तरां का उदाहरण लूंगा:
मान लीजिए आपके पास रेस्तरां समीक्षाओं का एक कॉर्पस है और आप एक ऐसी प्रणाली बनाना चाहते हैं जो प्रत्येक समीक्षा की भावना को स्वतः सकारात्मक या नकारात्मक के रूप में वर्गीकृत करे। मैं सुझाव दूंगा कि प्रत्येक समीक्षा को सघन वेक्टर के रूप में दर्शाने के लिए टेक्स्ट एम्बेडिंग का उपयोग करें, ताकि वह टेक्स्ट में व्यक्त वैचारिक अर्थ और भावना को कैप्चर कर सके।
आइए दो समीक्षाओं पर विचार करें:
समीक्षा 1: "The food was delicious, and the service was excellent. I highly recommend this restaurant."
समीक्षा 2: "The food was mediocre, and the service was poor. I won't be going back."
हालांकि ये समीक्षाएं बहुत से शब्द साझा नहीं करतीं, फिर भी उनके एम्बेडिंग वेक्टर स्पेस में एक-दूसरे से दूर होने चाहिए, जो व्यक्त की गई विपरीत भावनाओं को दर्शाए। समीक्षा 1 में "delicious" और "excellent" जैसे सकारात्मक भाव वाले शब्द वेक्टर स्पेस के सकारात्मक क्षेत्र के करीब होंगे, जबकि समीक्षा 2 में "mediocre" और "poor" जैसे नकारात्मक भाव वाले शब्द नकारात्मक क्षेत्र के करीब होंगे।
इन टेक्स्ट एम्बेडिंग पर एक मशीन लर्निंग मॉडल को प्रशिक्षित करके, वह एम्बेडिंग में एन्कोड किए गए वैचारिक पैटर्न और सेंटिमेंट जानकारी को संबंधित सेंटिमेंट लेबल (सकारात्मक या नकारात्मक) से मैप करना सीख सकता है, और नई, अनदेखी समीक्षाओं को सटीकता से वर्गीकृत कर सकता है।
टेक्स्ट एम्बेडिंग का विकास
पुस्तक “Embeddings in Natural Language Processing: Theory and Advances in Vector Representations of Meaning” — Mohammad Taher Pilehvar और Jose Camacho-Collados के अनुसार, टेक्स्ट एम्बेडिंग,
“मुख्यतः 2013 के बाद लोकप्रिय हुईं, जब Word2vec पेश किया गया।”
यह वर्ष वाकई टेक्स्ट एम्बेडिंग के लिए एक बड़ा बदलाव लेकर आया। हालांकि, टेक्स्ट एम्बेडिंग पर शोध 1950 के दशक तक जाता है। जबकि यह खंड संपूर्ण नहीं है, मैं टेक्स्ट एम्बेडिंग के विकास के कुछ प्रमुख मील के पत्थरों को कवर करूंगा।
शुरुआती दौर (1950s–2000s)
1950s–2000s में वन-हॉट एन्कोडिंग और बैग-ऑफ-वर्ड्स (BoW) जैसी पद्धतियां प्रचलित थीं। दुर्भाग्यवश, ये तरीके पर्याप्त नहीं थे और उन्होंने कुछ चुनौतियां पेश कीं, जैसे:
- अर्थ नहीं, केवल शब्द-आवृत्ति पर ध्यान: इन तरीकों ने दस्तावेज़ों को व्यक्तिगत शब्दों के संग्रह की तरह माना और केवल यह गिना कि हर शब्द कितनी बार आया। इससे शब्दों के वैचारिक संबंध और संदर्भ की अनदेखी हो गई। उदाहरण के लिए, "The bank is on the river" और "I went bankrupt" वाक्यों को कुछ समान शब्द साझा करने के कारण एक जैसा माना जा सकता था, जबकि उनके अर्थ बिल्कुल अलग हैं।
- पर्यायवाची और बहुअर्थकता संभालने की सीमित क्षमता: BoW समान अर्थ वाले शब्दों (पर्यायवाची) या संदर्भ के आधार पर कई अर्थ रखने वाले शब्दों (बहुअर्थकता) में फर्क नहीं कर सकता था। इससे भाषा को समझना मुश्किल हो जाता था।
TF-IDF (टर्म फ़्रीक्वेंसी–इनवर्स डॉक्यूमेंट फ़्रीक्वेंसी) 70 के दशक में टेक्स्ट को संख्याओं में पकड़ने का एक और शुरुआती प्रयास था। यह तरीका किसी खास दस्तावेज़ में शब्द की आवृत्ति के साथ-साथ सभी दस्तावेज़ों में उसकी आमियत के आधार पर वजन तय करता था, कम आम शब्दों को अधिक मान देता था। हालांकि इसने वन-हॉट एन्कोडिंग की तुलना में अधिक अंतर्दृष्टि दी, फिर भी यह शब्दों के वैचारिक अर्थ को कैप्चर करने में कम पड़ गया।
एम्बेडिंग का उदय (2000s–2010s)
IBM के अनुसार, 2000 के दशक की शुरुआत में शोधकर्ता
“न्यूरल लैंग्वेज मॉडल (NLMs) का अन्वेषण कर रहे थे, जो निरंतर स्पेस में शब्दों के बीच संबंधों को मॉडल करने के लिए न्यूरल नेटवर्क का उपयोग करते हैं। इन शुरुआती मॉडलों ने आगे चलकर वर्ड एम्बेडिंग के विकास की नींव रखी।”
एक शुरुआती उदाहरण Bengio और सह-लेखकों द्वारा लगभग 2000 में प्रस्तुत "न्यूरल प्रॉबैबिलिस्टिक लैंग्वेज मॉडल्स" है, जिसका उद्देश्य शब्दों के वितरित निरूपण सीखना था।
इसके बाद, 2013 में Word2Vec एक क्रांतिकारी मॉडल के रूप में सामने आया, जिसने शब्दों को सांख्यिकीय वेक्टरों में बदलने का विचार पेश किया। ये वेक्टर वैचारिक समानताओं को कैप्चर करते थे, जिससे समान अर्थ वाले शब्द वेक्टर स्पेस में एक-दूसरे के करीब आ जाते थे। यह मानो शब्दों का एक नक्शा बनाना था, जो उनके पारस्परिक संबंधों पर आधारित था।
2014 में, GloVe को “Glove: Global Vectors for Word Representation” शीर्षक वाले शोध पत्र में Jeffery Pennington और सह-लेखकों ने प्रस्तुत किया। GloVe ने किसी शब्द के आस-पास के तात्कालिक संदर्भ और कॉर्पस में उसके समग्र उपयोग — दोनों को ध्यान में रखकर शब्दार्थ को बेहतर समझते हुए Word2Vec में सुधार किया।
शब्दों से आगे: वाक्य और अटेंशन (2010s–2020s)
इस दौरान, अटेंशन मैकेनिज्म (2017) और ट्रांसफर लर्निंग तथा संदर्भ (2018) जैसी विधियां उभरीं।
अटेंशन मैकेनिज्म ने मॉडलों को किसी वाक्य के खास हिस्सों पर ध्यान केंद्रित करने और उनकी महत्ता के आधार पर अलग-अलग वेट देने में सक्षम बनाया। इससे मॉडल को शब्दों के बीच के संबंध और उनके अर्थ में योगदान को समझने में मदद मिली।
उदाहरण के लिए, इस वाक्य में, "The quick brown fox jumps over the lazy dog," अगला शब्द भविष्यवाणी करते समय अटेंशन मैकेनिज्म "quick" और "jumps" पर "the" या "brown" की तुलना में अधिक ध्यान दे सकता है।
वहीं, ट्रांसफर लर्निंग और संदर्भ ने प्री-ट्रेंड मॉडलों के उपयोग का मार्ग प्रशस्त किया। ULMFiT और BERT जैसी तकनीकों ने इन प्री-ट्रेंड मॉडलों को विशिष्ट कार्यों के लिए फाइन-ट्यून करना संभव बनाया। इसका अर्थ था कि उच्च प्रदर्शन के लिए कम डेटा और कम कंप्यूटिंग शक्ति की जरूरत पड़ी।
एम्बेडिंग APIs का आना
एम्बेडिंग API टेक्स्ट एम्बेडिंग के लिए हालिया दृष्टिकोण है। हालांकि यह हालिया है, इसका क्रमिक उभार 2010 के दशक में शुरू हुआ, जब क्लाउड-आधारित AI समाधान और प्री-ट्रेंड मॉडलों में प्रगति व्यापक हो रही थी।
2020 के दशक में आते-आते, डेवलपर समुदाय में APIs का अपनाव बड़े पैमाने पर बढ़ा, और एम्बेडिंग API भी लोकप्रिय हुए। एम्बेडिंग API प्री-ट्रेंड मॉडलों के माध्यम से टेक्स्ट एम्बेडिंग प्राप्त करना आसान बना देता है।
एम्बेडिंग API का एक अच्छा उदाहरण है OpenAI एम्बेडिंग API। OpenAI ने दिसंबर 2022 में अहम अपडेट के साथ अपना Embedding API पेश किया। यह API text-embedding-ada-002 नामक एकीकृत मॉडल प्रदान करती है, जो कई पुराने मॉडलों की क्षमताओं को एक ही मॉडल में समाहित करती है। यह मॉडल टेक्स्ट सर्च, कोड सर्च और वाक्य समानता जैसे कार्यों में उत्कृष्ट प्रदर्शन के लिए डिज़ाइन किया गया है।
टेक्स्ट एम्बेडिंग के उपयोग के मामले
आइए टेक्स्ट एम्बेडिंग के कुछ उपयोगों पर चर्चा करें।
सूचना पुनर्प्राप्ति और खोज
वर्ड एम्बेडिंग सर्च इंजनों को आपकी क्वेरी के अंतर्निहित अर्थ को समझने और संबंधित दस्तावेज़ खोजने में मदद करती है, भले ही उनमें आपके द्वारा इस्तेमाल किए गए सटीक शब्द न हों। यह विशेष रूप से अस्पष्ट खोजों या समान सामग्री ढूँढने में सहायक है।
ई-कॉमर्स प्लेटफ़ॉर्म, सोशल मीडिया प्लेटफ़ॉर्म और स्ट्रीमिंग सेवाएं अक्सर आपके पिछले पसंद-नापसंद के आधार पर उत्पादों या कंटेंट की सिफारिश करने के लिए टेक्स्ट एम्बेडिंग का उपयोग करती हैं। जिन आइटमों के विवरण और समीक्षाओं से आपने इंटरैक्ट किया है, उनका विश्लेषण करके वे आपको समान चीजें सुझा सकती हैं जिनमें आपकी रुचि हो सकती है।
Meta (Facebook) अपनी सोशल सर्च के लिए टेक्स्ट एम्बेडिंग का उपयोग करता है। आप इस बारे में अधिक इस एब्स्ट्रैक्ट में पढ़ सकते हैं।
मशीन अनुवाद और चैटबॉट्स
टेक्स्ट एम्बेडिंग शब्द-से-शब्द अनुवाद से आगे जाती हैं। वे टेक्स्ट के संदर्भ और अर्थ पर विचार करती हैं, जिससे अधिक सटीक और स्वाभाविक लगने वाले अनुवाद मिलते हैं।
टेक्स्ट एम्बेडिंग से संचालित चैटबॉट्स आपके सवालों के पीछे के इरादे को समझ सकते हैं और अधिक तर्कसंगत और रोचक तरीके से जवाब दे सकते हैं। वे आपके संदेश की भावना का विश्लेषण कर सकते हैं और उसके अनुसार अपनी संप्रेषण शैली समायोजित कर सकते हैं।
कंटेंट निर्माण और विश्लेषण
वर्ड एम्बेडिंग का उपयोग उत्पाद विवरण या सोशल मीडिया पोस्ट जैसी अलग-अलग रचनात्मक पाठ शैलियों को जनरेट करने के लिए किया जा सकता है। ब्रांड्स सोशल मीडिया वार्तालापों का विश्लेषण करने और अपने उत्पादों या सेवाओं के प्रति ग्राहक भावना समझने के लिए भी टेक्स्ट एम्बेडिंग का उपयोग कर सकते हैं।
शीर्ष 5 टेक्स्ट एम्बेडिंग मॉडल
यहां शीर्ष टेक्स्ट एम्बेडिंग मॉडलों पर नज़र डालते हैं, जिनमें ओपन-सोर्स और क्लोज़्ड-सोर्स दोनों विकल्प शामिल हैं:
Word2Vec
जैसा कि हमने पहले चर्चा की, Word2Vec अग्रणी टेक्स्ट एम्बेडिंग मॉडलों में से एक है। इसे Google के Tomas Mikolov और सहकर्मियों ने विकसित किया। Word2Vec उथले (शैलो) न्यूरल नेटवर्क का उपयोग करता है ताकि ऐसे वर्ड वेक्टर बनाए जा सकें जो वैचारिक समानताओं को कैप्चर करें।
Word2Vec दो मॉडल आर्किटेक्चर का उपयोग करता है: कंटीन्यूस बैग-ऑफ-वर्ड्स (CBOW) और स्किप-ग्राम। CBOW आस-पास के संदर्भ के आधार पर किसी शब्द की भविष्यवाणी करता है, जबकि स्किप-ग्राम दिए गए शब्द के आधार पर आसपास के शब्दों की भविष्यवाणी करता है। यह प्रक्रिया शब्दों के बीच वैचारिक संबंधों को एन्कोड करने में मदद करती है।
Gensim और spaCY जैसे लोकप्रिय NLP लाइब्रेरी Word2Vec के इम्प्लीमेंटेशन प्रदान करती हैं। आप Google द्वारा होस्ट किया गया Word2vec का ओपन-सोर्स संस्करण पा सकते हैं, जो Apache 2.0 लाइसेंस के तहत जारी है।
GloVe
स्टैनफोर्ड का GloVe एक और व्यापक रूप से इस्तेमाल किया जाने वाला मॉडल है। यह बड़े टेक्स्ट कॉर्पस में शब्दों की सह-उपस्थिति (co-occurrence) सांख्यिकी का विश्लेषण करके स्थानीय और वैश्विक दोनों संदर्भों को कैप्चर करने पर केंद्रित है। GloVe एक शब्द सह-उपस्थिति मैट्रिक्स बनाता है और फिर उसे फैक्टराइज़ करके वर्ड वेक्टर प्राप्त करता है। यह प्रक्रिया नज़दीकी और दूरस्थ दोनों प्रकार की सह-उपस्थितियों पर विचार करती है, जिससे शब्दार्थ की व्यापक समझ बनती है।
GloVe भी ओपन-सोर्स है। प्री-ट्रेंड GloVe वेक्टर डाउनलोड के लिए उपलब्ध हैं, और इसके इम्प्लीमेंटेशन Gensim जैसी लाइब्रेरी में भी मिलते हैं।
FastText
FastText, जिसे Facebook (अब Meta) ने विकसित किया, Word2Vec का एक विस्तार है जो आउट-ऑफ-वोकैबुलरी (OOV) शब्दों को संभाल न पाने की सीमा को दूर करता है। यह शब्दों को दर्शाने के लिए सबवर्ड सूचना को शामिल करता है, जिससे अनदेखे शब्दों के लिए भी एम्बेडिंग बनाना संभव हो जाता है।
FastText शब्दों को कैरेक्टर n-ग्राम (सबवर्ड) में तोड़ता है। Word2Vec की तरह, यह इन सबवर्ड इकाइयों के आधार पर वर्ड वेक्टर प्रशिक्षित करता है। इससे मॉडल नए शब्दों को उनके घटक सबवर्ड के अर्थ के आधार पर दर्शा सकता है।
FastText ओपन-सोर्स है और FastText लाइब्रेरी के जरिए उपलब्ध है। विभिन्न भाषाओं के लिए प्री-ट्रेंड FastText वेक्टर भी डाउनलोड किए जा सकते हैं।
embedding v3
Embedding v3 (Text-embedding-3) OpenAI के एम्बेडिंग मॉडलों का नवीनतम संस्करण है। ये दो क्लास में आते हैं: text-embedding-3-small (छोटा मॉडल) और text-embedding-3-large (बड़ा मॉडल)। ये क्लोज़्ड-सोर्स हैं, और इन तक पहुंचने के लिए सशुल्क API की आवश्यकता होती है।
Text-embedding-3 मॉडल टेक्स्ट को पहले टोकन (शब्द या सबवर्ड) में तोड़कर सांख्यिकीय निरूपणों में बदलते हैं। प्रत्येक टोकन को उच्च-आयामी स्पेस में एक वेक्टर से मैप किया जाता है। इसके बाद एक ट्रांसफॉर्मर एन्कोडर इन वेक्टरों का विश्लेषण करता है, और हर शब्द के आस-पास के संदर्भ को ध्यान में रखता है।
अंत में, मॉडल पूरे टेक्स्ट का प्रतिनिधित्व करने वाला एक एकल वेक्टर आउटपुट करता है, जो उसके समग्र अर्थ और भीतर के शब्दों के संबंधों को कैप्चर करता है। बड़े संस्करण में अधिक जटिल आर्किटेक्चर और उच्च विमीयता होती है, जो संभावित रूप से बेहतर शुद्धता देती है; जबकि छोटा संस्करण तेज़ी और दक्षता को प्राथमिकता देता है, सरल आर्किटेक्चर और कम विमीयता के साथ।
OpenAI एम्बेडिंग के बारे में अधिक जानने के लिए हमारा गाइड देखें: Exploring Text-Embedding-3-Large: नए OpenAI एम्बेडिंग्स पर एक व्यापक मार्गदर्शिका।
Universal Sentence Encoder (USE)
USE Google AI द्वारा बनाया गया एक क्लोज़्ड-सोर्स सेंटेंस एम्बेडिंग मॉडल है। यह टेक्स्ट को उच्च-आयामी एम्बेडिंग में बदलता है जो वाक्यों या छोटे पैराग्राफ़ों के वैचारिक अर्थों को दर्शाते हैं।
व्यक्तिगत शब्दों को एम्बेड करने वाले मॉडलों के विपरीत, USE एक विविध टेक्स्ट कॉर्पस पर प्री-ट्रेंड डीप न्यूरल नेटवर्क का उपयोग करके पूरे वाक्यों को संभालता है। यह डिज़ाइन वैचारिक संबंधों को प्रभावी ढंग से कैप्चर करने देता है, और विभिन्न लंबाई के वाक्यों के लिए फिक्स्ड-साइज़ वेक्टर उत्पन्न करता है, जिससे संगणनात्मक दक्षता बढ़ती है।
Google अपनी TensorFlow Hub रिपॉज़िटरी के माध्यम से एक्सेस प्रदान करता है।
टेक्स्ट एम्बेडिंग से शुरुआत करें
इस गाइड में, हमने टेक्स्ट एम्बेडिंग का व्यापक परिचय, उनका अर्थ, उनकी महत्ता, और उनके विकास के प्रमुख मील के पत्थर कवर किए। हमने टेक्स्ट एम्बेडिंग के उपयोग मामलों और शीर्ष मॉडलों की भी समीक्षा की।
AI, NLP, और टेक्स्ट एम्बेडिंग के बारे में गहराई से सीखने के लिए, ये संसाधन देखें:


टेक्स्ट एम्बेडिंग (वर्ड एम्बेडिंग के समान) नेचुरल लैंग्वेज प्रोसेसिंग (NLP) की एक परिवर्तनकारी तकनीक है जिसने मशीनों के लिए मानव भाषा को समझने और प्रोसेस करने का तरीका बेहतर बनाया है।
टेक्स्ट एम्बेडिंग कच्चे टेक्स्ट को सांख्यिकीय वेक्टरों में बदलती है, जिससे कंप्यूटर उसे बेहतर समझ पाते हैं।
कारण सरल है — कंप्यूटर केवल संख्याओं में सोचते हैं और वे मानव शब्दों को स्वतंत्र रूप से नहीं समझ सकते। टेक्स्ट एम्बेडिंग की बदौलत कंप्यूटर के लिए टेक्स्ट पढ़ना, समझना, और क्वेरी के लिए अधिक सटीक उत्तर देना आसान हो गया है।
इस लेख में, हम टेक्स्ट एम्बेडिंग का अर्थ, उसकी महत्ता, विकास, उपयोग के मामले, शीर्ष मॉडल, और उसके पीछे की सहज समझ को समझेंगे।
टेक्स्ट एम्बेडिंग क्या हैं?
टेक्स्ट एम्बेडिंग शब्दों या वाक्यांशों को ऐसे संख्यात्मक डेटा में बदलने का तरीका है जिसे मशीन समझ सके। इसे ऐसे समझिए जैसे टेक्स्ट को संख्याओं की एक सूची में बदला जा रहा हो, जहां हर संख्या टेक्स्ट के अर्थ का एक हिस्सा पकड़ती है। यह तकनीक मशीनों को संदर्भ और शब्दों के बीच के संबंध समझने में मदद करती है।
स्रोत
टेक्स्ट एम्बेडिंग बनाने की प्रक्रिया में अक्सर न्यूरल नेटवर्क शामिल होते हैं, जो शब्दों के वैचारिक (सेमांटिक) अर्थ को वास्तविक संख्याओं के सघन वेक्टरों में एन्कोड करना सीखते हैं। Word2Vec और GloVe जैसे तरीके बड़े टेक्स्ट कॉर्पस में शब्दों की सह-उपस्थिति का विश्लेषण करके ये एम्बेडिंग बनाने के लिए लोकप्रिय हैं।
आप OpenAI API के साथ टेक्स्ट एम्बेडिंग के बारे में अधिक जान सकते हैं और एक अलग लेख में व्यावहारिक अनुप्रयोग देख सकते हैं।
टेक्स्ट एम्बेडिंग महत्वपूर्ण क्यों हैं?
पारंपरिक भाषा मॉडल शब्दों को स्वतंत्र इकाइयों के रूप में देखते थे। वर्ड एम्बेडिंग इस समस्या को हल करते हैं, समान अर्थ या संदर्भ साझा करने वाले शब्दों को बहुआयामी स्पेस में एक-दूसरे के पास रखकर।
टेक्स्ट एम्बेडिंग के महत्वपूर्ण होने के कुछ और कारण यहां हैं:
जनरलाइज़ेशन
एम्बेडिंग मॉडल को प्रशिक्षण डेटा से सीखे गए संदर्भ का उपयोग करके नए, अनदेखे शब्दों या वाक्यांशों पर बेहतर तरीके से सामान्यीकरण करने में मदद करते हैं। यह विशेष रूप से गतिशील भाषाओं में उपयोगी है जहां नए शब्द अक्सर उभरते रहते हैं।
मशीन लर्निंग कार्यों में सुधार
एम्बेडिंग दस्तावेज़ वर्गीकरण, सेंटिमेंट विश्लेषण और मशीन अनुवाद जैसे विभिन्न मशीन लर्निंग कार्यों में फीचर के रूप में व्यापक रूप से उपयोग किए जाते हैं। वे समृद्ध, संघनित डेटा रूप प्रदान करके एल्गोरिद्म के प्रदर्शन में सुधार करते हैं, जो मूल पाठकीय गुणों को कैप्चर करता है।
भाषा-निरपेक्ष प्रोसेसिंग
टेक्स्ट एम्बेडिंग विभिन्न भाषाओं में वैचारिक समानताओं की पहचान करके और उनका निरूपण करके बहुभाषी डेटा को संभालने में सक्षम हैं। एक उदाहरण है Language-agnostic BERT Sentence Embedding (LaBSE) मॉडल, जिसने 109 भाषाओं को कवर करने वाली क्रॉस-लिंगुअल वाक्य एम्बेडिंग बनाने में उल्लेखनीय क्षमता दिखाई है।
बड़े शब्द-संग्रह का प्रबंधन
वन-हॉट एन्कोडिंग जैसी पारंपरिक विधियां विरल डेटा (खासकर क्योंकि अधिकांश मान 0 होते हैं) और उच्च-आयामी वेक्टर बनाती हैं, जो बड़े शब्द-संग्रह के लिए अक्षम हैं। एम्बेडिंग विमीयता और संगणनात्मक जटिलता को कम करते हैं, जिससे वे व्यापक टेक्स्ट डेटा को बेहतर तरीके से संभालने के लिए उपयुक्त बनते हैं।
टेक्स्ट एम्बेडिंग के पीछे की सहज समझ
टेक्स्ट एम्बेडिंग टेक्स्ट डेटा के सघन वेक्टर निरूपण हैं, जहां समान अर्थ वाले शब्द और दस्तावेज़ उच्च-आयामी वेक्टर स्पेस में समान वेक्टरों से दर्शाए जाते हैं।
टेक्स्ट एम्बेडिंग के पीछे की सहज समझ यह है कि वे टेक्स्ट तत्वों के बीच वैचारिक और संदर्भात्मक संबंधों को कैप्चर करें, ताकि मशीन लर्निंग मॉडल टेक्स्ट डेटा पर अधिक प्रभावी ढंग से तर्क कर सकें और उसे प्रोसेस कर सकें।
वितरणात्मक परिकल्पना
टेक्स्ट एम्बेडिंग के पीछे की मुख्य अंतर्दृष्टियों में से एक वितरणात्मक परिकल्पना है, जो कहती है कि जो शब्द या वाक्यांश समान संदर्भों में प्रकट होते हैं उनका अर्थ भी अक्सर समान होता है।
उदाहरण के लिए, "king" और "queen" शब्दों पर विचार करें। हालांकि वे पर्यायवाची नहीं हैं, फिर भी दोनों राजसत्ता और राजशाही से जुड़े समान संदर्भ साझा करते हैं। टेक्स्ट एम्बेडिंग का उद्देश्य इन शब्दों को वेक्टर स्पेस में एक-दूसरे के पास स्थित वेक्टरों से दर्शाकर इस वैचारिक समानता को कैप्चर करना है।
वेक्टर स्पेस ऑपरेशंस
टेक्स्ट एम्बेडिंग के पीछे एक और सहज समझ वेक्टर स्पेस ऑपरेशंस का विचार है। टेक्स्ट को संख्यात्मक वेक्टरों के रूप में दर्शाकर, हम जोड़, घटाव और कोसाइन समानता जैसे ऑपरेशंस का उपयोग कर सकते हैं, ताकि शब्दों और वाक्यांशों के बीच वैचारिक संबंधों को कैप्चर और संचालित किया जा सके। उदाहरण के लिए, आइए निम्न उदाहरण देखें:
king - man + woman ≈ queen
इस उदाहरण में, "king - man + woman" का वेक्टर ऑपरेशन ऐसा वेक्टर दे सकता है जो "queen" की एम्बेडिंग के बहुत करीब हो, और इन शब्दों के बीच आनुपातिक (एनालॉजिकल) संबंध को कैप्चर करे।
विमीयता न्यूनीकरण
एक और बात जिसका मैं उल्लेख करना चाहूंगा, वह है टेक्स्ट एम्बेडिंग में विमीयता न्यूनीकरण। वन-हॉट एन्कोडिंग जैसी पारंपरिक विरल टेक्स्ट निरूपण अत्यधिक उच्च विमीयता (शब्द-संग्रह के आकार के बराबर) रखते हैं। दूसरी ओर, टेक्स्ट एम्बेडिंग आम तौर पर कम विमीयता (जैसे, 300 डाइमेंशन्स) की होती हैं, जिससे वे टेक्स्ट की सबसे महत्वपूर्ण विशेषताओं को कैप्चर करते हुए शोर और संगणनात्मक जटिलता को कम कर पाती हैं।
रेस्तरां केस स्टडी
शब्द एम्बेडिंग की सामान्य सहज समझ समझाने के लिए मैं रेस्तरां का उदाहरण लूंगा:
मान लीजिए आपके पास रेस्तरां समीक्षाओं का एक कॉर्पस है और आप एक ऐसी प्रणाली बनाना चाहते हैं जो प्रत्येक समीक्षा की भावना को स्वतः सकारात्मक या नकारात्मक के रूप में वर्गीकृत करे। मैं सुझाव दूंगा कि प्रत्येक समीक्षा को सघन वेक्टर के रूप में दर्शाने के लिए टेक्स्ट एम्बेडिंग का उपयोग करें, ताकि वह टेक्स्ट में व्यक्त वैचारिक अर्थ और भावना को कैप्चर कर सके।
आइए दो समीक्षाओं पर विचार करें:
समीक्षा 1: "The food was delicious, and the service was excellent. I highly recommend this restaurant."
समीक्षा 2: "The food was mediocre, and the service was poor. I won't be going back."
हालांकि ये समीक्षाएं बहुत से शब्द साझा नहीं करतीं, फिर भी उनके एम्बेडिंग वेक्टर स्पेस में एक-दूसरे से दूर होने चाहिए, जो व्यक्त की गई विपरीत भावनाओं को दर्शाए। समीक्षा 1 में "delicious" और "excellent" जैसे सकारात्मक भाव वाले शब्द वेक्टर स्पेस के सकारात्मक क्षेत्र के करीब होंगे, जबकि समीक्षा 2 में "mediocre" और "poor" जैसे नकारात्मक भाव वाले शब्द नकारात्मक क्षेत्र के करीब होंगे।
इन टेक्स्ट एम्बेडिंग पर एक मशीन लर्निंग मॉडल को प्रशिक्षित करके, वह एम्बेडिंग में एन्कोड किए गए वैचारिक पैटर्न और सेंटिमेंट जानकारी को संबंधित सेंटिमेंट लेबल (सकारात्मक या नकारात्मक) से मैप करना सीख सकता है, और नई, अनदेखी समीक्षाओं को सटीकता से वर्गीकृत कर सकता है।
टेक्स्ट एम्बेडिंग का विकास
पुस्तक “Embeddings in Natural Language Processing: Theory and Advances in Vector Representations of Meaning” — Mohammad Taher Pilehvar और Jose Camacho-Collados के अनुसार, टेक्स्ट एम्बेडिंग,
“मुख्यतः 2013 के बाद लोकप्रिय हुईं, जब Word2vec पेश किया गया।”
यह वर्ष वाकई टेक्स्ट एम्बेडिंग के लिए एक बड़ा बदलाव लेकर आया। हालांकि, टेक्स्ट एम्बेडिंग पर शोध 1950 के दशक तक जाता है। जबकि यह खंड संपूर्ण नहीं है, मैं टेक्स्ट एम्बेडिंग के विकास के कुछ प्रमुख मील के पत्थरों को कवर करूंगा।
शुरुआती दौर (1950s–2000s)
1950s–2000s में वन-हॉट एन्कोडिंग और बैग-ऑफ-वर्ड्स (BoW) जैसी पद्धतियां प्रचलित थीं। दुर्भाग्यवश, ये तरीके पर्याप्त नहीं थे और उन्होंने कुछ चुनौतियां पेश कीं, जैसे:
TF-IDF (टर्म फ़्रीक्वेंसी–इनवर्स डॉक्यूमेंट फ़्रीक्वेंसी) 70 के दशक में टेक्स्ट को संख्याओं में पकड़ने का एक और शुरुआती प्रयास था। यह तरीका किसी खास दस्तावेज़ में शब्द की आवृत्ति के साथ-साथ सभी दस्तावेज़ों में उसकी आमियत के आधार पर वजन तय करता था, कम आम शब्दों को अधिक मान देता था। हालांकि इसने वन-हॉट एन्कोडिंग की तुलना में अधिक अंतर्दृष्टि दी, फिर भी यह शब्दों के वैचारिक अर्थ को कैप्चर करने में कम पड़ गया।
एम्बेडिंग का उदय (2000s–2010s)
IBM के अनुसार, 2000 के दशक की शुरुआत में शोधकर्ता
“न्यूरल लैंग्वेज मॉडल (NLMs) का अन्वेषण कर रहे थे, जो निरंतर स्पेस में शब्दों के बीच संबंधों को मॉडल करने के लिए न्यूरल नेटवर्क का उपयोग करते हैं। इन शुरुआती मॉडलों ने आगे चलकर वर्ड एम्बेडिंग के विकास की नींव रखी।”
एक शुरुआती उदाहरण Bengio और सह-लेखकों द्वारा लगभग 2000 में प्रस्तुत "न्यूरल प्रॉबैबिलिस्टिक लैंग्वेज मॉडल्स" है, जिसका उद्देश्य शब्दों के वितरित निरूपण सीखना था।
इसके बाद, 2013 में Word2Vec एक क्रांतिकारी मॉडल के रूप में सामने आया, जिसने शब्दों को सांख्यिकीय वेक्टरों में बदलने का विचार पेश किया। ये वेक्टर वैचारिक समानताओं को कैप्चर करते थे, जिससे समान अर्थ वाले शब्द वेक्टर स्पेस में एक-दूसरे के करीब आ जाते थे। यह मानो शब्दों का एक नक्शा बनाना था, जो उनके पारस्परिक संबंधों पर आधारित था।
2014 में, GloVe को “Glove: Global Vectors for Word Representation” शीर्षक वाले शोध पत्र में Jeffery Pennington और सह-लेखकों ने प्रस्तुत किया। GloVe ने किसी शब्द के आस-पास के तात्कालिक संदर्भ और कॉर्पस में उसके समग्र उपयोग — दोनों को ध्यान में रखकर शब्दार्थ को बेहतर समझते हुए Word2Vec में सुधार किया।
शब्दों से आगे: वाक्य और अटेंशन (2010s–2020s)
इस दौरान, अटेंशन मैकेनिज्म (2017) और ट्रांसफर लर्निंग तथा संदर्भ (2018) जैसी विधियां उभरीं।
अटेंशन मैकेनिज्म ने मॉडलों को किसी वाक्य के खास हिस्सों पर ध्यान केंद्रित करने और उनकी महत्ता के आधार पर अलग-अलग वेट देने में सक्षम बनाया। इससे मॉडल को शब्दों के बीच के संबंध और उनके अर्थ में योगदान को समझने में मदद मिली।
उदाहरण के लिए, इस वाक्य में, "The quick brown fox jumps over the lazy dog," अगला शब्द भविष्यवाणी करते समय अटेंशन मैकेनिज्म "quick" और "jumps" पर "the" या "brown" की तुलना में अधिक ध्यान दे सकता है।
वहीं, ट्रांसफर लर्निंग और संदर्भ ने प्री-ट्रेंड मॉडलों के उपयोग का मार्ग प्रशस्त किया। ULMFiT और BERT जैसी तकनीकों ने इन प्री-ट्रेंड मॉडलों को विशिष्ट कार्यों के लिए फाइन-ट्यून करना संभव बनाया। इसका अर्थ था कि उच्च प्रदर्शन के लिए कम डेटा और कम कंप्यूटिंग शक्ति की जरूरत पड़ी।
एम्बेडिंग APIs का आना
एम्बेडिंग API टेक्स्ट एम्बेडिंग के लिए हालिया दृष्टिकोण है। हालांकि यह हालिया है, इसका क्रमिक उभार 2010 के दशक में शुरू हुआ, जब क्लाउड-आधारित AI समाधान और प्री-ट्रेंड मॉडलों में प्रगति व्यापक हो रही थी।
2020 के दशक में आते-आते, डेवलपर समुदाय में APIs का अपनाव बड़े पैमाने पर बढ़ा, और एम्बेडिंग API भी लोकप्रिय हुए। एम्बेडिंग API प्री-ट्रेंड मॉडलों के माध्यम से टेक्स्ट एम्बेडिंग प्राप्त करना आसान बना देता है।
एम्बेडिंग API का एक अच्छा उदाहरण है OpenAI एम्बेडिंग API। OpenAI ने दिसंबर 2022 में अहम अपडेट के साथ अपना Embedding API पेश किया। यह API text-embedding-ada-002 नामक एकीकृत मॉडल प्रदान करती है, जो कई पुराने मॉडलों की क्षमताओं को एक ही मॉडल में समाहित करती है। यह मॉडल टेक्स्ट सर्च, कोड सर्च और वाक्य समानता जैसे कार्यों में उत्कृष्ट प्रदर्शन के लिए डिज़ाइन किया गया है।
टेक्स्ट एम्बेडिंग के उपयोग के मामले
आइए टेक्स्ट एम्बेडिंग के कुछ उपयोगों पर चर्चा करें।
सूचना पुनर्प्राप्ति और खोज
वर्ड एम्बेडिंग सर्च इंजनों को आपकी क्वेरी के अंतर्निहित अर्थ को समझने और संबंधित दस्तावेज़ खोजने में मदद करती है, भले ही उनमें आपके द्वारा इस्तेमाल किए गए सटीक शब्द न हों। यह विशेष रूप से अस्पष्ट खोजों या समान सामग्री ढूँढने में सहायक है।
ई-कॉमर्स प्लेटफ़ॉर्म, सोशल मीडिया प्लेटफ़ॉर्म और स्ट्रीमिंग सेवाएं अक्सर आपके पिछले पसंद-नापसंद के आधार पर उत्पादों या कंटेंट की सिफारिश करने के लिए टेक्स्ट एम्बेडिंग का उपयोग करती हैं। जिन आइटमों के विवरण और समीक्षाओं से आपने इंटरैक्ट किया है, उनका विश्लेषण करके वे आपको समान चीजें सुझा सकती हैं जिनमें आपकी रुचि हो सकती है।
Meta (Facebook) अपनी सोशल सर्च के लिए टेक्स्ट एम्बेडिंग का उपयोग करता है। आप इस बारे में अधिक इस एब्स्ट्रैक्ट में पढ़ सकते हैं।
मशीन अनुवाद और चैटबॉट्स
टेक्स्ट एम्बेडिंग शब्द-से-शब्द अनुवाद से आगे जाती हैं। वे टेक्स्ट के संदर्भ और अर्थ पर विचार करती हैं, जिससे अधिक सटीक और स्वाभाविक लगने वाले अनुवाद मिलते हैं।
टेक्स्ट एम्बेडिंग से संचालित चैटबॉट्स आपके सवालों के पीछे के इरादे को समझ सकते हैं और अधिक तर्कसंगत और रोचक तरीके से जवाब दे सकते हैं। वे आपके संदेश की भावना का विश्लेषण कर सकते हैं और उसके अनुसार अपनी संप्रेषण शैली समायोजित कर सकते हैं।
कंटेंट निर्माण और विश्लेषण
वर्ड एम्बेडिंग का उपयोग उत्पाद विवरण या सोशल मीडिया पोस्ट जैसी अलग-अलग रचनात्मक पाठ शैलियों को जनरेट करने के लिए किया जा सकता है। ब्रांड्स सोशल मीडिया वार्तालापों का विश्लेषण करने और अपने उत्पादों या सेवाओं के प्रति ग्राहक भावना समझने के लिए भी टेक्स्ट एम्बेडिंग का उपयोग कर सकते हैं।
शीर्ष 5 टेक्स्ट एम्बेडिंग मॉडल
यहां शीर्ष टेक्स्ट एम्बेडिंग मॉडलों पर नज़र डालते हैं, जिनमें ओपन-सोर्स और क्लोज़्ड-सोर्स दोनों विकल्प शामिल हैं:
Word2Vec
जैसा कि हमने पहले चर्चा की, Word2Vec अग्रणी टेक्स्ट एम्बेडिंग मॉडलों में से एक है। इसे Google के Tomas Mikolov और सहकर्मियों ने विकसित किया। Word2Vec उथले (शैलो) न्यूरल नेटवर्क का उपयोग करता है ताकि ऐसे वर्ड वेक्टर बनाए जा सकें जो वैचारिक समानताओं को कैप्चर करें।
Word2Vec दो मॉडल आर्किटेक्चर का उपयोग करता है: कंटीन्यूस बैग-ऑफ-वर्ड्स (CBOW) और स्किप-ग्राम। CBOW आस-पास के संदर्भ के आधार पर किसी शब्द की भविष्यवाणी करता है, जबकि स्किप-ग्राम दिए गए शब्द के आधार पर आसपास के शब्दों की भविष्यवाणी करता है। यह प्रक्रिया शब्दों के बीच वैचारिक संबंधों को एन्कोड करने में मदद करती है।
Gensim और spaCY जैसे लोकप्रिय NLP लाइब्रेरी Word2Vec के इम्प्लीमेंटेशन प्रदान करती हैं। आप Google द्वारा होस्ट किया गया Word2vec का ओपन-सोर्स संस्करण पा सकते हैं, जो Apache 2.0 लाइसेंस के तहत जारी है।
GloVe
स्टैनफोर्ड का GloVe एक और व्यापक रूप से इस्तेमाल किया जाने वाला मॉडल है। यह बड़े टेक्स्ट कॉर्पस में शब्दों की सह-उपस्थिति (co-occurrence) सांख्यिकी का विश्लेषण करके स्थानीय और वैश्विक दोनों संदर्भों को कैप्चर करने पर केंद्रित है। GloVe एक शब्द सह-उपस्थिति मैट्रिक्स बनाता है और फिर उसे फैक्टराइज़ करके वर्ड वेक्टर प्राप्त करता है। यह प्रक्रिया नज़दीकी और दूरस्थ दोनों प्रकार की सह-उपस्थितियों पर विचार करती है, जिससे शब्दार्थ की व्यापक समझ बनती है।
GloVe भी ओपन-सोर्स है। प्री-ट्रेंड GloVe वेक्टर डाउनलोड के लिए उपलब्ध हैं, और इसके इम्प्लीमेंटेशन Gensim जैसी लाइब्रेरी में भी मिलते हैं।
FastText
FastText, जिसे Facebook (अब Meta) ने विकसित किया, Word2Vec का एक विस्तार है जो आउट-ऑफ-वोकैबुलरी (OOV) शब्दों को संभाल न पाने की सीमा को दूर करता है। यह शब्दों को दर्शाने के लिए सबवर्ड सूचना को शामिल करता है, जिससे अनदेखे शब्दों के लिए भी एम्बेडिंग बनाना संभव हो जाता है।
FastText शब्दों को कैरेक्टर n-ग्राम (सबवर्ड) में तोड़ता है। Word2Vec की तरह, यह इन सबवर्ड इकाइयों के आधार पर वर्ड वेक्टर प्रशिक्षित करता है। इससे मॉडल नए शब्दों को उनके घटक सबवर्ड के अर्थ के आधार पर दर्शा सकता है।
FastText ओपन-सोर्स है और FastText लाइब्रेरी के जरिए उपलब्ध है। विभिन्न भाषाओं के लिए प्री-ट्रेंड FastText वेक्टर भी डाउनलोड किए जा सकते हैं।
embedding v3
Embedding v3 (Text-embedding-3) OpenAI के एम्बेडिंग मॉडलों का नवीनतम संस्करण है। ये दो क्लास में आते हैं:
text-embedding-3-small(छोटा मॉडल) औरtext-embedding-3-large(बड़ा मॉडल)। ये क्लोज़्ड-सोर्स हैं, और इन तक पहुंचने के लिए सशुल्क API की आवश्यकता होती है।Text-embedding-3 मॉडल टेक्स्ट को पहले टोकन (शब्द या सबवर्ड) में तोड़कर सांख्यिकीय निरूपणों में बदलते हैं। प्रत्येक टोकन को उच्च-आयामी स्पेस में एक वेक्टर से मैप किया जाता है। इसके बाद एक ट्रांसफॉर्मर एन्कोडर इन वेक्टरों का विश्लेषण करता है, और हर शब्द के आस-पास के संदर्भ को ध्यान में रखता है।
अंत में, मॉडल पूरे टेक्स्ट का प्रतिनिधित्व करने वाला एक एकल वेक्टर आउटपुट करता है, जो उसके समग्र अर्थ और भीतर के शब्दों के संबंधों को कैप्चर करता है। बड़े संस्करण में अधिक जटिल आर्किटेक्चर और उच्च विमीयता होती है, जो संभावित रूप से बेहतर शुद्धता देती है; जबकि छोटा संस्करण तेज़ी और दक्षता को प्राथमिकता देता है, सरल आर्किटेक्चर और कम विमीयता के साथ।
OpenAI एम्बेडिंग के बारे में अधिक जानने के लिए हमारा गाइड देखें: Exploring Text-Embedding-3-Large: नए OpenAI एम्बेडिंग्स पर एक व्यापक मार्गदर्शिका।
Universal Sentence Encoder (USE)
USE Google AI द्वारा बनाया गया एक क्लोज़्ड-सोर्स सेंटेंस एम्बेडिंग मॉडल है। यह टेक्स्ट को उच्च-आयामी एम्बेडिंग में बदलता है जो वाक्यों या छोटे पैराग्राफ़ों के वैचारिक अर्थों को दर्शाते हैं।
व्यक्तिगत शब्दों को एम्बेड करने वाले मॉडलों के विपरीत, USE एक विविध टेक्स्ट कॉर्पस पर प्री-ट्रेंड डीप न्यूरल नेटवर्क का उपयोग करके पूरे वाक्यों को संभालता है। यह डिज़ाइन वैचारिक संबंधों को प्रभावी ढंग से कैप्चर करने देता है, और विभिन्न लंबाई के वाक्यों के लिए फिक्स्ड-साइज़ वेक्टर उत्पन्न करता है, जिससे संगणनात्मक दक्षता बढ़ती है।
Google अपनी TensorFlow Hub रिपॉज़िटरी के माध्यम से एक्सेस प्रदान करता है।
टेक्स्ट एम्बेडिंग से शुरुआत करें
इस गाइड में, हमने टेक्स्ट एम्बेडिंग का व्यापक परिचय, उनका अर्थ, उनकी महत्ता, और उनके विकास के प्रमुख मील के पत्थर कवर किए। हमने टेक्स्ट एम्बेडिंग के उपयोग मामलों और शीर्ष मॉडलों की भी समीक्षा की।
AI, NLP, और टेक्स्ट एम्बेडिंग के बारे में गहराई से सीखने के लिए, ये संसाधन देखें: