Khóa học
Nhập môn Embeddings với OpenAI API
3 giờ
24.1K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleText embedding (tương tự word embedding) là một kỹ thuật mang tính chuyển đổi trong xử lý ngôn ngữ tự nhiên (NLP) đã cải thiện cách máy móc hiểu và xử lý ngôn ngữ của con người.
Text embedding chuyển đổi văn bản thô thành vector số, giúp máy tính hiểu văn bản tốt hơn.
Lý do rất đơn giản - máy tính chỉ “suy nghĩ” bằng con số và không thể tự hiểu từ ngữ của con người. Nhờ có text embedding, máy tính dễ dàng đọc, hiểu văn bản và đưa ra câu trả lời chính xác hơn cho các truy vấn.
Trong bài viết này, chúng ta sẽ phân tích ý nghĩa của text embedding, tầm quan trọng, quá trình phát triển, các trường hợp sử dụng, những mô hình hàng đầu và trực giác đằng sau nó.
Text embedding là cách chuyển đổi từ hoặc cụm từ trong văn bản thành dữ liệu số mà máy có thể hiểu. Hãy coi đó như việc biến văn bản thành một danh sách các con số, trong đó mỗi con số nắm bắt một phần ý nghĩa của văn bản. Kỹ thuật này giúp máy nắm bắt ngữ cảnh và mối quan hệ giữa các từ.
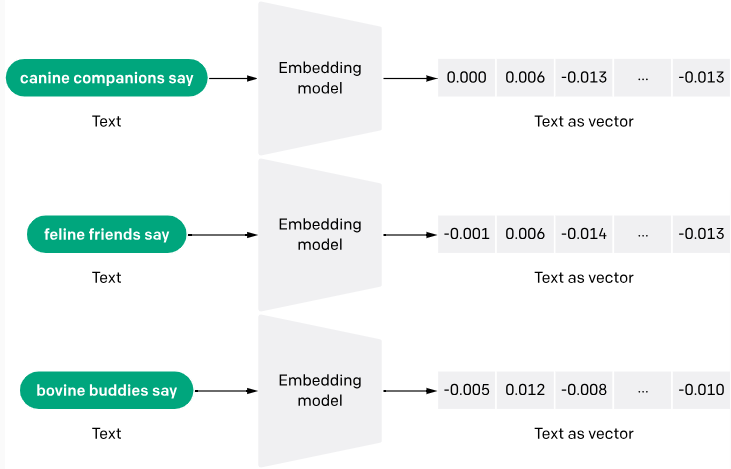
Quy trình tạo text embedding thường liên quan đến mạng nơ-ron học cách mã hóa ý nghĩa ngữ nghĩa của từ vào các vector dày đặc gồm số thực. Các phương pháp như Word2Vec và GloVe phổ biến để tạo embedding bằng cách phân tích sự đồng xuất hiện của từ trong các khối văn bản lớn.
Bạn có thể tìm hiểu thêm về text embedding với OpenAI API và xem một ứng dụng thực tế trong bài viết riêng.
Các mô hình ngôn ngữ truyền thống coi từ ngữ là những đơn vị độc lập. Word embedding khắc phục vấn đề này bằng cách đặt các từ có nghĩa hoặc ngữ cảnh tương đồng gần nhau trong một không gian đa chiều.
Dưới đây là một số lý do khác khiến text embedding quan trọng:
Embedding giúp mô hình khái quát hóa tốt hơn với các từ hoặc cụm từ mới, chưa từng thấy, bằng cách sử dụng ngữ cảnh đã học từ dữ liệu huấn luyện. Điều này đặc biệt hữu ích với các ngôn ngữ năng động, nơi từ mới xuất hiện thường xuyên.
Embedding được sử dụng rộng rãi như đặc trưng đầu vào trong nhiều tác vụ học máy, như phân loại tài liệu, phân tích cảm xúc và dịch máy. Chúng cải thiện hiệu năng thuật toán bằng cách cung cấp dạng dữ liệu giàu thông tin và cô đọng, nắm bắt các thuộc tính văn bản cơ bản.
Text embedding có khả năng xử lý nhiều ngôn ngữ bằng cách nhận diện và biểu diễn các tương đồng ngữ nghĩa trên các ngôn ngữ khác nhau. Ví dụ là mô hình Language-agnostic BERT Sentence Embedding (LaBSE), đã cho thấy năng lực vượt trội trong việc tạo embedding câu đa ngôn ngữ bao phủ 109 ngôn ngữ.
Các phương pháp truyền thống như one-hot encoding có thể tạo ra dữ liệu thưa (đặc biệt khi hầu hết quan sát có giá trị 0) và vector có số chiều rất lớn, không hiệu quả với bộ từ vựng đồ sộ. Embedding giảm số chiều và độ phức tạp tính toán, giúp xử lý tốt hơn dữ liệu văn bản khổng lồ.
Text embedding là các biểu diễn vector dày đặc của dữ liệu văn bản, trong đó những từ và tài liệu có ý nghĩa tương tự được biểu diễn bằng các vector tương tự trong một không gian vector có số chiều cao.
Trực giác đằng sau text embedding là nắm bắt các mối quan hệ ngữ nghĩa và ngữ cảnh giữa các thành phần văn bản, cho phép các mô hình học máy suy luận và xử lý dữ liệu văn bản hiệu quả hơn.
Một trong những trực giác cốt lõi là giả thuyết phân bố, cho rằng các từ hoặc cụm từ xuất hiện trong những ngữ cảnh tương tự có xu hướng mang ý nghĩa tương tự.
Ví dụ, hãy xét các từ "king" và "queen." Dù không phải là từ đồng nghĩa, chúng chia sẻ ngữ cảnh liên quan đến hoàng gia và quân chủ. Text embedding cố gắng nắm bắt sự tương đồng ngữ nghĩa này bằng cách biểu diễn những từ này bằng các vector gần nhau trong không gian vector.
Một trực giác khác là ý tưởng về các phép toán trong không gian vector. Bằng cách biểu diễn văn bản dưới dạng vector số, chúng ta có thể dùng các phép toán như cộng, trừ và độ tương đồng cosine để nắm bắt và thao tác các quan hệ ngữ nghĩa giữa từ và cụm từ. Chẳng hạn, hãy xem ví dụ sau:
king - man + woman ≈ queen
Trong ví dụ này, phép toán vector "king - man + woman" có thể cho ra một vector rất gần với embedding của "queen," nắm bắt mối quan hệ tương tự giữa các từ.
Một trực giác khác tôi muốn nhấn mạnh là giảm số chiều trong text embedding. Các biểu diễn văn bản thưa truyền thống, như one-hot encoding, có số chiều cực lớn (bằng kích thước từ vựng). Ngược lại, text embedding thường có số chiều thấp hơn (ví dụ 300 chiều), cho phép nắm bắt các đặc trưng nổi bật nhất của văn bản đồng thời giảm nhiễu và độ phức tạp tính toán.
Tôi sẽ dùng ví dụ về một nhà hàng để minh họa trực giác chung của word embedding:
Hãy tưởng tượng bạn có một tập hợp đánh giá nhà hàng và muốn xây dựng hệ thống tự động phân loại cảm xúc của mỗi đánh giá là tích cực hoặc tiêu cực. Tôi khuyến nghị dùng text embedding để biểu diễn mỗi đánh giá dưới dạng vector dày đặc, nhằm nắm bắt ý nghĩa ngữ nghĩa và cảm xúc thể hiện trong văn bản.
Hãy xét hai đánh giá:
Đánh giá 1: "The food was delicious, and the service was excellent. I highly recommend this restaurant."
Đánh giá 2: "The food was mediocre, and the service was poor. I won't be going back."
Dù hai đánh giá này không chia sẻ nhiều từ, embedding của chúng nên cách xa nhau trong không gian vector, phản ánh cảm xúc đối lập. Các từ mang sắc thái tích cực như "delicious" và "excellent" trong Đánh giá 1 sẽ có embedding gần vùng tích cực của không gian vector, trong khi các từ tiêu cực như "mediocre" và "poor" trong Đánh giá 2 sẽ gần vùng tiêu cực.
Bằng cách huấn luyện một mô hình học máy trên các text embedding này, mô hình có thể học cách ánh xạ các mẫu ngữ nghĩa và thông tin cảm xúc được mã hóa trong embedding tới các nhãn cảm xúc tương ứng (tích cực hoặc tiêu cực), từ đó phân loại chính xác các đánh giá mới, chưa từng thấy.
Theo cuốn “Embeddings in Natural Language Processing: Theory and Advances in Vector Representations of Meaning” - của Mohammad Taher Pilehvar và Jose Camacho-Collados, text embedding đã
“trở nên phổ biến chủ yếu sau năm 2013, với sự ra đời của Word2vec.”
Quả thực năm này đánh dấu một bước đột phá lớn cho text embedding. Tuy nhiên, nghiên cứu về text embedding đã bắt đầu từ tận những năm 1950. Dù không bao quát hết, phần này sẽ đề cập một số cột mốc quan trọng trong quá trình phát triển của text embedding.
Từ thập niên 1950 đến 2000, các phương pháp như one-hot encoding và Bag-of-Words (BoW) là tiêu chuẩn. Đáng tiếc, các phương pháp này chưa đủ và gây ra một số thách thức, như:
TF-IDF (Term Frequency-Inverse Document Frequency) là một nỗ lực sớm khác vào thập niên 70 để mã hóa văn bản thành con số. Cách tiếp cận này tính trọng số của mỗi từ không chỉ dựa trên tần suất trong một tài liệu cụ thể mà còn dựa trên độ phổ biến của nó trên toàn bộ tập tài liệu, gán giá trị cao hơn cho các từ ít phổ biến. Dù cải thiện so với one-hot encoding bằng cách cung cấp nhiều thông tin hơn, TF-IDF vẫn chưa nắm bắt được ý nghĩa ngữ nghĩa của từ.
Theo IBM, những năm 2000 bắt đầu với việc các nhà nghiên cứu
“khám phá các mô hình ngôn ngữ nơ-ron (NLM), sử dụng mạng nơ-ron để mô hình hóa mối quan hệ giữa từ trong một không gian liên tục. Những mô hình ban đầu này đặt nền móng cho sự phát triển sau này của word embedding.”
Một ví dụ sớm là việc Bengio và cộng sự giới thiệu "Neural probabilistic language models" vào khoảng năm 2000, nhằm học các biểu diễn phân tán của từ.
Sau đó, năm 2013, Word2Vec xuất hiện như một mô hình cách mạng, đưa ra ý tưởng biến từ ngữ thành vector số. Các vector này nắm bắt sự tương đồng ngữ nghĩa, khiến những từ có nghĩa giống nhau nằm gần nhau trong không gian vector. Tựa như tạo ra một “bản đồ” của từ dựa trên mối quan hệ của chúng.
Năm 2014, GloVe được giới thiệu trong bài nghiên cứu “Glove: Global Vectors for Word Representation” của Jeffery Pennington và đồng tác giả. GloVe cải thiện Word2Vec bằng cách hiểu nghĩa từ tốt hơn thông qua việc xét cả ngữ cảnh cận kề và mức độ sử dụng tổng thể trên toàn bộ kho ngữ liệu.
Trong giai đoạn này, các phương pháp như cơ chế attention (2017) và Học chuyển giao cùng Ngữ cảnh (2018) đã xuất hiện.
Cơ chế attention cho phép mô hình tập trung vào các phần cụ thể của câu và gán trọng số khác nhau dựa trên mức độ quan trọng. Điều này giúp mô hình hiểu mối quan hệ giữa các từ và cách chúng đóng góp vào ý nghĩa chung.
Ví dụ, trong câu "The quick brown fox jumps over the lazy dog," cơ chế attention có thể chú ý nhiều hơn đến "quick" và "jumps" khi dự đoán từ tiếp theo, so với "the" hay "brown."
Mặt khác, Học chuyển giao và Ngữ cảnh mở ra việc sử dụng các mô hình tiền huấn luyện. Các kỹ thuật như ULMFiT và BERT cho phép tinh chỉnh các mô hình tiền huấn luyện cho những tác vụ cụ thể. Điều này đồng nghĩa cần ít dữ liệu và sức mạnh tính toán hơn để đạt hiệu năng cao.
Embedding API là một cách tiếp cận gần đây đối với text embedding. Dù có vẻ mới, sự manh nha của nó đã từ thập niên 2010, khi các giải pháp AI trên nền tảng đám mây và các tiến bộ trong mô hình tiền huấn luyện trở nên phổ biến.
Tua nhanh đến thập niên 2020. Việc sử dụng API bùng nổ trong cộng đồng lập trình viên, và Embedding API cũng vậy. Embedding API giúp lấy embedding văn bản dễ dàng thông qua các mô hình tiền huấn luyện.
Một ví dụ điển hình về Embedding API là OpenAI embedding API. OpenAI giới thiệu Embedding API với các cập nhật quan trọng vào tháng 12/2022. API này cung cấp một mô hình hợp nhất có tên text-embedding-ada-002, tích hợp năng lực từ nhiều mô hình trước đó vào một mô hình duy nhất. Mô hình này được thiết kế để xuất sắc trong các tác vụ như tìm kiếm văn bản, tìm kiếm mã và đo độ tương đồng câu.
Hãy cùng thảo luận một số trường hợp sử dụng của text embedding.
Word embedding cho phép công cụ tìm kiếm hiểu ý nghĩa cơ bản của truy vấn và tìm tài liệu liên quan, ngay cả khi chúng không chứa chính xác các từ bạn dùng. Điều này đặc biệt hữu ích cho các tìm kiếm mơ hồ hoặc tìm nội dung tương tự.
Các nền tảng thương mại điện tử, mạng xã hội và dịch vụ phát trực tuyến là những ví dụ phổ biến sử dụng text embedding để đề xuất sản phẩm hoặc nội dung dựa trên sở thích trước đây của bạn. Bằng cách phân tích mô tả và đánh giá của các mục bạn đã tương tác, họ có thể gợi ý những thứ tương tự mà bạn có thể quan tâm.
Meta (Facebook) sử dụng text embedding cho tính năng tìm kiếm xã hội. Bạn có thể tìm hiểu thêm trong bản tóm tắt này.
Text embedding vượt ra ngoài dịch từng từ một. Chúng xét đến ngữ cảnh và ý nghĩa của văn bản, dẫn đến bản dịch chính xác và tự nhiên hơn.
Chatbot được hỗ trợ bởi text embedding có thể hiểu mục đích đằng sau câu hỏi của bạn và phản hồi hợp lý, hấp dẫn hơn. Chúng có thể phân tích cảm xúc trong tin nhắn và điều chỉnh phong cách giao tiếp cho phù hợp.
Word embedding có thể được dùng để tạo ra các định dạng văn bản sáng tạo khác nhau, như mô tả sản phẩm hoặc bài đăng mạng xã hội. Thương hiệu cũng có thể dùng text embedding để phân tích cuộc trò chuyện trên mạng xã hội và hiểu cảm nhận của khách hàng về sản phẩm hoặc dịch vụ của họ.
Dưới đây là cái nhìn về những mô hình text embedding hàng đầu, bao gồm cả tùy chọn mã nguồn mở và đóng:
Như đã đề cập, Word2Vec là một trong những mô hình text embedding tiên phong. Nó được phát triển bởi Tomas Mikolov và các cộng sự tại Google. Word2Vec dùng mạng nơ-ron nông để tạo vector từ nắm bắt sự tương đồng ngữ nghĩa.
Word2Vec sử dụng hai kiến trúc mô hình: Continuous Bag-of-Words (CBOW) và Skip-Gram. CBOW dự đoán một từ dựa trên ngữ cảnh xung quanh, trong khi Skip-Gram dự đoán các từ xung quanh dựa trên một từ cho trước. Quá trình này giúp mã hóa các quan hệ ngữ nghĩa giữa các từ.
Các thư viện NLP phổ biến như Gensim và spaCY cung cấp hiện thực của Word2Vec. Bạn có thể tìm phiên bản mã nguồn mở của Word2vec do Google lưu trữ và phát hành theo giấy phép Apache 2.0.
GloVe của Stanford là một mô hình được dùng rộng rãi khác. Nó tập trung nắm bắt cả ngữ cảnh cục bộ và toàn cục bằng cách phân tích thống kê đồng xuất hiện của từ trong một kho văn bản lớn. GloVe xây dựng ma trận đồng xuất hiện từ và sau đó phân rã để thu được vector từ. Quá trình này xét đến cả đồng xuất hiện gần và xa, dẫn tới hiểu biết toàn diện về ý nghĩa từ.
GloVe cũng là mã nguồn mở. Các vector GloVe tiền huấn luyện có sẵn để tải xuống, và hiện thực có thể tìm thấy trong các thư viện như Gensim.
FastText, do Facebook (nay là Meta) phát triển, là phần mở rộng của Word2Vec nhằm giải quyết hạn chế không xử lý được từ ngoài từ vựng (OOV). Nó đưa thông tin phân đoạn từ (subword) vào để biểu diễn từ, cho phép tạo embedding cho các từ chưa thấy.
FastText phân rã từ thành các n-gram ký tự (subword). Tương tự Word2Vec, nó huấn luyện vector từ dựa trên các đơn vị subword này. Điều này cho phép mô hình biểu diễn từ mới dựa trên ý nghĩa của các subword cấu thành.
FastText là mã nguồn mở và có sẵn qua thư viện FastText. Vector FastText tiền huấn luyện cũng có thể tải về cho nhiều ngôn ngữ.
Embedding v3 (Text-embedding-3) là bản phát hành mới nhất của các mô hình embedding của OpenAI. Các mô hình có hai lớp: text-embedding-3-small (mô hình nhỏ) và text-embedding-3-large (mô hình lớn). Chúng là mã đóng, và bạn cần API trả phí để truy cập.
Các mô hình Text-embedding-3 biến đổi văn bản thành biểu diễn số bằng cách trước hết tách văn bản thành token (từ hoặc subword). Mỗi token được ánh xạ tới một vector trong không gian chiều cao. Một bộ mã hóa Transformer sau đó phân tích các vector này, xét đến ngữ cảnh của từng từ dựa trên xung quanh nó.
Cuối cùng, mô hình xuất ra một vector duy nhất đại diện cho toàn bộ văn bản, nắm bắt ý nghĩa tổng thể và mối quan hệ giữa các từ bên trong. Phiên bản lớn có kiến trúc phức tạp hơn và số chiều cao hơn để đạt độ chính xác tiềm năng tốt hơn, trong khi phiên bản nhỏ ưu tiên tốc độ và hiệu quả với kiến trúc đơn giản hơn và số chiều thấp hơn.
Để tìm hiểu thêm về OpenAI embeddings, hãy xem hướng dẫn của chúng tôi: Exploring Text-Embedding-3-Large: A Comprehensive Guide to the new OpenAI Embeddings.
USE là mô hình embedding câu mã đóng do Google AI tạo ra. Nó chuyển văn bản thành embedding có số chiều cao phản ánh ý nghĩa ngữ nghĩa của câu hoặc đoạn ngắn.
Không giống các mô hình nhúng từng từ riêng lẻ, USE xử lý toàn bộ câu bằng mạng nơ-ron sâu tiền huấn luyện trên kho văn bản đa dạng. Thiết kế này cho phép nó nắm bắt hiệu quả các quan hệ ngữ nghĩa, tạo ra vector kích thước cố định cho các câu có độ dài biến thiên, giúp tăng hiệu quả tính toán.
Google cung cấp quyền truy cập thông qua kho TensorFlow Hub.
Trong hướng dẫn này, chúng ta đã có phần giới thiệu toàn diện về text embedding, ý nghĩa, tầm quan trọng và các cột mốc lớn trong quá trình phát triển. Chúng ta cũng xem xét các trường hợp sử dụng và những mô hình text embedding hàng đầu.
Để học sâu hơn về AI, NLP và text embedding, hãy xem các tài nguyên sau:
Tìm hiểu thêm về AI cùng DataCamp
Khóa học
Lộ trình
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
