Metin gömme (kelime gömmeleriyle aynı), makinelerin insan dilini anlama ve işleme biçimini geliştiren doğal dil işleme (NLP) alanındaki dönüştürücü bir tekniktir.
Metin gömme, ham metni sayısal vektörlere dönüştürerek bilgisayarların onu daha iyi anlamasını sağlar.
Bunun nedeni basittir: bilgisayarlar yalnızca sayılarla düşünür ve insan sözlerini tek başına anlayamaz. Metin gömmeleri sayesinde, bilgisayarların metinleri okuması, anlaması ve sorgulara daha doğru yanıtlar vermesi kolaylaşır.
Bu yazıda, metin gömmenin ne anlama geldiğini, önemini, evrimini, kullanım durumlarını, önde gelen modelleri ve temel sezgilerini inceleyeceğiz.
Metin Gömme Nedir?
Metin gömmeler, metindeki kelime veya ifadeleri, bir makinenin anlayabileceği sayısal verilere dönüştürmenin bir yoludur. Bunu, metni bir sayı listesine çevirmek gibi düşünün; her sayı metnin anlamının bir bölümünü yakalar. Bu teknik, makinelerin bağlamı ve kelimeler arası ilişkileri kavramasına yardımcı olur.
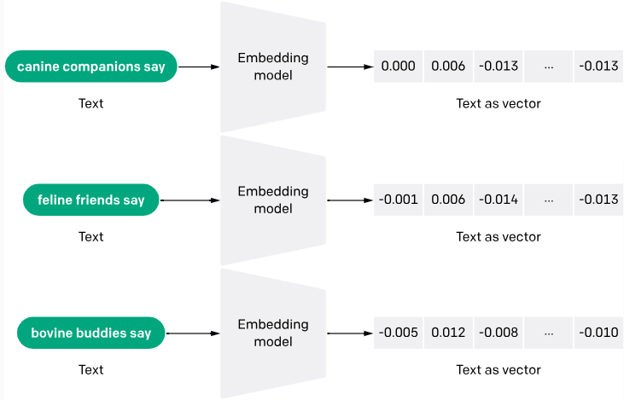
Kaynak
Metin gömmeleri üretme süreci genellikle, kelimelerin anlamsal içeriğini yoğun gerçek sayı vektörlerine kodlamayı öğrenen yapay sinir ağlarını içerir. Word2Vec ve GloVe gibi yöntemler, büyük metin yığınlarında kelime eş-görünümünü analiz ederek bu gömmeleri üretmek için popülerdir.
OpenAI API ile metin gömmeleri hakkında daha fazla bilgi edinebilir ve ayrı bir yazıda pratik bir uygulama görebilirsiniz.
Metin Gömmeleri Neden Önemlidir?
Geleneksel dil modelleri, kelimeleri bağımsız birimler olarak ele alırdı. Kelime gömmeleri, benzer anlam veya bağlam paylaşan kelimeleri çok boyutlu bir uzayda birbirine yakın konumlandırarak bu sorunu giderir.
Metin gömmelerinin önemli olmasının başka bazı nedenleri şunlardır:
Genelleme
Gömmeler, eğitim verilerinden öğrenilen bağlamı kullanarak yeni ve görülmemiş kelime veya ifadeleri daha iyi genellemeye yardımcı olur. Bu, yeni kelimelerin sıkça ortaya çıktığı dinamik dillerde özellikle faydalıdır.
Makine öğrenimi görevlerinde iyileşme
Gömmeler, belge sınıflandırma, duygu analizi ve makine çevirisi gibi çeşitli makine öğrenimi görevlerinde özellik olarak yaygın biçimde kullanılır. Metnin temel özelliklerini yakalayan zengin ve yoğun bir veri formu sunarak algoritmaların performansını artırırlar.
Dilden bağımsız işleme
Metin gömmeleri, farklı diller arasındaki anlamsal benzerlikleri tanımlayıp temsil ederek birden fazla dili işleyebilir. Buna bir örnek, 109 dili kapsayan diller arası tümce gömmeleri üretebilme yetenekleriyle dikkat çeken Language-agnostic BERT Sentence Embedding (LaBSE) modelidir.
Geniş söz varlığını yönetme
One-hot encoding gibi geleneksel yöntemler seyrek veri (özellikle çoğu gözlem 0 değeri aldığı için) ve yüksek boyutlu vektörler üretebilir; bu da büyük söz varlıkları için verimsizdir. Gömmeler, boyutluluğu ve hesaplama karmaşıklığını azaltarak kapsamlı metin verilerini daha iyi işlemeye uygun hale getirir.
Metin Gömmelerinin Arkasındaki Sezgi
Metin gömmeleri, benzer anlama sahip kelime ve belgelerin yüksek boyutlu bir vektör uzayında benzer vektörlerle temsil edildiği, metin verilerinin yoğun vektör gösterimleridir.
Metin gömmelerinin arkasındaki sezgi, metin öğeleri arasındaki anlamsal ve bağlamsal ilişkileri yakalamaktır; böylece makine öğrenimi modelleri metni daha etkili biçimde işleyip üzerinde akıl yürütebilir.
Dağıtımsal hipotez
Metin gömmelerinin temel sezgilerinden biri, benzer bağlamlarda görünen kelime veya ifadelerin benzer anlamlara sahip olma eğiliminde olduğunu söyleyen dağıtımsal hipotezdir.
Örneğin, "king" ve "queen" kelimelerini düşünün. Eş anlamlı olmasalar da kraliyet ve monarşiyle ilgili benzer bir bağlamı paylaşırlar. Metin gömmeleri, bu kelimeleri vektör uzayında birbirine yakın vektörlerle temsil ederek bu anlamsal benzerliği yakalamayı amaçlar.
Vektör uzayı işlemleri
Metin gömmelerinin bir diğer sezgisi, vektör uzayı işlemleri fikridir. Metni sayısal vektörler olarak temsil ederek, kelime ve ifadeler arasındaki anlamsal ilişkileri yakalayıp işlemek için toplama, çıkarma ve kosinüs benzerliği gibi vektör uzayı işlemlerini kullanabiliriz. Örneğin, şu örneği ele alalım:
king - man + woman ≈ queen
Bu örnekte, "king - man + woman" vektör işlemi, bu kelimeler arasındaki analojik ilişkiyi yakalayarak "queen" gömmesine çok yakın bir vektörle sonuçlanabilir.
Boyut indirgeme
Vurgulamak istediğim bir diğer sezgi, metin gömmelerinde boyut indirgemedir. One-hot encoding gibi geleneksel seyrek metin gösterimleri, (söz varlığı boyutuna eşit) son derece yüksek boyutluluğa sahip olabilir. Metin gömmeleri ise genellikle daha düşük boyutludur (ör. 300 boyut) ve böylece metnin en belirgin özelliklerini yakalarken gürültüyü ve hesaplama karmaşıklığını azaltır.
Restoran vaka çalışması
Kelime gömmelerine dair genel bir sezgiyi göstermek için restoran örneğini kullanacağım:
Elinizde restoran yorumlarından oluşan bir derlem olduğunu ve her bir yorumu otomatik olarak olumlu ya da olumsuz olarak sınıflandıran bir sistem kurmak istediğinizi düşünün. Her yorumu, metinde ifade edilen anlamsal anlamı ve duyguyu yakalayacak şekilde yoğun bir vektörle temsil etmek için metin gömmelerini kullanmanızı öneririm.
İki yorumu ele alalım:
Yorum 1: "Yemekler lezzetliydi ve servis mükemmeldi. Bu restoranı kesinlikle tavsiye ederim."
Yorum 2: "Yemekler vasattı ve servis zayıftı. Bir daha gitmeyeceğim."
Bu yorumlar çok fazla ortak kelime paylaşmasa da, vektör uzayında gömmeleri birbirinden uzak olmalıdır; bu da ifade edilen zıt duyguları yansıtır. 1. Yorumdaki "lezzetli" ve "mükemmel" gibi olumlu duygu kelimeleri vektör uzayının olumlu bölgesine daha yakın gömmelere sahip olurken, 2. Yorumdaki "vasat" ve "zayıf" gibi olumsuz kelimeler olumsuz bölgeye daha yakın gömmelere sahip olacaktır.
Bir makine öğrenimi modelini bu metin gömmeleri üzerinde eğiterek, model gömmelere kodlanan anlamsal kalıpları ve duygu bilgisini ilgili duygu etiketlerine (olumlu veya olumsuz) eşlemeyi öğrenebilir ve yeni, görülmemiş yorumları isabetli biçimde sınıflandırabilir.
Metin Gömmelerinin Evrimi
Mohammad Taher Pilehvar ve Jose Camacho-Collados’un yazdığı “Doğal Dil İşlemede Gömmeler: Anlamın Vektörel Gösterimlerinde Kuram ve İlerlemler” kitabına göre, metin gömmeleri,
“esas olarak 2013’ten sonra, Word2vec’in tanıtılmasıyla popülerleşmiştir.”
Bu yıl gerçekten de metin gömmeleri için büyük bir atılıma işaret etti. Ancak metin gömmelerine yönelik araştırmalar 1950’lere kadar uzanır. Bu bölüm kapsamlı olmasa da, metin gömmelerinin evrimindeki bazı önemli dönüm noktalarını ele alacağım.
İlk yıllar (1950’ler-2000’ler)
1950’lerden 2000’lere kadar, one-hot encoding ve Kelime Torbası (BoW) gibi yöntemler yaygındı. Ne yazık ki bu yöntemler pek yeterli değildi ve şu gibi sorunlar barındırıyordu:
- Frekansa odaklanma, anlama değil: Bu yöntemler belgeleri tek tek kelimelerin koleksiyonu olarak ele alır ve yalnızca her kelimenin kaç kez geçtiğini sayardı. Bu, kelimeler arası anlamsal ilişkileri ve bağlamı göz ardı ederdi. Örneğin, "Banka nehrin kıyısında" ile "İflas ettim" cümleleri bazı ortak kelimeleri paylaştıkları için benzer muamele görür, oysa anlamları tamamen farklıdır.
- Eş anlamlılar ve çok anlamlılıkta sınırlılık: BoW, benzer anlama sahip kelimeleri (eş anlamlılar) ya da bağlama göre birden fazla anlama gelebilen kelimeleri (çok anlamlılık) ayırt edemezdi. Bu da dili anlamayı zorlaştırırdı.
TF-IDF (Terim Frekansı-Ters Belge Frekansı), metinleri sayılara dökmeye yönelik 70’lerdeki bir diğer erken girişimdi. Bu yaklaşım, her kelimenin ağırlığını yalnızca belirli bir belgedeki sıklığına göre değil, tüm belgeler arasındaki yaygınlığına göre de hesaplar; daha seyrek kelimelere daha yüksek değer atardı. One-hot encoding’e kıyasla daha fazla içgörü sunsa da, kelimelerin anlamsal içeriğini yakalama konusunda hâlâ yetersiz kalıyordu.
Gömmelerin şafağı (2000’ler-2010’lar)
IBM’e göre 2000’ler, araştırmacıların
“kelimeler arasındaki ilişkileri sürekli bir uzayda modelleyen sinirsel dil modellerini (NLM) araştırmaya başlamasıyla”
açıldı. Bengio ve arkadaşlarının 2000’ler civarında tanıttığı "Sinirsel olasılıksal dil modelleri", kelimelerin dağıtık gösterimlerini öğrenmeyi amaçlayan erken bir örnektir.
Ardından 2013’te Word2Vec, kelimeleri sayısal vektörlere dönüştürme fikrini tanıtan devrim niteliğinde bir model olarak sahneye çıktı. Bu vektörler, anlamsal benzerlikleri yakalar; yani benzer anlamlı kelimeler vektör uzayında birbirine daha yakın konumlanır. Bu, kelimeler arası ilişkilere dayalı bir kelime haritası oluşturmak gibiydi.
2014’te, Jeffery Pennington ve yazar arkadaşlarının kaleme aldığı “GloVe: Kelime Gösterimi için Küresel Vektörler” başlıklı makaleyle GloVe tanıtıldı. GloVe, bir kelimenin hem yakın bağlamını hem de tüm derlemdeki genel kullanımını dikkate alarak Word2Vec’in kelime anlamlarını anlama yeteneğini geliştirdi.
Kelimelerin ötesi: cümleler ve dikkat (2010’lar-2020’ler)
Bu dönemde, dikkat mekanizmaları (2017) ile Transfer Öğrenimi ve Bağlam (2018) gibi yöntemler öne çıktı.
Dikkat mekanizmaları, modellerin bir cümlenin belirli kısımlarına odaklanmasına ve önemlerine göre bunlara farklı ağırlıklar atamasına olanak tanıdı. Bu, modelin kelimeler arasındaki ilişkileri ve bunların anlama katkısını kavramasına yardımcı oldu.
Örneğin, "The quick brown fox jumps over the lazy dog" cümlesinde, dikkat mekanizması bir sonraki kelimeyi tahmin ederken "quick" ve "jumps" kelimelerine, "the" veya "brown"a kıyasla daha fazla ağırlık verebilir.
Öte yandan, Transfer Öğrenimi ve Bağlam, önceden eğitilmiş modellerin kullanımını yaygınlaştırdı. ULMFiT ve BERT gibi teknikler, bu ön eğitimli modellerin belirli görevlere ince ayarlanmasına olanak tanıdı. Bu da yüksek performans için daha az veri ve hesaplama gücü gerektirdi.
Gömme API’lerinin sahneye çıkışı
Gömme API’leri, metin gömmeye yönelik yeni bir yaklaşımdır. Yeni olsa da, bulut tabanlı yapay zeka çözümleri ile ön eğitimli modellerdeki ilerlemelerin yaygınlaştığı 2010’lara kadar uzanan kademeli bir ortaya çıkışı vardır.
2020’lere geldiğimizde, API’lerin benimsenmesi geliştirici topluluğu içinde büyük ölçüde arttı; gömme API’leri de öyle. Bir gömme API’si, ön eğitimli modeller aracılığıyla metinlerden gömme elde etmeyi kolaylaştırır.
Gömme API’sine iyi bir örnek OpenAI gömme API’sidir. OpenAI, Aralık 2022’de önemli güncellemelerle Gömme API’sini tanıttı. Bu API, önceki birkaç modelin yeteneklerini tek bir modelde birleştiren text-embedding-ada-002 adlı birleşik bir model sunar. Bu model, metin arama, kod arama ve tümce benzerliği gibi görevlerde başarı gösterecek şekilde tasarlanmıştır.
Metin Gömmelerinin Kullanım Alanları
Metin gömmelerinin bazı kullanım alanlarını ele alalım.
Bilgi erişimi ve arama
Kelime gömmeleri, arama motorlarının sorgunuzun altında yatan anlamı kavramasına ve sizin kullandığınız kelimeleri birebir içermeseler bile ilgili belgeleri bulmasına yardımcı olur. Bu, özellikle belirsiz aramalar veya benzer içerik bulma durumlarında faydalıdır.
E-ticaret platformları, sosyal medya platformları ve yayın servisleri; geçmiş tercihlerinize dayalı ürün veya içerik önermek için metin gömmelerini kullanan uygulamalara yaygın örneklerdir. Etkileşimde bulunduğunuz öğelerin açıklamalarını ve yorumlarını analiz ederek ilginizi çekebilecek benzer seçenekler önerebilirler.
Meta (Facebook), sosyal araması için metin gömmelerini kullanır. Bu konuda daha fazla bilgiyi şu özette bulabilirsiniz.
Makine çevirisi ve sohbet botları
Metin gömmeleri, kelimeleri birebir çevirmekten öteye geçer. Metnin bağlamını ve anlamını dikkate alarak daha doğru ve doğal duyulan çeviriler üretir.
Metin gömmeleriyle çalışan sohbet botları, sorularınızın arkasındaki niyeti anlayarak daha makul ve ilgi çekici yanıtlar verebilir. Mesajınızın duygusunu analiz edip iletişim tarzlarını buna göre ayarlayabilirler.
İçerik oluşturma ve analiz
Kelime gömmeleri, ürün açıklamaları veya sosyal medya gönderileri gibi farklı yaratıcı metin formatları üretmek için kullanılabilir. Markalar ayrıca sosyal medya konuşmalarını analiz etmek ve ürünleri veya hizmetlerine yönelik müşteri duygusunu anlamak için metin gömmelerinden yararlanabilir.
En İyi 5 Metin Gömme Modeli
Hem açık kaynaklı hem de kapalı kaynaklı seçenekleri içeren en iyi metin gömme modellerine bir göz atalım:
Word2Vec
Önceden tartıştığımız gibi, Word2Vec öncü metin gömme modellerinden biridir. Google’da Tomas Mikolov ve çalışma arkadaşları tarafından geliştirilmiştir. Word2Vec, anlamsal benzerlikleri yakalayan kelime vektörleri üretmek için sığ sinir ağları kullanır.
Word2Vec iki model mimarisi kullanır: Sürekli Kelime Torbası (CBOW) ve Skip-Gram. CBOW, çevresindeki bağlama göre bir kelimeyi tahmin ederken, Skip-Gram verilen bir kelimeye göre çevresindeki kelimeleri tahmin eder. Bu süreç, kelimeler arasındaki anlamsal ilişkilerin kodlanmasına yardımcı olur.
Gensim ve spaCY gibi popüler NLP kütüphaneleri Word2Vec uygulamaları sunar. Google tarafından barındırılan Word2vec’in açık kaynak sürümünü Apache 2.0 lisansı ile bulabilirsiniz.
GloVe
Stanford’un GloVe’u bir diğer yaygın kullanılan modeldir. Büyük bir metin derlemi içinde kelime eş-görünüm istatistiklerini analiz ederek hem yerel hem küresel bağlamı yakalamaya odaklanır. GloVe bir kelime eş-görünüm matrisi oluşturur ve ardından kelime vektörlerini elde etmek için bunu ayrıştırır. Bu süreç, hem yakın hem de uzak kelime eş-görünümlerini dikkate alarak kelime anlamını kapsamlı biçimde kavrar.
GloVe da açık kaynaktır. Önceden eğitilmiş GloVe vektörleri indirilebilir ve Gensim gibi kütüphanelerde uygulamalar bulunabilir.
FastText
Facebook (şimdi Meta) tarafından geliştirilen FastText, sözlük dışı (OOV) kelimeleri işleyememe sınırlılığını ele alan Word2Vec’in bir uzantısıdır. Kelimeleri temsil etmek için alt kelime bilgisini dahil eder ve böylece görülmemiş kelimeler için de gömme üretebilir.
FastText, kelimeleri karakter n-gramlarına (alt kelimelere) ayrıştırır. Word2Vec’e benzer şekilde, bu alt kelime birimlerine dayalı kelime vektörleri eğitir. Bu, modelin yeni kelimeleri, onları oluşturan alt kelimelerin anlamına dayanarak temsil etmesine olanak tanır.
FastText açık kaynaktır ve FastText kütüphanesi üzerinden kullanılabilir. Çeşitli diller için önceden eğitilmiş FastText vektörleri de indirilebilir.
embedding v3
embedding v3 (Text-embedding-3), OpenAI’nin gömme modellerinin en son sürümüdür. Modeller iki sınıfta gelir: text-embedding-3-small (daha küçük model) ve text-embedding-3-large (daha büyük model). Kapalı kaynaktır ve erişim için ücretli bir API gerekir.
Text-embedding-3 modelleri, metni önce belirteçlere (kelimeler veya alt kelimeler) ayırarak sayısal temsillere dönüştürür. Her belirteç, yüksek boyutlu bir uzayda bir vektöre eşlenir. Ardından bir Transformer kodlayıcı, bu vektörleri, her kelimenin çevresine dayalı bağlamını dikkate alarak analiz eder.
Son olarak model, tüm metni temsil eden tek bir vektör çıktılar; bu vektör, metnin genel anlamını ve içindeki kelimeler arasındaki ilişkileri yakalar. Büyük sürüm, potansiyel olarak daha iyi doğruluk için daha karmaşık bir mimariye ve daha yüksek boyutluluğa sahipken; küçük sürüm, daha basit mimari ve daha düşük boyutlulukla hız ve verimliliği öncelemektedir.
OpenAI gömmeleri hakkında daha fazla bilgi edinmek için şu rehbere göz atın: Text-Embedding-3-Large’ı Keşfetmek: Yeni OpenAI Gömmelerine Kapsamlı Bir Rehber.
Universal Sentence Encoder (USE)
USE, Google AI tarafından oluşturulmuş kapalı kaynaklı bir cümle gömme modelidir. Metni, cümlelerin veya kısa paragrafların anlamsal anlamlarını yansıtan yüksek boyutlu gömmelere dönüştürür.
Bireysel kelimeleri gömen modellerden farklı olarak USE, çeşitli bir metin derlemi üzerinde önceden eğitilmiş derin bir sinir ağı kullanarak tüm cümleleri işler. Bu tasarım, anlamsal ilişkileri etkili biçimde yakalamasını sağlar ve değişken uzunluktaki cümleler için sabit boyutlu vektörler üreterek hesaplama verimliliğini artırır.
Google, TensorFlow Hub deposu üzerinden erişim sağlar.
Metin Gömmeye Başlayın
Bu rehberde metin gömmelerine kapsamlı bir giriş yaptık; ne anlama geldiklerini, neden önemli olduklarını ve evrimlerindeki başlıca dönüm noktalarını ele aldık. Ayrıca metin gömme kullanım alanlarını ve önde gelen metin gömme modellerini inceledik.
Yapay zeka, NLP ve metin gömmeleri hakkında derinlemesine öğrenmek için şu kaynaklara göz atın:





Metin gömme (kelime gömmeleriyle aynı), makinelerin insan dilini anlama ve işleme biçimini geliştiren doğal dil işleme (NLP) alanındaki dönüştürücü bir tekniktir.
Metin gömme, ham metni sayısal vektörlere dönüştürerek bilgisayarların onu daha iyi anlamasını sağlar.
Bunun nedeni basittir: bilgisayarlar yalnızca sayılarla düşünür ve insan sözlerini tek başına anlayamaz. Metin gömmeleri sayesinde, bilgisayarların metinleri okuması, anlaması ve sorgulara daha doğru yanıtlar vermesi kolaylaşır.
Bu yazıda, metin gömmenin ne anlama geldiğini, önemini, evrimini, kullanım durumlarını, önde gelen modelleri ve temel sezgilerini inceleyeceğiz.
Metin Gömme Nedir?
Metin gömmeler, metindeki kelime veya ifadeleri, bir makinenin anlayabileceği sayısal verilere dönüştürmenin bir yoludur. Bunu, metni bir sayı listesine çevirmek gibi düşünün; her sayı metnin anlamının bir bölümünü yakalar. Bu teknik, makinelerin bağlamı ve kelimeler arası ilişkileri kavramasına yardımcı olur.
Kaynak
Metin gömmeleri üretme süreci genellikle, kelimelerin anlamsal içeriğini yoğun gerçek sayı vektörlerine kodlamayı öğrenen yapay sinir ağlarını içerir. Word2Vec ve GloVe gibi yöntemler, büyük metin yığınlarında kelime eş-görünümünü analiz ederek bu gömmeleri üretmek için popülerdir.
OpenAI API ile metin gömmeleri hakkında daha fazla bilgi edinebilir ve ayrı bir yazıda pratik bir uygulama görebilirsiniz.
Metin Gömmeleri Neden Önemlidir?
Geleneksel dil modelleri, kelimeleri bağımsız birimler olarak ele alırdı. Kelime gömmeleri, benzer anlam veya bağlam paylaşan kelimeleri çok boyutlu bir uzayda birbirine yakın konumlandırarak bu sorunu giderir.
Metin gömmelerinin önemli olmasının başka bazı nedenleri şunlardır:
Genelleme
Gömmeler, eğitim verilerinden öğrenilen bağlamı kullanarak yeni ve görülmemiş kelime veya ifadeleri daha iyi genellemeye yardımcı olur. Bu, yeni kelimelerin sıkça ortaya çıktığı dinamik dillerde özellikle faydalıdır.
Makine öğrenimi görevlerinde iyileşme
Gömmeler, belge sınıflandırma, duygu analizi ve makine çevirisi gibi çeşitli makine öğrenimi görevlerinde özellik olarak yaygın biçimde kullanılır. Metnin temel özelliklerini yakalayan zengin ve yoğun bir veri formu sunarak algoritmaların performansını artırırlar.
Dilden bağımsız işleme
Metin gömmeleri, farklı diller arasındaki anlamsal benzerlikleri tanımlayıp temsil ederek birden fazla dili işleyebilir. Buna bir örnek, 109 dili kapsayan diller arası tümce gömmeleri üretebilme yetenekleriyle dikkat çeken Language-agnostic BERT Sentence Embedding (LaBSE) modelidir.
Geniş söz varlığını yönetme
One-hot encoding gibi geleneksel yöntemler seyrek veri (özellikle çoğu gözlem 0 değeri aldığı için) ve yüksek boyutlu vektörler üretebilir; bu da büyük söz varlıkları için verimsizdir. Gömmeler, boyutluluğu ve hesaplama karmaşıklığını azaltarak kapsamlı metin verilerini daha iyi işlemeye uygun hale getirir.
Metin Gömmelerinin Arkasındaki Sezgi
Metin gömmeleri, benzer anlama sahip kelime ve belgelerin yüksek boyutlu bir vektör uzayında benzer vektörlerle temsil edildiği, metin verilerinin yoğun vektör gösterimleridir.
Metin gömmelerinin arkasındaki sezgi, metin öğeleri arasındaki anlamsal ve bağlamsal ilişkileri yakalamaktır; böylece makine öğrenimi modelleri metni daha etkili biçimde işleyip üzerinde akıl yürütebilir.
Dağıtımsal hipotez
Metin gömmelerinin temel sezgilerinden biri, benzer bağlamlarda görünen kelime veya ifadelerin benzer anlamlara sahip olma eğiliminde olduğunu söyleyen dağıtımsal hipotezdir.
Örneğin, "king" ve "queen" kelimelerini düşünün. Eş anlamlı olmasalar da kraliyet ve monarşiyle ilgili benzer bir bağlamı paylaşırlar. Metin gömmeleri, bu kelimeleri vektör uzayında birbirine yakın vektörlerle temsil ederek bu anlamsal benzerliği yakalamayı amaçlar.
Vektör uzayı işlemleri
Metin gömmelerinin bir diğer sezgisi, vektör uzayı işlemleri fikridir. Metni sayısal vektörler olarak temsil ederek, kelime ve ifadeler arasındaki anlamsal ilişkileri yakalayıp işlemek için toplama, çıkarma ve kosinüs benzerliği gibi vektör uzayı işlemlerini kullanabiliriz. Örneğin, şu örneği ele alalım:
king - man + woman ≈ queen
Bu örnekte, "king - man + woman" vektör işlemi, bu kelimeler arasındaki analojik ilişkiyi yakalayarak "queen" gömmesine çok yakın bir vektörle sonuçlanabilir.
Boyut indirgeme
Vurgulamak istediğim bir diğer sezgi, metin gömmelerinde boyut indirgemedir. One-hot encoding gibi geleneksel seyrek metin gösterimleri, (söz varlığı boyutuna eşit) son derece yüksek boyutluluğa sahip olabilir. Metin gömmeleri ise genellikle daha düşük boyutludur (ör. 300 boyut) ve böylece metnin en belirgin özelliklerini yakalarken gürültüyü ve hesaplama karmaşıklığını azaltır.
Restoran vaka çalışması
Kelime gömmelerine dair genel bir sezgiyi göstermek için restoran örneğini kullanacağım:
Elinizde restoran yorumlarından oluşan bir derlem olduğunu ve her bir yorumu otomatik olarak olumlu ya da olumsuz olarak sınıflandıran bir sistem kurmak istediğinizi düşünün. Her yorumu, metinde ifade edilen anlamsal anlamı ve duyguyu yakalayacak şekilde yoğun bir vektörle temsil etmek için metin gömmelerini kullanmanızı öneririm.
İki yorumu ele alalım:
Yorum 1: "Yemekler lezzetliydi ve servis mükemmeldi. Bu restoranı kesinlikle tavsiye ederim."
Yorum 2: "Yemekler vasattı ve servis zayıftı. Bir daha gitmeyeceğim."
Bu yorumlar çok fazla ortak kelime paylaşmasa da, vektör uzayında gömmeleri birbirinden uzak olmalıdır; bu da ifade edilen zıt duyguları yansıtır. 1. Yorumdaki "lezzetli" ve "mükemmel" gibi olumlu duygu kelimeleri vektör uzayının olumlu bölgesine daha yakın gömmelere sahip olurken, 2. Yorumdaki "vasat" ve "zayıf" gibi olumsuz kelimeler olumsuz bölgeye daha yakın gömmelere sahip olacaktır.
Bir makine öğrenimi modelini bu metin gömmeleri üzerinde eğiterek, model gömmelere kodlanan anlamsal kalıpları ve duygu bilgisini ilgili duygu etiketlerine (olumlu veya olumsuz) eşlemeyi öğrenebilir ve yeni, görülmemiş yorumları isabetli biçimde sınıflandırabilir.
Metin Gömmelerinin Evrimi
Mohammad Taher Pilehvar ve Jose Camacho-Collados’un yazdığı “Doğal Dil İşlemede Gömmeler: Anlamın Vektörel Gösterimlerinde Kuram ve İlerlemler” kitabına göre, metin gömmeleri,
“esas olarak 2013’ten sonra, Word2vec’in tanıtılmasıyla popülerleşmiştir.”
Bu yıl gerçekten de metin gömmeleri için büyük bir atılıma işaret etti. Ancak metin gömmelerine yönelik araştırmalar 1950’lere kadar uzanır. Bu bölüm kapsamlı olmasa da, metin gömmelerinin evrimindeki bazı önemli dönüm noktalarını ele alacağım.
İlk yıllar (1950’ler-2000’ler)
1950’lerden 2000’lere kadar, one-hot encoding ve Kelime Torbası (BoW) gibi yöntemler yaygındı. Ne yazık ki bu yöntemler pek yeterli değildi ve şu gibi sorunlar barındırıyordu:
TF-IDF (Terim Frekansı-Ters Belge Frekansı), metinleri sayılara dökmeye yönelik 70’lerdeki bir diğer erken girişimdi. Bu yaklaşım, her kelimenin ağırlığını yalnızca belirli bir belgedeki sıklığına göre değil, tüm belgeler arasındaki yaygınlığına göre de hesaplar; daha seyrek kelimelere daha yüksek değer atardı. One-hot encoding’e kıyasla daha fazla içgörü sunsa da, kelimelerin anlamsal içeriğini yakalama konusunda hâlâ yetersiz kalıyordu.
Gömmelerin şafağı (2000’ler-2010’lar)
IBM’e göre 2000’ler, araştırmacıların
“kelimeler arasındaki ilişkileri sürekli bir uzayda modelleyen sinirsel dil modellerini (NLM) araştırmaya başlamasıyla”
açıldı. Bengio ve arkadaşlarının 2000’ler civarında tanıttığı "Sinirsel olasılıksal dil modelleri", kelimelerin dağıtık gösterimlerini öğrenmeyi amaçlayan erken bir örnektir.
Ardından 2013’te Word2Vec, kelimeleri sayısal vektörlere dönüştürme fikrini tanıtan devrim niteliğinde bir model olarak sahneye çıktı. Bu vektörler, anlamsal benzerlikleri yakalar; yani benzer anlamlı kelimeler vektör uzayında birbirine daha yakın konumlanır. Bu, kelimeler arası ilişkilere dayalı bir kelime haritası oluşturmak gibiydi.
2014’te, Jeffery Pennington ve yazar arkadaşlarının kaleme aldığı “GloVe: Kelime Gösterimi için Küresel Vektörler” başlıklı makaleyle GloVe tanıtıldı. GloVe, bir kelimenin hem yakın bağlamını hem de tüm derlemdeki genel kullanımını dikkate alarak Word2Vec’in kelime anlamlarını anlama yeteneğini geliştirdi.
Kelimelerin ötesi: cümleler ve dikkat (2010’lar-2020’ler)
Bu dönemde, dikkat mekanizmaları (2017) ile Transfer Öğrenimi ve Bağlam (2018) gibi yöntemler öne çıktı.
Dikkat mekanizmaları, modellerin bir cümlenin belirli kısımlarına odaklanmasına ve önemlerine göre bunlara farklı ağırlıklar atamasına olanak tanıdı. Bu, modelin kelimeler arasındaki ilişkileri ve bunların anlama katkısını kavramasına yardımcı oldu.
Örneğin, "The quick brown fox jumps over the lazy dog" cümlesinde, dikkat mekanizması bir sonraki kelimeyi tahmin ederken "quick" ve "jumps" kelimelerine, "the" veya "brown"a kıyasla daha fazla ağırlık verebilir.
Öte yandan, Transfer Öğrenimi ve Bağlam, önceden eğitilmiş modellerin kullanımını yaygınlaştırdı. ULMFiT ve BERT gibi teknikler, bu ön eğitimli modellerin belirli görevlere ince ayarlanmasına olanak tanıdı. Bu da yüksek performans için daha az veri ve hesaplama gücü gerektirdi.
Gömme API’lerinin sahneye çıkışı
Gömme API’leri, metin gömmeye yönelik yeni bir yaklaşımdır. Yeni olsa da, bulut tabanlı yapay zeka çözümleri ile ön eğitimli modellerdeki ilerlemelerin yaygınlaştığı 2010’lara kadar uzanan kademeli bir ortaya çıkışı vardır.
2020’lere geldiğimizde, API’lerin benimsenmesi geliştirici topluluğu içinde büyük ölçüde arttı; gömme API’leri de öyle. Bir gömme API’si, ön eğitimli modeller aracılığıyla metinlerden gömme elde etmeyi kolaylaştırır.
Gömme API’sine iyi bir örnek OpenAI gömme API’sidir. OpenAI, Aralık 2022’de önemli güncellemelerle Gömme API’sini tanıttı. Bu API, önceki birkaç modelin yeteneklerini tek bir modelde birleştiren text-embedding-ada-002 adlı birleşik bir model sunar. Bu model, metin arama, kod arama ve tümce benzerliği gibi görevlerde başarı gösterecek şekilde tasarlanmıştır.
Metin Gömmelerinin Kullanım Alanları
Metin gömmelerinin bazı kullanım alanlarını ele alalım.
Bilgi erişimi ve arama
Kelime gömmeleri, arama motorlarının sorgunuzun altında yatan anlamı kavramasına ve sizin kullandığınız kelimeleri birebir içermeseler bile ilgili belgeleri bulmasına yardımcı olur. Bu, özellikle belirsiz aramalar veya benzer içerik bulma durumlarında faydalıdır.
E-ticaret platformları, sosyal medya platformları ve yayın servisleri; geçmiş tercihlerinize dayalı ürün veya içerik önermek için metin gömmelerini kullanan uygulamalara yaygın örneklerdir. Etkileşimde bulunduğunuz öğelerin açıklamalarını ve yorumlarını analiz ederek ilginizi çekebilecek benzer seçenekler önerebilirler.
Meta (Facebook), sosyal araması için metin gömmelerini kullanır. Bu konuda daha fazla bilgiyi şu özette bulabilirsiniz.
Makine çevirisi ve sohbet botları
Metin gömmeleri, kelimeleri birebir çevirmekten öteye geçer. Metnin bağlamını ve anlamını dikkate alarak daha doğru ve doğal duyulan çeviriler üretir.
Metin gömmeleriyle çalışan sohbet botları, sorularınızın arkasındaki niyeti anlayarak daha makul ve ilgi çekici yanıtlar verebilir. Mesajınızın duygusunu analiz edip iletişim tarzlarını buna göre ayarlayabilirler.
İçerik oluşturma ve analiz
Kelime gömmeleri, ürün açıklamaları veya sosyal medya gönderileri gibi farklı yaratıcı metin formatları üretmek için kullanılabilir. Markalar ayrıca sosyal medya konuşmalarını analiz etmek ve ürünleri veya hizmetlerine yönelik müşteri duygusunu anlamak için metin gömmelerinden yararlanabilir.
En İyi 5 Metin Gömme Modeli
Hem açık kaynaklı hem de kapalı kaynaklı seçenekleri içeren en iyi metin gömme modellerine bir göz atalım:
Word2Vec
Önceden tartıştığımız gibi, Word2Vec öncü metin gömme modellerinden biridir. Google’da Tomas Mikolov ve çalışma arkadaşları tarafından geliştirilmiştir. Word2Vec, anlamsal benzerlikleri yakalayan kelime vektörleri üretmek için sığ sinir ağları kullanır.
Word2Vec iki model mimarisi kullanır: Sürekli Kelime Torbası (CBOW) ve Skip-Gram. CBOW, çevresindeki bağlama göre bir kelimeyi tahmin ederken, Skip-Gram verilen bir kelimeye göre çevresindeki kelimeleri tahmin eder. Bu süreç, kelimeler arasındaki anlamsal ilişkilerin kodlanmasına yardımcı olur.
Gensim ve spaCY gibi popüler NLP kütüphaneleri Word2Vec uygulamaları sunar. Google tarafından barındırılan Word2vec’in açık kaynak sürümünü Apache 2.0 lisansı ile bulabilirsiniz.
GloVe
Stanford’un GloVe’u bir diğer yaygın kullanılan modeldir. Büyük bir metin derlemi içinde kelime eş-görünüm istatistiklerini analiz ederek hem yerel hem küresel bağlamı yakalamaya odaklanır. GloVe bir kelime eş-görünüm matrisi oluşturur ve ardından kelime vektörlerini elde etmek için bunu ayrıştırır. Bu süreç, hem yakın hem de uzak kelime eş-görünümlerini dikkate alarak kelime anlamını kapsamlı biçimde kavrar.
GloVe da açık kaynaktır. Önceden eğitilmiş GloVe vektörleri indirilebilir ve Gensim gibi kütüphanelerde uygulamalar bulunabilir.
FastText
Facebook (şimdi Meta) tarafından geliştirilen FastText, sözlük dışı (OOV) kelimeleri işleyememe sınırlılığını ele alan Word2Vec’in bir uzantısıdır. Kelimeleri temsil etmek için alt kelime bilgisini dahil eder ve böylece görülmemiş kelimeler için de gömme üretebilir.
FastText, kelimeleri karakter n-gramlarına (alt kelimelere) ayrıştırır. Word2Vec’e benzer şekilde, bu alt kelime birimlerine dayalı kelime vektörleri eğitir. Bu, modelin yeni kelimeleri, onları oluşturan alt kelimelerin anlamına dayanarak temsil etmesine olanak tanır.
FastText açık kaynaktır ve FastText kütüphanesi üzerinden kullanılabilir. Çeşitli diller için önceden eğitilmiş FastText vektörleri de indirilebilir.
embedding v3
embedding v3 (Text-embedding-3), OpenAI’nin gömme modellerinin en son sürümüdür. Modeller iki sınıfta gelir:
text-embedding-3-small(daha küçük model) vetext-embedding-3-large(daha büyük model). Kapalı kaynaktır ve erişim için ücretli bir API gerekir.Text-embedding-3 modelleri, metni önce belirteçlere (kelimeler veya alt kelimeler) ayırarak sayısal temsillere dönüştürür. Her belirteç, yüksek boyutlu bir uzayda bir vektöre eşlenir. Ardından bir Transformer kodlayıcı, bu vektörleri, her kelimenin çevresine dayalı bağlamını dikkate alarak analiz eder.
Son olarak model, tüm metni temsil eden tek bir vektör çıktılar; bu vektör, metnin genel anlamını ve içindeki kelimeler arasındaki ilişkileri yakalar. Büyük sürüm, potansiyel olarak daha iyi doğruluk için daha karmaşık bir mimariye ve daha yüksek boyutluluğa sahipken; küçük sürüm, daha basit mimari ve daha düşük boyutlulukla hız ve verimliliği öncelemektedir.
OpenAI gömmeleri hakkında daha fazla bilgi edinmek için şu rehbere göz atın: Text-Embedding-3-Large’ı Keşfetmek: Yeni OpenAI Gömmelerine Kapsamlı Bir Rehber.
Universal Sentence Encoder (USE)
USE, Google AI tarafından oluşturulmuş kapalı kaynaklı bir cümle gömme modelidir. Metni, cümlelerin veya kısa paragrafların anlamsal anlamlarını yansıtan yüksek boyutlu gömmelere dönüştürür.
Bireysel kelimeleri gömen modellerden farklı olarak USE, çeşitli bir metin derlemi üzerinde önceden eğitilmiş derin bir sinir ağı kullanarak tüm cümleleri işler. Bu tasarım, anlamsal ilişkileri etkili biçimde yakalamasını sağlar ve değişken uzunluktaki cümleler için sabit boyutlu vektörler üreterek hesaplama verimliliğini artırır.
Google, TensorFlow Hub deposu üzerinden erişim sağlar.
Metin Gömmeye Başlayın
Bu rehberde metin gömmelerine kapsamlı bir giriş yaptık; ne anlama geldiklerini, neden önemli olduklarını ve evrimlerindeki başlıca dönüm noktalarını ele aldık. Ayrıca metin gömme kullanım alanlarını ve önde gelen metin gömme modellerini inceledik.
Yapay zeka, NLP ve metin gömmeleri hakkında derinlemesine öğrenmek için şu kaynaklara göz atın: