
Corso
Meta AI ha appena introdotto Llama 3.3, un modello da 70 miliardi di parametri che offre prestazioni paragonabili al ben più grande Llama 3.1 405B, ma con richieste computazionali molto più basse.
Lo riteniamo particolarmente interessante perché rende un'IA di alta qualità più accessibile agli sviluppatori che non hanno accesso a hardware costoso.
Progettato per attività basate su testo come chat multilingue, assistenza al coding e generazione di dati sintetici, Llama 3.3 si concentra esclusivamente su input e output testuali: non è pensato per gestire immagini o audio.
In questo blog, ti spieghiamo cosa rende unico questo modello e ti aiutiamo a capire se è adatto ai tuoi progetti.
Che cos'è Llama 3.3?
Llama 3.3 è l'ultimo large language model di Meta AI e lo consideriamo un passo verso un'IA avanzata più accessibile per una varietà di progetti. Con 70 miliardi di parametri, offre prestazioni in linea con il molto più grande Llama 3.1 405B, ma con requisiti hardware significativamente ridotti. Questo significa che possiamo esplorare applicazioni di IA sofisticate senza bisogno di setup costosi e specializzati.
Il modello è progettato specificamente per input e output testuali, quindi non gestisce immagini, audio o altri media. L'abbiamo trovato particolarmente efficace per attività come chat multilingue, assistenza al coding e generazione di dati sintetici. Con il supporto per otto lingue, tra cui inglese, spagnolo, hindi e tedesco, è un'ottima opzione per progetti che richiedono capacità multilingue.
Ciò che ci colpisce è l'attenzione all'efficienza. Llama 3.3 è ottimizzato per girare su GPU comuni, il che lo rende pratico per implementazioni locali e più semplice da sperimentare. Integra anche tecniche di allineamento per garantire risposte utili e sicure, aspetto fondamentale per applicazioni sensibili.
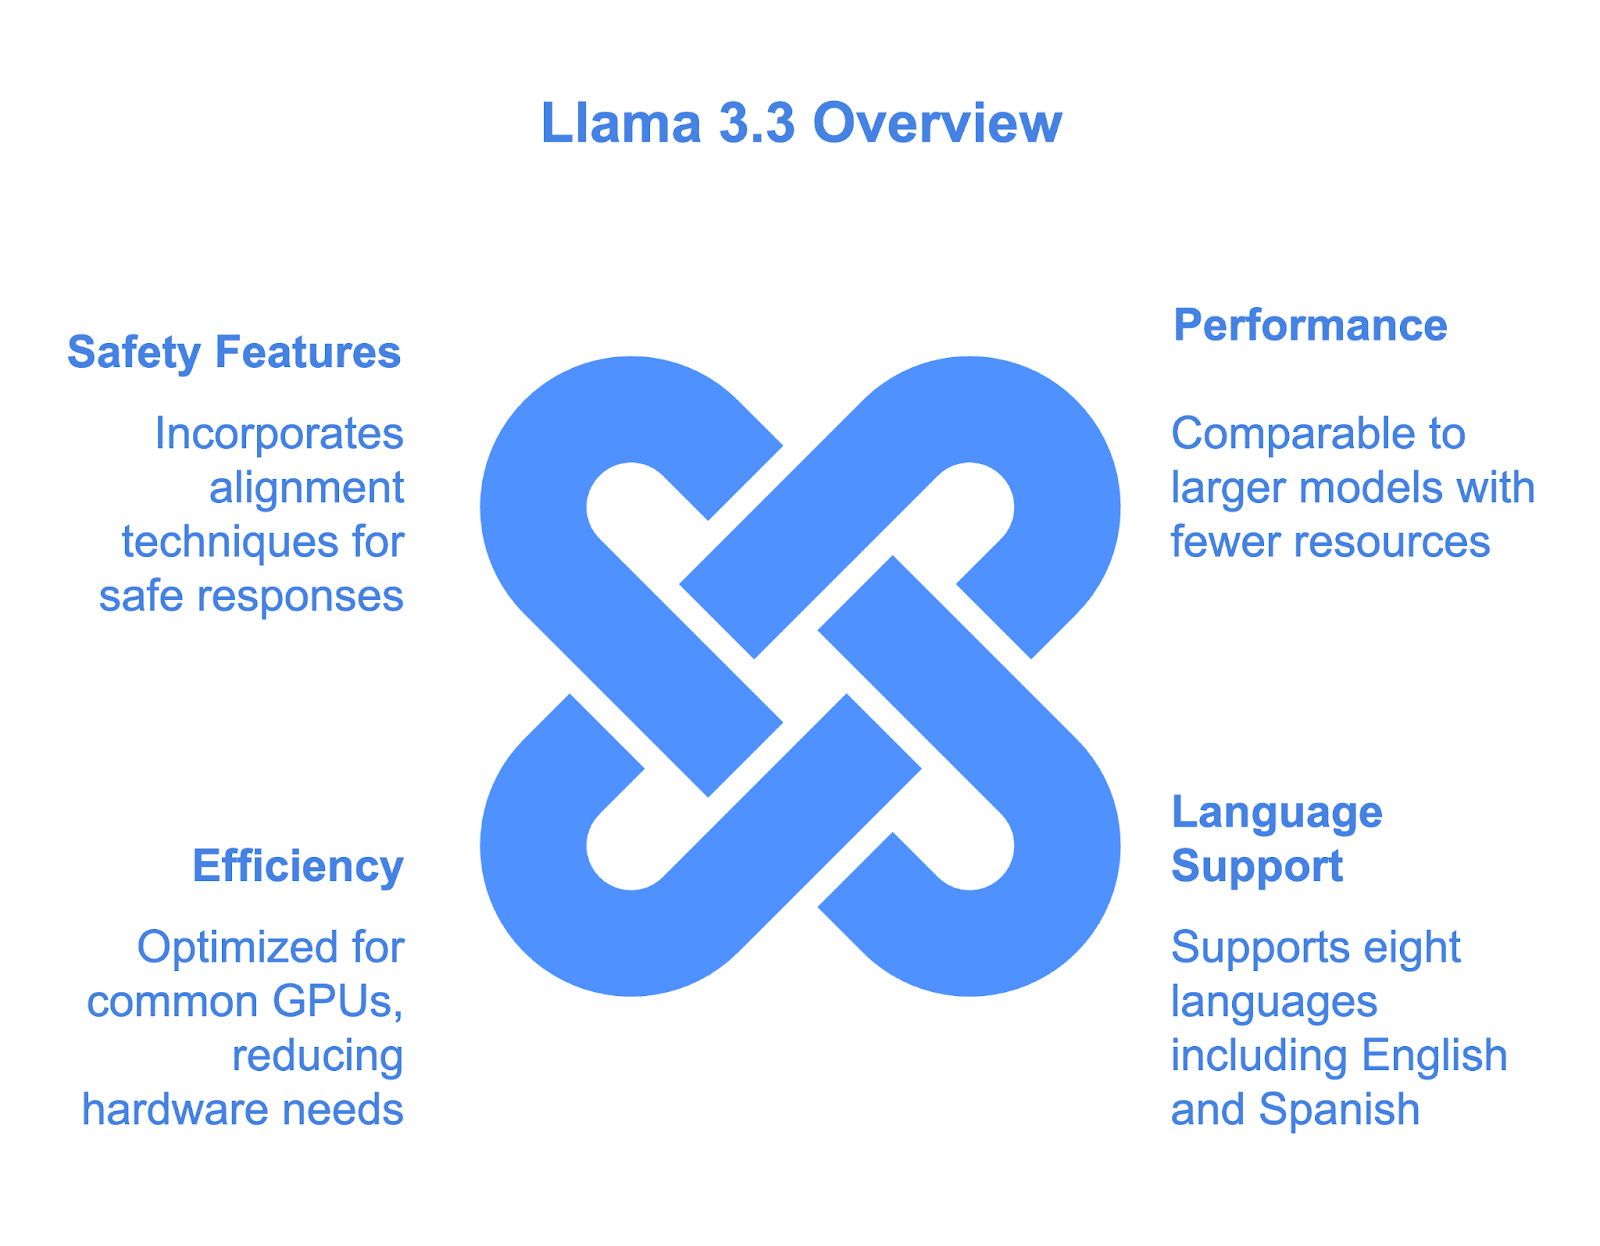
In questa sezione abbiamo riassunto le basi di cosa sia Llama 3.3, ma andremo più a fondo nelle prossime. Vedremo come funziona, come iniziare a usarlo e come si comporta nei benchmark, così potrai determinare se è la scelta giusta per il tuo lavoro.
Come funziona Llama 3.3?
Ecco come opera Llama 3.3, spiegato in modo che abbia senso sia se conosci già i large language model sia se stai iniziando a esplorarli.
Architettura: efficiente e scalabile
Al cuore di Llama 3.3 c'è un'architettura basata su transformer con 70 miliardi di parametri. Se non ti è familiare, i parametri sono in sostanza le "manopole" che il modello regola durante l'addestramento per imparare schemi e relazioni nel testo. È ciò che consente a Llama 3.3 di generare risposte coerenti e contestualmente pertinenti.
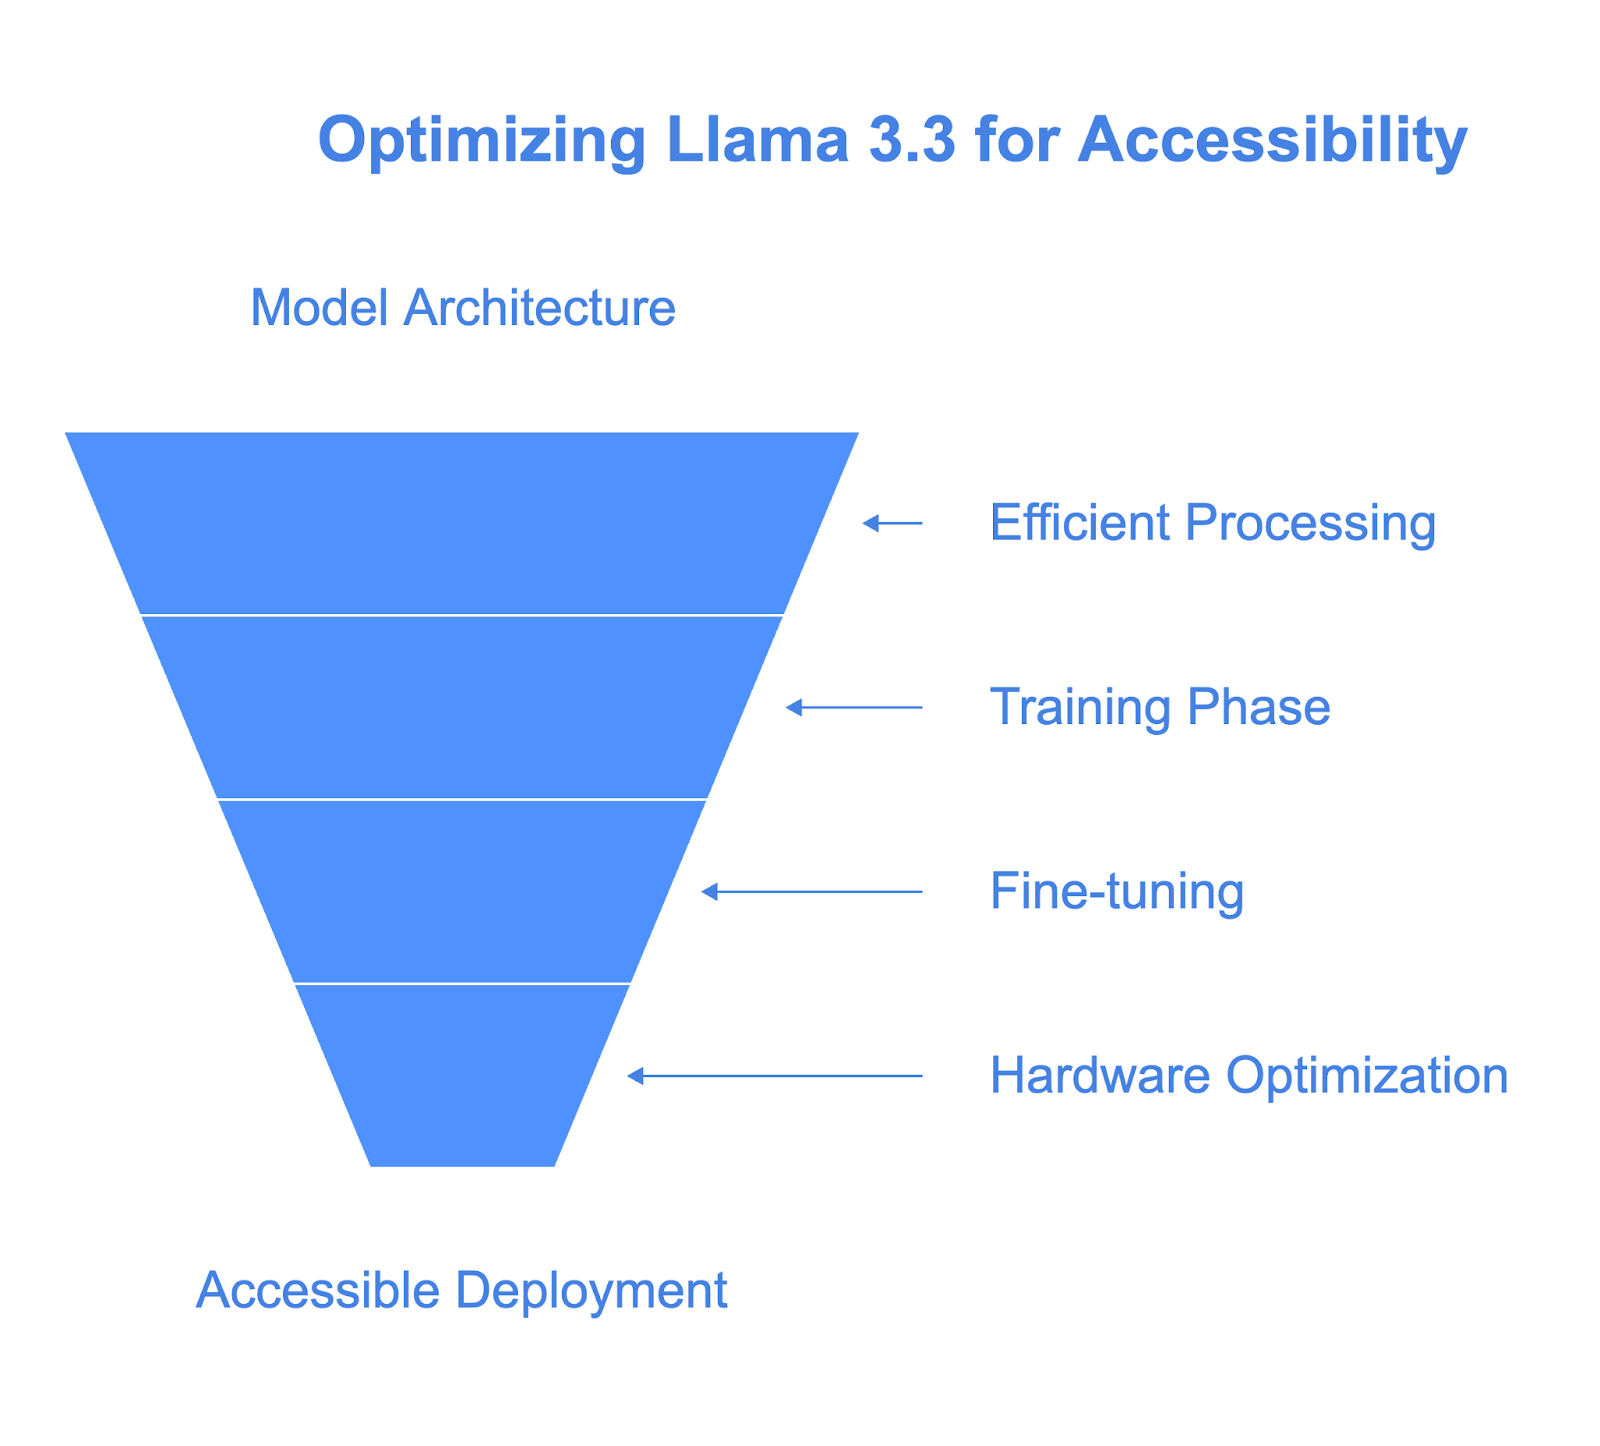
La differenza di Llama 3.3 sta nell'uso della Grouped-Query Attention (GQA). Questo rende il modello più efficiente permettendogli di processare il testo più velocemente e con meno risorse computazionali. Ecco perché può raggiungere prestazioni simili al molto più grande Llama 3.1 405B pur risultando molto meno esigente in termini di hardware.
Addestramento e fine-tuning
L'addestramento di un modello come Llama 3.3 parte esponendolo a un vasto dataset: 15 trilioni di token di testo da fonti pubblicamente disponibili. Questo conferisce al modello un'ampia comprensione del linguaggio e della conoscenza.
Ma sappiamo che il training grezzo non basta a rendere un modello utile in scenari reali. Qui entra in gioco il fine-tuning:
- Supervised fine-tuning (SFT): qui il modello impara da esempi accuratamente selezionati di buone risposte. Pensalo come un "gold standard" di come dovrebbe comportarsi.
- Reinforcement learning con feedback umano (RLHF): prevede di raccogliere feedback umani sulle prestazioni del modello e usare tali feedback per affinarne il comportamento.
Questo approccio duale assicura che Llama 3.3 sia allineato alle aspettative umane, sia in termini di utilità sia di sicurezza.
Progettato per hardware accessibile
Llama 3.3 è progettato per girare in locale su comuni workstation per sviluppatori, rendendolo accessibile a chi non dispone di infrastrutture di livello enterprise. A differenza di modelli più grandi come Llama 3.1 405B, richiede molta meno potenza computazionale pur mantenendo prestazioni solide.
Questa efficienza è dovuta in gran parte alla Grouped-Query Attention (GQA), che ottimizza il modo in cui il modello elabora il testo riducendo l'uso di memoria e accelerando l'inferenza.
Il modello supporta anche tecniche di quantizzazione, come la precisione a 8 bit e 4 bit, tramite strumenti come bitsandbytes. Queste tecniche riducono notevolmente i requisiti di memoria senza sacrificare troppo le prestazioni.
Inoltre, scala bene su diverse configurazioni hardware, da singole GPU a sistemi distribuiti, offrendo flessibilità sia per esperimenti locali sia per implementazioni più ampie.
In pratica, questo significa che possiamo sperimentare o distribuire Llama 3.3 su setup hardware più economici, evitando gli alti costi tipicamente associati ai modelli di IA avanzati. Lo rende una scelta pratica per sviluppatori e team che cercano di bilanciare prestazioni e accessibilità.
Benchmark di Llama 3.3
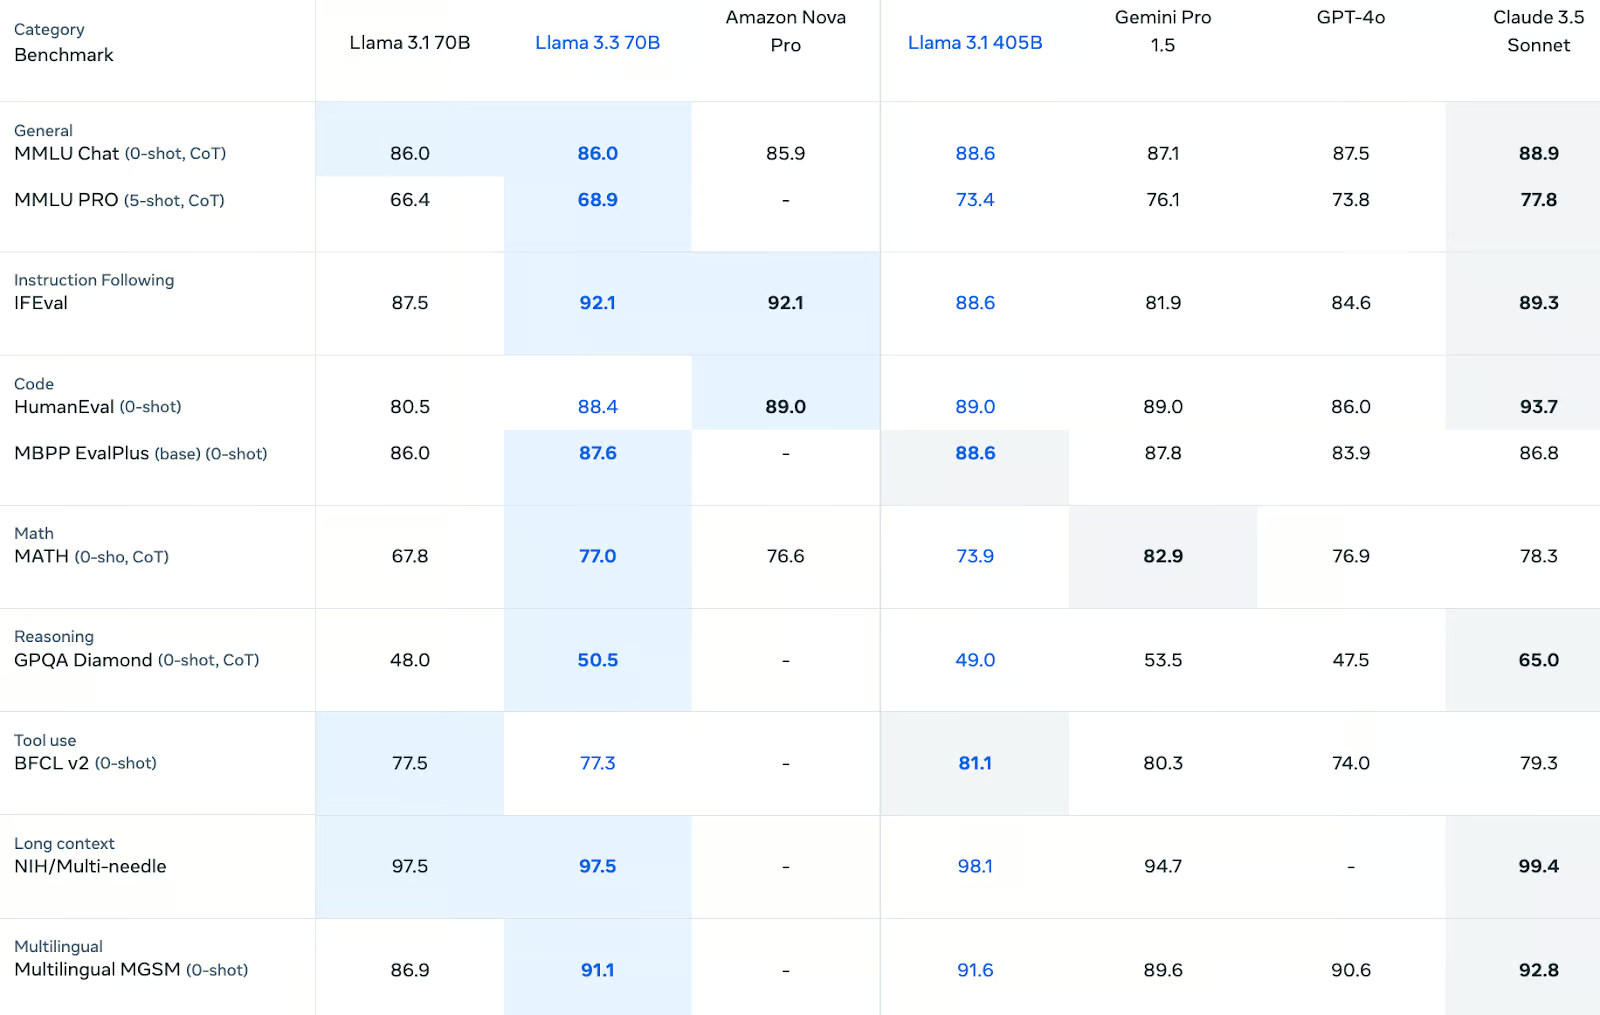
Llama 3.3 si comporta bene su una varietà di benchmark, con risultati di spicco nel rispetto delle istruzioni, nel coding e nel ragionamento multilingue. Pur non superando costantemente modelli più grandi come Llama 3.1 405B o Claude 3.5 Sonnet, offre risultati affidabili e competitivi nella maggior parte delle categorie. Per gli sviluppatori alla ricerca di un modello equilibrato che gestisca efficacemente compiti diversi, Llama 3.3 è un'ottima opzione.
Conoscenza generale e ragionamento
Nei compiti di conoscenza generale, Llama 3.3 offre risultati solidi. Ottiene un punteggio di 86,0 su MMLU Chat (0-shot, CoT), eguagliando il suo predecessore Llama 3.1 70B e restando competitivo con Amazon Nova Pro (85,9). Tuttavia, è leggermente sotto al più grande Llama 3.1 405B (88,6) e a Claude 3.5 Sonnet (88,9).
Sul più impegnativo benchmark MMLU PRO (5-shot, CoT), Llama 3.3 migliora rispetto a Llama 3.1 70B con un punteggio di 68,9, ma resta indietro rispetto a Llama 3.1 405B (73,4) e Claude 3.5 Sonnet (77,8).
Per i compiti di ragionamento, Llama 3.3 ottiene 50,5 su GPQA Diamond (0-shot, CoT), un lieve miglioramento rispetto a Llama 3.1 70B (48,0). Pur collocandosi dietro ad alcuni concorrenti come Claude 3.5 Sonnet (65,0), mostra progressi nel ragionamento strutturato.
Rispetto delle istruzioni
Llama 3.3 eccelle nei compiti di rispetto delle istruzioni, con un 92,1 su IFEval, che misura quanto bene un modello segue le istruzioni dell'utente. Questo risultato lo pone davanti a Llama 3.1 405B (88,6) e GPT-4o (84,6), e vicino a Claude 3.5 Sonnet (89,3). Le sue prestazioni in questa categoria evidenziano le capacità di allineamento, cruciali per applicazioni come chatbot e assistenti orientati ai compiti.
Capacità di coding
I benchmark di programmazione sono un punto di forza di Llama 3.3. Su HumanEval (0-shot), ottiene 88,4, leggermente sotto a Llama 3.1 405B (89,0) e in linea con Gemini Pro 1.5. Allo stesso modo, in MBPP EvalPlus (base), raggiunge 87,6, un leggero miglioramento rispetto a Llama 3.1 70B (86,0). Questi risultati confermano la sua efficacia nel generare codice e risolvere compiti legati alla programmazione.
Matematica e ragionamento simbolico
Nel ragionamento simbolico, Llama 3.3 mostra progressi significativi. Ottiene 77,0 su MATH (0-shot, CoT), superando Llama 3.1 70B (67,8) e Amazon Nova Pro (76,6). Tuttavia, è dietro a Gemini Pro 1.5 (82,9). Pur non essendo il leader in questa categoria, offre prestazioni sufficienti per molti compiti di ragionamento strutturato.
Capacità multilingue
Llama 3.3 dimostra una notevole forza nel ragionamento multilingue, con un 91,1 su MGSM (0-shot). È un miglioramento sostanziale rispetto a Llama 3.1 70B (86,9) e lo colloca vicino a Claude 3.5 Sonnet (92,8). Le sue prestazioni in questa categoria lo rendono un'ottima scelta per applicazioni multilingue come traduzione e assistenza clienti globale.
Uso di strumenti e prestazioni su contesti lunghi
Per l'uso di strumenti, Llama 3.3 ottiene 77,3 su BFCL v2 (0-shot), paragonabile a Llama 3.1 70B (77,5) ma inferiore a Llama 3.1 405B (81,1). Nella gestione di input a contesto lungo, ottiene 97,5 su NIH/Multi-Needle, in linea con Llama 3.1 70B e leggermente sotto a Llama 3.1 405B (98,1). Questi risultati indicano solide capacità per workflow assistiti da strumenti e scenari con input estesi.
Casi d'uso di Llama 3.3
Llama 3.3 apre un'ampia gamma di possibilità per sviluppatori e ricercatori, grazie al suo equilibrio tra prestazioni elevate ed efficienza hardware. Apprezziamo il fatto che giri efficacemente su normali workstation per sviluppatori, rendendolo un'opzione accessibile per chi non dispone di infrastrutture enterprise. Ecco alcune aree in cui può essere utile.
1. Chatbot e assistenti multilingue
Uno dei punti di forza di Llama 3.3 è la capacità di gestire più lingue. Con il supporto per otto lingue principali — tra cui inglese, spagnolo, francese e hindi — è ideale per costruire chatbot o assistenti virtuali multilingue.
Ci colpisce il fatto che non serva un data center per iniziare. Gli sviluppatori possono prototipare e distribuire questi sistemi sul proprio hardware, sia per l'assistenza clienti, strumenti educativi o altre applicazioni conversazionali.
Per esempio, potremmo usare Llama 3.3 per creare un chatbot di assistenza clienti che risponda alle richieste in più lingue, il tutto girando in modo efficiente su una singola GPU.
2. Supporto al coding e sviluppo software
Con punteggi elevati in benchmark di programmazione come HumanEval e MBPP EvalPlus, Llama 3.3 è un assistente affidabile per generare codice, fare debug o completare script parzialmente scritti.
Ciò che troviamo particolarmente prezioso è quanto bene funzioni su hardware personale. Invece di affidarti a costosi sistemi cloud, puoi eseguire Llama 3.3 in locale per automatizzare compiti ripetitivi, generare boilerplate o creare test unitari. Per team o sviluppatori singoli, questo rende il supporto avanzato all'AI per il coding sia pratico sia conveniente.
3. Generazione di dati sintetici
Un'altra area in cui Llama 3.3 eccelle è la generazione di dataset sintetici. Che tu stia costruendo un chatbot, addestrando un classificatore o lavorando a un progetto NLP, la capacità di generare dati etichettati di alta qualità può far risparmiare tempo e fatica significativi.
Riteniamo che questo caso d'uso sia particolarmente prezioso per i team più piccoli che hanno bisogno di dati specifici di dominio ma non hanno risorse per raccoglierli manualmente. Poiché Llama 3.3 gira su hardware di livello sviluppatore, puoi generare dati in locale, riducendo i costi e semplificando il flusso di lavoro.
4. Creazione di contenuti multilingue e localizzazione
Le capacità multilingue di Llama 3.3 lo rendono anche un ottimo candidato per la creazione di contenuti. Ne vediamo il potenziale nella produzione di materiali di marketing localizzati, nella traduzione di documenti tecnici o nella creazione di blog multilingue. Gli sviluppatori possono fare fine-tuning del modello per adattarne tono o stile, assicurando che l'output corrisponda al pubblico di riferimento.
Per esempio, potresti usare Llama 3.3 per redigere una descrizione prodotto in più lingue, migliorando il processo di localizzazione senza bisogno di un team dedicato di traduttori.
5. Ricerca e sperimentazione
Per i ricercatori, Llama 3.3 fornisce una solida piattaforma per esplorare il language modeling, l'allineamento o le tecniche di fine-tuning. Ciò che lo rende particolarmente interessante è l'efficienza: non serve accedere a massicce infrastrutture cloud per sperimentare con l'IA avanzata.
È quindi un ottimo strumento per progetti accademici o ricerca industriale, soprattutto quando si esplorano aree come l'allineamento alla sicurezza o l'addestramento di modelli più piccoli e specializzati tramite distillazione.
6. Applicazioni basate sulla conoscenza
Le forti capacità di elaborazione del testo di Llama 3.3 si prestano anche ad applicazioni come question answering, sintesi e generazione di report. Questi compiti spesso richiedono la gestione efficiente di grandi volumi di testo, qualcosa che Llama 3.3 può gestire bene anche su hardware personale.
Per esempio, potremmo usarlo per riassumere automaticamente il feedback dei clienti o generare documentazione interna, risparmiando tempo senza perdere in accuratezza.
7. Distribuzione flessibile per piccoli team
Infine, pensiamo che Llama 3.3 sia una grande opzione per startup, sviluppatori singoli o piccoli team che desiderano capacità di IA avanzate senza i costi di un'infrastruttura enterprise. La possibilità di eseguirlo su server locali o anche su una singola workstation lo rende una soluzione pratica per sistemi di produzione leggeri.
Come accedere a Llama 3.3
Meta fornisce accesso a Llama 3.3 tramite il loro sito dedicato: Llama Downloads. Qui trovi i link alla scheda del modello ufficiale, ai dettagli sulla licenza e ad altra documentazione per iniziare.
Per una guida approfondita, ti consigliamo di esplorare le risorse ufficiali:
- Scheda del modello e istruzioni d'uso su GitHub: Repository Meta su GitHub.
- Pagina del modello su Hugging Face: Llama 3.3-70B su Hugging Face.
Queste piattaforme offrono documentazione dettagliata e forum della community dove puoi fare domande o risolvere problemi.
Prezzi di Llama 3.3
Dal nostro punto di vista, questo schema di prezzi rende Llama 3.3 particolarmente interessante per sviluppatori con budget limitati o per progetti in scala con alta domanda di token. Che tu lo esegua in locale o tramite una piattaforma, queste tariffe competitive assicurano che un'IA di alta qualità sia accessibile senza spendere una fortuna.
Costi dei token in input
Per l'elaborazione di 1 milione di token in input, Llama 3.3 costa $0,1, in linea con il suo predecessore, Llama 3.1 70B. Rispetto ad altri modelli, è una delle tariffe più basse:
- Amazon Nova Pro addebita $0,80, risultando otto volte più costoso per lo stesso volume.
- GPT-4o e Claude 3.5 Sonnet costano rispettivamente $2,5 e $3,0, posizionandosi significativamente sopra Llama 3.3.
Questo basso costo in input rende Llama 3.3 particolarmente adatto ad applicazioni che richiedono l'elaborazione di grandi quantità di testo, come chatbot o strumenti di analisi testuale.
Costi dei token in output
Per 1 milione di token in output, Llama 3.3 costa $0,4, ancora una volta in linea con il costo di Llama 3.1 70B. Ecco il confronto:
- Amazon Nova Pro costa $1,8, oltre quattro volte più di Llama 3.3.
- GPT-4o addebita $10,0 e Claude 3.5 Sonnet $15,0, rendendo Llama 3.3 un'opzione economica con ampio margine.
Per applicazioni che generano grandi volumi di testo, come la creazione di dati sintetici o di contenuti, Llama 3.3 offre risparmi significativi.
Conclusione
Consideriamo Llama 3.3 un esempio convincente di come i large language model possano bilanciare capacità e accessibilità.
Come modello da 70 miliardi di parametri, offre prestazioni paragonabili al molto più grande Llama 3.1 405B ma con requisiti computazionali molto inferiori.
Per gli sviluppatori senza accesso a hardware di livello enterprise, questo modello rappresenta un modo pratico per integrare un'IA di alta qualità nei propri flussi di lavoro.
FAQ
In cosa Llama 3.3 è diverso da Llama 3.2?
Llama 3.3 migliora Llama 3.2 con un fine-tuning più efficace (SFT e RLHF), funzionalità di sicurezza ampliate, supporto multilingue (8 lingue), una finestra di contesto più lunga (128k token) e prestazioni migliori nei benchmark. Aggiunge anche capacità di uso di strumenti, maggiore efficienza energetica e un solido framework di AI responsabile, rendendolo più potente e versatile.
In cosa Llama 3.3 è diverso da Llama 405B?
Llama 3.3 offre prestazioni paragonabili a Llama 3.1 405B ma è significativamente più efficiente, richiedendo molta meno potenza computazionale per l'esecuzione.
Quali lingue supporta Llama 3.3?
Llama 3.3 supporta nativamente inglese, francese, tedesco, hindi, italiano, portoghese, spagnolo e thai. Gli sviluppatori possono effettuare fine-tuning per altre lingue, ma sono necessarie ulteriori misure di sicurezza.
In quali benchmark Llama 3.3 eccelle?
Llama 3.3 raggiunge punteggi elevati in benchmark come MMLU, HumanEval e MGSM, superando molti altri modelli in categorie come ragionamento, coding e capacità multilingue.
Llama 3.3 può girare su hardware standard per sviluppatori?
Sì, Llama 3.3 è progettato per girare su GPU comuni e workstation di livello sviluppatore, rendendolo accessibile a chi non dispone di infrastrutture enterprise.
Sono un editor e autore che si occupa di blog, tutorial e notizie sull’IA, assicurandomi che tutto rientri in una solida strategia di contenuti e nelle best practice SEO. Ho scritto corsi di data science su Python, statistica, probabilità e visualizzazione dei dati. Ho anche pubblicato un romanzo premiato e nel tempo libero mi dedico alla sceneggiatura e alla regia.

Sono uno scrittore e editor di data science, con contributi a articoli di ricerca su riviste scientifiche. Sono particolarmente interessato ad algebra lineare, statistica, R e affini. Inoltre, gioco anche parecchio a scacchi!



