
{count, plural, one {Corso} other {Corsi}}
Retrieval Augmented Generation (RAG) con LangChain
{hours} ore
21K
PageIndex è un framework di retrieval che ragionas sulla struttura di un documento invece di cercare testo simile alla tua query. È stato rilasciato da VectifyAI a settembre 2025, creato da Mingtian Zhang e Yu Tang. È open source sotto licenza MIT e, a luglio 2026, il repository GitHub ha accumulato oltre 34.000 stelle.
Il modo migliore per spiegare come funziona PageIndex è metterlo a confronto con il RAG standard. Se sei alle prime armi con il RAG, l'idea di base è dare a un LLM accesso a un documento recuperando le parti rilevanti al momento della query e passandole come contesto.
Il passaggio di retrieval è proprio ciò che PageIndex reimmagina. Invece di confrontare la tua query con ogni chunk del documento, PageIndex costruisce prima un indice ad albero gerarchico a partire dalla struttura del documento. Questo porta a risultati diversi:
In altre parole, la differenza tra RAG standard e PageIndex è quella tra scansionare ogni pagina di un libro alla ricerca di parole chiave e leggere prima l’indice per trovare il capitolo giusto.
Questi due obiettivi convergono per query fattuali semplici su documenti brevi, ma divergono nettamente quando i documenti diventano lunghi, strutturati e pieni di riferimenti interni.
Il processo si svolge in due fasi.
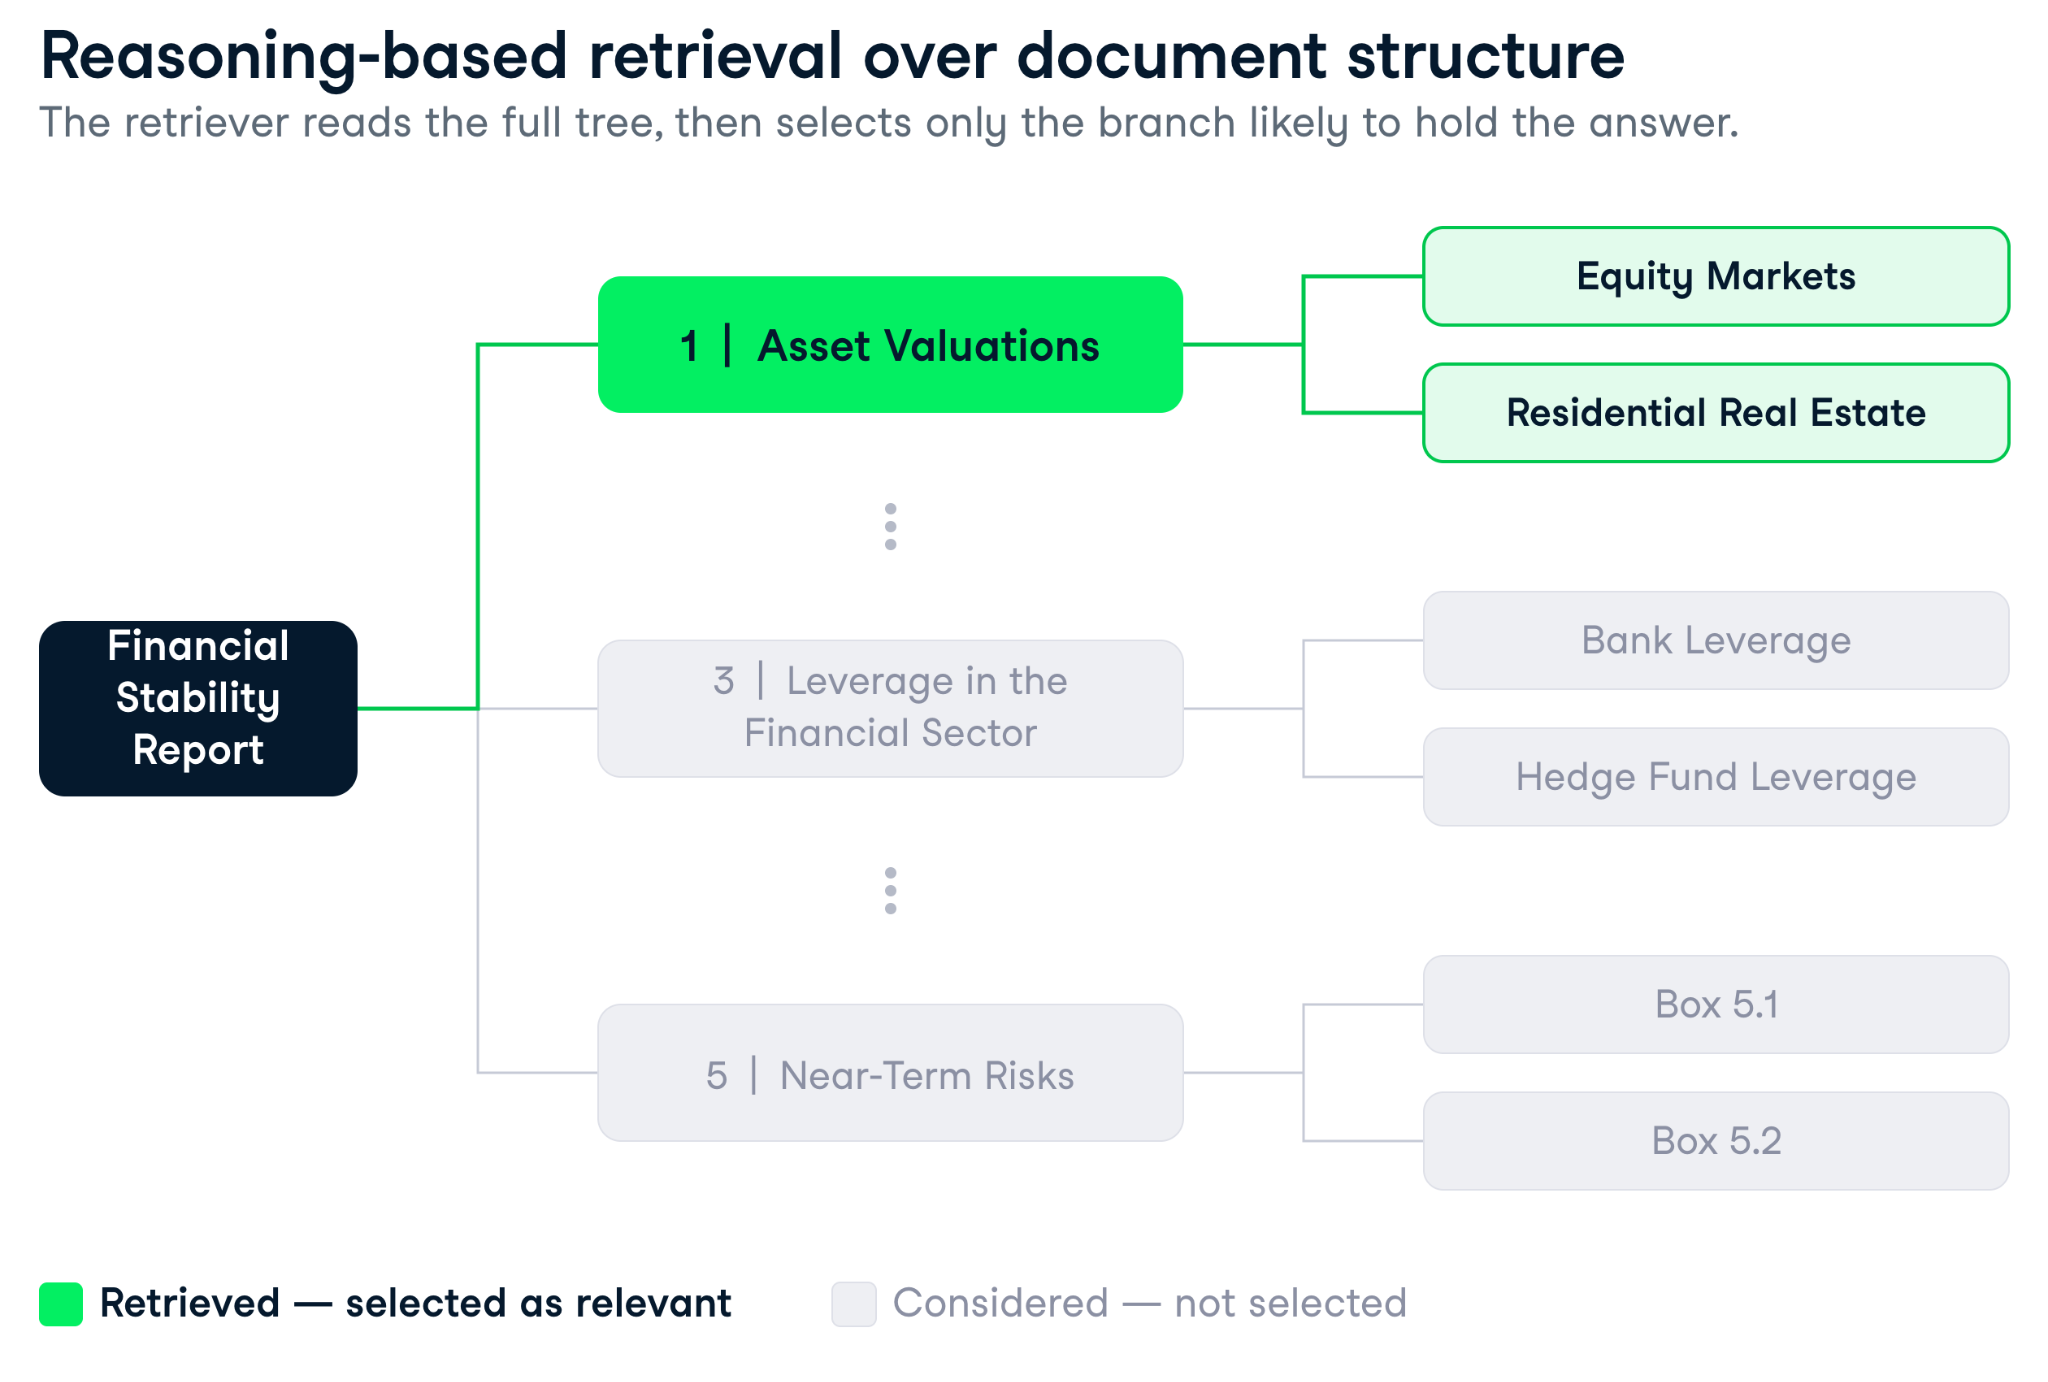
Ho costruito abbastanza pipeline RAG da sapere che il chunking è dove la maggior parte dei sistemi in produzione fallisce in silenzio. La strategia è pulita sulla carta, ma nel momento in cui il tuo documento ha una tabella che attraversa i margini di pagina, o una nota a piè di pagina che definisce un termine usato tre sezioni prima, emergono le crepe.
Il RAG a vettori ha tre debolezze strutturali che ricorrono costantemente su documenti finanziari e legali.
PageIndex gestisce tutti e tre i casi perché recupera in base alla struttura e non a frammenti. L’albero mantiene integro il documento, il passaggio di ragionamento può seguire un riferimento incrociato o confrontare sezioni, e poiché ogni nodo ha un indice di pagina e un riepilogo, il retriever naviga la “geografia” del documento invece della somiglianza superficiale del testo.
Sarò onesto: quando ho visto per la prima volta l'affermazione del 98,7% di accuratezza per Mafin 2.5 (il sistema basato su PageIndex di VectifyAI) su FinanceBench, il mio istinto è stato lo scetticismo, perché un divario di quasi 50 punti rispetto al RAG standard sembra un benchmark scelto per fare bella figura. Ma FinanceBench testa proprio questi casi limite: ragionamento multi‑step su filing SEC con risposte numeriche precise.
Questo tutorial richiede alcuni pacchetti e due chiavi API. Ecco tutto ciò che ti serve prima di scrivere una riga di codice.
Puoi consultare tutto il codice usato nel tutorial nel mio repo GitHub di accompagnamento.
Per seguire questo tutorial, ti serviranno:
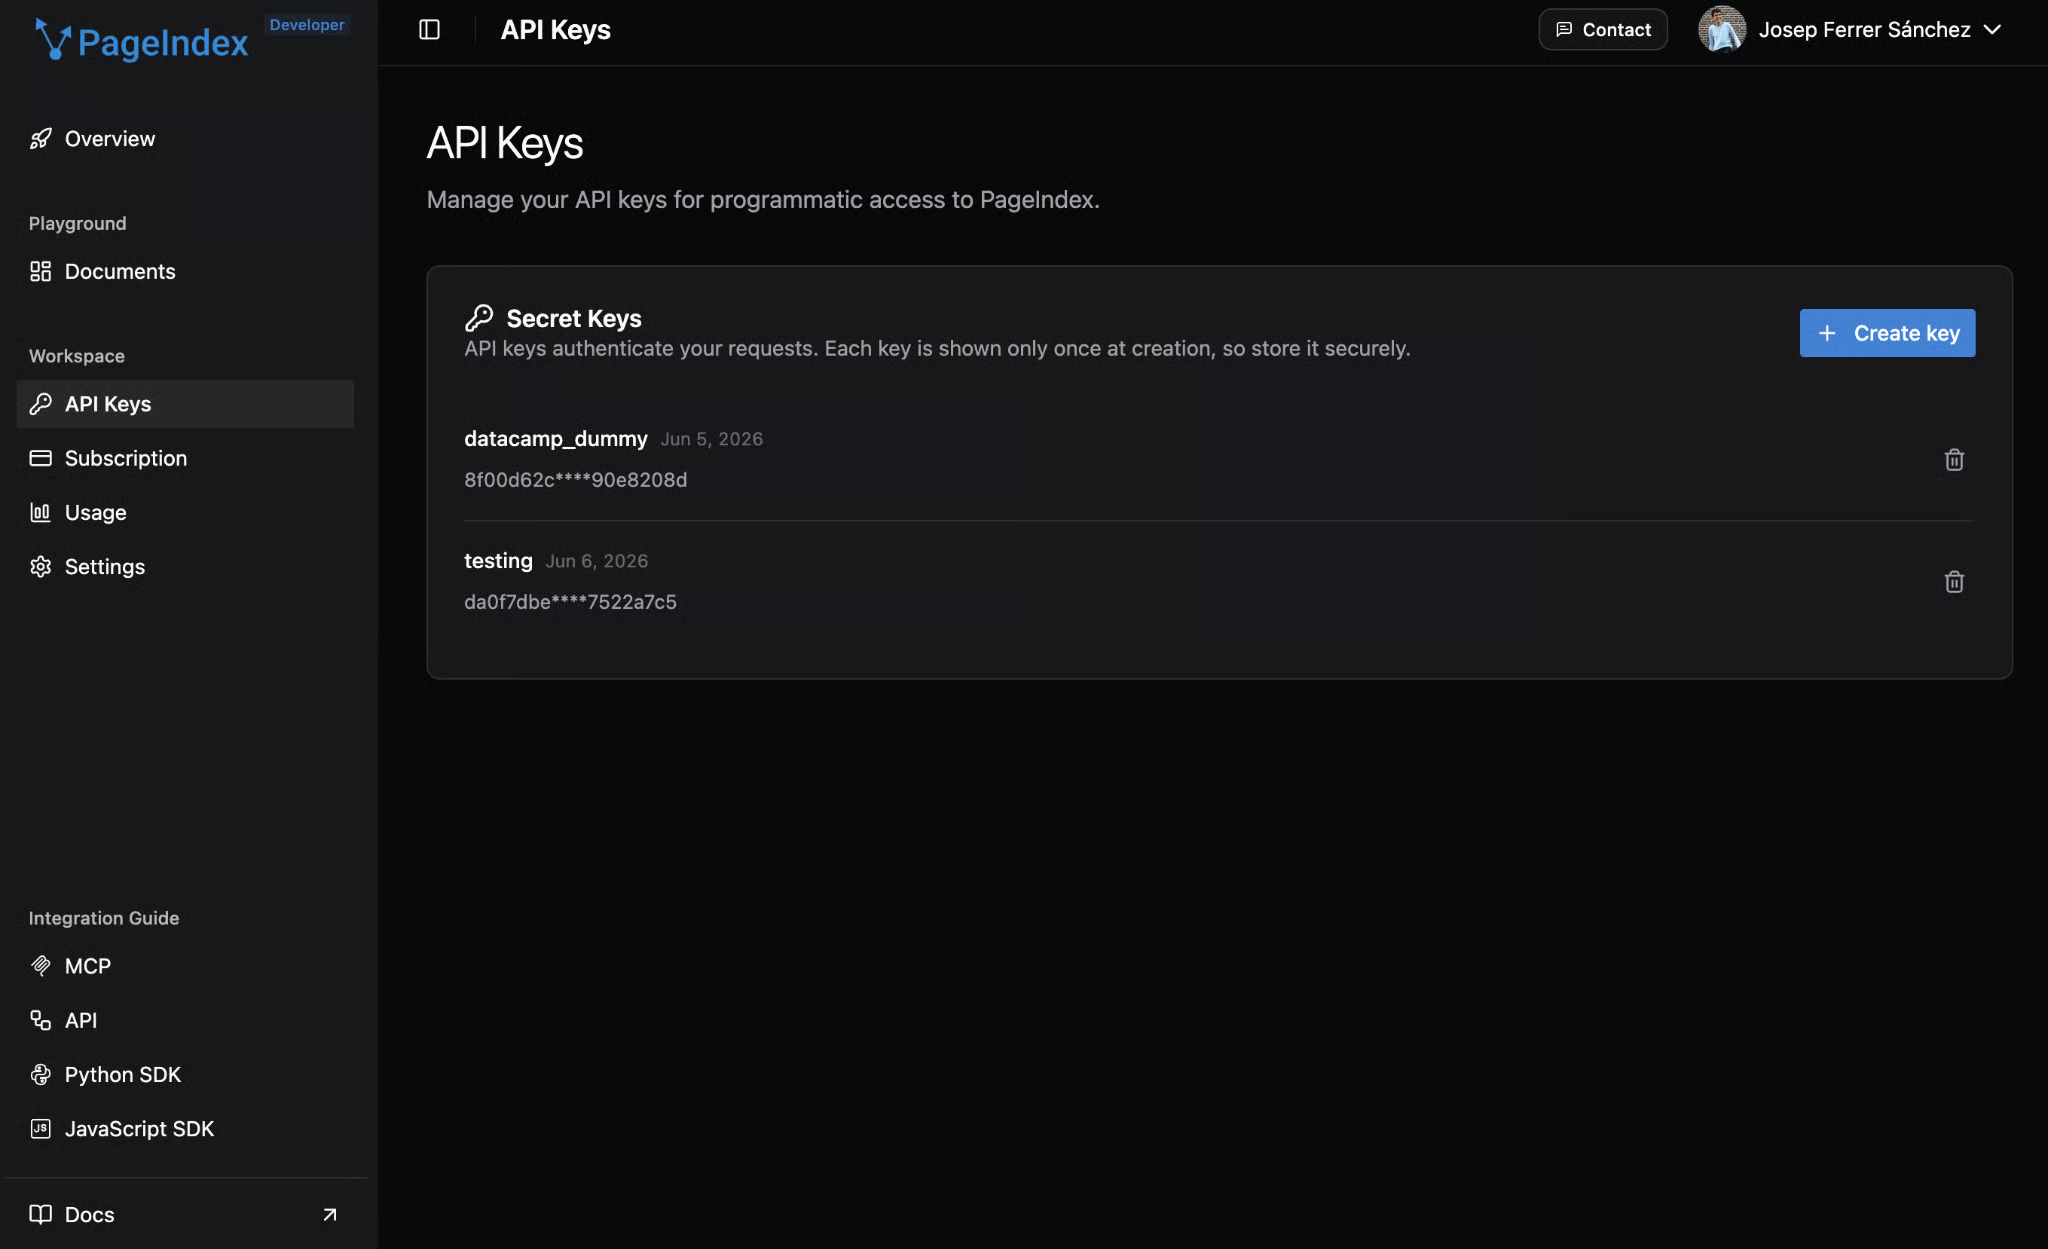
Installa i pacchetti richiesti:
pip install pageindex openai requests faiss-cpu pymupdfImposta le chiavi API come variabili d’ambiente invece di inserirle nel codice:
export PAGEINDEX_API_KEY="your_pageindex_key_here"
export OPENAI_API_KEY="your_openai_key_here"
Con entrambe le chiavi impostate, inizializza i client:
import os
import copy
import time
import json
import asyncio
import requests
from pageindex import PageIndexClient
import pageindex.utils as utils
import openai

PAGEINDEX_API_KEY = os.environ["PAGEINDEX_API_KEY"]
OPENAI_API_KEY = os.environ["OPENAI_API_KEY"]

pi_client = PageIndexClient(api_key=PAGEINDEX_API_KEY)
openai_client = openai.AsyncOpenAI(api_key=OPENAI_API_KEY)
Questo è tutto il setup: nove import, due variabili d’ambiente, due client.
Per questo tutorial useremo il Financial Stability Report di ottobre 2023 della Federal Reserve. È un PDF pubblico strutturato come un vero documento di produzione: sezioni formali, capitoli numerati, appendici e riferimenti interni.
La Fed pubblica i propri report come PDF accessibili a un URL stabile. Il controllo if not os.path.exists() significa che lo scarichi solo una volta, cosa utile quando iteri sul resto del codice e non vuoi riscaricare un PDF di 60 pagine a ogni esecuzione.
DOWNLOAD_DIR = "./data"
os.makedirs(DOWNLOAD_DIR, exist_ok=True)

PDF_URL = "https://www.federalreserve.gov/publications/files/financial-stability-report-20231020.pdf"
PDF_PATH = os.path.join(DOWNLOAD_DIR, "fed_financial_stability_report_2023.pdf")

if not os.path.exists(PDF_PATH):
    print("Downloading Federal Reserve Financial Stability Report (Oct 2023)...")
    response = requests.get(PDF_URL, timeout=60)
    response.raise_for_status()
    with open(PDF_PATH, "wb") as f:
        f.write(response.content)
    print(f"Saved to {PDF_PATH}")
else:
print(f"Already present: {PDF_PATH}")L’invio è una singola chiamata API. submit_document() carica il file e restituisce un doc_id da usare per ogni operazione successiva su questo documento. Salvalo da qualche parte, perché se riavvii la sessione puoi saltare l’invio e andare direttamente a get_tree() usando lo stesso ID.
print("Submitting document to PageIndex...")
submit_result = pi_client.submit_document(PDF_PATH)
doc_id = submit_result["doc_id"]
print(f"Document ID: {doc_id}")
PageIndex elabora il documento in modo asincrono, quindi devi effettuare il polling finché l’albero non è pronto:
print("Waiting for tree generation...")
while True:
    status_result = pi_client.get_document(doc_id)
    status = status_result.get("status")
    print(f"  Status: {status}")
    if status == "completed":
        break
    elif status == "failed":
        raise RuntimeError(f"Processing failed: {status_result}")
    time.sleep(10)

print("Done.")
Elaborare un PDF da 60 pagine richiede in genere da due a quattro minuti, e questo costo si paga una sola volta per documento. Vedrai lo stato passare da queued → processing → completed.
Submitting document to PageIndex...
Document ID: pi-cmq2bp4ok00rx01qxmym7tnd1

Waiting for tree generation...
  Status: queued
  Status: processing
  Status: completed
Processing done.Una volta completata l’elaborazione, get_tree() restituisce la struttura gerarchica completa come elenco annidato di nodi. L’helper utils.create_node_mapping() poi la appiattisce in un semplice dizionario indicizzato per ID nodo, rendendo l’estrazione del testo molto più veloce che attraversare l’albero ricorsivamente a ogni query.
tree_result = pi_client.get_tree(doc_id, node_summary=True)
tree = tree_result["result"]

# Build a flat node map for easy access later
node_map = utils.create_node_mapping(tree)

# Print the top-level nodes
print(f"\nTop-level nodes ({len(tree)} sections):\n")
for node in tree:
    print(f"  [{node['node_id']}] {node['title']}")
    print(f"       Page {node['page_index']}")
    print(f"       {node['summary'][:120]}...")
    print()
Eseguendo questo sul Financial Stability Report ottieni a colpo d’occhio lo scheletro del documento:
Top-level nodes (9 sections):

  [0000] Financial Stability Report
       Page 1
       This document is the October 2023 Financial Stability Report from the Federal Reserve...
  [0001] Purpose and Framework
       Page 5
       This report outlines the Federal Reserve's framework for assessing U.S. financial stability...
  [0002] Overview
       Page 9
       This report evaluates the stability of the U.S. financial system by analyzing four key vulnerability areas...
  [0003] 1 | Asset Valuations
       Page 13
       ...
  [0012] 2 | Borrowing by Businesses and Households
       Page 23
       ...
  [0019] 3 | Leverage in the Financial Sector
       Page 33
       ...
  [0029] 4 | Funding Risks
       Page 45
       ...
  [0036] 5 | Near-Term Risks to the Financial System
       Page 53
       ...
  [0041] Appendix | Figure Notes
       Page 59
       …
L’albero è semplice JSON, con ogni nodo che contiene un node_id, un title, un summary, un page_index e un elenco nodes per le eventuali sottosezioni. A differenza degli indici vettoriali, non c’è uno spazio di embedding opaco o un file di indice binario che richiede un lettore speciale. È solo un elenco annidato che puoi stampare, ispezionare e su cui puoi ragionare direttamente.
Questa trasparenza è molto utile in pratica: se il retriever restituisce la sezione sbagliata, puoi guardare l’albero e capire perché, cosa che semplicemente non puoi fare con un embedding a 768 dimensioni.
Il passaggio di retrieval invia la struttura dell’albero (senza il testo completo, che saturerebbe la finestra di contesto) a un LLM e gli chiede di identificare quali nodi sono rilevanti per la query.
Il prompt passa l’albero snello (solo titoli e riepiloghi, senza il testo completo) all’LLM e gli chiede di restituire un oggetto JSON con una traccia di ragionamento e un elenco di ID nodo. Due scelte progettuali qui sono degne di nota.
Primo, utils.remove_fields() rimuove il contenuto effettivo da ciascun nodo prima della serializzazione, mantenendo il prompt ben entro i limiti di contesto anche su documenti lunghi. La chiamata a copy.deepcopy() è necessaria perché remove_fields muta in place e ti serve l’albero originale intatto per l’estrazione testo successiva.
Secondo, response_format={"type": "json_object"} impone un output strutturato, così il parsing è affidabile e non fragile. La temperature resta a 0 perché è un compito di ragionamento.
TREE_SEARCH_PROMPT = """You are a document retrieval assistant.
Given a document's tree structure and a user query, identify which nodes (sections)
are most likely to contain the answer.

Document tree:
{tree_json}

User query: {query}

Return a JSON object with the following format:
{{
  "reasoning": "Your step-by-step reasoning about which sections to retrieve",
  "node_ids": ["id1", "id2", ...]
}}

Return ONLY the JSON object, no other text."""

async def tree_search(tree, query: str, model: str = "gpt-4o") -> dict:
    """Use an LLM to reason over the tree and return relevant node IDs."""

    # remove_fields mutates in place; deepcopy protects the original tree
    slim_tree = utils.remove_fields(copy.deepcopy(tree), fields=["text"])
    tree_json = json.dumps(slim_tree, indent=2)

    prompt = TREE_SEARCH_PROMPT.format(tree_json=tree_json, query=query)

    response = await openai_client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        response_format={"type": "json_object"}
    )

    result = json.loads(response.choices[0].message.content)
    return result
Nota: le chiamate await qui sotto assumono un ambiente Jupyter o iPython in cui il await top‑level è supportato. Se esegui questo come script .py semplice, incapsula le chiamate async in una funzione async def main() e richiamala con asyncio.run(main()).
Parti da una domanda che richiede di navigare tra più sezioni. Una query sulle vulnerabilità nelle valutazioni degli asset ha bisogno del materiale dall’overview, dal capitolo sulle valutazioni e dalle sottosezioni sui singoli mercati.
Sono sezioni che il RAG a vettori può far emergere singolarmente, ma raramente insieme e con la gerarchia corretta. È esattamente il tipo di query in cui la ricerca su albero fa la differenza.
query_1 = "What are the main vulnerabilities the Fed identified in asset valuations as of October 2023, and which markets were flagged as stretched?"

result = await tree_search(tree, query_1)

print("LLM Reasoning:")
print(result["reasoning"])
print("\nSelected node IDs:", result["node_ids"])
La traccia di ragionamento è la parte a cui prestare più attenzione. Ecco come appare tipicamente un output:
LLM Reasoning:
To identify the main vulnerabilities in asset valuations as of October 2023,
we should focus on sections that specifically discuss asset valuations and
related market conditions. The '1 | Asset Valuations' section and its
subsections are directly relevant as they provide detailed insights into
asset valuation pressures, equity market conditions, and specific market
sectors flagged as stretched.

Selected node IDs: ['0003', '0004', '0006', '0009', '0010', '0011']
Puoi vedere esattamente perché ogni sezione è stata selezionata, un livello di tracciabilità che non ottieni da un ranking per similarità coseno.
Una volta che hai gli ID dei nodi rilevanti, il passo successivo è estrarre il testo corrispondente e passarlo a un modello di generazione.
Due funzioni gestiscono la fase di generazione.
generate_answer() cerca ciascun nodo selezionato nel node_map, premette un’intestazione con titolo della sezione e indice di pagina (è ciò che ti dà citazioni verificabili nella risposta finale) e passa il contesto assemblato a un modello di generazione.
pageindex_pipeline() incapsula ricerca su albero e generazione in una singola chiamata, così non devi concatenarle manualmente ogni volta.
ANSWER_PROMPT = """You are a financial document analyst. Answer the user's question
using ONLY the provided context. Cite the specific section(s) you are drawing from.
If the context does not contain enough information to answer, say so clearly.

Context:
{context}

Question: {question}

Provide a precise, well-cited answer."""

async def generate_answer(node_ids: list, query: str, node_map: dict,
                          model: str = "gpt-4o") -> str:
    """Extract text from the selected nodes and generate an answer."""

    # Gather the text from each selected node
    context_parts = []
    for node_id in node_ids:
        node = node_map.get(node_id)
        if node:
            section_header = f"[{node['title']} | Page {node['page_index']}]"
            context_parts.append(f"{section_header}\n{node.get('text', '')}")

    context = "\n\n---\n\n".join(context_parts)
    prompt = ANSWER_PROMPT.format(context=context, question=query)

    response = await openai_client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0
    )

    return response.choices[0].message.content

async def pageindex_pipeline(tree, query: str, node_map: dict) -> dict:
    """Full PageIndex pipeline: tree search + answer generation."""
    search_result = await tree_search(tree, query)
    node_ids = search_result["node_ids"]
    reasoning = search_result["reasoning"]
    answer = await generate_answer(node_ids, query, node_map)
    return {
        "query": query,
        "reasoning": reasoning,
        "retrieved_sections": node_ids,
        "answer": answer
    }
Esegui la pipeline completa:
result = await pageindex_pipeline(tree, query_1, node_map)

print(f"Query: {result['query']}\n")
print(f"Retrieved sections: {result['retrieved_sections']}\n")
print(f"Answer:\n{result['answer']}")
La risposta arriva con citazioni a livello di sezione e numeri di pagina. È la tracciabilità che PageIndex ti offre di default.
Query: What are the main vulnerabilities the Fed identified in asset valuations
as of October 2023, and which markets were flagged as stretched?

Retrieved sections: ['0003', '0004', '0006', '0009', '0010', '0011']

Answer:
The main vulnerabilities identified by the Fed in asset valuations as of
October 2023 include:

1. Equity Markets: Valuations increased modestly from an already high level,
with the forward price-to-earnings ratio rising further above its historical
median (Page 13, "Equity market valuation pressures remained notable").

2. Residential Real Estate: House prices started increasing again, and the
price-to-rent ratio was close to its previous peak from the mid-2000s
(Page 20, "House prices started increasing again in recent months").

3. Commercial Real Estate: Despite recent price declines, valuations remained
elevated relative to rental income (Page 19, "Commercial real estate
valuations remained elevated").

4. Farmland: Prices near the peak of their historical distribution, driven
by strong agricultural commodity prices (Page 21, "Farmland valuations
remained elevated").Questa è la sezione che ti dice davvero qualcosa di utile. Costruiamo un baseline RAG a vettori sullo stesso documento ed eseguiamo entrambe le pipeline sulle stesse query.
Il baseline segue lo schema standard: estrai il testo grezzo dal PDF con PyMuPDF, dividilo in chunk sovrapposti da 500 parole, incorpora ogni chunk con text-embedding-3-small e carica tutto in un indice FAISS in memoria per il lookup via similarità coseno.
Se vuoi più contesto su come la scelta di dimensione e overlap dei chunk influisca sulla qualità del retrieval, il nostro articolo Chunking Strategies vale la pena di essere letto in parallelo, e l’explainer What Is FAISS? è anche utile se i passaggi di costruzione dell’indice non ti sono familiari.
from openai import OpenAI
import numpy as np
import faiss

sync_openai = OpenAI(api_key=OPENAI_API_KEY)

def extract_text_from_pdf(pdf_path: str) -> str:
    """Extract raw text from a PDF using PyMuPDF."""
    import fitz  # pip install pymupdf
    doc = fitz.open(pdf_path)
    pages = []
    for page_num, page in enumerate(doc):
        text = page.get_text()
        if text.strip():
            pages.append(f"[Page {page_num + 1}]\n{text}")
    return "\n\n".join(pages)


def chunk_text(text: str, chunk_size: int = 500, overlap: int = 50) -> list[str]:
    """Split text into overlapping chunks by word count."""
    words = text.split()
    chunks = []
    start = 0
    while start < len(words):
        end = min(start + chunk_size, len(words))
        chunks.append(" ".join(words[start:end]))
        start += chunk_size - overlap
    return chunks


def embed_chunks(chunks: list[str], model: str = "text-embedding-3-small") -> np.ndarray:
    """Embed a list of text chunks with the OpenAI embeddings API."""
    all_embeddings = []
    batch_size = 100
    for i in range(0, len(chunks), batch_size):
        batch = chunks[i : i + batch_size]
        response = sync_openai.embeddings.create(input=batch, model=model)
        batch_embeddings = [item.embedding for item in response.data]
        all_embeddings.extend(batch_embeddings)
    return np.array(all_embeddings, dtype="float32")


def build_faiss_index(embeddings: np.ndarray) -> faiss.IndexFlatIP:
    """Build an in-memory FAISS index for inner-product (cosine) search."""
    dim = embeddings.shape[1]
    faiss.normalize_L2(embeddings)
    index = faiss.IndexFlatIP(dim)
    index.add(embeddings)
    return index


def vector_rag_pipeline(query: str, chunks: list[str], index: faiss.IndexFlatIP,
                         k: int = 5, model: str = "gpt-4o") -> str:
    """Full vector RAG pipeline: embed query, retrieve top-k, generate answer."""

    # Embed the query
    query_embedding = sync_openai.embeddings.create(
        input=[query], model="text-embedding-3-small"
    ).data[0].embedding
    query_vec = np.array([query_embedding], dtype="float32")
    faiss.normalize_L2(query_vec)

    # Retrieve top-k chunks
    _, indices = index.search(query_vec, k)
    retrieved_chunks = [chunks[i] for i in indices[0] if i < len(chunks)]
    context = "\n\n---\n\n".join(retrieved_chunks)

    # Generate answer
    response = sync_openai.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "Answer the question using only the provided context. Be precise."},
            {"role": "user", "content": f"Context:\n{context}\n\nQuestion: {query}"}
        ],
        temperature=0
    )
    return response.choices[0].message.content
Con le funzioni di supporto definite, costruisci l’indice. Su un documento di 60 pagine, la fase di embedding è la più lenta: prevedi un minuto o due, a seconda della connessione e della capacità di OpenAI.
print("Extracting text from PDF...")
raw_text = extract_text_from_pdf(PDF_PATH)

print("Chunking text...")
chunks = chunk_text(raw_text, chunk_size=500, overlap=50)
print(f"  {len(chunks)} chunks created")

print("Embedding chunks...")
embeddings = embed_chunks(chunks)
print(f"  Embeddings shape: {embeddings.shape}")

print("Building FAISS index...")
faiss_index = build_faiss_index(embeddings)
print("Done.\n")Un report di 60 pagine produce circa 47 chunk a 500 parole con sovrapposizione di 50 parole.
Extracting text from PDF...
Chunking text...
  47 chunks created
Embedding chunks (takes 1-2 min)...
  Embeddings shape: (47, 1536)
Building FAISS index...
Done.
Tre query, ciascuna progettata per mettere in luce una diversa sfida di retrieval:
queries = [
    # Direct factual lookup
    "What does the Fed consider the most significant near-term risk to financial stability as of October 2023?",

    # Cross-reference question (Box 5.2 is referenced from Section 5, requires following an internal pointer)
    "What methodology does the Fed use to assess climate-related financial risks, and where in the report is it described?",

    # Multi-section reasoning (requires connecting Section 1 and Section 3)
    "How do elevated asset valuations interact with leverage in the financial sector to amplify systemic risk, according to the report?"
]
Con entrambe le pipeline pronte, il ciclo seguente invia ogni query a entrambi i sistemi e ne raccoglie i risultati. Lo slice [:500] su ogni risposta serve solo a mantenere leggibile l’output in console; le risposte complete vengono salvate in results per ispezioni successive.
results = []

for query in queries:
    print(f"\nQuery: {query}\n")

    # PageIndex
    pi_result = await pageindex_pipeline(tree, query, node_map)
    pi_answer = pi_result["answer"]

    # Vector RAG
    vec_answer = vector_rag_pipeline(query, chunks, faiss_index)

    results.append({
        "query": query,
        "pageindex_answer": pi_answer,
        "vector_rag_answer": vec_answer
    })

    print("PageIndex answer:")
    print(pi_answer[:500])
    print("\nVector RAG answer:")
    print(vec_answer[:500])
print("\n" + "="*60)Ecco il tipo di risultato che vedrai sui tre tipi di query:
|
Query |
PageIndex |
RAG a vettori |
Risposta corretta |
Vincitore |
|
Rischio più significativo a breve termine |
Risposta ampia che copre più rischi con citazioni di sezione |
Ha fatto emergere il dato specifico del 72% (più preciso in questo caso) |
Inflazione persistente e politica monetaria più restrittiva, citate dal 72% dei partecipanti al sondaggio (Riquadro 5.1) |
Pareggio, leggero vantaggio al RAG a vettori sulla statistica specifica |
|
Metodologia sul rischio climatico (riferimento incrociato) |
Ha recuperato la Sezione, ma ha selezionato il nodo padre invece del Riquadro 5.2, quindi il testo metodologico non è arrivato alla generazione |
Ha eseguito il chunking attraverso il Riquadro 5.2 restituendo i passi metodologici |
Il Riquadro 5.2 descrive la traduzione dei rischi fisici e di transizione in esposizioni finanziarie tramite analisi di scenario |
RAG a vettori |
|
Interazione valutazioni asset + leva |
Ha recuperato 18 nodi tra Sezioni 1 e 3 e spiegato il meccanismo di amplificazione |
Ha collegato le due sezioni e spiegato il meccanismo di amplificazione |
Valutazioni elevate aumentano il rischio di correzioni brusche; la leva amplifica le perdite quando le correzioni colpiscono istituzioni indebitate (Sezioni 1 e 3) |
Pareggio |
I risultati sono più sottili di una vittoria netta per uno dei due sistemi, il che li rende più utili.
PageIndex ha navigato verso le sezioni giuste in tutti e tre i casi. Sulla query fattuale diretta, entrambi hanno risposto correttamente, anche se il RAG a vettori ha fatto emergere il dato specifico del 72% perché il suo chunking piatto ha catturato intatto il Riquadro 5.1: più fortuna di chunking che vantaggio strutturale. Sulla query multi‑sezione, PageIndex ha recuperato 18 nodi tra Sezioni 1 e 3 e ha spiegato l’interazione, allineandosi grosso modo al RAG a vettori. L’unica sconfitta netta è stata la query sui riferimenti incrociati, e vale la pena capirne il motivo.
Sulla query sulla metodologia climatica, PageIndex ha ragionato fino alla Sezione 5 e all’Overview, ma la metodologia è nel Riquadro 5.2, un nodo figlio distinto sotto la Sezione 5. La ricerca su albero ha selezionato la sezione padre, non il riquadro, e il testo della sezione padre fa riferimento al riquadro senza riprodurlo, quindi la fase di generazione non ha visto la metodologia. Il RAG a vettori ha vinto perché ha eseguito il chunking direttamente attraverso il Riquadro 5.2.
Questo è un problema di granularità del retrieval, non un fallimento di ragionamento: selezionare un nodo padre non include il testo dei figli a meno che tu non espanda la selezione per includerli. Puoi colmare il gap istruendo la ricerca su albero a restituire i nodi figli di ogni sezione rilevante o espandendo ogni nodo selezionato per includere i discendenti prima della generazione.
Il vantaggio di PageIndex è emerso più chiaramente nell’esecuzione standalone vista prima (la query sulle valutazioni degli asset), dove ha ragionato correttamente sulla struttura del documento e ha restituito risposte ben citate e attribuite alle sezioni. Le query di confronto sopra sono state scelte apposta per stressare scenari di retrieval più impegnativi, motivo per cui favoriscono il RAG a vettori su un documento di 60 pagine.
La conclusione onesta: il vantaggio di PageIndex rispetto al RAG a vettori aumenta con la lunghezza del documento e la densità dei riferimenti interni. Su un report di 60 pagine, il divario è moderato. Su un 10‑K da 200 pagine con dozzine di note che si rimandano, aspettati che sia maggiore.
Se vuoi spingere oltre il baseline RAG a vettori prima di accantonarlo, How to Improve RAG Performance copre le cinque tecniche a maggior leva.
Il confronto sopra è specifico a un tipo e a una lunghezza di documento. Se PageIndex sia la scelta giusta dipende da tre fattori: struttura del documento, tipo di query e volume.
PageIndex ripaga il suo overhead su documenti professionali lunghi e strutturati dove una risposta sbagliata è costosa:
Sono anche i casi in cui le tracce di ragionamento ti danno qualcosa di concreto da verificare. Il punto di massima efficacia è il basso volume, alto impatto: qualche decina di documenti al giorno in cui ogni query deve essere corretta, e il premio in latenza e costo è giustificato.
Il RAG a vettori è la scelta predefinita migliore per workload ad alto throughput e bassa latenza, dove le chiamate multiple LLM per query di PageIndex diventano un collo di bottiglia e gli embedding in cache gestiscono il carico a una frazione del costo.
Si adatta anche a documenti piatti con poca gerarchia su cui ragionare, come:
È anche la scelta giusta nei casi in cui risposte approssimative sono sufficienti. Un chatbot di supporto che trova la FAQ giusta nove volte su dieci probabilmente raggiunge il suo obiettivo.
Il costo è velocità e denaro. Ogni query PageIndex esegue almeno due chiamate LLM (ricerca su albero e generazione della risposta) più l’elaborazione iniziale, quindi aspettati da tre a otto secondi per query su un documento di 60 pagine contro meno di un secondo per il RAG a vettori con un indice FAISS in cache, e il costo per query scala allo stesso modo.
Il Financial Stability Report è un caso di test corretto per PageIndex: strutturato, gerarchico, con riferimenti incrociati. Un corpus di migliaia di brevi ticket di supporto non lo è, e lì il RAG a vettori lo batte a una frazione del costo.
Il RAG a vettori ha un’ipotesi implicita: che il passaggio più simile alla tua query sia anche quello che contiene la risposta. Per documenti brevi e poco strutturati, l’ipotesi regge abbastanza. Per documenti professionali lunghi e strutturati, si rompe in modi prevedibili: tabelle spezzate, frequenze fuorvianti di termini e riferimenti incrociati invisibili.
PageIndex affronta tutti e tre i punti trattando il retrieval come un problema di ragionamento sulla struttura del documento, non come una ricerca per similarità su frammenti di testo.
La regola pratica è semplice: se i tuoi documenti hanno gerarchia, le tue query richiedono di seguire riferimenti interni e ottenere la risposta giusta conta più che averla in fretta, PageIndex vale l’extra in latenza e costo. Se esegui ricerche ad alto volume su documenti brevi o piatti, il RAG a vettori resta la scelta predefinita giusta.
Vuoi approfondire RAG in produzione e sistemi agentici? Il nostro percorso AI Engineering with LangChain ti porta dai fondamenti applicativi fino al retrieval, alla valutazione e agli agenti che usano strumenti.
Impara il RAG con DataCamp!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



