
Khóa học
Retrieval Augmented Generation (RAG) với LangChain
3 giờ
20.9K
PageIndex là một khung truy xuất suy luận dựa trên cấu trúc tài liệu thay vì tìm kiếm văn bản trông giống truy vấn của bạn. Nó được VectifyAI phát hành vào tháng 9 năm 2025, do Mingtian Zhang và Yu Tang xây dựng. Mã nguồn mở theo giấy phép MIT, và tính đến tháng 7 năm 2026, kho GitHub đã tích lũy hơn 34.000 sao.
Cách tốt nhất để giải thích PageIndex hoạt động ra sao là đối chiếu với RAG tiêu chuẩn. Nếu bạn mới biết về RAG, ý tưởng cơ bản là bạn cho một LLM truy cập vào tài liệu bằng cách truy xuất các phần liên quan tại thời điểm truy vấn và truyền chúng làm ngữ cảnh.
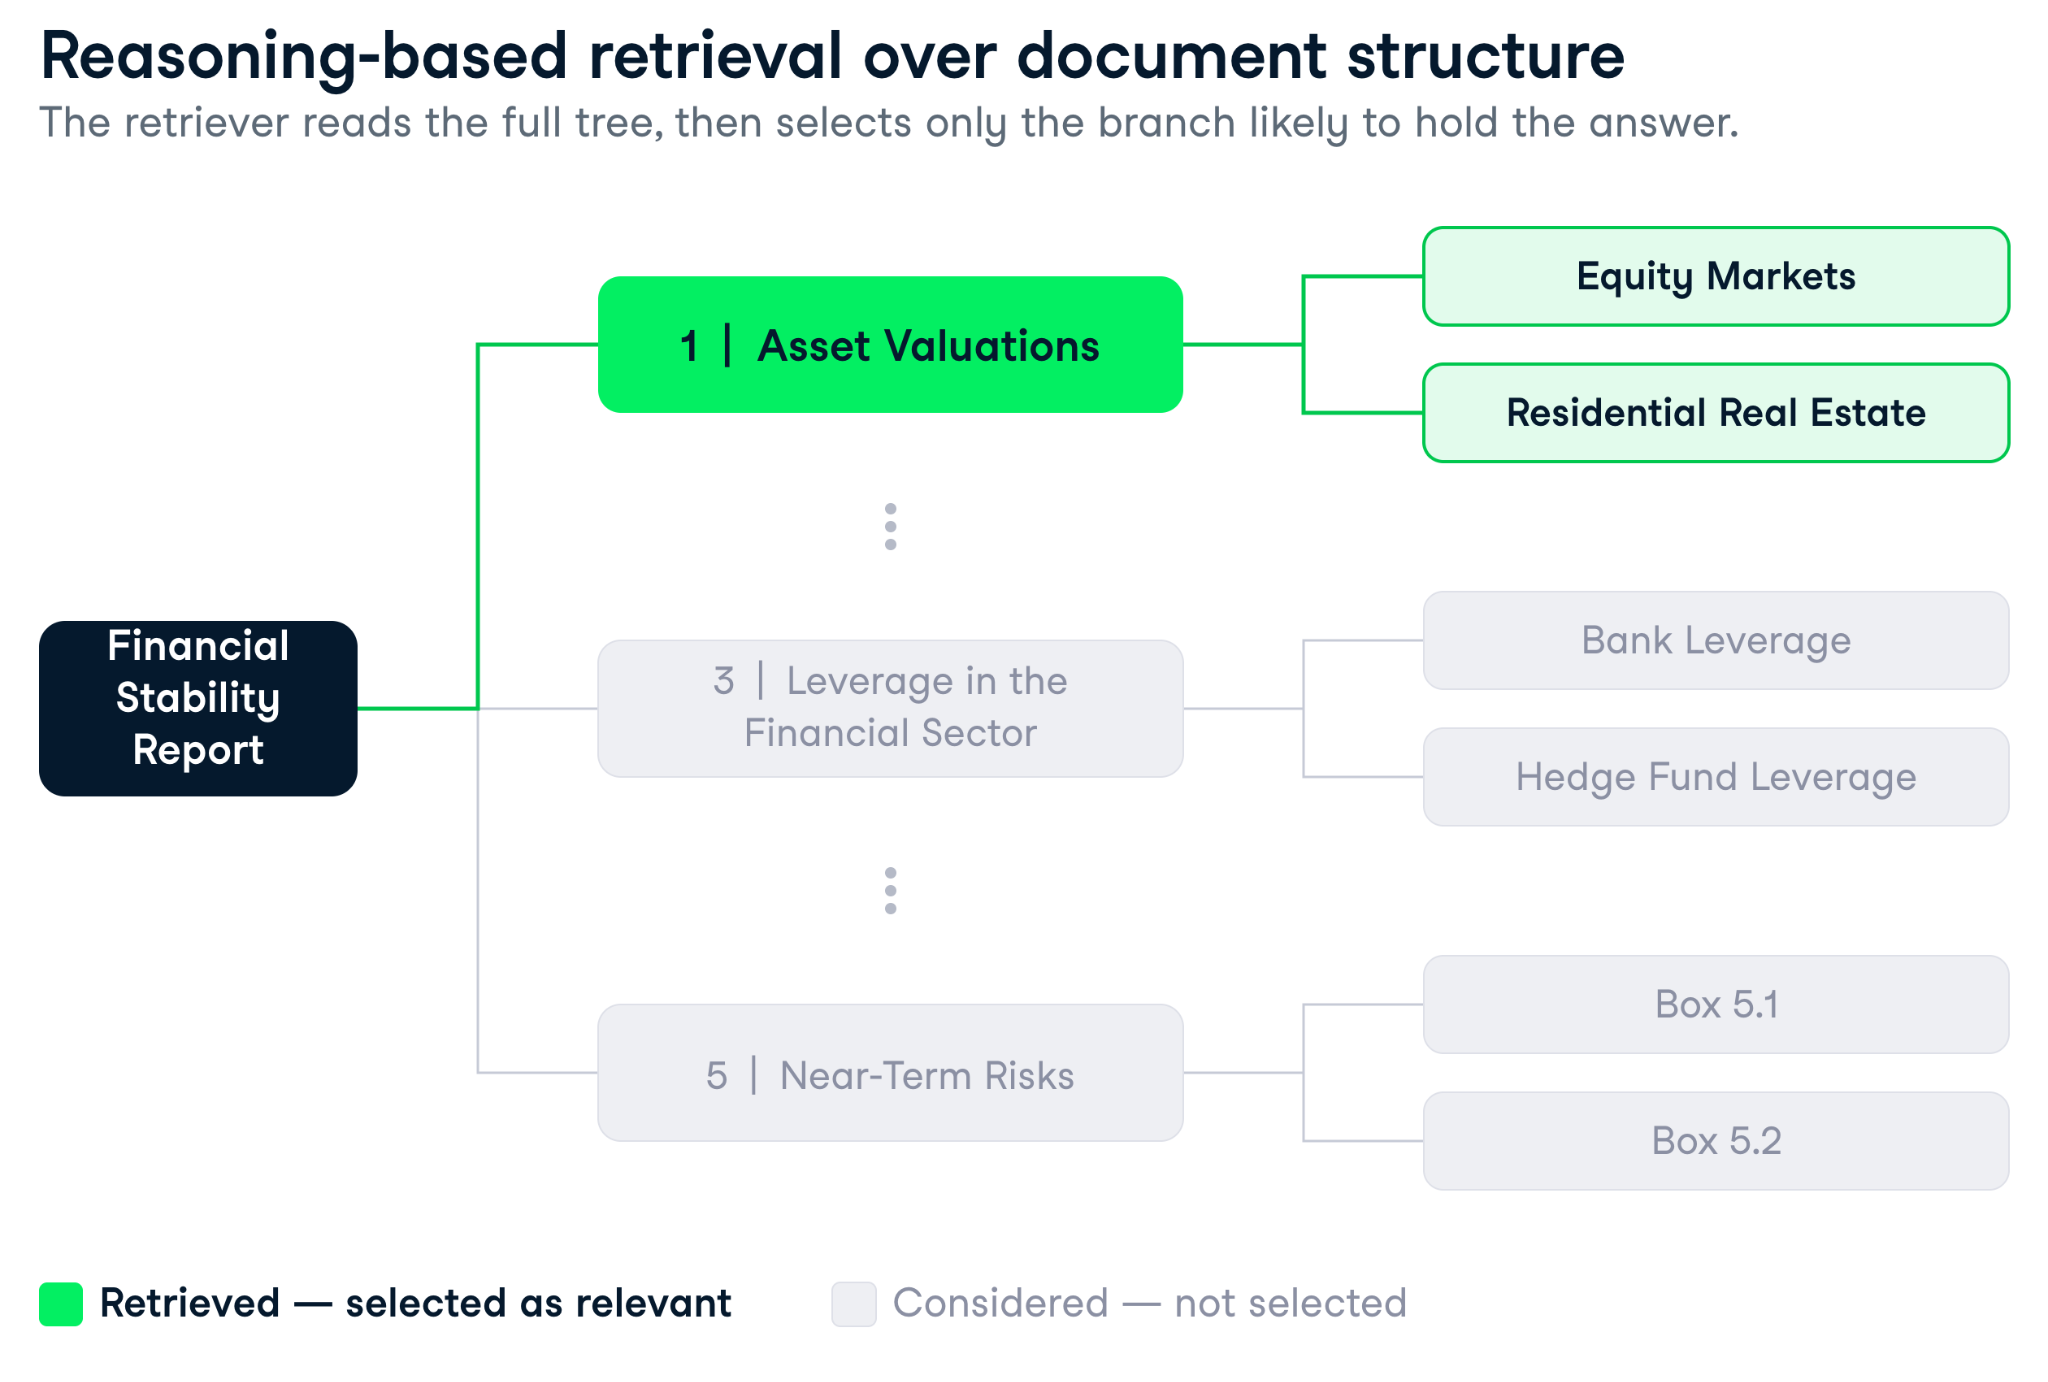
Bước truy xuất chính là điều PageIndex tái tưởng tượng. Thay vì so sánh truy vấn của bạn với mọi mảnh trong tài liệu, PageIndex trước hết xây dựng một chỉ mục cây phân cấp từ cấu trúc tài liệu. Điều này dẫn đến kết quả khác:
Nói cách khác, khác biệt giữa RAG tiêu chuẩn và PageIndex giống như giữa việc lướt qua từng trang sách để tìm từ khóa liên quan và đọc mục lục để tìm đúng chương trước.
Hai mục tiêu đó hội tụ với các truy vấn thực tế đơn giản trên tài liệu ngắn, nhưng tách biệt rõ rệt khi tài liệu trở nên dài, có cấu trúc, và đầy các tham chiếu chéo nội bộ.
Quy trình diễn ra trong hai bước.
Tôi đã xây đủ nhiều pipeline RAG để biết rằng chia mảnh là nơi hầu hết hệ thống triển khai âm thầm thất bại. Chiến lược trông gọn gàng trên giấy, nhưng ngay khi tài liệu có một bảng trải qua ranh giới trang, hoặc một chú thích định nghĩa thuật ngữ được dùng ba mục trước đó, các vết nứt hiện ra.
RAG vector có ba điểm yếu cấu trúc thường xuyên xuất hiện trên tài liệu tài chính và pháp lý.
PageIndex xử lý cả ba vì nó truy xuất theo cấu trúc thay vì các mảnh rời. Cây giữ tài liệu nguyên vẹn, bước suy luận có thể theo một tham chiếu chéo hoặc so sánh giữa các phần, và vì mỗi nút mang chỉ mục trang và tóm tắt, bộ truy xuất điều hướng theo “địa lý” của tài liệu thay vì mức độ tương đồng bề mặt của văn bản.
Thành thật mà nói: khi tôi lần đầu thấy tuyên bố độ chính xác 98,7% cho Mafin 2.5 (hệ thống dựa trên PageIndex của VectifyAI) trên FinanceBench, phản xạ của tôi là hoài nghi, vì khoảng cách gần 50 điểm so với RAG tiêu chuẩn trông như một bài benchmark được chọn để “nịnh”. Nhưng FinanceBench kiểm tra chính những điểm lỗi này: suy luận nhiều bước trên hồ sơ SEC với câu trả lời số học chính xác.
Hướng dẫn này cần một vài gói và hai khóa API. Đây là mọi thứ bạn cần trước khi viết một dòng mã.
Bạn có thể xem toàn bộ mã dùng xuyên suốt hướng dẫn trong repo GitHub đi kèm của tôi.
Để theo cùng hướng dẫn, bạn sẽ cần:
Cài đặt các gói cần thiết:
pip install pageindex openai requests faiss-cpu pymupdfĐặt các khóa API dưới dạng biến môi trường thay vì hardcode:
export PAGEINDEX_API_KEY="your_pageindex_key_here"
export OPENAI_API_KEY="your_openai_key_here"
Khi đã có cả hai khóa, khởi tạo các client của bạn:
import os
import copy
import time
import json
import asyncio
import requests
from pageindex import PageIndexClient
import pageindex.utils as utils
import openai

PAGEINDEX_API_KEY = os.environ["PAGEINDEX_API_KEY"]
OPENAI_API_KEY = os.environ["OPENAI_API_KEY"]

pi_client = PageIndexClient(api_key=PAGEINDEX_API_KEY)
openai_client = openai.AsyncOpenAI(api_key=OPENAI_API_KEY)
Đó là toàn bộ thiết lập: chín import, hai biến môi trường, hai client.
Trong hướng dẫn này, chúng ta sẽ dùng Báo cáo Ổn định Tài chính tháng 10/2023 của Cục Dự trữ Liên bang. Đây là một PDF công khai có cấu trúc như tài liệu sản xuất thực: các phần chính thức, chương đánh số, phụ lục và tham chiếu chéo nội bộ.
Fed phát hành các báo cáo của mình dưới dạng PDF có khả năng truy cập tại URL ổn định. Phần kiểm tra if not os.path.exists() nghĩa là bạn chỉ tải về một lần, điều này quan trọng khi bạn lặp trên phần mã còn lại và không muốn tải lại một PDF 60 trang mỗi lần chạy.
DOWNLOAD_DIR = "./data"
os.makedirs(DOWNLOAD_DIR, exist_ok=True)

PDF_URL = "https://www.federalreserve.gov/publications/files/financial-stability-report-20231020.pdf"
PDF_PATH = os.path.join(DOWNLOAD_DIR, "fed_financial_stability_report_2023.pdf")

if not os.path.exists(PDF_PATH):
    print("Downloading Federal Reserve Financial Stability Report (Oct 2023)...")
    response = requests.get(PDF_URL, timeout=60)
    response.raise_for_status()
    with open(PDF_PATH, "wb") as f:
        f.write(response.content)
    print(f"Saved to {PDF_PATH}")
else:
    print(f"Already present: {PDF_PATH}")
Gửi chỉ là một lần gọi API. submit_document() tải tệp lên và trả về một doc_id bạn sẽ dùng cho mọi thao tác tiếp theo trên tài liệu này. Lưu lại ở đâu đó, vì nếu bạn khởi động lại phiên, bạn có thể bỏ qua bước gửi và nhảy thẳng đến get_tree() dùng cùng ID.
print("Submitting document to PageIndex...")
submit_result = pi_client.submit_document(PDF_PATH)
doc_id = submit_result["doc_id"]
print(f"Document ID: {doc_id}")
PageIndex xử lý tài liệu bất đồng bộ, nên bạn cần thăm dò cho đến khi cây sẵn sàng:
print("Waiting for tree generation...")
while True:
    status_result = pi_client.get_document(doc_id)
    status = status_result.get("status")
    print(f"  Status: {status}")
    if status == "completed":
        break
    elif status == "failed":
        raise RuntimeError(f"Processing failed: {status_result}")
    time.sleep(10)

print("Done.")
Xử lý một PDF 60 trang thường mất hai đến bốn phút, và chi phí này chỉ trả một lần cho mỗi tài liệu. Bạn sẽ thấy trạng thái chuyển qua queued → processing → completed.
Submitting document to PageIndex...
Document ID: pi-cmq2bp4ok00rx01qxmym7tnd1

Waiting for tree generation...
  Status: queued
  Status: processing
  Status: completed
Processing done.Khi xử lý hoàn tất, get_tree() trả về toàn bộ cấu trúc phân cấp dưới dạng danh sách lồng nhau các nút. Trình trợ giúp utils.create_node_mapping() sau đó làm phẳng nó thành một từ điển đơn giản khóa theo ID nút, giúp việc trích xuất văn bản sau này nhanh hơn nhiều so với duyệt đệ quy cây cho mỗi truy vấn.
tree_result = pi_client.get_tree(doc_id, node_summary=True)
tree = tree_result["result"]

# Build a flat node map for easy access later
node_map = utils.create_node_mapping(tree)

# Print the top-level nodes
print(f"\nTop-level nodes ({len(tree)} sections):\n")
for node in tree:
    print(f"  [{node['node_id']}] {node['title']}")
    print(f"       Page {node['page_index']}")
    print(f"       {node['summary'][:120]}...")
    print()
Chạy phần này trên Báo cáo Ổn định Tài chính sẽ cho bạn khung xương của tài liệu trong nháy mắt:
Top-level nodes (9 sections):

  [0000] Financial Stability Report
       Page 1
       This document is the October 2023 Financial Stability Report from the Federal Reserve...
  [0001] Purpose and Framework
       Page 5
       This report outlines the Federal Reserve's framework for assessing U.S. financial stability...
  [0002] Overview
       Page 9
       This report evaluates the stability of the U.S. financial system by analyzing four key vulnerability areas...
  [0003] 1 | Asset Valuations
       Page 13
       ...
  [0012] 2 | Borrowing by Businesses and Households
       Page 23
       ...
  [0019] 3 | Leverage in the Financial Sector
       Page 33
       ...
  [0029] 4 | Funding Risks
       Page 45
       ...
  [0036] 5 | Near-Term Risks to the Financial System
       Page 53
       ...
  [0041] Appendix | Figure Notes
       Page 59
       …
Cây là JSON thuần, với mỗi nút mang node_id, title, summary, page_index, và danh sách nodes cho mọi tiểu mục nó chứa. Không như chỉ mục vector, không có không gian embedding mù mờ hay tệp chỉ mục nhị phân cần trình đọc đặc biệt. Chỉ là một danh sách lồng nhau bạn có thể in, kiểm tra và suy luận trực tiếp.
Tính minh bạch đó rất hữu ích trong thực tế: nếu bộ truy xuất trả về phần sai, bạn có thể xem cây và hiểu vì sao, điều mà bạn đơn giản không thể làm với một embedding 768 chiều.
Bước truy xuất gửi cấu trúc cây (không có toàn bộ văn bản, vì sẽ tràn cửa sổ ngữ cảnh) tới một LLM và yêu cầu nó xác định các nút liên quan đến truy vấn.
Prompt truyền cây rút gọn (chỉ tiêu đề và tóm tắt, loại bỏ văn bản toàn phần) cho LLM và yêu cầu trả về một đối tượng JSON chứa dấu vết suy luận và danh sách ID nút. Có hai lựa chọn thiết kế đáng chú ý.
Thứ nhất, utils.remove_fields() loại bỏ nội dung thực của mỗi nút trước khi tuần tự hóa, giúp prompt nằm gọn trong giới hạn ngữ cảnh ngay cả với tài liệu dài. Lời gọi copy.deepcopy() là cần thiết vì remove_fields thay đổi tại chỗ, và bạn cần giữ nguyên cây gốc cho bước trích xuất văn bản phía sau.
Thứ hai, response_format={"type": "json_object"} buộc đầu ra có cấu trúc, nên việc phân tích cú pháp đáng tin cậy thay vì mong manh. Nhiệt độ để 0 vì đây là nhiệm vụ suy luận.
TREE_SEARCH_PROMPT = """You are a document retrieval assistant.
Given a document's tree structure and a user query, identify which nodes (sections)
are most likely to contain the answer.

Document tree:
{tree_json}

User query: {query}

Return a JSON object with the following format:
{{
  "reasoning": "Your step-by-step reasoning about which sections to retrieve",
  "node_ids": ["id1", "id2", ...]
}}

Return ONLY the JSON object, no other text."""

async def tree_search(tree, query: str, model: str = "gpt-4o") -> dict:
    """Use an LLM to reason over the tree and return relevant node IDs."""

    # remove_fields mutates in place; deepcopy protects the original tree
    slim_tree = utils.remove_fields(copy.deepcopy(tree), fields=["text"])
    tree_json = json.dumps(slim_tree, indent=2)

    prompt = TREE_SEARCH_PROMPT.format(tree_json=tree_json, query=query)

    response = await openai_client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        response_format={"type": "json_object"}
    )

    result = json.loads(response.choices[0].message.content)
    return result
Lưu ý: các lời gọi await bên dưới giả định môi trường Jupyter hoặc iPython nơi await cấp cao được hỗ trợ. Nếu chạy dưới dạng script .py thuần, hãy bọc các lời gọi async trong một hàm async def main() và gọi bằng asyncio.run(main()).
Bắt đầu với một câu hỏi cần điều hướng qua nhiều phần. Một truy vấn về các dễ tổn thương trong định giá tài sản cần tài liệu từ phần tổng quan, chương về định giá tài sản và các tiểu mục của nó bao quát các thị trường cụ thể.
Đó là những phần mà RAG vector có thể đưa ra độc lập, nhưng hiếm khi cùng nhau với hệ phân cấp đúng. Đây chính là dạng truy vấn mà tìm kiếm theo cây phát huy tác dụng.
query_1 = "What are the main vulnerabilities the Fed identified in asset valuations as of October 2023, and which markets were flagged as stretched?"

result = await tree_search(tree, query_1)

print("LLM Reasoning:")
print(result["reasoning"])
print("\nSelected node IDs:", result["node_ids"])
Dấu vết suy luận là phần đáng lưu ý nhất. Đây là ví dụ đầu ra điển hình:
LLM Reasoning:
To identify the main vulnerabilities in asset valuations as of October 2023,
we should focus on sections that specifically discuss asset valuations and
related market conditions. The '1 | Asset Valuations' section and its
subsections are directly relevant as they provide detailed insights into
asset valuation pressures, equity market conditions, and specific market
sectors flagged as stretched.

Selected node IDs: ['0003', '0004', '0006', '0009', '0010', '0011']
Bạn có thể thấy chính xác vì sao mỗi phần được chọn, mức độ truy vết mà bạn đơn giản không nhận được từ một xếp hạng cosine similarity.
Khi đã có các ID nút liên quan, bước tiếp theo là trích xuất văn bản tương ứng và truyền nó cho một mô hình sinh.
Hai hàm xử lý bước sinh.
generate_answer() tra từng nút đã chọn trong node_map, thêm tiêu đề phần và chỉ mục trang ở đầu (đây là thứ cung cấp trích dẫn có thể kiểm toán trong câu trả lời cuối), và truyền ngữ cảnh đã lắp ráp cho mô hình sinh.
pageindex_pipeline() gói tìm kiếm cây và sinh câu trả lời vào một lần gọi, để bạn không phải xâu chuỗi thủ công mỗi lần.
ANSWER_PROMPT = """You are a financial document analyst. Answer the user's question
using ONLY the provided context. Cite the specific section(s) you are drawing from.
If the context does not contain enough information to answer, say so clearly.

Context:
{context}

Question: {question}

Provide a precise, well-cited answer."""

async def generate_answer(node_ids: list, query: str, node_map: dict,
                          model: str = "gpt-4o") -> str:
    """Extract text from the selected nodes and generate an answer."""

    # Gather the text from each selected node
    context_parts = []
    for node_id in node_ids:
        node = node_map.get(node_id)
        if node:
            section_header = f"[{node['title']} | Page {node['page_index']}]"
            context_parts.append(f"{section_header}\n{node.get('text', '')}")

    context = "\n\n---\n\n".join(context_parts)
    prompt = ANSWER_PROMPT.format(context=context, question=query)

    response = await openai_client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0
    )

    return response.choices[0].message.content

async def pageindex_pipeline(tree, query: str, node_map: dict) -> dict:
    """Full PageIndex pipeline: tree search + answer generation."""
    search_result = await tree_search(tree, query)
    node_ids = search_result["node_ids"]
    reasoning = search_result["reasoning"]
    answer = await generate_answer(node_ids, query, node_map)
    return {
        "query": query,
        "reasoning": reasoning,
        "retrieved_sections": node_ids,
        "answer": answer
    }
Chạy toàn bộ pipeline:
result = await pageindex_pipeline(tree, query_1, node_map)

print(f"Query: {result['query']}\n")
print(f"Retrieved sections: {result['retrieved_sections']}\n")
print(f"Answer:\n{result['answer']}")
Câu trả lời trả về với trích dẫn theo cấp độ phần và số trang. Đó là khả năng truy vết PageIndex cung cấp mặc định.
Query: What are the main vulnerabilities the Fed identified in asset valuations
as of October 2023, and which markets were flagged as stretched?

Retrieved sections: ['0003', '0004', '0006', '0009', '0010', '0011']

Answer:
The main vulnerabilities identified by the Fed in asset valuations as of
October 2023 include:

1. Equity Markets: Valuations increased modestly from an already high level,
with the forward price-to-earnings ratio rising further above its historical
median (Page 13, "Equity market valuation pressures remained notable").

2. Residential Real Estate: House prices started increasing again, and the
price-to-rent ratio was close to its previous peak from the mid-2000s
(Page 20, "House prices started increasing again in recent months").

3. Commercial Real Estate: Despite recent price declines, valuations remained
elevated relative to rental income (Page 19, "Commercial real estate
valuations remained elevated").

4. Farmland: Prices near the peak of their historical distribution, driven
by strong agricultural commodity prices (Page 21, "Farmland valuations
remained elevated").Đây là phần thực sự hữu ích. Hãy xây một đường cơ sở RAG vector trên cùng tài liệu và chạy cả hai pipeline trên cùng các truy vấn.
Đường cơ sở theo mẫu tiêu chuẩn: trích văn bản thô từ PDF bằng PyMuPDF, chia thành các mảnh 500 từ có chồng lắp, embed mỗi mảnh bằng text-embedding-3-small, và nạp tất cả vào chỉ mục FAISS trong bộ nhớ để tra cứu cosine similarity.
Nếu bạn muốn nền tảng thêm về vì sao lựa chọn kích thước mảnh và chồng lắp ảnh hưởng tới chất lượng truy xuất, bài Chiến lược chia mảnh của chúng tôi đáng đọc kèm theo, và bài FAISS là gì? cũng hữu ích nếu các bước xây chỉ mục còn lạ lẫm.
from openai import OpenAI
import numpy as np
import faiss

sync_openai = OpenAI(api_key=OPENAI_API_KEY)

def extract_text_from_pdf(pdf_path: str) -> str:
    """Extract raw text from a PDF using PyMuPDF."""
    import fitz  # pip install pymupdf
    doc = fitz.open(pdf_path)
    pages = []
    for page_num, page in enumerate(doc):
        text = page.get_text()
        if text.strip():
            pages.append(f"[Page {page_num + 1}]\n{text}")
    return "\n\n".join(pages)


def chunk_text(text: str, chunk_size: int = 500, overlap: int = 50) -> list[str]:
    """Split text into overlapping chunks by word count."""
    words = text.split()
    chunks = []
    start = 0
    while start < len(words):
        end = min(start + chunk_size, len(words))
        chunks.append(" ".join(words[start:end]))
        start += chunk_size - overlap
    return chunks


def embed_chunks(chunks: list[str], model: str = "text-embedding-3-small") -> np.ndarray:
    """Embed a list of text chunks with the OpenAI embeddings API."""
    all_embeddings = []
    batch_size = 100
    for i in range(0, len(chunks), batch_size):
        batch = chunks[i : i + batch_size]
        response = sync_openai.embeddings.create(input=batch, model=model)
        batch_embeddings = [item.embedding for item in response.data]
        all_embeddings.extend(batch_embeddings)
    return np.array(all_embeddings, dtype="float32")


def build_faiss_index(embeddings: np.ndarray) -> faiss.IndexFlatIP:
    """Build an in-memory FAISS index for inner-product (cosine) search."""
    dim = embeddings.shape[1]
    faiss.normalize_L2(embeddings)
    index = faiss.IndexFlatIP(dim)
    index.add(embeddings)
    return index


def vector_rag_pipeline(query: str, chunks: list[str], index: faiss.IndexFlatIP,
                         k: int = 5, model: str = "gpt-4o") -> str:
    """Full vector RAG pipeline: embed query, retrieve top-k, generate answer."""

    # Embed the query
    query_embedding = sync_openai.embeddings.create(
        input=[query], model="text-embedding-3-small"
    ).data[0].embedding
    query_vec = np.array([query_embedding], dtype="float32")
    faiss.normalize_L2(query_vec)

    # Retrieve top-k chunks
    _, indices = index.search(query_vec, k)
    retrieved_chunks = [chunks[i] for i in indices[0] if i < len(chunks)]
    context = "\n\n---\n\n".join(retrieved_chunks)

    # Generate answer
    response = sync_openai.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "Answer the question using only the provided context. Be precise."},
            {"role": "user", "content": f"Context:\n{context}\n\nQuestion: {query}"}
        ],
        temperature=0
    )
    return response.choices[0].message.content
Với các hàm trợ giúp đã định nghĩa, hãy xây chỉ mục. Với tài liệu 60 trang, bước embedding là chậm nhất: dự kiến một đến hai phút, tùy kết nối và thông lượng của OpenAI.
print("Extracting text from PDF...")
raw_text = extract_text_from_pdf(PDF_PATH)

print("Chunking text...")
chunks = chunk_text(raw_text, chunk_size=500, overlap=50)
print(f"  {len(chunks)} chunks created")

print("Embedding chunks...")
embeddings = embed_chunks(chunks)
print(f"  Embeddings shape: {embeddings.shape}")

print("Building FAISS index...")
faiss_index = build_faiss_index(embeddings)
print("Done.\n")Một báo cáo 60 trang tạo ra khoảng 47 mảnh ở kích thước 500 từ với chồng lắp 50 từ.
Extracting text from PDF...
Chunking text...
  47 chunks created
Embedding chunks (takes 1-2 min)...
  Embeddings shape: (47, 1536)
Building FAISS index...
Done.
Ba truy vấn, mỗi truy vấn thiết kế để lộ một thách thức truy xuất khác nhau:
queries = [
    # Direct factual lookup
    "What does the Fed consider the most significant near-term risk to financial stability as of October 2023?",

    # Cross-reference question (Box 5.2 is referenced from Section 5, requires following an internal pointer)
    "What methodology does the Fed use to assess climate-related financial risks, and where in the report is it described?",

    # Multi-section reasoning (requires connecting Section 1 and Section 3)
    "How do elevated asset valuations interact with leverage in the financial sector to amplify systemic risk, according to the report?"
]
Khi cả hai pipeline đã sẵn sàng, vòng lặp dưới đây gửi mỗi truy vấn qua cả hai hệ thống và thu kết quả. Phần cắt [:500] trên mỗi câu trả lời chỉ để bản in ra console dễ đọc; các câu trả lời đầy đủ được lưu trong results để kiểm tra sau.
results = []

for query in queries:
    print(f"\nQuery: {query}\n")

    # PageIndex
    pi_result = await pageindex_pipeline(tree, query, node_map)
    pi_answer = pi_result["answer"]

    # Vector RAG
    vec_answer = vector_rag_pipeline(query, chunks, faiss_index)

    results.append({
        "query": query,
        "pageindex_answer": pi_answer,
        "vector_rag_answer": vec_answer
    })

    print("PageIndex answer:")
    print(pi_answer[:500])
    print("\nVector RAG answer:")
    print(vec_answer[:500])
print("\n" + "="*60)Đây là kiểu kết quả bạn sẽ thấy trên ba loại truy vấn:
|
Truy vấn |
PageIndex |
RAG vector |
Đáp án đúng |
Bên thắng |
|
Rủi ro ngắn hạn đáng kể nhất |
Câu trả lời rộng, bao quát nhiều rủi ro với trích dẫn phần |
Đưa ra con số khảo sát 72% cụ thể (chính xác hơn ở câu này) |
Lạm phát dai dẳng và chính sách tiền tệ thắt chặt, được 72% người khảo sát nêu (Hộp 5.1) |
Hòa, RAG vector nhỉnh hơn chút ở thống kê cụ thể |
|
Phương pháp đánh giá rủi ro khí hậu (tham chiếu chéo) |
Truy xuất đúng mục, nhưng chọn nút cha thay vì Hộp 5.2, nên văn bản phương pháp không tới bước sinh |
Chia mảnh đi xuyên qua Hộp 5.2 và trả về các bước phương pháp thực tế |
Hộp 5.2 mô tả chuyển rủi ro vật lý và chuyển dịch thành phơi nhiễm tài chính qua phân tích kịch bản |
RAG vector |
|
Tương tác định giá tài sản + đòn bẩy |
Truy xuất 18 nút từ Mục 1 và 3 và giải thích cơ chế khuếch đại |
Kết nối hai mục và giải thích cơ chế khuếch đại |
Định giá cao làm tăng rủi ro điều chỉnh giá mạnh; đòn bẩy khuếch đại thua lỗ khi điều chỉnh xảy ra với các tổ chức dùng đòn bẩy (Mục 1 và 3) |
Hòa |
Kết quả tinh tế hơn là một chiến thắng tuyệt đối cho hệ nào, điều này khiến chúng hữu ích hơn.
PageIndex điều hướng đến đúng phần trong cả ba trường hợp. Ở truy vấn thực tế trực tiếp, cả hai đều trả lời đúng, dù RAG vector đưa ra con số 72% cụ thể vì cách chia mảnh phẳng tình cờ giữ nguyên Hộp 5.1, may mắn chia mảnh hơn là lợi thế cấu trúc. Ở truy vấn đa phần, PageIndex truy xuất 18 nút trải khắp Mục 1 và 3 và giải thích tương tác, gần như tương đương RAG vector. Trận thua rõ ràng là truy vấn tham chiếu chéo, và đáng để hiểu nguyên nhân.
Với truy vấn phương pháp về khí hậu, PageIndex suy luận đến Mục 5 và Tổng quan, nhưng phương pháp nằm trong Hộp 5.2, một nút con riêng dưới Mục 5. Tìm kiếm cây chọn mục cha, không phải hộp, và văn bản của mục cha tham chiếu đến hộp mà không trích lại, nên bước sinh không thấy phương pháp. RAG vector thắng bằng cách chia mảnh đi xuyên qua Hộp 5.2.
Đây là vấn đề về độ hạt truy xuất, không phải lỗi suy luận: chọn nút cha không kéo văn bản của các nút con trừ khi bạn mở rộng lựa chọn để bao gồm chúng. Bạn có thể thu hẹp khoảng cách bằng cách nhắc tìm kiếm cây trả về các nút con của mọi phần liên quan, hoặc mở rộng mỗi nút đã chọn để bao gồm hậu duệ trước bước sinh.
Lợi thế của PageIndex thể hiện rõ nhất trong lần chạy pipeline độc lập trước đó (truy vấn định giá tài sản), nơi nó suy luận đúng cấu trúc tài liệu và trả lời có trích dẫn theo phần rõ ràng. Các truy vấn so sánh ở trên được chọn cụ thể để “stress-test” các tình huống truy xuất thách thức hơn, vì vậy chúng thiên về RAG vector với tài liệu 60 trang.
Kết luận thẳng thắn: lợi thế của PageIndex so với RAG vector sắc nét hơn khi tài liệu dài và dày đặc tham chiếu chéo nội bộ. Với báo cáo 60 trang, khoảng cách ở mức vừa phải. Với một hồ sơ 10-K 200 trang có hàng chục chú thích tham chiếu lẫn nhau, hãy kỳ vọng khoảng cách lớn hơn.
Nếu bạn muốn đẩy đường cơ sở RAG vector xa hơn trước khi gác nó lại, Cách cải thiện hiệu năng RAG bao quát năm kỹ thuật đòn bẩy cao nhất.
So sánh trên đặc thù cho một loại tài liệu và độ dài. Việc PageIndex có phù hợp hay không phụ thuộc vào ba yếu tố: cấu trúc tài liệu, loại truy vấn và khối lượng.
PageIndex xứng đáng với overhead trên các tài liệu chuyên nghiệp dài, có cấu trúc nơi một câu trả lời sai có giá đắt:
Đây cũng là các trường hợp mà dấu vết suy luận cho bạn thứ gì đó cụ thể để kiểm toán. Điểm ngọt là khối lượng thấp, rủi ro cao: vài chục tài liệu mỗi ngày nơi mỗi truy vấn cần đúng, và phần bù độ trễ/chi phí là xứng đáng.
RAG vector là mặc định tốt hơn cho khối lượng cao, độ trễ thấp, nơi nhiều lần gọi LLM của PageIndex cho mỗi truy vấn trở thành nút thắt và embedding được cache xử lý tải với chi phí thấp hơn nhiều.
Nó cũng phù hợp với tài liệu phẳng ít phân cấp để suy luận, như:
Nó cũng là lựa chọn đúng cho các trường hợp câu trả lời xấp xỉ là đủ. Một chatbot hỗ trợ mà tìm đúng FAQ chín trên mười có lẽ đã đạt chuẩn.
Cái giá phải trả là tốc độ và tiền. Mỗi truy vấn PageIndex chạy ít nhất hai lần gọi LLM (tìm kiếm cây và sinh câu trả lời) cộng xử lý ban đầu, nên kỳ vọng ba đến tám giây mỗi truy vấn trên tài liệu 60 trang so với dưới một giây cho RAG vector với chỉ mục FAISS được cache, và hóa đơn mỗi truy vấn cũng tỷ lệ tương tự.
Báo cáo Ổn định Tài chính là ca kiểm thử công bằng cho PageIndex: có cấu trúc, phân cấp, tham chiếu chéo. Một tập hợp hàng nghìn phiếu hỗ trợ ngắn thì không, và RAG vector sẽ vượt trội ở đó với chi phí thấp hơn nhiều.
RAG vector có một giả định ẩn: đoạn văn giống nhất với truy vấn của bạn cũng là đoạn chứa câu trả lời. Với tài liệu ngắn, cấu trúc lỏng lẻo, giả định đó đủ đúng. Với các tài liệu chuyên nghiệp dài, có cấu trúc, nó đổ vỡ theo những cách có thể dự đoán: bảng bị tách, tần suất thuật ngữ gây nhiễu, và tham chiếu chéo “vô hình”.
PageIndex giải quyết cả ba bằng cách coi truy xuất là một bài toán suy luận trên cấu trúc tài liệu thay vì tìm kiếm tương đồng trên các mảnh văn bản.
Quy tắc thực tiễn rất đơn giản: nếu tài liệu của bạn có phân cấp, truy vấn đòi hỏi theo các tham chiếu nội bộ, và việc trả lời đúng quan trọng hơn trả lời nhanh, PageIndex xứng đáng với phần bù độ trễ và chi phí. Nếu bạn chạy tìm kiếm khối lượng lớn trên tài liệu ngắn hoặc phẳng, RAG vector vẫn là mặc định đúng.
Muốn tìm hiểu sâu hơn về RAG triển khai và hệ thống tác tửs? Lộ trình AI Engineering với LangChain của chúng tôi đưa bạn đi từ nền tảng ứng dụng đến truy xuất, đánh giá và tác tử dùng công cụ.
Học RAG với DataCamp!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
