
कोर्स
LangChain के साथ Retrieval Augmented Generation (RAG)
3 घंटा
20.9K
PageIndex एक रिट्रीवल फ्रेमवर्क है जो sकिसी दस्तावेज़ की संरचना पर तर्क करता है, बजाय इसके कि आपके प्रश्न से मिलते-जुलते पाठ की खोज करे। इसे सितंबर 2025 में VectifyAI ने जारी किया, और इसे Mingtian Zhang और Yu Tang ने बनाया। यह MIT लाइसेंस के तहत ओपन सोर्स है, और जुलाई 2026 तक GitHub रिपॉजिटरी ने 34,000 से अधिक सितारे संग्रहित किए हैं।
PageIndex कैसे काम करता है, इसे समझाने का सबसे अच्छा तरीका है इसे मानक RAG से तुलना करना। यदि आप RAG में नए हैं, तो बुनियादी विचार यह है कि आप क्वेरी के समय प्रासंगिक हिस्सों को निकालकर किसी LLM को दस्तावेज़ तक पहुँच देते हैं और उन्हें संदर्भ के रूप में पास करते हैं।
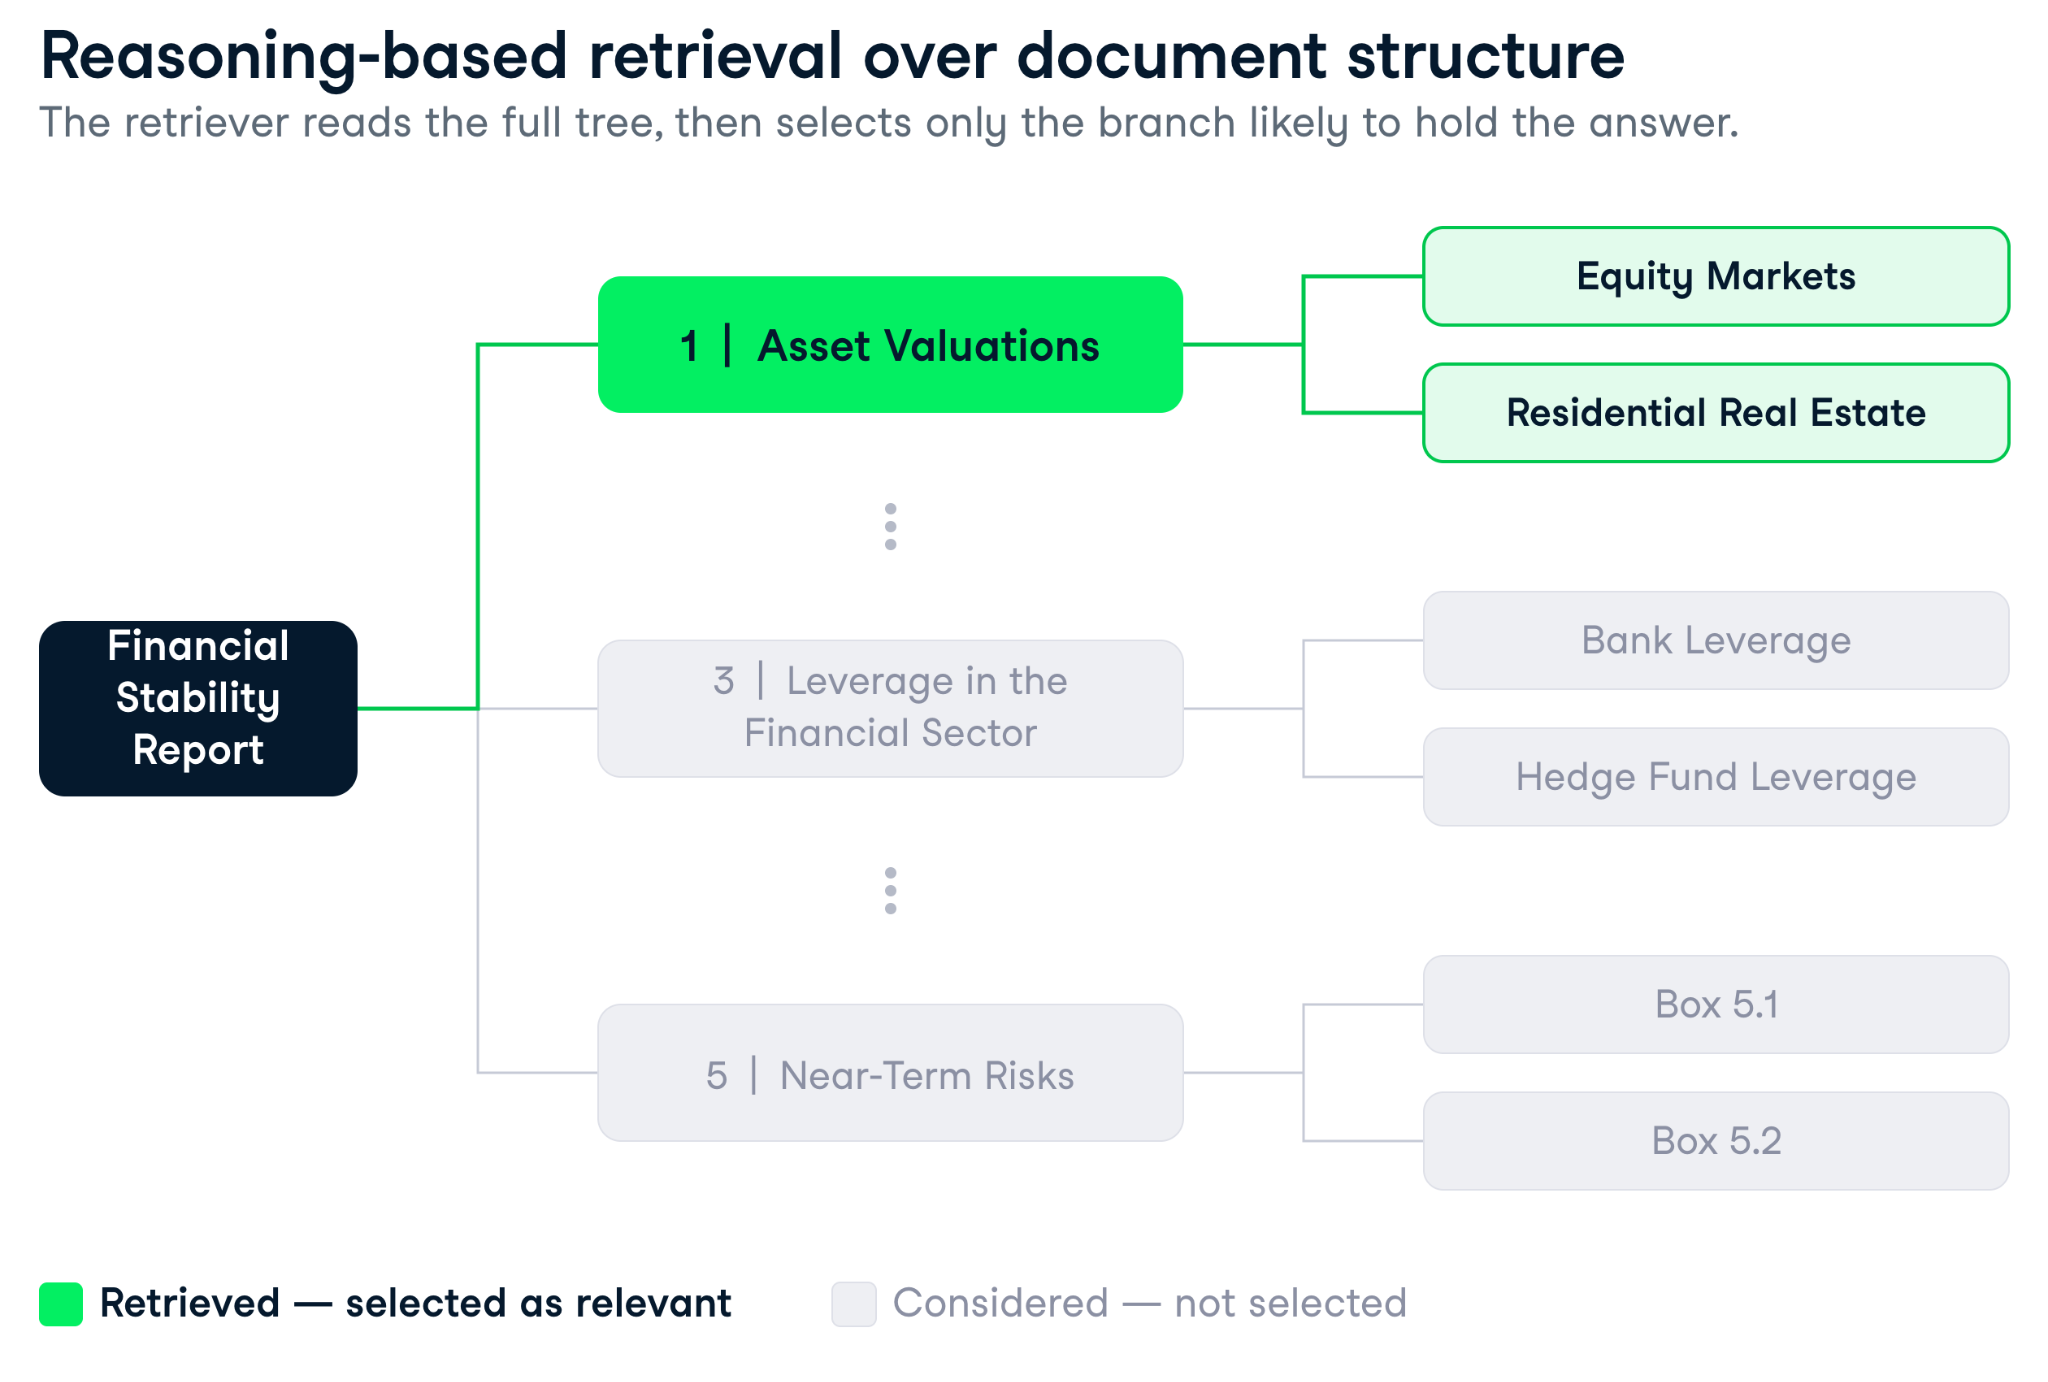
PageIndex ठीक इसी रिट्रीवल स्टेप की नई परिकल्पना करता है। आपकी क्वेरी की दस्तावेज़ के हर chunk से तुलना करने के बजाय, PageIndex पहले दस्तावेज़ की संरचना से एक पदानुक्रमित ट्री इंडेक्स बनाता है। इससे परिणाम अलग आते हैं:
दूसरे शब्दों में, मानक RAG और PageIndex के बीच फर्क वैसा ही है जैसा कि किसी किताब के हर पेज पर प्रासंगिक कीवर्ड्स ढूँढ़ने और पहले विषय-सूची पढ़कर सही चैप्टर तक पहुँचने के बीच।
सरल तथ्यों वाली छोटी फाइलों पर ये दोनों लक्ष्य मिल जाते हैं, लेकिन जैसे ही दस्तावेज़ लंबे, संरचित और आंतरिक क्रॉस-रेफरेंसेज़ से भरे होते हैं, ये तेज़ी से अलग हो जाते हैं।
प्रक्रिया दो कदमों में चलती है।
मैंने इतने RAG पाइपलाइन बनाए हैं कि चंकिंग ही वह जगह है जहाँ अधिकतर प्रोडक्शन सिस्टम चुपचाप असफल होते हैं। कागज़ पर रणनीति साफ़ दिखती है, लेकिन जैसे ही आपके दस्तावेज़ में कोई टेबल पेज सीमाओं के पार जाता है, या किसी फुटनोट में ऐसा शब्द परिभाषित है जो तीन सेक्शन पहले इस्तेमाल हुआ है, दरारें दिखने लगती हैं।
वेक्टर RAG की तीन संरचनात्मक कमजोरियाँ हैं जो वित्तीय और कानूनी दस्तावेज़ों में बार-बार दिखती हैं।
PageIndex इन तीनों को संभालता है क्योंकि यह फрагमेंट्स पर नहीं, संरचना पर रिट्रीव करता है। ट्री दस्तावेज़ को संपूर्ण बनाए रखता है, रीज़निंग स्टेप किसी क्रॉस-रेफरेंस का पीछा कर सकता है या सेक्शनों के बीच तुलना कर सकता है, और क्योंकि हर नोड में पेज इंडेक्स और सारांश है, रिट्रीवर सतही टेक्स्ट समानता के बजाय दस्तावेज़ की "भूगोल" नेविगेट करता है।
ईमानदारी से कहूँ: जब मैंने पहली बार Mafin 2.5 के लिए 98.7% सटीकता के दावे (VectifyAI के PageIndex-आधारित सिस्टम) को FinanceBench पर देखा, तो सहज प्रतिक्रिया संदेह थी, क्योंकि मानक RAG पर लगभग 50-प्वाइंट का अंतर ऐसा लगता है जैसे बेंचमार्क चापलूसी के लिए चुना गया हो। लेकिन FinanceBench ठीक इन्हीं विफलता मोड्स की जाँच करता है: SEC फाइलिंग्स पर मल्टी-स्टेप रीज़निंग, सटीक संख्यात्मक उत्तरों के साथ।
इस ट्यूटोरियल के लिए कुछ पैकेज और दो API कुंजियाँ चाहिए। कोड लिखने से पहले आपको यही सब चाहिए।
आप इस ट्यूटोरियल में इस्तेमाल हुआ सारा कोड मेरे साथ के GitHub रिपो में देख सकते हैं।
इस ट्यूटोरियल के साथ चलते रहने के लिए, आपको चाहिए:
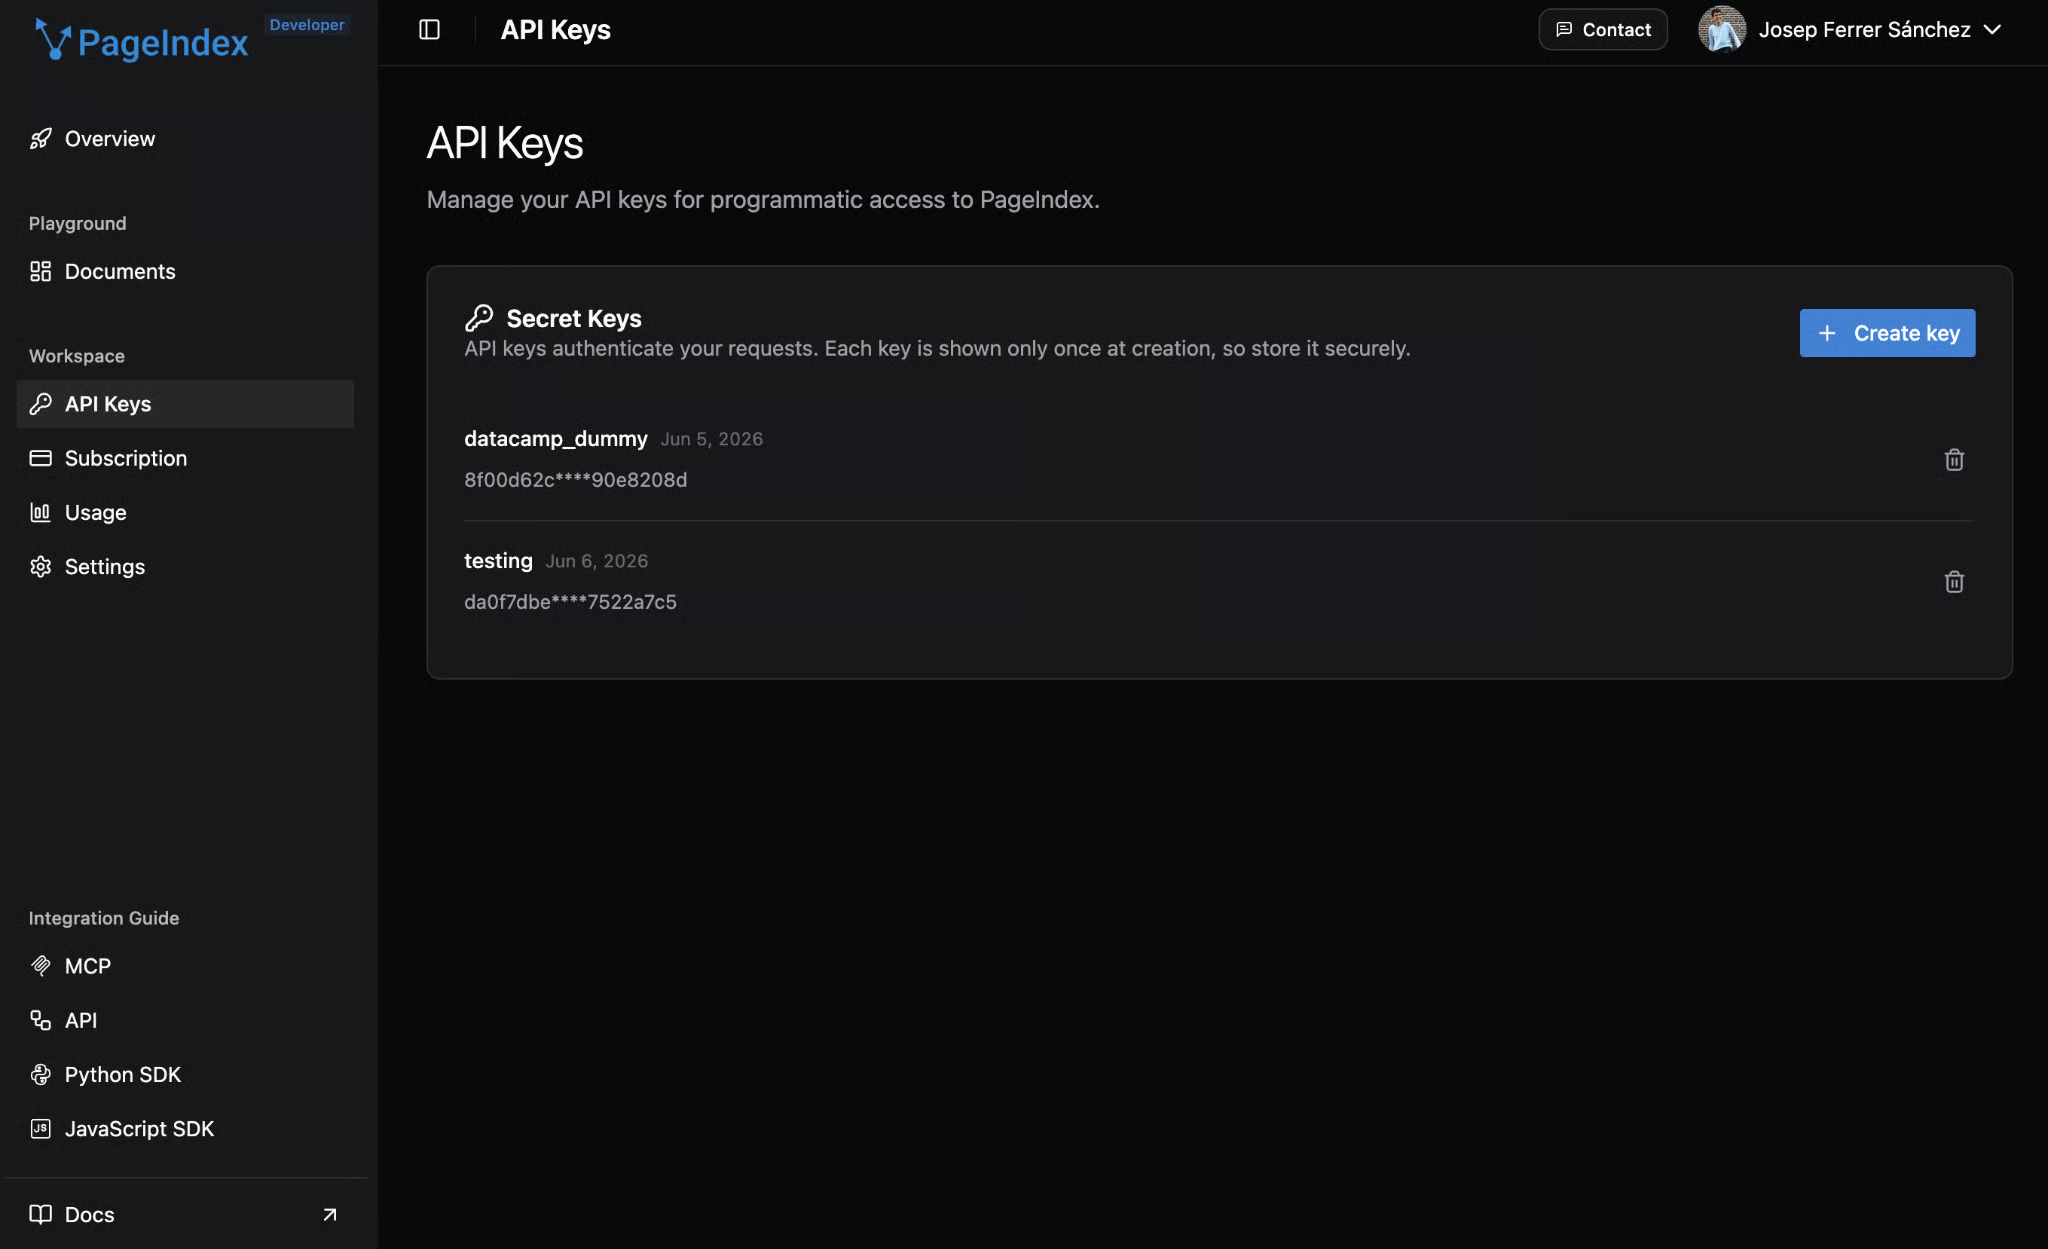
आवश्यक पैकेज इंस्टॉल करें:
pip install pageindex openai requests faiss-cpu pymupdfAPI कुंजियों को हार्डकोड करने के बजाय इन्हें एनवायरनमेंट वेरिएबल्स के रूप में सेट करें:
export PAGEINDEX_API_KEY="your_pageindex_key_here"
export OPENAI_API_KEY="your_openai_key_here"
दोनों कुंजियाँ सेट होने पर, अपने क्लाइंट्स इनिशियलाइज़ करें:
import os
import copy
import time
import json
import asyncio
import requests
from pageindex import PageIndexClient
import pageindex.utils as utils
import openai

PAGEINDEX_API_KEY = os.environ["PAGEINDEX_API_KEY"]
OPENAI_API_KEY = os.environ["OPENAI_API_KEY"]

pi_client = PageIndexClient(api_key=PAGEINDEX_API_KEY)
openai_client = openai.AsyncOpenAI(api_key=OPENAI_API_KEY)
पूरा सेटअप बस इतना ही: नौ इम्पोर्ट्स, दो एनवायरनमेंट वेरिएबल्स, दो क्लाइंट्स।
इस ट्यूटोरियल के लिए हम Federal Reserve की अक्टूबर 2023 Financial Stability Report का उपयोग करेंगे। यह एक सार्वजनिक PDF है, जो असली प्रोडक्शन दस्तावेज़ की तरह संरचित है: औपचारिक सेक्शन, क्रमांकित अध्याय, परिशिष्ट और आंतरिक क्रॉस-रेफरेंसेज़।
फेड अपने रिपोर्ट्स को एक स्थिर URL पर एक्सेसेबल PDF के रूप में प्रकाशित करता है। if not os.path.exists() चेक का मतलब है कि आप इसे केवल एक बार फेच करेंगे, जो तब मायने रखता है जब आप बाकी कोड पर इटररेट कर रहे हों और हर रन पर 60-पेज PDF फिर से डाउनलोड नहीं करना चाहते।
DOWNLOAD_DIR = "./data"
os.makedirs(DOWNLOAD_DIR, exist_ok=True)

PDF_URL = "https://www.federalreserve.gov/publications/files/financial-stability-report-20231020.pdf"
PDF_PATH = os.path.join(DOWNLOAD_DIR, "fed_financial_stability_report_2023.pdf")

if not os.path.exists(PDF_PATH):
    print("Downloading Federal Reserve Financial Stability Report (Oct 2023)...")
    response = requests.get(PDF_URL, timeout=60)
    response.raise_for_status()
    with open(PDF_PATH, "wb") as f:
        f.write(response.content)
    print(f"Saved to {PDF_PATH}")
else:
print(f"Already present: {PDF_PATH}")सबमिशन एक सिंगल API कॉल है। submit_document() फ़ाइल अपलोड करता है और एक doc_id लौटाता है जिसका उपयोग आप इस दस्तावेज़ पर आगे की हर प्रक्रिया में करेंगे। इसे कहीं सहेज लें, क्योंकि यदि आप सेशन रीस्टार्ट करते हैं, तो आप सबमिशन स्टेप को छोड़ सकते हैं और उसी ID के साथ सीधे get_tree() पर जा सकते हैं।
print("Submitting document to PageIndex...")
submit_result = pi_client.submit_document(PDF_PATH)
doc_id = submit_result["doc_id"]
print(f"Document ID: {doc_id}")
PageIndex दस्तावेज़ को एसिंक्रोनसली प्रोसेस करता है, इसलिए आपको ट्री तैयार होने तक पोल करना होगा:
print("Waiting for tree generation...")
while True:
    status_result = pi_client.get_document(doc_id)
    status = status_result.get("status")
    print(f"  Status: {status}")
    if status == "completed":
        break
    elif status == "failed":
        raise RuntimeError(f"Processing failed: {status_result}")
    time.sleep(10)

print("Done.")
60-पेज PDF को प्रोसेस करने में आमतौर पर दो से चार मिनट लगते हैं, और यह लागत प्रति दस्तावेज़ केवल एक बार चुकानी पड़ती है। आप स्टेटस को queued → processing → completed चक्र में जाते हुए देखेंगे।
Submitting document to PageIndex...
Document ID: pi-cmq2bp4ok00rx01qxmym7tnd1

Waiting for tree generation...
  Status: queued
  Status: processing
  Status: completed
Processing done.प्रोसेसिंग पूरा होने पर, get_tree() संपूर्ण पदानुक्रम को नोड्स की नेस्टेड सूची के रूप में लौटाता है। utils.create_node_mapping() हेल्पर इसे एक सादा डिक्शनरी में फ्लैटन कर देता है, जो नोड ID से keyed होता है—हर क्वेरी पर ट्री को रिकर्सिवली ट्रैवर्स करने की तुलना में बाद में टेक्स्ट निकालना कहीं तेज़ हो जाता है।
tree_result = pi_client.get_tree(doc_id, node_summary=True)
tree = tree_result["result"]

# Build a flat node map for easy access later
node_map = utils.create_node_mapping(tree)

# Print the top-level nodes
print(f"\nTop-level nodes ({len(tree)} sections):\n")
for node in tree:
    print(f"  [{node['node_id']}] {node['title']}")
    print(f"       Page {node['page_index']}")
    print(f"       {node['summary'][:120]}...")
    print()
Financial Stability Report पर इसे चलाने से आपको दस्तावेज़ का ढाँचा एक नज़र में दिखता है:
Top-level nodes (9 sections):

  [0000] Financial Stability Report
       Page 1
       This document is the October 2023 Financial Stability Report from the Federal Reserve...
  [0001] Purpose and Framework
       Page 5
       This report outlines the Federal Reserve's framework for assessing U.S. financial stability...
  [0002] Overview
       Page 9
       This report evaluates the stability of the U.S. financial system by analyzing four key vulnerability areas...
  [0003] 1 | Asset Valuations
       Page 13
       ...
  [0012] 2 | Borrowing by Businesses and Households
       Page 23
       ...
  [0019] 3 | Leverage in the Financial Sector
       Page 33
       ...
  [0029] 4 | Funding Risks
       Page 45
       ...
  [0036] 5 | Near-Term Risks to the Financial System
       Page 53
       ...
  [0041] Appendix | Figure Notes
       Page 59
       …
ट्री सादा JSON है, जहाँ हर नोड में node_id, title, summary, page_index और nodes (इसके अंतर्गत आने वाले सब-सेक्शंस) होते हैं। वेक्टर इंडेक्स के विपरीत, यहाँ कोई अपारदर्शी एंबेडिंग स्पेस या विशेष रीडर माँगती बाइनरी इंडेक्स फ़ाइल नहीं है। यह बस एक नेस्टेड सूची है जिसे आप प्रिंट, निरीक्षण और सीधे तर्क कर सकते हैं।
यह पारदर्शिता व्यवहार में बहुत उपयोगी है: यदि रिट्रीवर गलत सेक्शन लौटाता है, तो आप ट्री देखकर समझ सकते हैं कि क्यों—जो आप 768-डायमेंशनल एंबेडिंग के साथ कर ही नहीं सकते।
रिट्रीवल स्टेप ट्री स्ट्रक्चर (बिना फुल टेक्स्ट, जो कॉन्टेक्स्ट विंडो से बाहर चला जाएगा) LLM को भेजता है और उससे यह पहचानने को कहता है कि क्वेरी के लिए कौन-से नोड्स प्रासंगिक हैं।
प्रॉम्प्ट पतला ट्री (सिर्फ शीर्षक और सारांश, पूरा सेक्शन टेक्स्ट हटाकर) LLM को पास करता है और उससे एक JSON ऑब्जेक्ट लौटाने को कहता है जिसमें रीज़निंग ट्रेस और नोड IDs की सूची हो। यहाँ दो डिज़ाइन विकल्प ध्यान देने योग्य हैं।
पहला, utils.remove_fields() हर नोड से असल सामग्री हटाता है, जिससे प्रॉम्प्ट लंबी फाइल पर भी कॉन्टेक्स्ट लिमिट के भीतर रहता है। copy.deepcopy() ज़रूरी है क्योंकि remove_fields इन-प्लेस म्यूटेट करता है, और आपको आगे आने वाले टेक्स्ट एक्सट्रैक्शन स्टेप के लिए मूल ट्री जस का तस चाहिए।
दूसरा, response_format={"type": "json_object"} संरचित आउटपुट बाध्य करता है, जिससे पार्सिंग नाज़ुक नहीं, भरोसेमंद रहती है। तापमान 0 पर रहता है क्योंकि यह रीज़निंग का काम है।
TREE_SEARCH_PROMPT = """You are a document retrieval assistant.
Given a document's tree structure and a user query, identify which nodes (sections)
are most likely to contain the answer.

Document tree:
{tree_json}

User query: {query}

Return a JSON object with the following format:
{{
  "reasoning": "Your step-by-step reasoning about which sections to retrieve",
  "node_ids": ["id1", "id2", ...]
}}

Return ONLY the JSON object, no other text."""

async def tree_search(tree, query: str, model: str = "gpt-4o") -> dict:
    """Use an LLM to reason over the tree and return relevant node IDs."""

    # remove_fields mutates in place; deepcopy protects the original tree
    slim_tree = utils.remove_fields(copy.deepcopy(tree), fields=["text"])
    tree_json = json.dumps(slim_tree, indent=2)

    prompt = TREE_SEARCH_PROMPT.format(tree_json=tree_json, query=query)

    response = await openai_client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        response_format={"type": "json_object"}
    )

    result = json.loads(response.choices[0].message.content)
    return result
नोट: नीचे दिए गए await कॉल्स यह मानकर चलते हैं कि आप Jupyter या iPython वातावरण में हैं जहाँ टॉप-लेवल await सपोर्टेड है। यदि आप इसे साधारण .py स्क्रिप्ट के रूप में चलाते हैं, तो async कॉल्स को एक async def main() फ़ंक्शन में लपेटें और उसे asyncio.run(main()) से कॉल करें।
ऐसे प्रश्न से शुरू करें जिसमें एकाधिक सेक्शनों के बीच नेविगेशन लगे। एसेट वैल्यूएशन कमजोरियों पर क्वेरी को ओवरव्यू, एसेट वैल्यूएशंस चैप्टर और उसके विशिष्ट बाज़ारों वाले सब-सेक्शनों की सामग्री चाहिए।
ये वे सेक्शन हैं जिन्हें वेक्टर RAG अलग-अलग सतह पर ला सकता है, पर शायद ही सही पदानुक्रम के साथ एक साथ। यही वह क्वेरी है जहाँ ट्री सर्च अपने पैसे वसूलता है।
query_1 = "What are the main vulnerabilities the Fed identified in asset valuations as of October 2023, and which markets were flagged as stretched?"

result = await tree_search(tree, query_1)

print("LLM Reasoning:")
print(result["reasoning"])
print("\nSelected node IDs:", result["node_ids"])
रीज़निंग ट्रेस वह हिस्सा है जिस पर सबसे ज़्यादा ध्यान देना चाहिए। यहाँ एक सामान्य आउटपुट जैसा दिखता है:
LLM Reasoning:
To identify the main vulnerabilities in asset valuations as of October 2023,
we should focus on sections that specifically discuss asset valuations and
related market conditions. The '1 | Asset Valuations' section and its
subsections are directly relevant as they provide detailed insights into
asset valuation pressures, equity market conditions, and specific market
sectors flagged as stretched.

Selected node IDs: ['0003', '0004', '0006', '0009', '0010', '0011']
आप साफ़-साफ़ देख सकते हैं कि हर सेक्शन क्यों चुना गया—यह वह ट्रेसेबिलिटी है जो आपको कोसाइन सिमिलैरिटी रैंकिंग से नहीं मिलती।
एक बार आपके पास प्रासंगिक नोड IDs हों, अगला कदम है संबंधित टेक्स्ट निकालना और उसे जेनरेशन मॉडल को पास करना।
जेनरेशन स्टेप दो फ़ंक्शंस संभालते हैं.
generate_answer() चुने गए हर नोड को node_map में ढूँढ़ता है, सेक्शन शीर्षक और पेज इंडेक्स वाला हेडर जोड़ता है (यही आपको फाइनल उत्तर में ऑडिटेबल सिटेशंस देता है), और तैयार कॉन्टेक्स्ट को जेनरेशन मॉडल को पास करता है।
pageindex_pipeline() ट्री सर्च और जेनरेशन को एक कॉल में रैप करता है, ताकि आपको हर बार इन्हें मैन्युअली चेन न करना पड़े।
ANSWER_PROMPT = """You are a financial document analyst. Answer the user's question
using ONLY the provided context. Cite the specific section(s) you are drawing from.
If the context does not contain enough information to answer, say so clearly.

Context:
{context}

Question: {question}

Provide a precise, well-cited answer."""

async def generate_answer(node_ids: list, query: str, node_map: dict,
                          model: str = "gpt-4o") -> str:
    """Extract text from the selected nodes and generate an answer."""

    # Gather the text from each selected node
    context_parts = []
    for node_id in node_ids:
        node = node_map.get(node_id)
        if node:
            section_header = f"[{node['title']} | Page {node['page_index']}]"
            context_parts.append(f"{section_header}\n{node.get('text', '')}")

    context = "\n\n---\n\n".join(context_parts)
    prompt = ANSWER_PROMPT.format(context=context, question=query)

    response = await openai_client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0
    )

    return response.choices[0].message.content

async def pageindex_pipeline(tree, query: str, node_map: dict) -> dict:
    """Full PageIndex pipeline: tree search + answer generation."""
    search_result = await tree_search(tree, query)
    node_ids = search_result["node_ids"]
    reasoning = search_result["reasoning"]
    answer = await generate_answer(node_ids, query, node_map)
    return {
        "query": query,
        "reasoning": reasoning,
        "retrieved_sections": node_ids,
        "answer": answer
    }
पूरी पाइपलाइन चलाएँ:
result = await pageindex_pipeline(tree, query_1, node_map)

print(f"Query: {result['query']}\n")
print(f"Retrieved sections: {result['retrieved_sections']}\n")
print(f"Answer:\n{result['answer']}")
उत्तर सेक्शन-स्तरीय सिटेशंस और पेज नंबरों के साथ आता है। यही ट्रेसेबिलिटी PageIndex डिफ़ॉल्ट रूप से देता है।
Query: What are the main vulnerabilities the Fed identified in asset valuations
as of October 2023, and which markets were flagged as stretched?

Retrieved sections: ['0003', '0004', '0006', '0009', '0010', '0011']

Answer:
The main vulnerabilities identified by the Fed in asset valuations as of
October 2023 include:

1. Equity Markets: Valuations increased modestly from an already high level,
with the forward price-to-earnings ratio rising further above its historical
median (Page 13, "Equity market valuation pressures remained notable").

2. Residential Real Estate: House prices started increasing again, and the
price-to-rent ratio was close to its previous peak from the mid-2000s
(Page 20, "House prices started increasing again in recent months").

3. Commercial Real Estate: Despite recent price declines, valuations remained
elevated relative to rental income (Page 19, "Commercial real estate
valuations remained elevated").

4. Farmland: Prices near the peak of their historical distribution, driven
by strong agricultural commodity prices (Page 21, "Farmland valuations
remained elevated").यही वह सेक्शन है जो वस्तुतः कुछ उपयोगी बताता है। आइए उसी दस्तावेज़ पर एक वेक्टर RAG बेसलाइन बनाते हैं और दोनों पाइपलाइनों को एक जैसी क्वेरीज़ पर चलाते हैं।
बेसलाइन मानक पैटर्न का अनुसरण करती है: PyMuPDF से PDF से कच्चा टेक्स्ट निकालें, उसे 500-शब्द ओवरलैपिंग चंक्स में बाँटें, हर chunk को text-embedding-3-small से एंबेड करें, और सब कुछ इन-मेमाेरी FAISS इंडेक्स में लोड कर दें ताकि कोसाइन सिमिलैरिटी लुकअप किया जा सके।
यदि आप जानना चाहते हैं कि chunk आकार और ओवरलैप विकल्प रिट्रीवल गुणवत्ता को कैसे प्रभावित करते हैं, तो हमारा Chunking Strategies आलेख साथ में पढ़ना उपयोगी है, और What Is FAISS? समझाने वाला भी काम आएगा यदि इंडेक्स-बिल्डिंग स्टेप्स अनजाने लगें।
from openai import OpenAI
import numpy as np
import faiss

sync_openai = OpenAI(api_key=OPENAI_API_KEY)

def extract_text_from_pdf(pdf_path: str) -> str:
    """Extract raw text from a PDF using PyMuPDF."""
    import fitz  # pip install pymupdf
    doc = fitz.open(pdf_path)
    pages = []
    for page_num, page in enumerate(doc):
        text = page.get_text()
        if text.strip():
            pages.append(f"[Page {page_num + 1}]\n{text}")
    return "\n\n".join(pages)


def chunk_text(text: str, chunk_size: int = 500, overlap: int = 50) -> list[str]:
    """Split text into overlapping chunks by word count."""
    words = text.split()
    chunks = []
    start = 0
    while start < len(words):
        end = min(start + chunk_size, len(words))
        chunks.append(" ".join(words[start:end]))
        start += chunk_size - overlap
    return chunks


def embed_chunks(chunks: list[str], model: str = "text-embedding-3-small") -> np.ndarray:
    """Embed a list of text chunks with the OpenAI embeddings API."""
    all_embeddings = []
    batch_size = 100
    for i in range(0, len(chunks), batch_size):
        batch = chunks[i : i + batch_size]
        response = sync_openai.embeddings.create(input=batch, model=model)
        batch_embeddings = [item.embedding for item in response.data]
        all_embeddings.extend(batch_embeddings)
    return np.array(all_embeddings, dtype="float32")


def build_faiss_index(embeddings: np.ndarray) -> faiss.IndexFlatIP:
    """Build an in-memory FAISS index for inner-product (cosine) search."""
    dim = embeddings.shape[1]
    faiss.normalize_L2(embeddings)
    index = faiss.IndexFlatIP(dim)
    index.add(embeddings)
    return index


def vector_rag_pipeline(query: str, chunks: list[str], index: faiss.IndexFlatIP,
                         k: int = 5, model: str = "gpt-4o") -> str:
    """Full vector RAG pipeline: embed query, retrieve top-k, generate answer."""

    # Embed the query
    query_embedding = sync_openai.embeddings.create(
        input=[query], model="text-embedding-3-small"
    ).data[0].embedding
    query_vec = np.array([query_embedding], dtype="float32")
    faiss.normalize_L2(query_vec)

    # Retrieve top-k chunks
    _, indices = index.search(query_vec, k)
    retrieved_chunks = [chunks[i] for i in indices[0] if i < len(chunks)]
    context = "\n\n---\n\n".join(retrieved_chunks)

    # Generate answer
    response = sync_openai.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "Answer the question using only the provided context. Be precise."},
            {"role": "user", "content": f"Context:\n{context}\n\nQuestion: {query}"}
        ],
        temperature=0
    )
    return response.choices[0].message.content
हेल्पर फ़ंक्शंस परिभाषित होने के बाद, इंडेक्स बनाइए। 60-पेज दस्तावेज़ पर, एंबेडिंग स्टेप सबसे धीमा है: आपके कनेक्शन और OpenAI के थ्रूपुट पर निर्भर करते हुए एक-दो मिनट लग सकते हैं।
print("Extracting text from PDF...")
raw_text = extract_text_from_pdf(PDF_PATH)

print("Chunking text...")
chunks = chunk_text(raw_text, chunk_size=500, overlap=50)
print(f"  {len(chunks)} chunks created")

print("Embedding chunks...")
embeddings = embed_chunks(chunks)
print(f"  Embeddings shape: {embeddings.shape}")

print("Building FAISS index...")
faiss_index = build_faiss_index(embeddings)
print("Done.\n")60-पेज रिपोर्ट 500 शब्द और 50-शब्द ओवरलैप पर लगभग 47 चंक्स बनाती है।
Extracting text from PDF...
Chunking text...
  47 chunks created
Embedding chunks (takes 1-2 min)...
  Embeddings shape: (47, 1536)
Building FAISS index...
Done.
तीन क्वेरीज़, जिनमें से हर एक अलग रिट्रीवल चुनौती को उजागर करती है:
queries = [
    # Direct factual lookup
    "What does the Fed consider the most significant near-term risk to financial stability as of October 2023?",

    # Cross-reference question (Box 5.2 is referenced from Section 5, requires following an internal pointer)
    "What methodology does the Fed use to assess climate-related financial risks, and where in the report is it described?",

    # Multi-section reasoning (requires connecting Section 1 and Section 3)
    "How do elevated asset valuations interact with leverage in the financial sector to amplify systemic risk, according to the report?"
]
दोनों पाइपलाइंस तैयार होने पर, नीचे का लूप हर क्वेरी दोनों सिस्टम्स से गुज़ारता है और परिणाम इकट्ठा करता है। हर उत्तर पर [:500] स्लाइस सिर्फ कंसोल आउटपुट पठनीय रखने के लिए है; पूरे उत्तर results में बाद में देखने के लिए स्टोर होते हैं।
results = []

for query in queries:
    print(f"\nQuery: {query}\n")

    # PageIndex
    pi_result = await pageindex_pipeline(tree, query, node_map)
    pi_answer = pi_result["answer"]

    # Vector RAG
    vec_answer = vector_rag_pipeline(query, chunks, faiss_index)

    results.append({
        "query": query,
        "pageindex_answer": pi_answer,
        "vector_rag_answer": vec_answer
    })

    print("PageIndex answer:")
    print(pi_answer[:500])
    print("\nVector RAG answer:")
    print(vec_answer[:500])
print("\n" + "="*60)तीनों क्वेरी प्रकारों में आपको कुछ ऐसा ही पैटर्न दिखेगा:
|
क्वेरी |
PageIndex |
Vector RAG |
सही उत्तर |
विजेता |
|
सबसे महत्वपूर्ण अल्पकालिक जोखिम |
कई जोखिमों को कवर करता व्यापक उत्तर, सेक्शन सिटेशंस के साथ |
विशिष्ट 72% सर्वे आँकड़ा सतह पर लाया (इसमें अधिक सटीक) |
लगातार मुद्रास्फीति और कड़ा मौद्रिक नीति, 72% उत्तरदाताओं द्वारा उद्धृत (बॉक्स 5.1) |
ड्रा, विशिष्ट आँकड़े पर Vector RAG को हल्का फायदा |
|
जलवायु जोखिम मेथडोलॉजी (क्रॉस-रेफरेंस) |
सेक्शन रिट्रीव किया, पर बॉक्स 5.2 के बजाय पेरेंट नोड चुना, इसलिए मेथडोलॉजी टेक्स्ट जेनरेशन तक पहुँचा ही नहीं |
बॉक्स 5.2 को सीधा chunk किया और वास्तविक मेथडोलॉजी स्टेप्स लौटाए |
बॉक्स 5.2 परिदृश्य विश्लेषण के ज़रिए फिज़िकल और ट्रांज़िशन जोखिमों को वित्तीय एक्सपोज़र में अनुवाद करने का वर्णन करता है |
Vector RAG |
|
एसेट वैल्यूएशन + लीवरेज इंटरैक्शन |
सेक्शन 1 और 3 के 18 नोड्स रिट्रीव कर amplification मैकेनिज़्म समझाया |
दोनों सेक्शंस को जोड़ा और amplification मैकेनिज़्म समझाया |
ऊँचे वैल्यूएशन तेज़ कीमत-सुधार का जोखिम बढ़ाते हैं; लीवरेज ऐसे सुधार आने पर लीवरेज्ड संस्थानों में नुकसानों को बढ़ाता है (सेक्शन 1 और 3) |
ड्रा |
नतीजे किसी एक सिस्टम की क्लीन स्वीप नहीं हैं, जो उन्हें अधिक उपयोगी बनाता है।
PageIndex तीनों ही मामलों में सही सेक्शंस तक पहुँचा। सीधे तथ्य वाली क्वेरी पर दोनों ने सही उत्तर दिया, हालाँकि Vector RAG ने विशिष्ट 72% आँकड़ा सतह पर ला दिया क्योंकि उसका फ्लैट चंकिंग बॉक्स 5.1 को सलामत कवर कर गया—यह संरचनात्मक बढ़त से ज़्यादा चंकिंग का भाग्य था। मल्टी-सेक्शन क्वेरी में, PageIndex ने सेक्शन 1 और 3 में फैले 18 नोड्स रिट्रीव किए और इंटरैक्शन समझाया, जो मोटे तौर पर Vector RAG के बराबर था। एक स्पष्ट हार क्रॉस-रेफरेंस क्वेरी थी, और समझना ज़रूरी है क्यों।
जलवायु-मेथडोलॉजी क्वेरी में, PageIndex सेक्शन 5 और ओवरव्यू तक तर्क से पहुँचा, लेकिन मेथडोलॉजी बॉक्स 5.2 में है, जो सेक्शन 5 के अंतर्गत एक अलग चाइल्ड नोड है। ट्री सर्च ने पेरेंट सेक्शन चुना, बॉक्स नहीं, और पेरेंट का अपना टेक्स्ट बॉक्स का संदर्भ देता है पर उसे दोहराता नहीं—तदनुसार जेनरेशन स्टेप तक मेथडोलॉजी पहुँची ही नहीं। Vector RAG ने सीधे बॉक्स 5.2 पर chunk करके जीत हासिल की।
यह रीज़निंग नहीं, रिट्रीवल-ग्रैन्युलैरिटी का मुद्दा है: पेरेंट नोड चुनने से उसके बच्चों का टेक्स्ट अपने-आप शामिल नहीं होता जब तक आप सिलेक्शन को विस्तृत न करें। आप प्रॉम्प्टिंग से ट्री सर्च को संबंधित सेक्शन के चाइल्ड नोड्स भी लौटाने को कहकर, या जेनरेशन से पहले हर चुने गए नोड के डिसेंडेंट्स शामिल करके यह गैप पाट सकते हैं।
PageIndex का फायदा इस ट्यूटोरियल में पहले चलाए गए स्टैंडअलोन पाइपलाइन रन (एसेट वैल्यूएशंस क्वेरी) में सबसे साफ़ दिखा, जहाँ उसने दस्तावेज़ संरचना पर ठीक तरह तर्क किया और अच्छे सिटेशंस के साथ सेक्शन-एट्रिब्यूटेड उत्तर लौटाए। ऊपर की तुलना क्वेरीज़ खास तौर पर अधिक चुनौतीपूर्ण रिट्रीवल परिदृश्यों को स्ट्रेस-टेस्ट करने के लिए चुनी गई थीं—इसीलिए वे 60-पेज दस्तावेज़ पर Vector RAG को तरजीह देती हैं।
ईमानदार निष्कर्ष: दस्तावेज़ की लंबाई और आंतरिक क्रॉस-रेफरेंसेज़ की घनत्व के साथ PageIndex का बढ़त तेज़ होती है। 60-पेज रिपोर्ट पर अंतर मध्यम है। दर्जनों फुटनोट्स के परस्पर संदर्भों वाली 200-पेज 10-K पर, अंतर अधिक होने की उम्मीद करें।
यदि आप वेक्टर RAG बेसलाइन को त्यागने से पहले और आगे धकेलना चाहते हैं, तो How to Improve RAG Performance पाँच सबसे असरकारी तकनीकों को कवर करता है।
ऊपर की तुलना एक दस्तावेज़ प्रकार और लंबाई के लिए विशिष्ट है। PageIndex सही विकल्प है या नहीं, यह तीन कारकों पर निर्भर करता है: दस्तावेज़ संरचना, क्वेरी प्रकार, और वॉल्यूम।
PageIndex अपनी ओवरहेड लागत वसूल करता है लंबे, संरचित प्रोफेशनल दस्तावेज़ों पर—जहाँ गलत उत्तर महँगा पड़ता है:
यही वे मामले हैं जहाँ रीज़निंग ट्रेस आपको ऑडिट करने लायक ठोस चीज़ देता है। स्वीट स्पॉट है लो-वॉल्यूम, हाई-स्टेक्स कार्य: दिन में कुछ दर्जन दस्तावेज़ जहाँ हर क्वेरी का सही होना ज़रूरी है—और लेटेंसी व लागत प्रीमियम जायज़ है।
वेक्टर RAG हाई-थ्रूपुट, लो-लेटेंसी वर्कलोड्स के लिए बेहतर डिफ़ॉल्ट है, जहाँ PageIndex की प्रति क्वेरी कई LLM कॉल्स बोतलनेक बनते हैं और कैश्ड एंबेडिंग्स बहुत कम लागत पर लोड सँभालते हैं।
यह फ्लैट दस्तावेज़ों जिनमें पदानुक्रम कम हो, पर भी फिट बैठता है, जैसे:
यह उन मामलों के लिए भी सही है जहाँ लगभग-सही उत्तर पर्याप्त हैं। कोई सपोर्ट चैटबॉट जो दस में से नौ बार सही FAQ ढूँढ़ ले, संभवतः अपनी सीमा पूरी कर रहा है।
कीमत है गति और पैसा। हर PageIndex क्वेरी कम-से-कम दो LLM कॉल्स चलाती है (ट्री सर्च और उत्तर जेनरेशन) साथ में upfront प्रोसेसिंग—तो 60-पेज दस्तावेज़ पर प्रति क्वेरी तीन से आठ सेकंड की उम्मीद करें; वहीं कैश्ड FAISS इंडेक्स के साथ वेक्टर RAG एक सेकंड से कम में—और प्रति क्वेरी बिल भी उसी अनुपात में स्केल करता है।
Financial Stability Report PageIndex के लिए एक निष्पक्ष टेस्ट केस है: संरचित, पदानुक्रमित, क्रॉस-रेफरेंस्ड। हज़ारों छोटे सपोर्ट टिकट्स का कॉर्पस ऐसा नहीं है—और वहाँ वेक्टर RAG बहुत कम लागत पर इसे पीछे छोड़ देगा।
वेक्टर RAG में एक छिपा अनुमान निहित है: जो पैसेज आपकी क्वेरी से सबसे अधिक मिलता-जुलता है वही उत्तर भी रखता है। छोटे, ढीले-संरचित दस्तावेज़ों पर यह अनुमान काफी हद तक सही बैठता है। लंबे, संरचित प्रोफेशनल दस्तावेज़ों पर यह अनुमान पूर्वानुमेय तरीकों से टूटता है: टूटे टेबल, भ्रामक टर्म-फ़्रीक्वेंसी, और अदृश्य क्रॉस-रेफरेंसेज़।
PageIndex इन तीनों को संबोधित करता है—रिट्रीवल को टेक्स्ट फрагमेंट्स पर सिमिलैरिटी सर्च की जगह दस्तावेज़ संरचना पर रीज़निंग समस्या मानकर।
व्यावहारिक नियम सरल है: यदि आपके दस्तावेज़ों में पदानुक्रम है, आपकी क्वेरीज़ को आंतरिक रेफरेंसेज़ का पीछा करना पड़ता है, और सही उत्तर पाना तेज़ उत्तर से ज़्यादा मायने रखता है—तो अतिरिक्त लेटेंसी और लागत के बावजूद PageIndex सार्थक है। यदि आप छोटे या फ्लैट दस्तावेज़ों पर हाई-वॉल्यूम सर्च चला रहे हैं, तो वेक्टर RAG अब भी सही डिफ़ॉल्ट है।
प्रोडक्शन RAG और एजेंटिक सिस्टम्स पर और गहराई में जाना चाहते हैं? हमारा AI Engineering with LangChain ट्रैक आपको एप्लिकेशन फंडामेंटल्स से लेकर रिट्रीवल, इवैल्यूएशन और टूल-यूज़िंग एजेंट्स तक ले जाता है।
DataCamp के साथ RAG सीखें!
कोर्स
कोर्स
कोर्स