
Kurs
LangChain ile Retrieval Augmented Generation (RAG)
3 sa
20.9K
PageIndex, sorgunuza benzeyen metni aramak yerine bir belgenin yapısı üzerinde akıl yürüten bir getirme çerçevesidir. VectifyAI tarafından Eylül 2025’te yayımlandı; geliştiricileri Mingtian Zhang ve Yu Tang. MIT lisansı altında açık kaynaklıdır ve Temmuz 2026 itibarıyla GitHub deposu 34.000’in üzerinde yıldız biriktirmiştir.
PageIndex’in nasıl çalıştığını anlatmanın en iyi yolu, onu standart RAG ile karşılaştırmaktır. RAG’e yeniyseniz, temel fikir, bir LLM’e bir belgeye erişimi, sorgu anında ilgili kısımları getirip bağlam olarak geçirerek sağlamaktır.
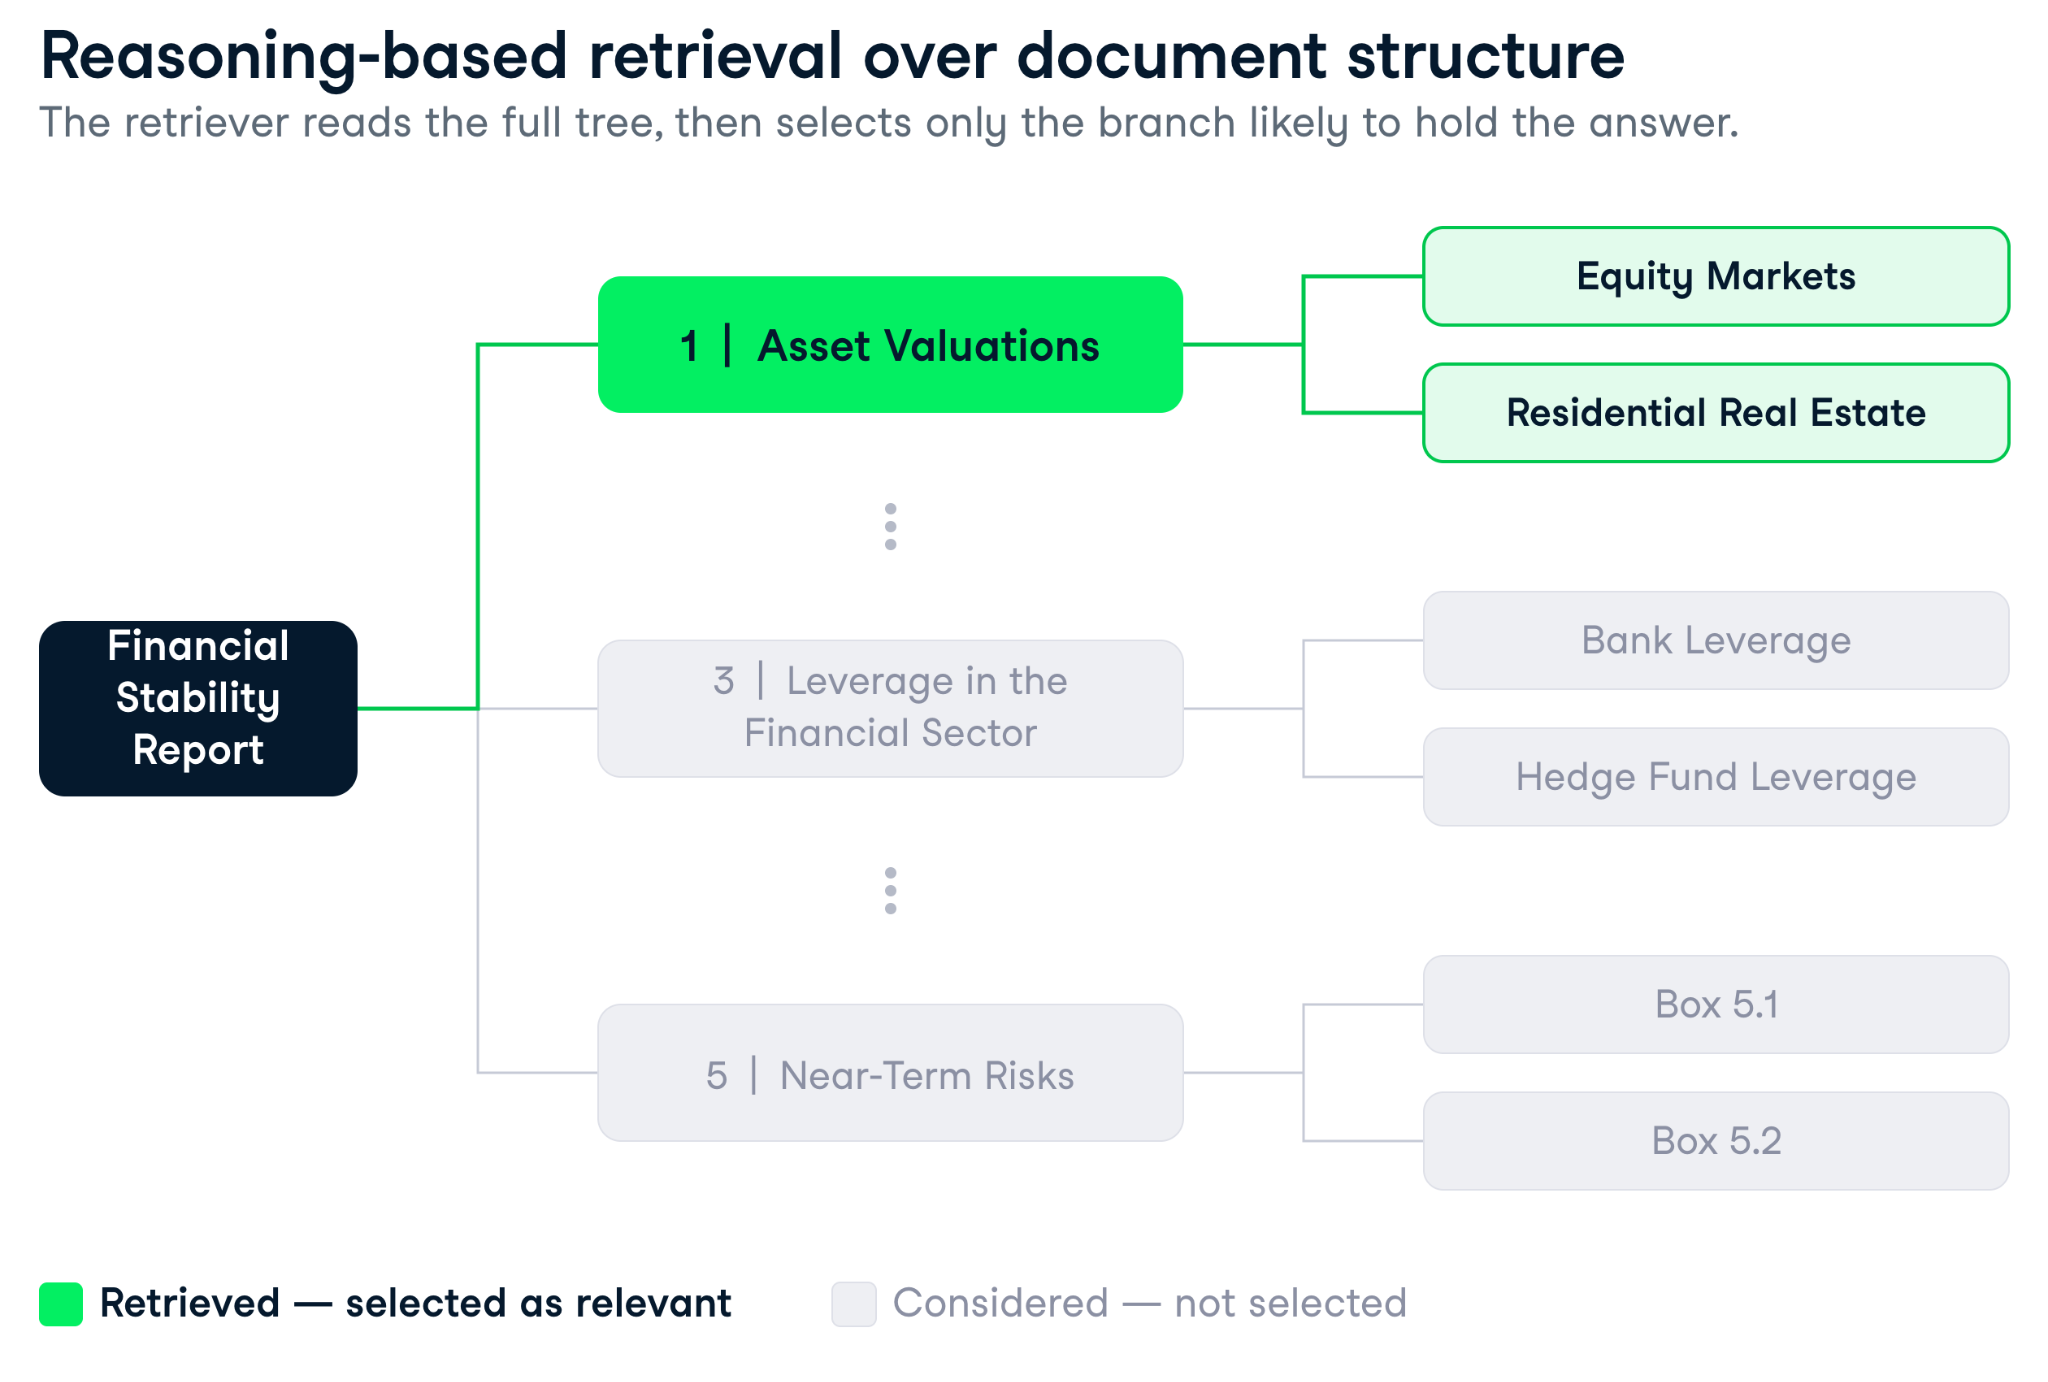
Getirme adımını tam olarak PageIndex yeniden tasarlar. Sorgunuzu belgedeki her parçayla (chunk) karşılaştırmak yerine PageIndex önce belgenin yapısından hiyerarşik bir ağaç indeksi oluşturur. Bu, farklı sonuçlara yol açar:
Başka bir deyişle, standart RAG ile PageIndex arasındaki fark, bir kitapta ilgili anahtar kelimeler için her sayfayı taramak ile önce içindekiler bölümüne bakıp doğru bölümü bulmak arasındaki fark gibidir.
Bu iki hedef kısa belgelerde basit olgusal sorular için yakınsar, ancak belgeler uzun, yapılandırılmış ve iç referanslarla dolu hâle geldiğinde keskin biçimde ayrışır.
Süreç iki adımda ilerler.
Yeterince çok RAG hattı kurdum ki parçalamanın çoğu üretim sisteminin sessizce tökezlediği yer olduğunu biliyorum. Strateji kağıt üzerinde temiz görünür; ama belgenizde sayfa sınırlarını aşan bir tablo ya da üç bölüm önce geçen bir terimi tanımlayan bir dipnot olduğu anda, çatlaklar belirir.
Vektör RAG’in finansal ve hukuki belgelerde tutarlı biçimde ortaya çıkan üç yapısal zayıflığı vardır.
PageIndex, parçalara değil yapıya göre getirdiği için bu üçünü de ele alır. Ağaç belgeyi bir bütün olarak tutar; akıl yürütme adımı bir çapraz referansı takip edebilir veya bölümler arasında karşılaştırma yapabilir ve her düğüm bir sayfa indeksi ile özet taşıdığından, getirici yüzey düzeyinde metin benzerliği yerine belgenin coğrafyasında gezinir.
Dürüst olayım: Mafin 2.5 için %98,7 doğruluk iddiasını (VectifyAI’ın PageIndex tabanlı sistemi) FinanceBench üzerinde ilk gördüğümde içgüdüm şüpheydi; zira standart RAG’e karşı neredeyse 50 puanlık fark, pohpohlayıcı bir kıyas gibi görünür. Ancak FinanceBench tam da bu arıza modlarını test eder: kesin sayısal yanıtlar isteyen, SEC dosyaları üzerinde çok adımlı akıl yürütme.
Bu eğitim, birkaç paket ve iki API anahtarı gerektirir. Kod yazmaya başlamadan önce ihtiyacınız olan her şey burada.
Eğitim boyunca kullandığım tüm kodu eşlik eden GitHub depomda görebilirsiniz.
Bu eğitimi adım adım izlemek için şunlara ihtiyacınız olacak:
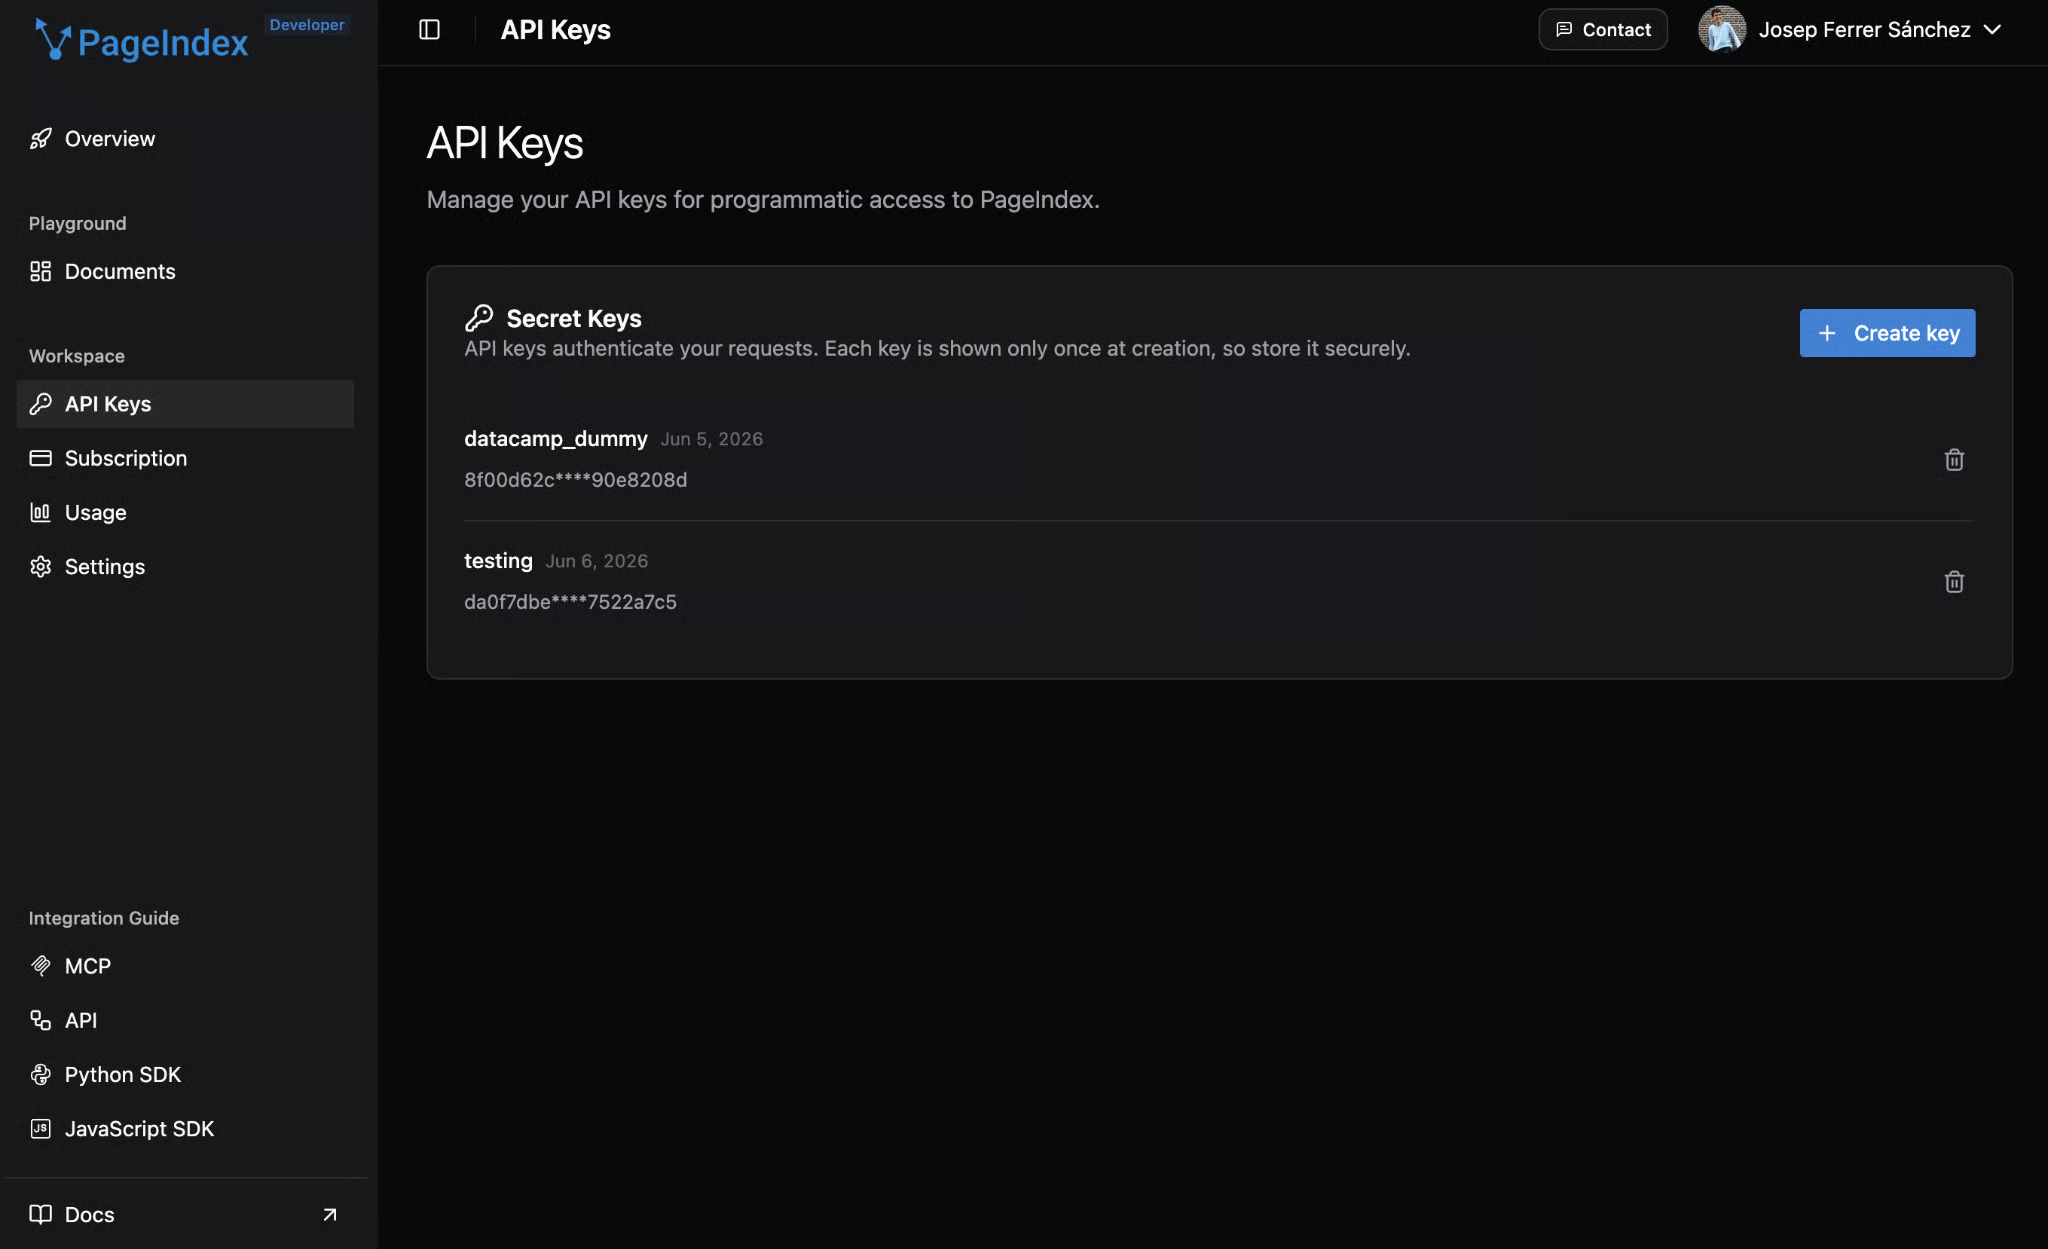
Gerekli paketleri yükleyin:
pip install pageindex openai requests faiss-cpu pymupdfAPI anahtarlarını kod içine gömmek yerine ortam değişkenleri olarak ayarlayın:
export PAGEINDEX_API_KEY="your_pageindex_key_here"
export OPENAI_API_KEY="your_openai_key_here"
Her iki anahtar da ayarlandıktan sonra istemcilerinizi başlatın:
import os
import copy
import time
import json
import asyncio
import requests
from pageindex import PageIndexClient
import pageindex.utils as utils
import openai

PAGEINDEX_API_KEY = os.environ["PAGEINDEX_API_KEY"]
OPENAI_API_KEY = os.environ["OPENAI_API_KEY"]

pi_client = PageIndexClient(api_key=PAGEINDEX_API_KEY)
openai_client = openai.AsyncOpenAI(api_key=OPENAI_API_KEY)
Kurulumun tamamı bu kadar: dokuz import, iki ortam değişkeni, iki istemci.
Bu eğitim için Federal Reserve’ün Ekim 2023 Finansal İstikrar Raporunu kullanacağız. Bu, gerçek bir üretim belgesi gibi yapılandırılmış, herkese açık bir PDF’dir: resmi bölümler, numaralı bölümler, ekler ve iç referanslar.
Fed, raporlarını sabit bir URL’de erişilebilir PDF’ler olarak yayımlar. if not os.path.exists() kontrolü, yalnızca bir kez indirmenizi sağlar; bu da kodun geri kalanında iterasyon yaparken ve her çalıştırmada 60 sayfalık bir PDF’yi yeniden indirmek istemediğinizde önemlidir.
DOWNLOAD_DIR = "./data"
os.makedirs(DOWNLOAD_DIR, exist_ok=True)

PDF_URL = "https://www.federalreserve.gov/publications/files/financial-stability-report-20231020.pdf"
PDF_PATH = os.path.join(DOWNLOAD_DIR, "fed_financial_stability_report_2023.pdf")

if not os.path.exists(PDF_PATH):
    print("Downloading Federal Reserve Financial Stability Report (Oct 2023)...")
    response = requests.get(PDF_URL, timeout=60)
    response.raise_for_status()
    with open(PDF_PATH, "wb") as f:
        f.write(response.content)
    print(f"Saved to {PDF_PATH}")
else:
print(f"Already present: {PDF_PATH}")Gönderim tek bir API çağrısıdır. submit_document() dosyayı yükler ve bu belge üzerinde sonraki tüm işlemlerde kullanacağınız bir doc_id döndürür. Bunu bir yere kaydedin; oturumu yeniden başlatırsanız gönderim adımını atlayıp aynı kimlikle doğrudan get_tree() aşamasına geçebilirsiniz.
print("Submitting document to PageIndex...")
submit_result = pi_client.submit_document(PDF_PATH)
doc_id = submit_result["doc_id"]
print(f"Document ID: {doc_id}")
PageIndex belgeyi eşzamansız işler; bu yüzden ağaç hazır olana kadar yoklamanız gerekir:
print("Waiting for tree generation...")
while True:
    status_result = pi_client.get_document(doc_id)
    status = status_result.get("status")
    print(f"  Status: {status}")
    if status == "completed":
        break
    elif status == "failed":
        raise RuntimeError(f"Processing failed: {status_result}")
    time.sleep(10)

print("Done.")
60 sayfalık bir PDF’yi işlemek genellikle iki ila dört dakika sürer ve bu maliyet belge başına yalnızca bir kez ödenir. Durumun queued → processing → completed döngüsünden geçtiğini göreceksiniz.
Submitting document to PageIndex...
Document ID: pi-cmq2bp4ok00rx01qxmym7tnd1

Waiting for tree generation...
  Status: queued
  Status: processing
  Status: completed
Processing done.İşlem tamamlandığında, get_tree() tüm hiyerarşik yapıyı iç içe düğüm listesi olarak döndürür. utils.create_node_mapping() yardımcı aracı bunu düğüm kimliğine göre anahtarlanan düz bir sözlüğe indirger; bu da daha sonra metin çıkarmayı her sorguda ağacı özyinelemeli dolaşmaktan çok daha hızlı hâle getirir.
tree_result = pi_client.get_tree(doc_id, node_summary=True)
tree = tree_result["result"]

# Build a flat node map for easy access later
node_map = utils.create_node_mapping(tree)

# Print the top-level nodes
print(f"\nTop-level nodes ({len(tree)} sections):\n")
for node in tree:
    print(f"  [{node['node_id']}] {node['title']}")
    print(f"       Page {node['page_index']}")
    print(f"       {node['summary'][:120]}...")
    print()
Financial Stability Report üzerinde bunu çalıştırdığınızda belgenin iskeletini bir bakışta görürsünüz:
Top-level nodes (9 sections):

  [0000] Financial Stability Report
       Page 1
       This document is the October 2023 Financial Stability Report from the Federal Reserve...
  [0001] Purpose and Framework
       Page 5
       This report outlines the Federal Reserve's framework for assessing U.S. financial stability...
  [0002] Overview
       Page 9
       This report evaluates the stability of the U.S. financial system by analyzing four key vulnerability areas...
  [0003] 1 | Asset Valuations
       Page 13
       ...
  [0012] 2 | Borrowing by Businesses and Households
       Page 23
       ...
  [0019] 3 | Leverage in the Financial Sector
       Page 33
       ...
  [0029] 4 | Funding Risks
       Page 45
       ...
  [0036] 5 | Near-Term Risks to the Financial System
       Page 53
       ...
  [0041] Appendix | Figure Notes
       Page 59
       …
Ağaç düz JSON’dur; her düğüm bir node_id, bir title, bir summary, bir page_index ve içerdiği alt bölümler için bir nodes listesi taşır. Vektör indekslerinin aksine, özel bir okuyucu gerektiren opak bir yerleştirme uzayı veya ikili indeks dosyası yoktur. Doğrudan yazdırabileceğiniz, inceleyebileceğiniz ve üzerinde akıl yürütebileceğiniz iç içe bir listedir.
Bu şeffaflık pratikte çok faydalıdır: getirici yanlış bölümü döndürürse, ağaca bakıp nedenini anlayabilirsiniz; 768 boyutlu bir yerleştirmeyle bunu yapamazsınız.
Getirme adımı, ağaç yapısını (tüm metin olmadan; bağlam penceresini aşardı) bir LLM’e gönderir ve sorguya uygun düğümlerin hangileri olduğunu belirlemesini ister.
İstem, kırpılmış ağacı (yalnızca başlıklar ve özetler; tam bölüm metni çıkarılmış) LLM’e iletir ve akıl yürütme izi ile düğüm kimliklerinden oluşan bir liste içeren bir JSON nesnesi döndürmesini ister. Burada iki tasarım seçimi dikkat çekicidir.
Birincisi, utils.remove_fields() serileştirmeden önce her düğümden gerçek içeriği çıkarır; bu da, uzun bir belgede bile istemi bağlam sınırları içinde tutar. copy.deepcopy() çağrısı gereklidir; çünkü remove_fields yerinde (in-place) değiştirir ve ardından gelecek metin çıkarma adımı için özgün ağacı sağlam tutmanız gerekir.
İkincisi, response_format={"type": "json_object"} yapılandırılmış çıktıyı zorlar; böylece ayrıştırma kırılgan değil güvenilir olur. Sıcaklık 0’da kalır; çünkü bu bir akıl yürütme görevidir.
TREE_SEARCH_PROMPT = """You are a document retrieval assistant.
Given a document's tree structure and a user query, identify which nodes (sections)
are most likely to contain the answer.

Document tree:
{tree_json}

User query: {query}

Return a JSON object with the following format:
{{
  "reasoning": "Your step-by-step reasoning about which sections to retrieve",
  "node_ids": ["id1", "id2", ...]
}}

Return ONLY the JSON object, no other text."""

async def tree_search(tree, query: str, model: str = "gpt-4o") -> dict:
    """Use an LLM to reason over the tree and return relevant node IDs."""

    # remove_fields mutates in place; deepcopy protects the original tree
    slim_tree = utils.remove_fields(copy.deepcopy(tree), fields=["text"])
    tree_json = json.dumps(slim_tree, indent=2)

    prompt = TREE_SEARCH_PROMPT.format(tree_json=tree_json, query=query)

    response = await openai_client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        response_format={"type": "json_object"}
    )

    result = json.loads(response.choices[0].message.content)
    return result
Not: Aşağıdaki await çağrıları, üst düzey awaitin desteklendiği bir Jupyter veya iPython ortamını varsayar. Bunu düz bir .py betiği olarak çalıştırırsanız, async çağrılarını bir async def main() fonksiyonu içine sarın ve asyncio.run(main()) ile çağırın.
Birden çok bölümde gezinmeyi gerektiren bir soruyla başlayın. Varlık değerlemelerindeki kırılganlıklarla ilgili bir sorgu; genel bakış, varlık değerlemeleri bölümü ve belirli piyasaları ele alan alt bölümlerden malzeme ister.
Bunlar, vektör RAG’in ayrı ayrı yüzeye çıkarabileceği; ancak doğru hiyerarşi bozulmadan birlikte nadiren getirebildiği bölümlerdir. Ağaç aramasının değerini gösteren tam olarak bu tür bir sorgudur.
query_1 = "What are the main vulnerabilities the Fed identified in asset valuations as of October 2023, and which markets were flagged as stretched?"

result = await tree_search(tree, query_1)

print("LLM Reasoning:")
print(result["reasoning"])
print("\nSelected node IDs:", result["node_ids"])
En yakından dikkat edilmesi gereken kısım akıl yürütme izidir. Tipik bir çıktı şöyle görünür:
LLM Reasoning:
To identify the main vulnerabilities in asset valuations as of October 2023,
we should focus on sections that specifically discuss asset valuations and
related market conditions. The '1 | Asset Valuations' section and its
subsections are directly relevant as they provide detailed insights into
asset valuation pressures, equity market conditions, and specific market
sectors flagged as stretched.

Selected node IDs: ['0003', '0004', '0006', '0009', '0010', '0011']
Her bölümün neden seçildiğini tam olarak görebilirsiniz; bu, kosinüs benzerliği sıralamasında elde edemeyeceğiniz bir izlenebilirlik düzeyidir.
İlgili düğüm kimliklerini aldıktan sonra, bir sonraki adım ilgili metni çıkarmak ve bir üretim modeline aktarmaktır.
Üretim adımını iki fonksiyon üstlenir.
generate_answer(), seçilen her düğümü node_map’te arar, bölüm başlığı ve sayfa indeksini içeren bir başlık ekler (nihai yanıttaki denetlenebilir atıfları bu sağlar) ve derlenmiş bağlamı bir üretim modeline geçirir.
pageindex_pipeline() ağaç araması ve üretimi tek bir çağrıda sarar; böylece her seferinde zincirlemek zorunda kalmazsınız.
ANSWER_PROMPT = """You are a financial document analyst. Answer the user's question
using ONLY the provided context. Cite the specific section(s) you are drawing from.
If the context does not contain enough information to answer, say so clearly.

Context:
{context}

Question: {question}

Provide a precise, well-cited answer."""

async def generate_answer(node_ids: list, query: str, node_map: dict,
                          model: str = "gpt-4o") -> str:
    """Extract text from the selected nodes and generate an answer."""

    # Gather the text from each selected node
    context_parts = []
    for node_id in node_ids:
        node = node_map.get(node_id)
        if node:
            section_header = f"[{node['title']} | Page {node['page_index']}]"
            context_parts.append(f"{section_header}\n{node.get('text', '')}")

    context = "\n\n---\n\n".join(context_parts)
    prompt = ANSWER_PROMPT.format(context=context, question=query)

    response = await openai_client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0
    )

    return response.choices[0].message.content

async def pageindex_pipeline(tree, query: str, node_map: dict) -> dict:
    """Full PageIndex pipeline: tree search + answer generation."""
    search_result = await tree_search(tree, query)
    node_ids = search_result["node_ids"]
    reasoning = search_result["reasoning"]
    answer = await generate_answer(node_ids, query, node_map)
    return {
        "query": query,
        "reasoning": reasoning,
        "retrieved_sections": node_ids,
        "answer": answer
    }
Tüm hattı çalıştırın:
result = await pageindex_pipeline(tree, query_1, node_map)

print(f"Query: {result['query']}\n")
print(f"Retrieved sections: {result['retrieved_sections']}\n")
print(f"Answer:\n{result['answer']}")
Yanıt, bölüm düzeyinde atıflar ve sayfa numaralarıyla birlikte gelir. PageIndex’in varsayılan olarak sunduğu izlenebilirlik budur.
Query: What are the main vulnerabilities the Fed identified in asset valuations
as of October 2023, and which markets were flagged as stretched?

Retrieved sections: ['0003', '0004', '0006', '0009', '0010', '0011']

Answer:
The main vulnerabilities identified by the Fed in asset valuations as of
October 2023 include:

1. Equity Markets: Valuations increased modestly from an already high level,
with the forward price-to-earnings ratio rising further above its historical
median (Page 13, "Equity market valuation pressures remained notable").

2. Residential Real Estate: House prices started increasing again, and the
price-to-rent ratio was close to its previous peak from the mid-2000s
(Page 20, "House prices started increasing again in recent months").

3. Commercial Real Estate: Despite recent price declines, valuations remained
elevated relative to rental income (Page 19, "Commercial real estate
valuations remained elevated").

4. Farmland: Prices near the peak of their historical distribution, driven
by strong agricultural commodity prices (Page 21, "Farmland valuations
remained elevated").Gerçekten faydalı olan kısım burası. Aynı belgede bir vektör RAG taban çizgisi kuralım ve her iki hattı da aynı sorgularda çalıştıralım.
Taban çizgisi standart deseni izler: ham metni PyMuPDF ile PDF’den çıkarın, 500 kelimelik üst üste binen parçalara bölün, her parçayı text-embedding-3-small ile yerleştirin ve hepsini kosinüs benzerliği bakışı için bellek içi bir FAISS indeksine yükleyin.
Parça boyutu ve örtüşme seçimlerinin getirme kalitesini neden etkilediğine dair daha fazla arka plan isterseniz, Chunking Strategies makalemiz bunu okurken faydalıdır; ayrıca FAISS Nedir? açıklayıcısı da indeks oluşturma adımları size yabancıysa işinize yarar.
from openai import OpenAI
import numpy as np
import faiss

sync_openai = OpenAI(api_key=OPENAI_API_KEY)

def extract_text_from_pdf(pdf_path: str) -> str:
    """Extract raw text from a PDF using PyMuPDF."""
    import fitz  # pip install pymupdf
    doc = fitz.open(pdf_path)
    pages = []
    for page_num, page in enumerate(doc):
        text = page.get_text()
        if text.strip():
            pages.append(f"[Page {page_num + 1}]\n{text}")
    return "\n\n".join(pages)


def chunk_text(text: str, chunk_size: int = 500, overlap: int = 50) -> list[str]:
    """Split text into overlapping chunks by word count."""
    words = text.split()
    chunks = []
    start = 0
    while start < len(words):
        end = min(start + chunk_size, len(words))
        chunks.append(" ".join(words[start:end]))
        start += chunk_size - overlap
    return chunks


def embed_chunks(chunks: list[str], model: str = "text-embedding-3-small") -> np.ndarray:
    """Embed a list of text chunks with the OpenAI embeddings API."""
    all_embeddings = []
    batch_size = 100
    for i in range(0, len(chunks), batch_size):
        batch = chunks[i : i + batch_size]
        response = sync_openai.embeddings.create(input=batch, model=model)
        batch_embeddings = [item.embedding for item in response.data]
        all_embeddings.extend(batch_embeddings)
    return np.array(all_embeddings, dtype="float32")


def build_faiss_index(embeddings: np.ndarray) -> faiss.IndexFlatIP:
    """Build an in-memory FAISS index for inner-product (cosine) search."""
    dim = embeddings.shape[1]
    faiss.normalize_L2(embeddings)
    index = faiss.IndexFlatIP(dim)
    index.add(embeddings)
    return index


def vector_rag_pipeline(query: str, chunks: list[str], index: faiss.IndexFlatIP,
                         k: int = 5, model: str = "gpt-4o") -> str:
    """Full vector RAG pipeline: embed query, retrieve top-k, generate answer."""

    # Embed the query
    query_embedding = sync_openai.embeddings.create(
        input=[query], model="text-embedding-3-small"
    ).data[0].embedding
    query_vec = np.array([query_embedding], dtype="float32")
    faiss.normalize_L2(query_vec)

    # Retrieve top-k chunks
    _, indices = index.search(query_vec, k)
    retrieved_chunks = [chunks[i] for i in indices[0] if i < len(chunks)]
    context = "\n\n---\n\n".join(retrieved_chunks)

    # Generate answer
    response = sync_openai.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "Answer the question using only the provided context. Be precise."},
            {"role": "user", "content": f"Context:\n{context}\n\nQuestion: {query}"}
        ],
        temperature=0
    )
    return response.choices[0].message.content
Yardımcı fonksiyonlar tanımlandığında indeksi oluşturun. 60 sayfalık bir belgede yavaş kısım yerleştirme adımıdır: bağlantınıza ve OpenAI’ın kapasitesine bağlı olarak bir iki dakika sürebilir.
print("Extracting text from PDF...")
raw_text = extract_text_from_pdf(PDF_PATH)

print("Chunking text...")
chunks = chunk_text(raw_text, chunk_size=500, overlap=50)
print(f"  {len(chunks)} chunks created")

print("Embedding chunks...")
embeddings = embed_chunks(chunks)
print(f"  Embeddings shape: {embeddings.shape}")

print("Building FAISS index...")
faiss_index = build_faiss_index(embeddings)
print("Done.\n")60 sayfalık bir rapor, 50 kelimelik örtüşme ile 500 kelimede yaklaşık 47 parça üretir.
Extracting text from PDF...
Chunking text...
  47 chunks created
Embedding chunks (takes 1-2 min)...
  Embeddings shape: (47, 1536)
Building FAISS index...
Done.
Üç sorgu; her biri farklı bir getirme zorluğunu ortaya çıkarmak üzere tasarlandı:
queries = [
    # Direct factual lookup
    "What does the Fed consider the most significant near-term risk to financial stability as of October 2023?",

    # Cross-reference question (Box 5.2 is referenced from Section 5, requires following an internal pointer)
    "What methodology does the Fed use to assess climate-related financial risks, and where in the report is it described?",

    # Multi-section reasoning (requires connecting Section 1 and Section 3)
    "How do elevated asset valuations interact with leverage in the financial sector to amplify systemic risk, according to the report?"
]
Her iki hat da hazırken, aşağıdaki döngü her sorguyu her iki sistemden geçirir ve sonuçları toplar. Her yanıttaki [:500] dilimi yalnızca konsol çıktısını okunabilir tutar; tam yanıtlar daha sonra incelemek üzere results içinde saklanır.
results = []

for query in queries:
    print(f"\nQuery: {query}\n")

    # PageIndex
    pi_result = await pageindex_pipeline(tree, query, node_map)
    pi_answer = pi_result["answer"]

    # Vector RAG
    vec_answer = vector_rag_pipeline(query, chunks, faiss_index)

    results.append({
        "query": query,
        "pageindex_answer": pi_answer,
        "vector_rag_answer": vec_answer
    })

    print("PageIndex answer:")
    print(pi_answer[:500])
    print("\nVector RAG answer:")
    print(vec_answer[:500])
print("\n" + "="*60)Üç sorgu tipi genelinde göreceğiniz sonuç türü şöyledir:
|
Sorgu |
PageIndex |
Vektör RAG |
Doğru Yanıt |
Kazanan |
|
En önemli kısa vadeli risk |
Bölüm atıflarıyla birden çok riski kapsayan geniş yanıt |
Spesifik %72 anket rakamını yüzeye çıkardı (bu soruda daha isabetli) |
Kalıcı enflasyon ve daha sıkı para politikası; katılımcıların %72’si tarafından belirtilmiş (Kutu 5.1) |
Berabere, spesifik istatistikte Vektör RAG’e küçük avantaj |
|
İklim riski metodolojisi (çapraz referans) |
Bölümü getirdi ama Kutu 5.2 yerine üst düğümü seçti; bu yüzden metodoloji metni üretime ulaşmadı |
Kutu 5.2’yi doğrudan parçalayıp gerçek metodoloji adımlarını döndürdü |
Kutu 5.2, fiziksel ve geçiş risklerini senaryo analiziyle finansal maruziyetlere çevirme yöntemini açıklar |
Vektör RAG |
|
Varlık değerlemeleri + kaldıraç etkileşimi |
Bölüm 1 ve 3’ten 18 düğüm getirdi ve büyütme mekanizmasını açıkladı |
İki bölümü ilişkilendirip büyütme mekanizmasını açıkladı |
Yüksek değerlemeler keskin fiyat düzeltmeleri riskini artırır; düzeltmeler kaldıraçlı kuruluşları vurduğunda kaldıraç kayıpları büyütür (Bölüm 1 ve 3) |
Berabere |
Sonuçlar, her iki sistem için de temiz bir süpürmeden ziyade daha nüanslı; bu da onları daha faydalı kılıyor.
PageIndex her üç durumda da doğru bölümlere gitti. Doğrudan olgusal sorguda her ikisi de doğru yanıt verdi; vektör RAG, düz parçalama Kutu 5.1’i bozulmadan yakaladığı için spesifik %72 rakamını yüzeye çıkardı; bu yapısal bir üstünlükten çok parça şansıdır. Çok bölümlü sorguda, PageIndex Bölüm 1 ve 3’e yayılan 18 düğüm getirdi ve etkileşimi açıkladı; vektör RAG ile kabaca aynı seviyede. Net kayıp, çapraz referanslı sorguydu ve nedeni anlamaya değer.
İklim metodolojisi sorgusunda, PageIndex Bölüm 5 ve Genel Bakış’a akıl yürüterek ulaştı; fakat metodoloji, Bölüm 5 altında ayrı bir alt düğüm olan Kutu 5.2’deydi. Ağaç araması üst bölümü seçti, kutuyu değil; üst bölümün metni kutuya atıfta bulunur ama onu tekrar etmez; dolayısıyla üretim adımı metodolojiyi hiç görmedi. Vektör RAG, Kutu 5.2’yi doğrudan parçaladığı için kazandı.
Bu bir akıl yürütme hatası değil; getirme tanecik boyutu sorunudur: bir üst düğümün seçilmesi, metinlerini çocuk düğümlerini de içerecek şekilde genişletmediğiniz sürece, çocuklarının metnini getirmez. İlgili herhangi bir bölümün alt düğümlerini de döndürmesi için ağaç aramasını istemleyerek ya da seçilen her düğümü üretimden önce soyundan gelenleriyle genişleterek aradaki farkı kapatabilirsiniz.
PageIndex’in avantajı, eğitimde daha önce tek başına çalıştırılan hat üzerinde (varlık değerlemeleri sorgusu) en net biçimde görüldü; belge yapısı hakkında doğru akıl yürüttü ve iyi atıf yapılan, bölümlere dayalı yanıtlar döndürdü. Yukarıdaki karşılaştırma sorguları, özellikle daha zorlu getirme senaryolarını zorlamak için seçildi; bu yüzden 60 sayfalık bir belge için vektör RAG’i kayırıyorlar.
Dürüst çıkarım: PageIndex’in vektör RAG’e üstünlüğü, belge uzunluğu ve iç referans yoğunluğu arttıkça keskinleşir. 60 sayfalık bir raporda fark orta düzeydedir. Birbirine atıf yapan onlarca dipnota sahip 200 sayfalık bir 10-K’da daha büyük olmasını bekleyin.
Vektör RAG taban çizgisini tamamen gözden çıkarmadan önce daha da zorlamak isterseniz, RAG Performansı Nasıl Artırılır yazısı en yüksek kaldıraçlı beş tekniği ele alır.
Yukarıdaki karşılaştırma belirli bir belge türü ve uzunluğa özeldir. PageIndex’in doğru seçenek olup olmadığı üç faktöre bağlıdır: belge yapısı, sorgu türü ve hacim.
PageIndex, uzun, yapılandırılmış profesyonel belgelerde, yanlış yanıtın maliyetli olduğu yerlerde fazlasıyla karşılığını verir:
Bunlar aynı zamanda akıl yürütme izlerinin denetlenebilir bir şey sunduğu durumlardır. Tatlı nokta düşük hacim, yüksek önem işidir: günde birkaç düzine belge; her sorgunun doğru olması gerekir ve gecikme ile maliyet primi buna değer.
Vektör RAG, yüksek verim, düşük gecikme iş yükleri için daha iyi varsayılandır; PageIndex’in sorgu başına birden çok LLM çağrısı darboğaz olur ve önbelleğe alınmış yerleştirmeler, maliyetin küçük bir kısmına yükü taşır.
Ayrıca az hiyerarşi içeren düz belgeler için uygundur; örneğin:
Yaklaşık yanıtların yeterli olduğu durumlar için de doğru seçimdir. Doğru SSS’yi on denemenin dokuzunda bulan bir destek sohbet botu muhtemelen çıtasını karşılıyordur.
Bedeli hız ve paradır. Her PageIndex sorgusu en az iki LLM çağrısı çalıştırır (ağaç araması ve yanıt üretimi) artı başlangıç işleme; bu nedenle 60 sayfalık bir belgede sorgu başına üç ila sekiz saniye bekleyin. Önbellekli FAISS indeksiyle vektör RAG ise bir saniyenin altındadır; sorgu başına fatura da benzer şekilde ölçeklenir.
Financial Stability Report, PageIndex için adil bir test örneğidir: yapılandırılmış, hiyerarşik, çapraz referanslı. Binlerce kısa destek kaydından oluşan bir külliyat ise değildir; vektör RAG, bunu çok daha düşük maliyetle geride bırakır.
Vektör RAG, içine gizlenmiş bir varsayım taşır: Sorgunuza en çok benzeyen pasajın, yanıtı da içeren pasaj olduğu. Kısa, gevşek yapılandırılmış belgelerde bu varsayım yeterince geçerlidir. Uzun, yapılandırılmış profesyonel belgelerde ise öngörülebilir şekillerde bozulur: bölünmüş tablolar, yanıltıcı terim sıklığı ve görünmez çapraz referanslar.
PageIndex, getirimi metin parçaları üzerinde bir benzerlik araması olarak değil, belge yapısı üzerinde bir akıl yürütme problemi olarak ele alarak üçünü de adresler.
Pratik kural basittir: Belgeleriniz hiyerarşi içeriyorsa, sorgularınız iç referansları takip etmeyi gerektiriyorsa ve doğru yanıtı almak hızdan daha önemliyse, PageIndex ek gecikme ve maliyete değer. Kısa veya düz belgeler üzerinde yüksek hacimli aramalar yapıyorsanız, vektör RAG doğru varsayılan olmaya devam eder.
Üretim RAG ve aracı (agentic) sistemlerde daha derine inmek mi istiyorsunuz? AI Engineering with LangChain eğitim yolumuz, uygulama temellerinden getirime, değerlendirmeye ve araç kullanan ajanlara kadar sizi adım adım ilerletir.
DataCamp ile RAG öğrenin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




