
Corso
Python - Livello Intermedio
4 ore
1.4M
Usare Redis con Python è una combinazione potente per i data engineer che vogliono creare sistemi ad alte prestazioni, scalabili e facili da mantenere. Che tu stia ottimizzando i livelli di cache, gestendo flussi di eventi in tempo reale o implementando lock distribuiti, Redis offre una soluzione flessibile ed efficiente.
In questa guida, vedremo le basi dell'uso di Redis con Python per aiutarti a integrarlo senza problemi nei tuoi workflow di data engineering.
Redis è un archivio open source in-memory di strutture dati, utilizzato come database, cache e message broker. Sta per Remote Dictionary Server ed è stato originariamente progettato come sistema di archiviazione key-value con tempi di accesso rapidi.
Supporta varie strutture dati come stringhe, hash, liste, set e sorted set con query per intervalli. Redis offre anche funzionalità avanzate come transazioni, messaggistica pub/sub, scripting Lua e funzionalità integrate di replica e clustering per una migliore disponibilità e scalabilità.
I potenziali casi d'uso di Redis sono vasti e variegati.
Alcuni dei casi più comuni nel data engineering includono:
Redis viene spesso usato insieme ad altre tecnologie come web server (ad es. NGINX), database (ad es. MySQL) e sistemi di messaggistica (ad es. Kafka) per ottimizzare prestazioni e scalabilità.
Python è un linguaggio dominante nel data engineering grazie alla sua flessibilità, all'ampio ecosistema e alla facilità di integrazione con le tecnologie big data.
Combinarlo con Redis può portare molti vantaggi alle tue applicazioni:
Redis-py è la libreria client ufficiale di Redis per Python. Fornisce un'interfaccia intuitiva per comunicare con Redis dal tuo codice Python.
Tra le sue principali caratteristiche:
Vediamo come possiamo configurare Redis usando Python.

Ci sono tre modi principali per far girare Redis:
Per prima cosa, usando Docker, devi avere Docker Desktop installato sulla tua macchina. Puoi scaricarlo dal sito DockerHub.
Una volta installato Docker, apri il prompt dei comandi e inserisci il seguente comando.
docker pull redis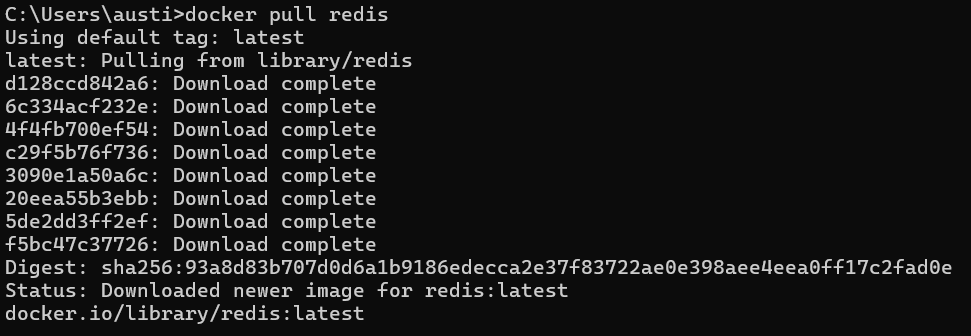
Poi avvieremo un nuovo container.
docker run --name my-redis -p 6379:6379 -d redisdocker pull redis scarica l'immagine ufficiale più recente di Redis. docker run --name my-redis -p 6379:6379 -d redis avvia un nuovo container chiamato my-redis. Il parametro -p 6379:6379 mappa la porta 6379 della tua macchina locale alla porta 6379 del container, così puoi connetterti a Redis su localhost:6379. Il flag -d esegue il container in background (modalità detached).
Per verificare, esegui:
docker exec -it my-redis redis-cli ping
Dovrebbe rispondere con PONG.
Per le macchine Windows, un altro metodo possibile è usare Windows Subsystem per l'installazione. Verrà usato Linux per eseguire l'installazione.
wsl --installQuesto comando installa e configura la distribuzione Ubuntu predefinita all'interno di WSL. Riavvia se richiesto.
Poi, apri il terminale Ubuntu (dal Microsoft Store o digitando wsl in PowerShell) ed esegui:
sudo apt-get update
sudo apt-get install redis-server
Successivamente, avvia il server Redis.
sudo service redis-server startFacciamo un test per vedere se il server è attivo e funzionante.
redis-cli pingEcco una descrizione dettagliata dei comandi usati sopra:
sudo apt-get update recupera le definizioni più recenti dei pacchetti.sudo apt-get install redis-server installa Redis all'interno dell'ambiente Ubuntu.sudo service redis-server start avvia immediatamente il servizio Redis.redis-cli ping testa la connettività al server Redis locale, restituendo PONG se ha successo.Queste soluzioni forniscono binari nativi per Windows. Dopo il download e l'installazione o l'unzip, esegui:
redis-server.exeUna volta avviato, redis-server.exe dovrebbe stampare log indicando che è in ascolto su 127.0.0.1:6379.
Puoi confermare usando la CLI inclusa (se fornita):
redis-cli.exe pingDovresti aspettarti un risultato PONG se tutto va a buon fine.
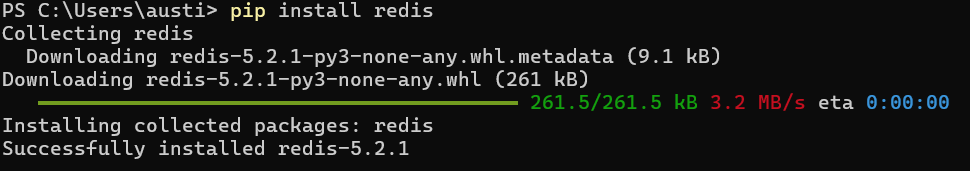
Poi dovrai installare la libreria redis-py per accedere al database usando Python. Prima di installare la libreria, assicurati di avere sia Python che Redis installati separatamente.
pip install redisQuesto comando scarica e installa la libreria client Redis per Python (redis-py) da PyPI. Se usi un ambiente virtuale, assicurati di attivarlo prima di eseguire questo comando.
Verifica con:
python -c "import redis; print(redis.__version__)"Dovrebbe stampare un numero di versione (ad es., 5.2.1).
Se hai seguito uno dei metodi sopra (Docker, WSL o una build di terze parti), ora dovresti avere un server Redis in esecuzione su localhost:6379. Questo è sufficiente per lo sviluppo locale su Windows.
Di seguito trovi esempi Python che mostrano come connettersi e manipolare diversi tipi di dati Redis. Ogni blocco di codice include commenti esplicativi che descrivono come funzionano metodi o comandi.
import redis

# Instantiate a Redis client, connecting to localhost on port 6379
r = redis.Redis(
    host='localhost',
    port=6379,
    db=0  # The default Redis database index
)

# 1. SET command: store a string under 'mykey'
r.set("mykey", "hello from Windows")

# 2. GET command: retrieve the value stored at 'mykey'
value = r.get("mykey")
print(value)   # Output is b'hello from Windows', since redis-py returns bytes.

# 3. Convert bytes to string
print(value.decode())  # prints "hello from Windows"

# 4. DEL command: remove 'mykey' from Redis
r.delete("mykey")
Creiamo un oggetto Redis che si connette al server Redis locale.
r.set("mykey", "hello from Windows") memorizza la stringa "hello from Windows" sotto la chiave "mykey".r.get("mykey") recupera il valore memorizzato in mykey. Redis restituisce byte, quindi li decodifichiamo per un output leggibile.r.delete("mykey") elimina completamente la chiave mykey.Ecco un esempio di gestione delle sessioni utente:
import uuid

def store_user_session(user_id):
    """
    Generates a unique session token (UUID) for a user and stores it in Redis.
    The session is stored under the key pattern: user:{user_id}:session
    """
    session_key = f"user:{user_id}:session"
    token = str(uuid.uuid4())   # Generate a random UUID as a session token
    r.set(session_key, token)   # Store token in Redis
    return token

def get_user_session(user_id):
    """
    Retrieves the stored session token for the given user_id.
    Returns None if the session does not exist or is expired.
    """
    session_key = f"user:{user_id}:session"
    token = r.get(session_key)
    return token.decode('utf-8') if token else None

def delete_user_session(user_id):
    """
    Deletes the session entry from Redis for the specified user_id.
    """
    session_key = f"user:{user_id}:session"
    r.delete(session_key)

# Usage demonstration
session_token = store_user_session(1001)
print(f"Stored session token: {session_token}")

retrieved_token = get_user_session(1001)
print(f"Retrieved session token: {retrieved_token}")

delete_user_session(1001)
print(f"Session after delete: {get_user_session(1001)}") # Should be None or emptystore_user_session(user_id): crea un ID globalmente unico tramite uuid.uuid4() e lo memorizza sotto una chiave specifica dell'utente. get_user_session(user_id): legge il token di sessione. Se None, la sessione è assente o scaduta. delete_user_session(user_id): rimuove la chiave di sessione da Redis, effettuando di fatto il logout dell'utente.
Le liste Redis sono sequenze ordinate di stringhe. Consentono operazioni su entrambe le estremità, risultando utili per code, stack o log.
# LPUSH: Push an element to the head (left) of the list
r.lpush("task_queue", "task1")

# RPUSH: Push an element to the tail (right) of the list
r.rpush("task_queue", "task2")
r.rpush("task_queue", "task3")

# LPOP: Pop (remove and return) the element at the head
task = r.lpop("task_queue")
print(task)  # b'task1'

# Optional: RPOP removes and returns the element at the tail
task = r.rpop("task_queue")
print(task)  # b'task3'
lpush("task_queue", "task1") aggiunge "task1" a sinistra di una lista chiamata "task_queue". rpush("task_queue", "task2") e rpush("task_queue", "task3") aggiungono task a destra. lpop("task_queue") and rpop("task_queue") rimuovono e restituiscono elementi dalle rispettive estremità della lista.
def enqueue_task(queue_name, task):
    """
    Appends a task to the end (right) of the Redis list named queue_name.
    """
    r.rpush(queue_name, task)

def dequeue_task(queue_name):
    """
    Removes a task from the front (left) of the Redis list named queue_name.
    Returns the task as a string, or None if the queue is empty.
    """
    task = r.lpop(queue_name)
    return task.decode('utf-8') if task else None

# Example usage:
enqueue_task("my_queue", "send_email")
enqueue_task("my_queue", "generate_report")

while True:
    task = dequeue_task("my_queue")
    if not task:
        print("No more tasks in queue.")
        break
    print(f"Processing task: {task}")
enqueue_task aggiunge sempre nuovi task alla fine della lista, simulando una coda FIFO tradizionale. dequeue_task rimuove i task dal fronte. Se la lista è vuota, restituisce None.
Il ciclo while elabora i task finché la coda non è vuota, poi si ferma.
Gli hash sono simili ai dizionari Python ma archiviati in Redis. Sono ideali per raggruppare campi correlati (ad es., dettagli utente).
# HSET: Store 'name' and 'email' fields for a user hash key
r.hset("user:1001", "name", "Alice")
r.hset("user:1001", "email", "alice@example.com")

# HGET: Retrieve a single field from the hash
email = r.hget("user:1001", "email")
print(email.decode('utf-8'))  # alice@example.com

# HDEL: Remove a field from the hash
r.hdel("user:1001", "email")
hset("user:1001", "name", "Alice") imposta il campo "name" al valore "Alice" nell'hash alla chiave "user:1001". hget("user:1001", "email") recupera il campo "email". hdel("user:1001", "email") elimina il campo "email" da quell'hash.
def create_user_profile(user_id, name, email):
    """
    Creates a user profile in Redis under the key 'user:{user_id}'.
    'name' and 'email' are stored as separate fields in the hash.
    """
    user_key = f"user:{user_id}"
    r.hset(user_key, mapping={"name": name, "email": email})

def get_user_profile(user_id):
    """
    Retrieves and returns all fields in the user profile hash
    as a Python dictionary. Keys and values are decoded from bytes.
    """
    user_key = f"user:{user_id}"
    profile_data = r.hgetall(user_key)
    return {k.decode('utf-8'): v.decode('utf-8') for k, v in profile_data.items()}

def delete_user_profile(user_id):
    """
    Deletes the entire user profile key from Redis.
    """
    user_key = f"user:{user_id}"
    r.delete(user_key)

# Usage demonstration
create_user_profile(1002, "Bob", "bob@example.com")
print(get_user_profile(1002))  # e.g. {'name': 'Bob', 'email': 'bob@example.com'}
delete_user_profile(1002)
Memorizziamo nome ed email di un utente all'interno di un hash. mapping={"name": name, "email": email} usa la capacità di redis-py di impostare più campi in una volta sola. r.hgetall(user_key) recupera tutti i campi e valori, restituiti come dizionario di byte grezzi che decodifichiamo in stringhe. delete_user_profile rimuove l'intera chiave dell'hash.
I dati in Redis possono essere gestiti usando set o sorted set.
I set sono collezioni di valori unici, mentre i sorted set sono collezioni di coppie chiave-valore con un punteggio associato a ciascun valore. Queste strutture dati offrono modi efficienti per archiviare e recuperare informazioni, rendendole utili per applicazioni che richiedono lookup rapidi.
Un set in Redis è simile a un insieme matematico: contiene una collezione di elementi unici e non sono ammessi duplicati. I set possono essere usati per modellare relazioni tra entità diverse, ad esempio gli utenti che hanno messo like a un post sui social.
Ecco una dimostrazione dei set:
# SADD: Add multiple members to a set
r.sadd("tags:python", "redis", "windows", "backend")

# SMEMBERS: Retrieve all unique members in the set
tags = r.smembers("tags:python")
print(tags)  # {b'redis', b'windows', b'backend'}
I set di Redis garantiscono l'unicità dei membri. Tentare di aggiungere un duplicato non avrà effetto.
Il risultato di smembers è un set Python di byte.
I sorted set in Redis sono simili ai set normali, ma ogni membro ha anche un punteggio corrispondente. Questo permette operazioni di ordinamento e ranking efficienti sul set.
I sorted set sono spesso usati per classifiche, dove il punteggio rappresenta il rango o i punti di un giocatore.
Ecco una dimostrazione dei sorted set:
# ZADD: Add members with scores
r.zadd("leaderboard", {"player1": 10, "player2": 20})

# ZRANGE: Retrieve members in ascending order of score
leaders = r.zrange("leaderboard", 0, -1, withscores=True)
print(leaders)  # [(b'player1', 10.0), (b'player2', 20.0)]
I sorted set memorizzano i membri in un ordine specifico determinato dai punteggi numerici. zrange("leaderboard", 0, -1, withscores=True) restituisce tutti i membri dal rango 0 alla fine, includendo i loro punteggi.
L'uso dei sorted set può essere utile per gestire tag o creare classifiche.
def add_tag(post_id, tag):
    """
    Adds a 'tag' to the set of tags belonging to a specific post.
    Each post has its own set under 'post:{post_id}:tags'.
    """
    r.sadd(f"post:{post_id}:tags", tag)

def get_tags(post_id):
    """
    Retrieves all tags for a specific post, decoding the bytes into strings.
    """
    raw_tags = r.smembers(f"post:{post_id}:tags")
    return {tag.decode('utf-8') for tag in raw_tags}

def update_leaderboard(player, score):
    """
    Updates or inserts a player's score in the 'game:leaderboard' sorted set.
    A higher score indicates a better position if sorting descending.
    """
    r.zadd("game:leaderboard", {player: score})

def get_leaderboard():
    """
    Returns an ascending list of (player, score) tuples from the leaderboard.
    To invert the sorting (highest first), you'd use ZREVRANGE.
    """
    entries = r.zrange("game:leaderboard", 0, -1, withscores=True)
    return [(player.decode('utf-8'), score) for player, score in entries]

# Usage demonstration
add_tag(123, "python")
add_tag(123, "redis")
print(get_tags(123))

update_leaderboard("Alice", 300)
update_leaderboard("Bob", 450)
print(get_leaderboard())
add_tag e get_tags mostrano un sistema di tagging one-to-many, archiviando i tag in un Set. update_leaderboard e get_leaderboard illustrano come potresti implementare una classifica di gioco.
Redis ha diverse funzionalità che lo rendono una scelta popolare per l'archiviazione dei dati nelle applicazioni Python: queueing, locking e caching.
Ecco di seguito le loro implementazioni in Python:
Esploriamo l'uso di Redis come coda con blocking usando BLPOP.
BLPOP è un'operazione bloccante che attende finché un elemento non è disponibile in una lista.
def blocking_consumer(queue_name):
    """
    Continuously listens to the specified queue (Redis list) using BLPOP,
    which blocks until new items are pushed. Once an item arrives,
    it is removed from the queue and processed.
    """
    print(f"Waiting on queue: {queue_name}")
    while True:
        result = r.blpop(queue_name)
        if result:
            list_name, task_bytes = result
            task = task_bytes.decode('utf-8')
            print(f"Received task: {task}")
        else:
            print("Queue is empty or an error occurred.")
            break

def enqueue_task(queue_name, task):
    """
    Pushes a task to the end of a Redis list (queue).
    """
    r.rpush(queue_name, task)

# Example usage:
enqueue_task("blocking_queue", "task_block_1")
enqueue_task("blocking_queue", "task_block_2")

# In a real application, the consumer might run in a separate thread or process
blocking_consumer("blocking_queue")
blocking_consumer usa blpop in un loop. Se la lista è vuota, blpop attenderà finché non viene inserito un altro elemento.
Una volta ricevuto un elemento, viene rimosso dalla lista e stampato.
Questo approccio è ideale per i pattern producer-consumer in cui i worker consumano task man mano che compaiono.
I lock distribuiti impediscono a più client o processi di modificare simultaneamente la stessa risorsa. Redis può aiutare a evitare race condition in un ambiente distribuito.
import time
from redis.exceptions import LockError

def process_critical_section():
    """
    Acquires a lock named 'resource_lock' with a timeout of 10 seconds.
    The lock automatically expires after 10 seconds to prevent deadlocks.
    """
    lock = r.lock("resource_lock", timeout=10)
    try:
        # Attempt to acquire the lock, wait for up to 5 seconds if another process holds it
        acquired = lock.acquire(blocking=True, blocking_timeout=5)
        if acquired:
            print("Lock acquired; performing critical operation...")
            time.sleep(3)  # Simulate some operation
        else:
            print("Failed to acquire lock within 5 seconds.")
    except LockError:
        print("A LockError occurred, possibly releasing already released lock.")
    finally:
        # Always release the lock in a finally block to ensure cleanup
        lock.release()
        print("Lock released.")

# Usage demonstration
process_critical_section()
Creiamo un lock con timeout=10, il che significa che se il lock non viene rilasciato manualmente, Redis lo rimuoverà automaticamente dopo 10 secondi per prevenire blocchi indefiniti (deadlock). lock.acquire(blocking=True, blocking_timeout=5) prova ad acquisire il lock per 5 secondi prima di rinunciare. Al termine, lock.release() libera la risorsa per altri processi.
Il caching è uno scenario d'uso comune: memorizzare in memoria i dati a cui si accede frequentemente, riducendo il carico su database o API esterne.
import requests
import json

def get_user_data(user_id):
    """
    Retrieves user data from a hypothetical API endpoint.
    If the data is found in Redis (cache), use that. Otherwise, call the API,
    store the response in Redis with a 60-second expiration, and return it.
    """
    cache_key = f"user_data:{user_id}"
    cached_data = r.get(cache_key)
    if cached_data:
        print("Cache hit!")
        return json.loads(cached_data)

    print("Cache miss. Fetching from API...")
    response = requests.get(f"https://api.example.com/users/{user_id}")
    user_info = response.json()

    # Store in Redis for 60 seconds
    r.setex(cache_key, 60, json.dumps(user_info))
    return user_info

# Usage
user = get_user_data(42)  # First call => cache miss
user_again = get_user_data(42)  # Subsequent call => cache hit
Verifichiamo se user_data:{user_id} esiste in Redis. Se sì, è un cache hit e saltiamo la chiamata API. In caso contrario, recuperiamo dall'API remota, poi usiamo setex (set + scadenza) per 60 secondi. Le chiamate successive entro quel lasso di tempo recupereranno i dati in cache, riducendo la latenza.
Pensi di aver già preso la mano con Redis? Vediamo alcuni argomenti più avanzati.
Pub/Sub (Publish/Subscribe) è un popolare pattern di messaggistica per la comunicazione in tempo reale. I publisher inviano messaggi a un canale e tutti gli iscritti a quel canale li ricevono.
import threading

def subscriber(r, channel_name):
    """
    Subscribes to the given Redis channel and listens for messages.
    When a new message is published on that channel, it is printed.
    """
    pubsub = r.pubsub()
    pubsub.subscribe(channel_name)
    print(f"Subscribed to {channel_name}")

    # pubsub.listen() yields messages from the subscribed channel(s) in real time
    for message in pubsub.listen():
        if message['type'] == 'message':
            print(f"Received message: {message['data'].decode('utf-8')}")

def publisher(r, channel_name, message):
    """
    Publishes a message to the specified Redis channel.
    All subscribers to this channel immediately receive the message.
    """
    r.publish(channel_name, message)

# Example usage
channel = "updates"

# Start subscriber in a separate thread to avoid blocking the main thread
sub_thread = threading.Thread(target=subscriber, args=(r, channel))
sub_thread.start()

# Publish messages
publisher(r, channel, "Hello from Windows!")
publisher(r, channel, "Another update!")
pubsub = r.pubsub() crea un oggetto PubSub. pubsub.subscribe(channel_name) indica a Redis di inviare i messaggi da quel canale all'oggetto PubSub. pubsub.listen() è un iteratore infinito che produce messaggi man mano che arrivano. r.publish(channel_name, message) invia un messaggio a tutti gli iscritti a channel_name.
Redis supporta il time-to-live (TTL). È essenziale per dati temporanei come sessioni o cache di breve durata.
# EXPIRE: Set a 30-second expiration on a key
r.set("temp_key", "some value")
r.expire("temp_key", 30)

# SETEX: Combined set + expire in one command
r.setex("temp_key2", 60, "another value")
r.expire("temp_key", 30) imposta un TTL di 30 secondi. Dopo 30 secondi, temp_key viene eliminata automaticamente. r.setex("temp_key2", 60, "another value") è una scorciatoia che imposta chiave e scadenza nello stesso momento.
Ecco un esempio di come usare chiavi con scadenza per impostare la scadenza di una sessione dopo un determinato intervallo di tempo.
def store_session_with_expiry(user_id, token, ttl=3600):
    """
    Stores a session token for a specific user with a time-to-live (TTL).
    By default, the session expires after 1 hour (3600 seconds).
    """
    session_key = f"user:{user_id}:session"
    r.setex(session_key, ttl, token)

def get_session_with_expiry(user_id):
    """
    Retrieves the session token for the user. Returns None if the key doesn't exist
    or if it has expired.
    """
    session_key = f"user:{user_id}:session"
    token = r.get(session_key)
    return token.decode('utf-8') if token else None

# Usage
store_session_with_expiry(2001, "session_token_abc", 3600)
retrieved_token = get_session_with_expiry(2001)
print(f"Retrieved token: {retrieved_token}")
store_session_with_expiry usa setex per memorizzare user:{user_id}:session con un TTL specificato. Se non passi un TTL, la chiave potrebbe rimanere indefinitamente.
Quando il TTL scade, Redis rimuove automaticamente la chiave, rendendo impossibile recuperare la sessione.
Gestire Redis richiede alcune considerazioni e best practice per garantire prestazioni ottimali ed evitare insidie comuni.
Alcuni consigli da tenere a mente includono:
Redis è uno strumento potente e versatile per gestire i dati nelle applicazioni Python. Usare Python con Redis può abilitare molte applicazioni e casi d'uso, dal caching dei dati alla gestione delle code.
Vuoi saperne di più su Redis? Il nostro corso Introduzione a NoSQL può aiutarti a imparare a gestire dati key-value. Ti interessa invece Python? Allora il nostro Python Data Fundamentals skill track potrebbe essere il punto di partenza migliore.
I migliori corsi DataCamp
Corso
Programma
Programma
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



