

कोर्स
इंटरमीडिएट Python
4 घंटा
1.4M
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंPython के साथ Redis का उपयोग डेटा इंजीनियरों के लिए उच्च-प्रदर्शन, स्केलेबल और मेंटेन करने योग्य सिस्टम बनाने का एक शक्तिशाली संयोजन है। चाहे आप कैशिंग लेयर्स का अनुकूलन कर रहे हों, रियल-टाइम इवेंट स्ट्रीम प्रबंधित कर रहे हों, या डिस्ट्रीब्यूटेड लॉकिंग लागू कर रहे हों, Redis लचीला और कुशल समाधान प्रदान करता है।
इस गाइड में, हम Python के साथ Redis के उपयोग की बुनियादी बातें कवर करेंगे ताकि आप इसे अपने डेटा इंजीनियरिंग वर्कफ़्लोज़ में बिना रुकावट एकीकृत कर सकें।
Redis एक ओपन-सोर्स, इन-मैमोरी डेटा स्ट्रक्चर स्टोर है जिसका उपयोग डेटाबेस, कैश और मैसेज ब्रोकर के रूप में किया जाता है। इसका पूरा नाम Remote Dictionary Server है और मूल रूप से इसे तेज़ एक्सेस समय के साथ की-वैल्यू स्टोरेज सिस्टम के रूप में डिज़ाइन किया गया था।
यह विभिन्न डेटा स्ट्रक्चर जैसे स्ट्रिंग, हैश, लिस्ट, सेट और रेंज क्वेरीज़ के साथ सॉर्टेड सेट का समर्थन करता है। Redis ट्रांज़ैक्शन, पब/सब मैसेजिंग, Lua स्क्रिप्टिंग, और बेहतर उपलब्धता व स्केलेबिलिटी के लिए बिल्ट-इन रेप्लिकेशन और क्लस्टरिंग क्षमताओं जैसी उन्नत सुविधाएँ भी प्रदान करता है।
Redis के संभावित उपयोग के मामले बहुत व्यापक और विविध हैं।
डेटा इंजीनियरिंग में कुछ सामान्य उपयोग के मामले इस प्रकार हैं:
Redis का उपयोग अक्सर अन्य तकनीकों के साथ भी किया जाता है, जैसे वेब सर्वर (उदा. NGINX), डेटाबेस (उदा. MySQL), और मैसेजिंग सिस्टम (उदा. Kafka), प्रदर्शन और स्केलेबिलिटी को अनुकूलित करने के लिए।
Python अपनी लचीलेपन, व्यापक इकोसिस्टम और बिग डेटा तकनीकों के साथ आसान एकीकरण के कारण डेटा इंजीनियरिंग में एक प्रमुख भाषा है।
इसे Redis के साथ जोड़ने से आपके अनुप्रयोगों को कई फायदे मिल सकते हैं:
Redis-py Python के लिए आधिकारिक Redis क्लाइंट लाइब्रेरी है। यह आपके Python कोड से Redis के साथ संवाद करने के लिए उपयोगकर्ता-अनुकूल इंटरफ़ेस प्रदान करती है।
इसकी कुछ मुख्य विशेषताएँ शामिल हैं:
आइए देखते हैं कि Python का उपयोग करते हुए हम अपने लिए Redis कैसे सेट कर सकते हैं।

Redis चलाने के तीन मुख्य तरीके हैं:
सबसे पहले, Docker का उपयोग करते समय, आपको अपनी मशीन में Docker Desktop इंस्टॉल करना होगा। यह DockerHub वेबसाइट से डाउनलोड किया जा सकता है।
Docker इंस्टॉल हो जाने पर, अपना कमांड प्रॉम्प्ट खोलें और निम्न कमांड दर्ज करें।
docker pull redis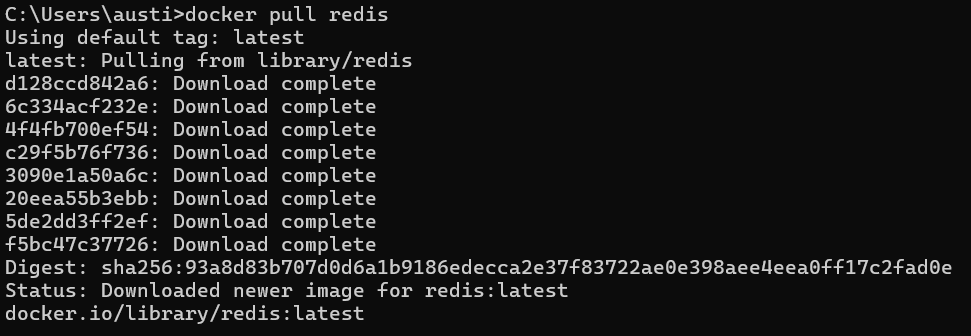
अगला, हम एक नया कंटेनर प्रारंभ करेंगे।
docker run --name my-redis -p 6379:6379 -d redisdocker pull redis नवीनतम आधिकारिक Redis इमेज डाउनलोड करता है। docker run --name my-redis -p 6379:6379 -d redis my-redis नामक नया कंटेनर शुरू करता है। -p 6379:6379 पैरामीटर आपकी लोकल मशीन के पोर्ट 6379 को कंटेनर के पोर्ट 6379 से मैप करता है, ताकि आप localhost:6379 पर Redis से कनेक्ट कर सकें। -d फ्लैग कंटेनर को बैकग्राउंड (डिटैच्ड मोड) में चलाता है।
सत्यापित करने के लिए, चलाएँ:
docker exec -it my-redis redis-cli ping
इसे PONG के साथ प्रतिक्रिया देनी चाहिए।
Windows मशीनों के लिए, एक अन्य संभव तरीका Windows Subsystem का उपयोग करके इंस्टॉलेशन करना है। यह इंस्टॉलेशन के लिए Linux का उपयोग करेगा।
wsl --installयह कमांड WSL के अंदर डिफॉल्ट Ubuntu डिस्ट्रीब्यूशन इंस्टॉल और कॉन्फ़िगर करता है। आवश्यकता होने पर रीबूट करें।
इसके बाद, अपना Ubuntu टर्मिनल खोलें (Microsoft Store से या PowerShell में wsl टाइप करके) और चलाएँ:
sudo apt-get update
sudo apt-get install redis-server
अगला, अपना Redis सर्वर शुरू करें।
sudo service redis-server startआइए परीक्षण करें कि सर्वर चालू और चल रहा है या नहीं।
redis-cli pingयहाँ ऊपर उपयोग किए गए कमांड्स का विस्तृत विवरण दिया गया है:
sudo apt-get update नवीनतम पैकेज परिभाषाएँ प्राप्त करता है।sudo apt-get install redis-server Ubuntu वातावरण के भीतर Redis इंस्टॉल करता है।sudo service redis-server start तुरंत Redis सेवा चालू करता है।redis-cli ping लोकल Redis सर्वर से कनेक्टिविटी की जाँच करता है, सफल होने पर PONG लौटाता है।ये समाधान नेटिव Windows बायनरीज़ प्रदान करते हैं। डाउनलोड व इंस्टॉल/अनज़िप करने के बाद, चलाएँ:
redis-server.exeलॉन्च होने के बाद, redis-server.exe लॉग प्रिंट करेगा जिससे पता चलेगा कि यह 127.0.0.1:6379 पर सुन रहा है।
आप शामिल CLI (यदि उपलब्ध हो) का उपयोग करके पुष्टि कर सकते हैं:
redis-cli.exe pingसफल होने पर आपको PONG परिणाम की अपेक्षा करनी चाहिए।
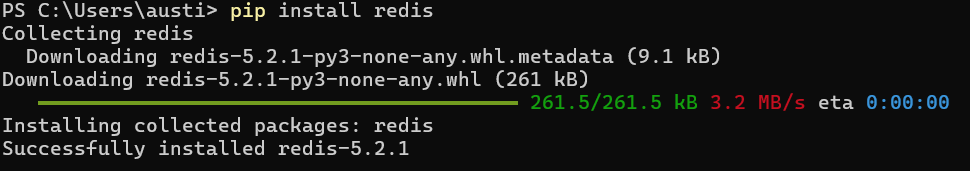
अगला, आपको Python का उपयोग करके डेटाबेस तक पहुँचने के लिए redis-py लाइब्रेरी इंस्टॉल करनी होगी। इंस्टॉल करने से पहले, सुनिश्चित करें कि आपके पास Python और Redis दोनों अलग-अलग इंस्टॉल हैं।
pip install redisयह कमांड PyPI से Python Redis क्लाइंट लाइब्रेरी (redis-py) डाउनलोड और इंस्टॉल करता है। यदि आप वर्चुअल एनवायरनमेंट का उपयोग कर रहे हैं, तो इस कमांड को चलाने से पहले उसे सक्रिय करें।
सत्यापित करें:
python -c "import redis; print(redis.__version__)"यह एक वर्ज़न नंबर प्रिंट करना चाहिए (उदा., 5.2.1)।
यदि आपने ऊपर दी गई कोई भी विधि (Docker, WSL, या थर्ड-पार्टी बिल्ड) अपनाई है, तो अब आपके पास localhost:6379 पर चल रहा Redis सर्वर होना चाहिए। यह Windows पर लोकल विकास के लिए पर्याप्त है।
नीचे Python उदाहरण दिए गए हैं जो विभिन्न Redis डेटा प्रकारों से कनेक्ट करने और उन्हें संशोधित करने का तरीका दिखाते हैं। प्रत्येक कोड ब्लॉक में यह बताने वाली टिप्पणियाँ शामिल हैं कि मेथड या कमांड कैसे काम करते हैं।
import redis

# Instantiate a Redis client, connecting to localhost on port 6379
r = redis.Redis(
    host='localhost',
    port=6379,
    db=0  # The default Redis database index
)

# 1. SET command: store a string under 'mykey'
r.set("mykey", "hello from Windows")

# 2. GET command: retrieve the value stored at 'mykey'
value = r.get("mykey")
print(value)   # Output is b'hello from Windows', since redis-py returns bytes.

# 3. Convert bytes to string
print(value.decode())  # prints "hello from Windows"

# 4. DEL command: remove 'mykey' from Redis
r.delete("mykey")
हम एक Redis ऑब्जेक्ट बनाते हैं जो लोकल Redis सर्वर से कनेक्ट होता है।
r.set("mykey", "hello from Windows") कुंजी "mykey" के अंतर्गत "hello from Windows" स्ट्रिंग संग्रहीत करता है।r.get("mykey") mykey में संग्रहीत मान लाता है। Redis बाइट्स लौटाता है, इसलिए हम मानव-पठनीय आउटपुट के लिए इसे डिकोड करते हैं।r.delete("mykey") कुंजी mykey को पूरी तरह हटा देता है।यहाँ यूज़र सेशन प्रबंधन का एक कोड उदाहरण है:
import uuid

def store_user_session(user_id):
    """
    Generates a unique session token (UUID) for a user and stores it in Redis.
    The session is stored under the key pattern: user:{user_id}:session
    """
    session_key = f"user:{user_id}:session"
    token = str(uuid.uuid4())   # Generate a random UUID as a session token
    r.set(session_key, token)   # Store token in Redis
    return token

def get_user_session(user_id):
    """
    Retrieves the stored session token for the given user_id.
    Returns None if the session does not exist or is expired.
    """
    session_key = f"user:{user_id}:session"
    token = r.get(session_key)
    return token.decode('utf-8') if token else None

def delete_user_session(user_id):
    """
    Deletes the session entry from Redis for the specified user_id.
    """
    session_key = f"user:{user_id}:session"
    r.delete(session_key)

# Usage demonstration
session_token = store_user_session(1001)
print(f"Stored session token: {session_token}")

retrieved_token = get_user_session(1001)
print(f"Retrieved session token: {retrieved_token}")

delete_user_session(1001)
print(f"Session after delete: {get_user_session(1001)}") # Should be None or emptystore_user_session(user_id): uuid.uuid4() के माध्यम से एक वैश्विक रूप से यूनिक ID बनाता है और उसे यूज़र-विशिष्ट कुंजी के अंतर्गत संग्रहीत करता है। get_user_session(user_id): सेशन टोकन पढ़ता है। यदि None है, तो सेशन अनुपस्थित है या समाप्त हो चुका है। delete_user_session(user_id): Redis से सेशन कुंजी हटाता है, प्रभावी रूप से यूज़र को लॉग आउट करता है।
Redis लिस्ट्स स्ट्रिंग्स के क्रमबद्ध अनुक्रम हैं। ये दोनों सिरों पर ऑपरेशन की अनुमति देती हैं, जो इन्हें क्यू, स्टैक या लॉग के लिए उपयोगी बनाती हैं।
# LPUSH: Push an element to the head (left) of the list
r.lpush("task_queue", "task1")

# RPUSH: Push an element to the tail (right) of the list
r.rpush("task_queue", "task2")
r.rpush("task_queue", "task3")

# LPOP: Pop (remove and return) the element at the head
task = r.lpop("task_queue")
print(task)  # b'task1'

# Optional: RPOP removes and returns the element at the tail
task = r.rpop("task_queue")
print(task)  # b'task3'
lpush("task_queue", "task1") "task_queue" नामक लिस्ट के बाएँ सिरे पर "task1" जोड़ता है। rpush("task_queue", "task2") और rpush("task_queue", "task3") दाएँ सिरे पर टास्क जोड़ते हैं। lpop("task_queue") और rpop("task_queue") लिस्ट के संबंधित सिरों से आइटम हटाते हैं और लौटाते हैं।
def enqueue_task(queue_name, task):
    """
    Appends a task to the end (right) of the Redis list named queue_name.
    """
    r.rpush(queue_name, task)

def dequeue_task(queue_name):
    """
    Removes a task from the front (left) of the Redis list named queue_name.
    Returns the task as a string, or None if the queue is empty.
    """
    task = r.lpop(queue_name)
    return task.decode('utf-8') if task else None

# Example usage:
enqueue_task("my_queue", "send_email")
enqueue_task("my_queue", "generate_report")

while True:
    task = dequeue_task("my_queue")
    if not task:
        print("No more tasks in queue.")
        break
    print(f"Processing task: {task}")
enqueue_task हमेशा नए टास्क को लिस्ट के अंत में जोड़ता है, जो पारंपरिक FIFO क्यू का अनुकरण करता है। dequeue_task सामने से टास्क हटाता है। यदि लिस्ट खाली है, तो यह None लौटाता है।
while-लूप क्यू खाली होने तक टास्क प्रोसेस करता है, फिर रुक जाता है।
हैश Python डिक्शनरी की तरह होते हैं, लेकिन Redis में स्टोर किए जाते हैं। ये संबंधित फ़ील्ड्स (जैसे, यूज़र विवरण) को समूहित करने के लिए सर्वोत्तम हैं।
# HSET: Store 'name' and 'email' fields for a user hash key
r.hset("user:1001", "name", "Alice")
r.hset("user:1001", "email", "alice@example.com")

# HGET: Retrieve a single field from the hash
email = r.hget("user:1001", "email")
print(email.decode('utf-8'))  # alice@example.com

# HDEL: Remove a field from the hash
r.hdel("user:1001", "email")
hset("user:1001", "name", "Alice") कुंजी "user:1001" पर स्थित हैश में "name" फ़ील्ड को "Alice" मान पर सेट करता है। hget("user:1001", "email") "email" फ़ील्ड प्राप्त करता है। hdel("user:1001", "email") उस हैश से "email" फ़ील्ड हटा देता है।
def create_user_profile(user_id, name, email):
    """
    Creates a user profile in Redis under the key 'user:{user_id}'.
    'name' and 'email' are stored as separate fields in the hash.
    """
    user_key = f"user:{user_id}"
    r.hset(user_key, mapping={"name": name, "email": email})

def get_user_profile(user_id):
    """
    Retrieves and returns all fields in the user profile hash
    as a Python dictionary. Keys and values are decoded from bytes.
    """
    user_key = f"user:{user_id}"
    profile_data = r.hgetall(user_key)
    return {k.decode('utf-8'): v.decode('utf-8') for k, v in profile_data.items()}

def delete_user_profile(user_id):
    """
    Deletes the entire user profile key from Redis.
    """
    user_key = f"user:{user_id}"
    r.delete(user_key)

# Usage demonstration
create_user_profile(1002, "Bob", "bob@example.com")
print(get_user_profile(1002))  # e.g. {'name': 'Bob', 'email': 'bob@example.com'}
delete_user_profile(1002)
हम किसी यूज़र का नाम और ईमेल एक हैश के भीतर स्टोर करते हैं। mapping={"name": name, "email": email} redis-py की एक साथ एकाधिक फ़ील्ड सेट करने की क्षमता का उपयोग करता है। r.hgetall(user_key) सभी फ़ील्ड और मान प्राप्त करता है, जो कच्चे बाइट्स की डिक्शनरी के रूप में लौटते हैं जिन्हें हम स्ट्रिंग में डिकोड करते हैं। delete_user_profile पूरी हैश कुंजी हटा देता है।
Redis में डेटा को सेट या सॉर्टेड सेट का उपयोग करके प्रबंधित किया जा सकता है।
सेट यूनिक मानों का संग्रह होते हैं, जबकि सॉर्टेड सेट ऐसे संग्रह होते हैं जिनमें प्रत्येक मान के साथ एक स्कोर जुड़ा होता है। ये डेटा स्ट्रक्चर डेटा को कुशलतापूर्वक स्टोर और प्राप्त करने के तरीके प्रदान करते हैं, जो तेज़ लुकअप की आवश्यकता वाले अनुप्रयोगों के लिए उपयोगी हैं।
Redis में सेट गणितीय सेट के समान होता है – इसमें यूनिक तत्वों का संग्रह होता है, और डुप्लिकेट तत्वों की अनुमति नहीं होती। सेट का उपयोग विभिन्न एंटिटीज़ के बीच संबंध मॉडल करने के लिए किया जा सकता है, जैसे किसी सोशल मीडिया पोस्ट को पसंद करने वाले यूज़र।
यहाँ सेट का डेमो है:
# SADD: Add multiple members to a set
r.sadd("tags:python", "redis", "windows", "backend")

# SMEMBERS: Retrieve all unique members in the set
tags = r.smembers("tags:python")
print(tags)  # {b'redis', b'windows', b'backend'}
Redis सेट सदस्यों की विशिष्टता सुनिश्चित करते हैं। डुप्लिकेट सदस्य जोड़ने का प्रयास करने पर कोई प्रभाव नहीं पड़ेगा।
smembers का परिणाम बाइट्स का Python सेट होता है।
Redis में सॉर्टेड सेट सामान्य सेट के समान होते हैं, लेकिन प्रत्येक सदस्य का एक संबंधित स्कोर भी होता है। इससे सेट पर कुशल सॉर्टिंग और रैंकिंग ऑपरेशन संभव होते हैं।
सॉर्टेड सेट का उपयोग अक्सर लीडरबोर्ड के लिए किया जाता है, जहाँ स्कोर किसी प्लेयर की रैंक या पॉइंट्स का प्रतिनिधित्व करता है।
यहाँ सॉर्टेड सेट का डेमो है:
# ZADD: Add members with scores
r.zadd("leaderboard", {"player1": 10, "player2": 20})

# ZRANGE: Retrieve members in ascending order of score
leaders = r.zrange("leaderboard", 0, -1, withscores=True)
print(leaders)  # [(b'player1', 10.0), (b'player2', 20.0)]
सॉर्टेड सेट सदस्यों को उनके संख्यात्मक स्कोर द्वारा निर्धारित विशिष्ट क्रम में संग्रहीत करते हैं। zrange("leaderboard", 0, -1, withscores=True) रैंक 0 से अंत तक सभी सदस्यों को उनके स्कोर सहित लौटाता है।
सॉर्टेड सेट का उपयोग टैग प्रबंधन या लीडरबोर्ड बनाने में सहायक हो सकता है।
def add_tag(post_id, tag):
    """
    Adds a 'tag' to the set of tags belonging to a specific post.
    Each post has its own set under 'post:{post_id}:tags'.
    """
    r.sadd(f"post:{post_id}:tags", tag)

def get_tags(post_id):
    """
    Retrieves all tags for a specific post, decoding the bytes into strings.
    """
    raw_tags = r.smembers(f"post:{post_id}:tags")
    return {tag.decode('utf-8') for tag in raw_tags}

def update_leaderboard(player, score):
    """
    Updates or inserts a player's score in the 'game:leaderboard' sorted set.
    A higher score indicates a better position if sorting descending.
    """
    r.zadd("game:leaderboard", {player: score})

def get_leaderboard():
    """
    Returns an ascending list of (player, score) tuples from the leaderboard.
    To invert the sorting (highest first), you'd use ZREVRANGE.
    """
    entries = r.zrange("game:leaderboard", 0, -1, withscores=True)
    return [(player.decode('utf-8'), score) for player, score in entries]

# Usage demonstration
add_tag(123, "python")
add_tag(123, "redis")
print(get_tags(123))

update_leaderboard("Alice", 300)
update_leaderboard("Bob", 450)
print(get_leaderboard())
add_tag और get_tags सेट में टैग संग्रहीत करके एक एक-से-अनेक टैगिंग सिस्टम प्रदर्शित करते हैं। update_leaderboard और get_leaderboard दिखाते हैं कि आप गेम लीडरबोर्ड कैसे लागू कर सकते हैं।
Redis में कई सुविधाएँ हैं जो इसे Python अनुप्रयोगों में डेटा स्टोरेज के लिए लोकप्रिय बनाती हैं: क्यूइंग, लॉकिंग और कैशिंग।
नीचे इनके Python में इम्प्लीमेंटेशन दिए गए हैं:
आइए BLPOP का उपयोग करके ब्लॉकिंग के साथ Redis को क्यू के रूप में उपयोग करना देखें।
BLPOP एक ब्लॉकिंग ऑपरेशन है जो तब तक प्रतीक्षा करता है जब तक कि किसी लिस्ट में कोई तत्व उपलब्ध नहीं हो जाता।
def blocking_consumer(queue_name):
    """
    Continuously listens to the specified queue (Redis list) using BLPOP,
    which blocks until new items are pushed. Once an item arrives,
    it is removed from the queue and processed.
    """
    print(f"Waiting on queue: {queue_name}")
    while True:
        result = r.blpop(queue_name)
        if result:
            list_name, task_bytes = result
            task = task_bytes.decode('utf-8')
            print(f"Received task: {task}")
        else:
            print("Queue is empty or an error occurred.")
            break

def enqueue_task(queue_name, task):
    """
    Pushes a task to the end of a Redis list (queue).
    """
    r.rpush(queue_name, task)

# Example usage:
enqueue_task("blocking_queue", "task_block_1")
enqueue_task("blocking_queue", "task_block_2")

# In a real application, the consumer might run in a separate thread or process
blocking_consumer("blocking_queue")
blocking_consumer लूप में blpop का उपयोग करता है। यदि लिस्ट खाली है, तो blpop तब तक प्रतीक्षा करेगा जब तक कोई और आइटम पुश न हो।
आइटम प्राप्त होने पर, वह लिस्ट से हटा दिया जाता है और प्रिंट होता है।
यह दृष्टिकोण प्रोड्यूसर-कंज़्यूमर पैटर्न के लिए आदर्श है, जहाँ वर्कर टास्क आने पर उन्हें कंज़्यूम करते हैं।
डिस्ट्रीब्यूटेड लॉक कई क्लाइंट्स या प्रक्रियाओं को एक साथ एक ही संसाधन को संशोधित करने से रोकते हैं। Redis वितरित वातावरण में रेस कंडीशंस से बचने में मदद कर सकता है।
import time
from redis.exceptions import LockError

def process_critical_section():
    """
    Acquires a lock named 'resource_lock' with a timeout of 10 seconds.
    The lock automatically expires after 10 seconds to prevent deadlocks.
    """
    lock = r.lock("resource_lock", timeout=10)
    try:
        # Attempt to acquire the lock, wait for up to 5 seconds if another process holds it
        acquired = lock.acquire(blocking=True, blocking_timeout=5)
        if acquired:
            print("Lock acquired; performing critical operation...")
            time.sleep(3)  # Simulate some operation
        else:
            print("Failed to acquire lock within 5 seconds.")
    except LockError:
        print("A LockError occurred, possibly releasing already released lock.")
    finally:
        # Always release the lock in a finally block to ensure cleanup
        lock.release()
        print("Lock released.")

# Usage demonstration
process_critical_section()
हम timeout=10 के साथ एक लॉक बनाते हैं, यानी यदि लॉक को मैन्युअली रिलीज़ नहीं किया गया, तो Redis 10 सेकंड में इसे स्वतः हटा देगा ताकि अनिश्चितकालीन ब्लॉकिंग (डेडलॉक) से बचा जा सके। lock.acquire(blocking=True, blocking_timeout=5) 5 सेकंड तक लॉक प्राप्त करने की कोशिश करता है। समाप्ति पर, lock.release() अन्य प्रक्रियाओं के लिए संसाधन मुक्त कर देता है।
कैशिंग एक सामान्य परिदृश्य है: अक्सर एक्सेस किए जाने वाले डेटा को मेमोरी में स्टोर करें, जिससे डेटाबेस या बाहरी APIs पर लोड कम हो।
import requests
import json

def get_user_data(user_id):
    """
    Retrieves user data from a hypothetical API endpoint.
    If the data is found in Redis (cache), use that. Otherwise, call the API,
    store the response in Redis with a 60-second expiration, and return it.
    """
    cache_key = f"user_data:{user_id}"
    cached_data = r.get(cache_key)
    if cached_data:
        print("Cache hit!")
        return json.loads(cached_data)

    print("Cache miss. Fetching from API...")
    response = requests.get(f"https://api.example.com/users/{user_id}")
    user_info = response.json()

    # Store in Redis for 60 seconds
    r.setex(cache_key, 60, json.dumps(user_info))
    return user_info

# Usage
user = get_user_data(42)  # First call => cache miss
user_again = get_user_data(42)  # Subsequent call => cache hit
हम जाँचते हैं कि user_data:{user_id} Redis में मौजूद है या नहीं। यदि हाँ, तो यह कैश हिट है, और हम API कॉल छोड़ देते हैं। यदि नहीं, तो हम रिमोट API से डेटा लाते हैं, फिर 60 सेकंड के लिए setex (सेट + एक्सपिरेशन) करते हैं। उस अवधि में आने वाली अगली कॉल्स कैश्ड डेटा लौटाएँगी, जिससे विलंबता घटेगी।
क्या आपको लगता है कि अब आप Redis को समझ गए हैं? आइए कुछ और उन्नत विषयों से गुज़रते हैं।
Pub/Sub (Publish/Subscribe) रियल-टाइम संचार के लिए एक लोकप्रिय मैसेजिंग पैटर्न है। पब्लिशर्स किसी चैनल पर संदेश भेजते हैं, और उस चैनल के सभी सब्सक्राइबर्स संदेश प्राप्त करते हैं।
import threading

def subscriber(r, channel_name):
    """
    Subscribes to the given Redis channel and listens for messages.
    When a new message is published on that channel, it is printed.
    """
    pubsub = r.pubsub()
    pubsub.subscribe(channel_name)
    print(f"Subscribed to {channel_name}")

    # pubsub.listen() yields messages from the subscribed channel(s) in real time
    for message in pubsub.listen():
        if message['type'] == 'message':
            print(f"Received message: {message['data'].decode('utf-8')}")

def publisher(r, channel_name, message):
    """
    Publishes a message to the specified Redis channel.
    All subscribers to this channel immediately receive the message.
    """
    r.publish(channel_name, message)

# Example usage
channel = "updates"

# Start subscriber in a separate thread to avoid blocking the main thread
sub_thread = threading.Thread(target=subscriber, args=(r, channel))
sub_thread.start()

# Publish messages
publisher(r, channel, "Hello from Windows!")
publisher(r, channel, "Another update!")
pubsub = r.pubsub() एक PubSub ऑब्जेक्ट बनाता है। pubsub.subscribe(channel_name) Redis को उस चैनल से संदेश PubSub ऑब्जेक्ट को भेजने का निर्देश देता है। pubsub.listen() एक अनंत इटरेटर है, जो संदेश आते ही उन्हें देता है। r.publish(channel_name, message) channel_name के सभी सब्सक्राइबर्स को संदेश भेजता है।
Redis टाइम-टू-लाइव (TTL) का समर्थन करता है। यह अस्थायी डेटा जैसे सेशंस या अल्पकालिक कैश के लिए आवश्यक है।
# EXPIRE: Set a 30-second expiration on a key
r.set("temp_key", "some value")
r.expire("temp_key", 30)

# SETEX: Combined set + expire in one command
r.setex("temp_key2", 60, "another value")
r.expire("temp_key", 30) 30 सेकंड का TTL सेट करता है। 30 सेकंड बाद, temp_key स्वतः हट जाएगा। r.setex("temp_key2", 60, "another value") एक शॉर्टकट है जो एक ही समय में कुंजी और समाप्ति सेट करता है।
यहाँ एक उदाहरण है कि आप किसी निर्दिष्ट अवधि के बाद सेशन समाप्त करने के लिए एक्सपायरिंग कुंजियों का उपयोग कैसे कर सकते हैं।
def store_session_with_expiry(user_id, token, ttl=3600):
    """
    Stores a session token for a specific user with a time-to-live (TTL).
    By default, the session expires after 1 hour (3600 seconds).
    """
    session_key = f"user:{user_id}:session"
    r.setex(session_key, ttl, token)

def get_session_with_expiry(user_id):
    """
    Retrieves the session token for the user. Returns None if the key doesn't exist
    or if it has expired.
    """
    session_key = f"user:{user_id}:session"
    token = r.get(session_key)
    return token.decode('utf-8') if token else None

# Usage
store_session_with_expiry(2001, "session_token_abc", 3600)
retrieved_token = get_session_with_expiry(2001)
print(f"Retrieved token: {retrieved_token}")
store_session_with_expiry अंदरूनी रूप से setex का उपयोग करके user:{user_id}:session को निर्दिष्ट TTL के साथ स्टोर करता है। यदि आप TTL पास नहीं करते हैं, तो कुंजी अनिश्चितकाल तक रह सकती है।
जब TTL समाप्त हो जाता है, तो Redis स्वचालित रूप से कुंजी हटा देता है, जिससे सेशन प्राप्त करना असंभव हो जाता है।
Redis को संभालते समय कुछ विचार और सर्वोत्तम अभ्यास आवश्यक होते हैं ताकि इष्टतम प्रदर्शन सुनिश्चित किया जा सके और सामान्य समस्याओं से बचा जा सके।
ध्यान में रखने योग्य कुछ टिप्स:
Redis Python अनुप्रयोगों में डेटा प्रबंधन के लिए एक शक्तिशाली और बहुमुखी उपकरण है। Python के साथ Redis का उपयोग कैशिंग से लेकर क्यू प्रबंधन तक के कई अनुप्रयोगों और उपयोग मामलों को संभव बनाता है।
Redis के बारे में और सीखने के इच्छुक हैं? हमारा Introduction to NoSQL कोर्स आपको की-वैल्यू डेटा को संभालना सिखा सकता है। Python में रुचि है? तो हमारा Python Data Fundamentals स्किल ट्रैक शुरू करने के लिए सबसे अच्छा स्थान हो सकता है।
शीर्ष DataCamp कोर्स
कोर्स
लर्निंग पाथ
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें